184、影响CFD计算速度的,到底有哪些因素?
我自己使用Fluent做CFD计算时,有时候会遇到这样的问题:对于不同的网格数量,电脑的计算速度是不同的,这很容易理解。但有时网格数量相同,用相同的电脑,计算速度也有所不同。有时候可以很快就算完,有时候却要跑几个小时,这很让人费解。
CFD计算速度到底由哪些因素决定呢?很多人归结为两个因素:电脑配置和网格数量。这两个因素当然重要,但真正做过复杂计算就会发现,事情没有这么简单。
同样是100万网格,一个模型算得飞快,另一个却很慢。为什么打开Energy、Species或者湍流模型以后速度就下来了?为什么加一个UDF,单次迭代突然变慢?
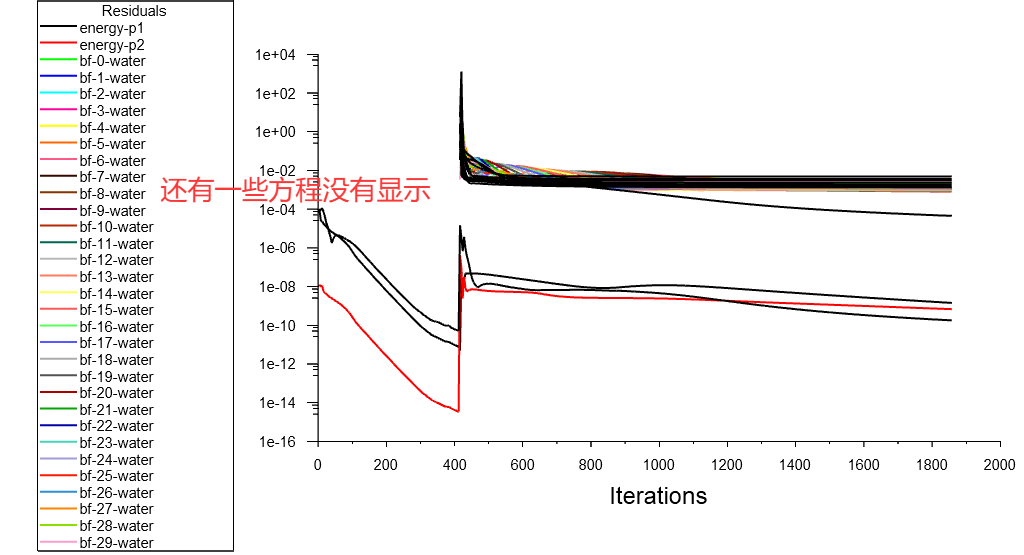
我曾经尝试过给模型额外加42组方程,完全相同的网格,计算速度会瞬间变慢,慢的离谱,必须用超算才算的动。这是什么原因呢?
要回答这些问题,先把CFD计算时间拆成两个最基本的部分:
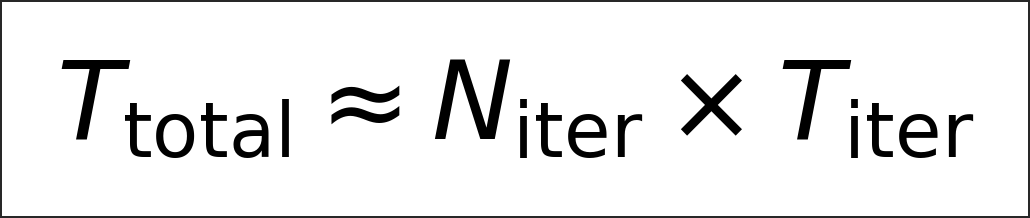
其中T_total是总计算时间,T_iter是单次迭代耗时,N_iter是达到收敛条件需要的迭代次数。
所以CFD计算速度这个问题,实际上就变成了两个更具体的问题:一次迭代为什么这么慢,以及为什么需要迭代这么多次。后面所有因素,都可以归到这两个问题里。
1. 计算机因素
1. 计算机因素
先说硬件。CFD求解说到底就是海量数值运算,CPU、内存和并行能力都直接影响单次迭代的耗时。
1.1 单核性能与核心数量
CPU要看两个方面:单核性能决定单个核心执行任务的能力,核心数量决定并行计算时能调动多少资源。Fluent这类CFD软件可以把网格切分到多个核心上同时求解,在一定范围内加核心确实能明显压缩单次迭代时间。
Ansys官方给过一个参考数据:1.4亿网格的F1赛车滑移网格仿真,在1280个CPU核心上运行,2020 R2版本比19.0版本提速61%。大规模并行确实是大模型算得动的前提。
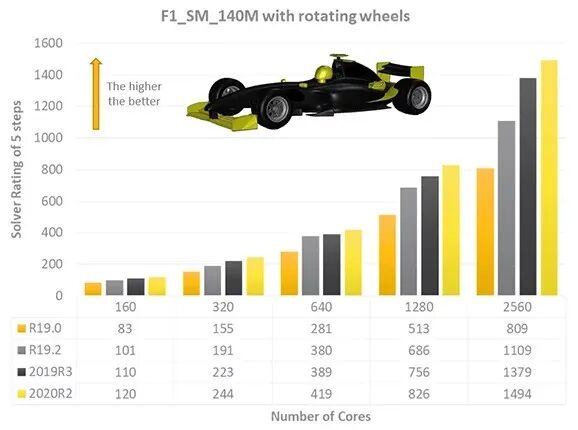
但核心数量翻倍,计算速度不一定翻倍。因为并行计算除了算,还要在核心之间做数据通信和同步:

核心少的时候,时间主要花在计算上;核心多了以后,通信和同步占的比例会越来越大。所以并行效率存在实际的上限,Ansys官方在硬件选型建议里也明确说过:无脑堆核心数反而可能拖累内存带宽,让Fluent、CFX这类软件性能下降。对CFD来说,该关注的是具体模型下的并行效率,不是核心越多越好。
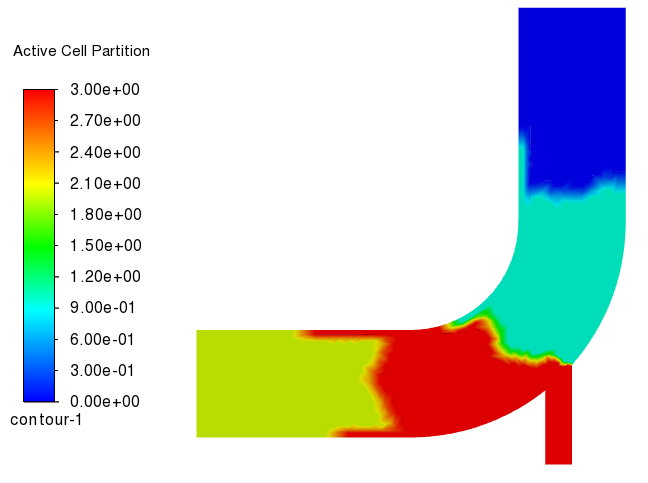
上面这张图是Fluent并行划分网格的示意图,每种颜色代表一个进程负责的区域。分区越多,区域之间的交界面就越多,通信量也就越大,这就是并行效率递减的直观来源。
1.2 内存与硬盘
CFD计算要在内存里保存大量网格、变量和矩阵数据。内存不够,系统就会频繁拿磁盘当虚拟内存用,速度会出现断崖式下降。所以内存对大型计算是个底线因素:够用的时候它不是瓶颈,不够用的时候它就是最致命的瓶颈。
SSD主要影响Case/Data文件读取、结果保存和自动保存这些过程,对求解阶段单次迭代的速度影响远没有CPU和内存大。
所以如果只看硬件,CPU性能、内存、并行效率是影响单次迭代速度最重要的三件事。但电脑配置只解决每次算得多快,解决不了需要算多少次。
2. 几何与网格因素
2. 几何与网格因素
如果说电脑决定用什么速度算,那网格决定的就是到底有多少东西要算。
2.1 网格数量直接影响单步耗时
10万单元的模型和500万单元的模型,哪怕用完全一样的数学模型,后者也必然更慢。因为每个单元都要存储变量、建立并求解离散方程,单元多了,单次迭代要处理的数据量就上去了:
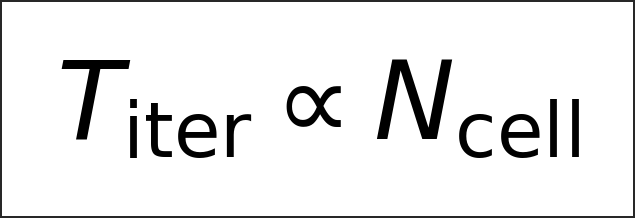
T_iter近似正比于网格数量N_cell。这只是个粗略关系,实际还受网格拓扑、并行划分和求解器效率影响。
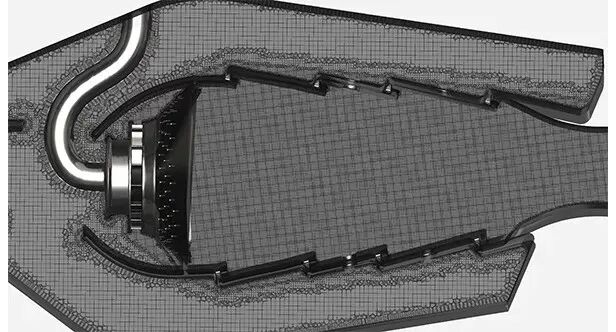
以Ansys官方这个燃气轮机燃烧室网格为例,旋流器、主燃区、掺混孔各区域的网格尺度都要单独规划。网格数量是这些细节共同决定的结果,不是一个总数。
2.2 网格质量决定迭代次数
网格还有另一个同样重要的作用:影响收敛速度。质量差的网格可能导致离散误差大、方程难解、残差下降缓慢、计算过程振荡,最后需要更多迭代才能达到收敛标准。
这时候就会出现一种情况:两个案例每次迭代都只要2秒,但一个需要500次,另一个要2000次。总时间分别是1000s和4000s,单次迭代速度完全一样,总时间却差了4倍。
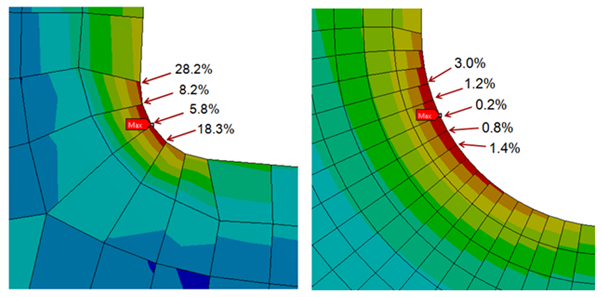
所以网格实际上同时影响两个方面:网格数量影响T_iter,网格质量影响N_iter。这也是为什么不能简单说"网格越少算得越快":为了减数量严重牺牲质量,收敛反而更难,得不偿失。
3. 物理模型因素
3. 物理模型因素
这一块最容易被忽略。假设两个模型都是100万网格,一个只算等温流动,另一个同时开湍流、能量、组分、辐射、多相流、DPM,计算成本显然不可能一样。
3.1 方程数量与复杂度
简单的流动问题主要解连续性方程和动量方程。打开湍流模型,要多解k方程和ε方程(或者k方程和ω方程);打开Energy,多一个能量方程;打开Species,再多一个或多个组分输运方程。方程数量增加,单次迭代的计算量就增加。
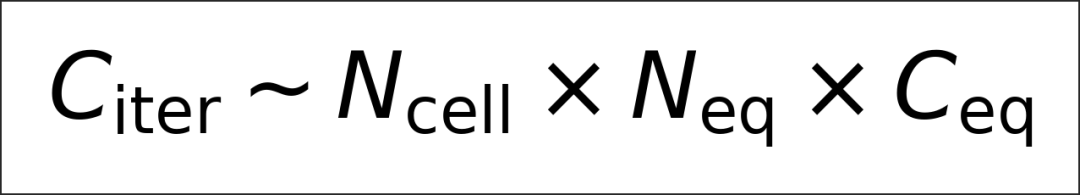
单次迭代成本C_iter近似由网格数量N_cell、方程数量N_eq和每个方程的复杂程度C_eq共同决定。
但要特别强调:计算时间不会严格按方程数量成比例增加。一个简单的输运方程,和一个带强非线性源项、复杂物性、强耦合关系的方程,成本可能差很远。所以选模型要按需来,不该开的模型别开。
3.2 模型耦合还会拖慢收敛
物理模型不只增加方程,还会让方程之间互相牵扯。典型的例子是自然对流:温度改变密度,密度产生浮力,浮力驱动速度,速度又反过来影响温度场。再加上组分传输、相变或者颗粒过程,耦合关系会更复杂。
所以一个复杂物理模型可能同时干两件事:让T_iter变大,也让N_iter变大。同样的网格数量,完全不等于同样的计算量。
4. 源项、UDF与物性
4. 源项、UDF与物性
4.1 UDF与源项
一个常数源项S=C,计算量小到可以忽略。但如果源项是S=f(T,Yi,k,ε,p,...),内部还带大量指数、对数、积分、插值、循环或者复杂判断,成本就完全不同了。
尤其要注意的是调用次数。500万网格的模型,如果UDF需要在每个单元上执行,那每次迭代就是几百万次相关运算;再乘以几百上千次迭代,累积起来的时间就非常可观了。
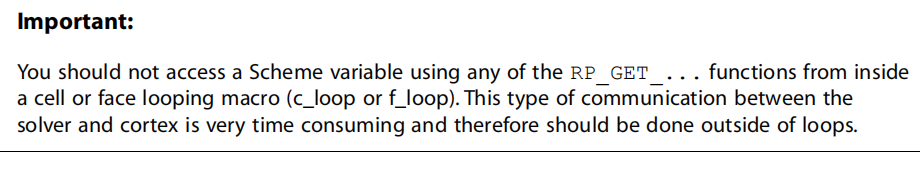
所以UDF决定"算什么",也可能决定"每次要算多少"。写UDF的时候,循环体内的每一行代码都会被放大几百万倍,能省则省。尤其尽量不要在begin_c_loop语句内再套循环语句,不然计算量会爆炸。
也这是这个原因,UDF手册中专门提了一句
4.2 物性模型
物性是同一个道理。密度当常数处理,计算很简单;但如果是ρ=f(T,p,Yi),求解过程中就要随温度、压力、组分的变化不断更新物性。
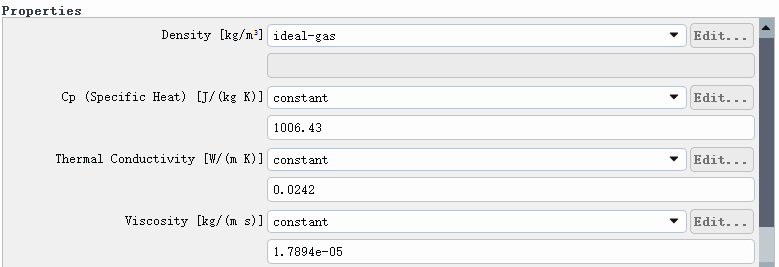
复杂物性、复杂源项和UDF都会增加单次迭代耗时,而且它们还会改变方程的非线性程度和耦合关系,反过来影响收敛速度。这一类因素,同样可能同时把T_iter和N_iter都抬上去。
5. 界面显示与监控输出
5. 界面显示与监控输出
还有一个经常被忽略因素--图形界面
残差曲线每刷新一次,就是把最新的数据画进图形窗口;云图、矢量图、动画的自动更新也一样。渲染占的是CPU(有些还占GPU),花在这上面的时间完全不参与求解。案例小的时候这部分占比不大,但大模型单次迭代本来就快不了,再每步刷一次图,白白搭进去的时间就很实在了。
5.1 图形显示
不看的窗口直接关掉,只留一个残差图足够。 残差曲线的更新间隔拉大,比如改成每50或100次迭代刷新一次,对盯收敛趋势没有任何影响。 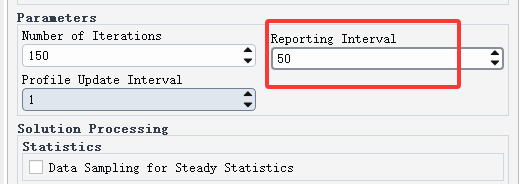
瞬态计算的动画、云图自动输出别每个时间步都来一份,按需设间隔。
5.2 Console打印与报告定义
Console每迭代打印一遍残差,其实是把字符写到控制台再滚动重绘,属于纯I/O开销;Windows下控制台滚过几万行,重绘和缓冲占掉的内存和时间都会往上走。同时写Transcript文件也是I/O。
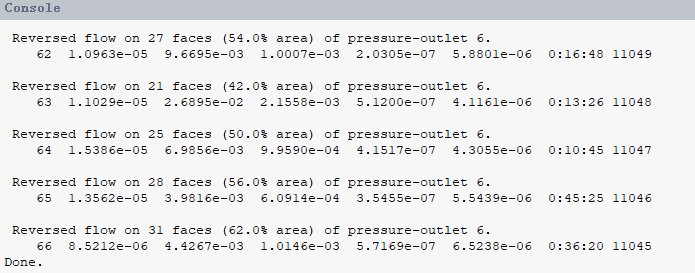
报告定义和surface monitor每个迭代都要对指定面或体积做一遍积分统计。monitor挂得越多,T_iter涨得越明显,而这些量往往一个迭代看一次就够。
所以批量跑算例可以journal脚本加后台运行,Fluent可以不开图形界面,GUI本身就占内存还拖速度;监控输出间隔拉大,用不到的monitor删干净。日常调试开着残差图没问题,正式跑长算例前把它们收拾干净就行。
6. 数值方法与求解设置
6. 数值方法与求解设置
Fluent里很多数值设置都影响效率:压力-速度耦合方法、梯度计算、对流项离散格式、压力离散格式、松弛因子等。
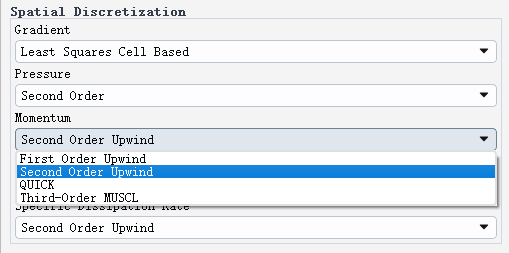
6.1 离散格式的取舍
拿一阶和二阶格式来说。高阶格式单次迭代的计算量更大,T_iter会上升;但它的精度和收敛特性往往更好,N_iter反而可能降下来。
所以不能简单说二阶格式一定比一阶格式慢,真正该比的是总时间:单次迭代耗时乘以迭代次数。
6.2 压力-速度耦合与松弛因子
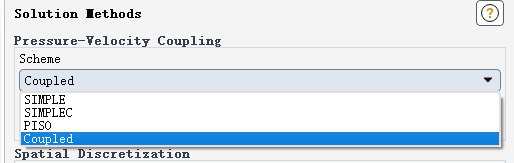
压力-速度耦合方法也一样:不同方法的计算方式、内存需求和收敛特性都不同,稳态和瞬态问题的效率表现也可能不一样,要根据问题类型选。
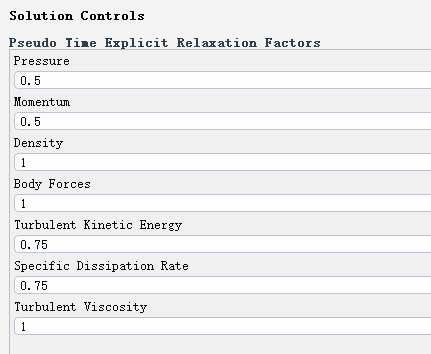
松弛因子就更典型了:设大了振荡甚至发散,设小了收敛极慢。它主要影响N_iter,但有些设置也会改变单次迭代的成本。
7. 初始条件、边界条件与时间步长
7. 初始条件、边界条件与时间步长
如果模型A每次迭代1秒但要5000次,总时间5000s;模型B每次迭代2秒只要500次,总时间1000s。B单步更慢,总时间反而短。迭代次数本身就是影响计算时间的核心因素。
7.1 初始化与边界条件
合理的初始化能让初始场更接近最终解,直接减少达到收敛所需的迭代次数,这一步花两分钟,后面可能省两小时。关于初始化可以参考文章:一文说清楚Fluent初始化操作(标准+混合初始化+Patch+UDF)
边界条件同样重要。边界之间不协调,计算就会振荡甚至难以收敛,迭代次数直接失控。
7.2 时间步长是瞬态计算的大头
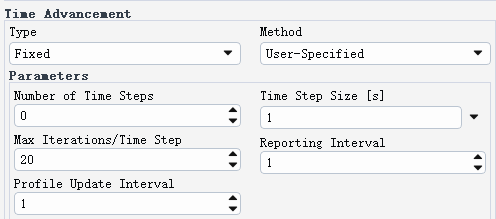
瞬态计算还要多乘一个维度。模拟100s的物理过程:Δt取0.01s需要10000个时间步;Δt取0.001s需要100000个时间步。哪怕每个时间步的迭代次数完全一样,总计算量也差10倍。所以瞬态计算的总时间要把公式再扩一层:
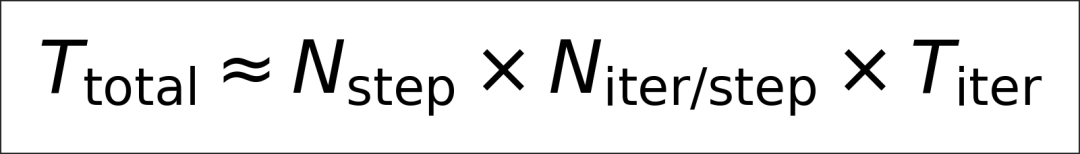
T_total由时间步数N_step、每步迭代次数N_iter/step和单步耗时T_iter共同决定。时间步长不能为了追求速度随意放大,它受流动时间尺度、CFL条件和需要解析的物理现象约束。
8. 算得慢,到底先查什么
8. 算得慢,到底先查什么
把前面的内容进行总结,所有因素最后都落到两个问题上:
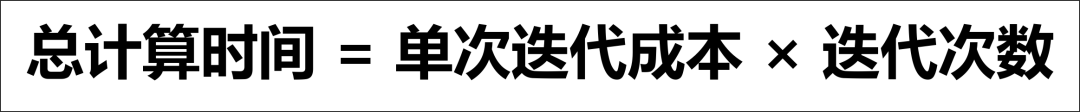
一次迭代为什么慢,主要受计算机、网格数量、方程数量、物理模型、UDF/源项、物性、数值求解过程和界面监控输出影响;
为什么需要这么多次迭代,主要受网格质量、物理模型耦合、初始条件、边界条件、数值格式、松弛因子和时间步长影响。有些因素两头都占,比如复杂物理模型既增加单步计算量,又加深耦合拖慢收敛。
以后遇到一个Fluent案例算得明显偏慢,按下面的顺序排查:
先看单次迭代耗时。一次迭代就很慢,重点查CPU、内存、并行设置、网格数量、方程数量、物理模型、UDF、源项和物性模型,再看一眼图形更新和Console输出是不是太勤。
单次迭代不慢但要几千次才收敛,重点查网格质量、初始化、边界条件、松弛因子、离散格式、压力-速度耦合和模型耦合程度。
瞬态计算再加一条:时间步长、时间步数量、每个时间步的迭代次数。
算得慢有时候真正的问题根本不在电脑,可能是网格质量导致收敛困难,可能是加了一个复杂的UDF,甚至可能只是时间步设得太小。