
首页/文章/ 详情

EESD 开源论文推荐 | 基于物理约束仅编码器Transformer的结构滞回预测与动力分析
46分钟前浏览0

0  引言

EESD正在积极推动科研数据与代码开放。对于数据驱动研究,论文不仅要说明“结果是什么”,还应让读者能够检查数据、理解方法,并进一步验证和复用研究成果。

近期,EESD发表了一项利用物理约束的Transformer预测结构滞回行为的研究。作者同时公开了模型代码、预训练模型及配套数据,值得向大家推荐。
 

论文题名:Physics-Based Encoder-Only Transformer for Structural Hysteresis Prediction and Dynamic Analysis

作者:Jongha Joo、Jaehwan Jeon、Junho Song。

论文链接:https://doi.org/10.1002/eqe.70298


1  这篇论文研究了什么?

结构在地震作用下反复变形时,恢复力不仅取决于当前位移,还与此前的加载历史有关。如何准确描述这种“记忆效应”,是结构非线性分析中的重要问题。传统滞回模型通常需要人工选择模型形式、标定参数,面对不同滞回特征时仍有局限。

论文提出物理约束的仅编码器Transformer模型PET,利用自注意力机制学习位移历史与恢复力之间的关系,并引入基于Drucker公设的能量约束和局部刚度一致性约束,使模型在有限数据条件下兼顾预测精度与物理合理性。

研究分别在六类解析滞回模型上进行训练和测试,并利用防屈曲支撑框架混合试验中的支撑轴向滞回数据进行验证。训练后的PET还被嵌入到数值动力分析中,逐步提供恢复力预测。
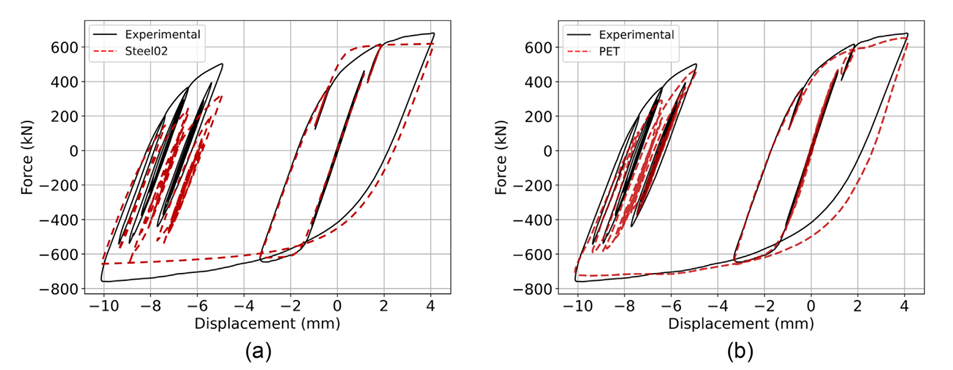
 

Steel02模型与PET模型对试验恢复力的预测对比。来源:原论文图12。


2  数据与代码公开

论文的数据可用性声明给出了配套GitHub仓库,其中可以获取:

(1)模型实现与运行说明:PET模型源代码、预训练与微调、测试和动力分析流程,以及README和依赖说明。

(2)数值滞回响应数据:当前仓库包含双线性、Bouc–Wen、BWBN、IMK和Ramberg–Osgood五类模型的预生成响应数据,并提供相应的预处理代码。

(3)预训练模型与实验测试资源:除数值模型的预训练权重外,还包括AYB支撑实验应用的预训练权重、处理后的实验测试数据及测试入口,便于读者进一步检验模型性能。

数据与代码:https://github.com/JonghaJoo/PET


3  通讯作者简介

本文通讯作者Junho Song教授,任职于韩国首尔大学土木、城市与环境工程系,并担任Structural Safety期刊主编,同时为Member of National Academy of Engineering of Korea (NAEK)。

他长期从事结构与系统可靠度、地震工程与随机振动、城市基础设施风险与韧性研究,并探索统计与机器学习方法在不确定性分析中的应用。
 

Junho Song教授。照片来源:其课题组官方主页。

人物简介来源:https://systemreliability.wordpress.com/junhosong


4  EESD为什么持续倡导开放与可重复性?

将数据、代码和模型整理为可获取、可理解、可使用的资源,有助于研究者检查方法的适用范围,并在共同的数据基础上开展公平比较。

按照EESD的数据驱动论文政策,最低要求是开放测试/验证数据,并提供能够复现关键结果的可运行实现;期刊进一步鼓励公开训练数据、完整源代码和必要文档,并要求通过带DOI的可靠仓库保障长期访问。

EESD欢迎高质量的地震工程与结构动力学研究,也期待更多作者共同推动开放、透明、可重复的学术实践。

延伸阅读|EESD数据驱动论文政策:https://onlinelibrary.wiley.com/pb-assets/assets/10969845/EESD-AI-Policy-Final-1769749073093.pdf

来源:陆新征课题组
System振动非线性化学建筑消防BIM理论Opensees材料科普数字孪生控制试验
著作权归作者所有,欢迎分享,未经许可,不得转载
首次发布时间:2026-10-15
最近编辑:46分钟前
地震那些事
博士 抗震防灾数值模拟仿真
获赞 84粉丝 73文章 678课程 0
点赞
收藏
作者推荐

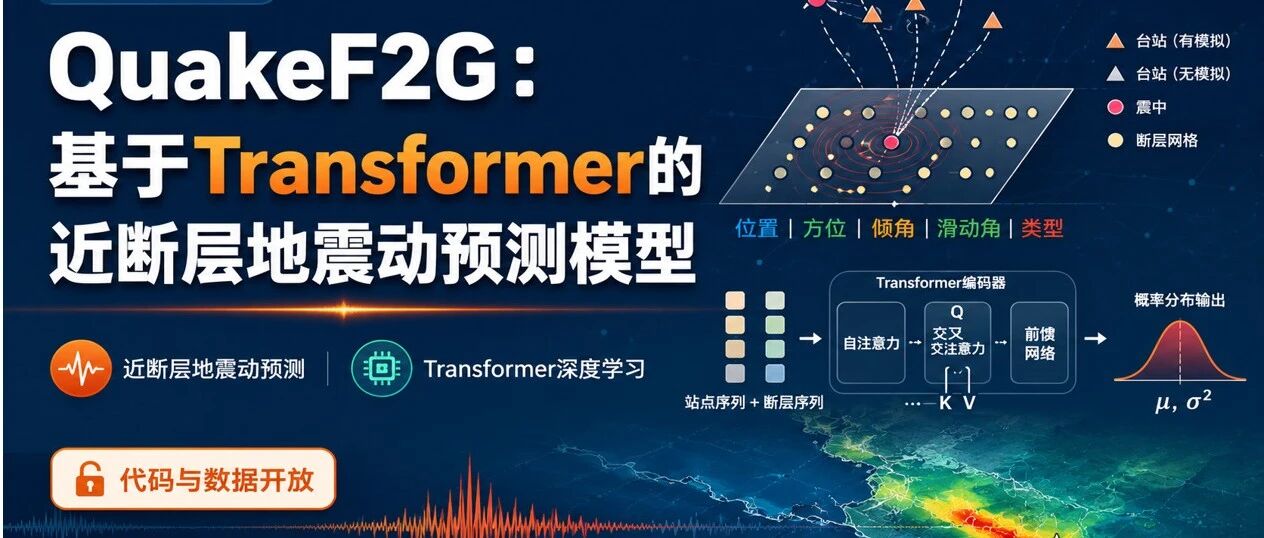
“拆成Token”交给Transformer|新开源论文:QuakeF2G近断层地震动预测模型

https://doi.org/10.1016/j.cacaie.2026.1001830 太长不看版近断层地震动预测有一个很现实的矛盾:越靠近断层,破裂方向、有限断层几何和盆地效应越重要;但越精细地描述这些物理过程,计算成本通常也越高。为此,我们提出 QuakeF2G:在此前 QuakeFormer 的基础上,不再把大地震简单表示为一个“点”,而是把有限断层离散成一组 fault-segment tokens,再通过 Transformer 的自注意力和交叉注意力机制,将断层几何、震源信息、场地条件以及可选的站点观测统一融合,用于概率型 PGV 预测。模型基于南加州 CyberShake 约 62.6 万个地震场景训练。研究表明:显式引入有限断层几何后,相比点源方法,测试集 RMSE 降低约 36%;在空间插值实验中,QuakeF2G 也优于 Ordinary Kriging。此外,本研究的论文为开放获取,代码公开。文末附代码、数据和论文链接,便于进一步检查、复现和扩展。 图1 CyberShake 数据集中的站点、断层与数据分布(原文 Fig. 1)1 为什么近断层地震动特别难预测?远离断层时,很多地震动指标可以在一定程度上用“震级 + 距离 + 场地条件”来描述。但到了近断层区域,问题会明显复杂起来。破裂从震源点向外传播时,不同断层段释放的能量可能在某些方向上叠加,形成显著的破裂方向性(rupture directivity);同时,盆地结构、传播路径和场地条件还会进一步改变地震动空间分布。传统经验型地震动模型(GMPE/GMM)计算很快,但通常需要用有限数量的参数概括断层几何;物理波动传播模拟可以更直接地描述三维速度结构和破裂过程,但计算和存储成本很高。因此,这项研究希望回答的问题是:能否把高保真物理模拟中学到的区域规律压缩到一个轻量模型中,同时把有限断层几何特征显式地保留下来?2 核心思路:把有限断层变成 Transformer 能处理的 TokenQuakeF2G 的关键变化,是不再把震源只压缩为震中位置和震级,而是把复杂断层离散为一组长度可变的 token。每个断层段携带位置(纬度、经度、深度)、方向(走向、倾角、滑动角)和类别等信息;震源点则作为一个特殊 token,帮助模型识别破裂起始位置。这些 fault-segment tokens 首先进入专门的 Fault Encoder,通过多尺度位置编码、RoPE 和自注意力学习断层内部的空间关系。随后,Fault Encoder 输出的断层表示与站点—震源序列在 Main Encoder 中通过 cross-attention 融合。 图2 QuakeF2G 模型架构:Fault Encoder + geometry-aware cross-attention(原文 Fig. 2)这里还有一个很重要的细节:对于每一个“断层段—站点”组合,模型预先计算断层段到站点的距离以及沿走向方位角,并把这些几何量转化为 cross-attention 的可学习偏置。也就是说,模型不仅知道“有哪些断层段”,还显式知道“这个断层段相对这个站点在哪里”。最终,模型输出的不是一个单一 PGV 数值,而是每个站点 ln(PGV) 的概率分布参数,从而可以用于概率地震危险性分析。3 同一个框架,适配四种不同精细程度的震源信息论文没有假设任何时候都能立刻得到完整的有限断层模型,而是设计了四种逐步复杂的震源表示。这个设计很贴近真实的震后信息获取过程:越早得到的信息越简单,随着时间推移,震源机制和有限断层几何才会逐步完善。Point Source(PS)只使用震源位置和震级;PS + Focal Mechanism(PS+FM)进一步加入走向、倾角和滑动角;Line Source(LS)用线段近似破裂范围;Plane Source(PL)则把断层离散为三维断层段,可以表达更复杂、非平面或多段断层几何。 图3 四种不同精细程度的震源表示:PS、PS+FM、LS 和 PL(原文 Fig. 3)4 有限断层几何信息确实可以提升精度消融实验给出了一个很清晰的结果。对于 rupture distance ≤ 100 km 的测试数据,点源模型 PS 的总 RMSE 为 0.379;加入震源机制后降至 0.359;使用 Line Source 后进一步降至 0.246;完整 Plane Source 为 0.243。也就是说,从点源到有限断层表示后,RMSE 总体降低约 36%。 图4 不同震源表示对两个 CyberShake 场景预测结果的影响(原文 Fig. 4)因此,把有限断层及其与站点的几何关系显式加入模型,比简单点源表示更有效;至于更细致的断层面表达能够带来多大进一步收益,还需要更丰富的破裂运动学数据来验证。5 2019 Ridgecrest Mw 7.1 地震案例论文进一步将 QuakeF2G 应用于 2019 年 Mw 7.1 Ridgecrest 地震。对比了 QuakeF2G 的 Point Source、Plane Source 与 ASK14、ASK14+BS13 等经验模型。 图5 2019 Mw 7.1 Ridgecrest 地震的预测与残差对比(原文 Fig. 10)在本文采用的台站和对比设置下,QuakeF2G 的 PS 和 PL 残差箱线图中位数更接近零、离散程度也更小;同时,加入有限断层信息后的 PL 相比 PS 进一步改善。这说明在这个真实地震案例中,显式考虑断层几何对地震动空间预测是有帮助的。6 不仅可以预测,还可以做 PSHA 和空间插值QuakeF2G 的另一个特点,是同一套 masked Transformer 思路可以在不同信息条件下工作。没有站点观测时,它是纯预测模型;如果部分站点已有 PGV 观测或模拟结果,这些信息可以作为可见 token 输入,模型对其余站点进行条件预测。在 PSHA 示例中,论文在 NVIDIA RTX 6000 GPU 上计算一条 hazard curve 的时间约为 32 min,而 CyberShake 模拟流程对应的计算时间约为 1592 h。神经网络训练完成后,可以把大规模模拟数据库中的区域规律转化为快速重复调用的代理模型。空间插值实验也很有意思:当 QuakeF2G 只使用 50% 的训练站点时,RMSE 约为 0.05;Ordinary Kriging 即使使用 100% 的训练站点,RMSE 仍约为 0.08。论文在所测试的 10%、50% 和 100% 采样密度下,QuakeF2G在相同的测试台站中均取得更低的 RMSE。 图6 QuakeF2G 与 Ordinary Kriging 的空间插值 RMSE 对比(原文 Fig. 12)来源:陆新征课题组

未登录
还没有评论
课程
培训
服务
行家
VIP会员 学习计划 福利任务
下载APP
联系我们
帮助与反馈