首页/文章/ 详情

面向安全关键工程系统的可信智能体 AI 框架:可审计的无故障标签机械故障诊断(下)
42分钟前浏览0

    接上篇(故障诊断大模型 | 面向安全关键工程系统的可信智能体 AI 框架:可审计的无故障标签机械故障诊断(上)),论文提出了一种由感知、诊断与验证三个智能体协作的可信诊断框架。系统仅利用正常工况数据和轴承几何参数,通过调用物理分析工具,在无需故障类别标签的条件下开展诊断,并记录谐波、频率偏差与边带等关键证据。论文将可审计推理、诊断纠错与组件失效后的规则回退纳入统一流程,为智能体走向可靠的工业应用提供了值得关注的思路。下篇主要介绍实验和讨论,更多实验细节可查看论文附录链接。

    论文基本信息

    论文题目:

    A trustworthy agentic AI framework for auditable label-free machinery fault diagnosis in safety-critical engineering systems

    论文日期:2026(online)

    发表期刊:

    Advanced Engineering Informatics 77 (2027), 105205

    论文链接:

    https://doi.org/10.1016/j.aei.2026.105205

    作者:

    Yuntong Chen,Binhao Liu,Yingqi Li,Ziang Wang,Liping Ma,Jianyu Liu,Xitian Tian,Lijiang Huang(∗)

    作者单位:

    School of Mechanical Engineering, Northwestern Polytechnical University, Xi’an, Shaanxi 710072, China.

    目录

    摘要

    符号与缩略语

    1 引言

    2 相关工作

    2.1 轴承故障诊断的深度学习方法

    2.2 基于大语言模型的轴承故障诊断

    2.3 工程信息学中的多智能体大语言模型系统

    2.4 研究空白总结

    3 方法

    3.1 问题定义与框架概述

    3.1.1 问题定义

    3.1.2 框架架构

    3.2 基于自编码器的正常基线学习

    3.3 感知智能体:大语言模型自适应异常评估

    3.3.1 动机

    3.3.2 多指标融合

    3.3.3 两级决策架构

    3.4 诊断智能体:基于物理的工具链推理

    3.4.1 设计理念

    3.4.2 三层工具架构

    3.4.3 推理过程

    3.4.4 跨域泛化

    3.5 验证智能体:证据一致性与反思纠正

    3.5.1 动机

    3.5.2 三步证据一致性协议

    3.5.3 反思纠正循环

    3.6 多智能体编排流程

    3.6.1 流程执行

    3.6.2 设计属性

    3.6.3 计算成本

    3.7 框架的可信性属性

    4 实验与结果

    4.1 实验设置

    4.2 域内评估

    4.3 消融研究

    4.4 感知智能体评估

    4.5 向未见目标数据集的无故障标签迁移

    4.6 诊断推理分析

    4.6.1 系统性审计记录评估

    4.6.2 案例一:标准正确诊断

    4.6.3 案例二:边带消歧

    4.6.4 包络谱证据可视化

    4.6.5 错误分析

    4.6.6 频率匹配容差分析

    4.6.7 轴承参数扰动分析

    4.7 与基于大语言模型的诊断方法比较

    5 结论

    4. 实验与结果

    4.1. 实验设置

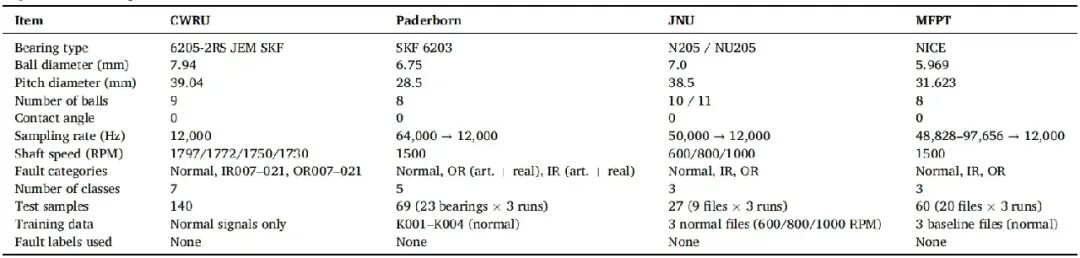
    为评估基于物理的多智能体诊断推理框架,我们在四个滚动轴承数据集上实验:CWRU [22] 为域内评估源域,Paderborn [47]、JNU、MFPT 为跨数据集无故障标签迁移的三个目标域。这些数据集在轴承几何、采集设备、故障生成机理及运行条件上显著不同,为域内准确率与跨域泛化提供严格测试环境。检测率对应可靠性工程中的检测概率(POD)。详细配置见表 2。

    实验环境:NVIDIA RTX 4090 GPU(24 GB)、AMD Ryzen R7 9800X3D CPU(5.6 GHz)、64 GB 内存。框架采用 PyTorch 2.1 实现。

    CWRU 数据集来自电机驱动机械系统,使用电火花加工(EDM)在内外圈引入三种尺寸的单点缺陷:0.007、0.014 和 0.021 英寸。使用驱动端加速度计的 12000 Hz 数据,覆盖 0–3 HP 四种电机负载,对应转速 1797、1772、1750、1730 RPM。每个 LLM 的测试量为 7 类 × 4 负载 × 5 个重复片段,共 140 个样本。

    Paderborn 提供更具挑战的场景,既有 EDM 和钻孔制造的人工缺陷,也有真实运行条件下加速寿命试验形成的故障。信号从 64000 Hz 重采样到 12000 Hz。四个健康轴承 K001–K004 仅用于自编码器训练;测试包含 23 个轴承、五类状态:健康 2 个、人工外圈故障 3 个、真实磨损外圈故障 7 个、人工内圈故障 3 个、真实磨损内圈故障 8 个。关键的是,训练或提示构建都不使用这两个数据集的任何带标签故障数据,自编码器仅学习正常信号。

    江南大学 JNU 数据集包含 600、800 和 1000 RPM 的变速工况,这是 CWRU 与 Paderborn 不具备的独特挑战。正常、外圈及滚珠故障使用 N205 轴承,      ;内圈故障使用 NU205,      。振动采样率 50000 Hz,重采样至 12000 Hz。每种转速取一个正常文件,共三个文件训练自编码器;在正常、内圈、外圈三类的九个文件上测试,每文件三个重复片段,共 27 个样本。

    MFPT 数据集由机械故障预防技术学会提供,使用以 1500 RPM 运行的 NICE 轴承。正常信号采样率为 97656 Hz,故障信号为 48828 Hz,均重采样到 12000 Hz。三个正常文件用于训练;20 个测试文件包括正常 3 个、内圈 7 个、外圈 10 个,每文件三个重复片段,共 60 个样本。MFPT 在轴承诊断文献中广泛使用,故障类别定义明确。

    为考察模型通用性,我们评估三个先进 LLM 作为推理骨干:阿里巴巴 Qwen-Plus、OpenAI GPT-4.1 和 Anthropic Claude Sonnet 4.6。

    监督基线在 CWRU 全部七类故障标签上训练,包括 1D-CNN、ResNet-1D、WDCNN [10](使用宽首层卷积核抑制噪声)、1D-Transformer(patch 嵌入与四层编码器),以及具有梯度反转的域对抗神经网络 DANN [48]。前四个模型使用全部四种负载,按标准监督学习训练 50 个 epoch,采用 Adam,学习率 0.001、权重衰减       、余弦退火调度。DANN 额外接收各目标域无标签振动信号,进行 100 个 epoch 域对抗训练;       按标准公式        调度,域损失权重为 0.5。

    为减轻不同试验台幅值尺度造成的域偏移,所有五个基线在训练和推理、源域和目标域均统一使用逐样本 z 分数归一化。五个模型在 CWRU 上都达到近乎完美的准确率(至少 99%),然后不重训,直接用于目标域。该设计确保基线失败反映真实域偏移坍缩,而非训练不足。

    表 2  实验配置
     

    4.2. 域内评估

    首先使用三个 LLM 在 CWRU 上评估完整系统。各模型处理完全相同的输入,包括自编码器输出、工具实现及提示模板,唯一区别是推理骨干。结果见表 3。

    三种 LLM 在五次独立运行中的平均总体准确率均超过 92%,表明框架在不同推理骨干间具有良好通用性。Qwen-Plus 最高,为       ;GPT-4.1 为       ;Claude Sonnet 4.6 为       。模型间仅相差 2.7 个百分点,运行间标准差不超过 1.2 个百分点,共同表明性能主要由物理工具链、感知机制和验证协议等架构决定,而非特定 LLM 或随机推理路径。

    每个值为在相同 140 样本上独立运行五次的均值 ± 标准差,温度为 0。较小的总体标准差(0.6–1.2 个百分点)说明诊断输出稳定。类别方差集中在 OR014,三个 LLM 的标准差均为 3.5 个百分点,与 4.6.5 节 BPFO/BPFI 谐波混叠分析一致:推理路径恰在谐波数相同的边界样本上略有变化。

    表 3 CWRU 上多 LLM 诊断准确率(%,      )

     

    三模型有一致规律。IR014 和 OR021 达到完全或近乎完全准确,IR014 均为       ,说明中大尺寸故障产生强且无歧义的谱特征,不依赖后端即可可靠识别。OR014 最困难,三者平均准确率分别为 85.0%、75.0%、75.0%,标准差却完全相同(3.5 个百分点),说明困难来自确定性的物理原因,即该故障尺寸下谐波重叠,而非随机 LLM 行为。按第 4.6 节分析,0.014 英寸故障下 BPFO 高阶与 BPFI 低阶谐波重叠,是 CWRU 6205 轴承的基本几何性质,而非框架局限。

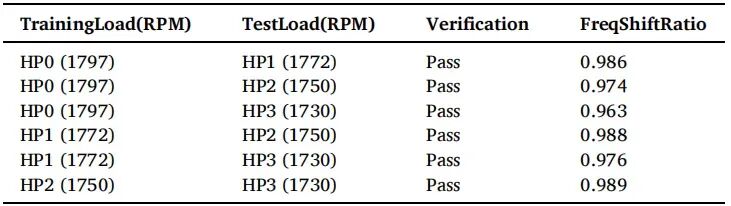
    物理推理的根本优势是特征频率随轴转速线性缩放。我们用四个 CWRU 负载的全部六个两两组合验证(表 4)。对每一对,系统先在第一转速诊断,根据转速比预测特征频移,再验证第二转速包络谱中是否出现预测频率。六对均通过,观测频移比与理论转速比误差不超过 0.3%,确认框架依据物理原理而非模式记忆。

    跨模型结果也间接支持提示鲁棒性。三个后端的预训练语料、指令遵循及推理策略差异显著,却处理相同提示模板;仅 2.7 个百分点的范围,说明能力主要由结构化物理工具链而非提示措辞细节决定。提示指导工具选择和解释,FFT、包络解调及谐波匹配等数值结果不依赖提示措辞。

    表 4 跨工况验证(六对)
     

    4.3. 消融研究

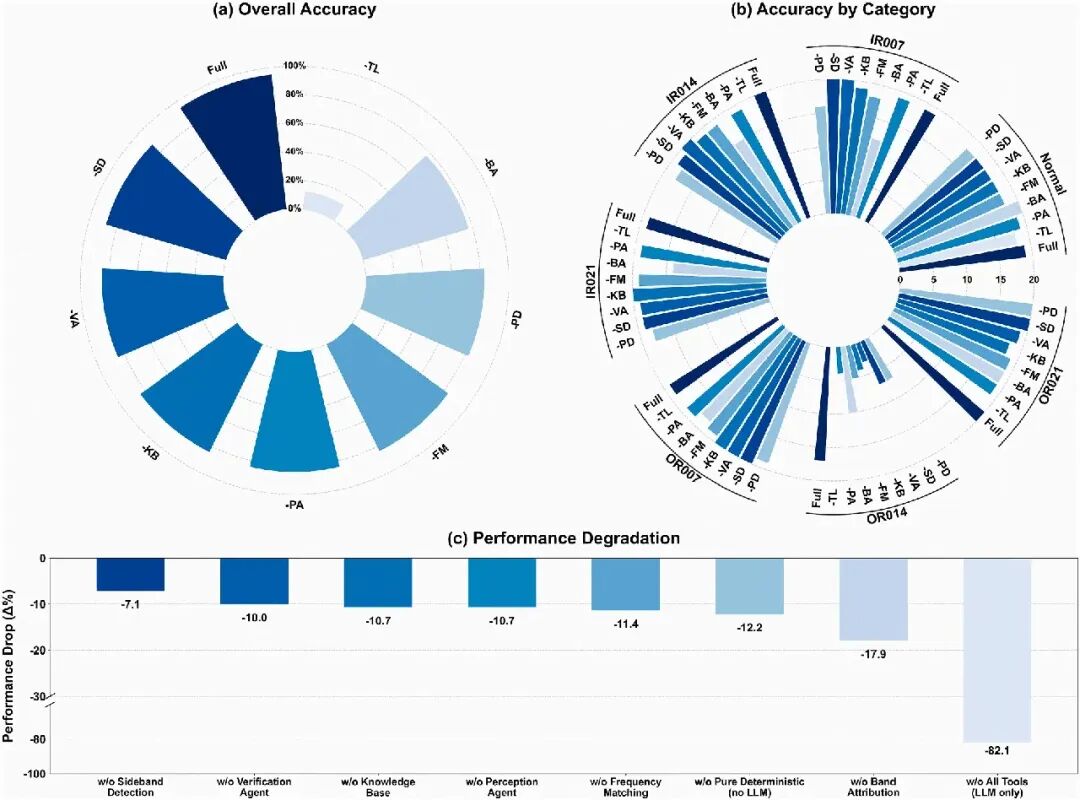
    使用 Qwen-Plus 在 CWRU(      )上进行系统消融,沿两个正交方向组织。第一方向比较完整系统与“纯确定性”流程,隔离 LLM 编排的总体贡献。后者采用完全相同的物理工具,但将所有 LLM 决策替换为人工规则:按最大 z 分数选频带,按谐波数最大值分类,并内置 BSF/FTF 审慎规则及规则式边带消歧。第二方向移除各子组件,包括感知智能体、诊断智能体三个子模块及验证智能体两个子模块,定位贡献来源。另设移除全部工具、只保留 LLM 的合理性检查。结果见表 5 和图 4。

    表 5 消融研究
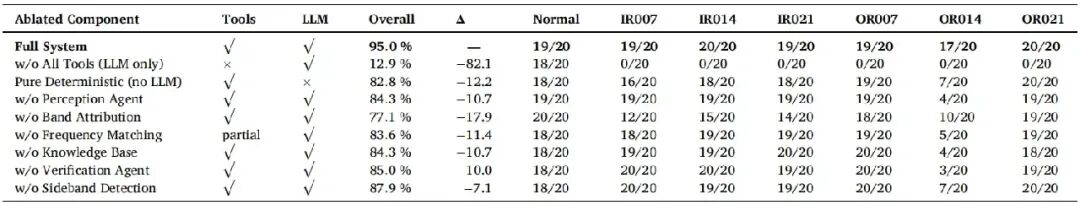


    图 4 CWRU 消融结果(Qwen-Plus,      ,一次代表性运行)。(a)各配置总体准确率;(b)七类故障的分类别准确率;(c)相较完整系统的性能下降(      )。缩写:TL,全部工具;BA,频带归因;PD,纯确定性;PA,感知智能体;FM,频率匹配;KB,知识库;VA,验证智能体;SD,边带检测。

    消融揭示三层发现。

    第一层:LLM 编排比相同工具的规则编排提高 12.2 个百分点。 完整系统 95.0% 减去纯确定性 82.8%,对应表 5 移除 LLM 后的       。纯确定性明显弱于完整系统,但远高于任何无工具配置,确立 LLM 的真实贡献:作为能够选取分析参数、化解歧义的上下文感知编排器,而不是特征提取器。

    第二层:提升集中在物理歧义样本。 对明显且占主导的故障特征类别(OR007、OR021、IR014),确定性流程已接近完美,达到每类 19–20/20,LLM 仅增加 0–2 个样本;OR014 则由 7/20 恢复到 17/20,提高 50 个百分点,贡献了整体差距的大部分。按 4.6.5 和图 8(c),OR014 恰好存在 BPFO 三倍频与 BPFI 二倍频在 0.7% 内重叠,导致人工最大值规则无法解决的谐波数近似并列。LLM 结合边带、感知频带指导及验证输出改善该类,这正是上下文推理区别于规则逻辑的多证据综合。

    第三层:各子模块均非冗余。 诊断子模块中频带归因影响最大,移除后下降 17.9 个百分点。没有感知频带指导,诊断智能体只能盲选参数,常选择不理想的包络谱带通范围。内圈类别影响最明显:IR007 为 12/20、IR014 为 15/20、IR021 为 14/20,因为冲击故障特征需要精确选择高频频带才能有效包络解调。验证智能体贡献 10.0 个百分点,其中边带检测单独贡献 7.1 个百分点。OR014 再次受影响最大,无验证时从 17/20 降为 3/20,确认边带消歧是 LLM 编排解决谐波混叠的主要机制。

    仅 LLM 的合理性检查为 12.9%:通过常识正确识别 18/20 个正常样本,但全部故障类别为 0%,证明仅靠文本描述不能完成振动诊断。此项排除“LLM 仅凭足够先验即可无计算支持分类”的简单假设;决定性消融仍是纯确定性对照,而非此检查。

    4.4. 感知智能体评估

    为验证 LLM 自适应异常感知(贡献 C2),在 Paderborn 比较三种感知配置。该跨域挑战要求在一种轴承(SKF 6203,K001–K004)上训练的自编码器 MSE 阈值,泛化到运行特征不同的测试轴承。

    配置 A:固定 MSE。 当 MSE 比值大于 1.0,即重构误差超过正常基线的       ,触发异常,代表标准自编码器异常检测。

    配置 B:固定 MSE + 峭度。 在 A 基础上加入规则:MSE 比值大于 1.0,或滤波峭度大于 20,即触发异常。峭度在 2000–10000 Hz 带通滤波信号上计算,以提取冲击故障内容并抑制低频旋转成分。

    配置 C:LLM 自适应。 完整系统由感知 LLM 综合 MSE 比值、频带 z 分数、峭度、峰值因子及跨域上下文,进行自适应异常评估,即本文方法。总体与分类别结果见表 6。

    表 6 感知智能体配置比较(Paderborn,23 个轴承)。上表为总体指标,下表为分类别结果;Acc 为分类准确率,Det 为检测率,单位均为 %。
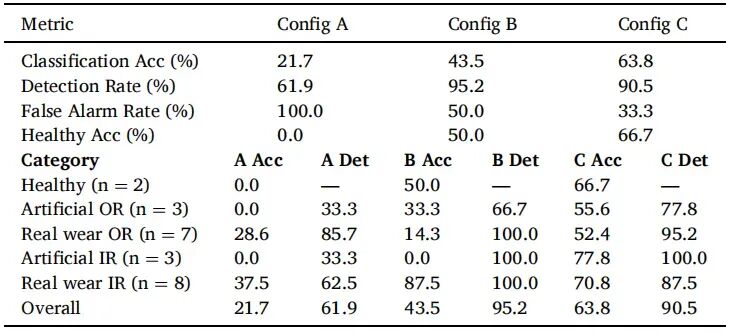
     

    结果呈现感知复杂度提升及其对下游诊断的影响。仅依赖 MSE 的 A 在跨域下严重退化:由于自编码器训练于不同轴承类型,大多数故障轴承的 MSE 比值低于 1.0,通常为 0.4–0.8 倍,使阈值不可靠。如图 5,Paderborn 健康与故障轴承的比值分布大量重叠,大多数故障位于阈值以下,与源域可获得的清晰分离形成对照。因此 A 检测率仅 61.9%,健康准确率为 0%;两健康轴承均误判,其中一个触发 MSE 阈值,而系统缺少推翻误报的上下文推理能力。

    B 引入反映冲击故障的物理指标峭度,将检测率提高至 95.2%。Paderborn 故障轴承滤波峭度范围为 7.27–301.87,多数超过 20。但激进检测牺牲特异性:B 分类准确率仅 43.5%,因为无法区分故障类型。峭度规则标记异常,却不指导分析频带,诊断智能体因而常把外圈判为内圈,真实磨损外圈准确率仅 14.3%。

    C 取得最佳总体平衡:分类准确率 63.8%、检测率 90.5%、误报率 33.3%。跨域感知使 LLM 认识 MSE 不可靠,主要依赖峭度与频带 z 分数,将 MSE 作为次要参考。C 可正确识别 66.7% 健康轴承,而 A 为 0%,同时保持高故障检出。B 与 C 检测率相差 4.7 个百分点,反映 C 更保守、更智能的阈值判断:并非高峭度一律报异常,而是综合其他指标评估是否真正意味着故障。
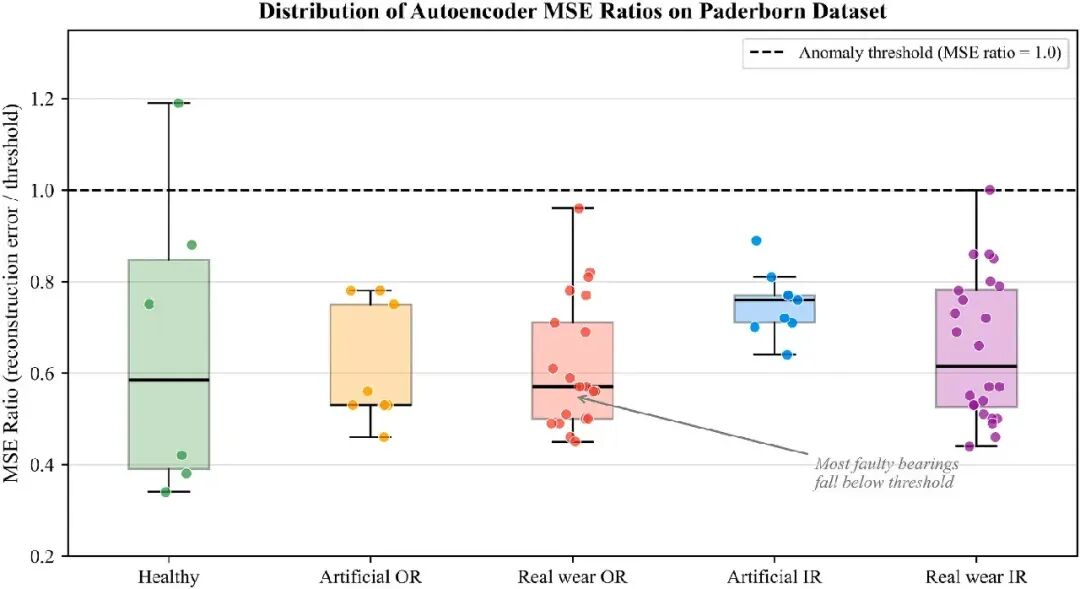
     

    图 5 Paderborn 各轴承类别的自编码器 MSE 比值分布。多数故障轴承比值低于异常阈值(1.0 处虚线),说明固定 MSE 阈值为何在跨域时失效。

    4.5. 向未见目标数据集的无故障标签迁移

    最严格评估是跨数据集无故障标签迁移。对 Paderborn、JNU、MFPT 各目标域,自编码器仅用该域正常信号重新训练;物理工具链、提示模板及所有智能体逻辑与 CWRU 完全相同,只更新轴承几何与转速。

    这一设置没有可直接比较的基线:表 1 的现有 LLM 方法在训练或微调中都需要故障标签,因此不适用。加入在 CWRU 全标签上训练、源域准确率近乎完美的五个监督基线,是为了展示域偏移坍缩的严重性与普遍性。DANN 还额外接收目标域无标签信号进行对抗训练,信息严格多于其他基线。结果见表 7 与图 6。

    表 7 三个目标域上的跨数据集无故障标签评估
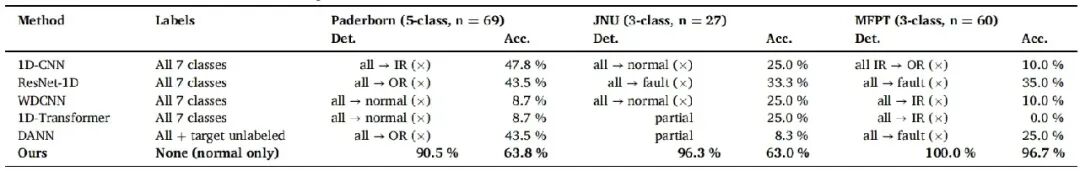
     

    注:全部基线逐样本 z 分数归一化,以减轻幅值尺度域偏移。DANN 额外接收无标签目标域信号,训练 100 个 epoch,余弦学习率调度、权重衰减       、域损失权重 0.5,信息严格多于其他基线。“全部 → X”表示坍缩为单一恒定类别、无判别能力;“部分”表示输出分散但无判别力;× 表示诊断坍缩。Paderborn 的 43.5%–47.8% 恰对应多数类比例(外圈 43.5%、内圈 47.8%),等同于始终预测多数类。JNU 的 25.0% 同样对应正常样本比例;DANN 的 8.3% 低于四个均衡类别的 25% 随机猜测水平,表明负迁移。全部监督模型在 CWRU 七类全标签上训练,测试按文件以 20 片段多数投票评估。
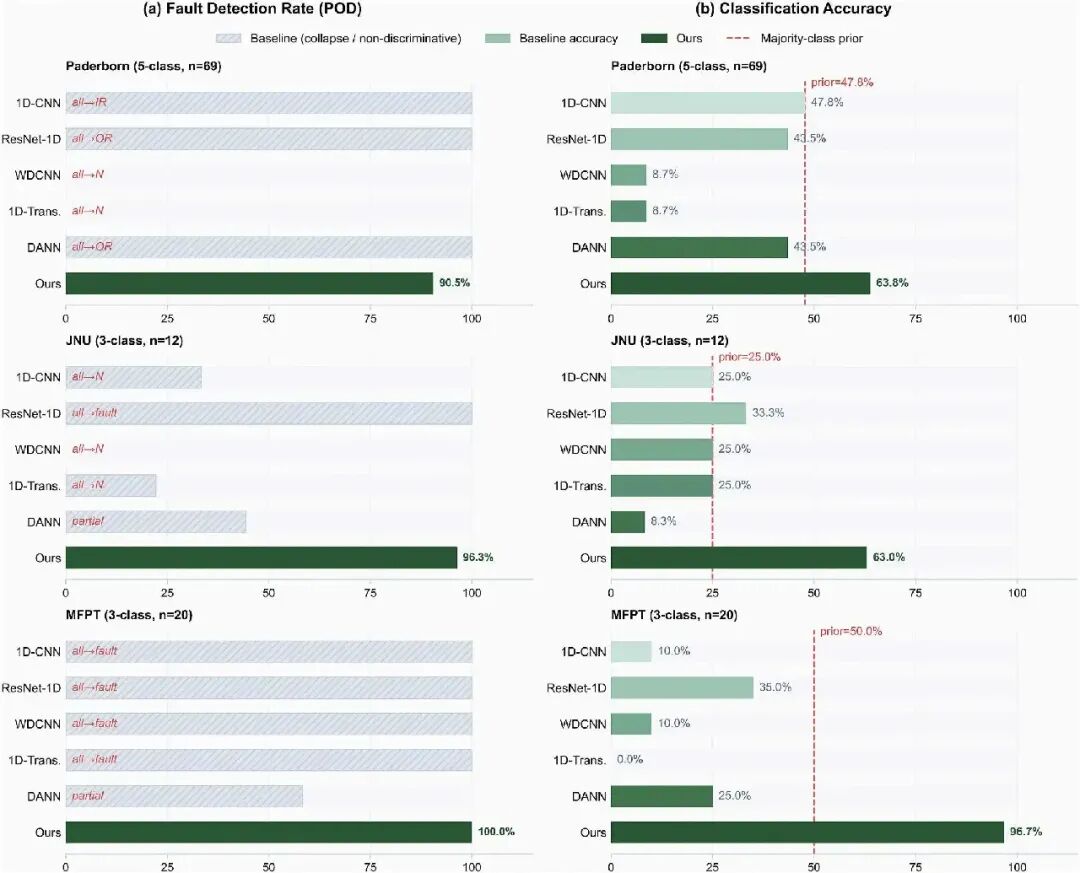
     

    图 6 三个目标数据集 Paderborn、JNU、MFPT 的跨数据集迁移评估。(a)故障检测率;(b)分类准确率。

    结果有三个发现。第一,无任何故障标注样本,框架在三个域上分别取得 90.5%、96.3%、100.0% 检测率,验证正确指定几何与转速即可迁移诊断能力。第二,五个监督基线,包括获得目标域无标签数据的 DANN,均无法泛化,表现为恒定类别坍缩,或分散但无判别力的输出。Paderborn 的表面准确率恰等于多数类比例,表明域内模式记忆无法跨越设备边界。第三,虽然分类准确率随频谱条件变化,MFPT 为 96.7%,JNU 为 63.0%——其低转速将故障谐波压缩至重叠频段——但检测率始终超过 90%,说明即使下游类型判别受限,多指标感知仍可靠识别异常。

    比较的公平性需要说明。DANN 用正常及故障混合的无标签目标域信号进行对抗特征对齐,信息严格多于只用正常信号的本文框架。尽管如此,DANN 在三域仍坍缩,准确率为 43.5%、8.3%、25.0%。这说明跨域失败并非目标数据不足,而是诊断知识编码于绑定源域分布的权重所导致的根本局限。本文用运动学方程、谐波匹配等物理公式编码知识,这些规则在设计上不随域偏移变化。

    结果还揭示超越准确率指标的结构性认识:轴承状态评估本质是具有非对称运行后果的两级决策。第一级故障检测回答“是否需要关注”,与安全直接相关;漏检可能造成非计划停机、连锁损坏或安全事故。第二级分类回答“哪个部件损坏”,用于维护规划;即使分类错误,也会触发检查,在拆解后发现真实状态,带来的是增量成本而非灾难性后果。本文在无故障标签条件下,以 90.5%–100.0% 检测率应对安全关键层级。

    Paderborn 与 JNU 分类准确率较低,与黑箱错误具有本质差别:每个诊断携带匹配谐波、理论偏差、边带结果等证据链,使工程师可独立评估歧义。分类不确定性由无声失败转化为可审计建议,适于保留人类专业判断的安全关键系统。

    与监督基线及 LLM 方法比较(4.3、4.7)还产生更广泛的架构启示:监督模型的知识编码于源域权重,分布不成立时知识不可访问;本文将知识编码于运动学方程、包络解调与谐波匹配等物理关系,避免这一问题。与监督 LLM 的参考比较显示,域内准确率与完全监督方法差距在 1.7 个百分点以内,大域差距下跨域检测更稳健。实际部署只需要正常数据、几何与转速,无需故障样本、重训或微调。

    4.6. 诊断推理分析

    4.6.1. 系统性审计记录评估

    为超越个案评估审计记录质量,我们分析全部 140 个 CWRU 测试样本的完整输出日志(Qwen-Plus,一次代表性运行),见表 8。

    表 8 审计记录完整性统计(CWRU,Qwen-Plus,      )
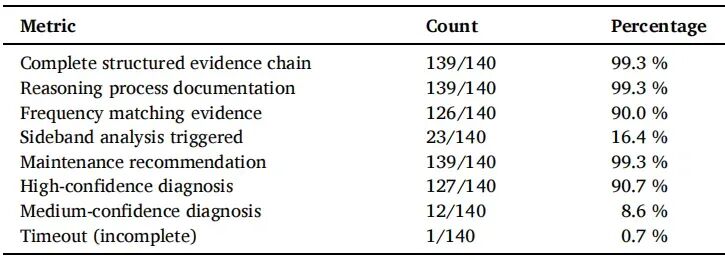
     

    结果证实,框架在完整测试集系统性生成可审计证据链。边带分析主要在内圈类触发:IR007 为 3/20、IR014 为 8/20、IR021 为 6/20,与内圈缺陷产生轴频幅值调制的机理一致。12 个中置信度诊断对应谐波证据模糊样本,为人工复核提供明确不确定性信号。唯一不完整样本为超时,说明即使失败也可追溯,而非无声发生。

    为深入展示推理,我们给出两个案例、物理证据包络谱可视化以及系统性错误模式分析。

    4.6.2. 案例 1:标准正确诊断

    考察 1797 RPM 的 OR007,即直接明确的外圈故障。感知智能体在 3500–4000 Hz 频带发现极端异常,z 分数大于 160 万,触发诊断。诊断智能体依次计算特征频率:BPFO 107.4 Hz、BPFI 162.2 Hz、轴频 29.95 Hz;对异常高频段计算包络谱;提取 15 个峰;执行确定性匹配。

    结果无歧义:BPFO 匹配五阶谐波,依次为 107.5、215.5、323.0、430.5、538.0 Hz,平均匹配误差 0.28%,单个误差 0.1%–0.36%,见图 8(a)。BPFI 和 BSF 各仅一阶匹配,FTF 为零。知识库确认至少五阶谐波表示第 3 阶段(进展期)外圈故障。整个诊断仅需六次工具调用,50.6 s 完成。

    此例体现物理推理范式:LLM 不直接处理原始振动,而是编排由几何频率计算、信号处理到确定性匹配的工具链,综合输出为连贯诊断。平均 0.28% 误差体现以计算工具而非模式识别支撑推理时的高精度。

    4.6.3. 案例 2:边带消歧

    考察 1797 RPM 的 IR007(图 7 右),存在谐波歧义。包络谱和匹配后,BPFI、BPFO、BSF 各有两阶谐波,单纯计数无法打破三方并列。LLM 没有默认选最常见故障,而是主动调用边带检测,识别 132.0 Hz(BPFI 减轴频)和 191.5 Hz(BPFI 加轴频)两处清晰边带,间隔恰与        对应。

    物理依据是内圈缺陷随轴旋转,每转一周通过承载区一次,使 BPFI 信号以轴频幅值调制,在        产生边带。原文将其描述为内圈故障特有、外圈及滚动体缺陷不具备的特征。框架识别并应用该原理,将模糊诊断提升为高置信内圈故障,展示超越简单频率匹配的推理。

    该案例直接对应表 5 移除边带检测下降 7.1 个百分点:若无此机制,涉及谐波歧义的 7.1% 样本将依赖默认启发式或随机机会,而非物理推理。
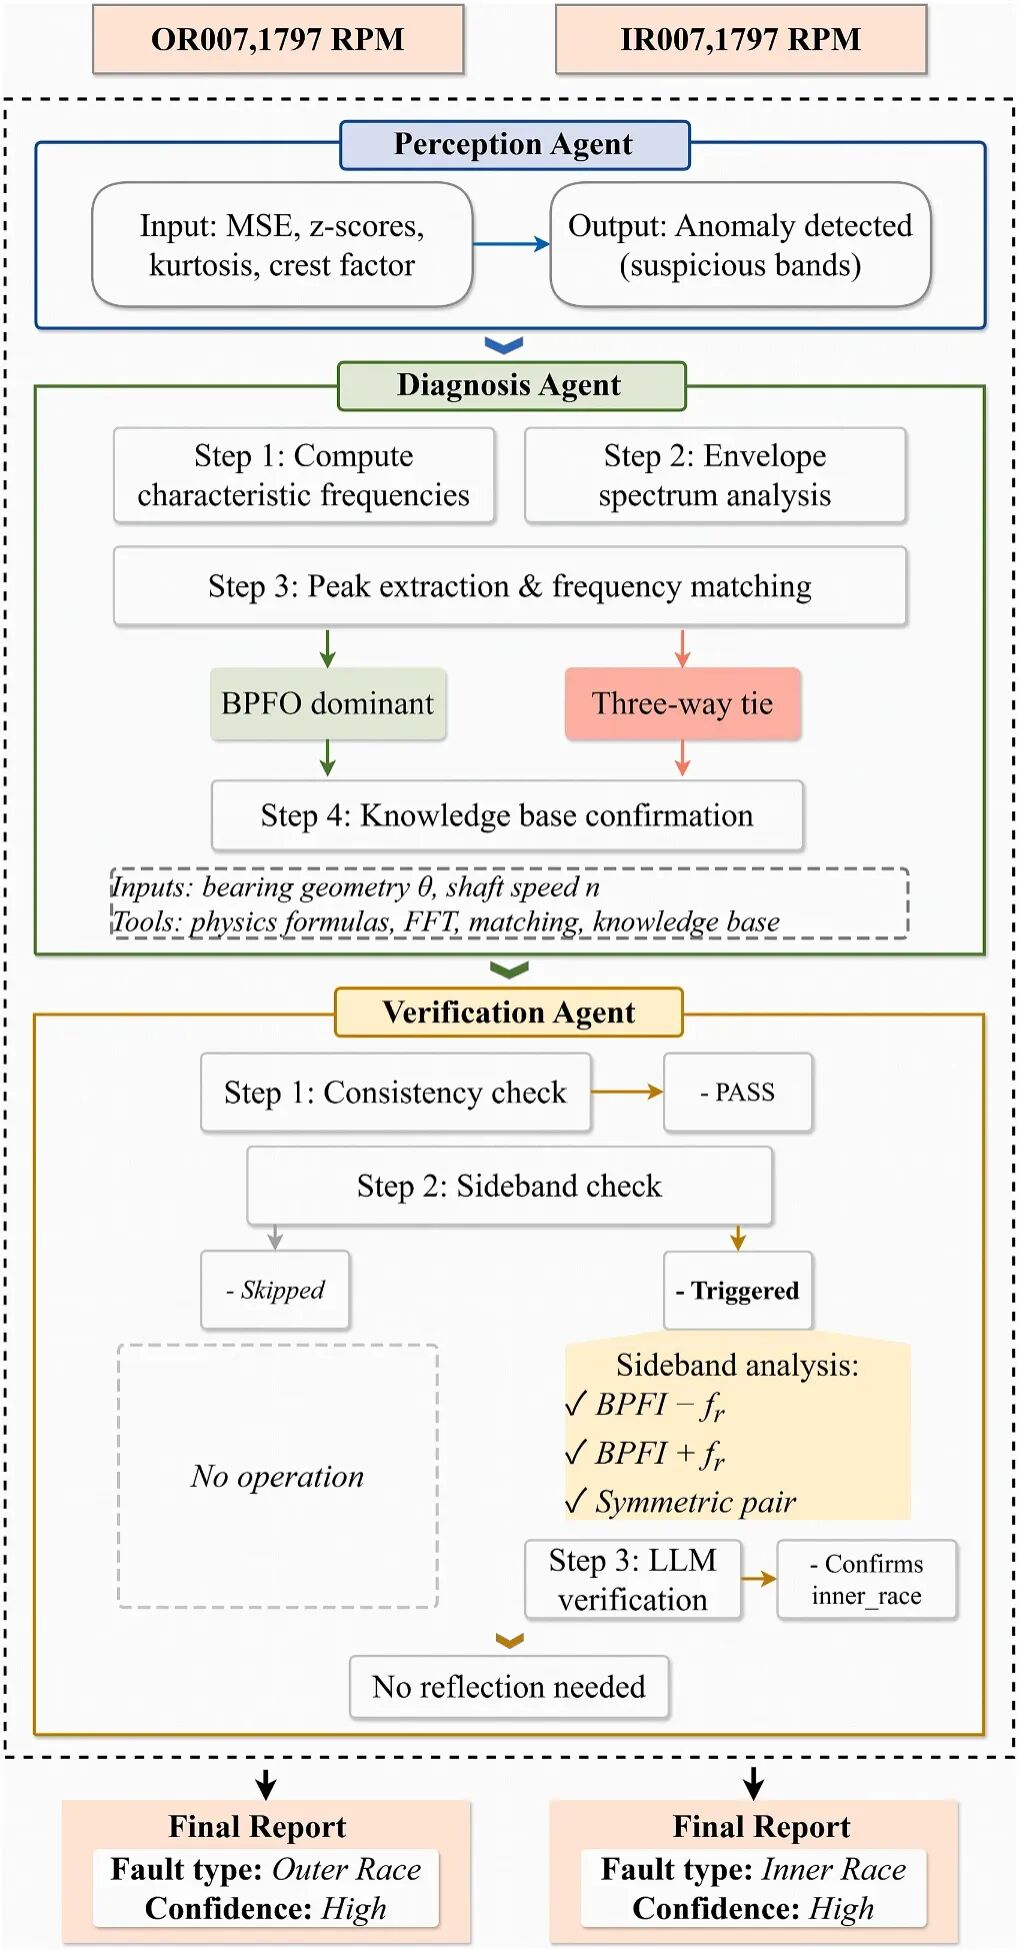
     

    图 7 1797 RPM 下两个代表性样本的诊断推理链:标准外圈故障 OR007(左);需边带消歧的模糊内圈故障 IR007(右)

    4.6.4. 包络谱证据可视化

    图 8 展示四个代表案例的包络谱。(a)(b)对应上述案例:OR007 有五阶 BPFO 谐波,匹配误差小于 0.4%,是明确外圈特征;IR007 有三阶 BPFI 谐波,并伴随 BPFI ± 轴频边带,确认旋转内圈缺陷的幅值调制。(c)揭示主要错误来源:OR014 的 BPFO 三倍频 322.1 Hz 与 BPFI 二倍频 324.4 Hz 仅相差 0.7%,引发 4.6.5 节的系统性误分类。(d)健康轴承没有占主导的故障谐波,作为基线参考。
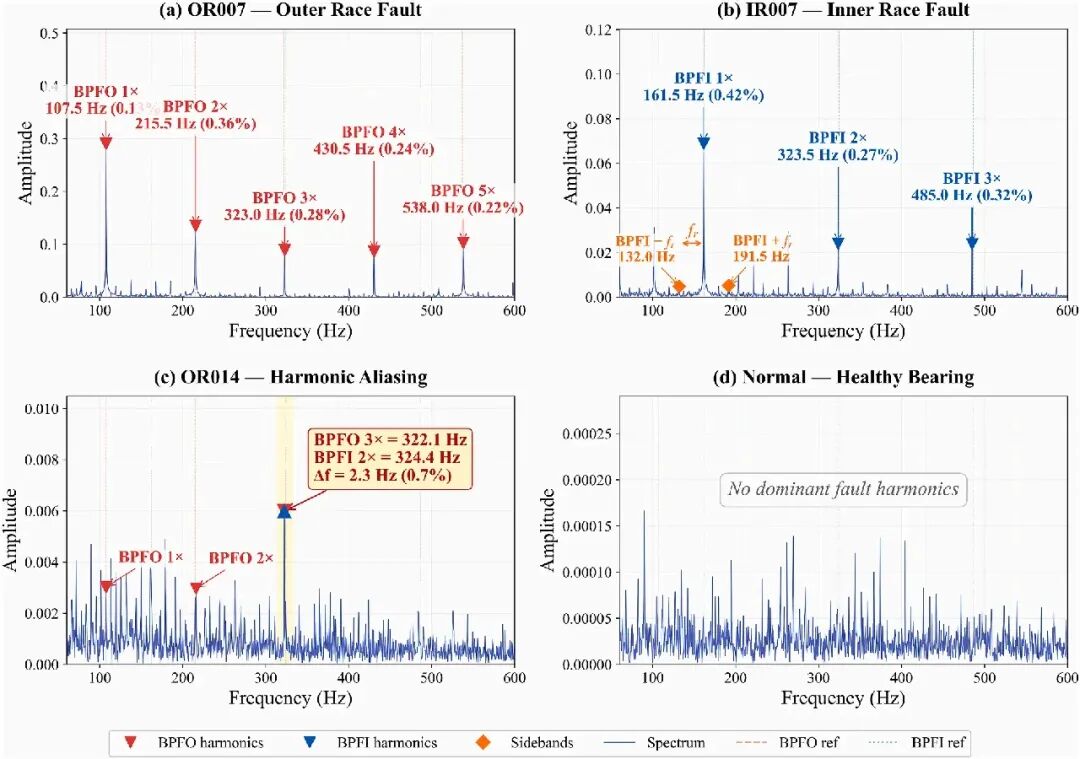
     

    图 8 1797 RPM 下四个代表样本的包络谱。(a)OR007:清晰识别五阶 BPFO 谐波,误差小于 0.4%;(b)IR007:三阶 BPFI 谐波及轴频边带(BPFI ±       ),确认幅值调制;(c)OR014:BPFO 三倍频(322.1 Hz)与 BPFI 二倍频(324.4 Hz)相差 0.7% 的混叠区域,是内外圈误分类根因;(d)正常:噪声底之上无占主导的故障谐波。

    4.6.5. 错误分析

    CWRU 实验的七个误分类样本(错误率 5.0%)揭示两种失效模式,见表 9。

    表 9 错误分类(Qwen-Plus,CWRU,140 样本中 7 个误分类)
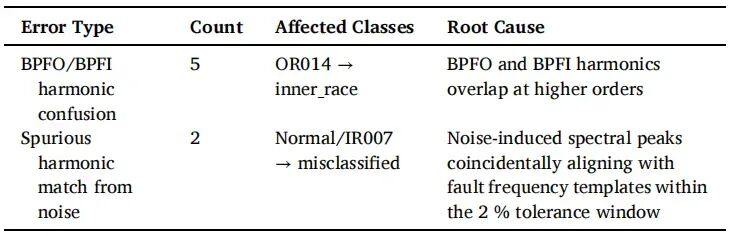
     

    主要类型为 BPFO/BPFI 谐波混淆,占七个错误中的五个,且全部影响 OR014。0.014 英寸故障下,BPFO 三阶约       ,与 BPFI 二阶约        相差 0.7%。采用 2% 容差的匹配工具,会合理地将约 322–323 Hz 的观测峰同时匹配至 BPFO 三阶和 BPFI 二阶,产生额外 BPFI 计数,偏向内圈诊断。这是 CWRU 6205 几何频率比引起的基本物理限制,而非框架缺陷。可行缓解包括收紧容差(代价是漏掉真实匹配),或按幅值加权谐波评分,留待未来研究。

    单个误报案例说明统计上的不可避免性:每个样本提取 15 个峰,对四类故障频率、各五阶谐波应用 2% 窗口,噪声峰偶然对齐模板的概率不可忽略。正常类误报率为       ,与此参数空间预期偶然匹配率一致,说明增加幅值阈值或峰显著性等判别特征可能进一步降低误报。

    4.6.6. 频率匹配容差分析

    第 3.4.2 节的        容差反映三种实际因素。第一,不同负载下转速波动;CWRU 四工况为 1730–1797 RPM,范围 3.7%,实际特征频率即使在同一数据集中也随转速变化。第二,轴承几何公差与内部游隙变化,使名义参数理论频率偏离实测谱频率。第三,有限 FFT 分辨率产生离散化下限:12 kHz、16384 点时,


    约为 BPFO 107.4 Hz 的 0.7%。因此        是在容纳综合不确定性与限制偶然匹配间的工程折中。

    从 4.6.5 错误分析可评估其敏感性。收紧至        会减少偶然落入窗口的噪声峰,可能降低正常类误报;但不能消除主要 OR014 错误,因为两组谐波仅相差 0.7%,仍落在两侧        窗口内。放宽至        会增加各类噪声偶然匹配,抬高误报及类间混淆。当前        取得 95.1% 总体准确率,主要错误来自 CWRU 6205 特定几何巧合,而非系统性框架限制。

    第 4.6.7 节参数扰动提供进一步定量证据:几何参数扰动        至        时,理论频率变化相当于在真实参数不确定性下测试容差窗口。表 10 确认,在符合工业参数精度的扰动下保持鲁棒。针对不同轴承几何细致优化容差,是未来部署定制方向。

    4.6.7. 轴承参数扰动分析

    物理推理依赖几何参数和转速计算理论频率。实际中,制造公差、长期磨损或文档不完整会使名义值偏离真实值。为评估鲁棒性,我们在 CWRU 上系统扰动。

    每个扰动幅度为 1%、3%、5%,对滚珠直径       、节圆直径       、滚动体数       (四舍五入至最近整数)以及转速        独立施加随机乘性扰动:


    各幅度使用五个独立随机种子重复测试,每次用 Qwen-Plus 诊断全部 140 个样本。结果见表 10。

    表 10 参数扰动分析(CWRU,Qwen-Plus,每次       ,每级五次)
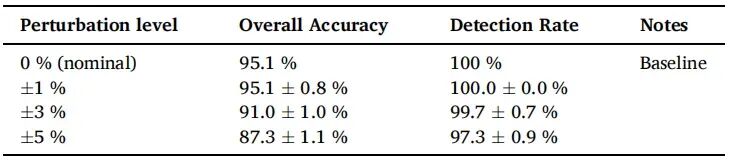
     

    第一,分类准确率随扰动平稳下降:       仅下降 4.1 个百分点,       下降 7.8 个百分点,没有突发坍缩。       代表厂家数据表精度,此时与名义基线在统计上无法区分(均 95.1%),确认        匹配容差充分吸收小不确定性。较大扰动下主要是转速影响,因它成比例平移所有特征频率;转速偏差超过匹配容差时,高阶谐波落出窗口,匹配计数减少、分类歧义增加。

    第二,更重要的是,即使       ,检测率仍超过 97%。这来自感知—诊断分离:感知依赖直接由信号计算的 MSE 比值、频带 z 分数与峭度,完全独立于几何参数。扰动只影响诊断频率匹配,削弱分类但不削弱上游检测。结果验证两级设计:即便参数不确定性远超典型工业条件,框架仍可靠识别故障存在,并保持合理分类准确率。

    4.7. 与基于 LLM 的诊断方法比较

    为将本文置于新兴 LLM 轴承诊断研究中,我们与 Tao 等 [16]、BearLLM [18]、DiagLLM [17] 作参考比较。由于这些方法需故障标签训练/微调、无法直接用于无标签条件,因此采用原论文报告结果,而非受控复现。表 11 从三个维度汇总比较。

    表 11 与基于 LLM 的轴承故障诊断方法的参考比较
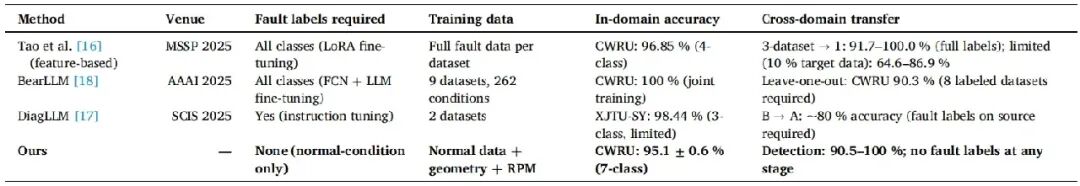
     

    标签效率。 本文在 CWRU 无故障标签达到 95.1%,仅比 Tao 等使用全标签和 LoRA 的 96.85% 低 1.7 个百分点,且是更难的七类而非四类设置。BearLLM 达 100%,但需九个数据集故障标签;其 CWRU 留一跨数据集准确率为 90.3%,即使使用其他八个有标签数据集仍比本文低 4.8 个百分点。这种较小准确率差距对应部署需求的质变:设备投用后即可部署,不必等待故障数据。

    跨域鲁棒性。 在最接近工业部署的有限数据情形,Tao 等即使有三个源域完整标签和 10% 目标域故障数据,准确率仍降至 64.6%–86.9%。本文监督更少,在相同目标域故障检测率达到 90.5%–100%,说明物理推理在大域差距下比学习模式表示更平稳地退化。

    需要指出,本比较来自不同论文,数据划分、类别定义和评估协议不同,应视为展示标签效率与诊断能力的范式级权衡,而非受控的一对一比较。在相同实验条件下复现,仍是未来基准研究的重要方向。

    5. 结论

    本文提出可信多智能体 LLM 框架,应对安全关键机械状态监测部署智能体 AI 的保障要求。通过将 LLM 从模式分类器重新定位为确定性物理工具链的推理编排器,实现完全无故障标签诊断,并把四种可信属性直接落实于架构:LLM 推理—信号计算分离、可审计推理溯源、安全单调反思纠正及组件失效平稳降级。

    主要结论如下。

    1. 无故障标签的物理推理在 CWRU 取得          准确率。其中确定性工具链贡献 82.8%,LLM 编排额外贡献 12.2 个百分点,这是 4.3 节单次运行消融结果。在三个未见目标域的无标签迁移中,平均故障检测率 95.6%;五个监督基线均未能泛化,输出退化为恒定类别或多数类先验。
    2. 带 LLM 自适应感知的三智能体架构,将跨域分类准确率从 21.7% 提高至 63.8%,误报率从 100% 降至 33.3%,在分布偏移下有效平衡灵敏度与特异性。
    3. 多层证据一致性验证贡献 10.0 个百分点总体准确率,边带消歧单独贡献 7.1 个百分点,有效缓解 BPFO/BPFI 谐波重叠引起的系统性内外圈误分类。
    4. 与三种 LLM 方法的参考比较显示,本文无需故障标签,域内准确率与完全监督替代方法差距在 1.7 个百分点以内,并在大域差距下提供更稳健跨域故障检测。

    此外,三 LLM 后端五次运行均值为 92.4%–95.1%,差距仅 2.7 个百分点,标准差 0.6–1.2 个百分点,确认能力主要由物理工具链架构而非某一 LLM 决定。

    需要指出若干局限。每样本 30–90 s 的端到端时间主要来自 API 延迟,因此框架定位为定期检查和离线维护支持,而非连续实时监测。框架尚未验证多故障同时存在的复合工况,例如外圈点蚀与保持架磨损同时发生。此时不同谱特征可能重叠,谐波逻辑会报告多个类型及各自计数。多证据综合或许能标记并发故障,但边带消歧原为内外圈二分设计,面对多种故障谱叠加的行为未经测试。通过幅值加权谐波评分和多故障假设检验扩展至复合诊断,是优先方向。

    防回退约束虽防止真实故障回退为正常,却引入互补风险:若初始诊断因偶然谱峰把健康轴承判为故障,约束会阻止系统自行纠正误报。这反映漏检代价远高于误报的安全关键非对称性。可考虑置信度门控放宽:若原诊断低置信且证据不完整,例如只匹配单个低 SNR 谐波,就放宽约束;也可设计人工覆盖路径,让工程师依据实体检查证据撤销已锁定诊断。

    与 LLM 方法的参考比较采用不同论文、不同划分、类别及协议,应解释为范式级权衡,而非受控对照。LLM 随机性虽有界,运行间不超过 1.2 个百分点,工业部署仍可能受益于多次诊断投票。最后,物理推理依赖准确几何参数和轴转速,长期磨损可能使其偏离名义值。4.6.7 节仅确认        下平稳退化,尚未覆盖严重磨损或错误文档引起的更大偏差。

    未来工作聚焦六个方向:

    1. 以齿轮啮合频率公式替换运动学方程,将物理工具链扩展到多部件旋转机械。
    2. 融合振动、声发射、电机电流等多传感器多模态信息,丰富异常指标与谐波消歧证据。
    3. 引入 RAG,积累历史诊断案例以持续学习。
    4. 构建物理与数据驱动混合架构:无标签框架作为初筛,故障数据可用后由微调模型细化分类。
    5. 迁移至 7B–13B 轻量级本地 LLM,实现边缘部署;框架仅传输文本提示而非原始信号,自然适应工业“数据留在本地”的严格隐私要求。
    6. 与制造执行系统(MES)和数字孪生平台集成,对智能产线多设备进行系统级状态监测。
    编辑:Kira
    校核:李正平、陈凯歌、Leo、曹希铭、赵学功、白亮、任超、海洋、陈宇航、Tina、王金、赵诚、肖鑫鑫、张优
    该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除
    来源:故障诊断与python学习
    MechanicalSystem振动旋转机械通用航空python海洋理论电机数字孪生试验
    著作权归作者所有,欢迎分享,未经许可,不得转载
    首次发布时间:2026-10-15
    最近编辑:42分钟前
    故障诊断与python学习
    硕士 签名征集中
    获赞 87粉丝 153文章 340课程 0
    点赞
    收藏
    作者推荐

    新锐期刊一区TOP论文推荐|注意力引导的图同构学习:面向故障诊断与剩余使用寿命预测的多任务框架

    本期给大家推荐注意力引导的图同构学习:面向故障诊断与剩余使用寿命预测的多任务框架。旋转机械的智能运维正从单一故障诊断迈向多任务协同决策。故障诊断与剩余使用寿命(Remaining Useful Life, RUL)预测是保障设备可靠运行的两大核心,但传统状态监测往往为二者分别建模,导致知识共享效率低、深度学习模型部署与维护成本高昂。图卷积网络凭借对图数据的强大表征能力为状态监测提供了新范式,然而如何在同一框架下实现诊断与预测的协同仍具挑战。针对此,本研究提出一种融合注意力机制的多任务图同构网络,通过参数共享与自注意力机制建模任务间关联,同步完成故障诊断与RUL预测。基于轴承全生命周期退化数据的实验验证表明,该方法较传统单任务方法精度更高、实用性更强,并可显著降低模型开发成本,为旋转机械的智能故障诊断与寿命预测提供了兼具学术价值与工程潜力的新方案。论文基本信息论文题目:Attention-guided graph isomorphism learning: A multi-task framework for fault diagnosis and remaining useful life prediction 论文期刊:Reliability Engineering and System SafetyDoi:10.1016/j.ress.2025.111209作者:Junyu Qi (a,b), Zhuyun Chen (a, c, *), Yun Kong (d), Wu Qin (e), Yi Qin (f) 论文时间:2025年 机构: (a) School of Electromechanical Engineering, Guangdong University of Technology, Guangzhou, China (b) Electronics & Drives, Reutlingen University, Reutlingen, Germany (c) School of Mechanical and Automotive Engineering, South China University of Technology, Guangzhou, China (d) School of Mechanical Engineering, Beijing Institute of Technology, Beijing, China (e) School of Mechatronics and Vehicle Engineering, East China Jiaotong University, Nanchang, China (f) College of Mechanical and Vehicle Engineering, Chongqing University, Chongqing, China作者简介: 陈祝云,广东工业大学"青年百人"高层次引进人才,副教授/硕士生导师,刘强院长智能制造团队;华南理工大学-鲁汶大学联培博士,华南理工大学机械与汽车工程学院李巍华院长博士、博士后/副研究员,省部共建精密电子制造技术与装备国家重点实验室核心成员,入选广州市科协青年托举人才、人社部国际交流计划派出项目(2024, 2021)。主研方向为复杂系统的智能故障诊断与预测性维护、工业大数据/时序信号处理、工业人工智能/工业大模型/可解释性人工智能、数字孪生、工艺性能优化等。主持国家自然科学基金面上项目、青年基金项目、广东省/广州市基金、企业合作等项目10余项;作为核心成员参与国家自然科学基金联合基金重点项目/面上项目、国家重点研发计划课题、广东省重点领域研发计划、校企合作重大项目等10余项。目前在IEEE TNNLS、IEEE TCYB、IEEE TII、MSSP、REES、机械工程学报等高水平期刊发表论文 70余篇,含ESI高被引论文10篇,Google学术累积被引4800余次,H-index: 28,受理/授权发明专利20余件,连续入选2023/2024 斯坦福大学全球前2%顶尖科学家年度榜单;担任广东省机械工程学会设备与维修工程分会副秘书长、广州市机电工程学会设备与维修工程分会副秘书长、中国振动工程学会故障诊断分会青年工作组成员、广东省机械工程学会制造业信息化分会理事;担任仪器测量领域顶刊《IEEE Transactions on Instrumentation and Measurement》副编辑、《Chinese Journal of Mechanical Engineering》(机械工程学报英文版)、《Instrumentation》(仪器仪表学报英文版)、《工程科学与技术》、《机械科学与技术》、《机电工程技术》等8个期刊(首届)青年编委、《Journal of Dynamics,Monitoring and Diagnostics》青年编委会副主任,10余个国内外期刊的客座主编/编辑、ICSMD 2022/2023、IEEE PHM-Beijing 2024、ICEIOM 2023等国际会议的分会主席等,国际会议SIGNAL 2022-2024的技术委员会成员等;荣获2024年中国振动工程学会科学技术一等奖、英国皇家物理学会 "Emerging Leader Award(青年领军人奖)"、中国汽车工程学会优秀博士学位论文提名奖、多次国内外期刊/会议最佳论文、优秀论文、优秀青年编委、杰出审稿人等荣誉。(摘自广东工业大学教师个人主页)通讯作者邮箱:mezychen@gdut.edu.cn 摘要智能故障诊断与剩余使用寿命(Remaining Useful Life,RUL)预测对旋转机械的可靠运行至关重要。这些技术可提升制造业的安全性、可用性与生产效率。图卷积网络(Graph Convolutional Networks,GCNs)是深度学习(Deep Learning,DL)在图数据上的拓展,凭借其独特的数据表征能力实现了优异性能。传统状态监测(Condition Monitoring,CM)通常需要为故障诊断与RUL预测分别构建模型,面临知识共享效率低、深度学习模型部署与制备成本高等难题。为解决上述问题,本研究提出一种融合注意力机制的多任务图同构网络,可同步实现故障诊断与RUL预测。该方法考虑任务间的关联关系,引入参数共享机制与自注意力机制。与传统单任务方法相比,所提方法精度更高、实用性更强,且能降低模型开发成本。通过轴承全生命周期退化实验数据验证了该方法的有效性,结果表明该方法可解决故障诊断与RUL预测中的关键问题,在实际应用中具备广阔潜力。关键词:状态监测;可靠性分析;诊断;预测;健康管理 目录1 引言2 相关工作2.1 多任务学习2.2 自注意力机制3 面向故障诊断与RUL预测的所提方法3.1 图构建模块3.2 图同构网络3.3 图自注意力模块3.4 多任务模块3.5 联合结果模块3.6 所提方法的实施步骤4 实验结果4.1 实验数据4.2 数据准备4.3 性能指标4.4 结果与分析5 结论1 引言近年来,随着信息通信技术的发展[1, 2],制造业取得显著进步,智能制造与数字化制造加速发展。人工智能(Artificial Intelligence,AI)与制造业深度融合,显著提升经济效益、推动数字化转型、改善产品质量与生产效率[3,4]。然而,随着机械设备向大型化、复杂化、自动化方向发展,设备结构复杂度提升,为维护与维修工作带来巨大挑战[5]。同时,不断增长的生产需求对运行机械的安全性与可靠性提出更高要求。旋转机械常在高负载、变工况下运行,齿轮、轴承、链条、皮带等部件易发生磨损、裂纹与断裂[6]。此类故障会导致机械运行失稳甚至失效,若未及时检测、维修或更换,将引发重大安全风险与经济损失[7]。轴承作为核心部件,直接影响制造系统中多数旋转机械的性能与整体健康状态[8]。统计数据显示,约50%的电机故障由轴承问题导致[9,10]。机械部件故障是固有随机过程[11],即使相同型号、相同工况的轴承,寿命差异也极大,从数天到数年不等。传统模式下,维护人员定期更换轴承以保障可靠运行,易造成过度更换、停机时间延长、维护成本增加[12,13]。智能状态监测(Condition Monitoring,CM)[14–16]包含故障诊断与剩余使用寿命(Remaining Useful Life,RUL)预测,可精准监测机械健康状态、预防突发故障、减少非计划停机与维护成本、提升安全性与可靠性[17]。相关技术已被广泛研究。Kateris等[18]基于传感器与特征融合提取健康指标(Health Indicators,HI),结合带自动相关性确定的多层感知器(Multilayer Perceptron,MLP)实现故障类型分类。Qi等[19]提出一种智能状态监测方法,用于异常检测与 RUL 预测,该方法基于稀疏度指标HI采用支持向量数据描述(Support Vector Data Description,SVDD)实现异常检测,并通过多步估计器完成 RUL 预测。类似地,Kankar等[20]提取多种时域统计HI,筛选合适指标后输入支持向量机(Support Vector Machine,SVM)与人工神经网络(Artificial Neural Network,ANN),实现轴承故障诊断。Wang 等[21]基于高斯混合模型(Gaussian Mixture Model,GMM)构建HI,采用支持向量回归(Support Vector Regression,SVR)预测RUL。Han与Jiang[22]结合变分模态分解与自回归模型分解振动信号,将其作为故障特征向量,基于随机森林(Random Forest,RF)实现故障诊断。深度学习(Deep Learning, DL)的兴起彻底革新了智能状态监测方法,无需依赖专家知识,可直接从海量数据中提取有价值的故障相关信息 [23]。该领域常用DL模型包括卷积神经网络(Convolutional Neural Networks,CNN)、长短期记忆网络(Long and Short-Term Memory networks,LSTM)、自编码器(Autoencoders,AE)与深度置信网络(Deep Belief Networks,DBN)。与传统机器学习(Machine Learning,ML)不同,基于DL的状态监测适用性强,无需领域专业知识与先验知识,如手动提取与筛选HI[24]。为解决轴承故障诊断难题,Jing等[24]基于CNN构建端到端深度学习模型,将特征提取、筛选与分类集成于单一系统。该模型以原始振动信号的频域数据为输入,性能优于常用机器学习方法、前馈神经网络(Feedforward Neural Networks,FFNN)、SVM与RF。另一项研究中,Sabir等[9]基于LSTM提出故障诊断方法,采用电机电流信号,在时域与时频域提取8种HI并输入LSTM,分类精度达 96%。近期,Qi等[25]提出一种无传感器深度加权k近邻(Deep Weighted K-Nearest Neighbors,WKNN)方法,融合深度AE实现健康评估,结合WKNN实现鲁棒异常检测。该方法利用电机驱动器数据,在解决滚子链系统监测难题上优于现有方法。类似地,Peng等[26]提出一种基于无监督深度支持向量数据描述的风机自适应异常检测技术。该方法构建鲁棒球形边界,有效应对数据噪声与波动,提升风机状态监测可靠性。同时,Ahmad等[27]构建基于LSTM的AE,利用实测振动数据在单一状态监测系统中完成特征提取与异常检测。类似地,Hasani等[28]提出基于AE的HI提取方法,追踪轴承全生命周期退化过程。该模型采用振动数据训练,计算初始健康数据与连续样本间的相关性,表征健康状态。此外,Fu等[29]构建融合CNN与LSTM的深度学习模型,利用风机轴承温度数据实现早期隐患检测。Khorram等[30]构建CNN-LSTM模型,以原始振动数据为输入、故障类型为输出,无需对输入数据进行预处理。Ma与Mao[31]构建CNN-LSTM模型,利用时频特征捕捉长时依赖并选择性传播相关信息,RUL预测效果优于单一CNN或LSTM模型。此外,为降低环境噪声影响、提升波浪能转换器齿轮箱故障诊断效果,研究人员开发了CNN-LSTM模型。该模型融合自适应矩估计与刚柔耦合动力学仿真模型,通过仿真与实验数据验证,在变工况干扰下可高效、精准诊断各类故障[32]。Zhao等[33]提出自适应多尺度CNN,有效捕捉实际工业系统变工况下的多时间尺度与数据特征。尽管CNN可通过卷积核提取数据相关信息,但无法表征故障、噪声与相邻点间的因果关系[34,35]。近年来,图神经网络(Graph Neural Networks,GNNs)在故障诊断领域备受关注,因其可在图域中同时表征节点数值与节点间关联关系[36]。Zhang等[36]将图论、深度学习与图卷积网络(Graph Convolutional Networks,GCNs)融合,构建基于声学数据的故障诊断模型,精度优于CNN、RNN与深度AE等DL模型[36]。Wang等[37]提出融合GNNs与图注意力网络的故障诊断方法,捕捉全局结构信息并根据节点相对重要性动态调整节点权重。Wang等[38]开发门控图卷积网络用于多传感器数据融合与RUL预测,有效建模多传感器信号的时空依赖,精准提取退化特征。此外,Yu等[34]开发深度GCN用于风机齿轮箱故障诊断,采用小波包分解与时频特征。Zhao等[39]引入半监督图卷积深度信念网络构建图邻域关系,解决实际工业场景中标注数据有限的难题。Zhang与Wu[35]提出基于格兰杰因果检验的GNN用于故障分类,量化噪声影响,性能优于SVM、RF与CNN等DL模型[35]。然而,现有方法仍面临诸多挑战。多数用于RUL预测的DL方法高度依赖特征提取实现样本与RUL的映射,常忽略样本自身的空间关联,这会限制DL模型在RUL预测中的性能。此外,当前多数方法将智能故障诊断与RUL预测视为完全独立的任务,为每个任务单独训练模型。这不仅无法利用任务间的相关性,还因忽略样本空间关联增加了实施复杂度与成本。为解决上述问题,本研究提出一种基于融合注意力机制的多任务图同构网络(Graph Isomorphism Network,GIN)的故障诊断与RUL预测联合方法。通过参数共享与基于自注意力的数据融合,所提方法有效构建故障诊断与RUL预测间的关联关系。该联合训练策略可同步实现故障诊断与RUL估计,相比传统单任务深度学习模型,精度更高、适应性更强、部署成本更低。本研究的核心方法贡献如下:(1) 本研究引入基于GIN的模型,采用图卷积实现特征提取。该模型可有效捕捉采集数据中的空间依赖,GIN的层级结构提升特征表征能力。多层架构确保每一层输出均参与多任务模型训练,提升预测性能。(2) 引入图自注意力机制,自适应融合每一层图卷积提取的特征向量。该改进可动态平衡不同任务的性能,同时提升故障诊断与RUL预测效果。与传统融合技术不同,所提方法可实现最优信息融合,且不降低任一任务的精度。(3) 开发多任务GCN模型,同步实现轴承故障诊断与RUL估计。通过学习多任务共享表征,提升模型在不同状态监测场景下的泛化能力。此外,多任务模型部署可降低计算与运维成本,为设备维护提供更全面的决策支持。 (4) 大量实验评估表明,所提方法性能优于传统单任务深度学习模型。该模型在三种不同转速与负载工况下,故障诊断与RUL估计均展现出鲁棒性,进一步验证其在实际状态监测任务中的实用性。本文后续结构安排如下:第2节综述多任务学习与自注意力机制相关研究;第3节详细阐述多任务状态监测的所提方法,包括图构建、图卷积、自注意力与多任务原理;第4节展示实验结果,包含数据描述、性能指标与深入讨论;最后总结研究成果并展望未来工作。2 相关工作本节综述多任务学习与自注意力机制的相关理论。2.1 多任务学习多任务学习(Multi-Task Learning,MTL)是一种机器学习技术,利用多个相关任务包含的有效信息训练单一模型,同步提升所有任务的泛化能力[40]。传统机器学习中,任务单独处理、单独建模,每个模型仅执行单一任务,忽略任务间的关联信息。而MTL通过联合学习多个相关任务并实现信息共享,为多任务构建鲁棒、通用的表征。深度学习中,MTL通常通过参数共享机制实现,包括硬共享、软共享、层级共享与稀疏共享,如图1所示。 图1 参数共享机制[41]:(a)硬共享,(b)软共享,(c)层次化共享,(d)稀疏共享硬共享:最常用方法,所有任务共享隐藏层,同时定义任务专属输出层。该方法易于实现,参数设置高效。软共享:与硬共享相反,软共享为每个任务构建独立网络,通过不同任务网络间的交互实现信息共享。该方法更灵活,无需共享网络结构,无需假设任务相关性。但随着任务数量增加,模型参数同步增长,需新增大量参数[42]。层级共享:该方法在网络结构不同层分配不同任务监督,融入部分任务先验知识设计层级共享结构。层级共享比硬共享更灵活,参数需求少于软共享。但实际应用中,设计有效的层级结构难度较大。稀疏共享:该方法根据任务随机共享层参数,寻找最优任务与模型参数组合的搜索空间极大。参数共享的随机性为实验结果带来不确定性,无法有效识别并减少模型中的冗余信息[42]。与单任务模型相比,MTL具备以下优势[43]:MTL通过共享固有层,避免为每个任务重复计算共享层特征,减小模型规模与复杂度,大幅提升模型效率与训练速度。通过共享任务间的通用知识与信息,MTL提升模型泛化能力与鲁棒性,降低过拟合风险。MTL通过多任务共享相同数据,提升数据利用率。这降低了对大量标注数据的依赖,减少深度学习模型训练与部署成本。MTL模型训练与优化时,不同任务具有不同目标函数。MTL通过反向传播联合损失函数更新模型参数,同步优化多任务目标函数。假设共有N个任务参与MTL,联合损失函数可表示为式 其中 表示共享网络结构的输入, 表示不同任务间的共享参数, 、 、 与 分别为第 个子任务的标签、前向传播函数、损失函数与权重。该公式使MTL模型可根据权重 确定的重要性,平衡每个任务的贡献。2.2 自注意力机制注意力机制是受人类认知过程启发的强大技术,可选择性聚焦输入数据中最相关的部分[44]。例如,图像识别中会重点关注图像中信息更丰富的特定区域。注意力机制为不同输入元素分配不同权重,使模型优先关注任务相关信息、抑制无关细节[45]。该技术在DL中应用广泛,尤其在序列建模领域,可通过学习输入特征的相对重要性动态提升模型性能。自注意力机制是注意力机制的重要变体,在自然语言处理与计算机视觉等领域应用广泛[44]。与传统注意力不同,自注意力计算单一输入序列内部元素间的关系,使模型可捕捉长距离依赖与上下文信息。其核心思想是学习不同输入组件间的相互依赖并据此聚合信息,每个元素根据与其他元素的相关性加权。在多任务学习场景中,自注意力机制提供额外灵活性。每个任务可独立学习专属注意力权重,实现任务专属特征聚合,无需修改共享模型架构。该能力使模型可选择性关注每个任务最相关的特征,通过更高效的表征学习提升所有任务性能。3 面向故障诊断与RUL预测的所提方法为克服传统方法需为故障诊断与剩余使用寿命预测分别构建模型的局限,本研究提出一种基于多任务图神经网络的统一框架。图2展示了所提方法的整体流程,包括实验装置、数据采集、图构建、图运算、自注意力模块与MTL。图3为更详细的流程示意图,包含五大核心组件:(a)图构建模块(Constructing Graph Module,CGM)、(b)图同构网络(Graph Isomorphism Network,GIN)、(c)图自注意力模块(Graph Self-attention Module,GSM)、(d)多任务模块(Multi-Task Module,MTM)与(e)联合结果模块(Joint Results Module,JRM)。 图2 所提出的多任务学习方法论概述 图3 所提出联合故障诊断与RUL预测方法的详细阐述3.1 图构建模块CGM是将采集的振动信号转换为样本图的核心组件,支持图卷积网络实现特征提取。流程始于从原始信号提取16种时频域特征,这些提取的特征作为样本图的节点。为建立节点间连接,计算每对特征的皮尔逊相关系数。若相关系数超过预设阈值,则在两个节点间构建边。通过将原始振动信号转换为结构化图表征,该方法保留了比原始信号更全面的信息。预处理阶段是为所提方法准备振动信号的关键步骤,包含两大核心组件:(1) 特征提取:从振动信号中提取节点特征;(2) 图构建:生成邻接矩阵定义节点间连接。具体步骤详述如下:节点特征:为利用图卷积网络实现特征提取,首先将采集的振动信号转换为样本图。转换始于从原始信号提取16种时频域特征,包括均值、均方根、方差等统计量。这些特征记为 至 ,详见表1[46],选择依据是其可有效反映滚动轴承运行状态,且随时间呈现显著变化。每个特征作为样本图中的一个节点,节点特征提取是构建图的基础。融入这些特征后,样本图可丰富表征振动信号的动态行为信息。 表1 所用指标的表达式 邻接矩阵:邻接矩阵是样本图的核心组件,定义节点间连接,是图卷积层的必要输入。节点间连接基于皮尔逊相关系数确定,该系数量化节点特征对间的线性关系。两个节点 与 间的皮尔逊相关系数 计算如下: 其中 与 表示两个不同节点, 与 为其对应均值。 取值范围为0至1,数值越高表示节点间相关性越强。为确保仅保留显著关联关系,为皮尔逊相关系数设置0.8的阈值。具体而言,仅当节点 与 的相关系数 超过0.8时,才在二者间构建边。该阈值处理确保图结构保留特征间最有意义的连接,过滤弱相关关系,提升样本图的表征能力。 通过上述预处理步骤,振动信号被有效转换为样本图,封装数据的时序与关联特征。该结构化表征为所提方法后续的分析与分类任务提供支撑。3.2 图同构网络GIN包含三层图同构卷积层与图边池化层。每一层图卷积(Graph Convolution,GC)的输出通过图池化(Graph Pooling,GP)方法——边池化(EdgePool)[47]处理,再全局平均池化得到每一层的特征表征。仅使用最后一层输出会导致图卷积模块性能损失。层级图卷积神经网络的每一层输出均参与后续任务,使训练过程更稳定、模型性能更高。特征提取由三层堆叠的GIN层实现。每一层包含GIN卷积层、批量归一化层、激活层与图池化层。前一层图池化层的输出作为下一层GIN层的输入。三层全局平均池化层的输出拼接后,作为两个全连接层的输入。设 为样本图,GIN计算如式(3): 其中 为图同构网络卷积层, 为批量归一化层, 为激活函数, 为图池化层, 为全局平均池化层, 为拼接操作, 为全连接层。3.2.1 图同构卷积传统图神经网络采用邻域聚合策略更新节点表征,但难以有效学习同构图的判别特征[48]。图同构卷积(如图4所示)具备更强的图结构依赖捕捉能力与图区分能力,主要分为两步:首先通过求和函数聚合邻域节点特征;随后将聚合特征输入 MLP 进行非线性映射,完成节点特征更新。更新机制如图 4 所示,对应公式: 该公式中,第 层节点特征 通过将前一层特征向量 乘以可学习参数 更新。聚合邻域节点特征并融合后,输入MLP层,输出经非线性激活得到节点 的新特征。具体而言, 与 分别为节点 在第 层与 层的特征。节点 为节点 的邻域节点,满足 ,其中 为节点 的邻域集 合。 图4 图同构卷积层的更新机制聚合与融合函数必须满足单射性,即每个输入对应唯一输出。GIN通过MLP在GNN中学习上述函数,确保单射性。采用求和函数聚合、MLP非线性变换,GIN可有效区分同构图,学习更具信息性的节点表征。3.2.2 图边池化为预测RUL,模型必须学习样本图对应的剩余寿命回归曲线。因此,GP是GNN应用于RUL预测等任务的关键步骤。图池化的核心目的是降低图复杂度,同时保留核心图结构信息[49]。通过融合节点特征实现,减少回归模型需拟合的节点数量。Edgepool[47]是基于连接边分数融合节点的池化方法。首先通过可学习参数Θ与偏置项b计算边分数,再经softmax函数归一化得到最终边分数 ,如式(5): 其中 与 分别为第 个与第 个节点特征, 为边 的原始分数。Θ 与𝑏为可学习参数。 为节点所有边归一化后的最终边分数。 池化操作根据最终边分数融合第 个与第 个节点特征,生成新节点特征,如式(6)。图池化确保高分边连接的节点被融合,有效降低图复杂度、保留结构信息、提升计算效率。3.3 图自注意力模块GSM通过自适应重加权不同输入元素的贡献,提升特征表征能力。该机制使模型可选择性强调重要特征、抑制无关特征,提升分类与回归任务性能。如图3所示,为两个任务分别设置独立自注意力模块,使其在共享卷积层参数的同时,学习专属特征表征。该设计确保模型可高效提取任务专属特征,无冗余。 GSM按结构化三步流程运行: (1)线性映射:第一步将全局平均池化层得到的特征向量转换为三种不同表征:查询(Query,Q)、键(Key,K)与值(Value,V)[44, 50]。该转换通过三个可学习权重矩阵 、 与 实现,将输入特征向量X映射至不同隐空间。过程数学公式如下: 每种转换学习输入特征的不同视角。 为寻求注意力的特征, 为对比参考, 为最终聚合步骤使用的实际特征表征。该分解使模型可捕捉特征间复杂的依赖与交互。 (2)注意力分数计算:第二步计算注意力分数,量化每个特征相对其他特征的重要性。通过缩放点积运算计算 与 间的相似度: 其中内积 衡量查询向量与键向量的相似度,生成注意力分数矩阵 。缩放因子 防止点积数值过大,避免训练过程中梯度消失或爆炸[51]。Softmax函数将 的每一行归一化,使分数和为 1,确保其表示输入特征的概率分布。 (3)加权聚合:计算注意力分数后,用于对值矩阵 进行加权聚合。最终输出表征 计算如下: 该操作生成精细化特征表征,每个元素为输入特征的自适应组合,按重要性加权。 最终输出输入后续层,执行分类与回归任务。通过动态调整特征重要性,该步骤提升模型表达能力,增强捕捉任务专属信息的能力。3.4 多任务模块设计优良的故障诊断模型不仅需精准识别具体故障,还需支持故障预测。为实现该目标,所提方法融合MTL与联合损失函数,确保故障诊断与RUL预测同步优化。MTL的核心原理是参数共享,提升跨任务特征泛化能力。所提MTM采用硬参数共享,即两个任务共享整个图卷积模块。该结构使任务间交互、竞争,学习更泛化的特征,最终同步提升故障诊断与RUL估计效果。针对任务专属处理,MTM采用两个独立全连接层:故障诊断分类模块与RUL预测回归模块。如图3所示,分类模块(任务 1)预测每种故障的概率分布,回归模块(任务 2)输出RUL估计值。为实现同步学习,采用联合损失函数平衡两个任务。故障诊断任务采用带交叉熵损失函数 的Softmax分类器,如式 (10): 同时,RUL预测任务采用均方误差(Mean Squared Error,MSE)损失函数 优化: 其中 为输入样本, 与 分别为故障诊断与RUL预测任务的标签。 为平衡两个任务的贡献,构建加权联合损失函数 : 其中 与 为任务专属权重,控制故障诊断与RUL预测的相对重要性。为不同任务分配不同权重,会直接影响学习动态,可能优先优化某一任务。需详细讨论这些权重对模型性能的影响,阐明每个任务的学习机制。 前向传播过程计算联合损失函数,随后用于反向传播更新模型参数。最终,MTM 在统一框架中学习故障诊断与RUL预测。训练完成后,模型可同步输出预测故障类型与估计RUL,验证其故障识别与预测能力。3.5 联合结果模块基于计算得到的联合损失,同步得到故障诊断与故障预测结果。为全面评估性能,除可视化展示外,还采用多种指标。故障诊断任务采用精度、精确率、召回率与 F1 分数;故障预测(RUL预测)任务采用F1分数、均方根误差(Root Mean Square Error,RMSE)与决定系数( )。3.6 所提方法的实施步骤通过允许每个任务学习专属注意力权重与聚合方法,多任务模型可更精准地聚焦每个任务输入中最相关的部分。该定向注意力机制使模型更好地捕捉数据中与每个任务最相关的独特特征与关联关系。因此,带任务专属注意力的MTL不仅提升模型适应性,还显著增强整体性能与泛化能力。所提方法的实施步骤如下: 步骤1:首先通过加速度计采集滚动轴承全生命周期退化过程的振动数据。 步骤2:采用时频域分析处理采集的振动信号,提取特征。计算特征间相关系数,构建样本图。 步骤3:为RUL预测设置分段线性标签,为故障类型设置对应标签(标签知识),监督模型学习隐藏信息。 步骤4:构建多任务数据集 ,其中 为输入样本, 为输入样本的故障类型标签, 为RUL标签。 步骤5:采用多任务模型基于构建的数据集开展联合监督训练,通过最小化联合损失函数优化模型参数。迭代次数达到上限或模型收敛至最优时停止训练,得到训练完成的多任务模型。 步骤6:最后将测试样本输入训练完成的多任务模型,模型同步输出输入样本的故障类别与对应RUL。 该方法通过动态学习并为每个任务应用不同注意力机制,确保模型有效优先利用关键信息。在保留任务专属细节的同时,共享跨任务知识,所提方法形成全面高效的框架。4 实验结果所提方法融合GIN与自注意力模块,实现故障分类与回归任务。为验证所提方法的有效性,采用轴承全生命周期退化数据进行实验验证。4.1 实验数据实验装置如图5所示,主要包括交流电机、电机调速器、支撑轴承、测试轴承与液压加载系统。电机由调速器控制,以不同转速运行。测试轴承安装在旋转轴上,液压加载系统为测试轴承施加径向载荷。实验设计三种不同工况开展,详见表2。 图5 轴承退化试验实验装置表2 被测轴承的工况及故障详情 采用两个加速度计采集数据,分别水平与垂直布置于测试轴承旁。采样频率设为25.6kHz,每分钟采集一次数据。每次采集时长1.28秒,每次采集得到32768个数据点。当测试轴承振动幅值超过健康阶段十倍时,停止退化测试。测试结束时轴承失效模式如图6所示,包括内圈故障、外圈故障与保持架断裂。实验结束后,获取三种工况下15个轴承的完整退化数据,具体寿命见表2。 图6 滚动轴承失效类型:(a) 内圈失效,(b) 保持架失效,(c) 外圈磨损,(d) 外圈断裂4.2 数据准备训练多任务模型时,必须为输入数据标注故障类型。表2中仅轴承2–3与1–4存在保持架故障,因此不参与训练。此外,轴承1–5与3–2存在外圈故障(Outer Fault,OF)、内圈故障(Inner Fault,IF)、滚动体故障(Ball Fault,BF)与保持架故障(Cage Fault,CF)等混合故障类型,同样排除在训练集外。因此,其余轴承的故障类型分为健康(Healthy,H)、OF与IF三类。三种故障类型的标签分别设为[0, 1, 2]。为验证所提方法性能并覆盖多种工业场景,每种工况选取两个轴承用于训练多任务模型。共计选取表2中6个轴承用于训练,每种工况选取一个轴承用于测试模型性能。由于不同轴承健康阶段时长不同,选取每个轴承健康阶段前30分钟数据作为正常样本。最终实验数据集见表3。精心筛选确保数据集平衡,使模型可在不同故障类型与工况下泛化。表3 训练集和测试集准备 4.3 性能指标为评估故障诊断与RUL预测性能,采用分类指标与回归指标。4.3.1 分类指标二分类问题中,样本分为正类或负类,如图7所示。为评估不同方法性能,选择合适的评估指标至关重要。分类问题常用评估指标包括精度、精确率、召回率与F1分数 [52,53]。这些指标可由混淆矩阵推导得出,如图7所示,混淆矩阵通过对比实际标签与预测标签,汇总预测性能。 真正例(True Positive,TP)表示正样本被正确预测为正类。假负例(False Negative,FN)表示正样本被错误预测为负类。假正例(False Positive,FP)表示负样本被错误预测为正类。真负例(True Negative,TN)表示负样本被正确预测为负类。 精度:该指标表示正确预测样本数占总样本数的比例,如式 (13)。 精确率:该指标表示所有预测为正类的样本中,真正例样本的比例。 召回率:该指标表示所有实际正类样本中,被正确预测为正类的比例。 F1分数:当数据样本不平衡时,单一指标(如精度、精确率、召回率)无法 正确评估故障分类性能。此时,结合精确率与召回率的F1分数可提供更均衡、准确的评估。该指标在评估不平衡数据模型性能时尤为有用,提供全面衡量。 图7 混淆矩阵的解释 4.3.2 回归指标RUL预测采用均方根误差(Root Mean Square Error, RMSE)与拟合优度 衡量预测性能 [54, 55]。RMSE:该指标衡量预测值与真实值间的平均误差。完美预测时该值趋近于 0。 拟合优度 :该指标表示回归线对观测值的拟合程度。 越接近 1,拟合效果越好。 其中 与 分别为真实值与预测值, 为真实值均值。4.4 结果与分析本节展示所提多任务模型的故障诊断与RUL预测结果,分析包括故障诊断与RUL预测性能,以及与现有方法的对比(见表 4)。表4 超参数设置 4.4.1 单任务/多任务学习结果对比为验证所提方法有效性,分别在单任务与多任务模式下评估所提方法。单任务模式下,独立训练两个模型,分别执行故障诊断与RUL预测。多任务模式下,采用带联合损失函数的单一模型,同步执行故障诊断与RUL预测。为确保公平对比,深度学习模型超参数在单任务与多任务训练中保持一致,见表4。为降低随机性影响,每个测试轴承的设计模型重复实验五次,取五次运行平均值作为最终结果。 实验结果如表5、图8与图9所示,表明所提多任务模型不仅可同步实现故障诊断与RUL预测,在验证轴承上的性能还优于单任务模型。对比测试集平均性能,故障诊断F1分数为0.803,RUL预测RMSE与 分别为0.086与0.927。表5 基于单任务/多任务模型的结果对比 图8 采用不同性能指标进行的结果对比 图9 RUL预测结果对比 分析每个轴承的结果可见,所提多任务方法RUL预测的RMSE值始终更低,表明模型在捕捉潜在退化特征方面具备鲁棒性。F1分数方面,除轴承2–1略低外,多任务模型在其余两个测试轴承上均优于单任务模型。这表明所提多任务模型在实现轴承RUL预测的同时,取得更优的故障诊断效果。如图9所示,所提多任务模型的RUL预测值紧密跟随真实RUL。初始健康阶段,预测RUL相对稳定,趋近于1。随着轴承开始退化,预测RUL呈下降趋势,与实际RUL曲线高度拟合,直至寿命结束。因此,三种工况下三个轴承的验证结果证实,所提多任务模型的RUL预测精度高于单任务模型。单一模型同步实现故障诊断与RUL预测的能力,为预测性维护提供全面决策支撑,在未来应用中具备重要实用潜力。 单任务与多任务模型对比显示,轴承2–1的单任务模型故障诊断F1分数更高。但其余轴承的单任务模型F1分数与RMSE均差于多任务模型。单任务模型的平均F1分数、RMSE与 分别为0.747、0.099与0.905,劣于多任务模型。这表明所提多任务模型学习到更鲁棒的特征表征,提升了跨任务、跨轴承、跨工况的泛化性能。 此外,图10所示混淆矩阵结果表明,所提多任务模型在不同故障类型下均实现稳定高诊断精度,凸显其优异的泛化能力。对比之下,单任务模型对健康轴承、内圈故障、外圈故障的分类精度分别为0.83333、0.75676、0.88043。而多任务模型(如图10 (b))对应类别精度分别提升至 0.88889、0.83781、0.92391,诊断性能显著提升。为进一步支撑对比,4.3.1节提供的精度、F1分数、精确率与召回率等额外性能指标汇总于表6。结果清晰表明,多任务模型在所有故障类别与评估指标上均优于单任务模型。这印证了模型可有效利用任务间共享表征,实现更泛化、鲁棒的特征学习。 图10 基于单任务/多任务模型的混淆矩阵对比 表6 单任务与多任务方法的性能对比 4.4.2 多任务学习与其他方法对比为验证所提方法有效性,选取三种前沿故障诊断与 RUL 预测方法进行对比。 (1) WDCNN [56]:一种卷积神经网络结构,包含五层卷积层与一层全连接层。第一层采用尺寸为 64、步长为 16 的大卷积核。该模型采用单任务策略测试故障诊断与 RUL 预测,训练超参数与所提方法保持一致。 (2) LSTM [57]:一种循环神经网络模型,由两层堆叠 LSTM 单元组成,后接两层全连接层用于 RUL 预测。与 WDCNN 相同,LSTM 模型也采用单任务策略实现故障诊断与 RUL 预测。 (3)GCN [58]:典型图卷积神经网络模型,包含三层图卷积层与两层全连接层,可直接处理图结构数据,利用其结构信息。该模型采用消息传递机制,每个节点在特征更新时聚合邻域节点信息,有效捕捉节点间关系,提升特征提取效果。实际应用中采用单任务方法实现轴承故障诊断与剩余使用寿命预测。GCN 处理前,需先将振动信号转换为图结构数据,本研究采用所提图构建方法,确保模型充分利用振动信号内在关联。 实验结果汇总于表7与图11。WDCNN、LSTM与GCN的对比凸显各自优劣。故障诊断任务中,LSTM平均F1分数为0.657,低于WDCNN的0.747与GCN的0.723。但RUL预测任务中,LSTM优于WDCNN,平均RMSE为0.122、 为 0.859,而WDCNN 表现较差。尽管如此,LSTM仍劣于GCN,GCN平均RMSE为0.105、 为0.890,效果更优。上述结果表明,WDCNN擅长提取深度特征,更适用于故障诊断;而LSTM与GCN在捕捉时序依赖方面能力更强,对RUL预测更有利。值得注意的是,所提多任务模型在故障诊断与RUL预测任务上均超越WDCNN、LSTM与GCN。这验证了其在联合提取深度特征表征与时序模式方面的有效性,为状态监测提供更全面、鲁棒的解决方案。 表7 所提方法和先进方法的结果对比 图11 所提方法和先进方法的结果对比 图12可视化展示WDCNN、LSTM、GCN与所提多任务模型在轴承1–1、2–1、3–1 上的RUL预测结果。所提方法的拟合趋势明显优于WDCNN、LSTM与GCN,有效表征测试轴承的退化趋势。具体而言,对于轴承3–1,所提方法不仅实现更优的 与更低的RMSE,RUL预测也更稳定。这表明所提方法在轴承RUL预测方面具备更强的鲁棒性。 图12 所提方法和先进方法的RUL对比 此外,开展全面计算复杂度分析,评估所提方法与标准方法(WDCNN、LSTM、GCN)的效率与实用性。 WDCNN[56]:WDCNN的时间复杂度主要由卷积层决定。每层卷积复杂度为 ,其中 为样本数, 为卷积核尺寸, 与 为输入输出通道数, 与 为输出特征图维度。空间复杂度主要由卷积核参数决定,为 。 LSTM[57]:LSTM的时间复杂度为 ,其中 为时间步长, 为输入维度, 为隐藏状态维度。LSTM的空间复杂度为 ,需存储每个时间步的隐藏状态。 GCN[58]:GCN 的时间复杂度为 ,其中 为层数, 为边数, 为节点数, 为节点特征维度。稀疏图中 占主导。空间复杂度为 ,需存储所有节点特征向量。 所提方法:本方法采用融合自注意力与多任务学习的GIN。时间复杂度主要由GINConv层与自注意力模块决定。每层GINConv复杂度为 (与 GCN 相同,但采用单射聚合)。自注意力模块额外增加复杂度 , 为节点特征维度。空间复杂度为 (存储节点特征)与 (自注意力模块参数)。 不同方法计算成本汇总于表8。融合自注意力的GIN方法相比基线方法计算效率更优。在保持GCN基于边的线性复杂度( )的同时,通过GIN强大的聚合能力提升表达能力。自注意力机制仅增加 复杂度,远优于LSTM的 时序处理或WDCNN的 卷积操作。该架构通过稀疏存储保持内存效率( ),并通过多任务学习消除冗余计算。这种最优复杂度特性使本方法在大规模图应用( )中尤为有利,兼顾GCN的可扩展性与注意力的表达能力,同时避免时序或卷积方法的高成本。特征维度的二次依赖( 项)通过统一特征学习实现合理性,否则需多个专用模型,在图结构任务的表达能力与计算效率间实现最优平衡。此外,多任务学习方法可同步实现故障诊断与剩余使用寿命预测,减少对独立模型的需求,提升数据利用效率。 表8 不同深度学习模型的计算消耗 4.4.3 图自注意力模块消融分析为验证图3所述所提方法中图自注意力模块的有效性,对每层全局平均池化输出的特征向量采用不同数据融合方法。方法1:每层输出特征向量直接相加实现特征融合。模型为分类与回归任务输入相同向量,维度为256。方法2:每层输出特征向量通过向量拼接融合。模型为分类与回归任务输入相同向量,维度为768。方法3:所提方法采用图自注意力模块,对每层特征向量进行注意力加权数据融合。模型为分类与回归任务输入相同向量,维度为256。实验结果如表9与图13所示。对比三种数据融合方法的平均F1值,发现方法1的故障诊断效果优于方法2,表明通过相加融合的特征向量对故障诊断任务更有利。方法3的F1分数超过方法1与2,表明注意力加权数据融合可提取更有利于故障诊断的特征。对比三种方法RUL预测的RMSE与 ,方法2优于方法1。这可能归因于拼接向量导致全连接层参数增加,提升深度学习模型容量。相反,方法1的直接相加平滑了输入特征向量间的差异,阻碍模型学习隐藏信息。相比之下,方法3相比方法1与2,RUL预测性能提升。这表明图自注意力模块不仅提升故障诊断效果,还改善RUL预测,验证了图自注意力模块的有效性。综上,方法3在所有指标(F1、RMSE、 )上均稳定优于方法1与2,尤其在平均性能上,验证了自注意力模块的有效性。方法3的F1分数高于方法1与2,分类精度提升。同样,方法3实现最低RMSE与最高 ,凸显其更优的预测能力。表9 不同特征融合方法的性能对比 图13 采用方法 1、方法 2 及方法 3 进行结果对比 图14 采用方法 1、方法 2 及方法 3 进行的 RUL 比较三种方法的RUL结果如图14所示。所有方法的图卷积神经网络RUL预测RMSE均较低,表明每种方法均实现良好的RUL预测。图14中观察到细微差异,与每个轴承的测试RMSE值一致。此外,明显可见所提方法(方法 3)在三个测试轴承上拟合效果最佳。方法3在健康与故障阶段均精准拟合真实RUL。这表明所提方法融合的特征可更有效区分健康与故障阶段,进一步验证所提方法在故障诊断中的优异性能。因此,采用图自注意力模块对每层图卷积特征向量加权数据融合,不仅提升模型故障诊断性能,还改善RUL预测效果。该提升归因于模型可根据每个任务的具体需求,自适应构建合适的特征向量,从而同步提升故障诊断与RUL预测任务性能。 基于实验结果分析,所提基于图神经网络的多任务模型有效融合轴承故障诊断与RUL预测,两项任务性能均表现优异。与单任务模型相比,该方法提升预测精度,同时显著降低多模型开发与部署成本。图自注意力模块通过自适应加权图卷积层特征表征,优先关注信息丰富的特征、过滤无关特征,发挥关键作用。该机制通过捕捉细微故障模式提升故障分类精度,在不同工况下的优异故障诊断性能验证了这一点。与其他融合方法(方法1与2)相比,图自注意力模块在故障诊断与RUL预测间实现更优平衡,确保任一任务性能不受损。此外,多任务学习策略实现相关任务间知识共享,提升泛化能力与鲁棒性。通过联合优化故障诊断与RUL预测,模型缓解数据稀疏问题,增强识别退化趋势的能力。相比单任务方法更优的预测性能,凸显融合诊断与预测信息的优势。因此,所提方法不仅为预测性维护提供更全面的方法,还优化维护效率、降低运行风险。其强大的实用潜力使其适配工业应用,支撑智能状态监测与健康管理策略。5 结论本文提出一种基于融合图同构神经网络与注意力机制的多任务模型的新型故障诊断与RUL预测方法。核心创新在于通过单一模型联合训练,同步实现故障诊断与RUL预测。所提模型通过参数共享与联合损失函数机制实现,仅用一个模型同步处理多任务,降低智能维护模型实施复杂度与成本,为工业设备健康管理提供更全面的决策支持。此外,采用图自注意力模块自适应加权图卷积层特征向量。与其他数据融合方法相比,所提方法有效平衡不同任务性能。通过三种不同工况的实验验证,所提多任务模型性能优于其他单任务方法,不仅精准预测RUL,在识别测试轴承故障类型方面也具备良好的故障诊断能力,有效避免运行机械突发故障引发的严重后果。作为基于深度学习的多任务模型,当前网络架构本质上仍为黑箱系统,内部决策机制缺乏可解释性。尽管注意力机制为特征权重分配提供部分可解释性,但故障模式识别与RUL预测间的跨任务关联机制、图结构与物理退化过程间的具体映射关系等关键方面,仍缺乏清晰的可视化解释。这种可解释性缺口可能阻碍模型在安全关键领域的实际部署,尤其在需要故障溯源与决策验证的场景,如航空发动机维护。未来工作应融合可解释人工智能技术,包括特征重要性分析、注意力路径可视化或模型蒸馏,建立物理退化过程与网络决策间的明确关联。 编辑:陈宇航校核:李正平、陈凯歌、曹希铭、赵学功、白亮、任超、海洋、Leo、Kira、Tina、王金、赵诚、肖鑫鑫、张优该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除来源:故障诊断与python学习

    未登录
    还没有评论
    课程
    培训
    服务
    行家
    VIP会员 学习计划 福利任务
    下载APP
    联系我们
    帮助与反馈