首页/文章/ 详情

基于CEEMDAN-KPCA与BiLSTM-Transformer的轴承剩余使用寿命预测预测
2小时前浏览0

本期给大家推荐基于CEEMDAN-KPCA与BiLSTM-Transformer的轴承剩余使用寿命预测混合预测方法。滚动轴承作为旋转机械的核心承载部件,其运行状态直接决定了整套工业设备的作业稳定性与安全性,精准的剩余使用寿命预测是规避设备突发故障、落地智能化预测性维护、降低工业运维成本的核心关键。在复杂工况干扰下,轴承振动信号易掺杂大量噪声,退化特征存在非线性、时序耦合性强等特点,传统预测方法难以有效挖掘深层退化信息,普遍存在特征提取鲁棒性不足、时序依赖建模不全面、泛化能力薄弱等问题,难以满足高精度寿命预测的工程需求。针对上述痛点,本文融合信号分解、特征降维与深度学习技术,构建了一种全新的混合式滚动轴承剩余使用寿命预测方法,通过多维度特征优化与双分支时序特征建模,实现轴承退化趋势的精准刻画与剩余使用寿命的高效预测。


论文基本信息

论文题目:A Hybrid Prognostic Method Based on CEEMDAN-KPCA and BiLSTM-Transformer for Bearing Remaining Useful Life Prediction  

论文期刊:IEEE TRANSACTIONS ON INSTRUMENTATION AND MEASUREMENT

Doi:10.1109/TIM.2026.3676093

作者:Guoxu Wang (a), Siyu Liu (a, b, *), Weidong Jiao (a, b,*), Zhilin Dong (a), Wanxiu Xu (a, b), Jianfeng Sun (a), Xiaohao Chen (a), and Yonghua Jiang (a, b)
论文时间:2026年
机构:

(a) College of Engineering, Zhejiang Normal University, Jinhua 321004, China

(b) Xingzhi College, Zhejiang Normal University, Lanxi 321100, China

作者简介:

刘思雨,中共党员,博士,硕士导师,校聘副教授,本硕博均毕业于江南大学,获自动化学士和控制科学与工程博士学位。2021-2023年赴加拿大University of Alberta(QS前100)进行博士公派联合培养2年。荣获2021年度江苏省高等学校科学技术研究成果奖(自然科学类)一等奖、博士国家奖学金,江南大学优秀毕业研究生、优秀博士学位论文。主持国家自然科学基金青年项目,浙江省青年基金项目,江苏省研究生科研创新计划项目,江南大学优博培育基金。在《Automatica》、《Journal of Process Control》、《International Journal of Robust and Nonlinear Control》、《ISA Transactions》、《Nonlinear Dynamics》等期刊上发表论文20余篇,其中第一作者发表论文18篇,SCI收录13篇,ESI高被引论文3篇,热点论文2篇。担任多个国际SCI期刊审稿人。(摘自浙江师范大学教师个人主页)

通讯作者邮箱:siyu.liu@zjnu.edu.cn; jiaowd1970@zjnu.cn

摘要

滚动轴承剩余使用寿命(Remaining Useful Life, RUL)预测对防范重大设备故障、实现预测性维护起到至关重要的作用。针对轴承故障预测问题,本文提出一种全新混合预测方法。所提方法包含两阶段预测框架: 首先,自适应噪声完备集 合经验模态分解(Complete Ensemble Empirical Mode Decomposition with Adaptive Noise, CEEMDAN)对振动信号进行自适应分解,从本征模函数(Intrinsic Mode Function, IMF)中提取多域特征;再通过核主成分分析(Kernel Principal Component Analysis, KPCA)完成非线性降维,将特征转化为鲁棒健康指标(Health Indicator, HI),保留累计方差占比85%的主成分,并选取第一主成分(First Principal Component, PC1),结合3δ准则精准判定退化起始点。 其次,经预处理的序列输入双分支网络:双向长短期记忆网络(Bidirectional Long Short-Term Memory, BiLSTM)捕捉双向时序依赖关系,Transformer 编码器通过自注意力机制建模全局上下文特征,完成 RUL 预测。 本文采用两套公开滚动轴承数据集对所提模型开展验证。分析结果表明,该方法具备较高预测精度;与其他对比方法相比,平均绝对误差(Mean Absolute Error, MAE)、均方根误差(Root-Mean-Square Error, RMSE)可降低10%~30%。在统一测试条件下,该方法性能优于各类对比算法,证明其在不同运行工况下具备强泛化能力,且RUL预测精度优异。

关键词:自适应噪声完备集 合经验模态分解、故障预测、核主成分分析、剩余使用寿命预测、滚动轴承

目录

1 引言

2 本文提出的混合预测方法

2.1 CEEMDAN-KPCA数据预处理

2.2 自适应噪声完备集 合经验模态分解

2.3 核主成分分析

2.4 健康指标构建

3 BiLSTM-Transformer模型搭建

3.1 Transformer网络搭建

3.2 BiLSTM网络搭建

3.3 混合预测方法整体架构

4 实验与结果分析

4.1 IEEE-PHM-2012挑战赛数据集

4.2 XJTU-SY挑战赛数据集

5 结论

1 引言

滚动轴承是机械设备的核心零部件,直接决定设备运行安全与稳定性,其性能退化会严重影响整套系统的可靠性。轴承长期承受交变载荷、工作环境复杂,极易出现磨损与性能劣化。因此,及时故障检测、精准的剩余寿命(Remaining Useful Life, RUL)预测对企业至关重要:能够辅助制定维护策略、规避潜在故障、提升生产效率。 但在复杂工况下,仅依靠人工经验评估轴承状态存在诸多局限,难以及时、精准调整设备运行状态 [1]-[4]。随着人工智能、统计学、预测与健康管理(Prognostics and Health Management, PHM)技术快速发展,该方向已成为国内外热门研究领域,不仅理论成果丰硕,同时在工业现场得到广泛落地。 工业监测数据存在特征冗余、有效信息密度低、属性复杂、噪声干扰强等问题,如何从中提取有效特征仍是PHM领域一大难题;如何精准表征设备健康状态、构建可靠健康指标(Health Indicator, HI)用于RUL预测,是该领域尚未完全解决的核心问题[5]-[8]。轴承RUL预测流程通常分为四步:特征提取、退化起始点识别、模型搭建、最终预测RUL。实际应用中,提取的特征与轴承退化状态高度相关。 时域研究方面,Yan等[9]提出相对均方根(Relative Root Mean Square, RRMS)、惯性相对均方根两个全新指标,用于表征轴承振动相对正常基准值的振动强度,以此描述轴承退化全过程。Ahmad等[10]采用在线递归更新回归算法跟踪轴承HI演变趋势,外推指标变化轨迹,实现未来指标数值预测与RUL估算。 上述方法虽得到大量研究,但在捕捉轴承长期退化趋势方面仍存在明显短板。

当前RUL预测方法整体可分为三类:基于模型的方法、数据驱动方法、混合方法[11]。基于模型的方法可深度解析轴承运行、磨损机理,依托物理模型实现精准 RUL 估算。Huang与Dietrich[12]提出一种基于截断威布尔分布、含时变形状参数的半解析方法,实现高精度轴承RUL预测。但物理模型构建需要大量专业领域知识、完整系统参数,难以适配多变工况与突发故障场景。

数据驱动方法仅依托历史数据即可完成预测,无需深入掌握轴承物理机理;可自主挖掘数据内部隐藏规律与有效特征,适配多种轴承类型。 例如,Wang等[13]采用主成分分析(Principal Component Analysis, PCA)融合多类退化特征,在降维同时保留关键信息。核主成分分析(Kernel Principal Component Analysis, KPCA)作为PCA的改进算法,专门用于提取高维数据中的非线性关联特征[14]。Zvokel等[15]将KPCA多变量监测与集 合经验模态分解(Ensemble Empirical Mode Decomposition, EEMD)结合,搭建非线性多尺度多变量流程监测与降噪框架,捕捉系统多尺度动态特性。 Zhou等[16]结合高斯混合模型与KL散度构建HI,再将HI输入强化门控循环单元(Gated Recurrent Unit, GRU)网络完成轴承RUL预估。 现有多数数据驱动研究通过修改、融合模型提升预测精度,但往往带来网络结构复杂化、计算开销上升、运行效率下降等问题;同时该类方法高度依赖大规模数据集,若数据质量差、存在缺失,模型性能会大幅衰减。

为解决上述缺陷,混合方法将统计类数据驱动算法与深度学习(Deep Learning, DL)模型结合,实现物理模型参数自动校准与自适应调整[17]。该融合思路让模型适配不同工况、不同数据集,提升RUL预测精度,同时可输出RUL概率分布;深度学习与物理模型结合的混合建模思路,在提升预测性能方面潜力巨大。 Zhang等[18]搭建基于 Transformer 的多尺度特征融合、域自适应模块,融合多尺度传感器特征,实现传感器数据域不变特性;基于多传感器多尺度特征融合网络(Multisensor Multiscale Feature Fusion Network, MMFNet)全面提取多传感器特征,提升故障诊断精度。 随后,Li等[19]提出基于回归指数慢特征分析结合双向长短期记忆网络(Bidirectional Long Short-Term Memory, BiLSTM)的预测方法,提升多方向工况下的预测精度。Jin等[20]摒弃单一输入形式,采用人工特征与原始信号融合的混合建模策略,将融合特征送入 BiLSTM 网络完成预测分析。 Guo等[21]搭建嵌入卷积块注意力模块的双通道 Transformer 网络,对轴承退化过程建模,实现概率化 RUL 预测。现有特征提取方法 会将原始序列拆分为大量复杂度各异的子序列,逐个子序列预测耗时久,降低整体预测效率;同时不同信号分解算法生成的子序列物理含义模糊。针对以上难点,本文提出一种全新混合预测方案:融合自适应噪声完备集 合经验模态分解(Complete Ensemble Empirical Mode Decomposition with Adaptive Noise, CEEMDAN)与KPCA的降维预处理与BiLSTM双通道Transformer网络。整体技术路线如图1所示。本文主要创新点归纳如下:

1)提出一套非线性数据预处理框架:采用CEEMDAN-KPCA完整刻画轴承各阶段退化规律;将第一主成分(First Principal Component, PC1)作为全新 HI,用于判定退化起始点。该框架显著提升HI的趋势性与可预测性,为精准定位故障前兆时刻(Failure Precursor Time, FPT)奠定基础。

2)搭建BiLSTM-Transformer预测模型,用于轴承全寿命退化过程预测:融合BiLSTM捕捉长时序依赖的优势、Transformer并行计算与全局上下文建模能力,提升特征利用率、加快训练收敛速度、大幅提高RUL估算精度;并行结构框架优化特征提取效率、加速模型收敛、显著提升RUL预测精度。

3)采用两套公开数据集完成模型验证,并与多种传统智能算法开展对比实验,证明该方法在不同运行工况下均具备更优预测精度与泛化能力;通过消融实验定量验证各核心模块的必要性,充分证明该方法的有效性与可靠性。
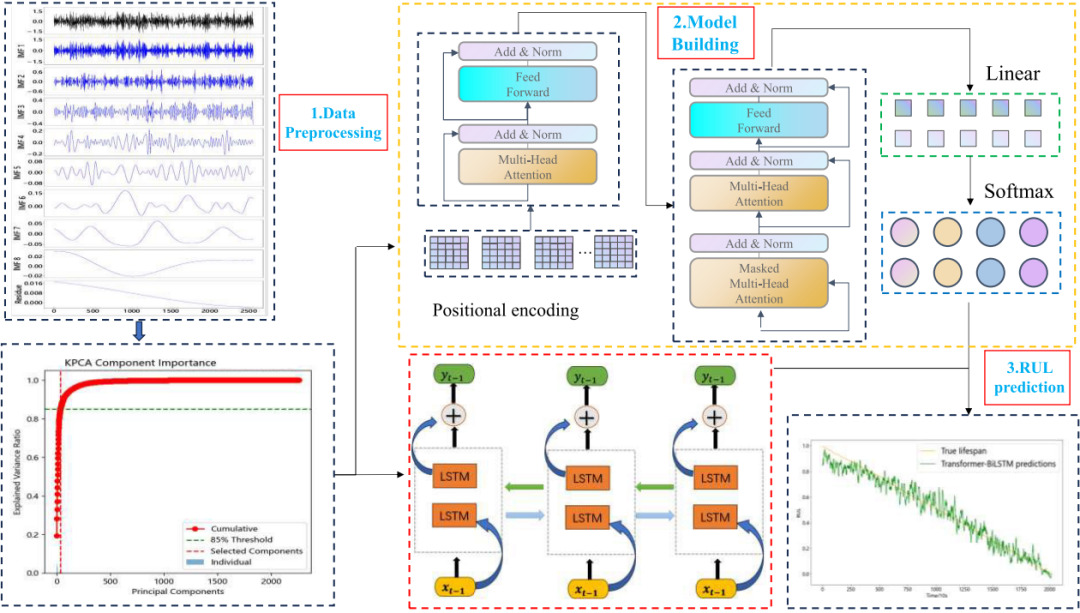
 

图1 基于BiLSTM-Transformer模型的RUL预测框架

本文剩余章节安排如下:第2节介绍所提数据预处理方法;第3节阐述模型搭建方案;第4节验证该方法的优越性与有效性;第5节为全文总结。

2 本文提出的混合预测方法

2.1 CEEMDAN-KPCA数据预处理

传统时域特征易受噪声干扰、分解子序列复杂度参差不齐,针对该问题,本文搭建CEEMDAN-KPCA非线性降维两阶段预处理框架。该协同方案通过CEEMDAN信号分解完成信噪分离,从IMF中提取多域特征、缓解模态混叠;再借助KPCA核技巧挖掘特征间非线性关联,将多特征融合为物理意义清晰的低维HI,兼顾噪声鲁棒性与非线性退化动态表征精度,为后续RUL预测提供可靠输入。CEEMDAN-KPCA完整流程如图2所示。
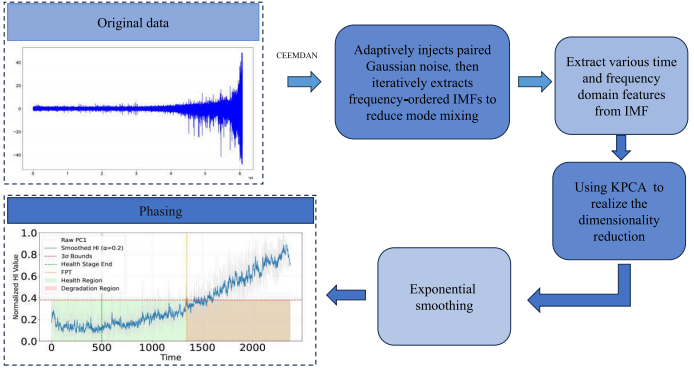
 

图2 CEEMDAN-KPCA流程图

2.2 自适应噪声完备集 合经验模态分解

针对高维时序特征、振动信号强噪声问题,本文采用CEEMDAN完成自适应分解,分解关键参数设置:最大模态数=8,噪声标准差=0.2,集成实验次数=100,随机种子=42。如图3所示,该噪声辅助分解算法将原始信号拆分为多组频率特征区分明显的IMF分量。 
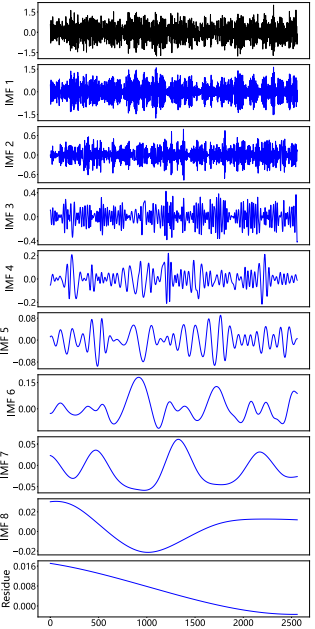
 

图3 CEEMDAN信号分解结果图

CEEMDAN相比EMD有两大核心改进:1)高斯噪声辅助集成平均;2)递进式分解流程。两项改进保障算法在非平稳信号下稳定运行。第一项改进在分解过程中注入可控噪声,再通过多次集成平均抑制残余噪声、消除模态混叠;第二项引入相位对齐递进策略[22],在初始分解阶段递归平均IMF候选分量,优化分量对齐效果、避免误差累积,突破传统递归分解算法的核心缺陷。

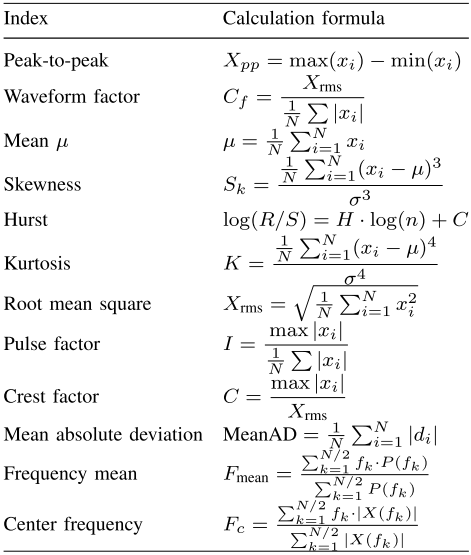
对原始信号执行CEEMDAN分解后,保留前8个代表性IMF用于信号重构。尽管CEEMDAN可大幅缓解模态混叠、提升分解稳定性,但重构信号仍存在残余高频噪声[23]。为进一步优化信号质量,本文基于各IMF时频特征提取多类诊断特征,保留更多有效信息;该多尺度特征提取框架充分挖掘多时间尺度下的信号信息,强化退化表征鲁棒性,为后续健康建模、RUL预测筑牢基础[24]。所需时域、频域指标汇总如表1所示。

表1 时域与频域指标及计算公式
 

2.3 核主成分分析

由前8阶IMF生成的故障特征向量存在高维冗余,本文采用KPCA实现非线性降维。对比多项式核、高斯核后,选取径向基核函数(Radial Basis Function, RBF):可隐式将数据映射至高维特征空间,把非线性可分问题转化为线性可分问题。 通过网格搜索在区间[0.005, 5]内优化核函数gamma参数;降维过程保留累计方差占比85%的前序主成分,保证关键信息不丢失。该方案两大核心优势:1)核技巧通过隐式映射规避高维计算复杂度;2)RBF的局部敏感特性,提升对非平稳退化规律的表征能力[25]。

2.4 健康指标构建

本文专门针对滚动轴承设计全新HI构建框架:经CEEMDAN、KPCA处理得到训练轴承非线性HI序列,用于FPT判定 [26];最终通过下式将HI归一化至0~1区间:


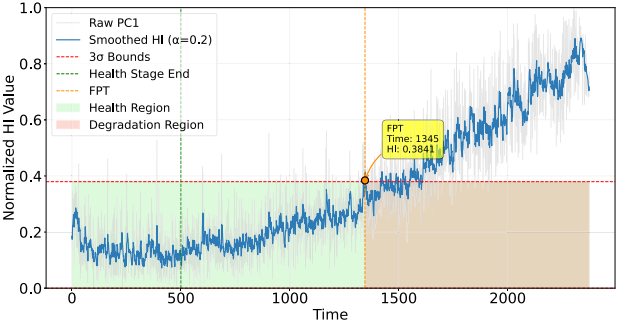
滚动轴承完整生命周期分为健康阶段(无需开展RUL预测)与故障退化阶段[27]。本文通过CEEMDAN+KPCA生成一维HI,其中PC1承载最核心退化趋势信息,可完整表征轴承性能整体变化规律。采用指数平滑消除序列波动;基于健康阶段HI均值m、标准差    构建    判定准则,划定状态监测(Condition Monitoring, CM)区间 [28];当连续3个HI数值超出该区间时判定触发FPT,削弱随机噪声带来的误判影响 [29]。FPT定义为首次突破CM区间的时刻,如图4所示。FPT数学判定条件:


式中,    代表第    个HI数值;m、    分别为健康状态CM区间的均值、三倍标准差。


图4 FPT检测过程示意图

为量化模型时序预测误差,本文采用三项评价指标:MAE、RMSE、决定系数    ,计算公式如下:


式中,    、    分别代表第    个样本的预测值、真实标签;    为真实数据平均值;    为总样本数量。

3 BiLSTM-Transformer模型搭建

完成HI构建后,预测模型需要精准捕捉退化序列内长期时序依赖与全局上下文信息,弥补单一网络架构表征轴承退化时序特征的缺陷。为提升预测精度与泛化能力,本文提出基于预处理特征的BiLSTM-Transformer预测架构,融合两类网络互补优势:BiLSTM提取序列双向时序依赖,Transformer依靠自注意力机制并行建模全局上下文关联。 

模型搭建分为三步:1)介绍BiLSTM、Transformer基础原理,阐明二者在时序特征提取、全局关联学习中的作用;2)设计BiLSTM-Transformer混合架构,详细说明模块融合策略;3)阐述完整实现流程,包含特征嵌入、位置编码、残差连接、层归一化,保证故障预测模型可复现部署。Transformer分支沿时间维度自适应平均得到全局特征向量;BiLSTM分支取最后一个时间步输出向量;将两路向量直接拼接后送入全连接层完成回归预测。加权特征融合框架如图5所示。
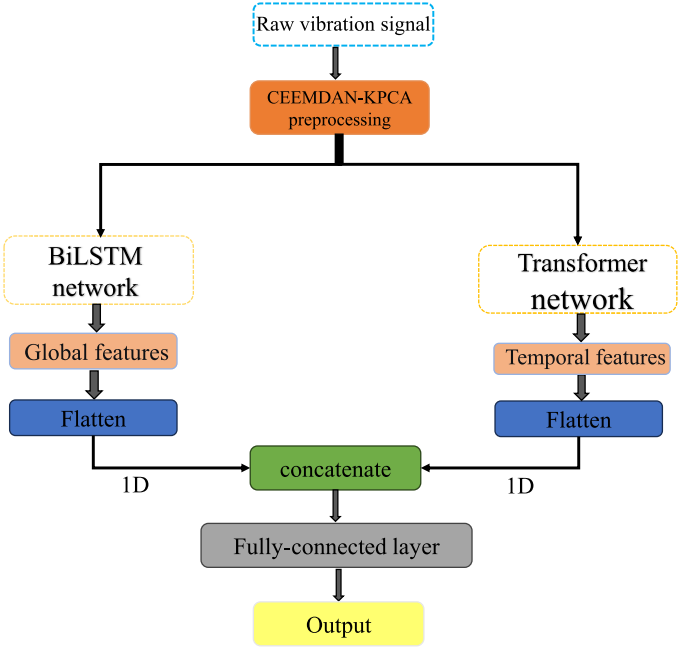
 

图5 BiLSTM-Transformer加权特征融合框架

3.1 Transformer网络搭建

Transformer 架构突破循环神经网络(Recurrent Neural Network, RNN)固有局限,具备三大核心优势[30]:

(1)多头自注意力机制替代串行递归计算,支持并行运算,同时消除梯度不稳定问题;

(2)编码器-解码器架构通过全局上下文建模捕捉超长距离依赖;

(3)内置位置编码层记录序列时序顺序,解决标准注意力机制无法感知位置的缺陷[31]。 如图6所示,该结构在局部、全局时序模式建模上性能全面优于RNN类模型。
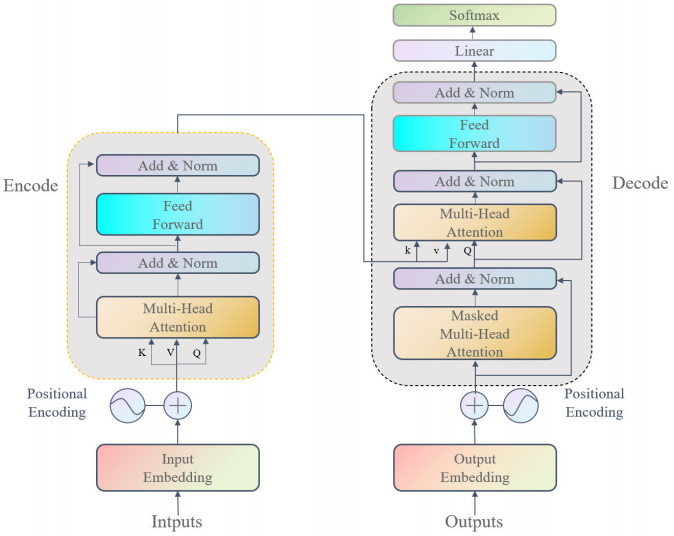
 

图6 Transformer网络整体架构

1)编码器-解码器架构

本文编码器、解码器架构存在两处核心差异: ①解码器引入掩码自注意力,屏蔽未来时刻信息,保证因果性;编码器可读取完整序列,实现全局特征充分提取; ②解码器采用跨模块参数设计:查询向量(Query,     )取自解码器状态,键向量(Key,     )、值向量(Value,     )来自编码器输出;结合位置编码,实现上下文语义与时序依赖联合学习。 

2)位置编码

标准Transformer无循环结构,无法天然感知序列先后顺序,因此引入位置编码层,通过数学公式建模输入序列元素的绝对、相对位置信息,将位置嵌入叠加至输入特征中,公式如下:


式中,    代表序列内元素位置;    为向量维度;    对应偶数维度;    对应奇数维度。 

3)多头自注意力

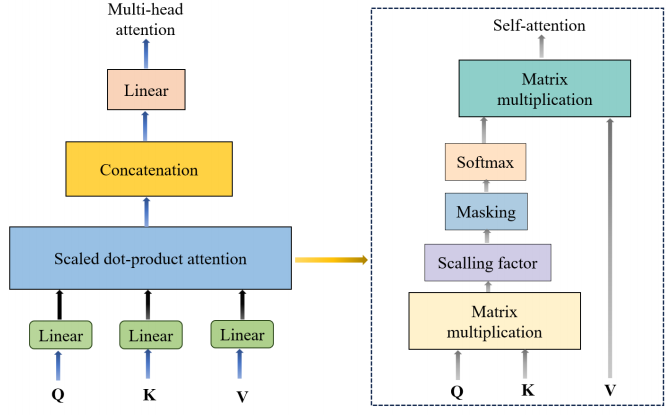
多头自注意力采用多组并行自注意力子模块,每组在独立特征子空间内计算注意力权重。如图7所示,各子模块并行完成查询-键值运算,将    、    整理为矩阵形式提升计算效率;全部子模块输出拼接后经线性变换得到最终特征表征。该并行设计使模型同时提取多特征子空间关联信息,精准捕捉序列内复杂依赖关系。计算公式如下:


式中,    、    、    矩阵由预处理轴承特征生成;    、    、    分别为    、    、    对应的权重矩阵;    为输入矩阵;    代表    向量维度。输入矩阵    送入并行自注意力模块,各模块输出拼接后线性变换,生成多头注意力最终表征。


图7 多头注意力网络结构

4)前馈网络

前馈模块采用两层全连接网络实现非线性特征映射:第一层通过非线性激活将特征映射至高维空间,增强表征能力;第二层压缩特征至原始维度,平衡参数量。该模块对序列所有时间步并行处理,共享参数保证各时序位置变换规则统一,兼顾特征表达能力与计算效率,适配同时需要局部抽象、全局一致性的时序预测任务。

3.2 BiLSTM网络搭建

BiLSTM网络采用双向架构,具有正向和反向两个时间方向的LSTM层处理序列。如图8所示,前向层捕获历史模式,反向层提取反映未来趋势的前瞻性特征。在图9中,两个方向的隐藏状态沿着时间维度串联,形成融合的双向表示,从而实现综合上下文建模,集成历史因果关系和前瞻性模式,用于复杂操作条件下的鲁棒退化轨迹学习[32]。 
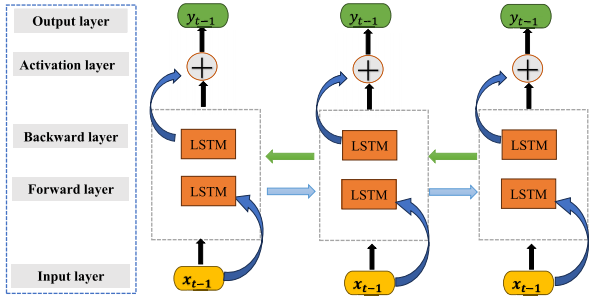
 

图8 BiLSTM网络结构
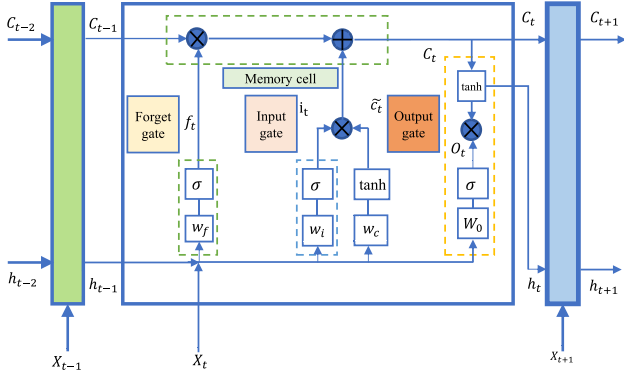
 

图9 BiLSTM网络的理论框图

BiLSTM前向传播计算流程:


式中,    为    时刻输入;    为隐状态;    为单元记忆状态;门控变量:    遗忘门、    输入门、    输出门;    、    、    、    分别对应前向LSTM输入门、遗忘门、输出门、单元的权重矩阵;    、    、    、    为对应偏置项;tanh为双曲正切激活函数,    为sigmoid逻辑函数。 BiLSTM反向传播计算流程:

BiLSTM反向传播计算流程:


式中,    为    时刻输入;    为反向隐表征;    为反向单元记忆状态;门控信号:    反向遗忘门、    反向输入门、    反向输出门;    、    、    、    分别对应反向LSTM输入门、遗忘门、输出门、单元权重矩阵;    、    、    、    为反向门控对应偏置。

3.3 混合预测方法整体架构

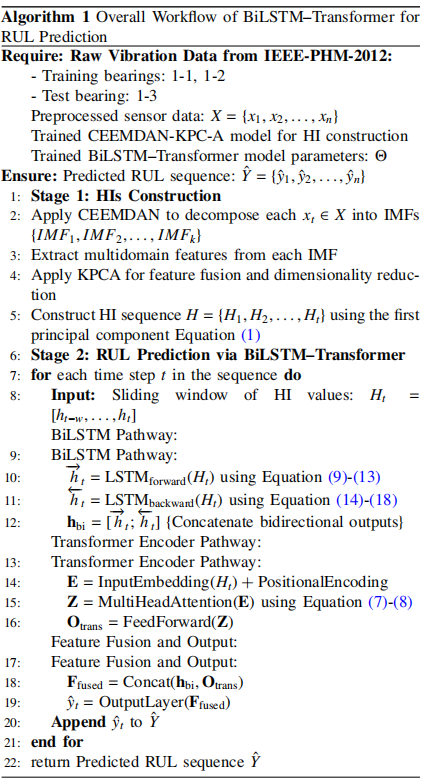
混合预测方法完整架构如图1、算法1所示,共四大流程:1)数据采集;2)特征提取;3)HI构建与FPT检测;4)模型搭建与RUL预测。
 

4 实验与结果分析

4.1 案例1:IEEE-PHM-2012挑战赛数据集

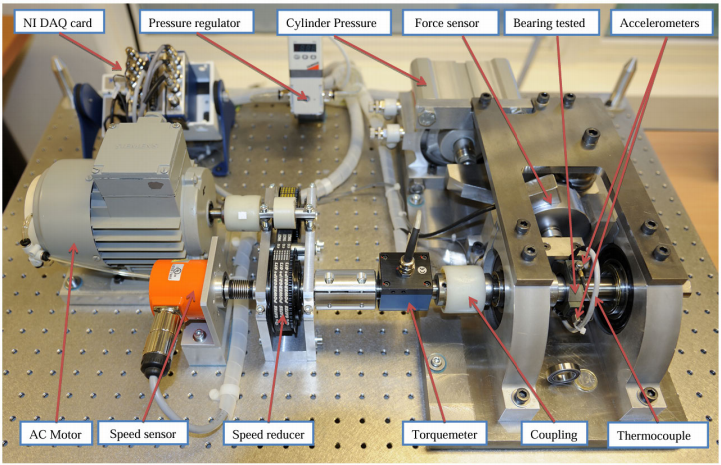
本文采用IEEE PHM预测挑战赛基准数据集[33]验证算法性能。实验数据采集自PRONOSTIA加速寿命实验平台,如图10;平台搭载正交布置压电式加速度传感器,同步采集水平、竖直方向振动信号。数据采集采用固定间隔触发机制:每10秒采集一段0.1秒时长信号,采样频率25.6kHz,完整覆盖轴承故障特征。如表2所示工况1(轴向载荷 4000N、转速1800rpm)中轴承1-1、1-2作为训练集,轴承1-3~1-7作为测试集。平台通过过载动态载荷加速轴承退化,在可控时间内采集完整全生命周期数据,生成具备工程代表性的退化轨迹,用于算法验证。

表2 工况参数
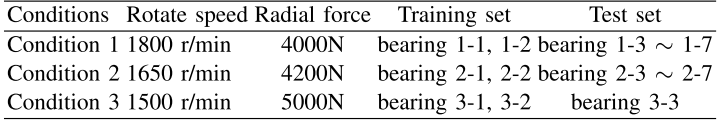


图10 PRONOSTIA实验台

1)数据说明

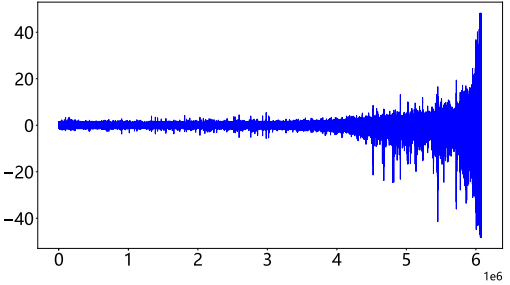
实验加载系统沿水平方向向被测轴承施加轴向载荷,该布置下水平振动信号包含更丰富健康相关信息。振动数据经CEEMDAN-KPCA预处理提取时频特征。图11为轴承1-3全生命周期振动信号:随运行时长增加,振动幅值持续上升,直观表征轴承健康退化过程。随后搭建BiLSTM-Transformer并行架构完成RUL预测,网络详细超参数如表3所示。

表3 模型参数设置
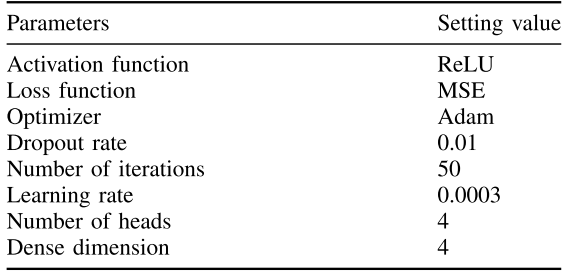


图11 滚动轴承全生命周期振动信号

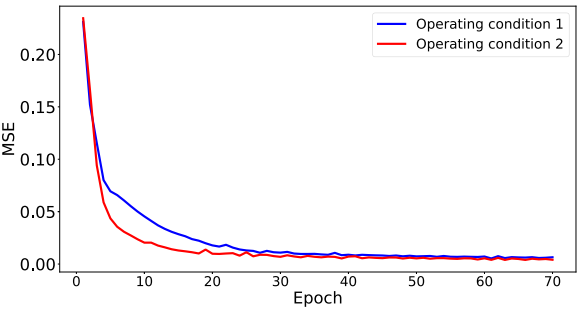
超参数优化阶段,系统分析迭代轮数、批次大小、学习率对模型的影响。图12训练损失曲线表明:两种工况下,迭代50轮后损失函数趋于稳定、模型收敛,因此迭代轮数设定为50。以工况1部分轴承数据集为例,分析批次大小、学习率对轴承RUL预测精度的影响,结果汇总如表4。最终最优参数:批次大小32,学习率 0.0003。基于该组参数,将所提模型用于1800rpm轴承数据集。

表4 参数选择
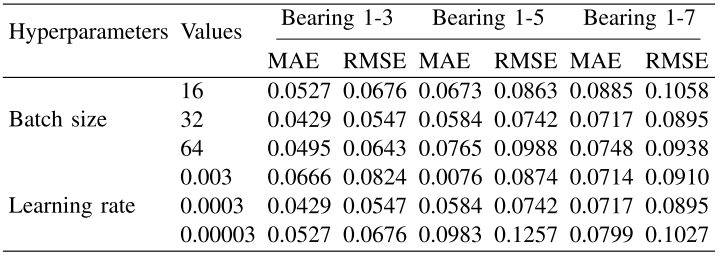


图12 不同工况下模型训练损失随训练轮次的演变趋势

如图13所示,轴承1-3、1-5的RUL预测值仅在真实值附近小幅波动,变化趋势与真实退化轨迹高度贴合,验证该模型可精准捕捉实际工况下轴承退化动态规律。
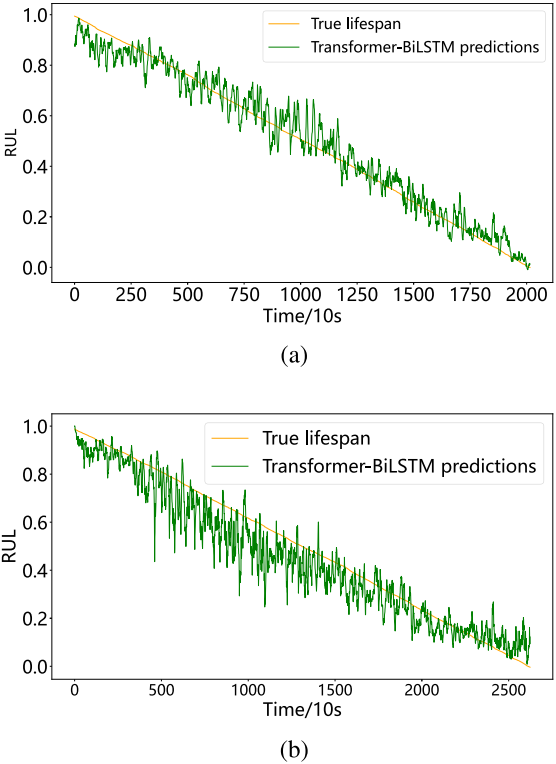
 

图13 采用所提方法获得的RUL预测结果:(a) 轴承1-3及 (b) 轴承1-5

2)案例 1 RUL预测结果 

为进一步证明所提模型在轴承 RUL 预测上的优越性,统一数据集条件下,选取四类经典算法(Transformer、CNN、LSTM、GRU)开展对比实验。定量结果如表5,可视化对比见图14。 

表5 滚动轴承轴颈预测结果的对比分析
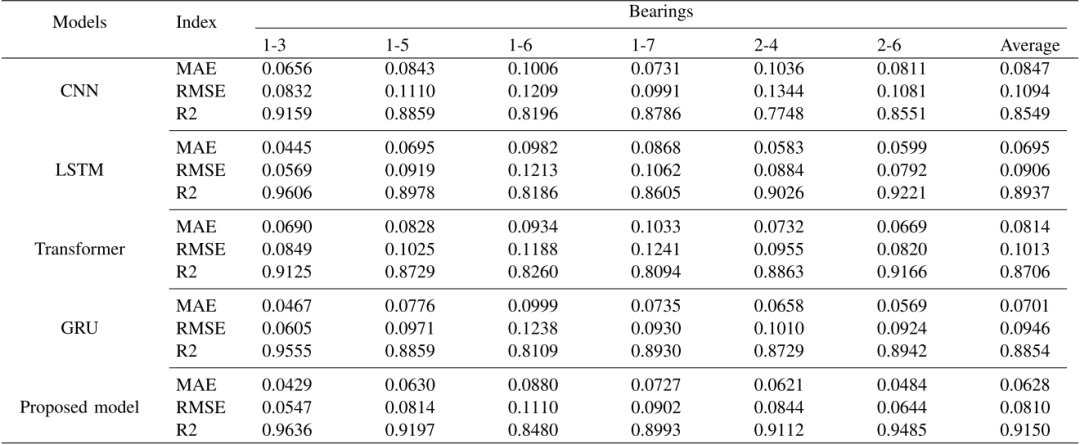
 

如图14 (a)和(b)所示,CNN依靠卷积核提取局部空间特征,但固定感受野限制其捕捉长时序依赖,RMSE、MAE数值偏高; 从图14 (c)和(d)可以发现,Transformer通过多头自注意力突破该局限,实现全局时空建模,两项评价指标全面优于CNN; 从图14 (e)和(f)可以发现理论上LSTM门控结构具备长依赖建模能力,但轴承退化场景存在多物理场耦合,易出现梯度衰减,早期故障特征丢失,预测误差高于Transformer; 从图14 (g)和(h)可以看出GRU作为LSTM简化变体,精简门控结构降低计算量,但复杂退化模式表征能力下降;GRU性能优于LSTM,但仍不及Transformer。 

相同实验条件下,本文混合模型RMSE、MAE在所有对比方法中最低,证明其特征学习能力优异,可有效融合各模块互补优势。上述结果证实该方法在真实工况轴承RUL预测任务中性能领先。
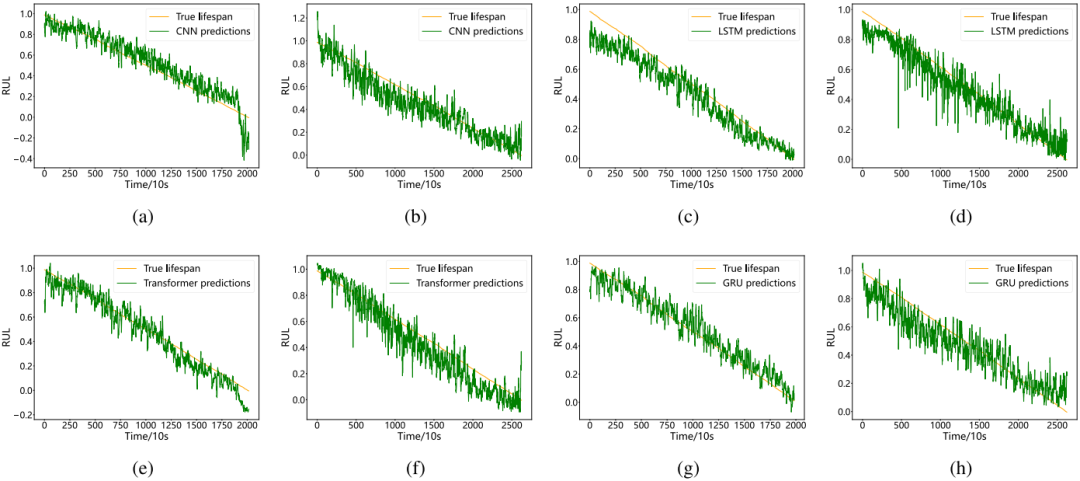
 

图14 不同模型对轴承1-3和轴承1-5的RUL预测结果:(a)与(b)为CNN,(c)与(d)为 LSTM ,(e)与(f)为Transformer,(g)与(h)为GRU

以轴承1-3为例,各类方法性能对比见图15:本文方法预测值与真实RUL偏差最小。如图16,计算全部预测值标准差、标准误差,生成等宽置信区间带,绝大多数预测结果落在真实标签95%置信区间内。
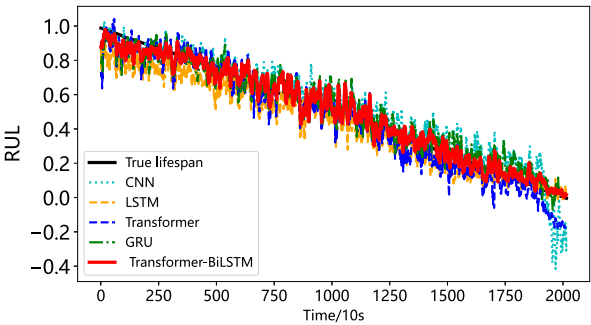
 

图15 案例1各方法预测曲线对比
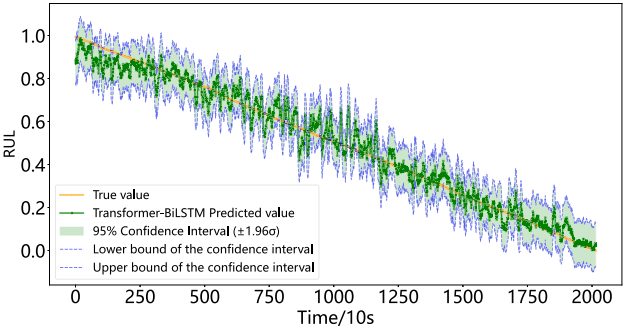
 

图16 95%置信区间预测图

绘制预测值-真实值散点图与拟合回归线(图 17),可见预测值与真实值高度贴近,近似一条直线[34]。
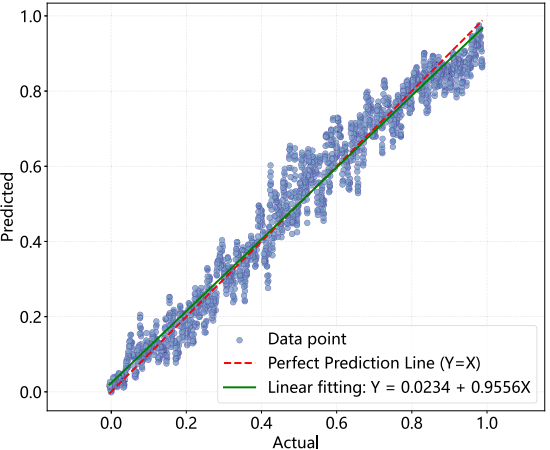
 

图17 预测值-真实值散点与拟合回归线

汇总多组轴承MAE、RMSE、均方误差(Mean Square Error, MSE)、      指标,评估模型跨工况鲁棒性。雷达图18显示本文混合方法整体MAE、RMSE最低,证明变载荷工况下性能稳定。性能分布图中,本文方法在MAE、RMSE维度始终处于最内层区域,变负载场景下优势显著。该优越性来源于两大特性:1)深度学习高维特征提取能力,从含噪信号中建模复杂退化规律;2)统计类数据驱动方法融合,通过概率置信区间量化预测不确定性。
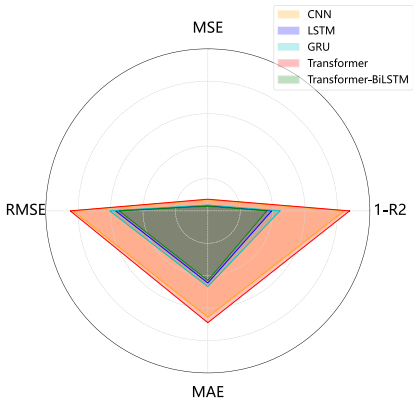
 

图18 案例1四类评价指标雷达对比图

3)消融实验对比

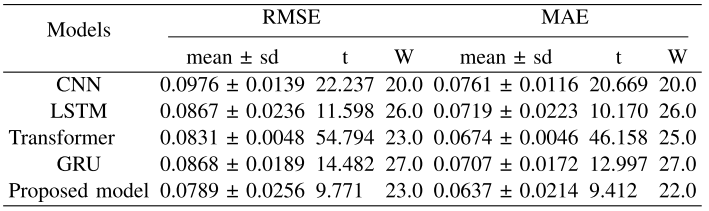
设计六组消融对比实验,验证框架各模块对 RUL 预测的增益:M1-M4依次移除四大核心模块(CEEMDAN、KPCA、BiLSTM、Transformer);M5、M6将CEEMDAN分别替换为EMD、EEMD,消融实验定量结果如表6。 为评估框架稳定性、可靠性,基于IEEE-PHM-2012数据集四组测试轴承,独立重复运行10次,统计RMSE、MAE均值与标准差(表7);采用配对t检验,对本文方法与基准模型预测误差开展统计学对比,定量分析预测精度差异并给出统计解释。

表6 消融实验结果对比
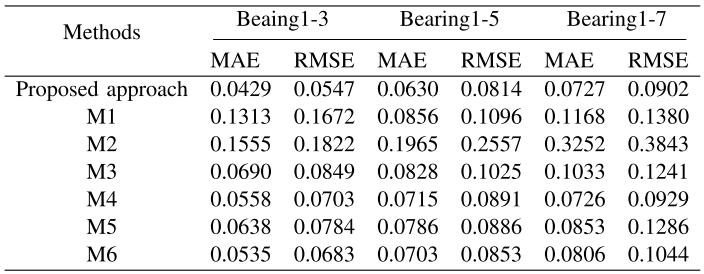
 

表7 标准差与配对检验统计量(T,W)
 

4)HI评价指标 

HI质量直接决定退化建模、RUL估算效果。本文采用趋势性(Trendability, Tr)、可预测性(Prognosability, Pro)两大指标量化HI性能 [35],计算公式如下:


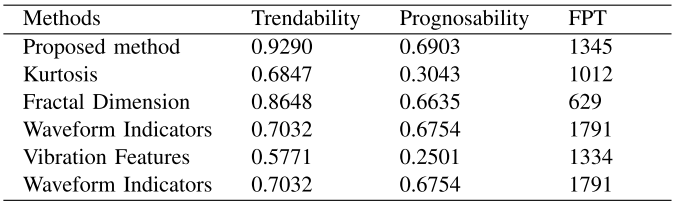
式中,    为HI序列长度;    为    时刻HI数值;    和    分别为HI初始基准值、失效临界值。 为全面验证本文HI构建方案,选取五种单指标HI构建算法作为对照(表8),并采用指数平滑消除HI噪声[36]。得益于多域特征提取与分层架构,该方法充分挖掘完整退化信息,趋势性、可预测性指标全面优于现有算法。

 表8 HI评估结果与FPT检测


4.2 案例2:XJTU-SY挑战赛数据集

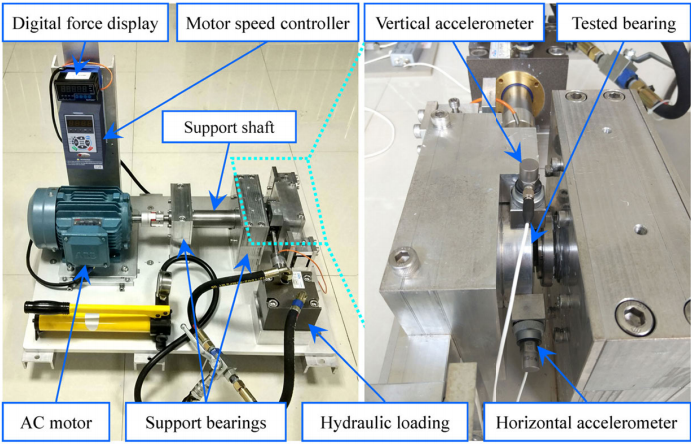
本文额外采用西安交通大学-昇阳(XJTU-SY)公开数据集[37]完成模型验证。实验平台如图19,包含变频驱动系统、动态加载模块、多通道传感单元,模拟多工况轴承振动;针对15组LDK UER 204轴承开展加速寿命实验,设置三类载荷-转速工况(表9),完整采集从初始微点蚀到最终失效的全退化数据。正交布置压电加速度传感器以25.6kHz采集振动波形,每60秒采集一段1.28秒时长信号,构建高分辨率时序数据库,平衡时间精度与存储开销。 每种工况下,前两组轴承全生命周期数据作为训练集,剩余轴承振动数据构成测试集用于模型评估。

表9 不同工况下实验参数的配置
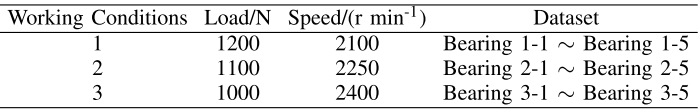


图19 XJTU-SY滚动轴承实验台

1)案例 2 RUL 预测结果

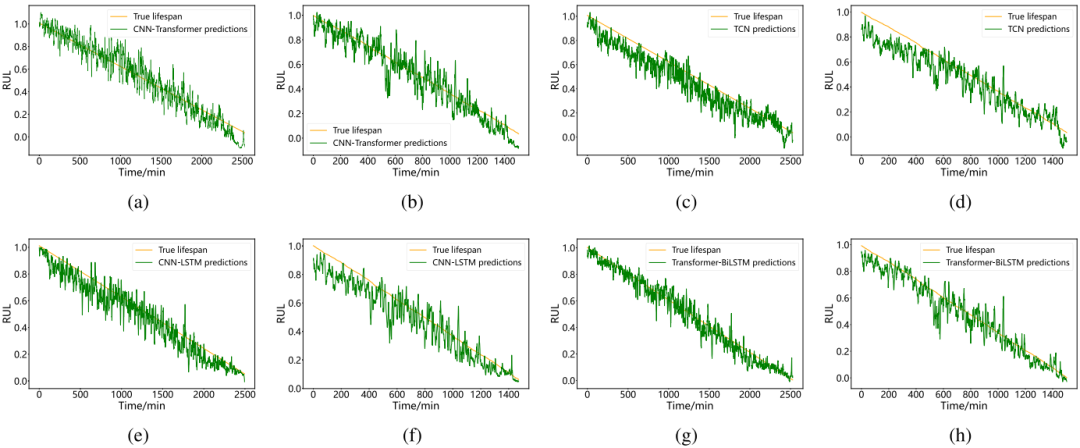
实验设置:每组工况前两组轴承完整生命周期数据用于训练,剩余轴承振动信号作为测试集评估模型性能。选取CNN-LSTM[38]、时域卷积网络(Temporal Convolutional Network, TCN)、CNN-Transformer[39]作为基准对比模型,采用 RMSE、MAE 定量评价性能,详细结果如表10,预测曲线见图20。从图20 (a)(b)可以看出CNN-Transformer结合CNN局部特征提取、Transformer全局时序建模能力,依靠多头自注意力并行处理时频特征,动态加权多尺度信息;从图20 (c)(d) 可以看出CNN-LSTM建模轴承退化过程存在梯度衰减问题,深层网络难以传递早期故障特征;从图20 (e)(f) 可以看出TCN采用空洞因果卷积构建分层时序感受野,可捕捉长周期退化规律,计算效率较高; 从图 20 (g)(h)可以看出本文BiLSTM-Transformer混合模型的预测误差最低,特征表征学习能力更强,RUL预测精度全面超越所有基准方法。

表10 不同模型的比较结果
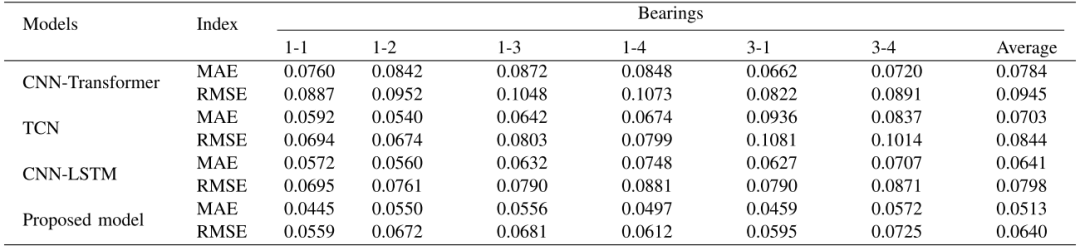


图20 不同模型对轴承3-1和轴承3-4预测结果的分析:(a)与(b)为CNN–Transformer模型,(c)与(d)为 TCN 模型,(e)与(f)为CNN– LSTM 模型,(g)与(h)为本文提出的模型。

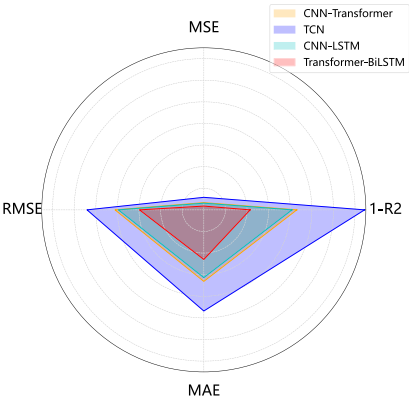
各类方法综合对比曲线见图21,展示单轴承、整体平均预测性能;实验结果表明本文方法预测值与真实RUL差值最小。 汇总多工况轴承MAE、RMSE、MSE、      四项指标绘制雷达图22:本文混合预测方法整体MAE、RMSE数值最低,所有指标稳定处于雷达图最内层,证明在多变运行场景下,该轴承健康监测RUL预测方案精度、鲁棒性更优。
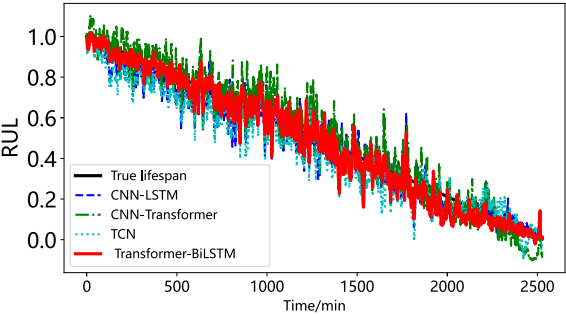
 

图21 案例2各方法预测曲线对比


图22 案例2四类评价指标雷达对比图

5 结论

针对滚动轴承RUL预测误差大、模型泛化能力不足的问题,本文提出一套全新混合框架:融合双通道Transformer双向LSTM 网络、KPCA非线性特征融合。采用两套公开轴承全生命周期数据集完整验证该方法,对比实验证明其性能优于现有主流基准算法。 实验结果证实,该混合框架可实现更高预测精度,核心优势来源于HI 构建、退化建模闭环融合。 未来的研究将聚焦于强化深度学习架构与非线性特征预处理方法的耦合关联;针对极端复杂运行工况,设计更鲁棒、自适应的阈值设定方案,进一步提升预测精度。


编辑:陈宇航

校核:李正平、陈凯歌、曹希铭、赵学功、白亮、任超、海洋、Leo、Kira、Tina、王金、赵诚、肖鑫鑫、张优

该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除


来源:故障诊断与python学习
ACT振动非线性化学旋转机械电力ANSA海洋UM参数优化理论电机多尺度人工智能DAP
著作权归作者所有,欢迎分享,未经许可,不得转载
首次发布时间:2026-10-15
最近编辑:2小时前
故障诊断与python学习
硕士 签名征集中
获赞 87粉丝 153文章 340课程 0
点赞
收藏
作者推荐

IEEE || ABIGX:一个可扩展的故障检测和分类的统一框架(下)

从对抗攻击视角重构故障重建,东南大学团队提出ABIGX统一框架,将经典CP/RBC诊断方法拓展至任意深度学习模型,理论证明其等价性,破解"故障类别涂抹"难题,在TEP、晶圆图及工业图像上验证,为智能运维黑箱决策提供可信归因工具。 本期给大家推荐这篇东南大学虞文武教授团队的论文。本文提出ABIGX(Adversarial Fault Reconstruction-Based Integrated Gradient eXplanation,基于对抗故障重构的积分梯度解释)框架,统一解决可解释故障检测与分类问题。核心创新在于:1)从对抗攻击视角重构故障重建,将传统CP(Contribution Plot,贡献图)/RBC(Reconstruction-Based Contribution,基于重构的贡献)方法扩展到非线性模型;2)提出分类SPE(Squared Prediction Error,平方预测误差)指标,使AFR(Adversarial Fault Reconstruction,对抗故障重构)适用于故障分类任务;3)结合集成梯度实现模型无关的变量归因。理论证明CP和RBC是ABIGX的线性特例,并分析"故障类别涂抹"问题,证明ABIGX优于传统梯度方法。实验涵盖多种模型,在TEP过程、晶圆图和MVTec-AD数据集上验证其优越的解释准确性与泛化能力。 由于文章篇幅过长,小编将分两次为大家翻译介绍这篇论文,第一篇推文(点击即达)系统系统综述了故障检测与分类的研究背景,指出传统CP、RBC方法受限于线性模型且无法处理分类任务,而现有深度学习解释器缺乏故障诊断领域的理论基础。基于此,作者从对抗攻击视角重新诠释故障重建,提出AFR方法及分类SPE指标,进而构建ABIGX统一框架——通过AFR生成语义有效的反事实基线,结合集成梯度实现任意可微FDC模型的变量归因,为后续理论分析与实验验证奠定基础。 本篇推文进一步涵盖理论证明与实验验证。理论层面,作者提出"故障类别涂抹"问题,证明ABIGX比显著性图和IG更能缓解该问题;同时证明CP和RBC是ABIGX在线性PCA检测器下的特例,实现经典方法与现代框架的统一。实验层面,在TEP化工过程、晶圆图及MVTec-AD工业图像上,ABIGX对PCA、AE、MLP、CNN、ViT等模型均展现出更优的解释准确性与一致性,验证了框架的泛化能力与实用价值。 文章质量很高。本文配套思维导图&论文精华速览,已同步至小红书:(ID:故障诊断与python学习),需要的小伙伴可以自取💡~ 论文链接:通过点击最左下角的阅读原文进行在线阅读及下载。 论文基本信息论文题目: ABIGX: A Unified Framework for eXplainable Fault Detection and Classification论文期刊:IEEE Transactions on Pattern Analysis and Machine IntelligenceDoi:https://doi.org/10.1109/TPΑΜΙ.2026.3689327作者: Yue Zhuo a , Duxin Chen a , Wenwu Yu a , Zhiqiang Ge a , Xiaoyu Jiang b , Jinchuan Qian c , Junhua Zheng c , Zhihuan Song d 论文时间: 2026年1月 机构: a School of Mathematics, Southeast University, Nanjing 210096, Chinab Hangzhou International Innovation Institute, Beihang University, Hangzhou 311115, Chinac School of Automation and Electrical Engineering, Zhejiang University of Science and Technology, Hangzhou 310023, Chinad School of Automation, Guangdong University of Petrochemical Technology, Maoming, 525000, Guangdong, China作者: 虞文武,东南大学首席教授、数学学院院长,入选教育部长江学者、青年长江、国家"万人计划"青年拔尖人才、国家优青,2014-2024连续十一次入选全球高被引科学家。主要从事系统科学与人工智能交叉研究,发表IEEE汇刊文章100余篇,Google和SCI引用超3万次,H指数75。主持科技部"新一代人工智能"重大项目等多项国家级课题,获国家自然科学二等奖1项、省部级一等奖3项;任Complex Engineering Systems主编及多个IEEE汇刊编委。(来源:Research)摘要本文提出了ABIGX,一种用于可解释故障检测与分类的统一框架。ABIGX建立在已有故障诊断方法的基础原理之上,包括贡献图和基于重构的贡献,同时将其适用范围扩展至通用FDC模型,并提升了故障解释效果。ABIGX的核心在于对抗故障重构方法,该方法从对抗攻击的视角重新审视故障重构,引入了一种适用于故障检测与分类任务的新型故障指标。在故障检测方面,我们通过理论证明CP和RBC是ABIGX的线性特例,从而建立了ABIGX与传统故障诊断方法之间的理论联系。对于故障分类,我们解决了故障类别模糊化问题——这是可能掩盖准确解释的固有缺陷。我们证明了ABIGX能够有效缓解该问题,其性能优于现有的基于梯度的解释方法。实验通过定量指标和直观图示对FDC(Fault Detection and Classification,故障检测与分类)的解释效果进行了评估。结果验证了AFR的通用性与准确性,并表明ABIGX在多种FDC模型上提供了更为全面和精确的解释,相较于现有方法具有显著提升。实现代码已公开发布于:https://github.com/qianjc3391/ABIGX。 关键词:特征归因;综合梯度;可解释的人工智能;反事实解释 目录1 引言2 预备知识及相关工作 2.1 FDC 2.2 故障诊断 2.3 基于梯度的XAI方法 2.4 对抗攻击 2.5 可解释FDC的挑战3 故障重建:对抗视角 3.1 对抗故障重建 3.2 故障分类的SPE指标 3.3 AFR算法 3.4 AFR与对抗攻击的对比4 ABIGX:统一框架 4.1 定义 4.2 算法 4.3 讨论5 ABIGX在故障分类中的应用 5.1 故障分类设定 5.2 故障类别涂抹6 ABIGX在故障诊断中的应用 6.1 RBC与ABIGX-OneVar 6.2 CP与ABIGX7 实验 7.1 评估指标与对比方法 7.2 田纳西伊斯曼过程 7.3 晶圆图 7.4 MVTec-AD工业图像 7.5 计算成本 7.6 实现细节8 结论注:小编能力有限,如有翻译不恰之处,请多多指正~ 若想进一步拜读完整版,请下载原论文进行细读。 5 AIBGX在故障分类中的应用本节介绍故障类别模糊化问题——这是故障分类模型中固有的问题,会导致误导性的变量贡献,并使准确识别故障真正原因变得困难。针对该问题,我们对故障分类中变量贡献的正确性进行理论分析。我们表明,显著性图直接受到故障类别模糊化的影响,而IG(Integrated Gradients,积分梯度)提供了一定程度的缓解。然而,我们的分析证明ABIGX对该问题的缓解效果最佳,能够提供最准确的解释。这些发现为ABIGX在故障分类模型上的卓越可解释性奠定了坚实的理论基础。 5.1 故障分类设定 首先,我们构建一个故障分类数据集和模型的玩具示例。不失一般性,假设不同故障类型发生在不同变量上:示例 1(玩具故障分类数据集)。假设所有正常变量独立同分布地采样自高斯分布 ,所有故障具有相同的幅度f,并且受损变量服从分布 。为简单起见,我们假设故障类型y在方向 上有一个受损变量。那么具有M个变量和N种故障类型的故障分类数据集定义为 (N<M):其次,我们为该玩具示例构建线性分类模型,以实现所有类别的最佳分离: 定义6.(线性分类器)设 为线性分类器的权重,其行向量 ( 对应于各故障(或正常)类别的线性决策边界。基于Fisher线性判别分析[35],最优行向量通过最大化类间均值距离并最小化类内方差进行训练: 其中 为故障类别y的均值向量, 为类别均值的均值, 为各类协方差之和。 基于示例1中的数据集和定义6中的线性分类器,我们可以证明最优模型权重:定理2. 设 为故障类别y中变量i的最优模型权重。对于正常类别y = 0,最优 为:对于故障类别y,最优 为:证明. 证明详见附录A.1.1。 5.2 故障类别涂抹 在可解释人工智能领域中,XFDC(eXplainable Fault Detection and Classification,可解释故障检测与分类)旨在帮助人们理解导致故障的潜在因素。给定一个故障样本,XFDC指示各变量对监测结果(检测分数或分类置信度)的贡献程度。贡献度较高的变量被视为异常的潜在根本原因(如故障传感器)。通过识别这些变量贡献,XFDC能够辅助用户解释模型预测的故障,并主动修复存在缺陷的部件。5.2.1 模型权重 本节正式介绍故障类别模糊化问题——这是故障分类模型中固有的挑战,并分析其对基于梯度的解释方法的影响。故障类别模糊化产生于分类器的优化目标导致无关变量上出现非零权重,进而扭曲显著性图和IG(Integrated Gradients,积分梯度)等解释器的归因分数。定义 7.(模型权重中的故障类涂抹)给定故障类型为y的受释故障样本x(如示例 1 中所定义),以及具有最优权重 的故障分类器,变量贡献在模型权重中被涂抹到其他不相关的变量上:其中 。这些在不相关的故障变量上的非零权重会导致基于梯度的解释器高估它们的贡献,从而产生误导性的归因。为了定量评估故障类涂抹的程度,我们定义了故障类涂抹 (FCS) 指标,该指标测量了错误分配给不相关变量的总归因比例:直观地说,故障类涂抹的发生是因为分类器不仅必须将故障样本与正常样本区分开来,还必须区分不同的故障类型。这导致了跨多个类的共享权重,其中与其他故障类型相关联的变量仍然获得非零权重(例如, ),尽管它们与当前的故障类y无关。另一方面,不对应任何故障类的变量(即,如公式5所示的其余M-N个变量)通常具有零权重,并且不会引发涂抹。这种现象对模型解释来说是个问题:当解释方法直接依赖于模型梯度或权重(例如,显著图或IG)时,变量贡献可能反映的是类可分性偏差,而不是与故障相关的根本变量。在接下来的小节中,我们将从理论上分析这种涂抹如何影响不同的解释方法,以及ABIGX如何减轻它。5.2.2 显著图 显著图简单地计算模型输出关于输入变量的梯度的绝对值。线性模型的梯度就是它的权重,因此显著图贡献直接受到了故障类涂抹问题的影响。定理 3.(显著图中的故障类涂抹)给定所解释的故障类型y及其真实变量 y,显著图的贡献被涂抹到其他不相关的变量上:显著图中 FCS 的程度为:5.2.3 IG 这些在不相关变量上的涂抹权重在故障分类模型中是不可避免的。一个好的解释方法应该有效地减轻涂抹权重对变量贡献的影响。接下来,我们讨论IG方法中的故障类涂抹。定理 4.(IG中的故障类涂抹)给定所解释的故障类型y及其真实变量y,以及正常样本期望的基线 ,IG贡献的期望为:IG中故障类涂抹 (FCS) 的程度为: 证明. 证明详见附录 A.1.2。 5.2.4 ABIGX 随后,我们分析了ABIGX中的故障类涂抹,表明ABIGX以更低的FCS程度优于IG。定理 5.(ABIGX 中的故障类涂抹)ABIGX中的故障类涂抹程度低于IG: 证明. 证明详见附录 A.1.3。 5.2.5 与故障涂抹的比较 先前在CP和RBC研究中讨论的故障涂抹 [7], [36] 是由所有输入共享的相同权重引起的,因为检测模型只输出一个标量(例如,SPE故障指数)。尽管每个故障类的模型权重都是唯一的,但我们表明分类器仍然会对不相关的变量分配权重(由于区分不同故障类型的任务)。这些非零的不相关权重涂抹了变量的贡献。总而言之,故障类涂抹论证了故障分类中故障涂抹问题的现象和原因。6 预备知识及相关工作本节介绍了ABIGX如何统一地重新构架两种基本的故障诊断方法CP和RBC。对于基于PCA的故障检测,我们指出CP和RBC都是ABIGX的特例。图 5 直观地展示了通过两个特定的经AFR重构的样本 和 ,CP和RBC与ABIGX的等价性。在下文中,基于 PCA 的检测器用其残差子空间投影矩阵表示: 6.1 RBC与ABIGX-OneVar第4节讨论了ABIGX源于RBC的思想。此外,我们证明了RBC是具有AFR-OneVar的ABIGX的线性特例。引理 1. (故障重构性质) 使得 最小化的故障重构中的 值为: 定理 6. (RBC与ABIGX的等价性)RBC等价于使用单变量AFR的ABIGX (即ABIGX-OneVar): 证明. 证明过程见附录A.2.1。 6.2 故障诊断CP与ABIGX故障检测模型的解释——通常称为故障诊断——已得到广泛研究[7]、[6]、[9]、[23]。一旦检测到故障,故障诊断旨在通过量化各输入变量对故障指标(如SPE)的贡献程度,识别其根源变量。下文简要回顾三种常用于基于 PCA 模型的经典故障诊断方法。 我们证明CP也是ABIGX在 范数AFR下的线性特例。首先,我们计算PCA在 范数距离约束下的AFR重构样本:引理2.(PCA的AFR)在 范数距离约束下,基于PCA的故障检测的AFR重构样本 为: 这意味着重构向量恰好是残差子空间投影。 证明.证明见附录A.2.2。 随后,我们可以证明CP与ABIGX的等同性。定理7.(CP与ABIGX的等同性)CP与 范数AFR下的ABIGX等同: 证明. 根据引理2中的 ,ABIGX为(省略 的下标):由式(35),我们有 ,因此得到ABIGX贡献: 这与 等同。此外,受引理2的启发,我们讨论了基于梯度的攻击的可行性,这也是AFR和ABIGX的默认算法:注 1. (针对PCA的基于梯度的攻击) 基于梯度的攻击总是沿着残差子空间投影的方向重构故障。证明. PGD每一步的对抗扰动为: 其中L是一个标量。 这与直觉一致,因为残差投影指向SPE下降最快的方向。7 实验 7.1 评估指标与对比方法我们引入两类定量指标,用于对解释方法进行公平评估:正确性[37]衡量变量贡献与根源变量之间的差异。更优的解释应更接近真实值。具体而言,Correctness-AUC将贡献视为二分类预测分数,通过改变贡献分数的负类阈值,计算受试者工作特征曲线下的面积[38]。正确性也可通过累加真实值上的归因分数来度量,称为Correctness-SUM。一致性[39]检验贡献是否聚焦于模型真正关注的区域。更优的解释方法应与模型行为具有更高的一致性。Consistency-ADD指标逐步将解释故障样本的变量值添加至正常样本。通过滑动贡献阈值,贡献最大的变量首先被添加,贡献最小的最后被添加。更优的解释方法应使模型预测分数上升更快,这可通过阈值相关的预测分数曲线下面积进行量化。相反,Consistency-DEL首先删除最重要的变量,直至所有特征均被正常样本替换。类似地,更优的方法应使模型预测分数下降更快,这可通过阈值相关的AUC进行度量。对于基线方法,我们引入了几种先进的基于梯度的XAI方法,包括:• 显著性图:输入变量梯度的绝对值,最常用的特征归因方法。• DeepLift[40]:一种梯度反向传播解释方法,能够妥善处理IG(Integrated Gradients,积分梯度)可能产生误导结果的情形。• 原始IG[16]:提出的原始IG方法,使用全零向量作为基线。• 期望IG[41]:IG的一种变体,使用来自数据分布的信息性基线(即本实验中的正常样本),通过对IG归因求期望来缓解基线选择的影响。• 重要方向梯度积分[42]:IG的一种变体,仅直接关注与梯度对齐的重要方向,在本实验中基于原始IG构建。• 引导IG[43]:IG的一种变体,基于梯度构建积分路径,使用全零向量作为基线。• AFR+ 引导IG:我们使用AFR重构样本作为基线,但将ABIGX的默认直线路径积分替换为引导IG的路径构建算法,作为消融设置以验证ABIGX中AFR基线的有效性。为确保公平比较,我们将所有基于IG的方法(原始IG、期望IG、引导IG和IDGI)的主要超参数——步长,设置为与ABIGX相同。所有实验在INTEL CORE i7-12700K CPU上运行TEP数据集的PCA、AE和MLP模型,在单块NVIDIA GeForce RTX 3080 GPU上运行Wafermap数据集的CNN模型和MVTec-AD数据集的ViT模型。7.2 田纳西伊斯曼过程7.2.1 数据集描述为使TEP设置自成体系,并阐明各故障的物理含义,我们在附录中提供了TE过程流程图及文献[18]中的官方变量和故障描述(图B.1、表B.1)。这些材料明确了故障注入位置(物流、单元)、涉及的执行器和传感器,以及预期的一阶响应,对于解释诊断性能和特征级归因至关重要。我们的解释正确性指标依赖于为每种故障精心筛选的根源变量 集 合,该集 合源自经典TE过程文献并汇总于附录表B.2。除列出变量索引外,该表还提供了逐故障的推理依据,基于(i)注入位置、(ii)最直接受影响的测量变量和执行器、以及(iii)过程结构和控制回路,将各故障与其根源变量相关联。我们在报告基于根源变量的正确性分数时,将其作为真实值参考。这一故障-变量关联亦与代表性TEP诊断工作[9]、[44]、[45]中采用的故障语义相一致,从而使我们的故障-变量映射成为与文献对齐的、透明的经典TEP故障定义表征,用于解释评估。 图6 为NN分类器对TEP故障6的解释对比,图中实根变量为红色。故障6由根变量XMEAS ( 1 )和XMV ( 3 )引起,故障14由XMEAS ( 9 ),XMV ( 10 )和XMEAS ( 21 )引起,详见表B.2 为清晰起见,图6直观展示了两种TEP故障类型(故障6和故障14)的解释对比。该图分别展示了故障检测和分类模型的传感器变量贡献,其中每个图的四个子图展示了四种不同技术解释的变量贡献。对于TEP数据集,我们采用了文献[46]中的绘图风格。水平轴表示变量贡献值(含方向)。变量按重要性在垂直轴上排序,其中展示了贡献最大的四个变量。值得注意的是,图中还通过彩色分布展示了变量(特征)值与其贡献之间的相关性。7.2.2 可解释故障检测 故障诊断与ABIGX的等价性:第6节从理论上证明了两种故障诊断方法与ABIGX之间的等价性。在TEP故障的PCA检测器上,我们计算了它们之间的经验误差,即所有变量贡献的均值。表2报告了结果,表明差异足够小(尤其在使用MILP求解AFR重构样本时)。解释结果:首先,图6a绘制了TEP数据集上AE模型不同解释方法的直观对比,表明ABIGX将最高贡献分配给了根源变量。同时,其他方法未能提供完整的解释。表3报告了TEP上AE检测解释的四项评估指标,涉及14种故障类型。总体而言,ABIGX方法优于其他解释方法,包括故障诊断方法(CP和LLBBC [47])以及基于IG的深度学习解释器(DeepLift不适用于故障检测)。通过比较期望IG与原始IG和IDGI,可以发现全零基线对故障检测解释产生了不利影响。ABIGX-OneVar提供了最接近真实值根源变量的解释。独立归因变量的显著性图在正确性指标上也表现良好。另一方面,ABIGX提供了最匹配模型行为的解释。我们认为,考虑变量交互的解释更接近模型实际处理样本的方式。基于消融研究(AFR+引导IG),在TEP数据集上使用AFR重构基线结合引导IG的自适应路径,相较于原始引导IG均有持续提升,同时相对于ABIGX具有竞争力的性能表现。7.2.3 可解释故障分类 与故障检测类似,图6b绘制了基于NN的TEP故障6分类器解释。ABIGX的优势体现在变量XMV(3)上。ABIGX为该变量分配了更高的贡献,而显著性图甚至忽略了该变量,其原因已在第4.3.2节中分析。表4报告了故障分类的解释指标,各方法性能与检测任务类似。ABIGX总体上仍表现更优,即使在正确性指标上(AUC除外)。ABIGX-OneVar仍然强调正确性,但模型一致性较差,这与显著性图类似。DeepLift与原始IG性能相近。尽管IDGI和引导IG相较于原始IG方法表现出性能提升,但由于其基线缺乏信息量,即使在期望IG设置下,在故障分类任务中仍不具竞争力。分类SPE指标的验证:通过ABIGX-AdvAFR进行消融研究。与第3.2节提出的ABIGX分类SPE不同,ABIGX-AdvAFR采用原始对抗攻击目标(即最小化正常类别的Softmax输出置信度)进行故障重构。ABIGX总体上优于ABIGX-AdvAFR,验证了本文提出的新型分类SPE指标在故障重构中的有效性。 7.2.4 故障级解释为清晰展示TEP数据集上的归因对比,附录图B.2和B.3以及表B.4和B.3呈现了故障检测和分类模型在所有TEP故障类型上的详细实验结果。这些图可视化了ABIGX在数据分布中对排名靠前变量的归因,而表格则通过报告故障级别的根源变量排名来比较各方法的归因性能。具体而言,根源变量出现在归因前三位中的比例及其平均排名表明,ABIGX在大多数故障类型上与真实值故障变量的一致性最高。为探究模型精度与ABIGX解释质量之间的相关性,图B.4详细分析了ABIGX在所有TEP故障类型上的归因性能,并按不同FDC模型的正确预测和错误预测样本分别展示。结果凸显了两个关键发现:(1)预测精度较高的故障类型往往表现出更准确的ABIGX归因;(2)在每个故障类型内部,正确预测样本的归因正确性通常高于误分类样本。这些发现表明,ABIGX解释与模型置信度密切相关——当模型成功检测故障时,其能够忠实地归因有意义的贡献;而当模型失效时,则揭示出归因的不确定性。 7.3 晶圆图 7.3.1 数据级描述晶圆图分析在半导体日常制造运营中至关重要。晶圆图提供了视觉细节,对于识别晶圆故障模式发生的制造阶段具有关键作用。我们研究了晶圆图故障模式分类的解释,其目标是确定晶圆图中哪些像素是故障根源。我们在WM-811K数据集[48]上训练了一个基于CNN(Convolutional Neural Network,卷积神经网络)的故障分类器,选取了四种故障类型(中心型、边缘局部型、边缘环型和划痕型)。故障和正常晶圆图如图7所示,其中真实值根源像素由红色圆圈标注。绿色像素表示正常芯片,黄色像素表示缺陷芯片。当不存在特定缺陷芯片模式时,晶圆图为正常(如图7左上角所示)。 图7 CNN分类器对四种具有不同故障模式的采样晶圆图的解释,其中真实根像素以红色为圆心7.3.2 可解释故障分类图7和表5中呈现的实验结果提供了多种解释方法在用于识别晶圆图故障模式的CNN分类器上的对比分析。ABIGX在所有故障类型中均表现出高度聚焦且清晰的解释效果,与标注的真实值区域高度吻合。这种清晰性表明ABIGX能够有效识别与模型分类决策最相关的区域。其他方法如显著性图、原始IG和IDGI则产生更为分散且聚焦性较差的解释。可以发现,原始IG和IDGI中使用的黑色基线导致了较差的解释效果。DeepLift和期望IG表现中等,其解释清晰度优于显著性图和原始IG,但缺乏ABIGX所具有的精确性。 表5 解释方法的评价指标(在晶圆图CNN分类器上) 表5量化了各方法在四项关键指标上的性能。ABIGX在正确性(AUC(Area Under Curve,曲线下面积):0.839)和一致性(ADD:0.859,DEL:0.040)上均取得了最高分数,表明其在准确识别关键区域的同时,生成的解释具有高度一致性。相比之下,显著性图和原始IG总体表现最低。DeepLift和期望IG在正确性方面表现良好,但在一致性上逊于ABIGX。引导IG(Guided IG,引导积分梯度)在正确性和一致性之间取得了平衡,其分数具有竞争力但未能超越ABIGX。使用AFR(Adversarial Fault Reconstruction,对抗故障重构)重构基线结合引导IG的自适应路径(AFR+引导IG)始终优于原始引导IG,且与ABIGX具有竞争力,证实了AFR基线改进在不同路径选择下均持续有效。晶圆图故障解释实验验证了ABIGX的泛化能力,其不仅适用于表格型传感器数据,还适用于CNN模型训练的图像等非结构化数据。 7.3.3 ABIGX详细解释 附录图B.5展示了ABIGX在七种故障类型更多晶圆图上的解释结果。每行展示每类故障的四个代表性样本,左侧为原始晶圆图,右侧为ABIGX归因热图。每对图像上方的Consistency-ADD(一致性-添加)分数量化了跨样本解释的一致性。ABIGX对于具有明确空间模式的故障(如"中心型"、"边缘环型"和"随机型")实现了高一致性,表明其在突出与视觉故障特征对齐的模型相关区域方面的有效性。然而,ABIGX在处理更复杂或模糊的故障时表现出局限性。例如,"近满型"始终产生较低的Consistency-ADD分数(0.375),表明模型仅当晶圆大部分区域受影响时才能对该故障类型进行高置信度预测。"划痕型"、"局部型"和"边缘局部型"等故障类型也表现出不一致的解释质量,凸显了ABIGX在处理混合或不规则模式方面的挑战。这些观察指出了未来改进的必要性,以提高实际质量检测任务中的鲁棒性和泛化能力。7.4 MVTec-AD工业图像 7.4.1 数据集描述MVTec-AD(MVTec Anomaly Detection,MVTec异常检测)数据集[49]是工业视觉检测中异常检测的广泛使用的基准数据集。该数据集包含15类物体和纹理类别的高分辨率图像,每类均含有正常样本和缺陷样本,缺陷类型涵盖划痕、凹痕和颜色偏差等多种表面异常。与传统故障检测中使用的表格型数据集(如TEP)不同,MVTec-AD专注于细粒度空间缺陷,使其适用于评估基于视觉的异常检测模型。其多样化的缺陷类型和真实的成像条件为可解释性带来了独特挑战,为评估ABIGX的泛化能力提供了有价值的测试平台。 7.4.2 模型描述在我们的工作中,我们采用WinClip [33]作为代表性的基于ViT的异常检测器,以评估ABIGX的泛化能力。WinClip是一种最先进的视觉Transformer模型,专为工业图像中的零样本异常检测而设计。通过利用CLIP [50]嵌入和多模态对齐,其在MVTec-AD数据集的多样化类别上取得了优异性能。我们使用预训练的ViT骨干网络,并对WinClip实现进行少量修改以确保可微性,从而实现与基于梯度的解释方法的兼容性。该实验设置展示了ABIGX对更复杂、大规模和现代基于Transformer模型的适用性。 7.4.3 可解释异常检测图8比较了不同方法在来自五个类别(地毯、木材、皮革、瓷砖和网格)的输入工业图像上的ViT归因图。与其他基线方法相比,ABIGX提供了显著更聚焦且更准确的归因,其一致性地突出了真实异常区域(如红色圆圈所示),同时抑制了无关噪声。相比之下,注意力图和原始IG等替代方法表现出分散或定位性较差的归因,往往延伸至真实值故障区域之外。 图8 WinClip异常检测器在MVTec - AD数据集的5个样本上的解释结果。在红色(放大以查看小区域内更精细的细节)中圈出了真值异常区定量而言,表5验证了ABIGX的优越解释性能。在正确性方面,ABIGX取得了最高的AUC和SUM(总和),表明其显著性区域与其他方法相比与实际故障区域的对齐程度更高。值得注意的是,这证明了ABIGX的归因图不仅具有视觉可解释性,而且在定量意义上也具有意义。相较于期望IG和显著性图的性能提升,进一步验证了ABIGX自适应基线策略的优势,尤其在传统IG方法难以处理任意基线的复杂高维图像域中。在一致性方面,ABIGX在各项评估指标上表现出强鲁棒性。值得注意的是,WinClip的预测对微小扰动高度敏感,仅添加少量像素即可显著增加异常分数,导致所有方法的ADD(一致性-添加)分数均较高。然而,ABIGX取得了相对较低的DEL(一致性-删除)分数,表明其识别的高排名特征对模型预测至关重要。总体而言,该实验证实了ABIGX与WinClip等大规模基于Transformer的模型兼容,并在工业图像的多样化异常类型上生成忠实且简洁的解释。ABIGX对不同模态和模型架构的泛化能力进一步巩固了其作为广泛适用且统一的表格型和视觉FDC任务可解释性框架的价值。7.4.4 ABIGX详细解释 附录图B.6展示了ABIGX在更多具有细微且视觉上不明显缺陷的MVTec-AD故障样本上的解释。这些具有挑战性的案例对于评估解释方法的必要性具有重要意义。对于FDC模型赋予高故障置信度的样本,ABIGX突出了与真实缺陷区域高度吻合的局部区域,表明模型正关注于语义相关的特征。相反,对于故障置信度较低的样本,ABIGX产生较弱或错位的归因,反映了模型的不确定性或未能识别异常。该分析表明:(1)对于难以观测的缺陷,解释对于验证模型是否基于有意义的证据做出决策至关重要;(2)解释作为诊断工具,有助于验证正确决策并解释失效案例,以进行进一步的模型诊断。 7.5 计算成本 尽管FDC领域的研究兴趣日益增长,但为基于深度神经网络的FDC模型生成准确且具备理论基础的解释仍然是一项关键挑战。虽然传统的故障诊断方法和深度学习解释器均已得到应用,但仍存在若干局限性:附录表B.15展示了每样本的平均解释时间。尽管计算开销有所增加,ABIGX仍保持实际可用的高效性:轻量级模型(如PCA、AE、MLP和小型CNN)的平均运行时间约为1至2秒,即使对于ViT(Vision Transformers,视觉Transformer)等更复杂的架构,也能保持在数十秒以内。传统方法如CP(Contribution Plot,贡献图)和RBC(Reconstruction-Based Contribution,基于重构的贡献)计算开销极低,对于PCA模型解释时间近乎为零。这种高效性源于其不依赖迭代优化或梯度计算。然而,这一速度是以非线性场景下的泛化能力和可解释性为代价的。ABIGX的主要计算成本来自梯度计算,这对于AFR(Adversarial Fault Reconstruction,对抗故障重构)过程和IG(Integrated Gradients,积分梯度)计算均不可或缺。因此,总运行时间主要取决于模型的正向和反向传播次数,由AFR和IG中使用的步长参数决定。实践中,我们通常将AFR的步数设置为与IG相等,这使得ABIGX所需的梯度评估次数约为标准IG方法的两倍,约为简单基于梯度方法的2×步数倍。在实践中,ABIGX可通过小批量(mini-batching)大幅加速,即在GPU显存限制下的批量大小(如我们设置中ViT为8)内,对多个样本并行执行AFR基线搜索和IG积分。7.6 实现细节 我们在附录中总结了模型架构和关键ABIGX超参数,以确保可复现性。具体而言,表B.5和B.14报告了实验中训练的网络结构;表B.6列出了所有四种被解释模型的主要ABIGX超参数。7.6.1 步长、步数与收敛性 为避免AFR基线欠优化影响归因结果,我们在所有具有合理运行时间的实验中采用保守的(较大的)迭代预算,以确保优化不足不会混淆归因质量。四种被解释模型的步长和步数敏感性分析详见附录表B.7至B.10。为诊断AFR基线搜索过程中的收敛性,我们监测迭代过程中的表征SPE值和模型预测置信度。具体而言,当SPE曲线达到平台期时(即连续迭代中SPE的相对下降变得可忽略不计),我们将该运行标记为已收敛。根据表B.16中的聚合收敛率,在默认步长和步数下,大多数样本表现出急剧的SPE下降后趋于饱和,表明跨模型的收敛行为稳定。我们还跟踪搜索过程中的模型正常性(图B.9),其通常与基于SPE的收敛诊断一致地趋于稳定。仅有少量运行仍陷入局部最优(未达到足够高的正常性置信度)或达到最大迭代预算上限。7.6.2 故障分类器表示层 在本文的故障分类设置中,ABIGX需要选择内部表征h(x)以定义分类SPE并驱动AFR基线搜索。我们选择倒数第二层作为默认表征,因其提供了稳定且语义有意义的特征空间,同时避免了最终对数几率层可能出现的饱和和标签特定坍缩。我们通过在TEP和晶圆图分类器上的敏感性研究验证了这一选择:在候选层中,倒数第二层表征始终产生最佳或接近最佳的解释正确性和一致性(附录图B.7和表B.13)。因此,除非另有说明,所有分类器实验均采用倒数第二层作为表征。7.6.3 失效案例 我们观察到ABIGX的两种反复出现的失效模式。第一种情况是AFR基线优化失败(最终基线的正常性较低)。在某些样本中,基于PGD的AFR搜索虽然降低了表征空间距离,但仍收敛至正常性置信度相对较低的基线,表明优化陷入了较差的局部最优。当最终基线仍非正常时,所得IG路径不再代表有意义的"故障到正常"过渡,归因正确性(如GT-AUC)随之下降(图B.8)。作为实际保障措施,在这些情况下我们可以回退至期望IG,即从输入空间正常样本池中抽取基线,而非依赖搜索得到的AFR基线,从而提高鲁棒性。第二种情况是低置信度模型预测(本质上模糊的样本)。这类失效源于模型本身对被解释样本赋予较低的故障置信度。在此情况下,归因可能与人工标注的真实值对齐不佳,但这并非因为解释器不正确,而是因为底层决策本身不确定(图B.6)。这种行为是符合预期的:ABIGX旨在解释模型的决策机制,当模型置信度较低(或接近决策边界)时,任何忠实的解释都将反映这种模糊性,而非强制与外部标注对齐。8 结论本文提出了一种统一框架ABIGX,用于解释通用FDC模型。ABIGX源于CP和RBC的核心要素,这两种方法在PCA模型故障诊断中已取得显著成功。本文提出的新型故障重构方法AFR是ABIGX的核心组成部分。AFR从对抗攻击的视角重新构建现有方法,并通过新型分类SPE指标将FR推广至故障分类任务。对于可解释故障分类,我们从故障类别模糊化的角度分析了各方法的性能。与显著性图和IG相比,我们证明了ABIGX能够以更低的故障类别模糊化程度提供更准确的变量贡献。对于可解释故障检测,我们从理论上证明了线性CP和RBC与ABIGX的等价性。通过定量指标,在广泛模型和数据集上的实验验证了ABIGX在故障诊断和深度学习解释两个领域中相较于其他先进解释器的总体优越性。 编辑:Leo校核:李正平、陈凯歌、曹希铭、赵学功、白亮、任超、海洋、陈宇航、Kira、Tina、王金、赵诚、肖鑫鑫、张优该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除来源:故障诊断与python学习

未登录
还没有评论
课程
培训
服务
行家
VIP会员 学习计划 福利任务
下载APP
联系我们
帮助与反馈