IEEE || ABIGX:一个可扩展的故障检测和分类的统一框架(下)
从对抗攻击视角重构故障重建,东南大学团队提出ABIGX统一框架,将经典CP/RBC诊断方法拓展至任意深度学习模型,理论证明其等价性,破解"故障类别涂抹"难题,在TEP、晶圆图及工业图像上验证,为智能运维黑箱决策提供可信归因工具。
本期给大家推荐这篇东南大学虞文武教授团队的论文。本文提出ABIGX(Adversarial Fault Reconstruction-Based Integrated Gradient eXplanation,基于对抗故障重构的积分梯度解释)框架,统一解决可解释故障检测与分类问题。核心创新在于:1)从对抗攻击视角重构故障重建,将传统CP(Contribution Plot,贡献图)/RBC(Reconstruction-Based Contribution,基于重构的贡献)方法扩展到非线性模型;2)提出分类SPE(Squared Prediction Error,平方预测误差)指标,使AFR(Adversarial Fault Reconstruction,对抗故障重构)适用于故障分类任务;3)结合集成梯度实现模型无关的变量归因。理论证明CP和RBC是ABIGX的线性特例,并分析"故障类别涂抹"问题,证明ABIGX优于传统梯度方法。实验涵盖多种模型,在TEP过程、晶圆图和MVTec-AD数据集上验证其优越的解释准确性与泛化能力。 由于文章篇幅过长,小编将分两次为大家翻译介绍这篇论文,第一篇推文(点击即达)系统系统综述了故障检测与分类的研究背景,指出传统CP、RBC方法受限于线性模型且无法处理分类任务,而现有深度学习解释器缺乏故障诊断领域的理论基础。基于此,作者从对抗攻击视角重新诠释故障重建,提出AFR方法及分类SPE指标,进而构建ABIGX统一框架——通过AFR生成语义有效的反事实基线,结合集成梯度实现任意可微FDC模型的变量归因,为后续理论分析与实验验证奠定基础。 本篇推文进一步涵盖理论证明与实验验证。理论层面,作者提出"故障类别涂抹"问题,证明ABIGX比显著性图和IG更能缓解该问题;同时证明CP和RBC是ABIGX在线性PCA检测器下的特例,实现经典方法与现代框架的统一。实验层面,在TEP化工过程、晶圆图及MVTec-AD工业图像上,ABIGX对PCA、AE、MLP、CNN、ViT等模型均展现出更优的解释准确性与一致性,验证了框架的泛化能力与实用价值。
文章质量很高。本文配套思维导图&论文精华速览,已同步至小红书:(ID:故障诊断与python学习),需要的小伙伴可以自取💡~
论文链接:通过点击最左下角的阅读原文进行在线阅读及下载。
从对抗攻击视角重构故障重建,东南大学团队提出ABIGX统一框架,将经典CP/RBC诊断方法拓展至任意深度学习模型,理论证明其等价性,破解"故障类别涂抹"难题,在TEP、晶圆图及工业图像上验证,为智能运维黑箱决策提供可信归因工具。
本期给大家推荐这篇东南大学虞文武教授团队的论文。本文提出ABIGX(Adversarial Fault Reconstruction-Based Integrated Gradient eXplanation,基于对抗故障重构的积分梯度解释)框架,统一解决可解释故障检测与分类问题。核心创新在于:1)从对抗攻击视角重构故障重建,将传统CP(Contribution Plot,贡献图)/RBC(Reconstruction-Based Contribution,基于重构的贡献)方法扩展到非线性模型;2)提出分类SPE(Squared Prediction Error,平方预测误差)指标,使AFR(Adversarial Fault Reconstruction,对抗故障重构)适用于故障分类任务;3)结合集成梯度实现模型无关的变量归因。理论证明CP和RBC是ABIGX的线性特例,并分析"故障类别涂抹"问题,证明ABIGX优于传统梯度方法。实验涵盖多种模型,在TEP过程、晶圆图和MVTec-AD数据集上验证其优越的解释准确性与泛化能力。 由于文章篇幅过长,小编将分两次为大家翻译介绍这篇论文,第一篇推文(点击即达)系统系统综述了故障检测与分类的研究背景,指出传统CP、RBC方法受限于线性模型且无法处理分类任务,而现有深度学习解释器缺乏故障诊断领域的理论基础。基于此,作者从对抗攻击视角重新诠释故障重建,提出AFR方法及分类SPE指标,进而构建ABIGX统一框架——通过AFR生成语义有效的反事实基线,结合集成梯度实现任意可微FDC模型的变量归因,为后续理论分析与实验验证奠定基础。 本篇推文进一步涵盖理论证明与实验验证。理论层面,作者提出"故障类别涂抹"问题,证明ABIGX比显著性图和IG更能缓解该问题;同时证明CP和RBC是ABIGX在线性PCA检测器下的特例,实现经典方法与现代框架的统一。实验层面,在TEP化工过程、晶圆图及MVTec-AD工业图像上,ABIGX对PCA、AE、MLP、CNN、ViT等模型均展现出更优的解释准确性与一致性,验证了框架的泛化能力与实用价值。
文章质量很高。本文配套思维导图&论文精华速览,已同步至小红书:(ID:故障诊断与python学习),需要的小伙伴可以自取💡~
论文基本信息
论文题目: ABIGX: A Unified Framework for eXplainable Fault Detection and Classification
论文期刊:IEEE Transactions on Pattern Analysis and Machine Intelligence
Doi:https://doi.org/10.1109/TPΑΜΙ.2026.3689327
a School of Mathematics, Southeast University, Nanjing 210096, China
b Hangzhou International Innovation Institute, Beihang University, Hangzhou 311115, China
c School of Automation and Electrical Engineering, Zhejiang University of Science and Technology, Hangzhou 310023, China
d School of Automation, Guangdong University of Petrochemical Technology, Maoming, 525000, Guangdong, China
作者: 虞文武,东南大学首席教授、数学学院院长,入选教育部长江学者、青年长江、国家"万人计划"青年拔尖人才、国家优青,2014-2024连续十一次入选全球高被引科学家。主要从事系统科学与人工智能交叉研究,发表IEEE汇刊文章100余篇,Google和SCI引用超3万次,H指数75。主持科技部"新一代人工智能"重大项目等多项国家级课题,获国家自然科学二等奖1项、省部级一等奖3项;任Complex Engineering Systems主编及多个IEEE汇刊编委。(来源:Research)
摘要
目录
1 引言
2 预备知识及相关工作
2.1 FDC
2.2 故障诊断
2.3 基于梯度的XAI方法
2.4 对抗攻击
2.5 可解释FDC的挑战
3 故障重建:对抗视角
3.1 对抗故障重建
3.2 故障分类的SPE指标
3.3 AFR算法
3.4 AFR与对抗攻击的对比
4 ABIGX:统一框架
4.1 定义
4.2 算法
4.3 讨论
5 ABIGX在故障分类中的应用
5.1 故障分类设定
5.2 故障类别涂抹
6 ABIGX在故障诊断中的应用
6.1 RBC与ABIGX-OneVar
6.2 CP与ABIGX
7 实验
7.1 评估指标与对比方法
7.2 田纳西伊斯曼过程
7.3 晶圆图
7.4 MVTec-AD工业图像
7.5 计算成本
7.6 实现细节
8 结论
5 AIBGX在故障分类中的应用
本节介绍故障类别模糊化问题——这是故障分类模型中固有的问题,会导致误导性的变量贡献,并使准确识别故障真正原因变得困难。针对该问题,我们对故障分类中变量贡献的正确性进行理论分析。我们表明,显著性图直接受到故障类别模糊化的影响,而IG(Integrated Gradients,积分梯度)提供了一定程度的缓解。然而,我们的分析证明ABIGX对该问题的缓解效果最佳,能够提供最准确的解释。这些发现为ABIGX在故障分类模型上的卓越可解释性奠定了坚实的理论基础。
5.1 故障分类设定
首先,我们构建一个故障分类数据集和模型的玩具示例。不失一般性,假设不同故障类型发生在不同变量上:
示例 1(玩具故障分类数据集)。假设所有正常变量独立同分布地采样自高斯分布 ,所有故障具有相同的幅度f,并且受损变量服从分布 。为简单起见,我们假设故障类型y在方向 上有一个受损变量。那么具有M个变量和N种故障类型的故障分类数据集定义为 (N<M):
其次,我们为该玩具示例构建线性分类模型,以实现所有类别的最佳分离:
定义6.(线性分类器)设 为线性分类器的权重,其行向量 ( 对应于各故障(或正常)类别的线性决策边界。基于Fisher线性判别分析[35],最优行向量通过最大化类间均值距离并最小化类内方差进行训练:
其中 为故障类别y的均值向量, 为类别均值的均值, 为各类协方差之和。
基于示例1中的数据集和定义6中的线性分类器,我们可以证明最优模型权重:
定理2. 设 为故障类别y中变量i的最优模型权重。对于正常类别y = 0,最优 为:
对于故障类别y,最优 为:
证明. 证明详见附录A.1.1。
5.2 故障类别涂抹
在可解释人工智能领域中,XFDC(eXplainable Fault Detection and Classification,可解释故障检测与分类)旨在帮助人们理解导致故障的潜在因素。给定一个故障样本,XFDC指示各变量对监测结果(检测分数或分类置信度)的贡献程度。贡献度较高的变量被视为异常的潜在根本原因(如故障传感器)。通过识别这些变量贡献,XFDC能够辅助用户解释模型预测的故障,并主动修复存在缺陷的部件。
5.2.1 模型权重
本节正式介绍故障类别模糊化问题——这是故障分类模型中固有的挑战,并分析其对基于梯度的解释方法的影响。故障类别模糊化产生于分类器的优化目标导致无关变量上出现非零权重,进而扭曲显著性图和IG(Integrated Gradients,积分梯度)等解释器的归因分数。
定义 7.(模型权重中的故障类涂抹)给定故障类型为y的受释故障样本x(如示例 1 中所定义),以及具有最优权重 的故障分类器,变量贡献在模型权重中被涂抹到其他不相关的变量上:
其中 。这些在不相关的故障变量上的非零权重会导致基于梯度的解释器高估它们的贡献,从而产生误导性的归因。
为了定量评估故障类涂抹的程度,我们定义了故障类涂抹 (FCS) 指标,该指标测量了错误分配给不相关变量的总归因比例:
直观地说,故障类涂抹的发生是因为分类器不仅必须将故障样本与正常样本区分开来,还必须区分不同的故障类型。这导致了跨多个类的共享权重,其中与其他故障类型相关联的变量仍然获得非零权重(例如, ),尽管它们与当前的故障类y无关。另一方面,不对应任何故障类的变量(即,如公式5所示的其余M-N个变量)通常具有零权重,并且不会引发涂抹。
这种现象对模型解释来说是个问题:当解释方法直接依赖于模型梯度或权重(例如,显著图或IG)时,变量贡献可能反映的是类可分性偏差,而不是与故障相关的根本变量。在接下来的小节中,我们将从理论上分析这种涂抹如何影响不同的解释方法,以及ABIGX如何减轻它。
5.2.2 显著图
显著图简单地计算模型输出关于输入变量的梯度的绝对值。线性模型的梯度就是它的权重,因此显著图贡献直接受到了故障类涂抹问题的影响。
定理 3.(显著图中的故障类涂抹)给定所解释的故障类型y及其真实变量 y,显著图的贡献被涂抹到其他不相关的变量上:
显著图中 FCS 的程度为:
5.2.3 IG
这些在不相关变量上的涂抹权重在故障分类模型中是不可避免的。一个好的解释方法应该有效地减轻涂抹权重对变量贡献的影响。接下来,我们讨论IG方法中的故障类涂抹。
定理 4.(IG中的故障类涂抹)给定所解释的故障类型y及其真实变量y,以及正常样本期望的基线 ,IG贡献的期望为:
IG中故障类涂抹 (FCS) 的程度为:
证明. 证明详见附录 A.1.2。5.2.4 ABIGX
随后,我们分析了ABIGX中的故障类涂抹,表明ABIGX以更低的FCS程度优于IG。
定理 5.(ABIGX 中的故障类涂抹)ABIGX中的故障类涂抹程度低于IG:
证明. 证明详见附录 A.1.3。
5.2.5 与故障涂抹的比较
先前在CP和RBC研究中讨论的故障涂抹 [7], [36] 是由所有输入共享的相同权重引起的,因为检测模型只输出一个标量(例如,SPE故障指数)。尽管每个故障类的模型权重都是唯一的,但我们表明分类器仍然会对不相关的变量分配权重(由于区分不同故障类型的任务)。这些非零的不相关权重涂抹了变量的贡献。总而言之,故障类涂抹论证了故障分类中故障涂抹问题的现象和原因。
6 预备知识及相关工作
本节介绍了ABIGX如何统一地重新构架两种基本的故障诊断方法CP和RBC。对于基于PCA的故障检测,我们指出CP和RBC都是ABIGX的特例。图 5 直观地展示了通过两个特定的经AFR重构的样本 和 ,CP和RBC与ABIGX的等价性。
在下文中,基于 PCA 的检测器用其残差子空间投影矩阵表示:
6.1 RBC与ABIGX-OneVar
第4节讨论了ABIGX源于RBC的思想。此外,我们证明了RBC是具有AFR-OneVar的ABIGX的线性特例。
引理 1. (故障重构性质) 使得 最小化的故障重构中的 值为:
定理 6. (RBC与ABIGX的等价性)RBC等价于使用单变量AFR的ABIGX (即ABIGX-OneVar):
证明. 证明过程见附录A.2.1。
6.2 故障诊断CP与ABIGX
故障检测模型的解释——通常称为故障诊断——已得到广泛研究[7]、[6]、[9]、[23]。一旦检测到故障,故障诊断旨在通过量化各输入变量对故障指标(如SPE)的贡献程度,识别其根源变量。下文简要回顾三种常用于基于 PCA 模型的经典故障诊断方法。
我们证明CP也是ABIGX在 范数AFR下的线性特例。首先,我们计算PCA在 范数距离约束下的AFR重构样本:
引理2.(PCA的AFR)在 范数距离约束下,基于PCA的故障检测的AFR重构样本 为:
这意味着重构向量恰好是残差子空间投影。 证明.证明见附录A.2.2。 随后,我们可以证明CP与ABIGX的等同性。
定理7.(CP与ABIGX的等同性)CP与 范数AFR下的ABIGX等同:
证明. 根据引理2中的 ,ABIGX为(省略 的下标):
由式(35),我们有 ,因此得到ABIGX贡献:
这与 等同。
此外,受引理2的启发,我们讨论了基于梯度的攻击的可行性,这也是AFR和ABIGX的默认算法:
注 1. (针对PCA的基于梯度的攻击) 基于梯度的攻击总是沿着残差子空间投影的方向重构故障。
证明. PGD每一步的对抗扰动为:
其中L是一个标量。 这与直觉一致,因为残差投影指向SPE下降最快的方向。
7 实验
7.1 评估指标与对比方法
我们引入两类定量指标,用于对解释方法进行公平评估:
正确性[37]衡量变量贡献与根源变量之间的差异。更优的解释应更接近真实值。具体而言,Correctness-AUC将贡献视为二分类预测分数,通过改变贡献分数的负类阈值,计算受试者工作特征曲线下的面积[38]。正确性也可通过累加真实值上的归因分数来度量,称为Correctness-SUM。
一致性[39]检验贡献是否聚焦于模型真正关注的区域。更优的解释方法应与模型行为具有更高的一致性。Consistency-ADD指标逐步将解释故障样本的变量值添加至正常样本。通过滑动贡献阈值,贡献最大的变量首先被添加,贡献最小的最后被添加。更优的解释方法应使模型预测分数上升更快,这可通过阈值
相关的预测分数曲线下面积进行量化。相反,Consistency-DEL首先删除最重要的变量,直至所有特征均被正常样本替换。类似地,更优的方法应使模型预测分数下降更快,这可通过阈值相关的AUC进行度量。
对于基线方法,我们引入了几种先进的基于梯度的XAI方法,包括:
• 显著性图:输入变量梯度的绝对值,最常用的特征归因方法。
• DeepLift[40]:一种梯度反向传播解释方法,能够妥善处理IG(Integrated Gradients,积分梯度)可能产生误导结果的情形。
• 原始IG[16]:提出的原始IG方法,使用全零向量作为基线。
• 期望IG[41]:IG的一种变体,使用来自数据分布的信息性基线(即本实验中的正常样本),通过对IG归因求期望来缓解基线选择的影响。
• 重要方向梯度积分[42]:IG的一种变体,仅直接关注与梯度对齐的重要方向,在本实验中基于原始IG构建。
• 引导IG[43]:IG的一种变体,基于梯度构建积分路径,使用全零向量作为基线。
• AFR+ 引导IG:我们使用AFR重构样本作为基线,但将ABIGX的默认直线路径积分替换为引导IG的路径构建算法,作为消融设置以验证ABIGX中AFR基线的有效性。
为确保公平比较,我们将所有基于IG的方法(原始IG、期望IG、引导IG和IDGI)的主要超参数——步长,设置为与ABIGX相同。所有实验在INTEL CORE i7-12700K CPU上运行TEP数据集的PCA、AE和MLP模型,在单块NVIDIA GeForce RTX 3080 GPU上运行Wafermap数据集的CNN模型和MVTec-AD数据集的ViT模型。
7.2 田纳西伊斯曼过程
7.2.1 数据集描述
为使TEP设置自成体系,并阐明各故障的物理含义,我们在附录中提供了TE过程流程图及文献[18]中的官方变量和故障描述(图B.1、表B.1)。这些材料明确了故障注入位置(物流、单元)、涉及的执行器和传感器,以及预期的一阶响应,对于解释诊断性能和特征级归因至关重要。
我们的解释正确性指标依赖于为每种故障精心筛选的根源变量 集 合,该集 合源自经典TE过程文献并汇总于附录表B.2。除列出变量索引外,该表还提供了逐故障的推理依据,基于(i)注入位置、(ii)最直接受影响的测量变量和执行器、以及(iii)过程结构和控制回路,将各故障与其根源变量相关联。我们在报告基于根源变量的正确性分数时,将其作为真实值参考。这一故障-变量关联亦与代表性TEP诊断工作[9]、[44]、[45]中采用的故障语义相一致,从而使我们的故障-变量映射成为与文献对齐的、透明的经典TEP故障定义表征,用于解释评估。
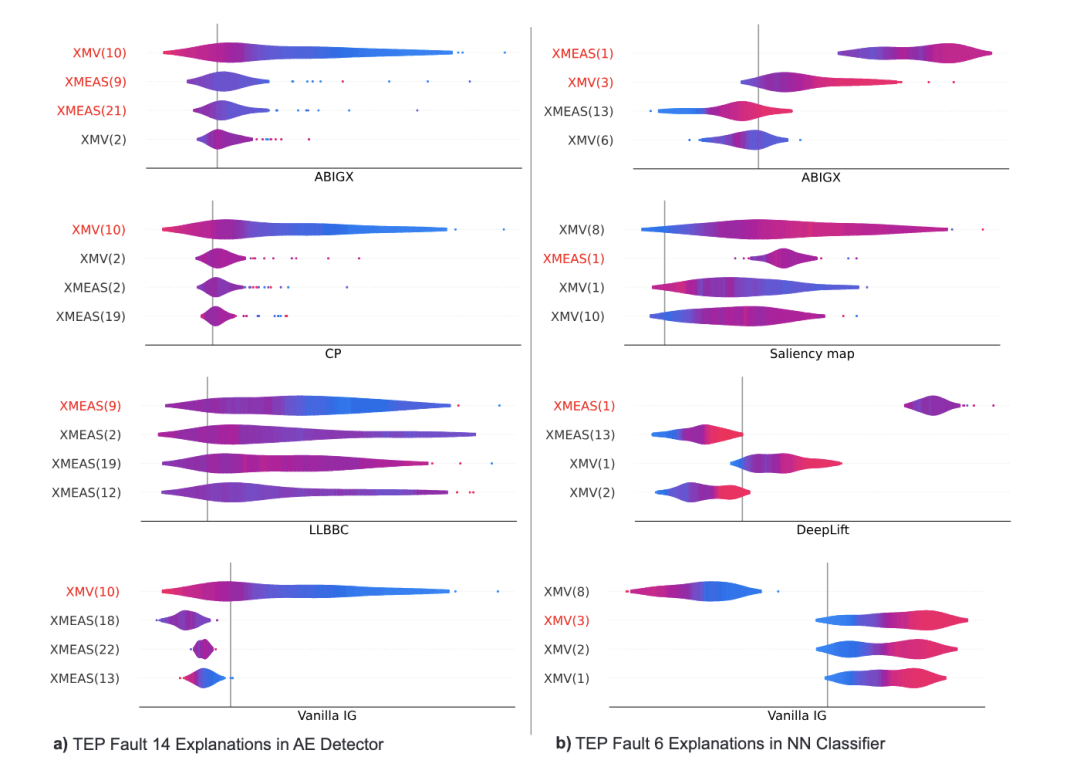
图6 为NN分类器对TEP故障6的解释对比,图中实根变量为红色。故障6由根变量XMEAS ( 1 )和XMV ( 3 )引起,故障14由XMEAS ( 9 ),XMV ( 10 )和XMEAS ( 21 )引起,详见表B.2
为清晰起见,图6直观展示了两种TEP故障类型(故障6和故障14)的解释对比。该图分别展示了故障检测和分类模型的传感器变量贡献,其中每个图的四个子图展示了四种不同技术解释的变量贡献。对于TEP数据集,我们采用了文献[46]中的绘图风格。水平轴表示变量贡献值(含方向)。变量按重要性在垂直轴上排序,其中展示了贡献最大的四个变量。值得注意的是,图中还通过彩色分布展示了变量(特征)值与其贡献之间的相关性。
7.2.2 可解释故障检测
故障诊断与ABIGX的等价性:第6节从理论上证明了两种故障诊断方法与ABIGX之间的等价性。在TEP故障的PCA检测器上,我们计算了它们之间的经验误差,即所有变量贡献的均值。表2报告了结果,表明差异足够小(尤其在使用MILP求解AFR重构样本时)。
解释结果:首先,图6a绘制了TEP数据集上AE模型不同解释方法的直观对比,表明ABIGX将最高贡献分配给了根源变量。同时,其他方法未能提供完整的解释。
表3报告了TEP上AE检测解释的四项评估指标,涉及14种故障类型。总体而言,ABIGX方法优于其他解释方法,包括故障诊断方法(CP和LLBBC [47])以及基于IG的深度学习解释器(DeepLift不适用于故障检测)。通过比较期望IG与原始IG和IDGI,可以发现全零基线对故障检测解释产生了不利影响。ABIGX-OneVar提供了最接近真实值根源变量的解释。独立归因变量的显著性图在正确性指标上也表现良好。另一方面,ABIGX提供了最匹配模型行为的解释。我们认为,考虑变量交互的解释更接近模型实际处理样本的方式。
基于消融研究(AFR+引导IG),在TEP数据集上使用AFR重构基线结合引导IG的自适应路径,相较于原始引导IG均有持续提升,同时相对于ABIGX具有竞争力的性能表现。
7.2.3 可解释故障分类
与故障检测类似,图6b绘制了基于NN的TEP故障6分类器解释。ABIGX的优势体现在变量XMV(3)上。ABIGX为该变量分配了更高的贡献,而显著性图甚至忽略了该变量,其原因已在第4.3.2节中分析。
表4报告了故障分类的解释指标,各方法性能与检测任务类似。ABIGX总体上仍表现更优,即使在正确性指标上(AUC除外)。ABIGX-OneVar仍然强调正确性,但模型一致性较差,这与显著性图类似。DeepLift与原始IG性能相近。尽管IDGI和引导IG相较于原始IG方法表现出性能提升,但由于其基线缺乏信息量,即使在期望IG设置下,在故障分类任务中仍不具竞争力。
分类SPE指标的验证:通过ABIGX-AdvAFR进行消融研究。与第3.2节提出的ABIGX分类SPE不同,ABIGX-AdvAFR采用原始对抗攻击目标(即最小化正常类别的Softmax输出置信度)进行故障重构。ABIGX总体上优于ABIGX-AdvAFR,验证了本文提出的新型分类SPE指标在故障重构中的有效性。
7.2.4 故障级解释
为清晰展示TEP数据集上的归因对比,附录图B.2和B.3以及表B.4和B.3呈现了故障检测和分类模型在所有TEP故障类型上的详细实验结果。这些图可视化了ABIGX在数据分布中对排名靠前变量的归因,而表格则通过报告故障级别的根源变量排名来比较各方法的归因性能。具体而言,根源变量出现在归因前三位中的比例及其平均排名表明,ABIGX在大多数故障类型上与真实值故障变量的一致性最高。
为探究模型精度与ABIGX解释质量之间的相关性,图B.4详细分析了ABIGX在所有TEP故障类型上的归因性能,并按不同FDC模型的正确预测和错误预测样本分别展示。结果凸显了两个关键发现:(1)预测精度较高的故障类型往往表现出更准确的ABIGX归因;(2)在每个故障类型内部,正确预测样本的归因正确性通常高于误分类样本。这些发现表明,ABIGX解释与模型置信度密切相关——当模型成功检测故障时,其能够忠实地归因有意义的贡献;而当模型失效时,则揭示出归因的不确定性。
7.3 晶圆图
7.3.1 数据级描述
晶圆图分析在半导体日常制造运营中至关重要。晶圆图提供了视觉细节,对于识别晶圆故障模式发生的制造阶段具有关键作用。我们研究了晶圆图故障模式分类的解释,其目标是确定晶圆图中哪些像素是故障根源。
我们在WM-811K数据集[48]上训练了一个基于CNN(Convolutional Neural Network,卷积神经网络)的故障分类器,选取了四种故障类型(中心型、边缘局部型、边缘环型和划痕型)。故障和正常晶圆图如图7所示,其中真实值根源像素由红色圆圈标注。绿色像素表示正常芯片,黄色像素表示缺陷芯片。当不存在特定缺陷芯片模式时,晶圆图为正常(如图7左上角所示)。
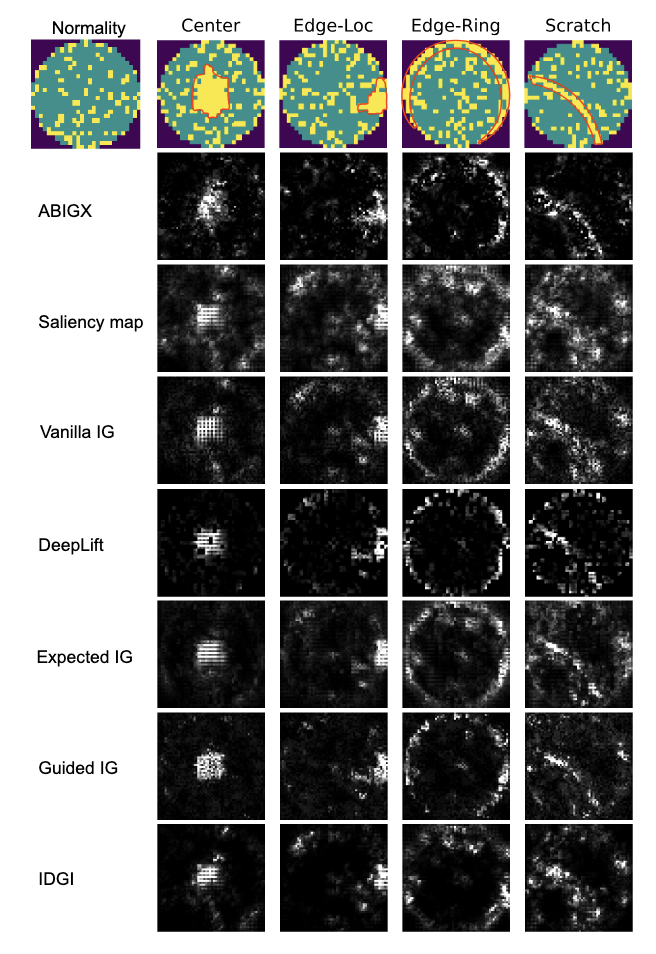
图7 CNN分类器对四种具有不同故障模式的采样晶圆图的解释,其中真实根像素以红色为圆心
7.3.2 可解释故障分类
图7和表5中呈现的实验结果提供了多种解释方法在用于识别晶圆图故障模式的CNN分类器上的对比分析。ABIGX在所有故障类型中均表现出高度聚焦且清晰的解释效果,与标注的真实值区域高度吻合。这种清晰性表明ABIGX能够有效识别与模型分类决策最相关的区域。其他方法如显著性图、原始IG和IDGI则产生更为分散且聚焦性较差的解释。可以发现,原始IG和IDGI中使用的黑色基线导致了较差的解释效果。DeepLift和期望IG表现中等,其解释清晰度优于显著性图和原始IG,但缺乏ABIGX所具有的精确性。
表5 解释方法的评价指标(在晶圆图CNN分类器上)
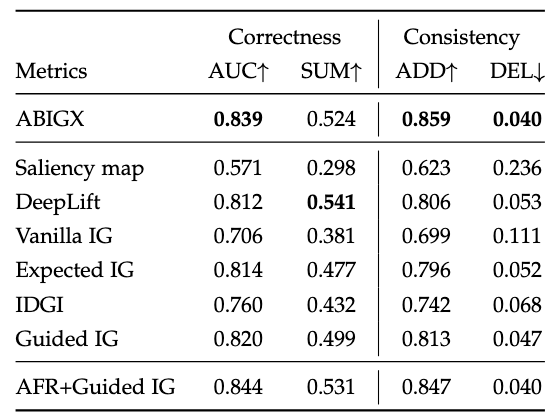
表5量化了各方法在四项关键指标上的性能。ABIGX在正确性(AUC(Area Under Curve,曲线下面积):0.839)和一致性(ADD:0.859,DEL:0.040)上均取得了最高分数,表明其在准确识别关键区域的同时,生成的解释具有高度一致性。相比之下,显著性图和原始IG总体表现最低。DeepLift和期望IG在正确性方面表现良好,但在一致性上逊于ABIGX。引导IG(Guided IG,引导积分梯度)在正确性和一致性之间取得了平衡,其分数具有竞争力但未能超越ABIGX。使用AFR(Adversarial Fault Reconstruction,对抗故障重构)重构基线结合引导IG的自适应路径(AFR+引导IG)始终优于原始引导IG,且与ABIGX具有竞争力,证实了AFR基线改进在不同路径选择下均持续有效。
晶圆图故障解释实验验证了ABIGX的泛化能力,其不仅适用于表格型传感器数据,还适用于CNN模型训练的图像等非结构化数据。
7.3.3 ABIGX详细解释
附录图B.5展示了ABIGX在七种故障类型更多晶圆图上的解释结果。每行展示每类故障的四个代表性样本,左侧为原始晶圆图,右侧为ABIGX归因热图。每对图像上方的Consistency-ADD(一致性-添加)分数量化了跨样本解释的一致性。ABIGX对于具有明确空间模式的故障(如"中心型"、"边缘环型"和"随机型")实现了高一致性,表明其在突出与视觉故障特征对齐的模型相关区域方面的有效性。
然而,ABIGX在处理更复杂或模糊的故障时表现出局限性。例如,"近满型"始终产生较低的Consistency-ADD分数(0.375),表明模型仅当晶圆大部分区域受影响时才能对该故障类型进行高置信度预测。"划痕型"、"局部型"和"边缘局部型"等故障类型也表现出不一致的解释质量,凸显了ABIGX在处理混合或不规则模式方面的挑战。这些观察指出了未来改进的必要性,以提高实际质量检测任务中的鲁棒性和泛化能力。
7.4.1 数据集描述
MVTec-AD(MVTec Anomaly Detection,MVTec异常检测)数据集[49]是工业视觉检测中异常检测的广泛使用的基准数据集。该数据集包含15类物体和纹理类别的高分辨率图像,每类均含有正常样本和缺陷样本,缺陷类型涵盖划痕、凹痕和颜色偏差等多种表面异常。与传统故障检测中使用的表格型数据集(如TEP)不同,MVTec-AD专注于细粒度空间缺陷,使其适用于评估基于视觉的异常检测模型。其多样化的缺陷类型和真实的成像条件为可解释性带来了独特挑战,为评估ABIGX的泛化能力提供了有价值的测试平台。
7.4.2 模型描述
在我们的工作中,我们采用WinClip [33]作为代表性的基于ViT的异常检测器,以评估ABIGX的泛化能力。WinClip是一种最先进的视觉Transformer模型,专为工业图像中的零样本异常检测而设计。通过利用CLIP [50]嵌入和多模态对齐,其在MVTec-AD数据集的多样化类别上取得了优异性能。我们使用预训练的ViT骨干网络,并对WinClip实现进行少量修改以确保可微性,从而实现与基于梯度的解释方法的兼容性。该实验设置展示了ABIGX对更复杂、大规模和现代基于Transformer模型的适用性。
7.4.3 可解释异常检测
图8比较了不同方法在来自五个类别(地毯、木材、皮革、瓷砖和网格)的输入工业图像上的ViT归因图。与其他基线方法相比,ABIGX提供了显著更聚焦且更准确的归因,其一致性地突出了真实异常区域(如红色圆圈所示),同时抑制了无关噪声。相比之下,注意力图和原始IG等替代方法表现出分散或定位性较差的归因,往往延伸至真实值故障区域之外。
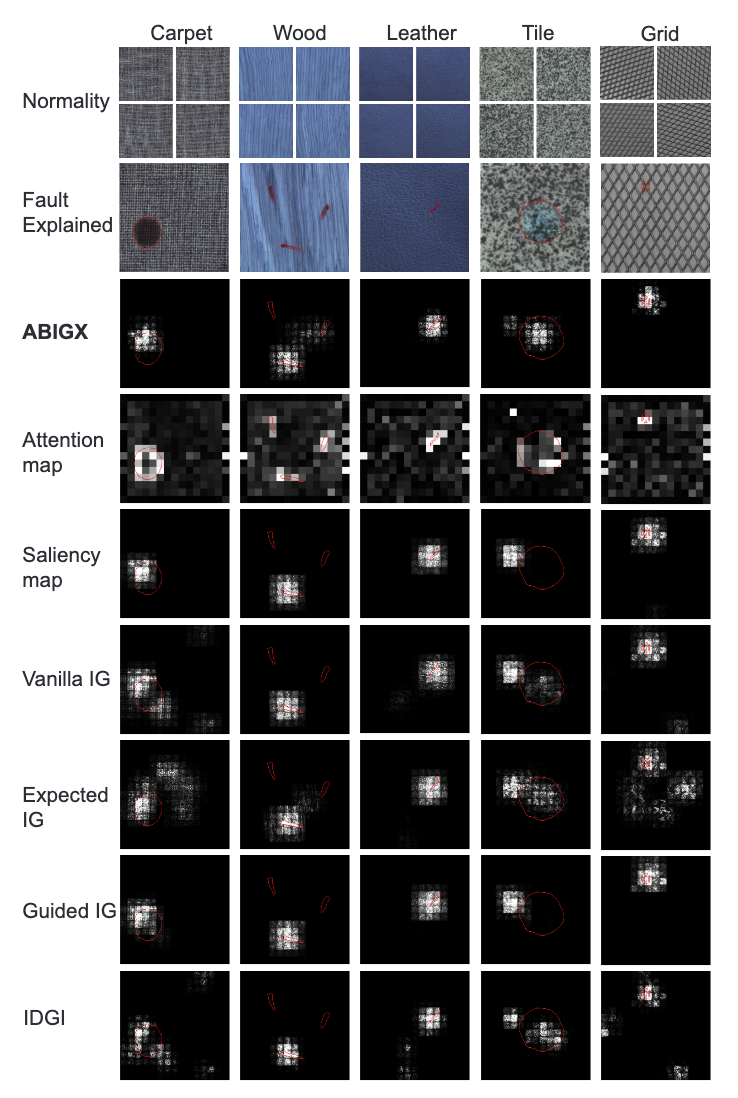
图8 WinClip异常检测器在MVTec - AD数据集的5个样本上的解释结果。在红色(放大以查看小区域内更精细的细节)中圈出了真值异常区
定量而言,表5验证了ABIGX的优越解释性能。在正确性方面,ABIGX取得了最高的AUC和SUM(总和),表明其显著性区域与其他方法相比与实际故障区域的对齐程度更高。值得注意的是,这证明了ABIGX的归因图不仅具有视觉可解释性,而且在定量意义上也具有意义。相较于期望IG和显著性图的性能提升,进一步验证了ABIGX自适应基线策略的优势,尤其在传统IG方法难以处理任意基线的复杂高维图像域中。
在一致性方面,ABIGX在各项评估指标上表现出强鲁棒性。值得注意的是,WinClip的预测对微小扰动高度敏感,仅添加少量像素即可显著增加异常分数,导致所有方法的ADD(一致性-添加)分数均较高。然而,ABIGX取得了相对较低的DEL(一致性-删除)分数,表明其识别的高排名特征对模型预测至关重要。
总体而言,该实验证实了ABIGX与WinClip等大规模基于Transformer的模型兼容,并在工业图像的多样化异常类型上生成忠实且简洁的解释。ABIGX对不同模态和模型架构的泛化能力进一步巩固了其作为广泛适用且统一的表格型和视觉FDC任务可解释性框架的价值。
7.4.4 ABIGX详细解释
附录图B.6展示了ABIGX在更多具有细微且视觉上不明显缺陷的MVTec-AD故障样本上的解释。这些具有挑战性的案例对于评估解释方法的必要性具有重要意义。对于FDC模型赋予高故障置信度的样本,ABIGX突出了与真实缺陷区域高度吻合的局部区域,表明模型正关注于语义相关的特征。相反,对于故障置信度较低的样本,ABIGX产生较弱或错位的归因,反映了模型的不确定性或未能识别异常。该分析表明:(1)对于难以观测的缺陷,解释对于验证模型是否基于有意义的证据做出决策至关重要;(2)解释作为诊断工具,有助于验证正确决策并解释失效案例,以进行进一步的模型诊断。
尽管FDC领域的研究兴趣日益增长,但为基于深度神经网络的FDC模型生成准确且具备理论基础的解释仍然是一项关键挑战。虽然传统的故障诊断方法和深度学习解释器均已得到应用,但仍存在若干局限性:
附录表B.15展示了每样本的平均解释时间。尽管计算开销有所增加,ABIGX仍保持实际可用的高效性:轻量级模型(如PCA、AE、MLP和小型CNN)的平均运行时间约为1至2秒,即使对于ViT(Vision Transformers,视觉Transformer)等更复杂的架构,也能保持在数十秒以内。
传统方法如CP(Contribution Plot,贡献图)和RBC(Reconstruction-Based Contribution,基于重构的贡献)计算开销极低,对于PCA模型解释时间近乎为零。这种高效性源于其不依赖迭代优化或梯度计算。然而,这一速度是以非线性场景下的泛化能力和可解释性为代价的。
ABIGX的主要计算成本来自梯度计算,这对于AFR(Adversarial Fault Reconstruction,对抗故障重构)过程和IG(Integrated Gradients,积分梯度)计算均不可或缺。因此,总运行时间主要取决于模型的正向和反向传播次数,由AFR和IG中使用的步长参数决定。实践中,我们通常将AFR的步数设置为与IG相等,这使得ABIGX所需的梯度评估次数约为标准IG方法的两倍,约为简单基于梯度方法的2×步数倍。
在实践中,ABIGX可通过小批量(mini-batching)大幅加速,即在GPU显存限制下的批量大小(如我们设置中ViT为8)内,对多个样本并行执行AFR基线搜索和IG积分。
我们在附录中总结了模型架构和关键ABIGX超参数,以确保可复现性。具体而言,表B.5和B.14报告了实验中训练的网络结构;表B.6列出了所有四种被解释模型的主要ABIGX超参数。
7.6.1 步长、步数与收敛性
为避免AFR基线欠优化影响归因结果,我们在所有具有合理运行时间的实验中采用保守的(较大的)迭代预算,以确保优化不足不会混淆归因质量。四种被解释模型的步长和步数敏感性分析详见附录表B.7至B.10。
为诊断AFR基线搜索过程中的收敛性,我们监测迭代过程中的表征SPE值和模型预测置信度。具体而言,当SPE曲线达到平台期时(即连续迭代中SPE的相对下降变得可忽略不计),我们将该运行标记为已收敛。根据表B.16中的聚合收敛率,在默认步长和步数下,大多数样本表现出急剧的SPE下降后趋于饱和,表明跨模型的收敛行为稳定。我们还跟踪搜索过程中的模型正常性(图B.9),其通常与基于SPE的收敛诊断一致地趋于稳定。仅有少量运行仍陷入局部最优(未达到足够高的正常性置信度)或达到最大迭代预算上限。
7.6.2 故障分类器表示层
在本文的故障分类设置中,ABIGX需要选择内部表征h(x)以定义分类SPE并驱动AFR基线搜索。我们选择倒数第二层作为默认表征,因其提供了稳定且语义有意义的特征空间,同时避免了最终对数几率层可能出现的饱和和标签特定坍缩。我们通过在TEP和晶圆图分类器上的敏感性研究验证了这一选择:在候选层中,倒数第二层表征始终产生最佳或接近最佳的解释正确性和一致性(附录图B.7和表B.13)。因此,除非另有说明,所有分类器实验均采用倒数第二层作为表征。
7.6.3 失效案例
我们观察到ABIGX的两种反复出现的失效模式。第一种情况是AFR基线优化失败(最终基线的正常性较低)。在某些样本中,基于PGD的AFR搜索虽然降低了表征空间距离,但仍收敛至正常性置信度相对较低的基线,表明优化陷入了较差的局部最优。当最终基线仍非正常时,所得IG路径不再代表有意义的"故障到正常"过渡,归因正确性(如GT-AUC)随之下降(图B.8)。作为实际保障措施,在这些情况下我们可以回退至期望IG,即从输入空间正常样本池中抽取基线,而非依赖搜索得到的AFR基线,从而提高鲁棒性。
第二种情况是低置信度模型预测(本质上模糊的样本)。这类失效源于模型本身对被解释样本赋予较低的故障置信度。在此情况下,归因可能与人工标注的真实值对齐不佳,但这并非因为解释器不正确,而是因为底层决策本身不确定(图B.6)。这种行为是符合预期的:ABIGX旨在解释模型的决策机制,当模型置信度较低(或接近决策边界)时,任何忠实的解释都将反映这种模糊性,而非强制与外部标注对齐。
8 结论
本文提出了一种统一框架ABIGX,用于解释通用FDC模型。ABIGX源于CP和RBC的核心要素,这两种方法在PCA模型故障诊断中已取得显著成功。本文提出的新型故障重构方法AFR是ABIGX的核心组成部分。AFR从对抗攻击的视角重新构建现有方法,并通过新型分类SPE指标将FR推广至故障分类任务。对于可解释故障分类,我们从故障类别模糊化的角度分析了各方法的性能。与显著性图和IG相比,我们证明了ABIGX能够以更低的故障类别模糊化程度提供更准确的变量贡献。对于可解释故障检测,我们从理论上证明了线性CP和RBC与ABIGX的等价性。通过定量指标,在广泛模型和数据集上的实验验证了ABIGX在故障诊断和深度学习解释两个领域中相较于其他先进解释器的总体优越性。
编辑:Leo
校核:李正平、陈凯歌、曹希铭、赵学功、白亮、任超、海洋、陈宇航、Kira、Tina、王金、赵诚、肖鑫鑫、张优
该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除