PhysicsAI模型训练:架构、超参数与数据准备
上一篇我们了解了 PhysicsAI 的整体架构与工作流。本篇深入模型训练环节,系统讲解三种AI架构(GCNS、TNS、SER)的差异、核心超参数的调优方法,以及输入特征与迁移学习的使用。掌握这些内容,才能训练出精度高、泛化强的物理AI模型。
一、训练流程概述
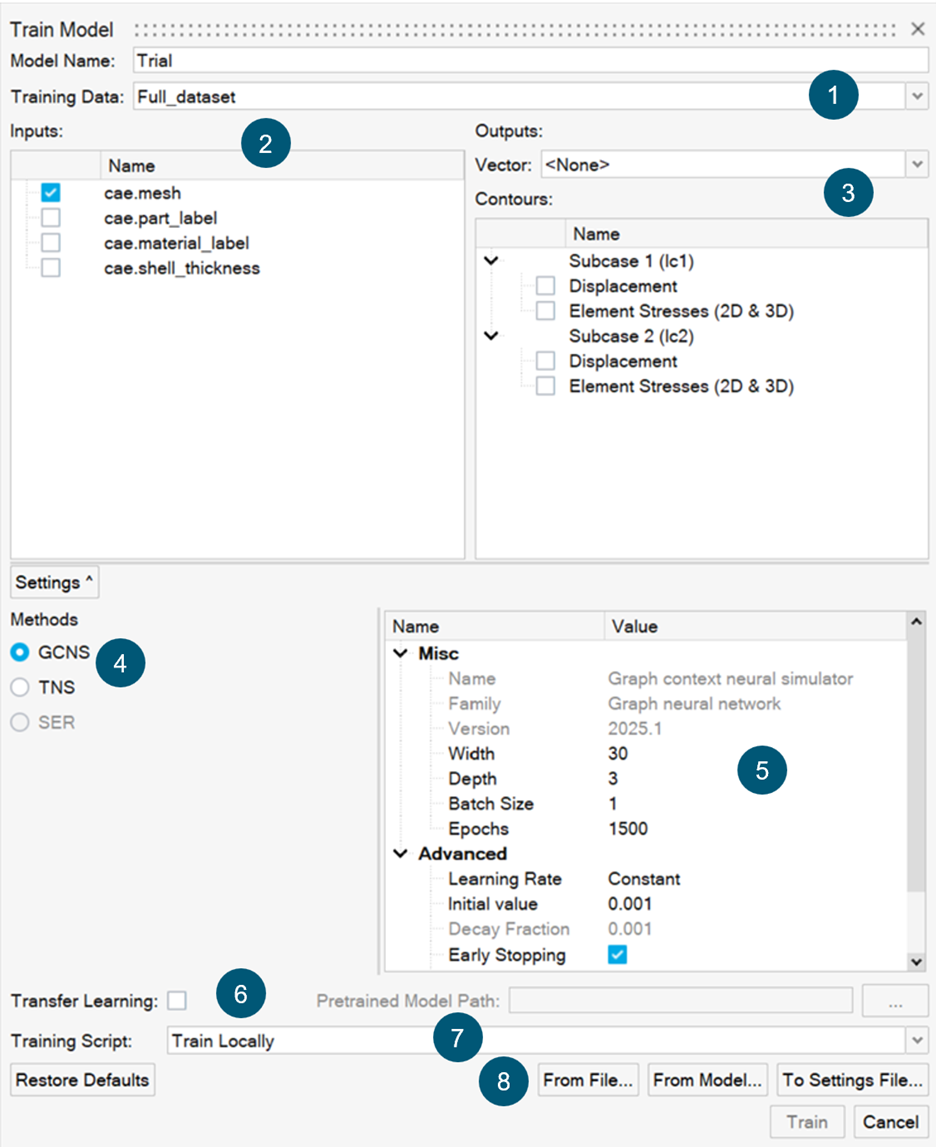
训练通过 Train Model 对话框完成。在该对话框中,需要定义训练的详细信息,包括:模型名称、训练数据集、输入/输出选择、训练脚本、超参数。此外,还可以启用迁移学习(Transfer Learning),并选择 Mesh Alignment 选项以处理空间平移的网格。
PhysicsAI 提供三种AI方法:GCNS(默认)、TNS 和SER。三者各有适用场景,后文将详细对比。
二、训练核心概念
理解训练过程,首先要掌握两个核心概念:
•Epoch(轮次)
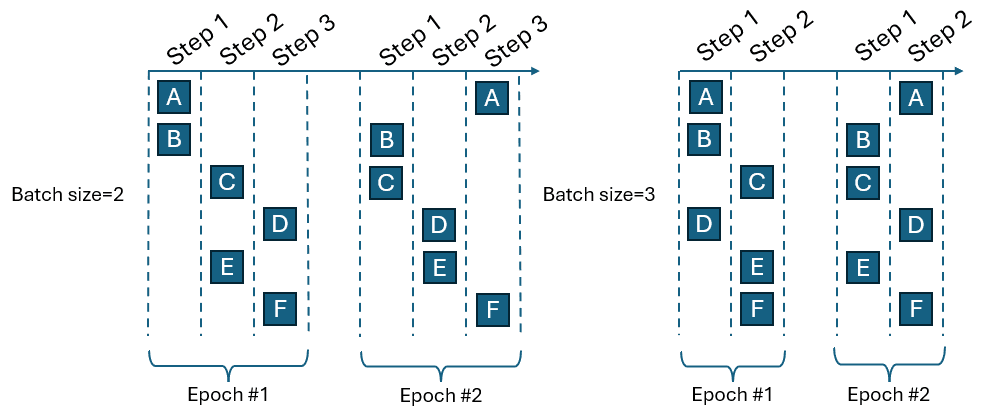
:一次完整的训练迭代,即模型遍历整个训练数据集一次。 •Batch size(批大小)
:每个训练步骤(step)所使用的数据点数量。
举例说明:当有 6 个数据点、训练 2 个 epoch 时:
•
若 batch size = 2,则每个 epoch 有 3 个 step,2 个 epoch 共 6 个 step; •
若 batch size = 3,则每个 epoch 有 2 个 step,2 个 epoch 共 4 个 step。
三、三种AI架构对比
PhysicsAI 提供三种神经网络架构,适用于不同的预测场景:
3.1 GCNS(Graph Context Neural Simulator)
默认架构。在 CPU 上比 TNS 更快,内存占用更少,训练过程更稳定。适合大多数常规预测任务。
3.2 TNS(Transformer Neural Simulator)
基于 Transformer 的架构。在 GPU 上速度更快,参数量更大,具有网格尺寸不变性(对CAD输入尤其友好),生成的云图轮廓更平滑,推荐用于瞬态与大变形场景。
3.3 SER(Shape Encoding Regressor)
仅支持向量输出(KPI/曲线),训练与预测速度远快于另外两种架构。当只需要预测标量KPI或曲线时,SER 是最高效的选择。
四、超参数详解
超参数直接决定模型的容量与收敛行为。PhysicsAI 的核心超参数包括:
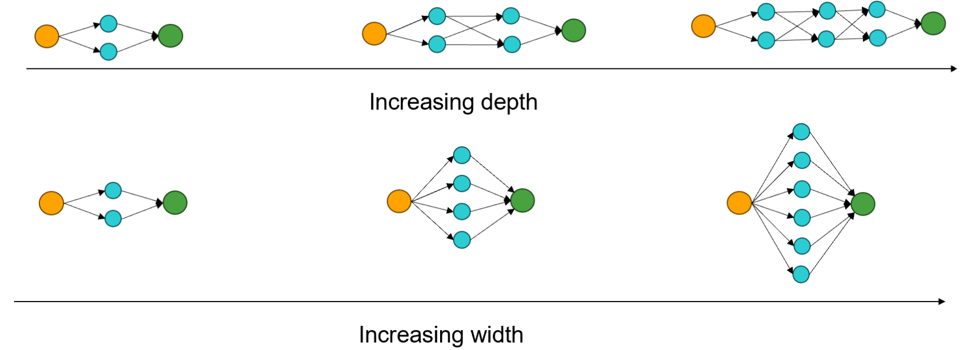
•Width(宽度)
:起始层的神经元数量,决定模型容量; •Depth(深度)
:神经网络的层数,影响模型表达能力; •Epochs(轮次)
:训练轮数,即模型遍历数据集的次数; •Batch size(批大小)
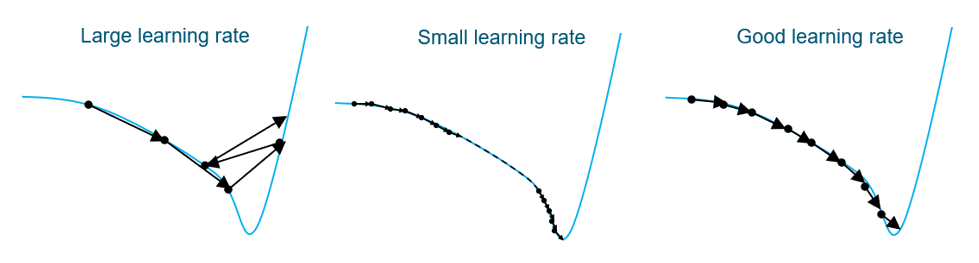
:每个 step 的数据点数量,默认为 1; •Learning rate(学习率)
:步长大小,采用余弦衰减(cosine decay)策略。
对于 TNS 架构,还有两个专属超参数:Sections(上下文分辨率,范围16~128)和Heads(多头注意力头数,范围4~16)。
五、输入特征
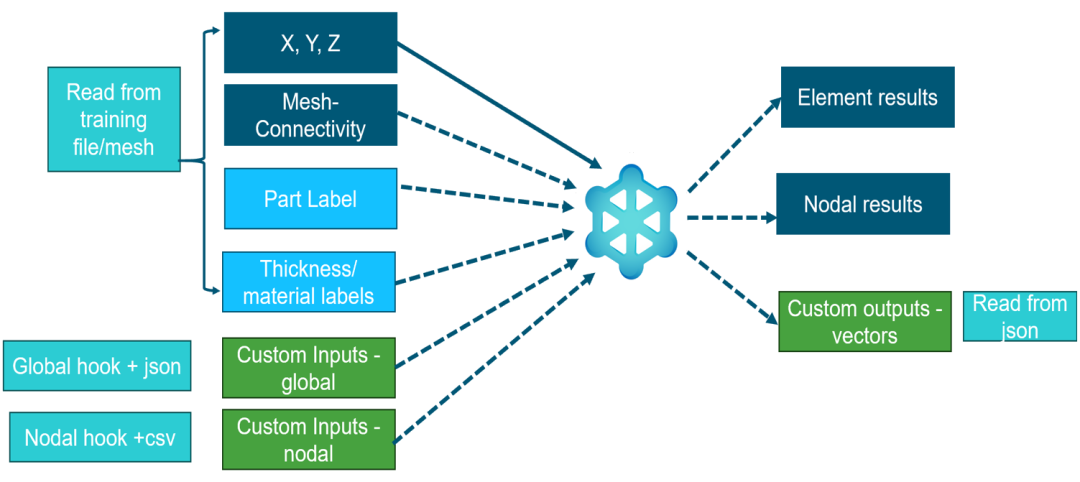
PhysicsAI 的输入特征决定了模型能"感知"哪些物理信息。内置的输入特征包括:
•
cae.coord:空间坐标,始终启用,是模型的基础输入; •
cae.part_label:部件名称,作为预测因子参与训练; •
cae.shell_thickness:2D壳单元的厚度; •
cae.material_label:材料名称。
除内置特征外,PhysicsAI 还支持两类自定义钩子(hooks):全局钩子(Global hooks)(.json + Python)和节点钩子(Nodal hooks)(.csv + Python),用于注入用户自定义的物理量。
六、迁移学习
迁移学习(Transfer Learning)允许以已训练好的模型作为起点,在新数据集上继续训练。这适用于模型复用和模型更新两种场景。
需要注意的是:由于存在灾难性遗忘(catastrophic forgetting),新训练得到的模型仅对新数据集准确,原有模型在新数据上的预测能力可能下降。因此迁移学习更适合在相似数据集间进行。
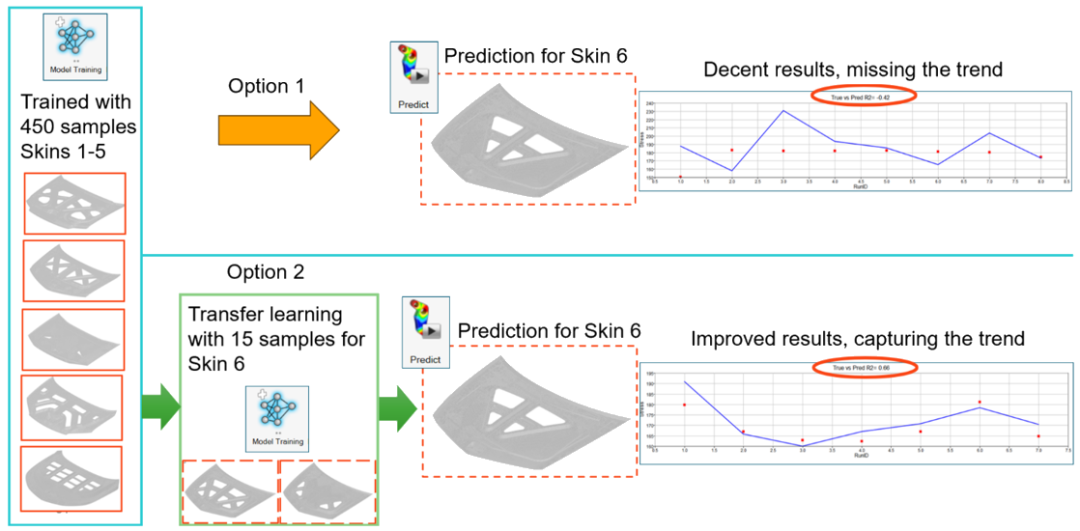
迁移学习建议:当新数据集与原数据集物理规律相似、仅几何或工况有少量变化时,迁移学习能显著减少所需训练数据与时间。若两者差异较大,建议从头训练以避免灾难性遗忘。
—— HyperWorks 2026 AI驱动CAE系列 · 完 ——