首页/文章/ 详情

故障诊断大模型 | 可靠性感知的动态图融合与基于大语言模型的轴承故障诊断助手 (上)
1天前浏览3

    如何让多个故障诊断模型真正实现优势互补,而不是简单地投票或加权平均?本期推荐篇论文《Reliability-aware Dynamic Graph Fusion and LLM-based Diagnostic Assistant for Bearing Faults》提出了一种融合动态知识协作、分层证据融合与大语言模型的轴承故障诊断框架。研究通过 VAE 提取全局运行状态,利用图注意力网络(GAT)动态构建诊断智能体之间的协作关系,并引入类似学术同行评审的“回答者—评审者”机制;进一步结合离线可靠性校准与双层 Dempster–Shafer 证据融合,提高噪声干扰、传感器失效及工况变化下的诊断鲁棒性。最后,借助 LLM 与检索增强生成(RAG),将诊断结果及中间证据转化为可追溯、可核查的自然语言报告。由于论文篇幅较长,分为上下两篇介绍。

    论文基本信息

    论文题目:

    Reliability-aware dynamic graph fusion and LLM-based diagnostic assistant for bearing faults

    论文日期:2026(online)

    发表期刊:

    Advanced Engineering Informatics 74 (2026), 104720

    论文链接:

    https://doi.org/10.1016/j.aei.2026.104720

    作者:

    Tantao Linᵇ,Zhijun Renᵃ˒ᵇ˒*,Kai Huangᵇ,Xinzhuo Zhangᵇ,Hamid Reza Karimiᶜ,Yongsheng Zhuᵇ,Jun Hongᵇ

    作者单位:

    ᵃ Frontier Institute of Science and Technology, Xi'an Jiaotong University, Xi'an 710049, China.

    ᵇ Key Laboratory of Education Ministry for Modern Design and Rotor-Bearing System, Xi'an Jiaotong University, Xi'an 710049, China.

    ᶜ Department of Mechanical Engineering, Politecnico di Milano, Milano 20156, Italy.

    作者简介:

    任智军,机械工程博士,西安交通大学前沿科学技术研究院助理教授、硕士生导师。(来源:https://faculty.xjtu.edu.cn/renzhijun/)

    目录

    摘要

    1. 引言

    2. 预备知识

      2.1. DS 理论

      2.2. LLM-Agent

    3. 方法

      3.1. 样本感知的图协作诊断

        3.1.1. 通过 VAE 建模全局状态

        3.1.2. 基于图注意力的智能体门控

        3.1.3. 回答者—评审者角色分配

      3.2. 结合离线可靠性校准的证据级融合

        3.2.1. 离线校准的类别级权重与全局可信度

        3.2.2. 内层评审融合

        3.2.3. 外层最终融合

        3.2.4. 诊断智能体与 VAE 的训练

        3.2.5. 图注意力网络的训练

        3.2.6. 推理阶段

      3.3. 用于轴承融合诊断的基于 LLM 的多智能体助手

        3.3.1. 用户交互层

        3.3.2. 意图路由层

        3.3.3. 任务执行层

        3.3.4. 知识库构建与存储层

        3.3.5. 记忆层

    4. 实验

    5. 结论

    摘要

    融合和解释异构证据仍然是多源轴承故障诊断中的一项重大挑战,尤其是在存在噪声、传感器失效和工况变化的情况下。本文提出一种可解释的诊断框架,将基于图的智能体协作、分层证据融合以及基于大语言模型(LLM)的诊断助手集成在一起。首先,构建样本自适应的动态诊断图,将传感器专属的基础模型构建为能够交互的回答者—评审者智能体。利用变分自编码器(VAE)提取全局运行状态表示,以此对图注意力进行条件化,从而实现逐样本的智能体权重分配与拓扑结构自适应。其次,提出一种结合离线可靠性校准的双层 Dempster–Shafer(DS)融合方案:内层融合整合评审者证据,以抑制高度冲突的意见;外层融合则聚合委员会层面的决策,逐步吸收不确定性。最后,基于 LLM 的助手在领域知识库检索的支持下,将结构化的诊断轨迹转换为面向维护、可验证的解释。实验表明,该框架能够持续提高诊断准确率并降低输出熵,同时增强过程可追溯性,支持人类与人工智能协同决策。

    关键词: 轴承故障诊断;多源信息融合;图注意力网络;Dempster–Shafer 证据融合;大语言模型。

    1. 引言

    滚动轴承是旋转机械中的关键部件,其健康状况直接影响运行稳定性、维护成本和系统安全性 [1–3]。由于轴承故障可能逐渐导致严重退化或意外停机,轴承故障诊断已成为智能维护和状态监测领域的重要课题。

    近年来,轴承故障诊断已从传统信号处理和浅层学习逐步发展为数据驱动的智能范式 [4]。基于深度学习的方法显著提升了从原始信号、变换后信号以及时频信号中自动提取故障敏感表征的能力,从而减少了对人工设计特征的依赖 [5,6]。近期研究进一步将这一方向拓展至跨域泛化和有限标签学习。例如,基于迁移学习的方法提升了不同工况下的诊断适应性 [7–9];采用联合损失的半监督自编码器提高了振动信号标签有限时的标签利用效率 [10];知识引导的深度网络则通过将先验工程知识引入诊断过程来增强鲁棒性 [11]。这些进展表明,近期研究日益关注的不仅是诊断准确率,还包括数据效率、鲁棒性及工程适应性。

    与此同时,随着异构传感器在工业系统中的部署不断增加,轴承监测已逐渐从单源感知发展为多源观测,即联合采集振动、声学、转速、电流及其他异构信号 [12–14]。与单源诊断相比,多源融合能够提高诊断准确率、鲁棒性,以及对噪声或部分信息缺失的容忍能力。现有故障诊断多源融合研究大致可分为以下三类:

    (1)数据级/特征级融合。 此类方法通过拼接异构信号、对齐潜在特征,或者利用具有共享融合模块的并行分支,学习多个通道的联合表示 [15–18]。当参与融合的通道能够持续提供有效信息且对齐良好时,这些方法是有效的;然而,它们通常将融合策略隐式编码在网络参数中,因此往往缺乏在单个样本层面显式重新分配各信息源贡献的机制。因此,当传感器失效、突发噪声或显著工况变化导致不同样本的信息源质量发生变化时,不可靠的通道仍可能被传播至共享表示中,具有误导性的跨模态交互甚至可能被放大,而不是受到抑制。

    (2)决策级融合。 此类方法通过加权平均、投票或基于 Dempster–Shafer(DS)证据理论的规则,将不同传感器或分类器的输出组合起来 [19–21]。其中,DS 理论因能够显式描述不确定性和无知程度,并为多源证据融合提供灵活框架而得到广泛应用。现有基于 DS 的研究主要沿着两条路线展开:其一,引入考虑不确定性的信源加权或置信度建模,例如将 DS 理论与基于 Dirichlet 分布的不确定性建模相结合,实现置信度感知的传感器加权 [22];其二,通过修改组合规则本身或重新分配冲突质量,提高高冲突条件下的鲁棒性 [23]。与数据/特征级融合相比,这些方法能够更加灵活地集成异构模型,也更适合进行考虑不确定性的聚合。然而,大多数现有研究仍将传感器或分类器视为相对静态、同质化的信息源,只在全局、模型或工况层面估计其可靠性。因此,它们虽然能够组合存在分歧的输出,但当跨模态证据既相互冲突又具有不均衡的可靠性时,通常仍无法判断当前样本应当更加信任哪个信息源。诊断模型之间逐样本变化的动态信任关系因而很少得到刻画,其与深度特征学习和自适应结构建模的结合也仍然有限。

    (3)基于图的建模。 此类方法构建样本空间图或传感器空间图,并通过图卷积或注意力机制进行信息传播 [24–27]。例如,Gao 等人 [28] 在      近邻(k-NN)图上构建图卷积网络(GCN),以捕获传感器数据之间的关系。尽管此类方法在建模高阶相关性和非局部依赖方面十分有效,但其图结构通常局限于样本和传感器层面。换言之,它们主要描述相关性结构,却很少显式建模异构诊断决策者之间的协作、评审或冲突仲裁。因此,将来自不同视角的诊断模型或决策单元视为图节点,并根据当前样本的全局状态自适应调整其协作拓扑结构的做法,目前仍不常见。

    除提升融合性能外,实际轴承故障诊断还要求诊断结果具有可解释性、置信度感知能力和可审计性 [29,30]。对于安全关键设备,工程师不仅需要了解诊断结果,还需要了解支持该结果的证据,以及结论的可信程度。近来,大语言模型(LLM)已成为故障诊断和预测性维护的一个有前景的研究方向,可实现自然语言交互、检索增强的知识访问以及人机协作 [31–33]。现有研究主要遵循两种代表性范式。一种范式将 LLM 本身作为以诊断为中心的模型。例如,Tao 等人 [34] 将振动信号转换为文本化的时域和频域特征,并对 LLM 进行微调,以支持跨工况、小样本及跨数据集诊断。Lin 等人 [35] 进一步提出 FD-LLM,通过结合数据—文本模态对齐和大模型微调,直接支持故障诊断和维护指导。另一种范式将 LLM 用作高层编排或解释模块,以集成诊断模型、知识图谱和维护策略。例如,Ma 等人 [36] 提出 FDRKG-LLM,用于故障诊断、维护调度和决策解释;Liu 等人 [37] 则探索协作式 LLM-Agent 机制,以提升故障识别效率。尽管这些研究展示了 LLM 在机械诊断中的潜力,但将其与样本自适应证据协作、冲突感知决策融合以及可审计推理轨迹进行系统性集成的研究仍然有限。

    在此背景下,本文所解决的关键问题并不是用 LLM 替代诊断主干模型,而是构建一个同时支持样本自适应的多模型协作、冲突感知证据融合及可审计解释的集成框架。因此,一个有效的框架应满足三项要求:在样本层面自适应调整信息源协作;在融合过程中显式管理相互冲突的证据与无知证据;保留结构化的中间轨迹,以供专家审查和解释。

    为解决上述挑战,本文提出一种动态图驱动的多智能体证据融合框架。首先,使用变分自编码器(VAE)从多源信号中提取跨模态全局状态,指导图注意力网络(GAT)自适应地构建回答者—评审者诊断智能体之间依赖样本的协作拓扑。随后,利用 DS 证据理论构建双层融合机制,将相互冲突的证据与无知证据区分处理。最后,开发一个基于检索增强 LLM 的多智能体助手,将其作为上层模块,把中间诊断轨迹转化为可验证、面向专家的解释报告。总体而言,该框架增强了决策鲁棒性、不确定性感知和可审计性,并形成模型推理、专家交互与知识演化之间的闭环。本文主要贡献概括如下:

    (1)具有显式回答者—评审者协作机制的样本自适应诊断图。 将异构传感器专属的基础模型视为能够交互的智能体,构建动态诊断图。利用 VAE 提取的全局运行状态表示对图注意力机制进行条件化,实现逐样本的智能体加权及拓扑自适应,以选择 Top-     个回答者。进一步在不断演化的图上采用加权随机游走采样方案分配评审者,从而实现有针对性的同行评审和委员会组建。

    (2)用于冲突感知决策的离线可靠性校准和分层 DS 融合。 设计一种离线校准策略,估计各模型的类别级能力和全局可信度,并将校准后的预测映射为基本概率分配,在无知集 合上显式分配概率质量。基于委员会结构,引入双层 DS 融合方案:内层融合汇总评审者证据,以抑制高度冲突的意见;随后,外层融合聚合委员会层面的证据,逐步吸收不确定性,并提供可审计的融合轨迹。

    (3)用于可审计解释和决策支持的检索增强 LLM 助手。 设计一个基于检索增强 LLM 的助手,将包含智能体选择、权重、委员会分配、冲突及融合轨迹的结构化诊断过程,转化为面向维护、可验证的解释与报告。在噪声干扰、传感器失效及工况变化条件下开展的大量实验表明,与传统投票和标准 DS 基线相比,该方法具有更好的稳定性与可靠性。

    本文其余部分安排如下:第 2 节回顾相关理论与背景;第 3 节详细介绍所提出的方法;第 4 节给出实验设计与分析;第 5 节总结全文并讨论未来工作。

    2. 预备知识

    2.1. DS 理论

    DS 理论是用于不确定性表示和证据组合的经典框架,已广泛应用于信息融合和决策支持 [38,39]。本文中的证据源是多个诊断智能体的输出;每个智能体都是一个独立训练的分类器,在识别框架      上输出经过校准的类别概率向量。对于第      个诊断智 能体,设其校准概率向量为     ,可靠性为     。在只将单元素集 合      和全集      作为焦元的常见设定下,相应的基本信任分配(BBA)定义为:


    其中,     表示由模型不确定性或信息不足引起的无知质量。

    随后,利用标准 Dempster 组合规则融合来自不同诊断智能体的 BBA [39]。由于该组合规则已十分成熟,本文为简洁起见省略其详细推导。融合后,通过 Pignistic 变换 [40] 将所得 BBA 映射为决策概率。在本文设定下,该变换简化为:


    据此,最终决策为     。

    2.2. LLM-Agent

    大语言模型通过在海量语料上预训练,获得较强的语言理解和生成能力,因此能够作为通用决策模块嵌入实际系统 [41]。将 LLM 与环境表示、工具调用及反馈机制相结合,可构成能够理解指令、规划子任务并通过交互持续自我纠正的 LLM-Agent [42]。此类智能体的核心组成包括面向任务的记忆结构、一组可调用的外部工具,以及对上下文状态的持续感知与更新 [43,44]。

    与单一、整体式的 LLM 相比,多智能体架构能够将功能分解为专门角色,并通过对话或消息传递实现协作,从而提高复杂诊断工作流的可扩展性和鲁棒性 [45,46]。典型角色包括任务路由器、执行智能体和评审智能体。路由器根据历史对话和系统状态选择下一步动作;执行智能体完成数据采样和模型推理等具体任务;评审智能体重新检查推理结果,并在必要时触发纠正措施。此外,检索增强生成(RAG)[47] 允许智能体在生成前查询结构化知识库或历史轨迹,确保其输出与最新的工程文档保持一致,并减少幻觉。

    在轴承故障诊断场景中,LLM-Agent 需要与多源传感器、数据驱动模型和不确定性量化机制紧密耦合。首先,路由层必须理解工况相关请求,并合理调度样本处理、诊断和报告生成等子任务。其次,任务执行层应读取诊断轨迹、冲突程度及置信度指标,将其转化为供专家理解的自然语言证据链解释。第三,知识库层必须不断吸收新的维护日志、实验结果及标准操作程序,以支持可验证和可审计的回答。

    3. 方法

    本节介绍所提出的动态图驱动多智能体证据融合诊断方法的整体设计。首先,针对每个输入样本,构建自适应演化的诊断协作图,以确定哪些诊断智能体担任回答者、哪些担任评审者。其次,在该图基础上引入具有离线校准先验的双层 DS 融合架构,从而显式建模每个诊断智能体的类别级可靠性与总体无知程度。为保证可复现性,还给出了清晰的训练—推理流程。最后,将诊断全过程产生的结构化轨迹与基于 LLM 的多智能体诊断助手对接,实现检索增强、可验证的自然语言解释。

    3.1. 样本感知的图协作诊断

    如图 1 所示,本节介绍所提出的动态图评审与融合协作诊断框架的整体结构。框架由三个关键步骤组成:(1)利用 VAE 将多源数据映射到全局状态向量;(2)将该全局状态向量输入基于 GAT 的门控模块,获得智能体置信权重及当前预测图;(3)根据置信权重选择回答者智能体,并从图中采样评审者智能体,以产生最终决策。
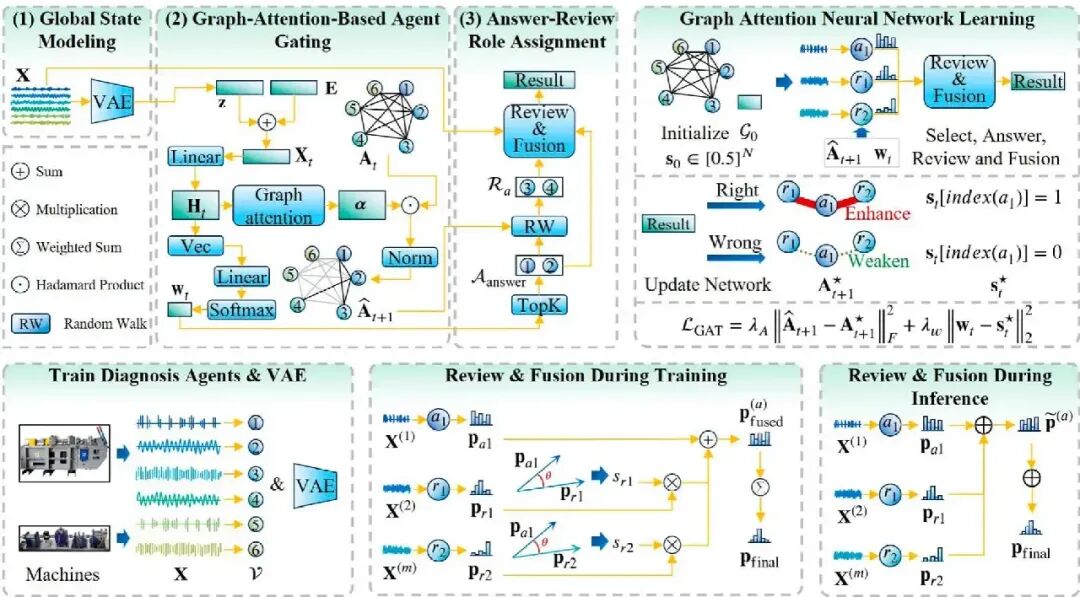
    图 1. 采用动态图评审与融合的协作诊断框架。

    3.1.1. 通过 VAE 建模全局状态

    在多源轴承诊断场景中,原始信号通常包含多种类型(如振动、电流、声发射等),采样率彼此不同,并且工况各异,因此单一诊断模型很难在所有工况下均保持稳定性能。在本文中,将多个互补的故障诊断模型抽象为一组诊断智能体     。每个智能体      都是独立训练的分类器,其输入可以是单源或多源数据,输出则是类别概率向量     ,其中      表示类别数。

    为了捕获当前多变量输入的全局状态,本文使用 VAE(如图 2 所示)对多源输入      的潜在状态进行建模。对      进行适当预处理(如归一化和截断)后,将信号展平并堆叠为矩阵     ,其中      表示信号类型数量,     是每类信号的特征维度。编码器和解码器均采用适于处理时间序列数据的卷积神经网络(CNN)架构。

    为了捕获当前多源输入的全局状态,采用变分自编码器(VAE)将预处理后的信号矩阵      编码为潜在表示     ,其中      是信号类型数量,     是每类信号的特征维度。在本文中,VAE 充当样本级状态编码器,而不是方法研究的重点。因此,这里仅保留其提取全局状态的作用。在推理过程中,使用后验均值      作为全局状态向量,并将其输入后续图注意力模块。

    编码器      将      映射为潜变量      上的条件分布。在推理过程中,取均值估计      作为全局状态向量,并将其输入图模型。
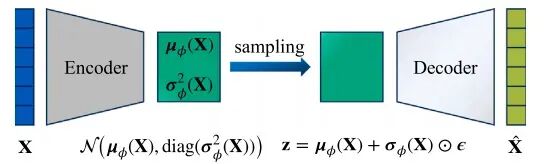
    图 2. VAE 编码器—解码器架构示意图。

    3.1.2. 基于图注意力的智能体门控

    给定样本级表示     ,需要判断哪些智能体对于当前样本更加可信,以及哪些智能体更适合担任辅助评审者。为此,设计了基于 GAT 的 门控机制。诊断智能体被视为图中的节点,智能体之间的关系(如相似性、历史协作关系)被建模为边,从而形成时刻      的动态图     。其中,     是节点/智能体集 合,    ,     是边集 合。加权邻接矩阵为     ,较大的矩阵元素表示较强的连接强度。GAT 通过注意力机制动态计算节点间权重,从而实现诊断智能体的自适应选择与加权。

    为了联合编码当前样本状态和历史先验信息,从而增强表示能力,将当前全局状态      和可学习的节点嵌入矩阵      注入节点表示,构造节点输入矩阵:


    其中,     是全 1 列向量,用于将      复 制到      个节点。因此,    。接下来,通过线性变换与非线性激活获得:


    其中,     是可训练的线性投影矩阵,     表示 ReLU 非线性函数,     是维度为      的潜在空间中的节点表示。边注意力分数定义为:


    其中,     是节点      到节点      的注意力分数,     为 LeakyReLU 激活函数,     是可学习的注意力向量,     表示相应行向量的拼接。系数      是通过逐行 softmax 归一化得到的注意力权重,分母在节点      的邻域      上求和。将注意力权重作用于当前邻接矩阵,可得到下一时间步的预测邻接矩阵:


    其中,     表示 Hadamard 积,     是注意力矩阵,     是保证数值稳定性的图结构归一化算子。随后应用线性映射     ,得到诊断智能体置信权重:


    其中,     表示通过堆叠      的行(或列)进行向量化;softmax 产生总和为 1 的非负权重;     为      维概率单纯形。

    3.1.3. 回答者—评审者角色分配

    虽然图注意力能够提供智能体的“重要性排序”,但有效的协作诊断还需要明确分配角色。根据图注意力门控模块输出的置信权重     ,每个智能体的权重反映其针对当前输入样本的可信度及任务相关性。因此,系统按照式(11)选择置信度最高的 Top-     个智能体作为回答者,类似于同行评审过程中,作者主动提交其最可靠的成果。这一机制确保诊断决策主要由最可靠、最相关的子模型发起,减轻低质量回答的影响,并使后续评审阶段能够重点关注正确性潜力更高的代表性候选结论:


     其中,     返回      中最大的      个元素的索引,     表示选中的回答者集 合,     是超参数。在训练期间,为了促进多样性和鲁棒性,回答者智能体改为通过无放回随机采样选取。

    在实际学术同行评审中,论文通常分配给研究背景高度相关的专家,以确保评审具有针对性且技术上充分。类比这一过程,本文旨在智能体之间建立由相似性驱动的评审分配机制,使每位回答者的输出由图结构中在语义或特征上最相关的其他智能体进行评价。

    设分配给每个回答者智能体的评审者数量为     。对于每个回答者     ,在当前图      上执行加权随机游走(RW)[48] 来分配评审者,其中转移偏好由      中的边权重决定。为实现无放回采样,在第      步定义已访问节点集 合为:


    下一位评审者从经过掩码处理的转移分布中采样:


    其中,     表示当前节点,     是指示函数。从      出发,随机游走最多进行      步;若没有未访问的邻居节点,则提前终止。所得评审者集 合记为     ,其中     ,且当      时     。

    这一过程实际上形成了一组小型局部委员会。每个委员会由一名回答者和若干名在图中密切相关、但意见可能不同的评审者组成。这些局部委员会为后续“先局部融合,再全局聚合”的策略奠定了基础。

    3.2. 结合离线可靠性校准的证据级融合

    在前一步得到的局部委员会中,不同诊断智能体面对同一样本时,可能表现出不同的可靠性和不确定性。因此,直接平均或投票容易使不可靠意见获得过大的影响,尤其是在跨模态证据既相互冲突又可靠性不均衡时。为解决这一问题,本文并不只依赖单层置信度加权或事后冲突处理,而是引入双层 DS 融合方案。具体而言,首先通过离线校准估计每个智能体的类别级能力和总体可信度,并构建显式包含无知质量的可靠性感知 BBA;随后,从每个委员会内部的局部评审开始逐步聚合,直至形成跨委员会的全局共识。

    3.2.1. 离线校准的类别级权重与全局可信度

    如算法 1 所示,首先在验证集      上计算每个智能体      的软混淆统计量:


    其中,     表示针对真实类别为      的样本,其被分配给预测类别      的累计概率质量;     表示指示函数;     是智能体      对样本      预测为类别      的概率。根据这些统计量,采用拉普拉斯平滑参数 ,将类别级精确率与召回率定义为:


    其中,     衡量被预测为类别      的结果的正确程度,     衡量真实类别      的召回程度。进一步定义类别级 F1 分数及对应的类别权重:


    其中, 是用于数值稳定性的小常数, 为锐化因子( 突出表现较强的类别,     则使分布更加平坦),     表示智能体      对类别      的可靠性。

    算法 1. 离线校准:类别级权重与全局可信度。
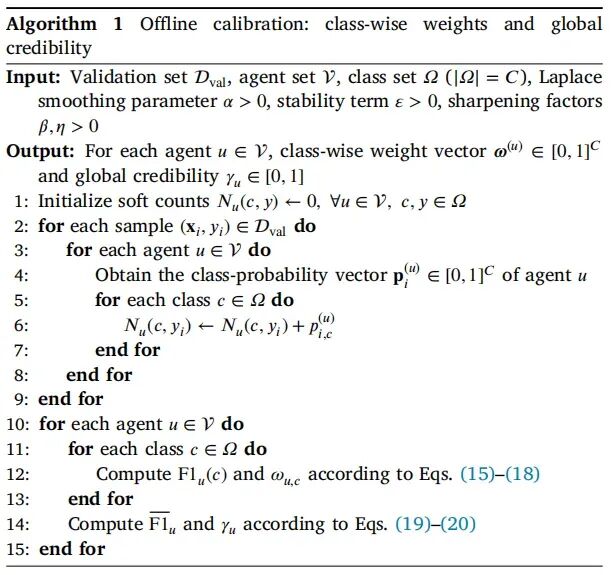
    随后,通过宏平均 F1 分数估计总体可信度:


    其中, 控制可信度分布的集中程度( 会放大强智能体与弱智能体之间的差异),     被视为智能体      的全局可信度。因此,指数      和      分别独立调节类别内部的锐化程度和智能体之间的可信度对比,使“强评审者”在融合过程中具有更大的影响力。随后应用经过校准的类别级可靠性,并重新归一化:


    其中,     是上述类别权重向量,     强制满足各元素之和为 1 的概率约束。

    为与第 2.1 节介绍的双焦元建模保持一致,这里采用相同形式的 BBA,以使内层和外层融合均可直接通过标准 DS 组合实现。最后,将校准后的概率      和全局可信度      映射为 BBA:


    这种 BBA 表示通过在      上分配概率质量,显式编码“不确定”或“模糊”的判断,而这一特征往往被传统概率融合方法忽略。

    3.2.2. 内层评审融合

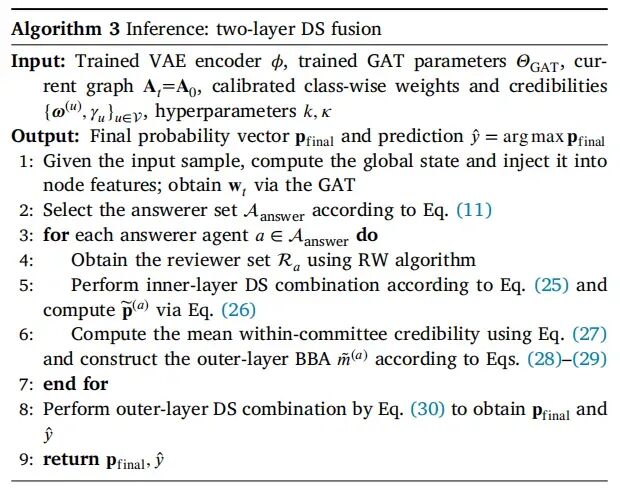
    对于每个 局部委员会,根据经过离线校准的 BBA 执行内层融合。设与回答者智能体      对应的评审者集 合为     ,则相应的内层融合为:


    其中,     表示 Dempster 组合规则 [39],     表示回答者智能体      经内层评审融合后的概率输出。

    3.2.3. 外层最终融合

    不同回答者智能体对应不同领域和传感器组合,需要在更高层级进一步集成各委员会层面的结论。因此,将回答者的内层输出视为独立专家的意见,在“全体会议”层面聚合不同领域专属委员会的决策,从而形成全局共识。为避免类别级偏差的重复引入,外层融合采用统一类别权重     ,而聚合可信度根据委员会内部的可信度统计量构建:


    其中,     是与回答者      对应的委员会内部平均可信度,     是根据      和      构建的外层 BBA。最终输出为:


    当      时,式(30)退化为     。这一分层结构在减轻单层决策偏差的同时,强化了局部一致性和领域专属性,并且可以被视为多层社会决策过程的一种数学实例化。

    3.2.4. 诊断智能体与 VAE 的训练

    诊断智能体模型可以灵活选择,包括传统机器学习模型和深度神经网络。每个智能体在训练集上独立训练,通过优化类别预测的交叉熵损失来学习。训练结束后,保存所有智能体模型的参数,供推理阶段使用。

    VAE 以      为输入,按照标准变分自编码框架 [49] 进行训练。训练后,VAE 用于为每个输入样本提取全局状态向量     ,作为后续图注意力编码器的条件信息。

    3.2.5. 图注意力网络的训练

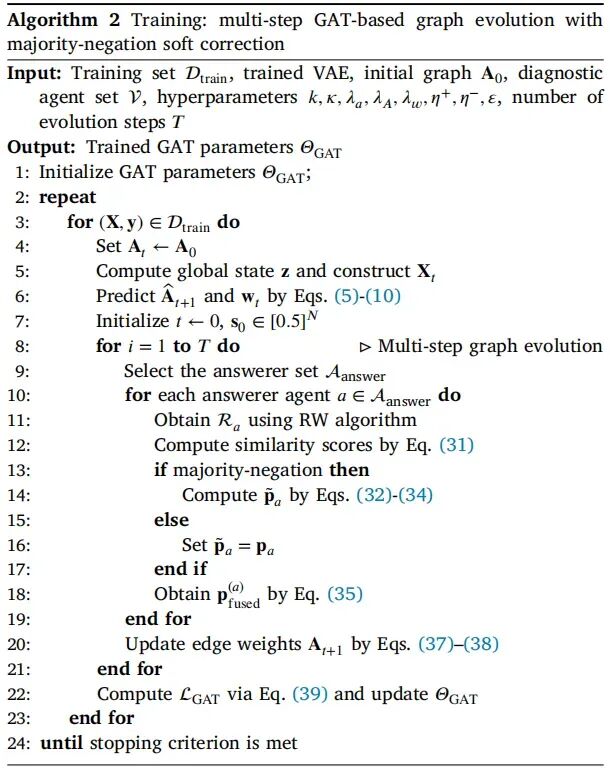
    为了使第 3.1 节的协作机制具备可学习性,训练时引入显式的“多数否定与软修正”监督信号,使回答者智能体在获得同行评审反馈后能够调整有偏的预测,并逐步学习更加可靠的预测分布。该机制受人类同行评审过程启发:作者(对应回答者智能体)提交初稿后,如果大多数评审者(对应评审者智能体)不同意其结论,作者通常会综合评审意见修改稿件。

    首先,按照式(31)计算每个回答者与其评审者之间的预测分布相似度,以量化意见一致性:


    其中,     为欧氏范数,对于概率向量,    ,用于衡量回答者与评审者预测分布的一致程度。

    如式(32)—(34)所示,当发生多数否定事件——即超过半数评审者不同意回答者预测概率最高的类别——系统将自动触发修正机制:用评审者分布的相似度加权融合结果替代回答者智能体的输出,以反映集体意见:


    其中,     是指示函数,     返回最大分量对应的索引,     是经过评审者修正的回答分布,     且      为归一化权重。函数      是用于控制相似度敏感性的非负单调映射(例如恒等映射、温度缩放或幂变换);本文采用 ReLU 函数     。因此,这种修正不是硬性覆盖,而是考虑相似度的软调整,一致性较高的评审者发挥更大作用。该软修正机制使模型在训练过程中学会如何“倾听”同行意见,从而增强回答者智能体的稳定性和协作性,体现一种受社会过程启发、基于博弈论的自演化诊断逻辑。

    如果未触发多数否定条件,则令     。对于每个回答者,随后执行回答者—评审者融合:


    其中,     为智能体      的融合分布, 是分配给回答者项的先验权重,用来控制回答者与评审者的相对影响。分母确保融合结果仍为凸组合。

    最后,对多个回答者智能体的融合输出进行线性聚合,得到最终概率向量     :


    其中,     表示选中的回答者智能体数量。     仅用于在训练期间监测聚合输出,不参与 GAT 的损失计算或参数更新。

    为了使 GAT 能够观察足够多的协作轨迹并实现有效学习,针对每个样本执行      步图演化。为捕获由可靠共识所引起的结构演化,考虑回答者      及评审者     ,将正确一致性的指示量定义为:


    其中,     是独热编码的真实标签。只有当回答者和评审者都预测正确类别(与      一致)时,才有     。边权重随后更新为:


    其中,     是时刻      的边权重,     分别是在正确一致时进行强化以及其他情况下进行衰减的步长。当     (阈值     )时,删除该边。对反向边      对称地应用同一更新,以维持无向图,得到具有“正确强化、错误衰减”动力学特性的自演化结构。

    GAT 的整体训练过程同时结合结构监督和权重监督,如算法 2 所示。对于每个样本(或小批量),通过最小化式(39)定义的损失函数      来更新 GAT 参数     :


    算法 2. 训练:基于 GAT 的多步图演化及多数否定软修正。
    其中,     是结构预测头的输出,     是目标邻接结构,     表示 Frobenius 范数。向量      是智能体正确性的指示量:根据每个智能体的预测标签      与真实标签之间的比较,将其构造为独热向量。标量      是两个损失项的权重系数。

    3.2.6. 推理阶段

    在推理阶段,首先利用离线校准得到的类别级权重和全局可信度调整每个智能体的预测概率,并构建相应的 BBA。随后应用双层 DS 融合结构进行决策,如算法 3 所示。该过程既保留局部专家共识,又保留全局集体智能;DS 理论能够有效处理多源证据高度冲突条件下的信息融合,从而增强诊断结果的鲁棒性和可靠性。

    算法 3. 推理:双层 DS 融合。
    3.3. 用于轴承融合诊断的基于 LLM 的多智能体助手

    上述融合诊断过程会产生结构化诊断轨迹,包括样本级表示、选中的回答者和评审者智能体、其权重与可信度、内外两层 DS 融合的中间量,以及最终诊断结果。为了使现场工程师及上层应用能够理解、追踪和验证这些信息,需要一个能够处理用户交互、任务调度与执行,以及诊断报告生成与存储的智能助手。为此,本文设计了一个基于 LLM 的多智能体协作诊断助手:该助手使用自然语言理解用户指令,编排底层诊断模块执行数据采样、诊断和报告生成,并以结构化、可审计的形式向用户返回结果。

    在一次典型交互中,用户通过自然语言请求轴承状态诊断,助手随后将请求路由至数据采样和多智能体协作诊断,生成决策结果及其诊断轨迹;之后在知识库中进行 RAG 检索,以生成结构化、可验证的报告并回答后续问题。

    助手的架构如图 3 所示,由五层组成:(1)用户交互层;(2)意图路由层;(3)任务执行层;(4)知识库构建与存储层;(5)记忆层。以下详细介绍各层的设计。
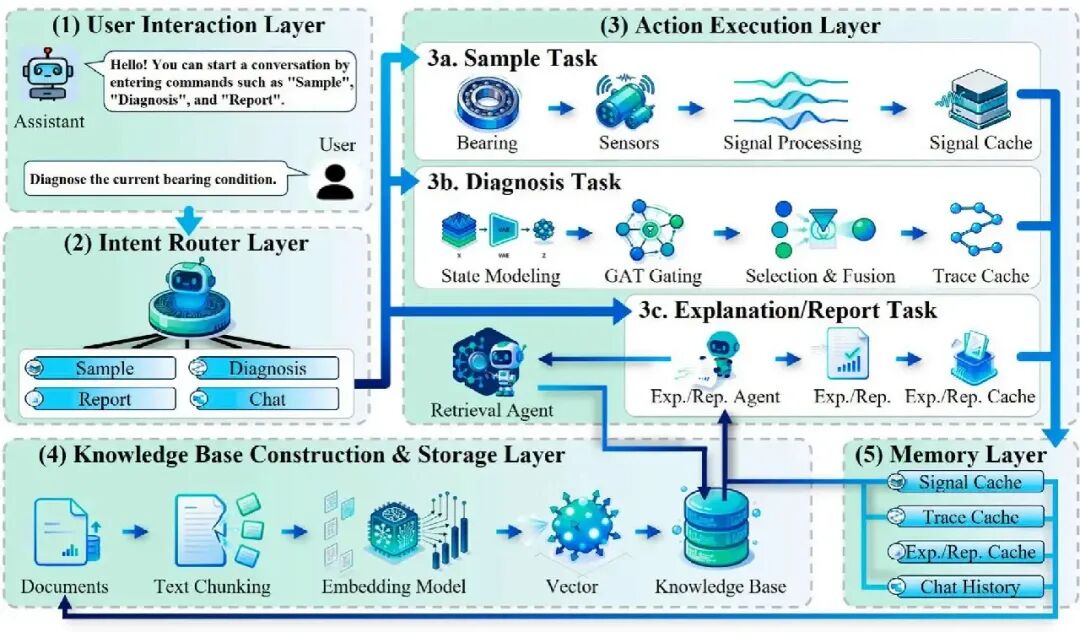
    图 3. 所提出的基于 LLM 的多智能体协作诊断助手框架示意图。

    3.3.1. 用户交互层

    用户交互层支持与用户进行自然语言交流,记录用户与助手之间的对话历史     ,并将关键指令及上下文摘要写入对话记忆     ,以维持跨轮次的一致性。

    3.3.2. 意图路由层

    基于 LLM 的路由器以      和系统状态     (例如缓存和知识库(KB)的可用性)为条件,输出工具选择分布:


    其中,    ,     是子任务集 合。选择概率最高的子任务,记为     ,用于触发对应模块。当请求涉及解释或引用时,同时调用第 3.3.4 节的知识库检索。

    3.3.3. 任务执行层

    采样任务(Sample task)。 根据采样配置     ,从指定轴承节点采集多源信号(例如振动、声学、电流和转速)。经过标准化信号处理和分段后,将数据整理为     ,并写入信号缓存     ,以支持低延迟复用。其中,     表示信号源集 合。

    诊断任务(Diagnosis task)。 VAE 提取全局状态,GAT 执行智能体选择和结构预测。基于 DS 证据理论的回答者—评审者协作及双层融合随后产生      和诊断轨迹(包括选中的智能体、注意力权重、冲突程度和其他中间量),并将其写入轨迹缓存     。

    解释/报告任务(Explanation/report task)。 报告智能体读取     、     和     ,构造查询      进行知识库检索,并根据检索到的上下文     ,生成结构化、可验证的报告(包括结论、证据链、建议及引用位置)。生成的报告被存储于报告缓存     。解释智能体则利用      和     ,为诊断结果生成解释和过程描述。

    普通聊天任务(Normal chat task)。 当路由器选择聊天任务时,助手根据      和      生成标准对话回复,支持常见问题式交互以及诊断结果解释。

    3.3.4. 知识库构建与存储层

    将领域文档集 合     (例如设备手册、传感器规格、诊断模型说明和故障案例)分块、嵌入,并使用近似最近邻(ANN)引擎(如 FAISS)建立索引,以支持 RAG。在检索过程中,计算查询      的嵌入,并返回相关性最高的 Top-     个文本块     ,供报告智能体使用。

    3.3.5. 记忆层

    记忆层统一管理四类缓存:    、    、     和     ,从而维护包括缓存可用性、知识库索引状态及其他路由决策所需元数据在内的全局状态     。必要时,还将数据和文档持久化,以扩充知识库并支持持续学习和更新。

    通过上述架构,操作人员能够借助与诊断助手的自然语言交互,完成从信号采集、故障诊断到报告生成的整个工作流。多智能体协作框架不仅提高了诊断的自动化和智能化水平,也增强了可解释性与可追溯性,满足工业场景对可靠诊断决策的要求。


    上篇结束。原文第 4 节“实验”及之后的内容见下篇。


    编辑:Kira
    校核:李正平、陈凯歌、Leo、曹希铭、赵学功、白亮、任超、海洋、陈宇航、Tina、王金、赵诚、肖鑫鑫、张优
    该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除
    来源:故障诊断与python学习
    MechanicalSystem振动非线性旋转机械通用航空python海洋声学理论电机化机控制人工智能
    著作权归作者所有,欢迎分享,未经许可,不得转载
    首次发布时间:2026-10-28
    最近编辑:1天前
    故障诊断与python学习
    硕士 签名征集中
    获赞 87粉丝 153文章 343课程 0
    点赞
    收藏
    作者推荐

    新锐期刊一区TOP论文推荐|注意力引导的图同构学习:面向故障诊断与剩余使用寿命预测的多任务框架

    本期给大家推荐注意力引导的图同构学习:面向故障诊断与剩余使用寿命预测的多任务框架。旋转机械的智能运维正从单一故障诊断迈向多任务协同决策。故障诊断与剩余使用寿命(Remaining Useful Life, RUL)预测是保障设备可靠运行的两大核心,但传统状态监测往往为二者分别建模,导致知识共享效率低、深度学习模型部署与维护成本高昂。图卷积网络凭借对图数据的强大表征能力为状态监测提供了新范式,然而如何在同一框架下实现诊断与预测的协同仍具挑战。针对此,本研究提出一种融合注意力机制的多任务图同构网络,通过参数共享与自注意力机制建模任务间关联,同步完成故障诊断与RUL预测。基于轴承全生命周期退化数据的实验验证表明,该方法较传统单任务方法精度更高、实用性更强,并可显著降低模型开发成本,为旋转机械的智能故障诊断与寿命预测提供了兼具学术价值与工程潜力的新方案。论文基本信息论文题目:Attention-guided graph isomorphism learning: A multi-task framework for fault diagnosis and remaining useful life prediction 论文期刊:Reliability Engineering and System SafetyDoi:10.1016/j.ress.2025.111209作者:Junyu Qi (a,b), Zhuyun Chen (a, c, *), Yun Kong (d), Wu Qin (e), Yi Qin (f) 论文时间:2025年 机构: (a) School of Electromechanical Engineering, Guangdong University of Technology, Guangzhou, China (b) Electronics & Drives, Reutlingen University, Reutlingen, Germany (c) School of Mechanical and Automotive Engineering, South China University of Technology, Guangzhou, China (d) School of Mechanical Engineering, Beijing Institute of Technology, Beijing, China (e) School of Mechatronics and Vehicle Engineering, East China Jiaotong University, Nanchang, China (f) College of Mechanical and Vehicle Engineering, Chongqing University, Chongqing, China作者简介: 陈祝云,广东工业大学"青年百人"高层次引进人才,副教授/硕士生导师,刘强院长智能制造团队;华南理工大学-鲁汶大学联培博士,华南理工大学机械与汽车工程学院李巍华院长博士、博士后/副研究员,省部共建精密电子制造技术与装备国家重点实验室核心成员,入选广州市科协青年托举人才、人社部国际交流计划派出项目(2024, 2021)。主研方向为复杂系统的智能故障诊断与预测性维护、工业大数据/时序信号处理、工业人工智能/工业大模型/可解释性人工智能、数字孪生、工艺性能优化等。主持国家自然科学基金面上项目、青年基金项目、广东省/广州市基金、企业合作等项目10余项;作为核心成员参与国家自然科学基金联合基金重点项目/面上项目、国家重点研发计划课题、广东省重点领域研发计划、校企合作重大项目等10余项。目前在IEEE TNNLS、IEEE TCYB、IEEE TII、MSSP、REES、机械工程学报等高水平期刊发表论文 70余篇,含ESI高被引论文10篇,Google学术累积被引4800余次,H-index: 28,受理/授权发明专利20余件,连续入选2023/2024 斯坦福大学全球前2%顶尖科学家年度榜单;担任广东省机械工程学会设备与维修工程分会副秘书长、广州市机电工程学会设备与维修工程分会副秘书长、中国振动工程学会故障诊断分会青年工作组成员、广东省机械工程学会制造业信息化分会理事;担任仪器测量领域顶刊《IEEE Transactions on Instrumentation and Measurement》副编辑、《Chinese Journal of Mechanical Engineering》(机械工程学报英文版)、《Instrumentation》(仪器仪表学报英文版)、《工程科学与技术》、《机械科学与技术》、《机电工程技术》等8个期刊(首届)青年编委、《Journal of Dynamics,Monitoring and Diagnostics》青年编委会副主任,10余个国内外期刊的客座主编/编辑、ICSMD 2022/2023、IEEE PHM-Beijing 2024、ICEIOM 2023等国际会议的分会主席等,国际会议SIGNAL 2022-2024的技术委员会成员等;荣获2024年中国振动工程学会科学技术一等奖、英国皇家物理学会 "Emerging Leader Award(青年领军人奖)"、中国汽车工程学会优秀博士学位论文提名奖、多次国内外期刊/会议最佳论文、优秀论文、优秀青年编委、杰出审稿人等荣誉。(摘自广东工业大学教师个人主页)通讯作者邮箱:mezychen@gdut.edu.cn 摘要智能故障诊断与剩余使用寿命(Remaining Useful Life,RUL)预测对旋转机械的可靠运行至关重要。这些技术可提升制造业的安全性、可用性与生产效率。图卷积网络(Graph Convolutional Networks,GCNs)是深度学习(Deep Learning,DL)在图数据上的拓展,凭借其独特的数据表征能力实现了优异性能。传统状态监测(Condition Monitoring,CM)通常需要为故障诊断与RUL预测分别构建模型,面临知识共享效率低、深度学习模型部署与制备成本高等难题。为解决上述问题,本研究提出一种融合注意力机制的多任务图同构网络,可同步实现故障诊断与RUL预测。该方法考虑任务间的关联关系,引入参数共享机制与自注意力机制。与传统单任务方法相比,所提方法精度更高、实用性更强,且能降低模型开发成本。通过轴承全生命周期退化实验数据验证了该方法的有效性,结果表明该方法可解决故障诊断与RUL预测中的关键问题,在实际应用中具备广阔潜力。关键词:状态监测;可靠性分析;诊断;预测;健康管理 目录1 引言2 相关工作2.1 多任务学习2.2 自注意力机制3 面向故障诊断与RUL预测的所提方法3.1 图构建模块3.2 图同构网络3.3 图自注意力模块3.4 多任务模块3.5 联合结果模块3.6 所提方法的实施步骤4 实验结果4.1 实验数据4.2 数据准备4.3 性能指标4.4 结果与分析5 结论1 引言近年来,随着信息通信技术的发展[1, 2],制造业取得显著进步,智能制造与数字化制造加速发展。人工智能(Artificial Intelligence,AI)与制造业深度融合,显著提升经济效益、推动数字化转型、改善产品质量与生产效率[3,4]。然而,随着机械设备向大型化、复杂化、自动化方向发展,设备结构复杂度提升,为维护与维修工作带来巨大挑战[5]。同时,不断增长的生产需求对运行机械的安全性与可靠性提出更高要求。旋转机械常在高负载、变工况下运行,齿轮、轴承、链条、皮带等部件易发生磨损、裂纹与断裂[6]。此类故障会导致机械运行失稳甚至失效,若未及时检测、维修或更换,将引发重大安全风险与经济损失[7]。轴承作为核心部件,直接影响制造系统中多数旋转机械的性能与整体健康状态[8]。统计数据显示,约50%的电机故障由轴承问题导致[9,10]。机械部件故障是固有随机过程[11],即使相同型号、相同工况的轴承,寿命差异也极大,从数天到数年不等。传统模式下,维护人员定期更换轴承以保障可靠运行,易造成过度更换、停机时间延长、维护成本增加[12,13]。智能状态监测(Condition Monitoring,CM)[14–16]包含故障诊断与剩余使用寿命(Remaining Useful Life,RUL)预测,可精准监测机械健康状态、预防突发故障、减少非计划停机与维护成本、提升安全性与可靠性[17]。相关技术已被广泛研究。Kateris等[18]基于传感器与特征融合提取健康指标(Health Indicators,HI),结合带自动相关性确定的多层感知器(Multilayer Perceptron,MLP)实现故障类型分类。Qi等[19]提出一种智能状态监测方法,用于异常检测与 RUL 预测,该方法基于稀疏度指标HI采用支持向量数据描述(Support Vector Data Description,SVDD)实现异常检测,并通过多步估计器完成 RUL 预测。类似地,Kankar等[20]提取多种时域统计HI,筛选合适指标后输入支持向量机(Support Vector Machine,SVM)与人工神经网络(Artificial Neural Network,ANN),实现轴承故障诊断。Wang 等[21]基于高斯混合模型(Gaussian Mixture Model,GMM)构建HI,采用支持向量回归(Support Vector Regression,SVR)预测RUL。Han与Jiang[22]结合变分模态分解与自回归模型分解振动信号,将其作为故障特征向量,基于随机森林(Random Forest,RF)实现故障诊断。深度学习(Deep Learning, DL)的兴起彻底革新了智能状态监测方法,无需依赖专家知识,可直接从海量数据中提取有价值的故障相关信息 [23]。该领域常用DL模型包括卷积神经网络(Convolutional Neural Networks,CNN)、长短期记忆网络(Long and Short-Term Memory networks,LSTM)、自编码器(Autoencoders,AE)与深度置信网络(Deep Belief Networks,DBN)。与传统机器学习(Machine Learning,ML)不同,基于DL的状态监测适用性强,无需领域专业知识与先验知识,如手动提取与筛选HI[24]。为解决轴承故障诊断难题,Jing等[24]基于CNN构建端到端深度学习模型,将特征提取、筛选与分类集成于单一系统。该模型以原始振动信号的频域数据为输入,性能优于常用机器学习方法、前馈神经网络(Feedforward Neural Networks,FFNN)、SVM与RF。另一项研究中,Sabir等[9]基于LSTM提出故障诊断方法,采用电机电流信号,在时域与时频域提取8种HI并输入LSTM,分类精度达 96%。近期,Qi等[25]提出一种无传感器深度加权k近邻(Deep Weighted K-Nearest Neighbors,WKNN)方法,融合深度AE实现健康评估,结合WKNN实现鲁棒异常检测。该方法利用电机驱动器数据,在解决滚子链系统监测难题上优于现有方法。类似地,Peng等[26]提出一种基于无监督深度支持向量数据描述的风机自适应异常检测技术。该方法构建鲁棒球形边界,有效应对数据噪声与波动,提升风机状态监测可靠性。同时,Ahmad等[27]构建基于LSTM的AE,利用实测振动数据在单一状态监测系统中完成特征提取与异常检测。类似地,Hasani等[28]提出基于AE的HI提取方法,追踪轴承全生命周期退化过程。该模型采用振动数据训练,计算初始健康数据与连续样本间的相关性,表征健康状态。此外,Fu等[29]构建融合CNN与LSTM的深度学习模型,利用风机轴承温度数据实现早期隐患检测。Khorram等[30]构建CNN-LSTM模型,以原始振动数据为输入、故障类型为输出,无需对输入数据进行预处理。Ma与Mao[31]构建CNN-LSTM模型,利用时频特征捕捉长时依赖并选择性传播相关信息,RUL预测效果优于单一CNN或LSTM模型。此外,为降低环境噪声影响、提升波浪能转换器齿轮箱故障诊断效果,研究人员开发了CNN-LSTM模型。该模型融合自适应矩估计与刚柔耦合动力学仿真模型,通过仿真与实验数据验证,在变工况干扰下可高效、精准诊断各类故障[32]。Zhao等[33]提出自适应多尺度CNN,有效捕捉实际工业系统变工况下的多时间尺度与数据特征。尽管CNN可通过卷积核提取数据相关信息,但无法表征故障、噪声与相邻点间的因果关系[34,35]。近年来,图神经网络(Graph Neural Networks,GNNs)在故障诊断领域备受关注,因其可在图域中同时表征节点数值与节点间关联关系[36]。Zhang等[36]将图论、深度学习与图卷积网络(Graph Convolutional Networks,GCNs)融合,构建基于声学数据的故障诊断模型,精度优于CNN、RNN与深度AE等DL模型[36]。Wang等[37]提出融合GNNs与图注意力网络的故障诊断方法,捕捉全局结构信息并根据节点相对重要性动态调整节点权重。Wang等[38]开发门控图卷积网络用于多传感器数据融合与RUL预测,有效建模多传感器信号的时空依赖,精准提取退化特征。此外,Yu等[34]开发深度GCN用于风机齿轮箱故障诊断,采用小波包分解与时频特征。Zhao等[39]引入半监督图卷积深度信念网络构建图邻域关系,解决实际工业场景中标注数据有限的难题。Zhang与Wu[35]提出基于格兰杰因果检验的GNN用于故障分类,量化噪声影响,性能优于SVM、RF与CNN等DL模型[35]。然而,现有方法仍面临诸多挑战。多数用于RUL预测的DL方法高度依赖特征提取实现样本与RUL的映射,常忽略样本自身的空间关联,这会限制DL模型在RUL预测中的性能。此外,当前多数方法将智能故障诊断与RUL预测视为完全独立的任务,为每个任务单独训练模型。这不仅无法利用任务间的相关性,还因忽略样本空间关联增加了实施复杂度与成本。为解决上述问题,本研究提出一种基于融合注意力机制的多任务图同构网络(Graph Isomorphism Network,GIN)的故障诊断与RUL预测联合方法。通过参数共享与基于自注意力的数据融合,所提方法有效构建故障诊断与RUL预测间的关联关系。该联合训练策略可同步实现故障诊断与RUL估计,相比传统单任务深度学习模型,精度更高、适应性更强、部署成本更低。本研究的核心方法贡献如下:(1) 本研究引入基于GIN的模型,采用图卷积实现特征提取。该模型可有效捕捉采集数据中的空间依赖,GIN的层级结构提升特征表征能力。多层架构确保每一层输出均参与多任务模型训练,提升预测性能。(2) 引入图自注意力机制,自适应融合每一层图卷积提取的特征向量。该改进可动态平衡不同任务的性能,同时提升故障诊断与RUL预测效果。与传统融合技术不同,所提方法可实现最优信息融合,且不降低任一任务的精度。(3) 开发多任务GCN模型,同步实现轴承故障诊断与RUL估计。通过学习多任务共享表征,提升模型在不同状态监测场景下的泛化能力。此外,多任务模型部署可降低计算与运维成本,为设备维护提供更全面的决策支持。 (4) 大量实验评估表明,所提方法性能优于传统单任务深度学习模型。该模型在三种不同转速与负载工况下,故障诊断与RUL估计均展现出鲁棒性,进一步验证其在实际状态监测任务中的实用性。本文后续结构安排如下:第2节综述多任务学习与自注意力机制相关研究;第3节详细阐述多任务状态监测的所提方法,包括图构建、图卷积、自注意力与多任务原理;第4节展示实验结果,包含数据描述、性能指标与深入讨论;最后总结研究成果并展望未来工作。2 相关工作本节综述多任务学习与自注意力机制的相关理论。2.1 多任务学习多任务学习(Multi-Task Learning,MTL)是一种机器学习技术,利用多个相关任务包含的有效信息训练单一模型,同步提升所有任务的泛化能力[40]。传统机器学习中,任务单独处理、单独建模,每个模型仅执行单一任务,忽略任务间的关联信息。而MTL通过联合学习多个相关任务并实现信息共享,为多任务构建鲁棒、通用的表征。深度学习中,MTL通常通过参数共享机制实现,包括硬共享、软共享、层级共享与稀疏共享,如图1所示。 图1 参数共享机制[41]:(a)硬共享,(b)软共享,(c)层次化共享,(d)稀疏共享硬共享:最常用方法,所有任务共享隐藏层,同时定义任务专属输出层。该方法易于实现,参数设置高效。软共享:与硬共享相反,软共享为每个任务构建独立网络,通过不同任务网络间的交互实现信息共享。该方法更灵活,无需共享网络结构,无需假设任务相关性。但随着任务数量增加,模型参数同步增长,需新增大量参数[42]。层级共享:该方法在网络结构不同层分配不同任务监督,融入部分任务先验知识设计层级共享结构。层级共享比硬共享更灵活,参数需求少于软共享。但实际应用中,设计有效的层级结构难度较大。稀疏共享:该方法根据任务随机共享层参数,寻找最优任务与模型参数组合的搜索空间极大。参数共享的随机性为实验结果带来不确定性,无法有效识别并减少模型中的冗余信息[42]。与单任务模型相比,MTL具备以下优势[43]:MTL通过共享固有层,避免为每个任务重复计算共享层特征,减小模型规模与复杂度,大幅提升模型效率与训练速度。通过共享任务间的通用知识与信息,MTL提升模型泛化能力与鲁棒性,降低过拟合风险。MTL通过多任务共享相同数据,提升数据利用率。这降低了对大量标注数据的依赖,减少深度学习模型训练与部署成本。MTL模型训练与优化时,不同任务具有不同目标函数。MTL通过反向传播联合损失函数更新模型参数,同步优化多任务目标函数。假设共有N个任务参与MTL,联合损失函数可表示为式 其中 表示共享网络结构的输入, 表示不同任务间的共享参数, 、 、 与 分别为第 个子任务的标签、前向传播函数、损失函数与权重。该公式使MTL模型可根据权重 确定的重要性,平衡每个任务的贡献。2.2 自注意力机制注意力机制是受人类认知过程启发的强大技术,可选择性聚焦输入数据中最相关的部分[44]。例如,图像识别中会重点关注图像中信息更丰富的特定区域。注意力机制为不同输入元素分配不同权重,使模型优先关注任务相关信息、抑制无关细节[45]。该技术在DL中应用广泛,尤其在序列建模领域,可通过学习输入特征的相对重要性动态提升模型性能。自注意力机制是注意力机制的重要变体,在自然语言处理与计算机视觉等领域应用广泛[44]。与传统注意力不同,自注意力计算单一输入序列内部元素间的关系,使模型可捕捉长距离依赖与上下文信息。其核心思想是学习不同输入组件间的相互依赖并据此聚合信息,每个元素根据与其他元素的相关性加权。在多任务学习场景中,自注意力机制提供额外灵活性。每个任务可独立学习专属注意力权重,实现任务专属特征聚合,无需修改共享模型架构。该能力使模型可选择性关注每个任务最相关的特征,通过更高效的表征学习提升所有任务性能。3 面向故障诊断与RUL预测的所提方法为克服传统方法需为故障诊断与剩余使用寿命预测分别构建模型的局限,本研究提出一种基于多任务图神经网络的统一框架。图2展示了所提方法的整体流程,包括实验装置、数据采集、图构建、图运算、自注意力模块与MTL。图3为更详细的流程示意图,包含五大核心组件:(a)图构建模块(Constructing Graph Module,CGM)、(b)图同构网络(Graph Isomorphism Network,GIN)、(c)图自注意力模块(Graph Self-attention Module,GSM)、(d)多任务模块(Multi-Task Module,MTM)与(e)联合结果模块(Joint Results Module,JRM)。 图2 所提出的多任务学习方法论概述 图3 所提出联合故障诊断与RUL预测方法的详细阐述3.1 图构建模块CGM是将采集的振动信号转换为样本图的核心组件,支持图卷积网络实现特征提取。流程始于从原始信号提取16种时频域特征,这些提取的特征作为样本图的节点。为建立节点间连接,计算每对特征的皮尔逊相关系数。若相关系数超过预设阈值,则在两个节点间构建边。通过将原始振动信号转换为结构化图表征,该方法保留了比原始信号更全面的信息。预处理阶段是为所提方法准备振动信号的关键步骤,包含两大核心组件:(1) 特征提取:从振动信号中提取节点特征;(2) 图构建:生成邻接矩阵定义节点间连接。具体步骤详述如下:节点特征:为利用图卷积网络实现特征提取,首先将采集的振动信号转换为样本图。转换始于从原始信号提取16种时频域特征,包括均值、均方根、方差等统计量。这些特征记为 至 ,详见表1[46],选择依据是其可有效反映滚动轴承运行状态,且随时间呈现显著变化。每个特征作为样本图中的一个节点,节点特征提取是构建图的基础。融入这些特征后,样本图可丰富表征振动信号的动态行为信息。 表1 所用指标的表达式 邻接矩阵:邻接矩阵是样本图的核心组件,定义节点间连接,是图卷积层的必要输入。节点间连接基于皮尔逊相关系数确定,该系数量化节点特征对间的线性关系。两个节点 与 间的皮尔逊相关系数 计算如下: 其中 与 表示两个不同节点, 与 为其对应均值。 取值范围为0至1,数值越高表示节点间相关性越强。为确保仅保留显著关联关系,为皮尔逊相关系数设置0.8的阈值。具体而言,仅当节点 与 的相关系数 超过0.8时,才在二者间构建边。该阈值处理确保图结构保留特征间最有意义的连接,过滤弱相关关系,提升样本图的表征能力。 通过上述预处理步骤,振动信号被有效转换为样本图,封装数据的时序与关联特征。该结构化表征为所提方法后续的分析与分类任务提供支撑。3.2 图同构网络GIN包含三层图同构卷积层与图边池化层。每一层图卷积(Graph Convolution,GC)的输出通过图池化(Graph Pooling,GP)方法——边池化(EdgePool)[47]处理,再全局平均池化得到每一层的特征表征。仅使用最后一层输出会导致图卷积模块性能损失。层级图卷积神经网络的每一层输出均参与后续任务,使训练过程更稳定、模型性能更高。特征提取由三层堆叠的GIN层实现。每一层包含GIN卷积层、批量归一化层、激活层与图池化层。前一层图池化层的输出作为下一层GIN层的输入。三层全局平均池化层的输出拼接后,作为两个全连接层的输入。设 为样本图,GIN计算如式(3): 其中 为图同构网络卷积层, 为批量归一化层, 为激活函数, 为图池化层, 为全局平均池化层, 为拼接操作, 为全连接层。3.2.1 图同构卷积传统图神经网络采用邻域聚合策略更新节点表征,但难以有效学习同构图的判别特征[48]。图同构卷积(如图4所示)具备更强的图结构依赖捕捉能力与图区分能力,主要分为两步:首先通过求和函数聚合邻域节点特征;随后将聚合特征输入 MLP 进行非线性映射,完成节点特征更新。更新机制如图 4 所示,对应公式: 该公式中,第 层节点特征 通过将前一层特征向量 乘以可学习参数 更新。聚合邻域节点特征并融合后,输入MLP层,输出经非线性激活得到节点 的新特征。具体而言, 与 分别为节点 在第 层与 层的特征。节点 为节点 的邻域节点,满足 ,其中 为节点 的邻域集 合。 图4 图同构卷积层的更新机制聚合与融合函数必须满足单射性,即每个输入对应唯一输出。GIN通过MLP在GNN中学习上述函数,确保单射性。采用求和函数聚合、MLP非线性变换,GIN可有效区分同构图,学习更具信息性的节点表征。3.2.2 图边池化为预测RUL,模型必须学习样本图对应的剩余寿命回归曲线。因此,GP是GNN应用于RUL预测等任务的关键步骤。图池化的核心目的是降低图复杂度,同时保留核心图结构信息[49]。通过融合节点特征实现,减少回归模型需拟合的节点数量。Edgepool[47]是基于连接边分数融合节点的池化方法。首先通过可学习参数Θ与偏置项b计算边分数,再经softmax函数归一化得到最终边分数 ,如式(5): 其中 与 分别为第 个与第 个节点特征, 为边 的原始分数。Θ 与𝑏为可学习参数。 为节点所有边归一化后的最终边分数。 池化操作根据最终边分数融合第 个与第 个节点特征,生成新节点特征,如式(6)。图池化确保高分边连接的节点被融合,有效降低图复杂度、保留结构信息、提升计算效率。3.3 图自注意力模块GSM通过自适应重加权不同输入元素的贡献,提升特征表征能力。该机制使模型可选择性强调重要特征、抑制无关特征,提升分类与回归任务性能。如图3所示,为两个任务分别设置独立自注意力模块,使其在共享卷积层参数的同时,学习专属特征表征。该设计确保模型可高效提取任务专属特征,无冗余。 GSM按结构化三步流程运行: (1)线性映射:第一步将全局平均池化层得到的特征向量转换为三种不同表征:查询(Query,Q)、键(Key,K)与值(Value,V)[44, 50]。该转换通过三个可学习权重矩阵 、 与 实现,将输入特征向量X映射至不同隐空间。过程数学公式如下: 每种转换学习输入特征的不同视角。 为寻求注意力的特征, 为对比参考, 为最终聚合步骤使用的实际特征表征。该分解使模型可捕捉特征间复杂的依赖与交互。 (2)注意力分数计算:第二步计算注意力分数,量化每个特征相对其他特征的重要性。通过缩放点积运算计算 与 间的相似度: 其中内积 衡量查询向量与键向量的相似度,生成注意力分数矩阵 。缩放因子 防止点积数值过大,避免训练过程中梯度消失或爆炸[51]。Softmax函数将 的每一行归一化,使分数和为 1,确保其表示输入特征的概率分布。 (3)加权聚合:计算注意力分数后,用于对值矩阵 进行加权聚合。最终输出表征 计算如下: 该操作生成精细化特征表征,每个元素为输入特征的自适应组合,按重要性加权。 最终输出输入后续层,执行分类与回归任务。通过动态调整特征重要性,该步骤提升模型表达能力,增强捕捉任务专属信息的能力。3.4 多任务模块设计优良的故障诊断模型不仅需精准识别具体故障,还需支持故障预测。为实现该目标,所提方法融合MTL与联合损失函数,确保故障诊断与RUL预测同步优化。MTL的核心原理是参数共享,提升跨任务特征泛化能力。所提MTM采用硬参数共享,即两个任务共享整个图卷积模块。该结构使任务间交互、竞争,学习更泛化的特征,最终同步提升故障诊断与RUL估计效果。针对任务专属处理,MTM采用两个独立全连接层:故障诊断分类模块与RUL预测回归模块。如图3所示,分类模块(任务 1)预测每种故障的概率分布,回归模块(任务 2)输出RUL估计值。为实现同步学习,采用联合损失函数平衡两个任务。故障诊断任务采用带交叉熵损失函数 的Softmax分类器,如式 (10): 同时,RUL预测任务采用均方误差(Mean Squared Error,MSE)损失函数 优化: 其中 为输入样本, 与 分别为故障诊断与RUL预测任务的标签。 为平衡两个任务的贡献,构建加权联合损失函数 : 其中 与 为任务专属权重,控制故障诊断与RUL预测的相对重要性。为不同任务分配不同权重,会直接影响学习动态,可能优先优化某一任务。需详细讨论这些权重对模型性能的影响,阐明每个任务的学习机制。 前向传播过程计算联合损失函数,随后用于反向传播更新模型参数。最终,MTM 在统一框架中学习故障诊断与RUL预测。训练完成后,模型可同步输出预测故障类型与估计RUL,验证其故障识别与预测能力。3.5 联合结果模块基于计算得到的联合损失,同步得到故障诊断与故障预测结果。为全面评估性能,除可视化展示外,还采用多种指标。故障诊断任务采用精度、精确率、召回率与 F1 分数;故障预测(RUL预测)任务采用F1分数、均方根误差(Root Mean Square Error,RMSE)与决定系数( )。3.6 所提方法的实施步骤通过允许每个任务学习专属注意力权重与聚合方法,多任务模型可更精准地聚焦每个任务输入中最相关的部分。该定向注意力机制使模型更好地捕捉数据中与每个任务最相关的独特特征与关联关系。因此,带任务专属注意力的MTL不仅提升模型适应性,还显著增强整体性能与泛化能力。所提方法的实施步骤如下: 步骤1:首先通过加速度计采集滚动轴承全生命周期退化过程的振动数据。 步骤2:采用时频域分析处理采集的振动信号,提取特征。计算特征间相关系数,构建样本图。 步骤3:为RUL预测设置分段线性标签,为故障类型设置对应标签(标签知识),监督模型学习隐藏信息。 步骤4:构建多任务数据集 ,其中 为输入样本, 为输入样本的故障类型标签, 为RUL标签。 步骤5:采用多任务模型基于构建的数据集开展联合监督训练,通过最小化联合损失函数优化模型参数。迭代次数达到上限或模型收敛至最优时停止训练,得到训练完成的多任务模型。 步骤6:最后将测试样本输入训练完成的多任务模型,模型同步输出输入样本的故障类别与对应RUL。 该方法通过动态学习并为每个任务应用不同注意力机制,确保模型有效优先利用关键信息。在保留任务专属细节的同时,共享跨任务知识,所提方法形成全面高效的框架。4 实验结果所提方法融合GIN与自注意力模块,实现故障分类与回归任务。为验证所提方法的有效性,采用轴承全生命周期退化数据进行实验验证。4.1 实验数据实验装置如图5所示,主要包括交流电机、电机调速器、支撑轴承、测试轴承与液压加载系统。电机由调速器控制,以不同转速运行。测试轴承安装在旋转轴上,液压加载系统为测试轴承施加径向载荷。实验设计三种不同工况开展,详见表2。 图5 轴承退化试验实验装置表2 被测轴承的工况及故障详情 采用两个加速度计采集数据,分别水平与垂直布置于测试轴承旁。采样频率设为25.6kHz,每分钟采集一次数据。每次采集时长1.28秒,每次采集得到32768个数据点。当测试轴承振动幅值超过健康阶段十倍时,停止退化测试。测试结束时轴承失效模式如图6所示,包括内圈故障、外圈故障与保持架断裂。实验结束后,获取三种工况下15个轴承的完整退化数据,具体寿命见表2。 图6 滚动轴承失效类型:(a) 内圈失效,(b) 保持架失效,(c) 外圈磨损,(d) 外圈断裂4.2 数据准备训练多任务模型时,必须为输入数据标注故障类型。表2中仅轴承2–3与1–4存在保持架故障,因此不参与训练。此外,轴承1–5与3–2存在外圈故障(Outer Fault,OF)、内圈故障(Inner Fault,IF)、滚动体故障(Ball Fault,BF)与保持架故障(Cage Fault,CF)等混合故障类型,同样排除在训练集外。因此,其余轴承的故障类型分为健康(Healthy,H)、OF与IF三类。三种故障类型的标签分别设为[0, 1, 2]。为验证所提方法性能并覆盖多种工业场景,每种工况选取两个轴承用于训练多任务模型。共计选取表2中6个轴承用于训练,每种工况选取一个轴承用于测试模型性能。由于不同轴承健康阶段时长不同,选取每个轴承健康阶段前30分钟数据作为正常样本。最终实验数据集见表3。精心筛选确保数据集平衡,使模型可在不同故障类型与工况下泛化。表3 训练集和测试集准备 4.3 性能指标为评估故障诊断与RUL预测性能,采用分类指标与回归指标。4.3.1 分类指标二分类问题中,样本分为正类或负类,如图7所示。为评估不同方法性能,选择合适的评估指标至关重要。分类问题常用评估指标包括精度、精确率、召回率与F1分数 [52,53]。这些指标可由混淆矩阵推导得出,如图7所示,混淆矩阵通过对比实际标签与预测标签,汇总预测性能。 真正例(True Positive,TP)表示正样本被正确预测为正类。假负例(False Negative,FN)表示正样本被错误预测为负类。假正例(False Positive,FP)表示负样本被错误预测为正类。真负例(True Negative,TN)表示负样本被正确预测为负类。 精度:该指标表示正确预测样本数占总样本数的比例,如式 (13)。 精确率:该指标表示所有预测为正类的样本中,真正例样本的比例。 召回率:该指标表示所有实际正类样本中,被正确预测为正类的比例。 F1分数:当数据样本不平衡时,单一指标(如精度、精确率、召回率)无法 正确评估故障分类性能。此时,结合精确率与召回率的F1分数可提供更均衡、准确的评估。该指标在评估不平衡数据模型性能时尤为有用,提供全面衡量。 图7 混淆矩阵的解释 4.3.2 回归指标RUL预测采用均方根误差(Root Mean Square Error, RMSE)与拟合优度 衡量预测性能 [54, 55]。RMSE:该指标衡量预测值与真实值间的平均误差。完美预测时该值趋近于 0。 拟合优度 :该指标表示回归线对观测值的拟合程度。 越接近 1,拟合效果越好。 其中 与 分别为真实值与预测值, 为真实值均值。4.4 结果与分析本节展示所提多任务模型的故障诊断与RUL预测结果,分析包括故障诊断与RUL预测性能,以及与现有方法的对比(见表 4)。表4 超参数设置 4.4.1 单任务/多任务学习结果对比为验证所提方法有效性,分别在单任务与多任务模式下评估所提方法。单任务模式下,独立训练两个模型,分别执行故障诊断与RUL预测。多任务模式下,采用带联合损失函数的单一模型,同步执行故障诊断与RUL预测。为确保公平对比,深度学习模型超参数在单任务与多任务训练中保持一致,见表4。为降低随机性影响,每个测试轴承的设计模型重复实验五次,取五次运行平均值作为最终结果。 实验结果如表5、图8与图9所示,表明所提多任务模型不仅可同步实现故障诊断与RUL预测,在验证轴承上的性能还优于单任务模型。对比测试集平均性能,故障诊断F1分数为0.803,RUL预测RMSE与 分别为0.086与0.927。表5 基于单任务/多任务模型的结果对比 图8 采用不同性能指标进行的结果对比 图9 RUL预测结果对比 分析每个轴承的结果可见,所提多任务方法RUL预测的RMSE值始终更低,表明模型在捕捉潜在退化特征方面具备鲁棒性。F1分数方面,除轴承2–1略低外,多任务模型在其余两个测试轴承上均优于单任务模型。这表明所提多任务模型在实现轴承RUL预测的同时,取得更优的故障诊断效果。如图9所示,所提多任务模型的RUL预测值紧密跟随真实RUL。初始健康阶段,预测RUL相对稳定,趋近于1。随着轴承开始退化,预测RUL呈下降趋势,与实际RUL曲线高度拟合,直至寿命结束。因此,三种工况下三个轴承的验证结果证实,所提多任务模型的RUL预测精度高于单任务模型。单一模型同步实现故障诊断与RUL预测的能力,为预测性维护提供全面决策支撑,在未来应用中具备重要实用潜力。 单任务与多任务模型对比显示,轴承2–1的单任务模型故障诊断F1分数更高。但其余轴承的单任务模型F1分数与RMSE均差于多任务模型。单任务模型的平均F1分数、RMSE与 分别为0.747、0.099与0.905,劣于多任务模型。这表明所提多任务模型学习到更鲁棒的特征表征,提升了跨任务、跨轴承、跨工况的泛化性能。 此外,图10所示混淆矩阵结果表明,所提多任务模型在不同故障类型下均实现稳定高诊断精度,凸显其优异的泛化能力。对比之下,单任务模型对健康轴承、内圈故障、外圈故障的分类精度分别为0.83333、0.75676、0.88043。而多任务模型(如图10 (b))对应类别精度分别提升至 0.88889、0.83781、0.92391,诊断性能显著提升。为进一步支撑对比,4.3.1节提供的精度、F1分数、精确率与召回率等额外性能指标汇总于表6。结果清晰表明,多任务模型在所有故障类别与评估指标上均优于单任务模型。这印证了模型可有效利用任务间共享表征,实现更泛化、鲁棒的特征学习。 图10 基于单任务/多任务模型的混淆矩阵对比 表6 单任务与多任务方法的性能对比 4.4.2 多任务学习与其他方法对比为验证所提方法有效性,选取三种前沿故障诊断与 RUL 预测方法进行对比。 (1) WDCNN [56]:一种卷积神经网络结构,包含五层卷积层与一层全连接层。第一层采用尺寸为 64、步长为 16 的大卷积核。该模型采用单任务策略测试故障诊断与 RUL 预测,训练超参数与所提方法保持一致。 (2) LSTM [57]:一种循环神经网络模型,由两层堆叠 LSTM 单元组成,后接两层全连接层用于 RUL 预测。与 WDCNN 相同,LSTM 模型也采用单任务策略实现故障诊断与 RUL 预测。 (3)GCN [58]:典型图卷积神经网络模型,包含三层图卷积层与两层全连接层,可直接处理图结构数据,利用其结构信息。该模型采用消息传递机制,每个节点在特征更新时聚合邻域节点信息,有效捕捉节点间关系,提升特征提取效果。实际应用中采用单任务方法实现轴承故障诊断与剩余使用寿命预测。GCN 处理前,需先将振动信号转换为图结构数据,本研究采用所提图构建方法,确保模型充分利用振动信号内在关联。 实验结果汇总于表7与图11。WDCNN、LSTM与GCN的对比凸显各自优劣。故障诊断任务中,LSTM平均F1分数为0.657,低于WDCNN的0.747与GCN的0.723。但RUL预测任务中,LSTM优于WDCNN,平均RMSE为0.122、 为 0.859,而WDCNN 表现较差。尽管如此,LSTM仍劣于GCN,GCN平均RMSE为0.105、 为0.890,效果更优。上述结果表明,WDCNN擅长提取深度特征,更适用于故障诊断;而LSTM与GCN在捕捉时序依赖方面能力更强,对RUL预测更有利。值得注意的是,所提多任务模型在故障诊断与RUL预测任务上均超越WDCNN、LSTM与GCN。这验证了其在联合提取深度特征表征与时序模式方面的有效性,为状态监测提供更全面、鲁棒的解决方案。 表7 所提方法和先进方法的结果对比 图11 所提方法和先进方法的结果对比 图12可视化展示WDCNN、LSTM、GCN与所提多任务模型在轴承1–1、2–1、3–1 上的RUL预测结果。所提方法的拟合趋势明显优于WDCNN、LSTM与GCN,有效表征测试轴承的退化趋势。具体而言,对于轴承3–1,所提方法不仅实现更优的 与更低的RMSE,RUL预测也更稳定。这表明所提方法在轴承RUL预测方面具备更强的鲁棒性。 图12 所提方法和先进方法的RUL对比 此外,开展全面计算复杂度分析,评估所提方法与标准方法(WDCNN、LSTM、GCN)的效率与实用性。 WDCNN[56]:WDCNN的时间复杂度主要由卷积层决定。每层卷积复杂度为 ,其中 为样本数, 为卷积核尺寸, 与 为输入输出通道数, 与 为输出特征图维度。空间复杂度主要由卷积核参数决定,为 。 LSTM[57]:LSTM的时间复杂度为 ,其中 为时间步长, 为输入维度, 为隐藏状态维度。LSTM的空间复杂度为 ,需存储每个时间步的隐藏状态。 GCN[58]:GCN 的时间复杂度为 ,其中 为层数, 为边数, 为节点数, 为节点特征维度。稀疏图中 占主导。空间复杂度为 ,需存储所有节点特征向量。 所提方法:本方法采用融合自注意力与多任务学习的GIN。时间复杂度主要由GINConv层与自注意力模块决定。每层GINConv复杂度为 (与 GCN 相同,但采用单射聚合)。自注意力模块额外增加复杂度 , 为节点特征维度。空间复杂度为 (存储节点特征)与 (自注意力模块参数)。 不同方法计算成本汇总于表8。融合自注意力的GIN方法相比基线方法计算效率更优。在保持GCN基于边的线性复杂度( )的同时,通过GIN强大的聚合能力提升表达能力。自注意力机制仅增加 复杂度,远优于LSTM的 时序处理或WDCNN的 卷积操作。该架构通过稀疏存储保持内存效率( ),并通过多任务学习消除冗余计算。这种最优复杂度特性使本方法在大规模图应用( )中尤为有利,兼顾GCN的可扩展性与注意力的表达能力,同时避免时序或卷积方法的高成本。特征维度的二次依赖( 项)通过统一特征学习实现合理性,否则需多个专用模型,在图结构任务的表达能力与计算效率间实现最优平衡。此外,多任务学习方法可同步实现故障诊断与剩余使用寿命预测,减少对独立模型的需求,提升数据利用效率。 表8 不同深度学习模型的计算消耗 4.4.3 图自注意力模块消融分析为验证图3所述所提方法中图自注意力模块的有效性,对每层全局平均池化输出的特征向量采用不同数据融合方法。方法1:每层输出特征向量直接相加实现特征融合。模型为分类与回归任务输入相同向量,维度为256。方法2:每层输出特征向量通过向量拼接融合。模型为分类与回归任务输入相同向量,维度为768。方法3:所提方法采用图自注意力模块,对每层特征向量进行注意力加权数据融合。模型为分类与回归任务输入相同向量,维度为256。实验结果如表9与图13所示。对比三种数据融合方法的平均F1值,发现方法1的故障诊断效果优于方法2,表明通过相加融合的特征向量对故障诊断任务更有利。方法3的F1分数超过方法1与2,表明注意力加权数据融合可提取更有利于故障诊断的特征。对比三种方法RUL预测的RMSE与 ,方法2优于方法1。这可能归因于拼接向量导致全连接层参数增加,提升深度学习模型容量。相反,方法1的直接相加平滑了输入特征向量间的差异,阻碍模型学习隐藏信息。相比之下,方法3相比方法1与2,RUL预测性能提升。这表明图自注意力模块不仅提升故障诊断效果,还改善RUL预测,验证了图自注意力模块的有效性。综上,方法3在所有指标(F1、RMSE、 )上均稳定优于方法1与2,尤其在平均性能上,验证了自注意力模块的有效性。方法3的F1分数高于方法1与2,分类精度提升。同样,方法3实现最低RMSE与最高 ,凸显其更优的预测能力。表9 不同特征融合方法的性能对比 图13 采用方法 1、方法 2 及方法 3 进行结果对比 图14 采用方法 1、方法 2 及方法 3 进行的 RUL 比较三种方法的RUL结果如图14所示。所有方法的图卷积神经网络RUL预测RMSE均较低,表明每种方法均实现良好的RUL预测。图14中观察到细微差异,与每个轴承的测试RMSE值一致。此外,明显可见所提方法(方法 3)在三个测试轴承上拟合效果最佳。方法3在健康与故障阶段均精准拟合真实RUL。这表明所提方法融合的特征可更有效区分健康与故障阶段,进一步验证所提方法在故障诊断中的优异性能。因此,采用图自注意力模块对每层图卷积特征向量加权数据融合,不仅提升模型故障诊断性能,还改善RUL预测效果。该提升归因于模型可根据每个任务的具体需求,自适应构建合适的特征向量,从而同步提升故障诊断与RUL预测任务性能。 基于实验结果分析,所提基于图神经网络的多任务模型有效融合轴承故障诊断与RUL预测,两项任务性能均表现优异。与单任务模型相比,该方法提升预测精度,同时显著降低多模型开发与部署成本。图自注意力模块通过自适应加权图卷积层特征表征,优先关注信息丰富的特征、过滤无关特征,发挥关键作用。该机制通过捕捉细微故障模式提升故障分类精度,在不同工况下的优异故障诊断性能验证了这一点。与其他融合方法(方法1与2)相比,图自注意力模块在故障诊断与RUL预测间实现更优平衡,确保任一任务性能不受损。此外,多任务学习策略实现相关任务间知识共享,提升泛化能力与鲁棒性。通过联合优化故障诊断与RUL预测,模型缓解数据稀疏问题,增强识别退化趋势的能力。相比单任务方法更优的预测性能,凸显融合诊断与预测信息的优势。因此,所提方法不仅为预测性维护提供更全面的方法,还优化维护效率、降低运行风险。其强大的实用潜力使其适配工业应用,支撑智能状态监测与健康管理策略。5 结论本文提出一种基于融合图同构神经网络与注意力机制的多任务模型的新型故障诊断与RUL预测方法。核心创新在于通过单一模型联合训练,同步实现故障诊断与RUL预测。所提模型通过参数共享与联合损失函数机制实现,仅用一个模型同步处理多任务,降低智能维护模型实施复杂度与成本,为工业设备健康管理提供更全面的决策支持。此外,采用图自注意力模块自适应加权图卷积层特征向量。与其他数据融合方法相比,所提方法有效平衡不同任务性能。通过三种不同工况的实验验证,所提多任务模型性能优于其他单任务方法,不仅精准预测RUL,在识别测试轴承故障类型方面也具备良好的故障诊断能力,有效避免运行机械突发故障引发的严重后果。作为基于深度学习的多任务模型,当前网络架构本质上仍为黑箱系统,内部决策机制缺乏可解释性。尽管注意力机制为特征权重分配提供部分可解释性,但故障模式识别与RUL预测间的跨任务关联机制、图结构与物理退化过程间的具体映射关系等关键方面,仍缺乏清晰的可视化解释。这种可解释性缺口可能阻碍模型在安全关键领域的实际部署,尤其在需要故障溯源与决策验证的场景,如航空发动机维护。未来工作应融合可解释人工智能技术,包括特征重要性分析、注意力路径可视化或模型蒸馏,建立物理退化过程与网络决策间的明确关联。 编辑:陈宇航校核:李正平、陈凯歌、曹希铭、赵学功、白亮、任超、海洋、Leo、Kira、Tina、王金、赵诚、肖鑫鑫、张优该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除来源:故障诊断与python学习

    未登录
    还没有评论
    课程
    培训
    服务
    行家
    VIP会员 学习计划 福利任务
    下载APP
    联系我们
    帮助与反馈