首页/文章/ 详情

新锐期刊一区TOP论文推荐|注意力引导的图同构学习:面向故障诊断与剩余使用寿命预测的多任务框架
48分钟前浏览0

本期给大家推荐注意力引导的图同构学习:面向故障诊断与剩余使用寿命预测的多任务框架。旋转机械的智能运维正从单一故障诊断迈向多任务协同决策。故障诊断与剩余使用寿命(Remaining Useful Life, RUL)预测是保障设备可靠运行的两大核心,但传统状态监测往往为二者分别建模,导致知识共享效率低、深度学习模型部署与维护成本高昂。图卷积网络凭借对图数据的强大表征能力为状态监测提供了新范式,然而如何在同一框架下实现诊断与预测的协同仍具挑战。针对此,本研究提出一种融合注意力机制的多任务图同构网络,通过参数共享与自注意力机制建模任务间关联,同步完成故障诊断与RUL预测。基于轴承全生命周期退化数据的实验验证表明,该方法较传统单任务方法精度更高、实用性更强,并可显著降低模型开发成本,为旋转机械的智能故障诊断与寿命预测提供了兼具学术价值与工程潜力的新方案。


论文基本信息

论文题目:Attention-guided graph isomorphism learning: A multi-task framework for fault diagnosis and remaining useful life prediction  

论文期刊:Reliability Engineering and System Safety

Doi:10.1016/j.ress.2025.111209

作者:Junyu Qi (a,b), Zhuyun Chen (a, c, *), Yun Kong (d), Wu Qin (e), Yi Qin (f)
论文时间:2025年
机构:

(a) School of Electromechanical Engineering, Guangdong University of Technology, Guangzhou, China 

(b) Electronics & Drives, Reutlingen University, Reutlingen, Germany 

(c) School of Mechanical and Automotive Engineering, South China University of Technology, Guangzhou, China 

(d) School of Mechanical Engineering, Beijing Institute of Technology, Beijing, China 

(e) School of Mechatronics and Vehicle Engineering, East China Jiaotong University, Nanchang, China 

(f) College of Mechanical and Vehicle Engineering, Chongqing University, Chongqing, China

作者简介:

陈祝云,广东工业大学"青年百人"高层次引进人才,副教授/硕士生导师,刘强院长智能制造团队;华南理工大学-鲁汶大学联培博士,华南理工大学机械与汽车工程学院李巍华院长博士、博士后/副研究员,省部共建精密电子制造技术与装备国家重点实验室核心成员,入选广州市科协青年托举人才、人社部国际交流计划派出项目(2024, 2021)。主研方向为复杂系统的智能故障诊断与预测性维护、工业大数据/时序信号处理、工业人工智能/工业大模型/可解释性人工智能、数字孪生、工艺性能优化等。

主持国家自然科学基金面上项目、青年基金项目、广东省/广州市基金、企业合作等项目10余项;作为核心成员参与国家自然科学基金联合基金重点项目/面上项目、国家重点研发计划课题、广东省重点领域研发计划、校企合作重大项目等10余项。目前在IEEE TNNLS、IEEE TCYB、IEEE TII、MSSP、REES、机械工程学报等高水平期刊发表论文 70余篇,含ESI高被引论文10篇,Google学术累积被引4800余次,H-index: 28,受理/授权发明专利20余件,连续入选2023/2024 斯坦福大学全球前2%顶尖科学家年度榜单;担任广东省机械工程学会设备与维修工程分会副秘书长、广州市机电工程学会设备与维修工程分会副秘书长、中国振动工程学会故障诊断分会青年工作组成员、广东省机械工程学会制造业信息化分会理事;担任仪器测量领域顶刊《IEEE Transactions on Instrumentation and Measurement》副编辑、《Chinese Journal of  Mechanical Engineering》(机械工程学报英文版)、《Instrumentation》(仪器仪表学报英文版)、《工程科学与技术》、《机械科学与技术》、《机电工程技术》等8个期刊(首届)青年编委、《Journal of  Dynamics,Monitoring and Diagnostics》青年编委会副主任,10余个国内外期刊的客座主编/编辑、ICSMD 2022/2023、IEEE PHM-Beijing 2024、ICEIOM 2023等国际会议的分会主席等,国际会议SIGNAL 2022-2024的技术委员会成员等;荣获2024年中国振动工程学会科学技术一等奖、英国皇家物理学会 "Emerging Leader Award(青年领军人奖)"、中国汽车工程学会优秀博士学位论文提名奖、多次国内外期刊/会议最佳论文、优秀论文、优秀青年编委、杰出审稿人等荣誉。(摘自广东工业大学教师个人主页)

通讯作者邮箱:mezychen@gdut.edu.cn

摘要

智能故障诊断与剩余使用寿命(Remaining Useful Life,RUL)预测对旋转机械的可靠运行至关重要。这些技术可提升制造业的安全性、可用性与生产效率。图卷积网络(Graph Convolutional Networks,GCNs)是深度学习(Deep Learning,DL)在图数据上的拓展,凭借其独特的数据表征能力实现了优异性能。传统状态监测(Condition Monitoring,CM)通常需要为故障诊断与RUL预测分别构建模型,面临知识共享效率低、深度学习模型部署与制备成本高等难题。为解决上述问题,本研究提出一种融合注意力机制的多任务图同构网络,可同步实现故障诊断与RUL预测。该方法考虑任务间的关联关系,引入参数共享机制与自注意力机制。与传统单任务方法相比,所提方法精度更高、实用性更强,且能降低模型开发成本。通过轴承全生命周期退化实验数据验证了该方法的有效性,结果表明该方法可解决故障诊断与RUL预测中的关键问题,在实际应用中具备广阔潜力。

关键词:状态监测;可靠性分析;诊断;预测;健康管理

目录

1 引言

2 相关工作

2.1 多任务学习

2.2 自注意力机制

3 面向故障诊断与RUL预测的所提方法

3.1 图构建模块

3.2 图同构网络

3.3 图自注意力模块

3.4 多任务模块

3.5 联合结果模块

3.6 所提方法的实施步骤

4 实验结果

4.1 实验数据

4.2 数据准备

4.3 性能指标

4.4 结果与分析

5 结论

1 引言

近年来,随着信息通信技术的发展[1, 2],制造业取得显著进步,智能制造与数字化制造加速发展。人工智能(Artificial Intelligence,AI)与制造业深度融合,显著提升经济效益、推动数字化转型、改善产品质量与生产效率[3,4]。然而,随着机械设备向大型化、复杂化、自动化方向发展,设备结构复杂度提升,为维护与维修工作带来巨大挑战[5]。同时,不断增长的生产需求对运行机械的安全性与可靠性提出更高要求。

旋转机械常在高负载、变工况下运行,齿轮、轴承、链条、皮带等部件易发生磨损、裂纹与断裂[6]。此类故障会导致机械运行失稳甚至失效,若未及时检测、维修或更换,将引发重大安全风险与经济损失[7]。轴承作为核心部件,直接影响制造系统中多数旋转机械的性能与整体健康状态[8]。统计数据显示,约50%的电机故障由轴承问题导致[9,10]。机械部件故障是固有随机过程[11],即使相同型号、相同工况的轴承,寿命差异也极大,从数天到数年不等。传统模式下,维护人员定期更换轴承以保障可靠运行,易造成过度更换、停机时间延长、维护成本增加[12,13]。

智能状态监测(Condition Monitoring,CM)[14–16]包含故障诊断与剩余使用寿命(Remaining Useful Life,RUL)预测,可精准监测机械健康状态、预防突发故障、减少非计划停机与维护成本、提升安全性与可靠性[17]。相关技术已被广泛研究。Kateris等[18]基于传感器与特征融合提取健康指标(Health Indicators,HI),结合带自动相关性确定的多层感知器(Multilayer Perceptron,MLP)实现故障类型分类。Qi等[19]提出一种智能状态监测方法,用于异常检测与 RUL 预测,该方法基于稀疏度指标HI采用支持向量数据描述(Support Vector Data Description,SVDD)实现异常检测,并通过多步估计器完成 RUL 预测。类似地,Kankar等[20]提取多种时域统计HI,筛选合适指标后输入支持向量机(Support Vector Machine,SVM)与人工神经网络(Artificial Neural Network,ANN),实现轴承故障诊断。Wang 等[21]基于高斯混合模型(Gaussian Mixture Model,GMM)构建HI,采用支持向量回归(Support Vector Regression,SVR)预测RUL。Han与Jiang[22]结合变分模态分解与自回归模型分解振动信号,将其作为故障特征向量,基于随机森林(Random Forest,RF)实现故障诊断。

深度学习(Deep Learning, DL)的兴起彻底革新了智能状态监测方法,无需依赖专家知识,可直接从海量数据中提取有价值的故障相关信息 [23]。该领域常用DL模型包括卷积神经网络(Convolutional Neural Networks,CNN)、长短期记忆网络(Long and Short-Term Memory networks,LSTM)、自编码器(Autoencoders,AE)与深度置信网络(Deep Belief Networks,DBN)。与传统机器学习(Machine Learning,ML)不同,基于DL的状态监测适用性强,无需领域专业知识与先验知识,如手动提取与筛选HI[24]。为解决轴承故障诊断难题,Jing等[24]基于CNN构建端到端深度学习模型,将特征提取、筛选与分类集成于单一系统。该模型以原始振动信号的频域数据为输入,性能优于常用机器学习方法、前馈神经网络(Feedforward Neural Networks,FFNN)、SVM与RF。另一项研究中,Sabir等[9]基于LSTM提出故障诊断方法,采用电机电流信号,在时域与时频域提取8种HI并输入LSTM,分类精度达 96%。近期,Qi等[25]提出一种无传感器深度加权k近邻(Deep Weighted K-Nearest Neighbors,WKNN)方法,融合深度AE实现健康评估,结合WKNN实现鲁棒异常检测。该方法利用电机驱动器数据,在解决滚子链系统监测难题上优于现有方法。类似地,Peng等[26]提出一种基于无监督深度支持向量数据描述的风机自适应异常检测技术。该方法构建鲁棒球形边界,有效应对数据噪声与波动,提升风机状态监测可靠性。同时,Ahmad等[27]构建基于LSTM的AE,利用实测振动数据在单一状态监测系统中完成特征提取与异常检测。类似地,Hasani等[28]提出基于AE的HI提取方法,追踪轴承全生命周期退化过程。该模型采用振动数据训练,计算初始健康数据与连续样本间的相关性,表征健康状态。此外,Fu等[29]构建融合CNN与LSTM的深度学习模型,利用风机轴承温度数据实现早期隐患检测。Khorram等[30]构建CNN-LSTM模型,以原始振动数据为输入、故障类型为输出,无需对输入数据进行预处理。Ma与Mao[31]构建CNN-LSTM模型,利用时频特征捕捉长时依赖并选择性传播相关信息,RUL预测效果优于单一CNN或LSTM模型。此外,为降低环境噪声影响、提升波浪能转换器齿轮箱故障诊断效果,研究人员开发了CNN-LSTM模型。该模型融合自适应矩估计与刚柔耦合动力学仿真模型,通过仿真与实验数据验证,在变工况干扰下可高效、精准诊断各类故障[32]。Zhao等[33]提出自适应多尺度CNN,有效捕捉实际工业系统变工况下的多时间尺度与数据特征。

尽管CNN可通过卷积核提取数据相关信息,但无法表征故障、噪声与相邻点间的因果关系[34,35]。近年来,图神经网络(Graph Neural Networks,GNNs)在故障诊断领域备受关注,因其可在图域中同时表征节点数值与节点间关联关系[36]。Zhang等[36]将图论、深度学习与图卷积网络(Graph Convolutional Networks,GCNs)融合,构建基于声学数据的故障诊断模型,精度优于CNN、RNN与深度AE等DL模型[36]。Wang等[37]提出融合GNNs与图注意力网络的故障诊断方法,捕捉全局结构信息并根据节点相对重要性动态调整节点权重。Wang等[38]开发门控图卷积网络用于多传感器数据融合与RUL预测,有效建模多传感器信号的时空依赖,精准提取退化特征。此外,Yu等[34]开发深度GCN用于风机齿轮箱故障诊断,采用小波包分解与时频特征。Zhao等[39]引入半监督图卷积深度信念网络构建图邻域关系,解决实际工业场景中标注数据有限的难题。Zhang与Wu[35]提出基于格兰杰因果检验的GNN用于故障分类,量化噪声影响,性能优于SVM、RF与CNN等DL模型[35]。

然而,现有方法仍面临诸多挑战。多数用于RUL预测的DL方法高度依赖特征提取实现样本与RUL的映射,常忽略样本自身的空间关联,这会限制DL模型在RUL预测中的性能。此外,当前多数方法将智能故障诊断与RUL预测视为完全独立的任务,为每个任务单独训练模型。这不仅无法利用任务间的相关性,还因忽略样本空间关联增加了实施复杂度与成本。为解决上述问题,本研究提出一种基于融合注意力机制的多任务图同构网络(Graph Isomorphism Network,GIN)的故障诊断与RUL预测联合方法。通过参数共享与基于自注意力的数据融合,所提方法有效构建故障诊断与RUL预测间的关联关系。该联合训练策略可同步实现故障诊断与RUL估计,相比传统单任务深度学习模型,精度更高、适应性更强、部署成本更低。

本研究的核心方法贡献如下:

(1)  本研究引入基于GIN的模型,采用图卷积实现特征提取。该模型可有效捕捉采集数据中的空间依赖,GIN的层级结构提升特征表征能力。多层架构确保每一层输出均参与多任务模型训练,提升预测性能。

(2)  引入图自注意力机制,自适应融合每一层图卷积提取的特征向量。该改进可动态平衡不同任务的性能,同时提升故障诊断与RUL预测效果。与传统融合技术不同,所提方法可实现最优信息融合,且不降低任一任务的精度。

(3) 开发多任务GCN模型,同步实现轴承故障诊断与RUL估计。通过学习多任务共享表征,提升模型在不同状态监测场景下的泛化能力。此外,多任务模型部署可降低计算与运维成本,为设备维护提供更全面的决策支持。 

(4) 大量实验评估表明,所提方法性能优于传统单任务深度学习模型。该模型在三种不同转速与负载工况下,故障诊断与RUL估计均展现出鲁棒性,进一步验证其在实际状态监测任务中的实用性。

本文后续结构安排如下:第2节综述多任务学习与自注意力机制相关研究;第3节详细阐述多任务状态监测的所提方法,包括图构建、图卷积、自注意力与多任务原理;第4节展示实验结果,包含数据描述、性能指标与深入讨论;最后总结研究成果并展望未来工作。

2 相关工作

本节综述多任务学习与自注意力机制的相关理论。

2.1 多任务学习

多任务学习(Multi-Task Learning,MTL)是一种机器学习技术,利用多个相关任务包含的有效信息训练单一模型,同步提升所有任务的泛化能力[40]。传统机器学习中,任务单独处理、单独建模,每个模型仅执行单一任务,忽略任务间的关联信息。而MTL通过联合学习多个相关任务并实现信息共享,为多任务构建鲁棒、通用的表征。

深度学习中,MTL通常通过参数共享机制实现,包括硬共享、软共享、层级共享与稀疏共享,如图1所示。
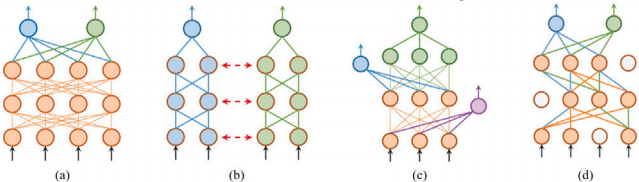
 

图1 参数共享机制[41]:(a)硬共享,(b)软共享,(c)层次化共享,(d)稀疏共享

硬共享:最常用方法,所有任务共享隐藏层,同时定义任务专属输出层。该方法易于实现,参数设置高效。

软共享:与硬共享相反,软共享为每个任务构建独立网络,通过不同任务网络间的交互实现信息共享。该方法更灵活,无需共享网络结构,无需假设任务相关性。但随着任务数量增加,模型参数同步增长,需新增大量参数[42]。

层级共享:该方法在网络结构不同层分配不同任务监督,融入部分任务先验知识设计层级共享结构。层级共享比硬共享更灵活,参数需求少于软共享。但实际应用中,设计有效的层级结构难度较大。

稀疏共享:该方法根据任务随机共享层参数,寻找最优任务与模型参数组合的搜索空间极大。参数共享的随机性为实验结果带来不确定性,无法有效识别并减少模型中的冗余信息[42]。

与单任务模型相比,MTL具备以下优势[43]:

MTL通过共享固有层,避免为每个任务重复计算共享层特征,减小模型规模与复杂度,大幅提升模型效率与训练速度。

通过共享任务间的通用知识与信息,MTL提升模型泛化能力与鲁棒性,降低过拟合风险。

MTL通过多任务共享相同数据,提升数据利用率。这降低了对大量标注数据的依赖,减少深度学习模型训练与部署成本。

MTL模型训练与优化时,不同任务具有不同目标函数。MTL通过反向传播联合损失函数更新模型参数,同步优化多任务目标函数。假设共有N个任务参与MTL,联合损失函数可表示为式


其中    表示共享网络结构的输入,    表示不同任务间的共享参数,    、    、    与    分别为第    个子任务的标签、前向传播函数、损失函数与权重。该公式使MTL模型可根据权重    确定的重要性,平衡每个任务的贡献。

2.2 自注意力机制

注意力机制是受人类认知过程启发的强大技术,可选择性聚焦输入数据中最相关的部分[44]。例如,图像识别中会重点关注图像中信息更丰富的特定区域。注意力机制为不同输入元素分配不同权重,使模型优先关注任务相关信息、抑制无关细节[45]。该技术在DL中应用广泛,尤其在序列建模领域,可通过学习输入特征的相对重要性动态提升模型性能。

自注意力机制是注意力机制的重要变体,在自然语言处理与计算机视觉等领域应用广泛[44]。与传统注意力不同,自注意力计算单一输入序列内部元素间的关系,使模型可捕捉长距离依赖与上下文信息。其核心思想是学习不同输入组件间的相互依赖并据此聚合信息,每个元素根据与其他元素的相关性加权。

在多任务学习场景中,自注意力机制提供额外灵活性。每个任务可独立学习专属注意力权重,实现任务专属特征聚合,无需修改共享模型架构。该能力使模型可选择性关注每个任务最相关的特征,通过更高效的表征学习提升所有任务性能。

3 面向故障诊断与RUL预测的所提方法

为克服传统方法需为故障诊断与剩余使用寿命预测分别构建模型的局限,本研究提出一种基于多任务图神经网络的统一框架。图2展示了所提方法的整体流程,包括实验装置、数据采集、图构建、图运算、自注意力模块与MTL。图3为更详细的流程示意图,包含五大核心组件:(a)图构建模块(Constructing Graph Module,CGM)、(b)图同构网络(Graph Isomorphism Network,GIN)、(c)图自注意力模块(Graph Self-attention Module,GSM)、(d)多任务模块(Multi-Task Module,MTM)与(e)联合结果模块(Joint Results Module,JRM)。
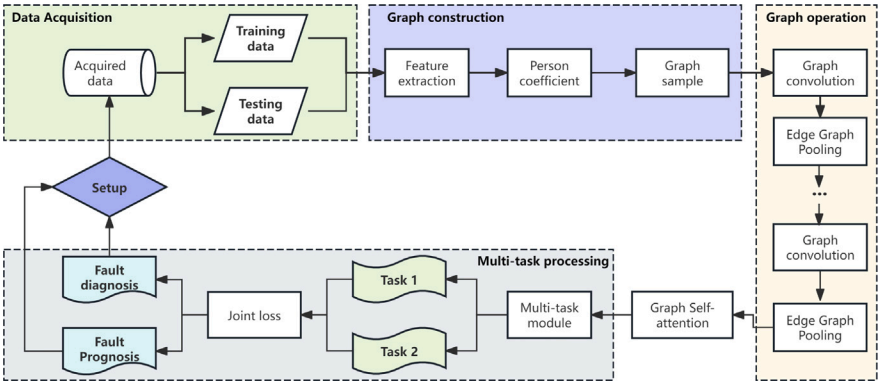
 

图2 所提出的多任务学习方法论概述
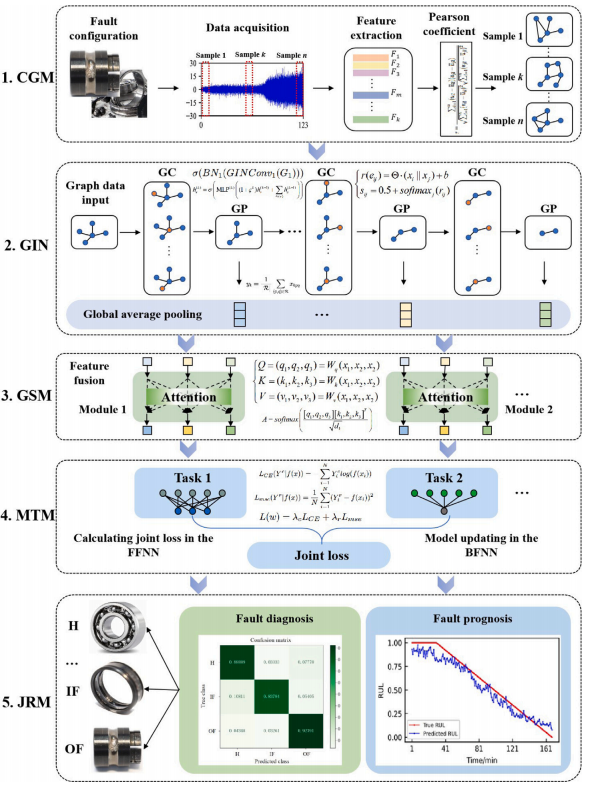
 

图3 所提出联合故障诊断与RUL预测方法的详细阐述

3.1 图构建模块

CGM是将采集的振动信号转换为样本图的核心组件,支持图卷积网络实现特征提取。流程始于从原始信号提取16种时频域特征,这些提取的特征作为样本图的节点。为建立节点间连接,计算每对特征的皮尔逊相关系数。若相关系数超过预设阈值,则在两个节点间构建边。通过将原始振动信号转换为结构化图表征,该方法保留了比原始信号更全面的信息。

预处理阶段是为所提方法准备振动信号的关键步骤,包含两大核心组件:(1) 特征提取:从振动信号中提取节点特征;(2) 图构建:生成邻接矩阵定义节点间连接。具体步骤详述如下:

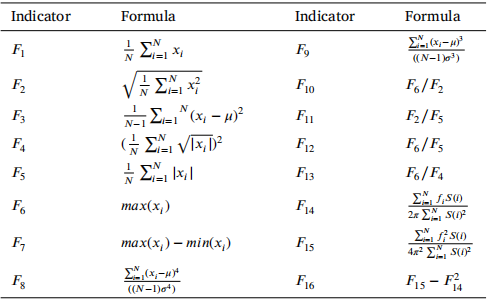
节点特征:为利用图卷积网络实现特征提取,首先将采集的振动信号转换为样本图。转换始于从原始信号提取16种时频域特征,包括均值、均方根、方差等统计量。这些特征记为    至    ,详见表1[46],选择依据是其可有效反映滚动轴承运行状态,且随时间呈现显著变化。每个特征作为样本图中的一个节点,节点特征提取是构建图的基础。融入这些特征后,样本图可丰富表征振动信号的动态行为信息。 

表1 所用指标的表达式


邻接矩阵:邻接矩阵是样本图的核心组件,定义节点间连接,是图卷积层的必要输入。节点间连接基于皮尔逊相关系数确定,该系数量化节点特征对间的线性关系。两个节点    与    间的皮尔逊相关系数    计算如下:


其中    与    表示两个不同节点,    与    为其对应均值。    取值范围为0至1,数值越高表示节点间相关性越强。为确保仅保留显著关联关系,为皮尔逊相关系数设置0.8的阈值。具体而言,仅当节点    与    的相关系数    超过0.8时,才在二者间构建边。该阈值处理确保图结构保留特征间最有意义的连接,过滤弱相关关系,提升样本图的表征能力。 通过上述预处理步骤,振动信号被有效转换为样本图,封装数据的时序与关联特征。该结构化表征为所提方法后续的分析与分类任务提供支撑。

3.2 图同构网络

GIN包含三层图同构卷积层与图边池化层。每一层图卷积(Graph Convolution,GC)的输出通过图池化(Graph Pooling,GP)方法——边池化(EdgePool)[47]处理,再全局平均池化得到每一层的特征表征。仅使用最后一层输出会导致图卷积模块性能损失。层级图卷积神经网络的每一层输出均参与后续任务,使训练过程更稳定、模型性能更高。

特征提取由三层堆叠的GIN层实现。每一层包含GIN卷积层、批量归一化层、激活层与图池化层。前一层图池化层的输出作为下一层GIN层的输入。三层全局平均池化层的输出拼接后,作为两个全连接层的输入。设    为样本图,GIN计算如式(3):


其中    为图同构网络卷积层,    为批量归一化层,    为激活函数,    为图池化层,    为全局平均池化层,    为拼接操作,    为全连接层。

3.2.1 图同构卷积

传统图神经网络采用邻域聚合策略更新节点表征,但难以有效学习同构图的判别特征[48]。图同构卷积(如图4所示)具备更强的图结构依赖捕捉能力与图区分能力,主要分为两步:首先通过求和函数聚合邻域节点特征;随后将聚合特征输入 MLP 进行非线性映射,完成节点特征更新。更新机制如图 4 所示,对应公式:


该公式中,第    层节点特征    通过将前一层特征向量    乘以可学习参数    更新。聚合邻域节点特征并融合后,输入MLP层,输出经非线性激活得到节点    的新特征。具体而言,    与    分别为节点    在第    层与    层的特征。节点    为节点    的邻域节点,满足    ,其中    为节点    的邻域集 合。
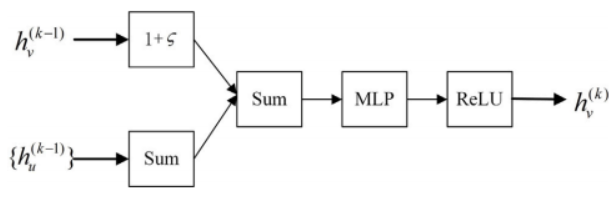
 

图4 图同构卷积层的更新机制

聚合与融合函数必须满足单射性,即每个输入对应唯一输出。GIN通过MLP在GNN中学习上述函数,确保单射性。采用求和函数聚合、MLP非线性变换,GIN可有效区分同构图,学习更具信息性的节点表征。

3.2.2 图边池化

为预测RUL,模型必须学习样本图对应的剩余寿命回归曲线。因此,GP是GNN应用于RUL预测等任务的关键步骤。图池化的核心目的是降低图复杂度,同时保留核心图结构信息[49]。通过融合节点特征实现,减少回归模型需拟合的节点数量。Edgepool[47]是基于连接边分数融合节点的池化方法。首先通过可学习参数Θ与偏置项b计算边分数,再经softmax函数归一化得到最终边分数    ,如式(5):


其中    与    分别为第    个与第    个节点特征,    为边    的原始分数。Θ 与𝑏为可学习参数。    为节点所有边归一化后的最终边分数。


池化操作根据最终边分数融合第    个与第    个节点特征,生成新节点特征,如式(6)。图池化确保高分边连接的节点被融合,有效降低图复杂度、保留结构信息、提升计算效率。

3.3 图自注意力模块

GSM通过自适应重加权不同输入元素的贡献,提升特征表征能力。该机制使模型可选择性强调重要特征、抑制无关特征,提升分类与回归任务性能。如图3所示,为两个任务分别设置独立自注意力模块,使其在共享卷积层参数的同时,学习专属特征表征。该设计确保模型可高效提取任务专属特征,无冗余。 GSM按结构化三步流程运行:

 (1)线性映射:第一步将全局平均池化层得到的特征向量转换为三种不同表征:查询(Query,Q)、键(Key,K)与值(Value,V)[44, 50]。该转换通过三个可学习权重矩阵    、    与    实现,将输入特征向量X映射至不同隐空间。过程数学公式如下:


每种转换学习输入特征的不同视角。    为寻求注意力的特征,    为对比参考,    为最终聚合步骤使用的实际特征表征。该分解使模型可捕捉特征间复杂的依赖与交互。 

(2)注意力分数计算:第二步计算注意力分数,量化每个特征相对其他特征的重要性。通过缩放点积运算计算    与    间的相似度:


其中内积    衡量查询向量与键向量的相似度,生成注意力分数矩阵    。缩放因子    防止点积数值过大,避免训练过程中梯度消失或爆炸[51]。Softmax函数将    的每一行归一化,使分数和为 1,确保其表示输入特征的概率分布。 

(3)加权聚合:计算注意力分数后,用于对值矩阵    进行加权聚合。最终输出表征    计算如下:


该操作生成精细化特征表征,每个元素为输入特征的自适应组合,按重要性加权。 最终输出输入后续层,执行分类与回归任务。通过动态调整特征重要性,该步骤提升模型表达能力,增强捕捉任务专属信息的能力。

3.4 多任务模块

设计优良的故障诊断模型不仅需精准识别具体故障,还需支持故障预测。为实现该目标,所提方法融合MTL与联合损失函数,确保故障诊断与RUL预测同步优化。

MTL的核心原理是参数共享,提升跨任务特征泛化能力。所提MTM采用硬参数共享,即两个任务共享整个图卷积模块。该结构使任务间交互、竞争,学习更泛化的特征,最终同步提升故障诊断与RUL估计效果。

针对任务专属处理,MTM采用两个独立全连接层:故障诊断分类模块与RUL预测回归模块。如图3所示,分类模块(任务 1)预测每种故障的概率分布,回归模块(任务 2)输出RUL估计值。

为实现同步学习,采用联合损失函数平衡两个任务。故障诊断任务采用带交叉熵损失函数    的Softmax分类器,如式 (10):


同时,RUL预测任务采用均方误差(Mean Squared Error,MSE)损失函数    优化:


其中    为输入样本,    与    分别为故障诊断与RUL预测任务的标签。 为平衡两个任务的贡献,构建加权联合损失函数    :


其中    与    为任务专属权重,控制故障诊断与RUL预测的相对重要性。为不同任务分配不同权重,会直接影响学习动态,可能优先优化某一任务。需详细讨论这些权重对模型性能的影响,阐明每个任务的学习机制。

 前向传播过程计算联合损失函数,随后用于反向传播更新模型参数。最终,MTM 在统一框架中学习故障诊断与RUL预测。训练完成后,模型可同步输出预测故障类型与估计RUL,验证其故障识别与预测能力。

3.5 联合结果模块

基于计算得到的联合损失,同步得到故障诊断与故障预测结果。为全面评估性能,除可视化展示外,还采用多种指标。故障诊断任务采用精度、精确率、召回率与 F1 分数;故障预测(RUL预测)任务采用F1分数、均方根误差(Root Mean Square Error,RMSE)与决定系数(    )。

3.6 所提方法的实施步骤

通过允许每个任务学习专属注意力权重与聚合方法,多任务模型可更精准地聚焦每个任务输入中最相关的部分。该定向注意力机制使模型更好地捕捉数据中与每个任务最相关的独特特征与关联关系。因此,带任务专属注意力的MTL不仅提升模型适应性,还显著增强整体性能与泛化能力。所提方法的实施步骤如下: 

步骤1:首先通过加速度计采集滚动轴承全生命周期退化过程的振动数据。 

步骤2:采用时频域分析处理采集的振动信号,提取特征。计算特征间相关系数,构建样本图。 

步骤3:为RUL预测设置分段线性标签,为故障类型设置对应标签(标签知识),监督模型学习隐藏信息。 

步骤4:构建多任务数据集    ,其中    为输入样本,    为输入样本的故障类型标签,    为RUL标签。 

步骤5:采用多任务模型基于构建的数据集开展联合监督训练,通过最小化联合损失函数优化模型参数。迭代次数达到上限或模型收敛至最优时停止训练,得到训练完成的多任务模型。 

步骤6:最后将测试样本输入训练完成的多任务模型,模型同步输出输入样本的故障类别与对应RUL。 该方法通过动态学习并为每个任务应用不同注意力机制,确保模型有效优先利用关键信息。在保留任务专属细节的同时,共享跨任务知识,所提方法形成全面高效的框架。

4 实验结果

所提方法融合GIN与自注意力模块,实现故障分类与回归任务。为验证所提方法的有效性,采用轴承全生命周期退化数据进行实验验证。

4.1 实验数据

实验装置如图5所示,主要包括交流电机、电机调速器、支撑轴承、测试轴承与液压加载系统。电机由调速器控制,以不同转速运行。测试轴承安装在旋转轴上,液压加载系统为测试轴承施加径向载荷。实验设计三种不同工况开展,详见表2。
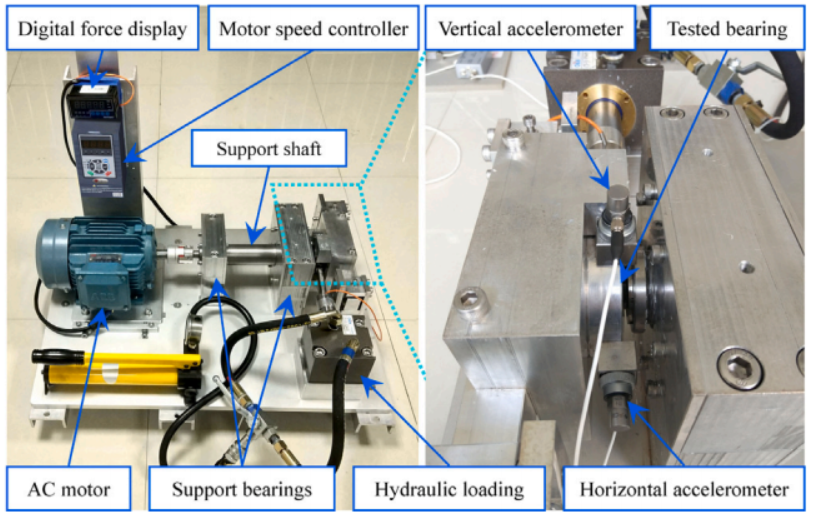
 

图5 轴承退化试验实验装置

表2 被测轴承的工况及故障详情
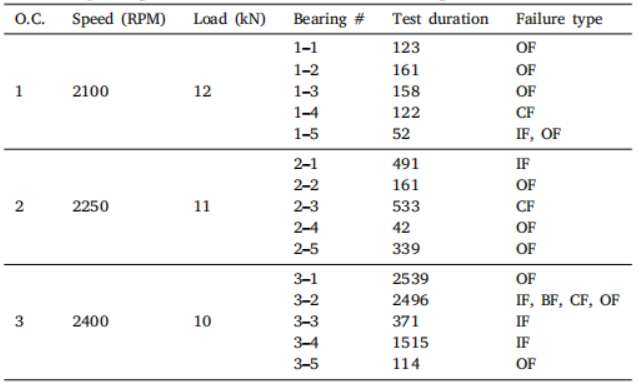
 

采用两个加速度计采集数据,分别水平与垂直布置于测试轴承旁。采样频率设为25.6kHz,每分钟采集一次数据。每次采集时长1.28秒,每次采集得到32768个数据点。当测试轴承振动幅值超过健康阶段十倍时,停止退化测试。测试结束时轴承失效模式如图6所示,包括内圈故障、外圈故障与保持架断裂。实验结束后,获取三种工况下15个轴承的完整退化数据,具体寿命见表2。
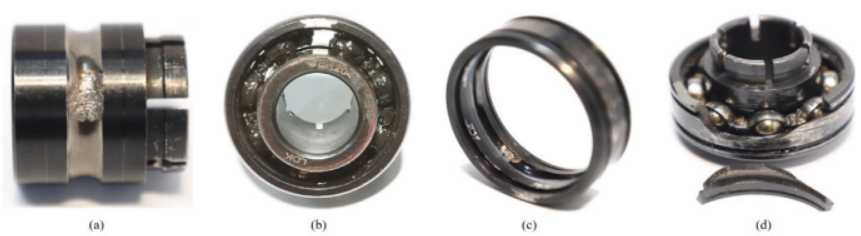
 

图6 滚动轴承失效类型:(a) 内圈失效,(b) 保持架失效,(c) 外圈磨损,(d) 外圈断裂

4.2 数据准备

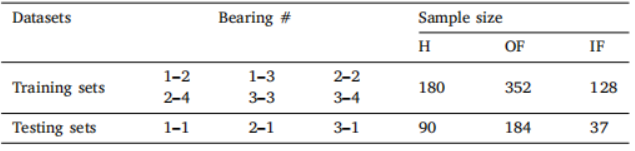
训练多任务模型时,必须为输入数据标注故障类型。表2中仅轴承2–3与1–4存在保持架故障,因此不参与训练。此外,轴承1–5与3–2存在外圈故障(Outer Fault,OF)、内圈故障(Inner Fault,IF)、滚动体故障(Ball Fault,BF)与保持架故障(Cage Fault,CF)等混合故障类型,同样排除在训练集外。因此,其余轴承的故障类型分为健康(Healthy,H)、OF与IF三类。三种故障类型的标签分别设为[0, 1, 2]。为验证所提方法性能并覆盖多种工业场景,每种工况选取两个轴承用于训练多任务模型。共计选取表2中6个轴承用于训练,每种工况选取一个轴承用于测试模型性能。由于不同轴承健康阶段时长不同,选取每个轴承健康阶段前30分钟数据作为正常样本。最终实验数据集见表3。精心筛选确保数据集平衡,使模型可在不同故障类型与工况下泛化。

表3 训练集和测试集准备
 

4.3 性能指标

为评估故障诊断与RUL预测性能,采用分类指标与回归指标。

4.3.1 分类指标

二分类问题中,样本分为正类或负类,如图7所示。为评估不同方法性能,选择合适的评估指标至关重要。分类问题常用评估指标包括精度、精确率、召回率与F1分数 [52,53]。这些指标可由混淆矩阵推导得出,如图7所示,混淆矩阵通过对比实际标签与预测标签,汇总预测性能。 真正例(True Positive,TP)表示正样本被正确预测为正类。假负例(False Negative,FN)表示正样本被错误预测为负类。假正例(False Positive,FP)表示负样本被错误预测为正类。真负例(True Negative,TN)表示负样本被正确预测为负类。 精度:该指标表示正确预测样本数占总样本数的比例,如式 (13)。


精确率:该指标表示所有预测为正类的样本中,真正例样本的比例。


召回率:该指标表示所有实际正类样本中,被正确预测为正类的比例。


F1分数:当数据样本不平衡时,单一指标(如精度、精确率、召回率)无法 正确评估故障分类性能。此时,结合精确率与召回率的F1分数可提供更均衡、准确的评估。该指标在评估不平衡数据模型性能时尤为有用,提供全面衡量。
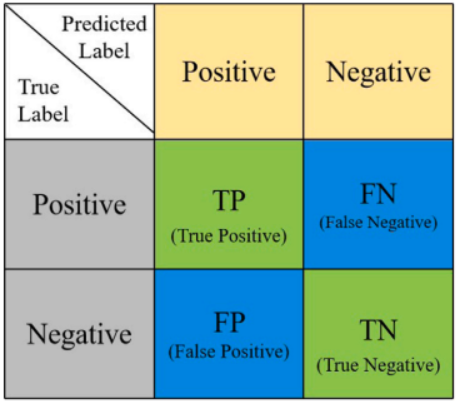
     
   
图7 混淆矩阵的解释    

4.3.2 回归指标

RUL预测采用均方根误差(Root Mean Square Error, RMSE)与拟合优度    衡量预测性能 [54, 55]。RMSE:该指标衡量预测值与真实值间的平均误差。完美预测时该值趋近于 0。 拟合优度    :该指标表示回归线对观测值的拟合程度。    越接近 1,拟合效果越好。


其中    与    分别为真实值与预测值,    为真实值均值。

4.4 结果与分析

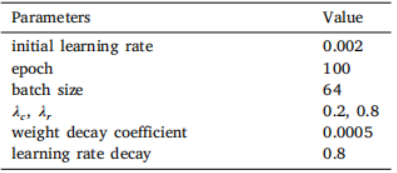
本节展示所提多任务模型的故障诊断与RUL预测结果,分析包括故障诊断与RUL预测性能,以及与现有方法的对比(见表 4)。

表4 超参数设置
 

4.4.1 单任务/多任务学习结果对比

为验证所提方法有效性,分别在单任务与多任务模式下评估所提方法。单任务模式下,独立训练两个模型,分别执行故障诊断与RUL预测。多任务模式下,采用带联合损失函数的单一模型,同步执行故障诊断与RUL预测。为确保公平对比,深度学习模型超参数在单任务与多任务训练中保持一致,见表4。为降低随机性影响,每个测试轴承的设计模型重复实验五次,取五次运行平均值作为最终结果。 

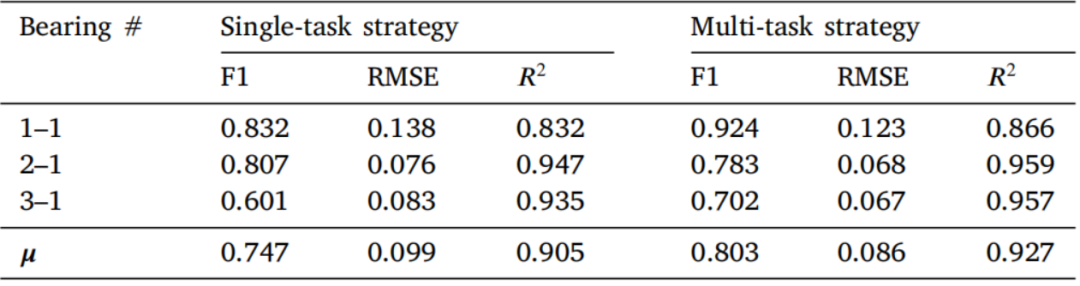
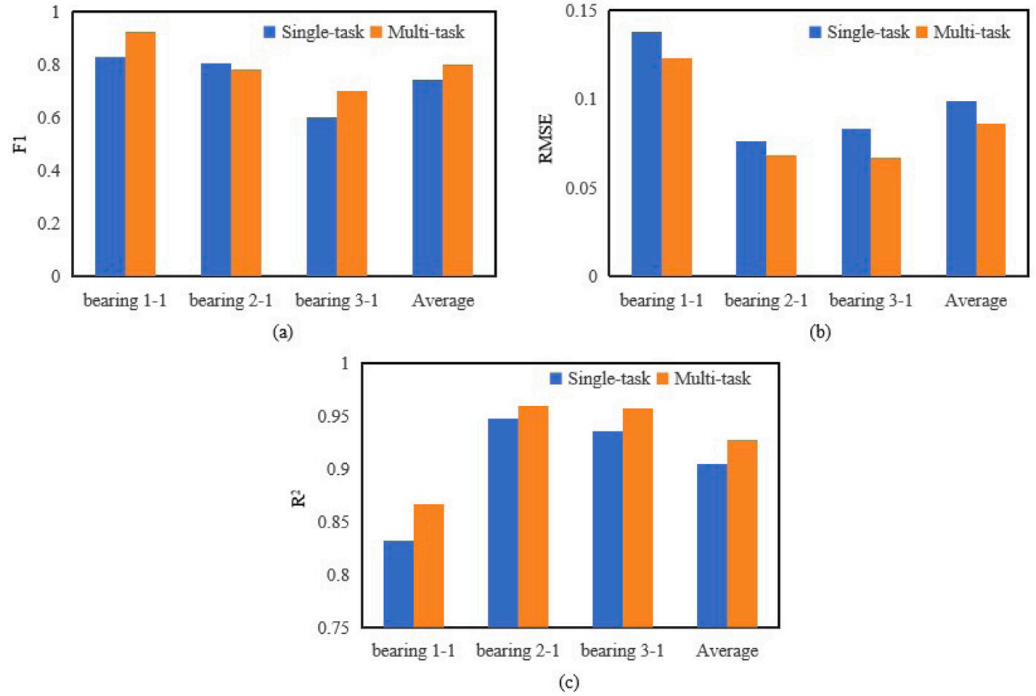
实验结果如表5、图8与图9所示,表明所提多任务模型不仅可同步实现故障诊断与RUL预测,在验证轴承上的性能还优于单任务模型。对比测试集平均性能,故障诊断F1分数为0.803,RUL预测RMSE与      分别为0.086与0.927。

表5 基于单任务/多任务模型的结果对比


图8 采用不同性能指标进行的结果对比  
 
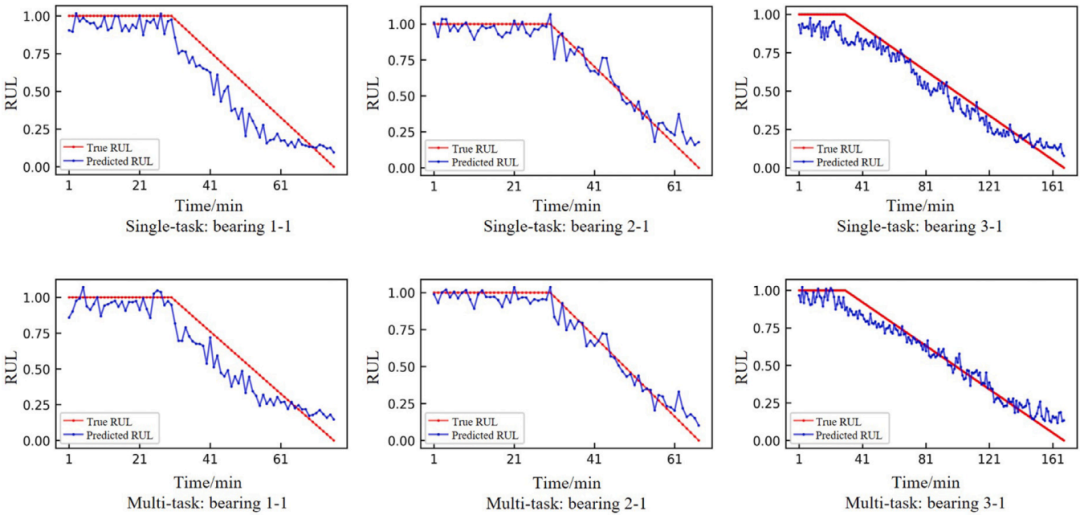
图9 RUL预测结果对比      
分析每个轴承的结果可见,所提多任务方法RUL预测的RMSE值始终更低,表明模型在捕捉潜在退化特征方面具备鲁棒性。F1分数方面,除轴承2–1略低外,多任务模型在其余两个测试轴承上均优于单任务模型。这表明所提多任务模型在实现轴承RUL预测的同时,取得更优的故障诊断效果。如图9所示,所提多任务模型的RUL预测值紧密跟随真实RUL。初始健康阶段,预测RUL相对稳定,趋近于1。随着轴承开始退化,预测RUL呈下降趋势,与实际RUL曲线高度拟合,直至寿命结束。因此,三种工况下三个轴承的验证结果证实,所提多任务模型的RUL预测精度高于单任务模型。单一模型同步实现故障诊断与RUL预测的能力,为预测性维护提供全面决策支撑,在未来应用中具备重要实用潜力。   
单任务与多任务模型对比显示,轴承2–1的单任务模型故障诊断F1分数更高。但其余轴承的单任务模型F1分数与RMSE均差于多任务模型。单任务模型的平均F1分数、RMSE与    分别为0.747、0.099与0.905,劣于多任务模型。这表明所提多任务模型学习到更鲁棒的特征表征,提升了跨任务、跨轴承、跨工况的泛化性能。   
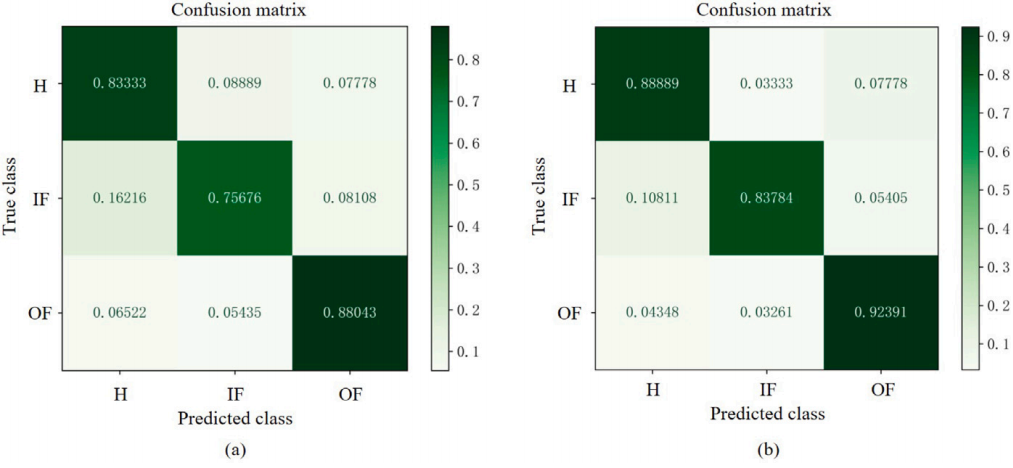
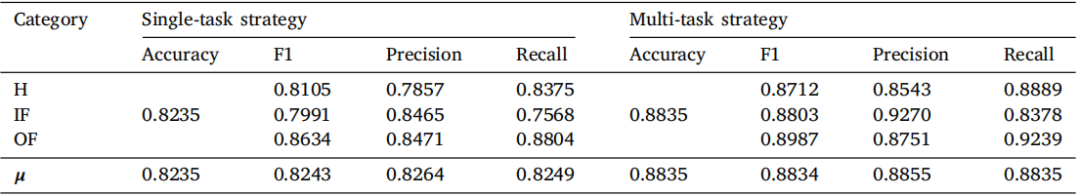
此外,图10所示混淆矩阵结果表明,所提多任务模型在不同故障类型下均实现稳定高诊断精度,凸显其优异的泛化能力。对比之下,单任务模型对健康轴承、内圈故障、外圈故障的分类精度分别为0.83333、0.75676、0.88043。而多任务模型(如图10 (b))对应类别精度分别提升至 0.88889、0.83781、0.92391,诊断性能显著提升。为进一步支撑对比,4.3.1节提供的精度、F1分数、精确率与召回率等额外性能指标汇总于表6。结果清晰表明,多任务模型在所有故障类别与评估指标上均优于单任务模型。这印证了模型可有效利用任务间共享表征,实现更泛化、鲁棒的特征学习。  
 
图10 基于单任务/多任务模型的混淆矩阵对比  
表6 单任务与多任务方法的性能对比  
 

4.4.2 多任务学习与其他方法对比

为验证所提方法有效性,选取三种前沿故障诊断与 RUL 预测方法进行对比。
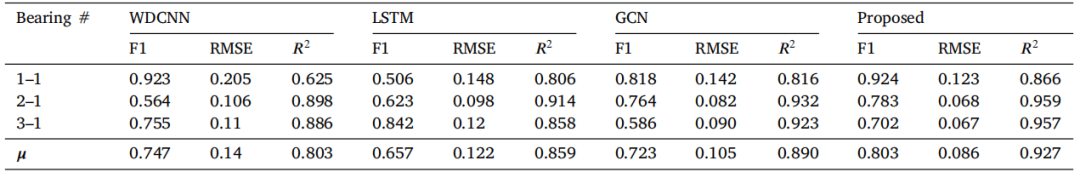
 (1) WDCNN [56]:一种卷积神经网络结构,包含五层卷积层与一层全连接层。第一层采用尺寸为 64、步长为 16 的大卷积核。该模型采用单任务策略测试故障诊断与 RUL 预测,训练超参数与所提方法保持一致。  
 (2) LSTM [57]:一种循环神经网络模型,由两层堆叠 LSTM 单元组成,后接两层全连接层用于 RUL 预测。与 WDCNN 相同,LSTM 模型也采用单任务策略实现故障诊断与 RUL 预测。   
(3)GCN [58]:典型图卷积神经网络模型,包含三层图卷积层与两层全连接层,可直接处理图结构数据,利用其结构信息。该模型采用消息传递机制,每个节点在特征更新时聚合邻域节点信息,有效捕捉节点间关系,提升特征提取效果。实际应用中采用单任务方法实现轴承故障诊断与剩余使用寿命预测。GCN 处理前,需先将振动信号转换为图结构数据,本研究采用所提图构建方法,确保模型充分利用振动信号内在关联。   
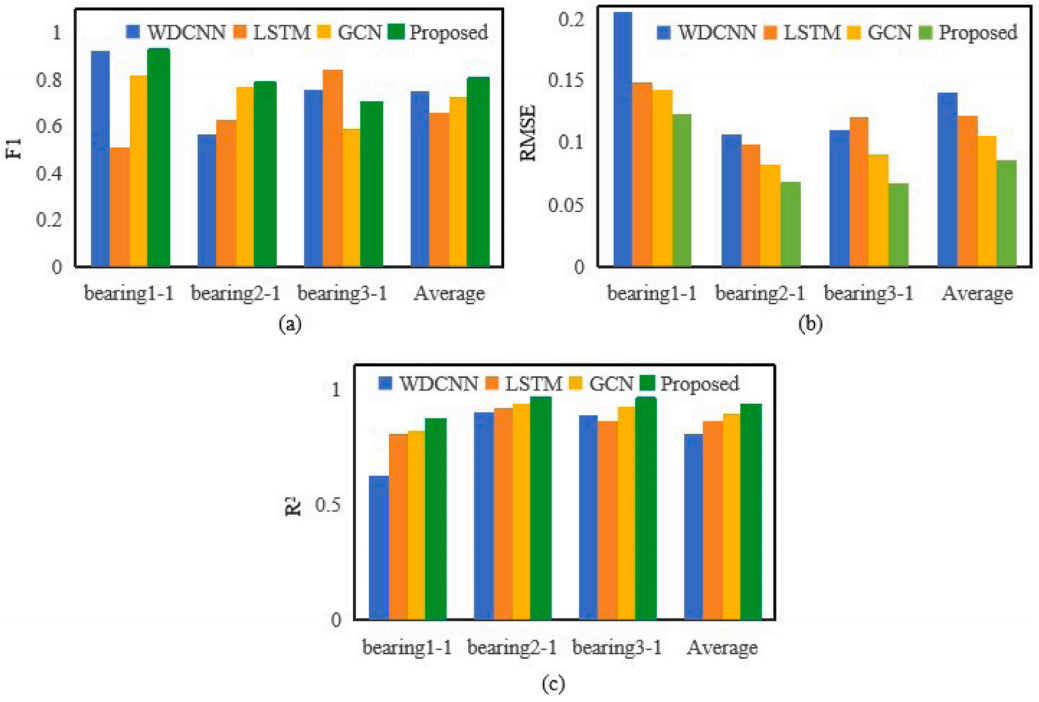
实验结果汇总于表7与图11。WDCNN、LSTM与GCN的对比凸显各自优劣。故障诊断任务中,LSTM平均F1分数为0.657,低于WDCNN的0.747与GCN的0.723。但RUL预测任务中,LSTM优于WDCNN,平均RMSE为0.122、    为 0.859,而WDCNN 表现较差。尽管如此,LSTM仍劣于GCN,GCN平均RMSE为0.105、    为0.890,效果更优。上述结果表明,WDCNN擅长提取深度特征,更适用于故障诊断;而LSTM与GCN在捕捉时序依赖方面能力更强,对RUL预测更有利。值得注意的是,所提多任务模型在故障诊断与RUL预测任务上均超越WDCNN、LSTM与GCN。这验证了其在联合提取深度特征表征与时序模式方面的有效性,为状态监测提供更全面、鲁棒的解决方案。  
表7 所提方法和先进方法的结果对比  


图11 所提方法和先进方法的结果对比  
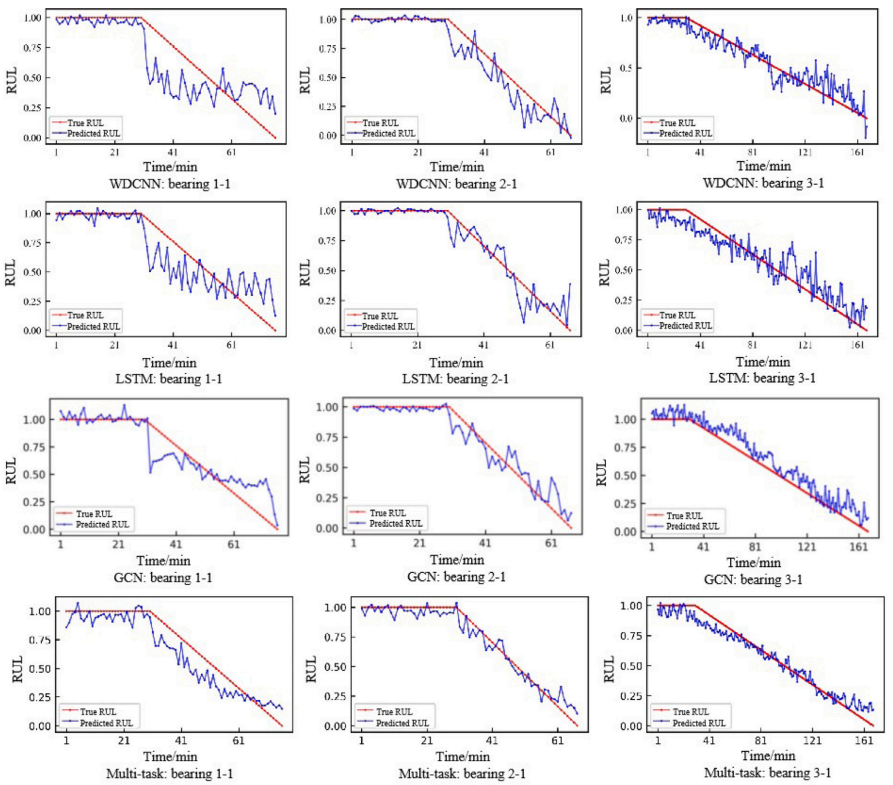
 图12可视化展示WDCNN、LSTM、GCN与所提多任务模型在轴承1–1、2–1、3–1 上的RUL预测结果。所提方法的拟合趋势明显优于WDCNN、LSTM与GCN,有效表征测试轴承的退化趋势。具体而言,对于轴承3–1,所提方法不仅实现更优的    与更低的RMSE,RUL预测也更稳定。这表明所提方法在轴承RUL预测方面具备更强的鲁棒性。   


图12 所提方法和先进方法的RUL对比  
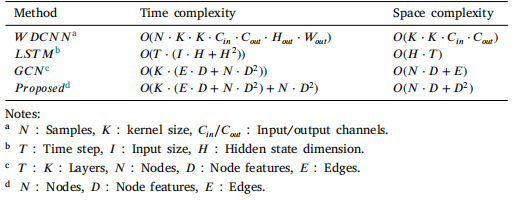
此外,开展全面计算复杂度分析,评估所提方法与标准方法(WDCNN、LSTM、GCN)的效率与实用性。   
WDCNN[56]:WDCNN的时间复杂度主要由卷积层决定。每层卷积复杂度为    ,其中    为样本数,    为卷积核尺寸,    与    为输入输出通道数,    与    为输出特征图维度。空间复杂度主要由卷积核参数决定,为    。   
LSTM[57]:LSTM的时间复杂度为    ,其中    为时间步长,    为输入维度,    为隐藏状态维度。LSTM的空间复杂度为    ,需存储每个时间步的隐藏状态。  
GCN[58]:GCN 的时间复杂度为    ,其中    为层数,    为边数,    为节点数,    为节点特征维度。稀疏图中    占主导。空间复杂度为    ,需存储所有节点特征向量。  
所提方法:本方法采用融合自注意力与多任务学习的GIN。时间复杂度主要由GINConv层与自注意力模块决定。每层GINConv复杂度为    (与 GCN 相同,但采用单射聚合)。自注意力模块额外增加复杂度    ,    为节点特征维度。空间复杂度为    (存储节点特征)与    (自注意力模块参数)。   
不同方法计算成本汇总于表8。融合自注意力的GIN方法相比基线方法计算效率更优。在保持GCN基于边的线性复杂度(    )的同时,通过GIN强大的聚合能力提升表达能力。自注意力机制仅增加    复杂度,远优于LSTM的    时序处理或WDCNN的    卷积操作。该架构通过稀疏存储保持内存效率(    ),并通过多任务学习消除冗余计算。这种最优复杂度特性使本方法在大规模图应用(    )中尤为有利,兼顾GCN的可扩展性与注意力的表达能力,同时避免时序或卷积方法的高成本。特征维度的二次依赖(    项)通过统一特征学习实现合理性,否则需多个专用模型,在图结构任务的表达能力与计算效率间实现最优平衡。此外,多任务学习方法可同步实现故障诊断与剩余使用寿命预测,减少对独立模型的需求,提升数据利用效率。  
表8 不同深度学习模型的计算消耗  
 

4.4.3 图自注意力模块消融分析

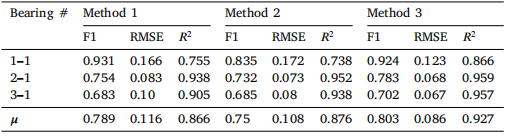
为验证图3所述所提方法中图自注意力模块的有效性,对每层全局平均池化输出的特征向量采用不同数据融合方法。

方法1:每层输出特征向量直接相加实现特征融合。模型为分类与回归任务输入相同向量,维度为256。

方法2:每层输出特征向量通过向量拼接融合。模型为分类与回归任务输入相同向量,维度为768。

方法3:所提方法采用图自注意力模块,对每层特征向量进行注意力加权数据融合。模型为分类与回归任务输入相同向量,维度为256。

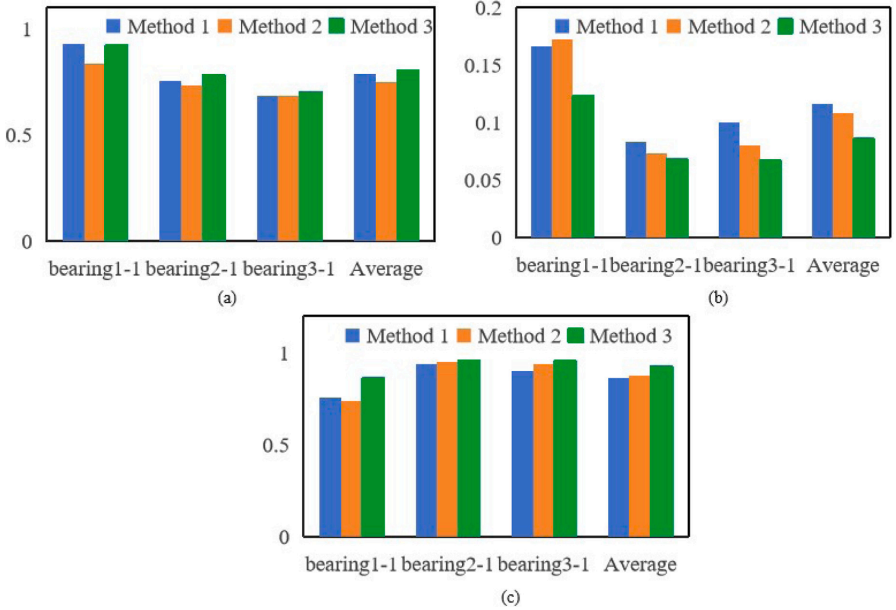
实验结果如表9与图13所示。对比三种数据融合方法的平均F1值,发现方法1的故障诊断效果优于方法2,表明通过相加融合的特征向量对故障诊断任务更有利。方法3的F1分数超过方法1与2,表明注意力加权数据融合可提取更有利于故障诊断的特征。对比三种方法RUL预测的RMSE与      ,方法2优于方法1。这可能归因于拼接向量导致全连接层参数增加,提升深度学习模型容量。相反,方法1的直接相加平滑了输入特征向量间的差异,阻碍模型学习隐藏信息。相比之下,方法3相比方法1与2,RUL预测性能提升。这表明图自注意力模块不仅提升故障诊断效果,还改善RUL预测,验证了图自注意力模块的有效性。综上,方法3在所有指标(F1、RMSE、      )上均稳定优于方法1与2,尤其在平均性能上,验证了自注意力模块的有效性。方法3的F1分数高于方法1与2,分类精度提升。同样,方法3实现最低RMSE与最高      ,凸显其更优的预测能力。

表9 不同特征融合方法的性能对比


图13 采用方法 1、方法 2 及方法 3 进行结果对比    
   

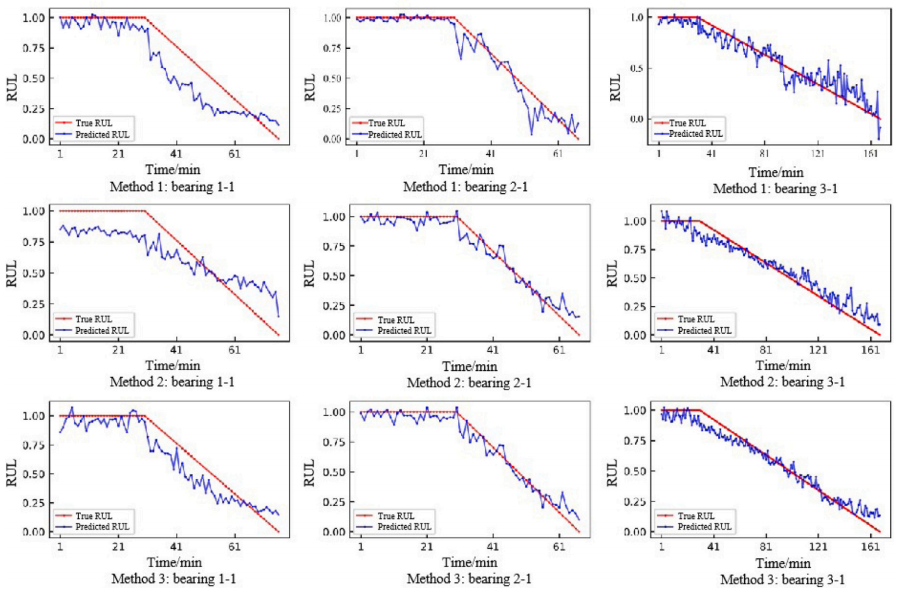
图14 采用方法 1、方法 2 及方法 3 进行的 RUL 比较

三种方法的RUL结果如图14所示。所有方法的图卷积神经网络RUL预测RMSE均较低,表明每种方法均实现良好的RUL预测。图14中观察到细微差异,与每个轴承的测试RMSE值一致。此外,明显可见所提方法(方法 3)在三个测试轴承上拟合效果最佳。方法3在健康与故障阶段均精准拟合真实RUL。这表明所提方法融合的特征可更有效区分健康与故障阶段,进一步验证所提方法在故障诊断中的优异性能。因此,采用图自注意力模块对每层图卷积特征向量加权数据融合,不仅提升模型故障诊断性能,还改善RUL预测效果。该提升归因于模型可根据每个任务的具体需求,自适应构建合适的特征向量,从而同步提升故障诊断与RUL预测任务性能。 

基于实验结果分析,所提基于图神经网络的多任务模型有效融合轴承故障诊断与RUL预测,两项任务性能均表现优异。与单任务模型相比,该方法提升预测精度,同时显著降低多模型开发与部署成本。图自注意力模块通过自适应加权图卷积层特征表征,优先关注信息丰富的特征、过滤无关特征,发挥关键作用。该机制通过捕捉细微故障模式提升故障分类精度,在不同工况下的优异故障诊断性能验证了这一点。与其他融合方法(方法1与2)相比,图自注意力模块在故障诊断与RUL预测间实现更优平衡,确保任一任务性能不受损。此外,多任务学习策略实现相关任务间知识共享,提升泛化能力与鲁棒性。通过联合优化故障诊断与RUL预测,模型缓解数据稀疏问题,增强识别退化趋势的能力。相比单任务方法更优的预测性能,凸显融合诊断与预测信息的优势。因此,所提方法不仅为预测性维护提供更全面的方法,还优化维护效率、降低运行风险。其强大的实用潜力使其适配工业应用,支撑智能状态监测与健康管理策略。

5 结论

本文提出一种基于融合图同构神经网络与注意力机制的多任务模型的新型故障诊断与RUL预测方法。核心创新在于通过单一模型联合训练,同步实现故障诊断与RUL预测。所提模型通过参数共享与联合损失函数机制实现,仅用一个模型同步处理多任务,降低智能维护模型实施复杂度与成本,为工业设备健康管理提供更全面的决策支持。此外,采用图自注意力模块自适应加权图卷积层特征向量。与其他数据融合方法相比,所提方法有效平衡不同任务性能。通过三种不同工况的实验验证,所提多任务模型性能优于其他单任务方法,不仅精准预测RUL,在识别测试轴承故障类型方面也具备良好的故障诊断能力,有效避免运行机械突发故障引发的严重后果。作为基于深度学习的多任务模型,当前网络架构本质上仍为黑箱系统,内部决策机制缺乏可解释性。尽管注意力机制为特征权重分配提供部分可解释性,但故障模式识别与RUL预测间的跨任务关联机制、图结构与物理退化过程间的具体映射关系等关键方面,仍缺乏清晰的可视化解释。这种可解释性缺口可能阻碍模型在安全关键领域的实际部署,尤其在需要故障溯源与决策验证的场景,如航空发动机维护。未来工作应融合可解释人工智能技术,包括特征重要性分析、注意力路径可视化或模型蒸馏,建立物理退化过程与网络决策间的明确关联。 

编辑:陈宇航

校核:李正平、陈凯歌、曹希铭、赵学功、白亮、任超、海洋、Leo、Kira、Tina、王金、赵诚、肖鑫鑫、张优

该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除


来源:故障诊断与python学习
ACTMechanicalSystem振动断裂非线性旋转机械通用航空汽车电力电子ANSAUM声学裂纹理论电机数字孪生人工智能
著作权归作者所有,欢迎分享,未经许可,不得转载
首次发布时间:2026-10-10
最近编辑:48分钟前
故障诊断与python学习
硕士 签名征集中
获赞 87粉丝 153文章 336课程 0
点赞
收藏
作者推荐

IEEE || ABIGX:一个可扩展的故障检测和分类的统一框架(下)

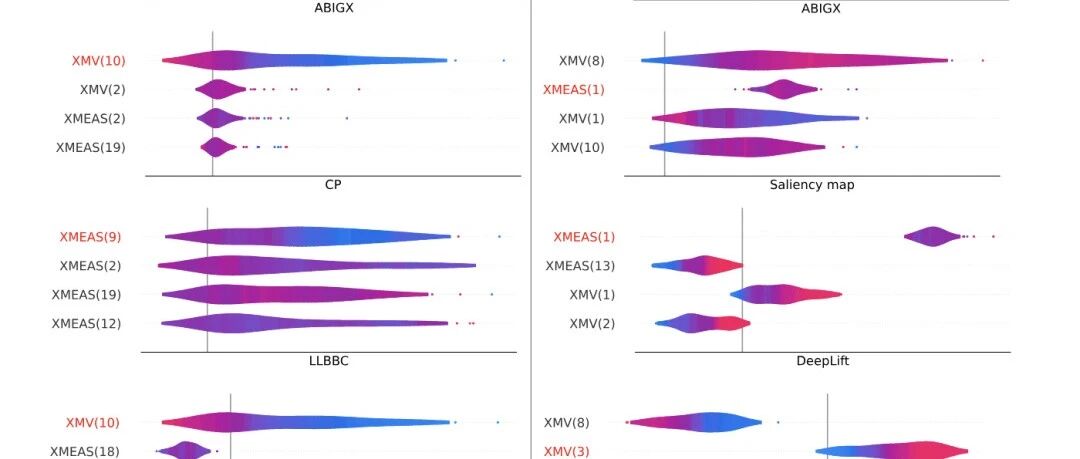
从对抗攻击视角重构故障重建,东南大学团队提出ABIGX统一框架,将经典CP/RBC诊断方法拓展至任意深度学习模型,理论证明其等价性,破解"故障类别涂抹"难题,在TEP、晶圆图及工业图像上验证,为智能运维黑箱决策提供可信归因工具。 本期给大家推荐这篇东南大学虞文武教授团队的论文。本文提出ABIGX(Adversarial Fault Reconstruction-Based Integrated Gradient eXplanation,基于对抗故障重构的积分梯度解释)框架,统一解决可解释故障检测与分类问题。核心创新在于:1)从对抗攻击视角重构故障重建,将传统CP(Contribution Plot,贡献图)/RBC(Reconstruction-Based Contribution,基于重构的贡献)方法扩展到非线性模型;2)提出分类SPE(Squared Prediction Error,平方预测误差)指标,使AFR(Adversarial Fault Reconstruction,对抗故障重构)适用于故障分类任务;3)结合集成梯度实现模型无关的变量归因。理论证明CP和RBC是ABIGX的线性特例,并分析"故障类别涂抹"问题,证明ABIGX优于传统梯度方法。实验涵盖多种模型,在TEP过程、晶圆图和MVTec-AD数据集上验证其优越的解释准确性与泛化能力。 由于文章篇幅过长,小编将分两次为大家翻译介绍这篇论文,第一篇推文(点击即达)系统系统综述了故障检测与分类的研究背景,指出传统CP、RBC方法受限于线性模型且无法处理分类任务,而现有深度学习解释器缺乏故障诊断领域的理论基础。基于此,作者从对抗攻击视角重新诠释故障重建,提出AFR方法及分类SPE指标,进而构建ABIGX统一框架——通过AFR生成语义有效的反事实基线,结合集成梯度实现任意可微FDC模型的变量归因,为后续理论分析与实验验证奠定基础。 本篇推文进一步涵盖理论证明与实验验证。理论层面,作者提出"故障类别涂抹"问题,证明ABIGX比显著性图和IG更能缓解该问题;同时证明CP和RBC是ABIGX在线性PCA检测器下的特例,实现经典方法与现代框架的统一。实验层面,在TEP化工过程、晶圆图及MVTec-AD工业图像上,ABIGX对PCA、AE、MLP、CNN、ViT等模型均展现出更优的解释准确性与一致性,验证了框架的泛化能力与实用价值。 文章质量很高。本文配套思维导图&论文精华速览,已同步至小红书:(ID:故障诊断与python学习),需要的小伙伴可以自取💡~ 论文链接:通过点击最左下角的阅读原文进行在线阅读及下载。 论文基本信息论文题目: ABIGX: A Unified Framework for eXplainable Fault Detection and Classification论文期刊:IEEE Transactions on Pattern Analysis and Machine IntelligenceDoi:https://doi.org/10.1109/TPΑΜΙ.2026.3689327作者: Yue Zhuo a , Duxin Chen a , Wenwu Yu a , Zhiqiang Ge a , Xiaoyu Jiang b , Jinchuan Qian c , Junhua Zheng c , Zhihuan Song d 论文时间: 2026年1月 机构: a School of Mathematics, Southeast University, Nanjing 210096, Chinab Hangzhou International Innovation Institute, Beihang University, Hangzhou 311115, Chinac School of Automation and Electrical Engineering, Zhejiang University of Science and Technology, Hangzhou 310023, Chinad School of Automation, Guangdong University of Petrochemical Technology, Maoming, 525000, Guangdong, China作者: 虞文武,东南大学首席教授、数学学院院长,入选教育部长江学者、青年长江、国家"万人计划"青年拔尖人才、国家优青,2014-2024连续十一次入选全球高被引科学家。主要从事系统科学与人工智能交叉研究,发表IEEE汇刊文章100余篇,Google和SCI引用超3万次,H指数75。主持科技部"新一代人工智能"重大项目等多项国家级课题,获国家自然科学二等奖1项、省部级一等奖3项;任Complex Engineering Systems主编及多个IEEE汇刊编委。(来源:Research)摘要本文提出了ABIGX,一种用于可解释故障检测与分类的统一框架。ABIGX建立在已有故障诊断方法的基础原理之上,包括贡献图和基于重构的贡献,同时将其适用范围扩展至通用FDC模型,并提升了故障解释效果。ABIGX的核心在于对抗故障重构方法,该方法从对抗攻击的视角重新审视故障重构,引入了一种适用于故障检测与分类任务的新型故障指标。在故障检测方面,我们通过理论证明CP和RBC是ABIGX的线性特例,从而建立了ABIGX与传统故障诊断方法之间的理论联系。对于故障分类,我们解决了故障类别模糊化问题——这是可能掩盖准确解释的固有缺陷。我们证明了ABIGX能够有效缓解该问题,其性能优于现有的基于梯度的解释方法。实验通过定量指标和直观图示对FDC(Fault Detection and Classification,故障检测与分类)的解释效果进行了评估。结果验证了AFR的通用性与准确性,并表明ABIGX在多种FDC模型上提供了更为全面和精确的解释,相较于现有方法具有显著提升。实现代码已公开发布于:https://github.com/qianjc3391/ABIGX。 关键词:特征归因;综合梯度;可解释的人工智能;反事实解释 目录1 引言2 预备知识及相关工作 2.1 FDC 2.2 故障诊断 2.3 基于梯度的XAI方法 2.4 对抗攻击 2.5 可解释FDC的挑战3 故障重建:对抗视角 3.1 对抗故障重建 3.2 故障分类的SPE指标 3.3 AFR算法 3.4 AFR与对抗攻击的对比4 ABIGX:统一框架 4.1 定义 4.2 算法 4.3 讨论5 ABIGX在故障分类中的应用 5.1 故障分类设定 5.2 故障类别涂抹6 ABIGX在故障诊断中的应用 6.1 RBC与ABIGX-OneVar 6.2 CP与ABIGX7 实验 7.1 评估指标与对比方法 7.2 田纳西伊斯曼过程 7.3 晶圆图 7.4 MVTec-AD工业图像 7.5 计算成本 7.6 实现细节8 结论注:小编能力有限,如有翻译不恰之处,请多多指正~ 若想进一步拜读完整版,请下载原论文进行细读。 5 AIBGX在故障分类中的应用本节介绍故障类别模糊化问题——这是故障分类模型中固有的问题,会导致误导性的变量贡献,并使准确识别故障真正原因变得困难。针对该问题,我们对故障分类中变量贡献的正确性进行理论分析。我们表明,显著性图直接受到故障类别模糊化的影响,而IG(Integrated Gradients,积分梯度)提供了一定程度的缓解。然而,我们的分析证明ABIGX对该问题的缓解效果最佳,能够提供最准确的解释。这些发现为ABIGX在故障分类模型上的卓越可解释性奠定了坚实的理论基础。 5.1 故障分类设定 首先,我们构建一个故障分类数据集和模型的玩具示例。不失一般性,假设不同故障类型发生在不同变量上:示例 1(玩具故障分类数据集)。假设所有正常变量独立同分布地采样自高斯分布 ,所有故障具有相同的幅度f,并且受损变量服从分布 。为简单起见,我们假设故障类型y在方向 上有一个受损变量。那么具有M个变量和N种故障类型的故障分类数据集定义为 (N<M):其次,我们为该玩具示例构建线性分类模型,以实现所有类别的最佳分离: 定义6.(线性分类器)设 为线性分类器的权重,其行向量 ( 对应于各故障(或正常)类别的线性决策边界。基于Fisher线性判别分析[35],最优行向量通过最大化类间均值距离并最小化类内方差进行训练: 其中 为故障类别y的均值向量, 为类别均值的均值, 为各类协方差之和。 基于示例1中的数据集和定义6中的线性分类器,我们可以证明最优模型权重:定理2. 设 为故障类别y中变量i的最优模型权重。对于正常类别y = 0,最优 为:对于故障类别y,最优 为:证明. 证明详见附录A.1.1。 5.2 故障类别涂抹 在可解释人工智能领域中,XFDC(eXplainable Fault Detection and Classification,可解释故障检测与分类)旨在帮助人们理解导致故障的潜在因素。给定一个故障样本,XFDC指示各变量对监测结果(检测分数或分类置信度)的贡献程度。贡献度较高的变量被视为异常的潜在根本原因(如故障传感器)。通过识别这些变量贡献,XFDC能够辅助用户解释模型预测的故障,并主动修复存在缺陷的部件。5.2.1 模型权重 本节正式介绍故障类别模糊化问题——这是故障分类模型中固有的挑战,并分析其对基于梯度的解释方法的影响。故障类别模糊化产生于分类器的优化目标导致无关变量上出现非零权重,进而扭曲显著性图和IG(Integrated Gradients,积分梯度)等解释器的归因分数。定义 7.(模型权重中的故障类涂抹)给定故障类型为y的受释故障样本x(如示例 1 中所定义),以及具有最优权重 的故障分类器,变量贡献在模型权重中被涂抹到其他不相关的变量上:其中 。这些在不相关的故障变量上的非零权重会导致基于梯度的解释器高估它们的贡献,从而产生误导性的归因。为了定量评估故障类涂抹的程度,我们定义了故障类涂抹 (FCS) 指标,该指标测量了错误分配给不相关变量的总归因比例:直观地说,故障类涂抹的发生是因为分类器不仅必须将故障样本与正常样本区分开来,还必须区分不同的故障类型。这导致了跨多个类的共享权重,其中与其他故障类型相关联的变量仍然获得非零权重(例如, ),尽管它们与当前的故障类y无关。另一方面,不对应任何故障类的变量(即,如公式5所示的其余M-N个变量)通常具有零权重,并且不会引发涂抹。这种现象对模型解释来说是个问题:当解释方法直接依赖于模型梯度或权重(例如,显著图或IG)时,变量贡献可能反映的是类可分性偏差,而不是与故障相关的根本变量。在接下来的小节中,我们将从理论上分析这种涂抹如何影响不同的解释方法,以及ABIGX如何减轻它。5.2.2 显著图 显著图简单地计算模型输出关于输入变量的梯度的绝对值。线性模型的梯度就是它的权重,因此显著图贡献直接受到了故障类涂抹问题的影响。定理 3.(显著图中的故障类涂抹)给定所解释的故障类型y及其真实变量 y,显著图的贡献被涂抹到其他不相关的变量上:显著图中 FCS 的程度为:5.2.3 IG 这些在不相关变量上的涂抹权重在故障分类模型中是不可避免的。一个好的解释方法应该有效地减轻涂抹权重对变量贡献的影响。接下来,我们讨论IG方法中的故障类涂抹。定理 4.(IG中的故障类涂抹)给定所解释的故障类型y及其真实变量y,以及正常样本期望的基线 ,IG贡献的期望为:IG中故障类涂抹 (FCS) 的程度为: 证明. 证明详见附录 A.1.2。 5.2.4 ABIGX 随后,我们分析了ABIGX中的故障类涂抹,表明ABIGX以更低的FCS程度优于IG。定理 5.(ABIGX 中的故障类涂抹)ABIGX中的故障类涂抹程度低于IG: 证明. 证明详见附录 A.1.3。 5.2.5 与故障涂抹的比较 先前在CP和RBC研究中讨论的故障涂抹 [7], [36] 是由所有输入共享的相同权重引起的,因为检测模型只输出一个标量(例如,SPE故障指数)。尽管每个故障类的模型权重都是唯一的,但我们表明分类器仍然会对不相关的变量分配权重(由于区分不同故障类型的任务)。这些非零的不相关权重涂抹了变量的贡献。总而言之,故障类涂抹论证了故障分类中故障涂抹问题的现象和原因。6 预备知识及相关工作本节介绍了ABIGX如何统一地重新构架两种基本的故障诊断方法CP和RBC。对于基于PCA的故障检测,我们指出CP和RBC都是ABIGX的特例。图 5 直观地展示了通过两个特定的经AFR重构的样本 和 ,CP和RBC与ABIGX的等价性。在下文中,基于 PCA 的检测器用其残差子空间投影矩阵表示: 6.1 RBC与ABIGX-OneVar第4节讨论了ABIGX源于RBC的思想。此外,我们证明了RBC是具有AFR-OneVar的ABIGX的线性特例。引理 1. (故障重构性质) 使得 最小化的故障重构中的 值为: 定理 6. (RBC与ABIGX的等价性)RBC等价于使用单变量AFR的ABIGX (即ABIGX-OneVar): 证明. 证明过程见附录A.2.1。 6.2 故障诊断CP与ABIGX故障检测模型的解释——通常称为故障诊断——已得到广泛研究[7]、[6]、[9]、[23]。一旦检测到故障,故障诊断旨在通过量化各输入变量对故障指标(如SPE)的贡献程度,识别其根源变量。下文简要回顾三种常用于基于 PCA 模型的经典故障诊断方法。 我们证明CP也是ABIGX在 范数AFR下的线性特例。首先,我们计算PCA在 范数距离约束下的AFR重构样本:引理2.(PCA的AFR)在 范数距离约束下,基于PCA的故障检测的AFR重构样本 为: 这意味着重构向量恰好是残差子空间投影。 证明.证明见附录A.2.2。 随后,我们可以证明CP与ABIGX的等同性。定理7.(CP与ABIGX的等同性)CP与 范数AFR下的ABIGX等同: 证明. 根据引理2中的 ,ABIGX为(省略 的下标):由式(35),我们有 ,因此得到ABIGX贡献: 这与 等同。此外,受引理2的启发,我们讨论了基于梯度的攻击的可行性,这也是AFR和ABIGX的默认算法:注 1. (针对PCA的基于梯度的攻击) 基于梯度的攻击总是沿着残差子空间投影的方向重构故障。证明. PGD每一步的对抗扰动为: 其中L是一个标量。 这与直觉一致,因为残差投影指向SPE下降最快的方向。7 实验 7.1 评估指标与对比方法我们引入两类定量指标,用于对解释方法进行公平评估:正确性[37]衡量变量贡献与根源变量之间的差异。更优的解释应更接近真实值。具体而言,Correctness-AUC将贡献视为二分类预测分数,通过改变贡献分数的负类阈值,计算受试者工作特征曲线下的面积[38]。正确性也可通过累加真实值上的归因分数来度量,称为Correctness-SUM。一致性[39]检验贡献是否聚焦于模型真正关注的区域。更优的解释方法应与模型行为具有更高的一致性。Consistency-ADD指标逐步将解释故障样本的变量值添加至正常样本。通过滑动贡献阈值,贡献最大的变量首先被添加,贡献最小的最后被添加。更优的解释方法应使模型预测分数上升更快,这可通过阈值相关的预测分数曲线下面积进行量化。相反,Consistency-DEL首先删除最重要的变量,直至所有特征均被正常样本替换。类似地,更优的方法应使模型预测分数下降更快,这可通过阈值相关的AUC进行度量。对于基线方法,我们引入了几种先进的基于梯度的XAI方法,包括:• 显著性图:输入变量梯度的绝对值,最常用的特征归因方法。• DeepLift[40]:一种梯度反向传播解释方法,能够妥善处理IG(Integrated Gradients,积分梯度)可能产生误导结果的情形。• 原始IG[16]:提出的原始IG方法,使用全零向量作为基线。• 期望IG[41]:IG的一种变体,使用来自数据分布的信息性基线(即本实验中的正常样本),通过对IG归因求期望来缓解基线选择的影响。• 重要方向梯度积分[42]:IG的一种变体,仅直接关注与梯度对齐的重要方向,在本实验中基于原始IG构建。• 引导IG[43]:IG的一种变体,基于梯度构建积分路径,使用全零向量作为基线。• AFR+ 引导IG:我们使用AFR重构样本作为基线,但将ABIGX的默认直线路径积分替换为引导IG的路径构建算法,作为消融设置以验证ABIGX中AFR基线的有效性。为确保公平比较,我们将所有基于IG的方法(原始IG、期望IG、引导IG和IDGI)的主要超参数——步长,设置为与ABIGX相同。所有实验在INTEL CORE i7-12700K CPU上运行TEP数据集的PCA、AE和MLP模型,在单块NVIDIA GeForce RTX 3080 GPU上运行Wafermap数据集的CNN模型和MVTec-AD数据集的ViT模型。7.2 田纳西伊斯曼过程7.2.1 数据集描述为使TEP设置自成体系,并阐明各故障的物理含义,我们在附录中提供了TE过程流程图及文献[18]中的官方变量和故障描述(图B.1、表B.1)。这些材料明确了故障注入位置(物流、单元)、涉及的执行器和传感器,以及预期的一阶响应,对于解释诊断性能和特征级归因至关重要。我们的解释正确性指标依赖于为每种故障精心筛选的根源变量 集 合,该集 合源自经典TE过程文献并汇总于附录表B.2。除列出变量索引外,该表还提供了逐故障的推理依据,基于(i)注入位置、(ii)最直接受影响的测量变量和执行器、以及(iii)过程结构和控制回路,将各故障与其根源变量相关联。我们在报告基于根源变量的正确性分数时,将其作为真实值参考。这一故障-变量关联亦与代表性TEP诊断工作[9]、[44]、[45]中采用的故障语义相一致,从而使我们的故障-变量映射成为与文献对齐的、透明的经典TEP故障定义表征,用于解释评估。 图6 为NN分类器对TEP故障6的解释对比,图中实根变量为红色。故障6由根变量XMEAS ( 1 )和XMV ( 3 )引起,故障14由XMEAS ( 9 ),XMV ( 10 )和XMEAS ( 21 )引起,详见表B.2 为清晰起见,图6直观展示了两种TEP故障类型(故障6和故障14)的解释对比。该图分别展示了故障检测和分类模型的传感器变量贡献,其中每个图的四个子图展示了四种不同技术解释的变量贡献。对于TEP数据集,我们采用了文献[46]中的绘图风格。水平轴表示变量贡献值(含方向)。变量按重要性在垂直轴上排序,其中展示了贡献最大的四个变量。值得注意的是,图中还通过彩色分布展示了变量(特征)值与其贡献之间的相关性。7.2.2 可解释故障检测 故障诊断与ABIGX的等价性:第6节从理论上证明了两种故障诊断方法与ABIGX之间的等价性。在TEP故障的PCA检测器上,我们计算了它们之间的经验误差,即所有变量贡献的均值。表2报告了结果,表明差异足够小(尤其在使用MILP求解AFR重构样本时)。解释结果:首先,图6a绘制了TEP数据集上AE模型不同解释方法的直观对比,表明ABIGX将最高贡献分配给了根源变量。同时,其他方法未能提供完整的解释。表3报告了TEP上AE检测解释的四项评估指标,涉及14种故障类型。总体而言,ABIGX方法优于其他解释方法,包括故障诊断方法(CP和LLBBC [47])以及基于IG的深度学习解释器(DeepLift不适用于故障检测)。通过比较期望IG与原始IG和IDGI,可以发现全零基线对故障检测解释产生了不利影响。ABIGX-OneVar提供了最接近真实值根源变量的解释。独立归因变量的显著性图在正确性指标上也表现良好。另一方面,ABIGX提供了最匹配模型行为的解释。我们认为,考虑变量交互的解释更接近模型实际处理样本的方式。基于消融研究(AFR+引导IG),在TEP数据集上使用AFR重构基线结合引导IG的自适应路径,相较于原始引导IG均有持续提升,同时相对于ABIGX具有竞争力的性能表现。7.2.3 可解释故障分类 与故障检测类似,图6b绘制了基于NN的TEP故障6分类器解释。ABIGX的优势体现在变量XMV(3)上。ABIGX为该变量分配了更高的贡献,而显著性图甚至忽略了该变量,其原因已在第4.3.2节中分析。表4报告了故障分类的解释指标,各方法性能与检测任务类似。ABIGX总体上仍表现更优,即使在正确性指标上(AUC除外)。ABIGX-OneVar仍然强调正确性,但模型一致性较差,这与显著性图类似。DeepLift与原始IG性能相近。尽管IDGI和引导IG相较于原始IG方法表现出性能提升,但由于其基线缺乏信息量,即使在期望IG设置下,在故障分类任务中仍不具竞争力。分类SPE指标的验证:通过ABIGX-AdvAFR进行消融研究。与第3.2节提出的ABIGX分类SPE不同,ABIGX-AdvAFR采用原始对抗攻击目标(即最小化正常类别的Softmax输出置信度)进行故障重构。ABIGX总体上优于ABIGX-AdvAFR,验证了本文提出的新型分类SPE指标在故障重构中的有效性。 7.2.4 故障级解释为清晰展示TEP数据集上的归因对比,附录图B.2和B.3以及表B.4和B.3呈现了故障检测和分类模型在所有TEP故障类型上的详细实验结果。这些图可视化了ABIGX在数据分布中对排名靠前变量的归因,而表格则通过报告故障级别的根源变量排名来比较各方法的归因性能。具体而言,根源变量出现在归因前三位中的比例及其平均排名表明,ABIGX在大多数故障类型上与真实值故障变量的一致性最高。为探究模型精度与ABIGX解释质量之间的相关性,图B.4详细分析了ABIGX在所有TEP故障类型上的归因性能,并按不同FDC模型的正确预测和错误预测样本分别展示。结果凸显了两个关键发现:(1)预测精度较高的故障类型往往表现出更准确的ABIGX归因;(2)在每个故障类型内部,正确预测样本的归因正确性通常高于误分类样本。这些发现表明,ABIGX解释与模型置信度密切相关——当模型成功检测故障时,其能够忠实地归因有意义的贡献;而当模型失效时,则揭示出归因的不确定性。 7.3 晶圆图 7.3.1 数据级描述晶圆图分析在半导体日常制造运营中至关重要。晶圆图提供了视觉细节,对于识别晶圆故障模式发生的制造阶段具有关键作用。我们研究了晶圆图故障模式分类的解释,其目标是确定晶圆图中哪些像素是故障根源。我们在WM-811K数据集[48]上训练了一个基于CNN(Convolutional Neural Network,卷积神经网络)的故障分类器,选取了四种故障类型(中心型、边缘局部型、边缘环型和划痕型)。故障和正常晶圆图如图7所示,其中真实值根源像素由红色圆圈标注。绿色像素表示正常芯片,黄色像素表示缺陷芯片。当不存在特定缺陷芯片模式时,晶圆图为正常(如图7左上角所示)。 图7 CNN分类器对四种具有不同故障模式的采样晶圆图的解释,其中真实根像素以红色为圆心7.3.2 可解释故障分类图7和表5中呈现的实验结果提供了多种解释方法在用于识别晶圆图故障模式的CNN分类器上的对比分析。ABIGX在所有故障类型中均表现出高度聚焦且清晰的解释效果,与标注的真实值区域高度吻合。这种清晰性表明ABIGX能够有效识别与模型分类决策最相关的区域。其他方法如显著性图、原始IG和IDGI则产生更为分散且聚焦性较差的解释。可以发现,原始IG和IDGI中使用的黑色基线导致了较差的解释效果。DeepLift和期望IG表现中等,其解释清晰度优于显著性图和原始IG,但缺乏ABIGX所具有的精确性。 表5 解释方法的评价指标(在晶圆图CNN分类器上) 表5量化了各方法在四项关键指标上的性能。ABIGX在正确性(AUC(Area Under Curve,曲线下面积):0.839)和一致性(ADD:0.859,DEL:0.040)上均取得了最高分数,表明其在准确识别关键区域的同时,生成的解释具有高度一致性。相比之下,显著性图和原始IG总体表现最低。DeepLift和期望IG在正确性方面表现良好,但在一致性上逊于ABIGX。引导IG(Guided IG,引导积分梯度)在正确性和一致性之间取得了平衡,其分数具有竞争力但未能超越ABIGX。使用AFR(Adversarial Fault Reconstruction,对抗故障重构)重构基线结合引导IG的自适应路径(AFR+引导IG)始终优于原始引导IG,且与ABIGX具有竞争力,证实了AFR基线改进在不同路径选择下均持续有效。晶圆图故障解释实验验证了ABIGX的泛化能力,其不仅适用于表格型传感器数据,还适用于CNN模型训练的图像等非结构化数据。 7.3.3 ABIGX详细解释 附录图B.5展示了ABIGX在七种故障类型更多晶圆图上的解释结果。每行展示每类故障的四个代表性样本,左侧为原始晶圆图,右侧为ABIGX归因热图。每对图像上方的Consistency-ADD(一致性-添加)分数量化了跨样本解释的一致性。ABIGX对于具有明确空间模式的故障(如"中心型"、"边缘环型"和"随机型")实现了高一致性,表明其在突出与视觉故障特征对齐的模型相关区域方面的有效性。然而,ABIGX在处理更复杂或模糊的故障时表现出局限性。例如,"近满型"始终产生较低的Consistency-ADD分数(0.375),表明模型仅当晶圆大部分区域受影响时才能对该故障类型进行高置信度预测。"划痕型"、"局部型"和"边缘局部型"等故障类型也表现出不一致的解释质量,凸显了ABIGX在处理混合或不规则模式方面的挑战。这些观察指出了未来改进的必要性,以提高实际质量检测任务中的鲁棒性和泛化能力。7.4 MVTec-AD工业图像 7.4.1 数据集描述MVTec-AD(MVTec Anomaly Detection,MVTec异常检测)数据集[49]是工业视觉检测中异常检测的广泛使用的基准数据集。该数据集包含15类物体和纹理类别的高分辨率图像,每类均含有正常样本和缺陷样本,缺陷类型涵盖划痕、凹痕和颜色偏差等多种表面异常。与传统故障检测中使用的表格型数据集(如TEP)不同,MVTec-AD专注于细粒度空间缺陷,使其适用于评估基于视觉的异常检测模型。其多样化的缺陷类型和真实的成像条件为可解释性带来了独特挑战,为评估ABIGX的泛化能力提供了有价值的测试平台。 7.4.2 模型描述在我们的工作中,我们采用WinClip [33]作为代表性的基于ViT的异常检测器,以评估ABIGX的泛化能力。WinClip是一种最先进的视觉Transformer模型,专为工业图像中的零样本异常检测而设计。通过利用CLIP [50]嵌入和多模态对齐,其在MVTec-AD数据集的多样化类别上取得了优异性能。我们使用预训练的ViT骨干网络,并对WinClip实现进行少量修改以确保可微性,从而实现与基于梯度的解释方法的兼容性。该实验设置展示了ABIGX对更复杂、大规模和现代基于Transformer模型的适用性。 7.4.3 可解释异常检测图8比较了不同方法在来自五个类别(地毯、木材、皮革、瓷砖和网格)的输入工业图像上的ViT归因图。与其他基线方法相比,ABIGX提供了显著更聚焦且更准确的归因,其一致性地突出了真实异常区域(如红色圆圈所示),同时抑制了无关噪声。相比之下,注意力图和原始IG等替代方法表现出分散或定位性较差的归因,往往延伸至真实值故障区域之外。 图8 WinClip异常检测器在MVTec - AD数据集的5个样本上的解释结果。在红色(放大以查看小区域内更精细的细节)中圈出了真值异常区定量而言,表5验证了ABIGX的优越解释性能。在正确性方面,ABIGX取得了最高的AUC和SUM(总和),表明其显著性区域与其他方法相比与实际故障区域的对齐程度更高。值得注意的是,这证明了ABIGX的归因图不仅具有视觉可解释性,而且在定量意义上也具有意义。相较于期望IG和显著性图的性能提升,进一步验证了ABIGX自适应基线策略的优势,尤其在传统IG方法难以处理任意基线的复杂高维图像域中。在一致性方面,ABIGX在各项评估指标上表现出强鲁棒性。值得注意的是,WinClip的预测对微小扰动高度敏感,仅添加少量像素即可显著增加异常分数,导致所有方法的ADD(一致性-添加)分数均较高。然而,ABIGX取得了相对较低的DEL(一致性-删除)分数,表明其识别的高排名特征对模型预测至关重要。总体而言,该实验证实了ABIGX与WinClip等大规模基于Transformer的模型兼容,并在工业图像的多样化异常类型上生成忠实且简洁的解释。ABIGX对不同模态和模型架构的泛化能力进一步巩固了其作为广泛适用且统一的表格型和视觉FDC任务可解释性框架的价值。7.4.4 ABIGX详细解释 附录图B.6展示了ABIGX在更多具有细微且视觉上不明显缺陷的MVTec-AD故障样本上的解释。这些具有挑战性的案例对于评估解释方法的必要性具有重要意义。对于FDC模型赋予高故障置信度的样本,ABIGX突出了与真实缺陷区域高度吻合的局部区域,表明模型正关注于语义相关的特征。相反,对于故障置信度较低的样本,ABIGX产生较弱或错位的归因,反映了模型的不确定性或未能识别异常。该分析表明:(1)对于难以观测的缺陷,解释对于验证模型是否基于有意义的证据做出决策至关重要;(2)解释作为诊断工具,有助于验证正确决策并解释失效案例,以进行进一步的模型诊断。 7.5 计算成本 尽管FDC领域的研究兴趣日益增长,但为基于深度神经网络的FDC模型生成准确且具备理论基础的解释仍然是一项关键挑战。虽然传统的故障诊断方法和深度学习解释器均已得到应用,但仍存在若干局限性:附录表B.15展示了每样本的平均解释时间。尽管计算开销有所增加,ABIGX仍保持实际可用的高效性:轻量级模型(如PCA、AE、MLP和小型CNN)的平均运行时间约为1至2秒,即使对于ViT(Vision Transformers,视觉Transformer)等更复杂的架构,也能保持在数十秒以内。传统方法如CP(Contribution Plot,贡献图)和RBC(Reconstruction-Based Contribution,基于重构的贡献)计算开销极低,对于PCA模型解释时间近乎为零。这种高效性源于其不依赖迭代优化或梯度计算。然而,这一速度是以非线性场景下的泛化能力和可解释性为代价的。ABIGX的主要计算成本来自梯度计算,这对于AFR(Adversarial Fault Reconstruction,对抗故障重构)过程和IG(Integrated Gradients,积分梯度)计算均不可或缺。因此,总运行时间主要取决于模型的正向和反向传播次数,由AFR和IG中使用的步长参数决定。实践中,我们通常将AFR的步数设置为与IG相等,这使得ABIGX所需的梯度评估次数约为标准IG方法的两倍,约为简单基于梯度方法的2×步数倍。在实践中,ABIGX可通过小批量(mini-batching)大幅加速,即在GPU显存限制下的批量大小(如我们设置中ViT为8)内,对多个样本并行执行AFR基线搜索和IG积分。7.6 实现细节 我们在附录中总结了模型架构和关键ABIGX超参数,以确保可复现性。具体而言,表B.5和B.14报告了实验中训练的网络结构;表B.6列出了所有四种被解释模型的主要ABIGX超参数。7.6.1 步长、步数与收敛性 为避免AFR基线欠优化影响归因结果,我们在所有具有合理运行时间的实验中采用保守的(较大的)迭代预算,以确保优化不足不会混淆归因质量。四种被解释模型的步长和步数敏感性分析详见附录表B.7至B.10。为诊断AFR基线搜索过程中的收敛性,我们监测迭代过程中的表征SPE值和模型预测置信度。具体而言,当SPE曲线达到平台期时(即连续迭代中SPE的相对下降变得可忽略不计),我们将该运行标记为已收敛。根据表B.16中的聚合收敛率,在默认步长和步数下,大多数样本表现出急剧的SPE下降后趋于饱和,表明跨模型的收敛行为稳定。我们还跟踪搜索过程中的模型正常性(图B.9),其通常与基于SPE的收敛诊断一致地趋于稳定。仅有少量运行仍陷入局部最优(未达到足够高的正常性置信度)或达到最大迭代预算上限。7.6.2 故障分类器表示层 在本文的故障分类设置中,ABIGX需要选择内部表征h(x)以定义分类SPE并驱动AFR基线搜索。我们选择倒数第二层作为默认表征,因其提供了稳定且语义有意义的特征空间,同时避免了最终对数几率层可能出现的饱和和标签特定坍缩。我们通过在TEP和晶圆图分类器上的敏感性研究验证了这一选择:在候选层中,倒数第二层表征始终产生最佳或接近最佳的解释正确性和一致性(附录图B.7和表B.13)。因此,除非另有说明,所有分类器实验均采用倒数第二层作为表征。7.6.3 失效案例 我们观察到ABIGX的两种反复出现的失效模式。第一种情况是AFR基线优化失败(最终基线的正常性较低)。在某些样本中,基于PGD的AFR搜索虽然降低了表征空间距离,但仍收敛至正常性置信度相对较低的基线,表明优化陷入了较差的局部最优。当最终基线仍非正常时,所得IG路径不再代表有意义的"故障到正常"过渡,归因正确性(如GT-AUC)随之下降(图B.8)。作为实际保障措施,在这些情况下我们可以回退至期望IG,即从输入空间正常样本池中抽取基线,而非依赖搜索得到的AFR基线,从而提高鲁棒性。第二种情况是低置信度模型预测(本质上模糊的样本)。这类失效源于模型本身对被解释样本赋予较低的故障置信度。在此情况下,归因可能与人工标注的真实值对齐不佳,但这并非因为解释器不正确,而是因为底层决策本身不确定(图B.6)。这种行为是符合预期的:ABIGX旨在解释模型的决策机制,当模型置信度较低(或接近决策边界)时,任何忠实的解释都将反映这种模糊性,而非强制与外部标注对齐。8 结论本文提出了一种统一框架ABIGX,用于解释通用FDC模型。ABIGX源于CP和RBC的核心要素,这两种方法在PCA模型故障诊断中已取得显著成功。本文提出的新型故障重构方法AFR是ABIGX的核心组成部分。AFR从对抗攻击的视角重新构建现有方法,并通过新型分类SPE指标将FR推广至故障分类任务。对于可解释故障分类,我们从故障类别模糊化的角度分析了各方法的性能。与显著性图和IG相比,我们证明了ABIGX能够以更低的故障类别模糊化程度提供更准确的变量贡献。对于可解释故障检测,我们从理论上证明了线性CP和RBC与ABIGX的等价性。通过定量指标,在广泛模型和数据集上的实验验证了ABIGX在故障诊断和深度学习解释两个领域中相较于其他先进解释器的总体优越性。 编辑:Leo校核:李正平、陈凯歌、曹希铭、赵学功、白亮、任超、海洋、陈宇航、Kira、Tina、王金、赵诚、肖鑫鑫、张优该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除来源:故障诊断与python学习

未登录
还没有评论
课程
培训
服务
行家
VIP会员 学习计划 福利任务
下载APP
联系我们
帮助与反馈