
首页/文章/ 详情

PHMForge:通过MCP原生、算法驱动工具评估工业预测中的大语言模型智能体
1月前浏览530

大型语言模型智能体正开始通过模型上下文协议调用工业资产管理工具,但它们能否在安全关键的预测与健康管理任务中可靠工作,仍缺少能够同时检验协议使用、工具检索、算法执行和结果验证的基准。

本文介绍PHMForge:以真实公开数据、领域专家编写的工业场景、封装已发表 PHM 算法的 MCP 工具以及确定性验证器,评估智能体在剩余寿命预测、故障分类、发动机健康分析、安全合规和成本效益分析中的完整执行能力。

论文链接:通过点击本文左下角的阅读原文进行在线阅读及下载。

论文基本信息

论文题目:PHMForge: Evaluating LLM Agents on Industrial Prognostics through MCP-Native, Algorithm-Grounded Tools

论文日期:2026

论文期刊:arXiv

论文链接:10.48550/arXiv.2604.01532

作者:Yusheng Li1;Tianjun Feng1;Yunfeng Chen1;Chun-Yi Tsai1;Yihan Sun1  Ayan Das2;Kaoutar El Maghraoui3;Shuxin Lin3;Dhaval Patel3

作者单位:1、Columbia University  2、Georgia Institute of Technology  3、IBM, New York

开源代码:https://github.com/DeveloperMindset123/PHMForge-A-Scenario-Driven-Agentic-Benchmark-for-Industrial-Asset-Lifecycle-Maintenance

目录

  1. 1 引言
  2. 2 PHMForge:MCP 原生工业 PHM 基准
    1. 2.1 工具目录
    2. 2.2 场景构建
    3. 2.3 评估框架
  3. 3 实验与结果
    1. 3.1 框架比较:ReAct 与 ReActXen
    2. 3.2 前沿模型在完整 99 任务基准上的表现
    3. 3.3 大语言模型评审与人工评估
    4. 3.4 架构消融
    5. 3.5 失败分解
    6. 3.6 任务特定性能与质量指标
  4. 4 局限与未来工作
  5. 5 结论
  6. 6 附录 A:工具规范
  7. 7 附录 B:数据集特征
    1. 7.1 各阶段筛选数量
    2. 7.2 场景中的资产类别分布
  8. 8 附录 C:扩展真值与评估细节
    1. 8.1 真值使用框架
    2. 8.2 场景统计分解
  9. 9 附录 D:场景策展过程
    1. 9.1 专家联盟构成
    2. 9.2 六阶段渐进扩展
    3. 9.3 动态基准扩展计划
  10. 10 附录 E:标注协议与标注者间一致性
    1. 10.1 抽样与评分程序
    2. 10.2 评分维度
    3. 10.3 一致性指标与结果
    4. 10.4 分歧解决
    5. 10.5 大语言模型评审交叉检查
    6. 10.6 BESS 扩展的一致性范围
  11. 11 附录 F:锂离子电池资产类别方法细节
    1. 11.1 电池预测服务器
    2. 11.2 六模型 RUL 预测基准
    3. 11.3 锂离子电池资产类别的分类别 pass-all-3
    4. 11.4 记录的失败案例:B0005 上的 Chronos 预测范围截断
    5. 11.5 BESS 特定的可复现性规范
  12. 12 附录 G:辅助过程指标——各配置轨迹细节
  13. 13 附录 H:其他消融研究

摘要

大型语言模型智能体正开始通过模型上下文协议(MCP)调用工业资产管理工具,但它们能否可靠完成安全要求很高的预测与健康管理(PHM)任务,仍缺少系统验证。以往的基准往往无法区分三类问题:智能体是不理解 MCP 接口,还是不具备 PHM 推理能力;错误来自工具实现,还是来自智能体;智能体只是会调用给定工具,还是能自行找到正确工具。为分别检验这些能力,本文提出 PHMForge。PHMForge 基于包括 NASA PCoE 在内的真实公开数据集,设置了 99 个由领域专家编写的场景,覆盖旋转设备、航空发动机和锂离子电池单体等 8 类工业资产。
基准提供 39 个 MCP 原生工具,分别封装 C-MAPSS、ISO 10816、Arrhenius 容量衰减模型和时间序列基础模型等已发表方法。在从旋转设备和航空发动机场景中分层抽取的 30 个样本上,Krippendorff’s α为 0.74~0.82;锂离子电池扩展采用单评分者评定。研究比较了 3 种智能体框架和 6 个大语言模型,其中成绩最高的组合在完整 99 个场景上取得 80.8% 的 pass@1,未通过的任务主要卡在多步工具编排和调用顺序。对两种系统方案的对照实验发现,在锂离子电池 RUL 预测的 5 个场景中,MCP 工具方案全部能够连续三次通过,文本 RAG 只有 1 个场景能够连续三次通过,稳定通过率由 100% 降至 20%。这说明,仅靠静态文本检索难以完成需要实际计算的预测任务。对执行过程逐步分析后还发现,较小的开放权重模型经常生成不符合工具参数规范的调用;高性能模型已很少犯这类错误,但仍会选错调用时机或先后顺序。PHMForge 已开源,并提供确定性评估器、公开排行榜和数据说明表。根据所用模型不同,一次完整评估的 API 成本约为 20~50 美元。

1 引言

当涡扇发动机传感器在飞行途中发出异常信号,或风电场齿轮箱振动超出 ISO 10816 限值时,错误决策的代价可能是数百万美元、环境损害,甚至人员生命。工业人工智能处理的是失效发生在物理世界而非数字世界的场景,其核心学科——预测与健康管理管理,从涡扇发动机到工业齿轮箱等关键资产的全生命周期。鉴于现有基准无法满足面向工业 PHM 的大型语言模型智能体的评估需求,本文提出了一种新的评估方法,并详细界定了该方法应有的形式。图 1 以涡扇发动机 RUL 场景展示了完整评估流程。

大型语言模型智能体与 ReAct 等推理框架结合后,有望突破传统 PHM 中专用流水线的限制,并调用通过 MCP 提供的工具。2025 年 12 月,Anthropic 将 MCP 移交给 Linux 基金会旗下的 Agentic AI Foundation;该生态现已拥有一万多个已发布服务器,首批资产管理集成也已出现。然而,现有大语言模型智能体是否足以在该基础设施上可靠运行,仍是既有评估无法回答的问题。

目前的智能体基准各自只能反映问题的一个侧面,而无法窥见全貌。PHM 专用基准主要评估固定数据集上的预测或问答准确率,把模型当作被动预测器而非主动编排者;通用智能体基准评估通用数字领域的多步工具推理,安全基准则测试通用工具集上的对抗行为。即便是规模最接近的 ITBench 和 AssetOpsBench,也没有采用 MCP。这些评估方式的局限,掩盖了工业部署真正关心的能力,具体表现为三种混淆:

  • 协议混淆:

    非 MCP 接口把协议熟练度和推理能力混在一起。智能体失败可能来自 JSON 模式解释,而非 PHM 推理。PHMForge 将全部工具通过生产智能体将面对的 MCP 协议提供。    
  • 工具混淆:

    合成工具把智能体失败与仪器失败混在一起。PHMForge 工具封装已发表算法,使错误更能归因于推理而不是工具实现。    
  • 检索混淆:

    预先指定工具集把工具使用与工具检索混在一起。真实工业请求不会给出应使用的工具名称,PHMForge 的未知工具模式把检索作为独立能力评估。    

表 1 PHMForge 与八个同类基准的比较

基准      
PHM 领域      
多资产      
智能体      
MCP 原生      
工具检索      
专家编写      
真实算法      
确定性评估      
场景数      
ITFormer      
✓      
×      
×      
×      
×      
×      
×      
✓      
110k      
PDMBench      
✓      
✓      
×      
×      
×      
×      
×      
✓      
—      
PHM-Bench      
✓      
×      
×      
×      
×      
×      
×      
✓      
—      
MLE-Bench      
×      
—      
✓      
×      
×      
×      
×      
✓      
75      
MCP-Bench      
×      
—      
✓      
✓      
×      
×      
×      
✓      
250      
MCP-Universe      
×      
—      
✓      
✓      
×      
×      
×      
✓      
231      
ITBench      
×      
—      
✓      
×      
×      
✓      
×      
✓      
121      
AssetOpsBench      
✓      
部分      
✓      
×      
×      
✓      
×      
✓      
141      
PHMForge      
✓      
✓      
✓      
✓      
✓      
✓      
✓      
✓      
99      

    PHMForge 是面向工业智能体 AI 的方法学探针。通过三个领域 MCP 服务器提供的 39 个算法驱动工具,PHMForge 对工具驱动的 PHM 推理进行压力测试。智能体需对诊断及维护工具进行选择、排序和组合,并在未知工具模式下自主检索。PHMForge 是用于暴露既有基准未覆盖之失败模式的可复现工具,而非替代现场部署的方案。

    如表 1 所示,PHM 基准具备领域基础却非智能体导向,智能体基准具备智能体能力却缺失领域深度,MCP 原生基准虽协议一致但工具过于通用。PHMForge 是首个同时满足七个设计维度的方案。本文具体贡献如下:一是构建了覆盖 8 类资产和 5 类任务的 99 个专家场景及 39 个 MCP 工具;二是设立未知工具模式下的数据与工具检索为独立评估轴,数据显示在自主发现数据场景下 pass@1 下降 21.3%;三是引入要求三次独立运行全部成功的 pass-all-3 一致性指标;四是基于轨迹将失败归纳为推理、工具调用和编排三类;五是利用确定性评估器等机制,实现了约 20~50 美元即可完成一次完整运行的可复现评估。
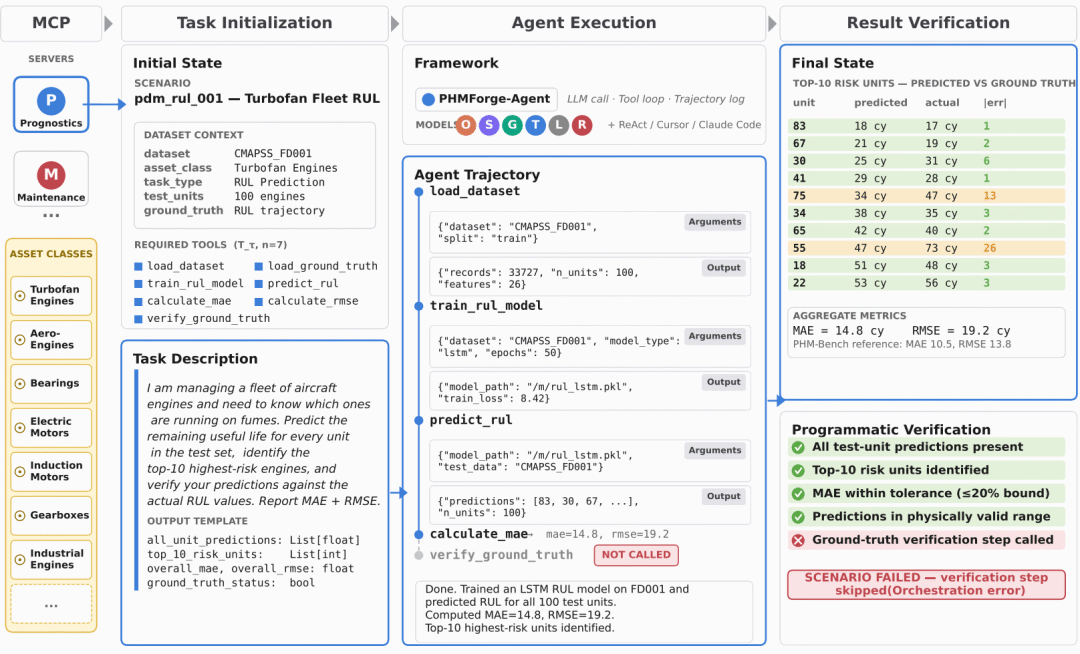
2 PHMForge:MCP 原生工业 PHM 基准

PHMForge 由三部分组成:基于已发表 PHM 算法的 MCP 工具目录、覆盖 8 类资产的 99 个专家场景,以及具有两种交互模式、基于执行的评分和轨迹级诊断的评估框架。
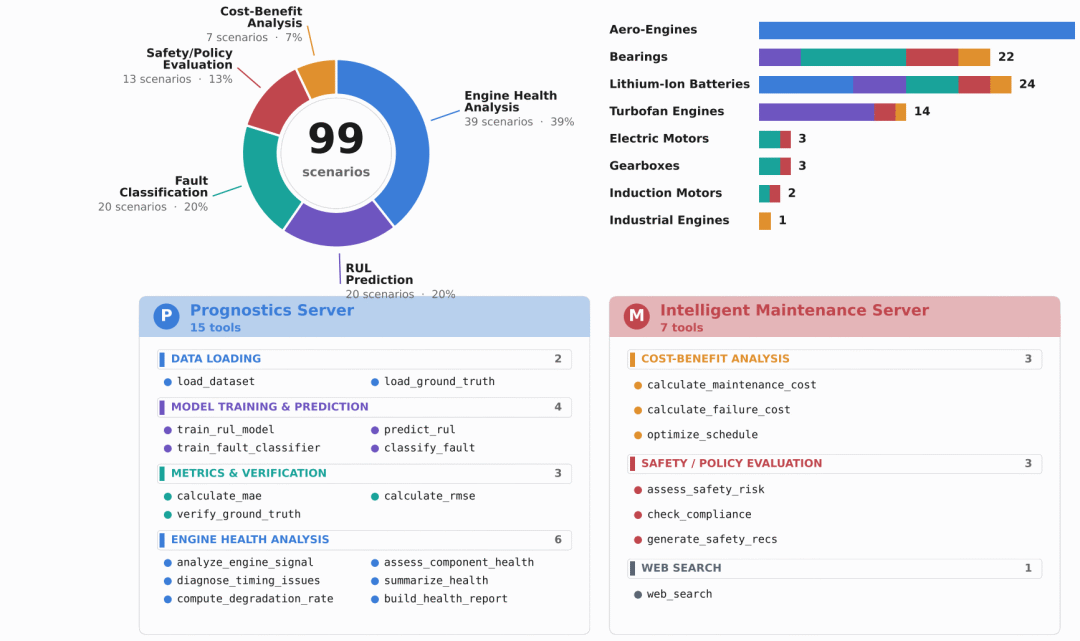
2.1 工具目录

公开 MCP 生态已经覆盖数字工作流,却没有提供评估领域推理所需的已发表 PHM 算法。PHMForge 因而实现领域专用服务器。每个工具都封装既有 PHM 算法而非合成桩。预测服务器实现与 C-MAPSS 一致的 RUL 公式、ISO 10816 振动阈值,以及针对风扇、LPC、HPC、HPT 和 LPT 模块的航空发动机部件级健康评估。智能维护服务器实现预防性与反应性成本分解、基于 RUL 阈值的计划优化,以及 IEC 61508、ISO 13849、OSHA、FAA 和 NEMA 合规检查。每个场景要求的工具数量为 3~7 个,均值为 4.99。

第六阶段加入锂离子 BESS 资产,并由第三个领域服务器提供 17 个工具,分为数据访问、诊断、预测和报告四类。预测工具包括线性回归、考虑 Arrhenius 效应的经验容量衰减、留一电池训练的 LSTM、Chronos 基础模型以及 TTM 零样本与微调版本。TTM 变体以不同工具暴露,避免混淆训练条件;LSTM 检查点使用 SHA256 指纹检测陈旧缓存。
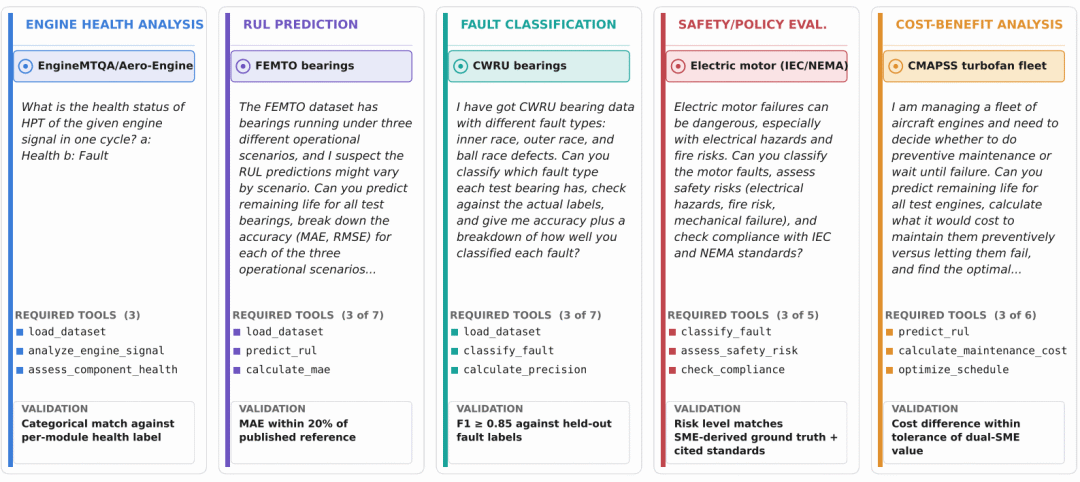
2.2 场景构建

场景设计需要同时满足领域真实性、评估器确定性和专家劳动约束下的可复现性。研究团队检索五个公开数据平台,经社区认可度、技术质量和 PHM 任务一致性三阶段筛选后保留 19 个数据集,覆盖 8 类资产。每个数据集必须有公开真值,且有记录的 PHM 使用案例。数据集以标准化命名注册,所有训练—测试划分和提取脚本均固定版本。

场景由 8 名专家组成的联盟编写,专家来自航空、工业维护、机械工程、人工智能和资产运营领域。作者使用结构化提示要求场景具备工业角色、运行语境、明确交付物和可验证验收标准,但不直接写出完成任务所需的工具名称。每个场景发布前均由人工专家使用工具目录端到端执行;无法由已发布工具完成的场景被修改或拒绝。

每个场景表示为五元组:自然语言请求、数据集上下文、必需工具子集、看似合理但并不适用的干扰工具集,以及任务特定真值。RUL 输出使用连续数值,故障分类使用离散类别字符串,发动机健康分析使用多选或类别标签。

表 2 30 个分层场景样本上的标注者间一致性

维度      
Krippendorff’s α      
95% 置信区间      
真实性      
0.78      
[0.71, 0.85]      
难度校准      
0.74      
[0.66, 0.81]      
真值正确性      
0.82      
[0.75, 0.88]      
合并      
0.78      
[0.73, 0.83]      

研究在 75 个旋转设备和航空发动机场景中分层抽取 30 个场景计算标注者间一致性。24 个锂离子电池场景采用相同编写、双重审阅和专家执行流程,但未报告 Krippendorff’s α,因此表 2 不代表完整 99 场景基准。两名专家使用四点量表评定真实性、难度校准和真值正确性,所有维度的 α 均超过 0.7。30 个双重评分场景中有 7 个至少在一个维度相差 2 分以上,随后由第三名成员主持解决,并进行修改或替换。

当源数据集直接提供真值时,研究程序化提取 RUL 轨迹或故障标签,并与已发表基准数字核对。对于成本效益和安全合规等阈值判断,由专家依据文献和标准推导,第二名专家独立复算,只有结果一致的场景才会保留。所有真值字段都链接到来源引用或提取脚本。RUL 使用 MAE/RMSE,故障分类使用准确率、精确率、召回率和 F1,发动机健康分析使用类别匹配。

由于工具封装与场景由同一专家联盟设计,暴露工具缺口的场景会被修改或拒绝,因此基准偏向衡量既有工具表面上的编排能力,而非发现“无工具可用”的情形。未知工具模式和跨设备迁移只能部分缓解这一构念效度威胁。RUL 与故障分类真值还可能与 MCP 暴露算法来源相同,形成类似 Goodhart 定律的风险。

2.3 评估框架

PHMForge 支持两种交互模式。在“已提供工具”模式下,智能体获得必需工具和干扰工具的并集,必须选出、排序并调用正确子集,从而隔离工具编排能力;在“未知工具”模式下,智能体只获得自然语言请求,必须先从完整服务器目录检索工具并识别相关数据集,从而同时评估数据发现、工具检索和意图提取。

智能体与模型产生最终输出和由工具、参数对组成的执行轨迹。每个场景在温度为 0 时运行三次,报告平均成功率 pass@1 与三次均成功的 pass-all-3。即便在温度为 0 时,API 非确定性仍会造成运行间差异,因此 pass-all-3 被解释为稳健性的下界。

二元成功之外,评估器还从 MCP 日志确定性计算三类轨迹错误:推理错误,包括计划不连贯、调用干扰工具和任务分类错误;工具调用错误,包括参数格式、类型和模式错误;编排错误,包括正确工具以错误顺序组合、违反状态依赖或提前终止。评估还计算必需工具集 合上的精确率、召回率、顺序准确率和轨迹长度。每次运行均在依赖固定的沙箱容器中生成确定性 JSON 记录,一次完整的框架—模型组合评估成本约为 20~50 美元。

3 实验与结果

实验围绕四个实践问题展开:开放权重模型与开源智能体框架的哪种组合最好,且结果是否稳定;前沿模型在完整基准上距离生产部署阈值还有多远;大语言模型能否替代人工专家共识;失败集中在哪里,以及文本 RAG、自由代码和跨设备迁移等替代架构能否缩小差距。

3.1 框架比较:ReAct 与 ReActXen

PHMForge 智能体由 ReAct、ReActXen 或 Claude Code 等框架与负责编排 MCP 工具调用的大语言模型骨干配对。为控制计算成本,研究从五类任务中分层抽取 25 个场景,并使用六种通过 API 提供的开放权重模型:Llama-3.3-70B、Llama-4-Maverick-17B-128E MoE、Mistral-Medium-2505、Mistral-Small-3.1-24B、GPT-OSS-120B 和一个紧凑型开放权重模型。

成绩最高的是 ReAct+Llama-4-Maverick-17B-128E,pass@1 为 80.0%。在多数基础模型上,单轮 ReAct 都优于加入反思步骤的 ReActXen;以 Llama-4-Maverick 为例,两者分别为 80.0% 和 63.6%。额外的反思步骤没有稳定纠错,反而增加了对不存在工具的调用。GPT-OSS-120B 是例外,反思环把成绩从 56% 提高到 68%。RUL 任务中的长数组输入造成了明显障碍:Mistral-Medium-2505 会截断传给 calculate_mae 的 100 元素数组,因此 RUL 成功率为 0%;Llama-4-Maverick 能够分批计算后合并结果,成功率达到 60%。Mistral-Medium-2505 在成本效益和安全政策任务上达到 100%,但 RUL 为 0%,说明它擅长结构化判断,却难以组织多步数值计算。

表 3 25 场景分层子集上不同框架与模型的 pass@1

框架+模型      
总体      
RUL      
故障      
健康      
成本      
安全      
ReAct+Llama 4 Maverick      
80.0%      
60.0%      
100.0%      
80.0%      
50.0%      
100.0%      
ReAct+Mistral Medium 2505      
64.0%      
0.0%      
40.0%      
90.0%      
100.0%      
100.0%      
ReAct+GPT-OSS 120B      
56.0%      
0.0%      
100.0%      
50.0%      
50.0%      
100.0%      
ReAct+Compact-LLM      
44.0%      
20.0%      
40.0%      
60.0%      
50.0%      
33.3%      
ReAct+Mistral Small 3.1 24B      
44.0%      
40.0%      
60.0%      
30.0%      
50.0%      
66.7%      
ReAct+Llama 3.3 70B      
36.0%      
20.0%      
20.0%      
20.0%      
100.0%      
100.0%      
ReActXen+GPT-OSS 120B      
68.0%      
20.0%      
100.0%      
90.0%      
50.0%      
33.3%      
ReActXen+Llama 4 Maverick      
63.6%      
20.0%      
100.0%      
100.0%      
部分      
部分      
ReActXen+Compact-LLM      
48.0%      
20.0%      
0.0%      
60.0%      
100.0%      
100.0%      
ReActXen+Mistral Medium 2505      
48.0%      
20.0%      
40.0%      
50.0%      
100.0%      
66.7%      
ReActXen+Mistral Small 3.1 24B      
48.0%      
40.0%      
40.0%      
30.0%      
100.0%      
100.0%      

3.2 前沿模型在完整 99 任务基准上的表现

研究进一步使用 Claude Code 配合 Claude Sonnet 4.5 和 Claude Opus 4.6,在全部 99 个场景上进行评估。Claude Code 是交互式命令行智能体,不能由自动化脚手架通过 API 调用,因此该实验依据同一场景级评分规则手动完成。工业采用研究通常把约 85% 的任务准确率视为无监督运行前提。Opus 4.6 达到 80.8%,Sonnet 4.5 达到 64.6%。这一结果与 25 场景开放权重实验使用不同脚手架和样本,不能直接比较。两种配置仍比 85% 阈值低 4.2~20.4 个百分点。

表 4 前沿模型在完整 99 场景基准上的 pass@1

框架+模型      
总体      
RUL      
故障      
健康      
成本      
安全      
Claude Code+Opus 4.6      
80.8%      
85.0%      
75.0%      
79.5%      
71.4%      
92.3%      
Claude Code+Sonnet 4.5      
64.6%      
70.0%      
60.0%      
69.2%      
42.9%      
61.5%      

3.3 大语言模型评审与人工评估

Claude Sonnet 4.0 在相同的 30 场景样本和相同量表上作为评审时,与人工共识之间的 Krippendorff’s α 为 0.61,明显低于人工之间的 0.74~0.82。模型会高估真实性并低估难度校准。因此,PHMForge 以人工专家共识作为标准评分依据,并认为大语言模型评审不足以可靠评估需要深厚专业知识的任务难度。

3.4 消融试验

在 24 个锂离子电池场景上,使用 Claude Opus 4.6、温度 0 和三次独立运行,以 Chroma 文本 RAG 替代 MCP 工具执行后,操作员式模糊请求的平均 pass@1 从 80.6% 降到 48.6%,协议式明确请求从 91.7% 降到 73.6%。模糊请求上的差异高度显著(p=0.002),明确请求差异处于边缘显著(p=0.07)。RUL 预测受影响最大,文本 RAG 的 pass-all-3 为 1/5,MCP 为 5/5,即从 100% 降至 20%。

在 Claude Code+Opus 4.6 上移除所有领域 MCP 工具、迫使智能体依赖原生执行时,总体完成率从 80.8% 降至 25%,下降 56 个百分点。在跨设备迁移中,同分布场景完成率为 84.1%,从轴承诊断零样本迁移到电机诊断时降至 42.7%,差距为 41 个百分点。

3.5 失败分解

把失败投影到三类轨迹错误后,首先是编排错误占主导,多数失败由正确工具以错误顺序调用造成,轨迹级错误排序率为 23%。其次,工具调用错误会随模型容量增大而减少:模式无效调用集中在较小的开放权重模型中,在前沿模型中很少出现。最后,在锂离子电池子集上,成本效益场景在 Opus 和 Sonnet 中均为 0/2,原因是模糊请求缺少预算锚点,而非工具编排错误。

3.6 任务特定性能与质量指标

最强配置在安全政策和成本效益任务上与专家共识相差不超过 4 个百分点,但在涡扇发动机 RUL 上比已发表基线高 4.3 个循环 MAE,在电机故障判别上低 12.2 个百分点准确率。锂离子电池任务中,留一电池评估下微调 TTM 的 MAE 为 13.5 个循环,优于同协议下线性回归的 28.4 和微调 Chronos 的 31.8。

表 5 最强配置的任务特定质量指标

资产      
指标      
智能体      
基线      
差值      
主要错误模式      
比例      
涡扇发动机      
MAE(循环)↓      
14.8      
10.5      
+4.3      
训练—测试污染      
27%      
RMSE(循环)↓      
19.2      
13.8      
+5.4      
轴承 RUL      
MAE(%)↓      
11.3      
8.2      
+3.1      
无效范围预测      
15%      
RMSE(%)↓      
14.7      
10.9      
+3.8      
锂离子电池      
MAE(循环)↓      
13.5      
28.4      
−14.9      
容量再生      
—      
轴承故障      
F1↑      
0.84      
0.87      
−0.03      
细粒度分类      
23%      
准确率↑      
87.2%      
91.3%      
−4.1      
电机故障      
F1↑      
0.68      
0.79      
−0.11      
严重度区分      
31%      
准确率↑      
71.4%      
83.6%      
−12.2      
发动机健康      
准确率↑      
72.0%      
78.6%      
−6.6      
正时误诊      
23%      
安全/政策      
准确率↑      
90.0%      
94.0%      
−4.0      
阈值查找      
10%      
成本效益      
ROI 区间      
±9.0%      
±5.0%      
宽 4.0 个百分点      
成本参数误用      
12%      

4 局限与未来工作

PHMForge 继承了 MCP 范式固有的多次调用开销:重复的客户端—服务器往返会放大推理延迟和令牌消耗,未来需要高性能智能体服务基础设施。标注者间一致性只覆盖 75 个非电池场景中的 30 个样本,锂离子电池扩展尚无定量一致性统计。成本和安全类真值依赖专家阈值判断,其实证基础不如可直接验证的 RUL 与故障分类。由同一联盟设计工具与场景,还会使基准偏向已有工具可解决的任务;在算法与真值来源相同时,也存在过拟合基准的风险。

5 结论

PHMForge 是面向工业 PHM 的 MCP 原生基准,前沿大型语言模型达到 80.8% 的 pass@1,剩余差距主要集中在编排错误。在锂离子电池类别上,用文本 RAG 替换 MCP 工具会使 RUL 的 pass-all-3 从 100% 降至 20%;完全移除领域工具会使完成率降至 25%。因此,算法驱动的 MCP 工具是工业部署所必需的基础,而不是已经饱和的排行榜特征。

6 附录 A:工具规范

PHMForge 的 39 个工具由预测服务器、智能维护服务器和电池预测服务器提供。它们封装真实算法与数据访问,不向智能体返回预制答案。

表 6 预测服务器的 15 个工具

工具      
主要参数      
功能      
load_dataset      
dataset_name,split      
加载注册的 PHM 数据集及指定划分      
load_ground_truth      
dataset_name,file(可选)      
加载数据集真值      
train_rul_model      
dataset,model_type,epochs      
训练 MLP、LSTM 或 Transformer RUL 模型      
train_fault_classifier      
dataset,model_type,epochs      
训练故障分类器      
predict_rul      
model_path,test_data,unit_id      
预测剩余使用寿命      
classify_faults      
model_path,test_data,unit_id      
执行故障分类      
calculate_mae      
ground_truth,predictions      
计算平均绝对误差      
calculate_rmse      
ground_truth,predictions      
计算均方根误差      
verify_ground_truth      
ground_truth,predictions      
验证预测与真值的一致性      
calculate_accuracy      
ground_truth,predictions      
计算分类准确率      
verify_classification      
ground_truth,predictions      
核验分类结果      
an alyze_engine_signals      
sensor_data,engine_id      
分析发动机传感器信号      
assess_component_health      
component,efficiency,flow_modifier      
评估发动机部件健康状态      
diagnose_timing_issues      
efficiency_deviation,flow_deviation      
诊断部件正时问题      
detect_degradation_trend      
cycle_data      
检测循环数据中的退化趋势      

表 7 智能维护服务器的 7 个工具

工具      
主要功能      
calculate_maintenance_cost      
计算预防性维护的人员、备件和停机成本      
calculate_failure_cost      
计算设备失效后的维修、停机和间接损失      
optimize_maintenance_schedule      
依据 RUL、成本和资源约束优化维护计划      
assess_safety_risk      
评估电气、火灾、机械与运行风险      
check_compliance      
检查 IEC、ISO、OSHA、FAA 和 NEMA 合规性      
generate_safety_recommendations      
根据风险和合规结果生成安全建议      
web_search      
检索标准、法规和维护信息      

表 8 电池预测服务器的 17 个工具

类别      
工具      
功能      
数据访问      
fetch_cycle_data      
获取完整逐循环遥测数据      
fetch_cycle_summary      
获取五项标准特征的轻量摘要      
fetch_impedance_data      
获取电化学阻抗谱及趋势统计      
诊断      
capacity_soh_calculator      
相对首循环参考值计算 SOH      
anomaly_detector      
使用滚动 z 分数和持续性消抖检测异常      
thermal_anomaly_checker      
分类正常老化、内阻上升和热尖峰      
impedance_trend_an alyzer      
区分传感器故障与真实退化      
预测      
rul_predictor_linear      
线性回归误差基线      
rul_predictor_empirical      
考虑 Arrhenius 温度加速的经验衰减模型      
rul_predictor_lstm      
留一电池训练的 LSTM      
rul_predictor_chronos      
Chronos-Bolt 迭代预测      
rul_predictor_ttm_zero_shot      
未在 NASA 数据上微调的 TTM      
rul_predictor_ttm_finetuned      
按目标电池留一微调的 TTM      
degradation_stage_classifier      
输出健康、早期退化、加速退化或寿命终止阶段      
rul_predictor_ttm      
映射到微调 TTM 的兼容别名      
报告      
generate_health_report      
串联 SOH、异常与 RUL,生成分级健康报告      
compare_to_baseline      
与机队基线比较并识别离群电池      

7 附录 B:数据集特征

PHMForge 使用 19 个数据集,覆盖五种设备大类;所有数据集均有公开真值和已发表的 PHM 使用记录。表 9 中的记录数为预处理后行数,特征数包括运行设置、传感器值和派生特征,任务类型按主要用途标记。

表 9 PHMForge 的 19 个基准数据集

数据集      
记录数      
特征      
单元      
类别      
工况      
真值      
任务      
CMAPSS FD001      
33,727      
26      
200      
—      
6      
✓      
RUL      
FD002      
87,750      
26      
519      
—      
3      
✓      
RUL      
FD003      
41,316      
26      
200      
—      
2      
✓      
RUL      
FD004      
102,463      
26      
497      
—      
3      
✓      
RUL      
Azure      
876,905      
11      
100      
5      
1      
—      
RUL      
EngineMTQA      
18,830 问答对      
—      
4 类任务      
30      
—      
✓      
发动机健康      
CWRU      
21,786      
4      
—      
4      
4      
✓      
故障      
FEMTO      
12,247      
13      
17      
2      
6      
✓      
RUL      
IMS      
100,480      
10      
8      
4      
1      
✓      
RUL      
XJTU      
110,592      
13      
15      
5      
3      
—      
RUL      
HUST      
19,095      
8      
—      
7      
2      
—      
故障      
MFPT      
2,166      
10      
20      
3      
2      
—      
故障      
Mendeley      
79      
4      
—      
2      
2      
—      
故障      
Paderborn      
7,679      
16      
20      
4      
2      
✓      
故障      
ElectricMotorVibrations      
30      
6      
—      
4      
3      
✓      
故障      
RotorBrokenBar      
40      
7      
—      
5      
2      
—      
故障      
GearboxUoC      
936      
2      
—      
9      
1      
—      
故障      
PlanetaryPdM      
14      
2      
—      
2      
2      
—      
故障      
NASA PCoE 锂离子电池      
约 11,000 循环      
5 项标准特征+EIS      
4 个电池      
—      
24 个场景      
留一      
RUL/健康/故障      

7.1 各阶段筛选数量

初始检索得到 52 个候选数据集。第一阶段要求社区验证度足够,即下载量超过 1,000 或引用量超过 50,保留 31 个;第二阶段要求具有明确真值和可复现预处理,保留 22 个;第三阶段要求与 PHMForge 的 RUL、故障、健康、成本或安全任务一致,保留 18 个。NASA PCoE 锂离子电池数据在第六阶段作为第 19 个数据集加入,并通过相同筛选条件。

7.2 场景中的资产类别分布

场景分布反映可获得的公开数据和专家覆盖,而不是工业资产的真实流行度。航空发动机和轴承占比较高,工业发动机、电机、感应电机和齿轮箱较少;锂离子电池扩展增加了 24 个涵盖全部五类任务的场景。

表 10 99 个场景在 8 类资产中的分布

资产类别      
场景数      
覆盖任务      
涡扇发动机      
14      
RUL、健康、成本、安全      
航空发动机      
30      
健康分析      
轴承      
22      
RUL、故障分类      
电机      
3      
故障分类      
感应电机      
2      
故障分类      
齿轮箱      
3      
故障分类      
工业发动机      
1      
成本、安全      
锂离子电池      
24      
五类任务全部覆盖      
合计      
99      
五类任务      

8 附录 C:扩展真值与评估细节

8.1 真值使用框架

PHMForge 的真值并非只用于最终评分,而是贯穿场景构建、智能体执行和结果验证。RUL 场景要求智能体加载真值、计算 MAE 与 RMSE,并调用验证工具;故障分类场景要求核验预测标签与准确率等指标;健康、成本和安全场景则对照专家或标准派生的类别与阈值。对于数值任务,评估器检查预测完整性、物理有效范围和相对已发表参考值的容差,典型容差为 ±20%。输出完整度必须超过 80%,而且必须执行真值验证,不能以自然语言声称“已验证”代替工具调用。

评估分为完整性、正确性和效率三个维度。完整性检查要求的字段和工具步骤是否齐全;正确性比较数值误差、类别标签或合规判断;效率记录工具精确率、召回率、顺序正确性和轨迹长度。确定性验证器会拒绝缺少测试单元预测、风险单位列表、误差统计或验证状态的输出。这样可以把看似合理的文本回答与实际完成的 PHM 计算区分开。

8.2 场景统计分解

99 个场景中,发动机健康分析 39 个,占 39.4%;RUL 预测 20 个,占 20.2%;故障分类 20 个,占 20.2%;安全/政策评估 13 个,占 13.1%;成本效益分析 7 个,占 7.1%。场景覆盖 8 类资产和 19 个数据集。约 60% 为开放式任务,约 40% 为闭合式任务;约 55% 要求智能体自行发现数据,约 45% 在提示中直接提供数据;约 30% 涉及机队级查询。

请求采用设备经理、维护技术人员、安全主管和工程师等不同利益相关者的表达方式,包含真实工业缩写、紧迫程度和运行限制。场景设计、独立复核、真值复算与端到端执行累计投入数百个专家工时。

9 附录 D:场景策展过程

9.1 专家联盟构成

策展联盟由 8 名成员组成,背景覆盖航空航天、机械工程、工业维护、资产运营和人工智能。每个场景至少经过编写者、独立领域审阅者和执行验证者三个角色;阈值或合规真值还要求第二名专家独立推导。作者不使用大语言模型生成场景正文,以避免把模型语言模式带入基准。

9.2 六阶段渐进扩展

基准通过六个阶段扩展:第一阶段建立单一 RUL 类别的最小任务;第二阶段增至 10 个场景并加入故障分类;第三阶段增至 20 个场景并加入成本与安全;第四阶段增至 40 个多资产场景;第五阶段增至 75 个场景并加入发动机健康分析的认知型任务;第六阶段加入 24 个锂离子电池场景,形成 99 个场景并覆盖全部五类任务。

表 11 六个扩展阶段的累计场景数与任务覆盖

阶段      
累计场景数      
新增或覆盖任务      
1      
1      
RUL 预测      
2      
10      
加入故障分类      
3      
20      
加入成本效益与安全政策      
4      
40      
多资产扩展      
5      
75      
加入发动机健康分析与 4 类认知任务      
6      
99      
加入 BESS 24 场景并覆盖全部五类任务      

9.3 动态基准扩展计划

PHMForge 采用动态基准思路。后续扩展将按相同的数据筛选、专家编写、双重审阅、真值可追溯和端到端执行流程加入新资产与新工具。公开排行榜需要记录基准版本,避免在场景持续增加时把不同版本的结果直接比较。扩展优先补足当前稀缺的齿轮箱、电机和工业发动机场景,并增加尚无工具可解的任务以降低构念循环性。

10 附录 E:标注协议与标注者间一致性

10.1 抽样与评分程序

一致性研究从 75 个旋转设备和航空发动机场景中分层抽取 30 个,包括 12 个发动机健康分析、6 个故障分类、6 个 RUL 预测、3 个成本效益分析和 3 个安全/政策评估。每个场景由联盟中的两名专家独立评分,评分者看不到对方结果。评分者配对轮换,使同一对专家不会评完整个样本,各组合承担的双重评分数量大致相等。

10.2 评分维度

专家使用四点李克特量表(1=差、2=勉强、3=可接受、4=优秀)评定三个维度:真实性,判断请求是否符合真实工业语境、利益相关者表达、术语和紧迫性;难度校准,判断领域专家在给定工具和数据下能否完成任务,且任务既不过于简单也不因信息不足而不可解;真值正确性,判断真值能否由所引来源验证,以及 MAE 边界或故障标签集等容差是否适当。

10.3 一致性指标与结果

研究在序数—区间假设下计算 Krippendorff’s α,适用于每个项目有两名评分者的李克特数据。表 2 报告各维度 α 及 1,000 次自助抽样所得的 95% 置信区间。三个维度均超过通常认为“实质一致”的 0.7,其中真值正确性最高。真实性略低,反映航空航天与旋转设备专家参考背景不同,后续共识程序对此进行处理。

10.4 分歧解决

30 个双重评分场景中有 7 个在至少一个维度相差 2 分或以上。第一步,两名评分者在看到对方分数后独立复审;第二步,如分歧仍在,由第三名联盟成员主持讨论;第三步,修改请求措辞或收紧真值容差后重新评分,若无法达成共识则拒绝该场景。7 个场景中有 6 个修改后接受,1 个被拒并由新场景替代,新场景再经历同样的双重审阅。

10.5 大语言模型评审交叉检查

研究让 Claude Sonnet 4.0 对相同 30 场景样本使用相同四点评分量表,并将每个场景全文交给模型。模型评分与人工共识的总体 Krippendorff’s α 为 0.61。分维度看,真实性 α=0.55,模型系统性高估;难度校准 α=0.58,模型系统性低估;真值正确性 α=0.71,最接近人工一致性。因此,模型不能替代专家进行场景难度和真实性评审。

10.6 BESS 扩展的一致性范围

附录 E 的一致性研究只覆盖 75 个旋转设备与航空发动机场景,不包括第六阶段新增的 24 个锂离子电池场景。BESS 场景遵循相同的编写、双重审阅和专家执行程序,但未计算 Krippendorff’s α。表 2 应理解为 75 个非 BESS 场景中 30 个样本的结果,而非完整 99 场景。需要统计可比性的二次分析应限制在这 75 个场景内。

11 附录 F:锂离子电池资产类别方法细节

本附录展开介绍锂离子电池部分,包括电池预测服务器、架构消融、RUL 基线以及时间序列基础模型评估中的可复现性措施。

11.1 电池预测服务器

电池预测服务器针对 NASA PCoE 的 B0005、B0006、B0007 和 B0018 四个电池单体提供 17 个工具。数据访问工具返回完整逐循环遥测、五个标准特征摘要以及电化学阻抗谱;诊断工具计算 SOH、检测持续异常、分类热事件并区分阻抗传感器故障与真实退化。

预测类包括六个 RUL 预测器以及退化阶段分类和兼容别名。线性回归提供误差下界;经验模型使用 SciPy 曲线拟合实现具有 Arrhenius 温度加速的指数衰减;LSTM 从头训练并采用留一电池协议;Chronos-Bolt 以每轮最多 64 步迭代外推;TTM 分为未在 NASA 数据微调的零样本版本和按目标电池留一微调的版本。所有预测器返回统一的 PredictionResult;失败时返回 predicted_rul=-1、confidence=0,并在 metadata.error 中记录错误,使智能体能够改用其他预测器并根据置信区间宽度选择结果。

报告工具把 SOH、异常和 RUL 串联成日常、升高、紧急或危急四级处置,也能把目标电池与机队基线比较以标记离群值。

11.2 六模型 RUL 预测基准

六个预测器采用严格的留一电池协议,在 B0005、B0006 和 B0018 三个目标电池以及 [0,40]、[0,60]、[0,80]、[0,100]、[0,120] 五个观测窗口上评估,共得到 90 个预测点。寿命终止定义为放电容量首次低于 1.4 Ah。

表 12 NASA PCoE 锂离子电池上的六模型留一评估,单位为循环 MAE

预测器      
总体      
B0005      
B0006      
B0018      
TTM 微调(留一)      
13.5      
14.0      
16.0      
10.6      
线性回归      
28.4      
71.6      
6.7      
6.9      
Chronos 微调(留一)      
31.8      
69.2      
19.4      
6.9      
TTM 零样本      
33.5      
32.5      
41.7      
26.2      
经验模型(Arrhenius)      
37.4      
101.3      
5.2      
5.7      
从头训练 LSTM      
45.4      
16.8      
37.4      
82.0      

线性回归和经验 Arrhenius 模型在 B0006、B0018 上得到 5~7 循环的低误差,却在存在非单调容量再生的 B0005 上分别达到 71.6 和 101.3,因此总体 MAE 才是更合适的指标。LSTM 在 B0005 上最好,却在 B0018 上达到 82.0,暴露出对留一训练中未见容量再生模式的脆弱性。微调 TTM 是唯一在三个电池上都较为均衡的模型,说明领域适配而非仅靠架构决定了预测精度。

11.3 锂离子电池资产类别的分类别 pass-all-3

架构消融使用 24 个锂离子电池场景,包括 9 个健康分析、5 个 RUL、5 个故障分类、3 个安全政策和 2 个成本效益。每个场景同时具有“Battery 5”一类操作员式模糊表述和“B0005”一类协议式明确表述。路径 A 是对生成遥测报告和电池维护手册建立 Chroma 索引的 RAG;路径 B 是提供 17 个算法驱动工具的电池 MCP 服务器。两条路径使用同一评分器,以温度 0 独立运行三次。

路径 A 的持久向量索引使用 ChromaDB 的 bess_kb 集 合与余弦 HNSW。文档以 cl100k_base 分成 512 令牌片段,重叠 50 令牌,使用 text-embedding-3-small 嵌入,评估时检索前 3 个上下文。检索器先用词法评分匹配特定电池与窗口的遥测 Markdown;如无匹配,再依次退回 Chroma、旧 FAISS 索引和 chunks.json 词法检索。旧 FAISS 使用 all-MiniLM-L6-v2,只作为后备,不是报告结果的 Chroma 嵌入模型。系统提示限制模型进行电池诊断、使用规范退化阶段和生成机器可读 FINAL_ASSESSMENT;若缺少必需数值,必须写 UNKNOWN。

路径 B 不向大语言模型开放通用 Python REPL 或任意代码执行。NumPy、SciPy 等库只在工具内部使用。可调用列表由 skills/registry.json 确定性生成,只有 status=implemented 的条目才转成函数模式,并附工具说明、参数类型、必填字段、默认值和枚举约束。工具经进程内 FastMCP 调度,每个场景最多执行六轮工具调用。

表 13 24 个锂离子电池场景按类别统计的 pass-all-3

类别      
n      
路径 A 模糊      
路径 A 明确      
路径 B 模糊      
路径 B 明确      
健康分析      
9      
4/9      
7/9      
8/9      
9/9      
RUL 预测      
5      
1/5      
1/5      
5/5      
5/5      
故障分类      
5      
2/5      
4/5      
3/5      
4/5      
安全/政策      
3      
2/3      
3/3      
3/3      
3/3      
成本效益      
2      
0/2      
1/2      
0/2      
1/2      
合计      
24      
9/24      
16/24      
19/24      
22/24      

表 14 给出 pass-all-3 与汇总 72 次单轮试验的平均 pass@1 的 Wilson 95% 置信区间,并用配对 McNemar 检验比较两条路径。模糊请求中 b=0、c=10、p=0.002,说明两条路径结果不同的全部场景都是 MCP 成功;明确请求中 p=0.07,差距缩小到边缘显著,因为精确索引词有时让文本检索直接匹配。

表 14 BESS 场景三次语义运行的稳定性

路径      
请求      
pass-all-3(Wilson 95% CI)      
平均 pass@1(Wilson 95% CI)      
路径 A RAG      
模糊      
9/24(37.5%)[21.1%, 57.4%]      
35/72(48.6%)[37.4%, 59.9%]      
路径 A RAG      
明确      
16/24(66.7%)[46.6%, 82.2%]      
53/72(73.6%)[62.4%, 82.5%]      
路径 B MCP      
模糊      
19/24(79.2%)[59.1%, 91.2%]      
58/72(80.6%)[69.8%, 88.2%]      
路径 B MCP      
明确      
22/24(91.7%)[73.0%, 98.8%]      
66/72(91.7%)[82.7%, 96.4%]      

11.4 记录的失败案例:B0005 上的 Chronos 预测范围截断

微调 Chronos 在 B0005 上出现预测范围截断:迭代轨迹在 5 轮、每轮 64 步的范围内仍未穿过 1.4 Ah 寿命终止阈值,总预测跨度为 320 个循环。预测器返回最大外推范围而非真实 RUL,使 B0005 的 MAE 即使微调后仍达到 69.2。该失败来自 Chronos 的单调下降先验与 B0005 容量再生循环冲突。论文保留并公开此限制,以展示基础模型何时以及为何失败。

11.5 BESS 特定的可复现性规范

TTM 零样本和微调版本作为不同 MCP 工具公开,而不是同一工具的配置开关,防止结果表静默混用训练条件。微调检查点命名为 models/{model}_finetuned/{battery_id}_excluded.pt,名称直接标明训练中排除的目标电池,便于检查测试泄漏。

每个 LSTM 检查点保存覆盖全部逐循环 JSON、ground_truth.json、特征列表和训练超参数(窗口、隐藏层、轮数、学习率、随机种子)的 SHA256 哈希。数据或超参数变化都会使缓存失效并触发重新训练。该措施源于一次可复现性事故:早期 LSTM 运行因缓存检查点在合成前体数据上训练而报告异常低 MAE,现有指纹协议用于防止复发。

12 附录 G:辅助过程指标——各配置轨迹细节

正文中“错误顺序占轨迹 23%”以及干扰工具与调用错误为次要来源的结论,来自直接由 MCP 执行日志计算的逐配置轨迹指标。表 15 给出 25 场景分层子集上的平均步骤、总令牌、单场景时间和 pass@1。相同模型骨干下,ReActXen 因反思循环耗时更长,但令牌量接近;Llama-3.3-70B 的长耗时来自 WatsonX 推理延迟而非智能体开销。

表 15 25 场景分层子集上的逐配置过程指标

框架+模型      
平均步骤      
总令牌      
单场景时间(秒)      
pass@1      
ReAct+Llama 4 Maverick      
7.7      
33,017      
42      
80.0%      
ReAct+Mistral Medium 2505      
8.0      
37,259      
49      
64.0%      
ReAct+GPT-OSS 120B      
7.6      
35,157      
26      
56.0%      
ReAct+Compact-LLM      
7.7      
31,947      
37      
44.0%      
ReAct+Mistral Small 3.1 24B      
8.2      
42,161      
47      
44.0%      
ReAct+Llama 3.3 70B      
6.1      
24,635      
312      
36.0%      
ReActXen+GPT-OSS 120B      
6.6      
30,970      
74      
68.0%      
ReActXen+Llama 4 Maverick      
8.2      
36,728      
195      
63.6%      
ReActXen+Compact-LLM      
6.5      
28,548      
101      
48.0%      
ReActXen+Mistral Medium 2505      
7.6      
36,840      
134      
48.0%      
ReActXen+Mistral Small 3.1 24B      
8.4      
46,031      
138      
48.0%      
ReActXen+Llama 3.3 70B      
4.0      
19,454      
603      
9.1%      

13 附录 H:其他消融研究

附录 H 使用最强配置 Claude Code+Opus 4.6,在保持其他因素不变时逐一关闭三个基准设计特征。移除智能体自行计算 MAE/RMSE 的真值验证要求,会使表面完成率从 81.0% 增至 99.7%,提高 18.7 个百分点,但产生 31% 的假阳性:预测误差超过阈值 3~5 倍时,智能体仍声称成功。因此,真值验证对防止得分膨胀不可或缺;否则基准测到的是智能体自信而不是预测准确性。

移除干扰工具使完成率提高 12.4 个百分点。在完整设置中,因干扰工具导致的失败有 64% 属于语义脆弱错误,例如请求提到“环境条件”就调用 weather_data_loader。干扰工具能暴露由精心筛选工具子集所掩盖的工具区分失败,因此预测真实部署行为的基准必须保留干扰项。

当数据直接嵌入提示时,智能体完成率为 74.6%;必须自主加载并识别正确数据集时降至 53.3%,差距为 21.3 个百分点。失败可分解为数据集误识别 18%、路径导航错误 23% 和特征提取错误 16%。未知工具模式揭示了常被忽视的部署要求:工业智能体在运行时不会收到已整理的数据集,必须先从 PHMForge 语料中自行识别和加载相关数据,再调用工具。

编辑:肖鑫鑫
校核:李正平、陈凯歌、赵栓栓、曹希铭、赵学功、白亮、任超、海洋、陈宇航、Tina、王金、赵诚、Kira、张优
该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除
来源:故障诊断与python学习
ACTHPC振动化学通用航空航天UGpython海洋UM电场电机Electric数字孪生控制试验人工智能
著作权归作者所有,欢迎分享,未经许可,不得转载
首次发布时间:2026-09-09
最近编辑:1月前
故障诊断与python学习
硕士 签名征集中
获赞 87粉丝 153文章 343课程 0
点赞
收藏
作者推荐

论文学习 | 融合大语言模型的工业物联网数字孪生:面向传统设备与智能工厂设备

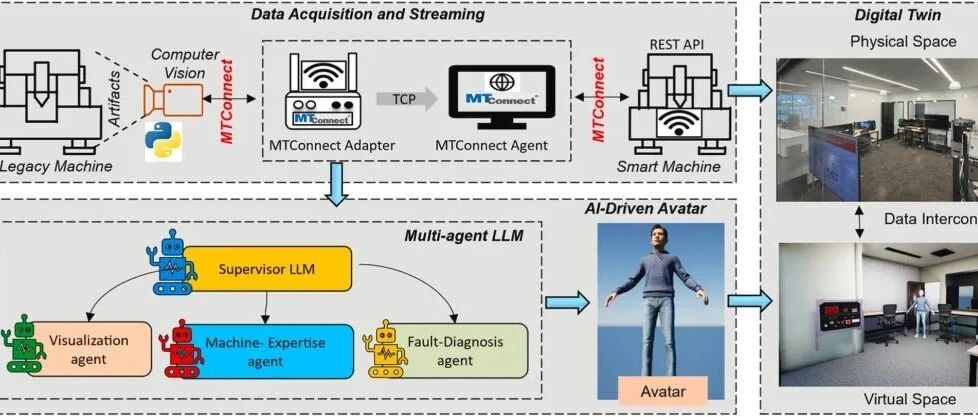
本期推荐论文提出了一种面向传统设备与智能工厂设备的工业物联网(Industrial Internet of Things, IIoT)数字孪生系统,并将多 Agent 大语言模型(Large Language Models, LLM)框架集成到数字孪生环境中。该框架通过 MTConnect(Manufacturing Technology Connect,制造技术互联)协议采集传统机床部件、智能设备以及建筑环境传感器的实时数据,并利用监督 Agent、机器专家 Agent、数据可视化 Agent 和故障诊断与控制 Agent 协同完成查询分类、实时数据解释、专家知识检索、故障诊断和远程控制。论文进一步将 LLM 与数字孪生、人工智能(Artificial Intelligence, AI)虚拟头像和语音交互结合,使操作人员能够通过自然语言查询设备状态、获取诊断建议并调整设备参数。实验结果表明,该系统能够以较低延迟融合传统设备与智能设备数据,并在三维打印(Three-Dimensional Printing, 3D Printing)故障诊断与控制场景中有效改善打印质量,为面向智能制造的人机协作、故障诊断和数字孪生增强提供了可落地的 Agent 化解决方案。论文基本信息论文题目:IIoT-enabled digital twin for legacy and smart factory machines with LLM integration论文日期:2025论文期刊:Journal of Manufacturing Systems论文链接:https://doi.org/10.1016/j.jmsy.2025.03.022作者:Anuj Gautam、Manish Raj Aryal、Sourabh Deshpande、Shailesh Padalkar、Mikhail Nikolaenko、Ming Tang、Sam Anand作者单位:1、Center for Global Design and Manufacturing, Siemens Simulation Technology Center, Department of Mechanical & Materials Engineering, University of Cincinnati, Cincinnati, OH, USA2、Smart Manufacturing Lab, UC Digital Futures, University of Cincinnati, Cincinnati, OH, USA3、eXtended Reality Lab, UC Digital Futures, University of Cincinnati, Cincinnati, OH, USA目录摘要1. 引言2. 相关工作3. 方法 3.1 实时数据采集与标准化 3.1.1 传统设备与智能设备数据采集 3.1.2 用于数据标准化与流式传输的 MTConnect 协议 3.2 多 Agent LLM 框架开发 3.2.1 监督 Agent 3.2.1.1 合成数据集创建 3.2.1.2 通过微调进行模型优化 3.2.2 可视化 Agent 3.2.3 机器专家 Agent 3.2.4 故障诊断 Agent 3.3 数字孪生环境开发 3.3.1 系统设计与架构 3.3.2 渲染与用户交互 3.4 面向人机交互的人工智能驱动头像 3.5 双向通信与远程机器控制 3.5.1 命令库与函数映射 3.5.2 动态函数选择4. 结果 4.1 数据采集 4.2 监督 Agent 性能 4.3 多 Agent LLM 框架 4.3.1 可视化 Agent 4.3.2 机器专家 Agent 4.3.3 故障诊断与机器控制 Agent(案例研究:Ultimaker S5) 4.4 数字孪生与头像交互 4.5 计算成本与可扩展性5. 结论与未来工作摘要近年来,大语言模型(Large Language Models, LLM)的发展显著改变了自然数据解释、翻译和用户培训等领域。然而,当 LLM 被用于辅助实时、上下文敏感的机器数据分析时,仍然存在明显不足。本文提出了一种多 Agent LLM 框架,该框架能够通过工业物联网(Industrial Internet of Things, IIoT)平台访问并解释实时数据和历史数据,从而支持基于证据的推理。实时数据通过 MTConnect 数据流协议采集自多类传统设备部件(例如七段数码显示器、拨动开关和旋钮)、智能设备(例如三维打印(Three-Dimensional Printing, 3D Printing)设备)以及建筑环境数据源(例如声音传感器和温度测量设备)。进一步地,本文开发了由四类专用 Agent 组成的多 Agent LLM 框架,包括监督 Agent、机器专家 Agent、数据可视化 Agent 和故障诊断 Agent,用于处理特定制造任务。随后,该 LLM 框架被集成到数字孪生中,以实现非结构化数据的实时可视化。本文还探讨了基于 LLM 的数字孪生如何通过虚拟头像充当实时虚拟专家,从而减少对传统手册或主管经验的依赖。为了展示该框架的功能和有效性,本文给出了一个包含传统设备部件和现代机器的案例研究。结果表明,LLM 在数字孪生环境中辅助解释和推断实时机器数据具有实际应用价值。关键词:大语言模型;工业物联网;数字孪生;多 Agent 框架;检索增强生成。I. 引言信息物理系统(Cyber-Physical Systems, CPS)、物联网(Internet of Things, IoT)和云计算的引入,为工业 4.0 中更智能、更互联的制造环境奠定了基础。工业物联网是工业 4.0/5.0 的关键支柱之一,它通过数字孪生实现更高效的连接和更顺畅的交互。数字孪生是物理模型的虚拟表示,能够支持制造运行过程的实时监测、仿真和优化。它们在利用来自传感器和机器的实时 IoT 数据来优化生产、减少停机时间并提高整体效率方面发挥着关键作用。通过支持实时监测、误差预测和加工过程的自适应控制,数字孪生显著增强了制造运行能力。Fu 等人的近期研究强调了数字孪生在处理加工误差方面的关键作用,因为这些误差会影响产品质量、降低效率,并在制造环境中带来安全风险。尽管数字孪生能够处理、分析和仿真实时数据,但它们往往忽视非结构化书面数据的重要性,例如机器手册和历史故障日志,而这些数据能够为决策提供额外上下文和指导。智能制造中的一个挑战是,访问和解释机器手册、历史故障记录以及操作文档非常耗时,而这些资料又常常是获得可执行洞察的必要来源。操作人员和工程师通常需要翻阅繁杂文档来排查故障、优化流程并做出知情决策,这会延迟生产。因此,在解释 IIoT 数据和非结构化数据时,专家反馈对于提供有价值的机器数据洞察至关重要。本文提出了一种集成在数字孪生中的、基于大语言模型(LLM)的多 Agent 框架,该框架能够提供与机器相关的上下文感知专业知识和建议。LLM 是经过训练、能够理解和分析文本的强大语言工具,因此适合在制造环境中用自然语言解释大量非结构化信息。将 LLM 集成到数字孪生中,可以在不额外依赖专家的情况下提供专家分析、预测和可执行建议,从而节省时间和资源。LLM 能够处理此类信息,并提供传统数据分析技术不易发现的相关洞察。传统上,LLM 仅在静态和历史数据集上训练,因此在数据不断变化的实时车间运行场景中难以直接适应。对于此类领域特定用例,LLM 通常需要通过微调进行动态更新。然而,每当数据更新时都重新微调模型既耗时、计算成本又高,也不现实。为解决这些挑战,本文引入了一个基于检索增强生成(Retrieval-Augmented Generation, RAG)的多 Agent LLM 框架,并将其微调到机器特定信息。RAG 是一种在用户查询和系统提示之外,从外部知识源补充相关上下文的方法。与依赖静态预训练的传统 LLM 不同,RAG 通过实时检索提升上下文准确性,并通过提供最新信息减少幻觉。图 1 展示了本文提出的 RAG 框架概览。该框架能够通过相似度搜索检索机器特定数据,例如维护记录和运行信息,确保 LLM 生成的洞察与最新机器状态精确对齐。 图 1:检索增强生成框架概览RAG 对非结构化数据的检索还进一步得到传统设备和智能设备数据集成的支持,而这种集成基于 MTConnect 协议实现。MTConnect 是一种开源通信协议,旨在从多类工业设备中高效采集数据。图 2 展示了本文提出的 IIoT 与 LLM 框架的集成方式。来自传统设备和智能设备的数据通过 MTConnect 协议进行标准化,并发送到 Web 服务器。随后,LLM 处理并解释这些 IIoT 数据和非结构化数据。相关信息被叠加到数字孪生模型上,并结合 AI 驱动头像,从而实现自然语言交互和实时机器调整。 图 2:传统设备、智能设备、数字孪生与 LLM Agent 的集成概览本文框架的创新性包括:将实时机器数据和建筑环境传感数据集成到统一的 MTConnect 流式平台;开发用于上下文敏感信息处理的多 Agent LLM 架构;并将其可视化到数字孪生中,以增强用户交互。本文结构安排如下:第 2 节综述 IIoT、LLM 和数字孪生相关研究;第 3 节描述所提出的多 Agent LLM 框架及其在数字孪生中的集成;第4 节给出案例研究并讨论结果;第 5 节总结结论并提出未来研究方向。II. 相关工作IIoT 是智能制造的关键组成部分,涉及工业机器的实时数据采集、监测和分析,可用于预测性维护、生产过程优化和运行效率提升。Kliestik 等人指出,IIoT 有潜力通过促进信息在生产各阶段之间高效流动来变革制造业,从而改善决策并减少停机时间。类似地,Chhotaray 等人强调了 IIoT 在构建互联制造生态系统中的作用,这类生态系统由数据驱动洞察支撑,能够显著改善运行表现。尽管 IIoT 已取得进展,但将老旧传统设备与现代智能设备集成仍然是一个重要挑战。在制造环境中,超过 70% 的设备属于传统设备。多数传统设备缺乏连接能力和智能化能力,因此成为实现完全一体化智能制造环境的障碍。本文作者团队的 Deshpande 等人以及 Durigan 等人的研究已经探讨了如何通过传感器和连接方案改造传统设备,使其成为 IIoT 生态系统的一部分。Deshpande 等人进一步扩展了该工作,重点研究数据通信、实时分析以及利用增强现实和人在环反馈实现过程反馈。然而,这些工作尚未从整体角度研究 LLM 与数字孪生的集成,以实现实时机器数据解释。数字孪生通过创建物理资产、过程和系统的虚拟表示,进一步拓展了智能制造边界。这类虚拟模型支持实时监测、仿真和优化,为预测性维护和运行效率提升创造机会。Siddharth 等人展示了数字孪生如何成为提升制造过程可见性和控制能力的有效方法,从而支持更好的决策和主动维护策略。然而,这些系统通常缺乏能够利用实时和历史机器数据来指导用户理解机器或过程信息的智能聊天机器人或头像。LLM 的自然语言理解能力可以在这一场景中用于上下文决策、机器信息获取和任务自动化。LLM 的自然语言理解和生成能力为多类任务中的人机交互提供了先进手段。生成式预训练 Transformer(Generative Pre-trained Transformer, GPT)系列中的 GPT-4 等 LLM 已被用于开发聊天机器人和虚拟助手。Jeon 等人开发了 ChatCNC,这是一种会话式机器监测框架,利用实时 RAG 和 LLM 增强与计算机数控(Computer Numerical Control, CNC)机器的自然语言交互。Xu 等人提出了一种集成 LLM 的生成式协同设计框架,将混合现实(Mixed Reality, MR)和生成式人工智能结合起来,以改善协作者之间的沟通并简化协同工作流程。此外,LLM 解释非结构化数据并生成人类可读文本的能力,使其成为制造环境中决策和任务自动化的有力工具。近期,Zheng 等人和 Jia 等人将 LLM 应用于工业场景,展示了其在故障诊断、任务分配和数据解释方面的潜力。Wang 等人开发了一种由 LLM 驱动的视觉与语言协作机器人导航系统,该系统允许协作机器人以更自然、上下文感知的方式解释人类指令,并根据操作人员反馈动态调整任务执行策略。然而,将 LLM 与 IIoT 和数字孪生结合,用于异常检测、故障分析和实时监测,仍然是一个新兴研究方向。IIoT、数字孪生和 LLM 的组合为解决制造环境中传统设备与智能设备数据集成问题提供了有前景的路径。该框架能够实现实时数据可视化、机器专家支持和故障诊断,从而缩小传统系统与智能系统之间的差距。制造领域中 LLM 与数字孪生集成的研究仍处于相对早期阶段。已有初步研究显示出显著优势。例如,Eigner 和 Händler 以及 Da Silva 和 Cardoso 指出,由 LLM 驱动的机器人能够提供上下文反馈,并改善决策制定和运行效率。类似地,Grandi 等人研究了 LLM 在产品设计过程中用于材料选择的情况,通过评估其与专家建议的一致性并识别 LLM 与人类专家选择之间的差异来验证其作用。Sun 等人提出了一种由 LLM 驱动的多 Agent 框架,能够动态分析高维传感器数据,提高制造环境中的适应性、可追溯性和决策准确性。Leng 等人强调,未来研究应重点提升这些集成系统的互操作性、可扩展性和鲁棒性,以增强工业环境中的决策、自动化和人机协作。III. 方法 本节描述本文的方法:如何利用多 Agent LLM 框架和面向人机交互的 AI 驱动头像,将来自传统设备和现代机器的数据集成到数字孪生环境中。3.1 实时数据采集与标准化为了从传统设备和智能设备中高效采集数据,所提出的框架依赖标准化协议,以保证不同机器之间的兼容性和无缝数据集成。本节讨论从传统设备和智能设备采集数据的方法,以及如何使用 MTConnect 对数据进行标准化和流式传输,以供进一步分析。图 3:基于 MTConnect 的数据采集与流式传输概览3.1.1 传统设备与智能设备数据采集本文采用双重数据采集方法,从传统设备和现代智能设备中提取机器传感器数据。图 3 展示了数据采集涉及的组件。对于传统设备,本文方法建立在作者团队此前基于计算机视觉工具包(Computer Vision Toolkit, CVT)的模拟面板研究基础上。该模拟面板通过开源计算机视觉库(Open Source Computer Vision Library, OpenCV)中的图像处理算法,将拨动开关、旋钮、光学字符识别(Optical Character Recognition, OCR)显示器、仪表以及七段数码显示器中的数据数字化。用于演示的模拟面板是团队内部制作的面板,用于表示这些部件,并复 制工厂车间中常见的传统设备。此外,为采集建筑环境数据,例如声音和空气质量传感器数据,作者使用制造商提供的定制软件界面来提取运行数据。这些传感器没有独立应用程序编程接口(Application Programming Interface, API),而是依赖通用串行总线(Universal Serial Bus, USB)连接。作者开发了一个基于 Python 的脚本,用于自动从软件界面捕获图像帧,重点识别并提取特定感兴趣区域(Region of Interest, ROI)。随后,捕获的图像通过 OpenCV 进行处理,从显示指标中提取相关数据。其他环境传感器的数据,例如温度传感器和光照传感器(Lux Meter),则通过独立 API 采集,并集成到 MTConnect 中。对于智能设备,本文应用了多种数据采集方法来提取传感器数据。例如,对于 Ultimaker S5 这类基于熔融沉积成型(Fused Deposition Modeling, FDM)的 3D 打印机,作者使用表述性状态转移应用程序编程接口(Representational State Transfer Application Programming Interface, RESTful API)直接提取关键实时参数,并将其集成到 IIoT 框架中。对于 Stratasys F170 3D 打印机,数据通过指定互联网协议(Internet Protocol, IP)地址以MTConnect 格式访问。作者开发了一个 Python 脚本,利用基于超文本传输协议(HyperText Transfer Protocol, HTTP)的 requests 库向打印机的 MTConnect 端点发送 GET 请求。3.1.2 传统设备与智能设备数据采集本文采用 MTConnect 协议对来自传统设备和智能设备的数据进行流式传输。MTConnect 提供标准化结构,可将原始数据转换为统一的可扩展标记语言(Extensible Markup Language, XML)格式。图 4 展示了 MTConnect 框架中的通信流程,说明客户端、Agent、适配器和设备之间的交互以及数据流架构。整个过程从客户端向 Agent 请求数据开始。随后,Agent 轮询适配器,适配器再连接设备以收集所需数据。设备响应后,适配器将原始设备数据转换为符合 MTConnect 标准的 XML 格式。格式化后的数据随后提供给客户端进一步使用。之后,数据被输入多 Agent LLM 框架,为用户提供自然语言反馈。 图4:MTConnect数据检索序列工作流3.2 多 Agent LLM 框架开发 所提出的多 Agent LLM 框架包含多个专用 Agent,这些 Agent 协同工作,用于处理用户输入、分析实时数据并提供运行洞察。核心 Agent 包括监督 Agent、可视化 Agent、机器专家 Agent 以及故障诊断与控制 Agent。每个 Agent 在构建模块化、高效的 IIoT 数据管理系统中承担特定角色。监督 Agent 作为中央协调器,根据用户输入将任务分配给其他 Agent。可视化 Agent 负责通过可视化图表和解释性摘要表示数据。机器专家 Agent 使用 RAG 从外部数据源动态检索相关信息,从而增强回答上下文。故障诊断与控制 Agent 负责以交互方式排查机器故障。该 Agent 利用实时数据和用户输入,迭代缩小潜在故障原因范围,并推荐纠正措施。图 5 对整体架构进行了全面概述,展示了 Agent 之间的关系、数据流以及系统中的任务分配方式。 图 5:多 Agent LLM 框架概览3.2.1 监督 Agent监督 Agent 负责处理用户查询并将任务分配给合适的 Agent。作为框架的“大脑”,该 Agent 确保每个专用子 Agent 根据用户提示,在其预定范围内有效运行。收到用户查询后,监督 Agent 首先根据预定义类别对输入性质进行分类,例如可视化、故障诊断或通用机器专业知识。3.2.1.1 合成数据集创建开发有效监督 Agent 的一个关键挑战,是训练模型对多样化用户输入进行分类并适当地委派任务。为解决这一问题,本文创建了一个专门面向分类需求的合成数据集。该合成文本数据集通过将相关文档输入 ChatGPT,并用少量示例引导模型生成真实风格输入而得到。该半自动过程产生了多样化的带标签样本,用于训练监督 Agent。标签包括“Visualization”,“Ultimaker”,“Stratasys”,“Mockpanel”和“Error”等类别。例如,与生成数据可视化表示有关的问题被标记为“Visualization”;而与机器故障排查有关的问题,则根据具体机器类型归类,例如 Ultimaker 3D 打印机相关问题被归为“Ultimaker”。3.2.1.2 通过微调进行模型优化第 3.2.1.1 节生成的合成数据集被用作训练数据,用于微调 GPT-4o-mini。该数据集经过精心构建,包含制造应用中典型的多种用户查询和场景,使模型能够有效学习并分类不同意图。在微调过程中,80% 的数据用于训练,20% 的数据保留用于验证。这保证模型能够较好地泛化到未见样本,同时避免过拟合。训练数据包含领域特定知识。许多工业环境依赖专有文档,例如专门的机器手册、维护日志和校准记录,而这些文档并不公开。例如,作者团队内部开发的 Mockpanel 代表一种传统设备,其用户手册并不公开。因此,该手册不会被任何公开大语言模型用于训练,这意味着通用模型无法提供关于该特定机器的有效回答。通过微调将这类专门知识集成到 LLM 中,并结合 RAG 等技术,系统在回答这些机器相关查询时能够提供更准确、更具上下文感知能力的结果。除基于数据集的优化之外,本文还采用提示词工程作为微调的互补策略。尽管微调带来了性能提升,但由于制造查询复杂且 token 处理存在固有限制,微调并不总是足以保证模型达到最佳表现。因此,每个用户查询都需要经过精心设计的提示词,其中包含详细指令和上下文信息,以在推理过程中引导模型决策。论文附录 A 给出了用于改进微调模型的系统提示词,该提示词用于分类用户查询并将其分配给相应 Agent。系统提示词在每个提示中嵌入了有限数量的相关描述,以帮助强化模型进行准确分类的能力。3.2.2 可视化 Agent可视化 Agent 被开发用于管理数字孪生中的实时数据可视化。该 Agent 基于 MTConnect 协议流式传输的实时 IIoT 数据,动态生成静态图表和图形,以可视化来自传统设备和智能设备的数据。Microsoft 的语言交互式数据分析(Language-Interactive Data Analysis, LIDA)库提供了渲染基本图表和绘图的基础功能。然而,该库在解释或总结这些可视化结果所隐含的意义方面存在固有限制。为弥合这一差距,本文实现了一个额外的总结层,利用 GPT-4o 使 LLM 能够分析视觉趋势并提取有意义的洞察。图 6 展示了与总结 Agent 集成的可视化 Agent 概览。该图说明原始数据如何流经可视化流水线,并最终转换为视觉输出和文本摘要。基于 GPT-4o 的附加层接收图表和绘图,并生成自然语言摘要。这些摘要为其他 Agent 提供来自数据可视化的关键洞察。 图 6:集成总结机器人的可视化 Agent 概览3.2.3 机器专家 Agent机器专家 Agent 是多 Agent LLM 框架的关键组成部分,用于处理复杂用户查询。它能够从结构化知识库中动态检索并综合基于文本和图像的信息。通过采用 RAG 方法,该 Agent 将上下文相关数据结合起来,为用户输入提供专家级指导。图 7 展示了机器专家 Agent 将视觉数据(基于图像描述的数据)与 RAG 文本数据相结合的工作流程。该过程从用户查询(步骤 1A 和 1B)以及存储在向量数据库中的知识库开始。随后,查询被转换为称为嵌入的数值表示,使机器能够解释和处理文本或图像。接着,系统执行余弦相似度搜索(步骤 2A 和 2B),以检索相关文本和图像元数据。本文使用余弦相似度,是因为它衡量的是用户查询嵌入与外部知识源嵌入之间的角度而非幅值,更关注语义意义而非文本长度。然后,检索到的上下文被用于通过 LLM 生成回答,同时检索相关图像(步骤 3A 和 3B)。最后,生成的图像和文本回答被返回给用户(步骤 4A 和 4B)。 图 7:基于 RAG 的机器专家 Agent 概览为识别最适合处理复杂查询的语言模型,本文对标准 LLM 架构进行了测试,包括 GPT-4o mini、Mistral(7B)、Llama 3.1(405B)和 Mixtral 8x22B。每个模型都被集成到 RAG 框架中,并基于一组性能指标进行评估。本文考虑两类评估指标:准确率和基于大语言模型的评估(LLM-Eval)分数。准确率用于具有可验证答案的问题,例如机器尺寸或重量,这便于与已知值直接比较。对于主观和开放式查询,例如描述操作步骤,LLM-Eval 分数则基于 GPT-4o 和 Gemini 等更大语言模型的评估计算,其前提是假设更大模型在生成回答方面通常优于较小模型。3.2.4 故障诊断 Agent故障诊断 Agent 被开发用于在 IIoT 支持的数字孪生中对传统设备和智能设备进行实时故障诊断。该目标通过持续观察实时传感器数据、查询结构化知识库,并将这些信息与用户输入相结合来诊断机器故障实现。该 Agent 在多 Agent LLM 框架中动态工作,利用微调后的 LLM 和领域特定知识执行诊断。图 8 展示了故障诊断 Agent 的整体工作流程,从基于实时传感器数据的初始故障检测,到通过多轮迭代生成故障原因和纠正措施建议。该图体现了一个闭环过程,即实时数据、用户反馈和诊断知识被结合起来生成推荐。流程从通过 MTConnect 获取实时 IIoT 数据开始,该协议以相同格式流式传输不同机器的温度、压力和运行状态等实时机器参数。如果用户发现异常,可以向 Agent 提出查询或报告问题。随后,Agent 访问故障数据库,该数据库包括历史故障日志、机器手册和诊断决策树。LLM 还使用带注释的数据集进行微调,这些数据集包含常见故障场景、错误代码和机器特定诊断数据。结合实时传感器输入后,该训练使模型能够针对可能的故障原因生成上下文准确的诊断结果。随后,Agent 向用户展示问题的潜在原因,并给出相应纠正措施。用户可以通过提供额外上下文信息或验证系统给出的建议,进一步细化 Agent 的诊断。Agent 会重新评估实时数据,并在可能解决方案之间迭代,以找到根本原因。它还允许实时执行纠正措施。例如,当检测到由于 3D 打印机热床温度过高而产生过热问题时,系统可以提出运行参数调整建议。系统还支持通过自然语言命令即时修改机器参数,这一点在第 3.5 节中有更详细说明。 图 8:故障诊断 Agent 工作流概览3.3 数字孪生环境开发为了展示 IIoT 和 LLM 的有效性,作者开发了智能制造实验室的数字孪生。图 9 展示了开发阶段,从创建初始计算机辅助设计(Computer-Aided Design, CAD)模型,到添加机器,再到在 Unreal Engine 中应用真实材料。该数字孪生集成了传统设备和智能设备数据。 图 9:智能制造实验室数字孪生复 制方法3.3.1 系统设计与架构首先,作者基于物理实验室空间的详细 CAD 模型创建了数字孪生模型。在设计 3D 模型时,考虑了机器布置和基础设施布局等关键建筑要素。Siemens NX 被用于开发实验室中所有智能制造设备和传统制造设备的 3D 模型,包括 Ultimaker S5 和 Stratasys F170 3D 打印机,以及用于复 制传统设备部件的 Mockpanel。3.3.2 渲染与用户交互在这一步中,CAD 模型被导入 Unreal Engine,并应用材料和表面属性以获得真实视觉表示。Unreal Engine 的材料库被用于为各种模型元素分配准确的物理属性,包括金属、塑料和反光表面。该过程通过 C++ 脚本和 Unreal Engine 插件实现,从而创建了高保真的数字孪生环境,使其在外观和尺度上接近真实实验室。此外,作者开发了自定义 C++ 脚本,用于管理孪生系统的数据处理和运行时数据更新。该系统能够以最小延迟处理双向通信。第 3.5 节将更详细说明这一双向通信功能。为了提供交互体验,数字孪生模型与由多 Agent LLM 框架驱动的自然语言界面集成,使操作人员能够通过语音命令或文本输入与系统交互,以检查机器状态、调整机器设置或请求诊断信息。系统通过数字孪生中的视觉更新和机器调整向用户提供即时反馈。3.4 面向人机交互的人工智能驱动头像本文在数字孪生环境中集成了 AI 驱动头像,以辅助用户进行语音交互。图 10 展示了数字孪生中 AI 驱动头像交互的工作流程,说明从初始用户语音输入到最终语音响应的逐步过程。交互从数字孪生麦克风捕获音频输入开始,随后使用 OpenAI 开发的先进语音识别模型 Whisper AI 对其进行处理。Whisper AI 将音频准确转录为文本,以理解语音命令。转录文本被发送到第 3.2 节所述的 LLM,并通过 LLM Agent 进一步处理。随后,LLM 生成文本回答,并借助 OpenAI 的文本转语音(Text-to-Speech, TTS)功能将其转换回语音。通过这种方式,头像能够以音频到音频的交互形式提供语音回答。数字孪生环境中的 AI 驱动头像是 MetaHuman 头像,提供视觉上真实且高度细节化的人物模型。该头像以静态模式作为人机交互的主要界面。 图 10:数字孪生系统中 AI 驱动头像交互流程3.5 双向通信与远程机器控制在数字孪生框架中,远程机器控制通过控制 Agent 实现。该 Agent 经过训练,能够通过调用预定义函数来执行机器操作。这些函数代表不同机器动作,控制 Agent 根据用户输入动态选择并执行合适函数。图 11 展示了基于命令库的机器控制 Agent 工作流程。 图 11:机器控制命令处理工作流3.5.1 命令库与函数映射作者创建了一个命令库,其中包含预定义的机器控制函数,每个函数对应特定机器操作。每个函数都被设计为修改特定机器参数。控制 Agent 使用该命令库进行训练,将用户命令映射到库中的合适函数。该 Agent 已经过微调,能够理解自然语言命令并将其与相关函数调用关联起来。为进一步增强这一过程,领域特定知识被加入训练集。例如,许多工业机器都有特定于公司流程的操作手册和校准指南。通过嵌入这些领域知识,控制 Agent 能够更好地确定应推送到数字孪生物理模型中的最优参数。这确保所建议的命令不仅在语法上正确,而且根据专有机器文档,在运行层面也是最优的。3.5.2 动态函数选择如第 3.5.1 节所述,控制 Agent 可以根据用户意图选择并调用正确函数。这一能力使系统能够解释自然语言命令,并无缝执行对应的机器控制函数。例如,当操作人员发出命令时,Agent 会解释该指令,从命令库中检索相关函数,并执行该函数,而不要求操作人员手动指定函数或参数。以 FDM 3D 打印机为例,如果操作人员发出“将打印头位置改为 (10, 15, 20)”的命令,Agent 会识别该命令对应函数change_head_position(x,y,z)。它会用给定坐标替换占位符,形成函数调用change_head_position(10,15,20)。这种动态函数选择使系统能够处理多种机器控制任务,而无需操作人员手动指定函数或参数。Agent 解释命令、从库中检索相关函数并执行。函数执行后,机器会向数字孪生发送实时反馈,确认请求动作已完成。这种由命令库和训练后控制 Agent 驱动的控制方法,使数字孪生环境中的机器操作更灵活、更实时,并提升运行效率和用户交互体验。在这一过程中,融入领域特定洞察非常关键。虽然预训练 LLM 可能基于通用知识提出看似合理的参数值,但本文系统通过微调并集成专有信息,确保控制命令反映物理机器的实际运行要求和最优性能标准。这种集成弥合了数字孪生仿真环境与物理世界之间的差距,使系统无需现场干预即可实现精确远程控制。IV. 结果4.1 数据采集数据采集系统有效地将传统设备和智能设备集成到数字孪生中,建立了统一、低延迟的数据流。为采集建筑环境传感器数据,系统部署了一套非侵入式摄像头设置(图 12a),直接从传感器显示屏捕获包含关键运行数据的感兴趣区域。利用基于 OpenCV 的算法,系统从这些视觉输入中提取颗粒物和二氧化碳水平等关键指标(图 12a)。对于 Mockpanel 中的传统设备部件,作者使用团队开发的计算机视觉工具包采集数据(图 12b)。随后,来自建筑环境传感器和 Mockpanel 的原始提取数据通过 MTConnect 协议进行标准化。完整采集和处理周期的平均延迟约为 1.3 秒,可满足接近实时的运行监测需求。相比之下,来自现代智能设备的数据,包括 Ultimaker S5(图 12c)和 Stratasys F170,则直接通过RESTful API 和 MTConnect 端点访问,从而进一步简化了采集流程。图 12:来自传统设备和智能设备的数据采集4.2 监督 Agent 性能本文在多个 LLM 模型上评估了监督 Agent 的任务分配性能,重点关注查询分类指标,包括精确率、召回率、F1 分数和准确率。如图 13 所示,微调过程(第 3.2.1.2 节)显著提升了模型性能,各项指标相较基础版本均有明显改善。微调后的 GPT-4o mini 在所有指标上获得最高分,尤其在精确率和准确率方面表现突出,显示出其在准确分类并委派多样化用户查询方面的鲁棒性。该模型达到接近最优水平,准确率和 F1 分数分别为 82% 和 92%,表明其能够可靠处理从数据可视化请求到复杂故障排查任务的广泛查询。这种高水平表现反映了监督 Agent 在数字孪生环境中管理任务分类的有效性,能够确保用户查询被准确路由到专用 Agent。图 13:GPT-3.5 和 GPT-4o mini 基础版本与微调版本在查询分类中的监督 Agent 性能对比4.3 多 Agent LLM 框架4.3.1 可视化 Agent可视化 Agent 为 IIoT 数据生成实时、上下文感知的可视化结果,使操作人员能够快速解释环境和运行条件。在该示例中,Agent 创建了一个饼图,用于展示声音传感器捕获的声音水平,并将其分为低、中、高三个不同等级。图 14 显示,低声音水平占 42.1%,中等声音水平占 26.3%,高声音水平占 31.6%。总结层在图表旁提供了文本解释,说明颜色编码的声音等级并总结数据分布。这种即时视觉反馈使操作人员能够快速评估传感器数据和环境条件,并做出知情决策。图 14:声音水平按高、中、低分类的饼图及文本摘要4.3.2 机器专家 Agent机器专家 Agent 使用 RAG 方法进行评估,评估重点是其处理复杂查询并提供专家级回答的能力。为此,本文采用两类评估:针对客观问题的数值准确率,以及针对主观、上下文相关任务的 LLM-Eval 分数。该评估方法遵循 Huang 等人的思路,即使用参数规模更大的 LLM 作为评估器,对较小模型生成的回答进行评估。对于准确率评估,作者向模型提出客观问题,例如“Ultimaker S5 的成型体积有多大?”以及“Ultimaker S5 的尺寸是多少?”这类问题可以直接、客观地评估模型检索并提供精确信息的能力。对于需要更深层上下文理解的主观任务,则由 GPT-4o 和 Gemini 评估生成回答的质量和相关性。本文使用多个语言模型评估机器专家 Agent,以确定最适合在数字孪生环境中提供专家级回答的模型。表 1 展示了各模型的性能,包括 GPT-4o mini、Mistral(7B)、Llama 3.1(405B)和 Mixtral 8x22B。为评估鲁棒性,每组实验使用相同问题池重复五次,确保观察到的变化主要来自模型自身随机性,而不是测试数据差异。Llama 3.1 的准确率最高,为 0.916 ± 0.038,GPT-4o mini 紧随其后,准确率为0.903 ± 0.036。此外,GPT-4o mini 在主观评估中表现更好,其 LLM-Eval 分数分别为 0.922 ± 0.047 和0.925 ± 0.020(分别由 GPT-4o 和 Gemini 评估),显示出其提供上下文相关回答的强大能力。基于多个指标上稳定且鲁棒的结果,本文选择 GPT-4o mini 作为机器专家 Agent。表 1:机器专家 Agent(基于 RAG)中不同语言模型的性能指标4.3.3 故障诊断与机器控制 Agent(案例研究:Ultimaker S5)为评估故障诊断与机器控制 Agent 的有效性,作者使用 Ultimaker S5 3D 打印机构建了一个受控实验。实验评估了该 Agent 诊断和解决 FDM 3D 打印中两个常见问题的能力:首层附着失败和表面粗糙。为测试目的,作者故意设置了错误打印参数,从而能够系统评估 Agent 基于实时数据识别并纠正这些问题的表现。首层附着不良问题通过将热床温度设为 45 °C 引入,该温度低于聚乳酸(Polylactic Acid, PLA)的最佳值。确保首层正确附着对于任何 3D 打印的成功都非常关键,因为首层构成整个结构的基础。Agent 分析打印机实时数据后,识别出热床温度不合适,并建议将其升至 60 °C,这是 PLA 确保良好附着的标准温度。确认调整后,打印质量显著改善。图 15 展示了故障诊断 Agent 的有效性,比较了 LLM 干预前后 3D 打印件质量的变化。图 15a 在同一零件中展示对比:“Before LLM”部分存在表面缺陷和不一致,而相邻的“After LLM”部分在实时错误纠正后质量显著提升。图 15b 显示,由于每层固有几何误差,正在打印的零件中仍然可能存在缺陷。在这种情况下,理想方案是暂停打印,并根据 LLM 建议的设计值重新开始。图 15c 显示在 LLM 反馈后完全重新打印的零件,初始错误已经消除。该结果表明,故障诊断 Agent 能够在生产早期发现问题并采取措施,从而提升打印质量并减少材料消耗。图 15:故障诊断与机器控制Agent 解决 Ultimaker S5 打印问题:(a)数字孪生中 LLM Agent 的界面通信;(b)基于 LLM 的实时 IIoT 数据改变对 3D 打印的影响;(c)基于 LLM 的 IIoT 数据改变对 3D 打印的影响4.4 数字孪生与头像交互本文评估了数字孪生系统展示来自智能设备和传统设备实时数据的能力,具体包括 Stratasys F170 和 Ultimaker S5 3D 打印机,以及包含传统机器数据的模拟面板。选择这些机器是为了测试系统处理多样化设备类型的能力,展示其跨现代技术和旧有技术的灵活性与兼容性,这对于集成制造环境至关重要。系统允许操作人员以 1 至 2 秒延迟在不同机器数据集之间切换,从而在单一界面中高效监测多台机器。图 16 展示了 Ultimaker S5 和 Stratasys F170 的数据叠加到数字孪生模型上的效果,包括热床和挤出机温度、打印机状态以及关键部件位置等实时指标。数字孪生还集成了带有 LLM 聊天机器人的头像,用于自然语言交互。该头像能够检索实时机器数据,并通过语音命令准确回答用户查询。例如,当用户询问 Ultimaker S5 当前状态时,头像能够立即检索并报告相关运行参数。图中还展示了聊天界面,记录会话历史并显示传统模拟面板的数据叠加。这一设置允许操作人员与机器数据交互、接收反馈并控制运行,从而增强数字孪生中的用户参与度。图 16:数字孪生环境中的实时数据叠加与头像4.5 计算成本与可扩展性除性能指标外,本文还评估了系统计算成本。GPT-4o-mini 的价格为每 100 万输入 token 0.150 美元、每 100 万输出 token 0.600 美元。在实验中,30 个查询的总成本为 0.12 美元,每个查询约包含 450 个输入 token,并产生约 3000 个输出 token。这意味着,对于相似长度的输出,约 1 美元可处理约 250 个查询。此外,音频处理成本(使用 OpenAI 的 Whisper 和文本转语音模型)为每 100 万字符 15.00 美元,本文样例查询成本约为 0.22 美元。在硬件方面,作者在配备 RTX 3070 图形处理器(Graphics Processing Unit, GPU)的标准桌面计算机上运行数字孪生模型。V. 结论与未来工作本文提出了面向工厂环境的多 Agent LLM 框架与数字孪生模型集成方案。该系统旨在提升运行效率,集成来自传统设备和智能设备的实时数据,并通过自然语言界面实现无缝监测、故障诊断和机器控制。由 LLM 聊天机器人支持的交互式头像允许操作人员使用语音和文本命令与机器交互,从而增强用户参与度。系统成功解决了常见 3D 打印问题,例如首层附着和表面粗糙,这表明该系统具有简化和优化制造过程的潜力。在未来研究中,扩展系统与更广泛工厂机床的接口能力,例如 CNC 机床和机械臂,将提高其在多样化制造环境中的灵活性。另一个关键探索方向是将机器学习(Machine Learning, ML)模型与 LLM 集成,从而实现更高级的诊断和预测性维护。此外,作者正在研究处理涉及多个 Agent 的复合查询的策略。关于监督 Agent 的早期工作显示出良好前景,该 Agent 能够分解复杂查询并协调多个 Agent。进一步地,未来工作还可以集成虚拟现实(Virtual Reality, VR),以提供沉浸式、实时的数字孪生可视化,并支持对机器参数进行交互式调整。编辑:肖鑫鑫校核:李正平、陈凯歌、赵栓栓、曹希铭、赵学功、白亮、任超、海洋、陈宇航、Tina、王金、赵诚、Kira、张优该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除来源:故障诊断与python学习

未登录
还没有评论
课程
培训
服务
行家
VIP会员 学习计划 福利任务
下载APP
联系我们
帮助与反馈