使用Python脚本创建1D单元代替MPC并导出INP文件后转换为BDF文件
- 作者优秀
- 从业CAX行业时间10年及以上/博士学历/特邀专家/独家讲师
- 平台推荐
- 内容稀缺
几个月前,对一个复杂天线进行模态分析,考虑到后续要将天线有限元模型以BDF文件格式交付上游,便在用Abaqus对天线进行建模之初,就留了后手:
1、在Abaqus中进行天线建模及模态分析,但将所有模型均放在1个part中,虽然建了近200个MPC,但提前在part中建好超过300个主从节点集 合(Node Set),且一对主从节点集 合命名有规律可循,便于后续跑Python脚本;
2、将Abaqus模型以不使用部件、装配的形式导出INP文件,使用Abaqus自带tonastran命令,将INP文件转换成BDF文件。
具体过程如下。
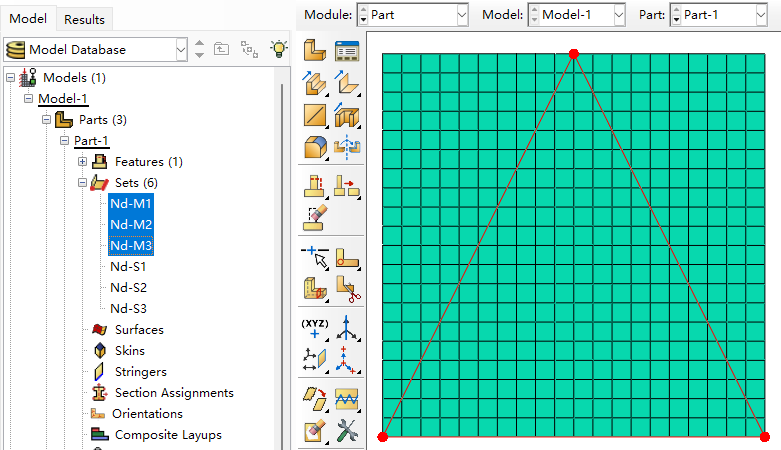
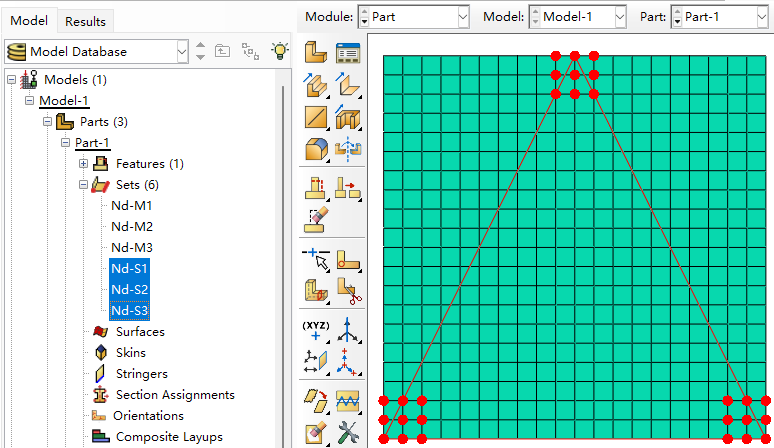
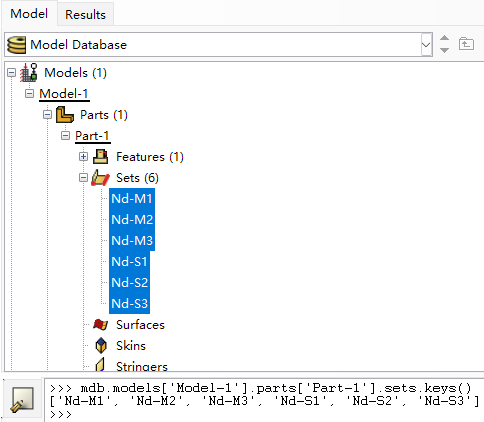
Step-1,准备模型,创建主从节点集 合。在Part-1中创建3个主节点集 合,每个节点集 合仅含一个节点;创建3个从属节点集 合,每个从属节点集 合包含多个节点;3主3从,一一对应。
Step-2,运行Python脚本,创建1D单元。
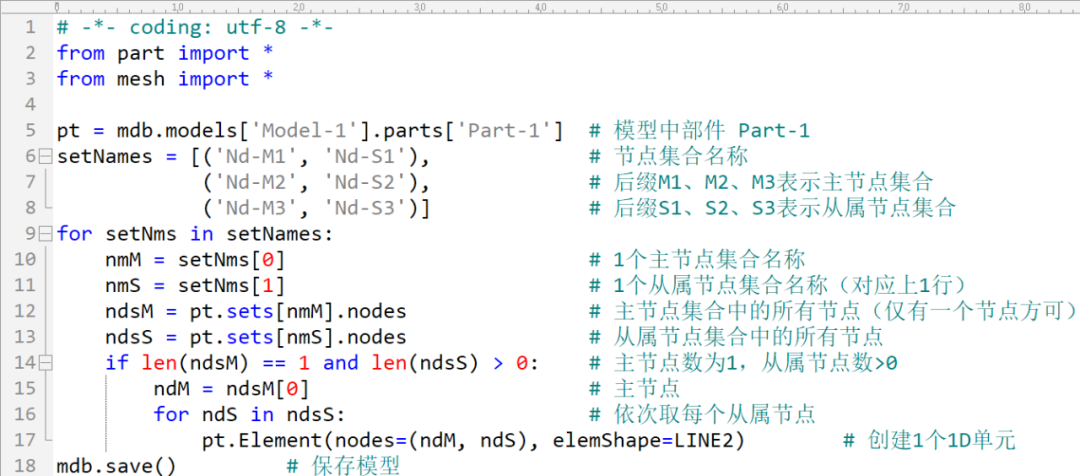
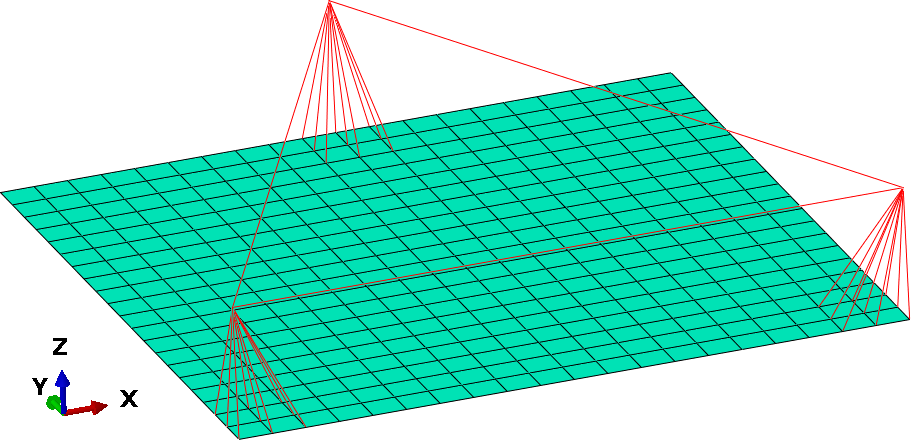
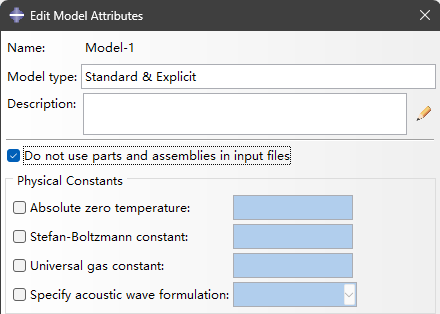
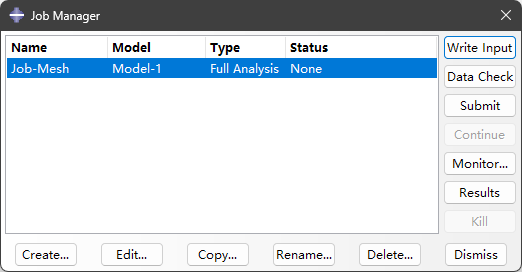
Step-3,设置模型属性,导出INP文件。单击Abaqus/CAE菜单栏Model→Edit Attributes→Model-1,在Edit Model Attributes对话框中勾选Do not use parts and assemblies in input files,即在INP文件中不使用部件、装配。在Job Manager对话框单击Write Input。
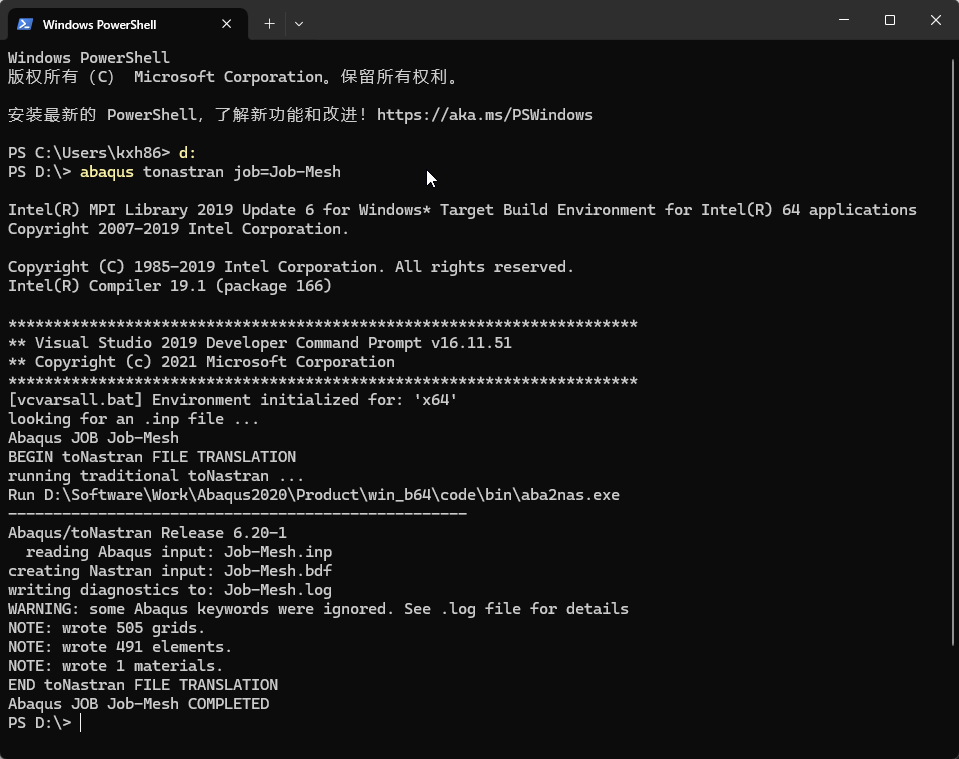
Step-4,INP转换为BDF。在Windows的CMD窗口或PowerShell窗口,将路径设置为INP文件所在文件夹,为简便,将INP放D盘根目录下。输入命令
abaqus tonastran job=Job-Mesh
INP文件不需带扩展名,回车,在INP文件同路径下生成同名BDF文件,完成模型转换。
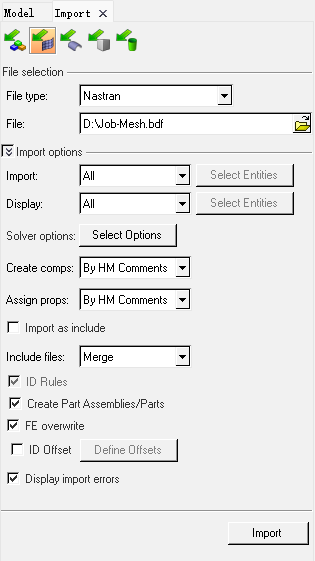
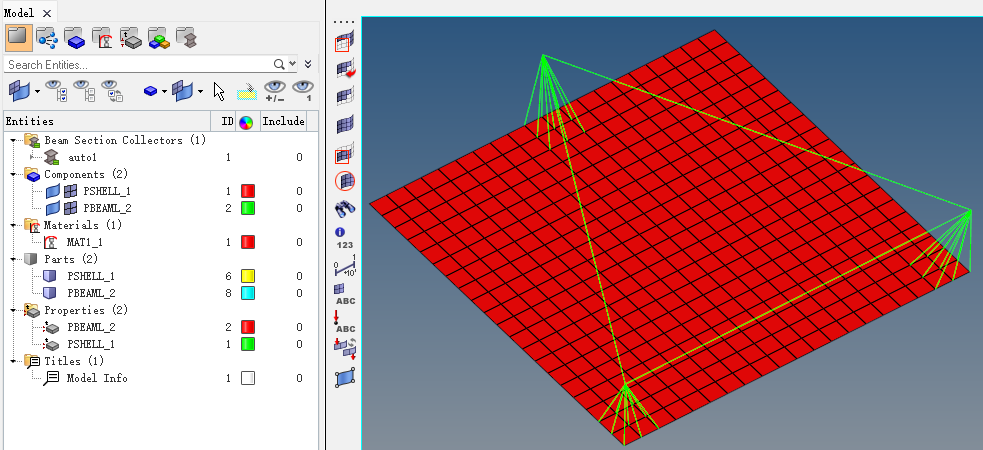
Step-5,在HyperMesh中查看转换后的模型。将BDF文件导入HyperMesh,可以进行模型查看、修改。有Patran的伙伴可以将BDF导入Patran看看。
啰嗦两句,节点集 合的名称怎么从模型中读出来,放到Python脚本中?
方法很多,最笨的一种方法仅需在Abaqus/CAE命令行接口输入一行Python语句如下。
>>> mdb.models['Model-1'].parts['Part-1'].sets.keys()
输出:['Nd-M1', 'Nd-M2', 'Nd-M3', 'Nd-S1', 'Nd-S2', 'Nd-S3']
对输出的节点集 合字符串列表加工一下就能用了。
The End!