首页/文章/ 详情

为什么 PDE 要研究弱解? —— 历史、动机与例子
44分钟前浏览7

微积分课上讲“微分方程”,有个很少有人点破的默认前提:未知函数足够光滑,方程里的每个导数都能逐点算出来。可偏微分方程(Partial Differential Equation,PDE)一进入高维,先出问题的往往就是这个前提。拿 Poisson 方程      来说,表面上至少得让      有二阶导数。那疑问就很自然了:假如      在某一点带个折角,或者流体速度在某个界面两侧跳了一下,方程是不是就没解了?

20 世纪的偏微分方程理论没有追求把所有解都证明得更光滑,而是退了一步思考:会不会是我们一开始就把解的门槛设得太高了?

这一退,诞生了现代 PDE 的基本语言。变分法、Sobolev 空间、守恒律、Navier–Stokes 方程、有限元方法(Finite Element Method,FEM),多少都建立在同一个思路上:逐点求导靠不住了,就把微分挪到一个光滑的测试函数身上,让方程以积分恒等式的形式继续成立。
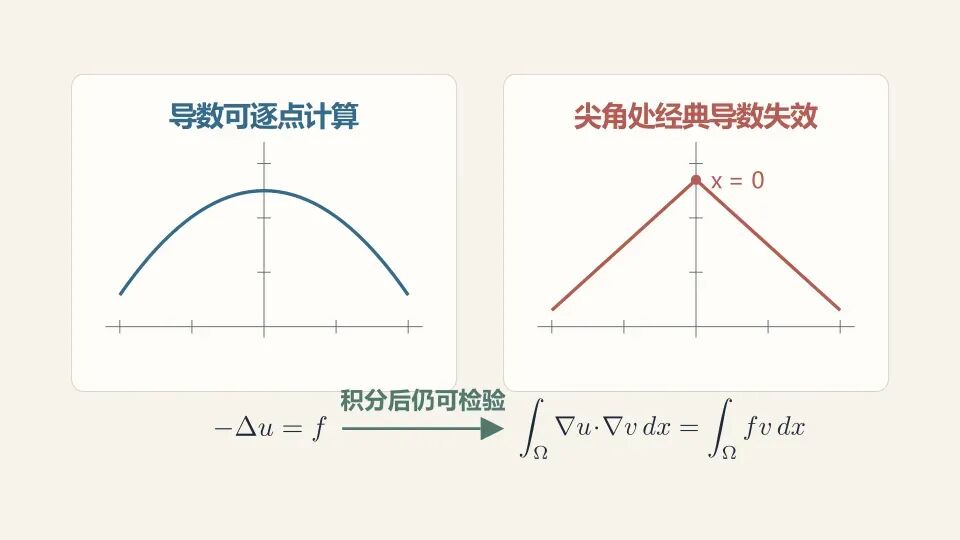
图 1:从光滑曲线到尖角函数——经典解要求方程在每一点都有意义;弱解把方程的检验转移到积分层面。  

“弱解”之前的存在性危机

弱解不是在某一天突然定义出来的。它更像 19 世纪末到 20 世纪上半叶几条线索慢慢交汇的结果,其中最早的一条来自 Dirichlet 原理。

考虑边界已经给定的 Laplace 方程     。与其硬解这个二阶 PDE,不如去找让 Dirichlet 能量


最小的函数。形式上,如果      是极小点,对任意边界上为零的扰动     ,把      代入能量、对      求导,就得到


假如      足够光滑,再分部积分一次,


就回到了     。

这条路看着优雅,可 19 世纪的人很快就撞上一个基础问题:能量有下确界,并不等于真有一个函数把这个下确界取到。

Dirichlet 原理在 19 世纪上半叶已被广泛使用,黎曼(Bernhard Riemann)就把它当作重要工具。魏尔斯特拉斯(Karl Weierstrass)随后指出,变分论证里不能把“存在一个越来越小的函数序列”直接当成“存在极小函数”。希尔伯特(David Hilbert)在 1900 年前后重新推动这类存在性问题,发展出直接法的思路:不先去解 Euler–Lagrange 方程,而是从极小化序列出发,证明它在某种合适意义下收敛,再证明极限仍然落在允许的函数集 合里。
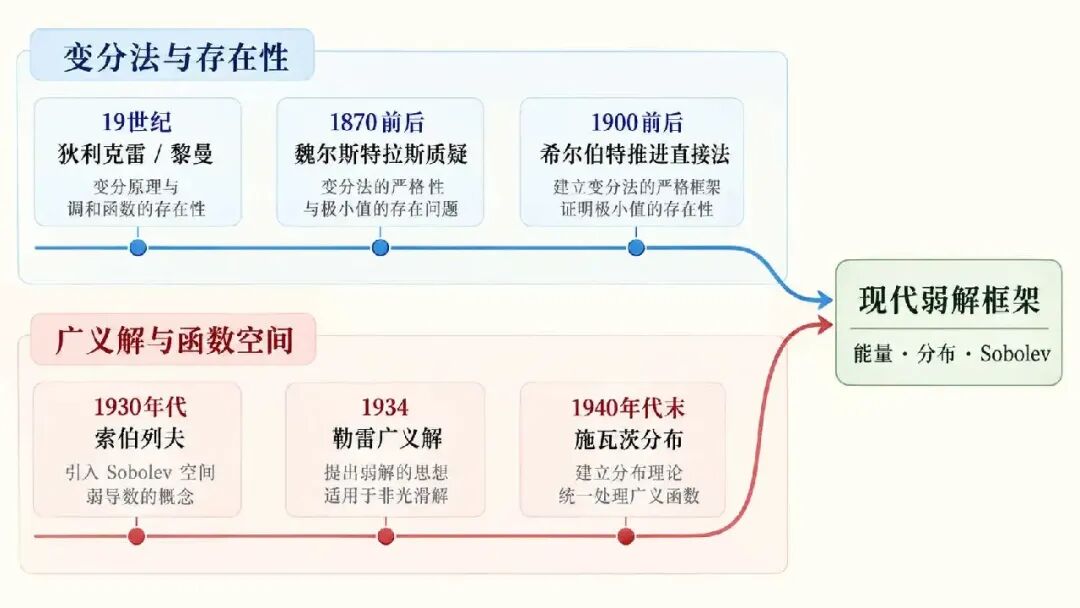
图 2:现代弱解框架的两条历史支线——弱解的形成来自变分法、广义函数与 PDE 存在性理论的共同推进,并非单一的“发明链”。  

麻烦于是换了一个方向:得找一个函数空间,够大,装得下极限;又有足够的结构,谈得了导数、边界值和能量。 顺着这个问题往下走,就是 Sobolev 空间。

一个经典解不存在的方程

下面用一个一维例子说明,“必须逐点二阶可微”这个要求有时没必要。

在区间      上考虑


其中      是集中在原点的单位点源,可以想象成所有外力都压在一个点上。

带这个边界条件的解很好写:    。它在      处有一个尖角,左半边斜率是     ,右半边斜率是     ,     都不存在,经典意义下的      更无从谈起。

要是规定“解”必须落在      里,这个问题无解。 但把方程乘上一个光滑、紧支撑的测试函数      再积分:


把左侧的一阶导数挪到测试函数上,


对      来说,左侧完全有意义:     除原点外只是两个常数,单个点不影响积分。直接算也能验证:


这里用到测试函数在端点附近为零。 原先在      处没法逐点解释的二阶方程,积分之后成了一个完全合法的等式。

弱解最朴素的动机就在这里:不必强迫未知函数具备方程表面上写出的所有经典导数,只要保住方程经过积分之后真正需要的那部分结构。
动图 3:尖角解如何进入弱形式——分部积分并没有“修复”尖角,而是把未知函数所需的导数阶数降低,把微分作用转移到光滑测试函数上。  

导数可以不逐点存在,但仍然可以被定义

上面的例子背后还有一个更普遍的想法。

如果函数      足够光滑,普通分部积分告诉我们


对所有      都成立。

现在把关系反过来:哪怕      没有经典偏导数,只要存在某个函数     ,使得


就把      叫作      的弱导数,记作     。

视角在这里换了一次。经典导数盯的是某个点附近的差商


弱导数不再逐点审问     ,改成让      和全体光滑测试函数做积分配对。测试函数本身足够光滑,导数放在它身上没有困难。

1930 年代,谢尔盖·索伯列夫(Sergei Sobolev)把广义导数和函数空间系统地接到了一起。今天最常见的例子是


其中      都按弱导数理解。

这个空间比      大得多,仍然带一个很好用的范数:


不少 PDE 的能量控制的恰好就是这种量。到这里,“物理上能量有限”和“数学上属于合适的函数空间”算是相当自然地接上了。

顺带澄清一个常见误解:Sobolev 的广义导数和后来 Schwartz 的分布不在完全同一个层级上。1940 年代末,洛朗·施瓦茨(Laurent Schwartz)建立起系统的分布理论,任何分布都能求导;Sobolev 空间在此之上还要求这些弱导数有一定的      可积性。做现代 PDE 时,可以按问题需要在这些层级之间来回切换。

从 Poisson 方程看弱形式“弱”在哪里

回到更普通的边值问题:


坚持经典解的话,通常要求      至少有像样的二阶导数,还得解释边界上的逐点取值。弱形式则从一个较光滑的假想解出发,把方程乘上测试函数     :


用 Green 公式,并令测试函数在边界上为零,


于是问题可以重新定义为:寻找     ,使得


这里其实变了两处。一是阶数:原方程里是      的二阶导数,弱形式只剩一阶。二是成立方式:方程不再要求每个点都成立,改成对所有测试函数      成立。

逐点条件换成积分条件,看着是放宽了,可“对所有      成立”留下的信息其实很多。一旦      事后被证明足够光滑,这个积分恒等式又能推回原来的 PDE。所以弱形式谈不上另起炉灶,它更像经典方程在低正则性环境里的延伸。

对很多椭圆型问题,存在性证明也因此简洁了不少。仍以 Poisson 方程为例,把左侧看成双线性型


右侧看成线性泛函


问题就变成     ,对所有      成立。

在合适条件下,Poincaré 不等式保证      能控制      中的范数,再配上 Lax–Milgram 定理,弱解的存在唯一性就得到了。

现代 PDE 的一个常用套路在这里很清晰:先在能量空间里找一个不那么光滑、但稳定存在的解,再去看它会不会有更高光滑性。后一半工作就是正则性理论。
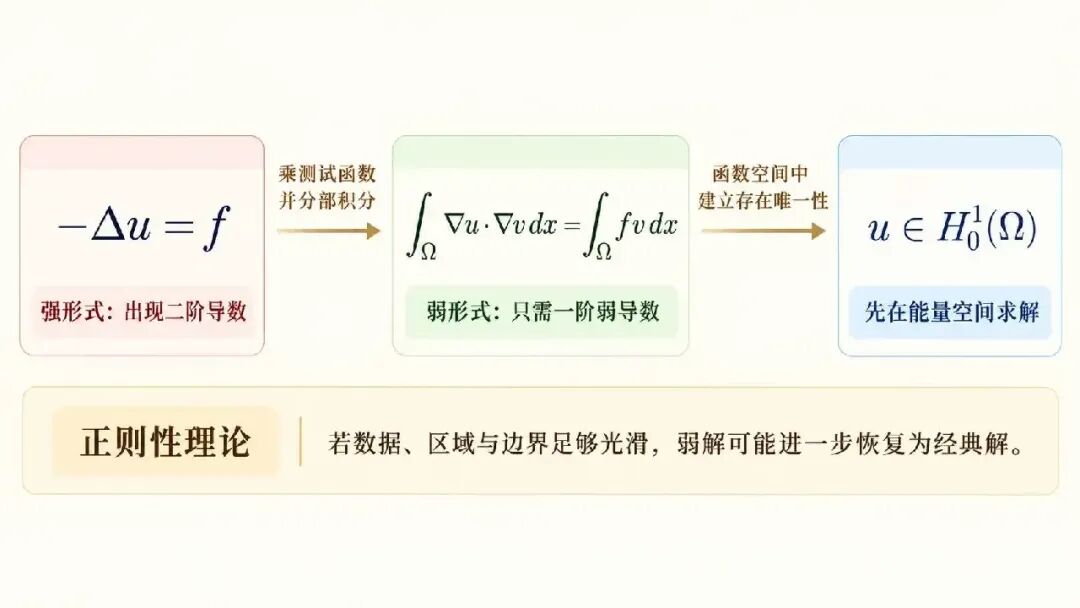
图 4:弱形式如何降低未知函数的导数阶数  

二阶椭圆方程的弱形式通常把未知函数所需的导数阶数从二阶降到一阶;额外正则性再决定弱解能否恢复为经典解。

有些 PDE 甚至不允许解一直光滑

假如弱解只是为了应付粗糙数据,它还当不上 PDE 的基础语言。更硬的动机来自非线性方程:有些系统哪怕从很光滑的初值出发,也会自己长出奇性或间断。

最典型的例子之一是一维守恒律


也就是无黏 Burgers 方程。

在经典解还光滑的那段时间里,它和


没有区别。问题是特征线的传播速度等于      本身:后面的特征线比前面的快,就会一点点挤上去,直到相交。经典导数可能在有限时间内爆掉,物理上看到的却是一个激波面。这个时候还坚持要经典解,方程就恰好在要紧的现象出现时失效。

守恒律本身更自然的说法,不是      和      各自存在,而是某个区域内“总量的变化等于穿过边界的通量”。把方程乘上测试函数并积分,得到弱形式


即使      带着跳跃,这个式子照样可以成立。
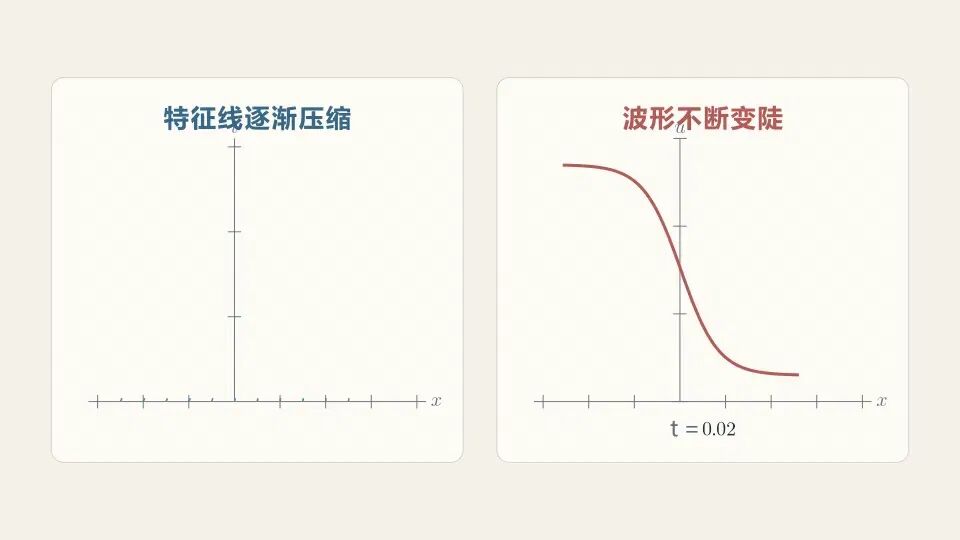
动图 5:Burgers 方程的特征线压缩与激波形成——即使初值光滑,非线性输运也可能让特征线压缩并在有限时间造成梯度爆破;之后必须用弱解并配合熵条件继续描述。  

麻烦也随之而来:弱解有时会太多。对非线性守恒律,光要求积分恒等式一般保证不了唯一性,还得加上熵条件,把不符合物理耗散方向的解排除掉。“寻找弱解”于是算不上理论的终点,很多时候只是第一步。

这也是为什么弱解并不自动等于“正确的物理解”。能量不等式、熵条件、适当性条件、辐射条件,不同方程要的额外结构不一样,最终正是这些条件筛出问题真正想描述的那类弱解。

为什么数值计算也离不开弱解

对做数值 PDE 的人来说,弱形式还有个很关键的身份:它是有限元离散的基础。

仍以 Poisson 方程为例。取有限维空间


令


要求


逐个取     ,就得到线性系统


也就是     。
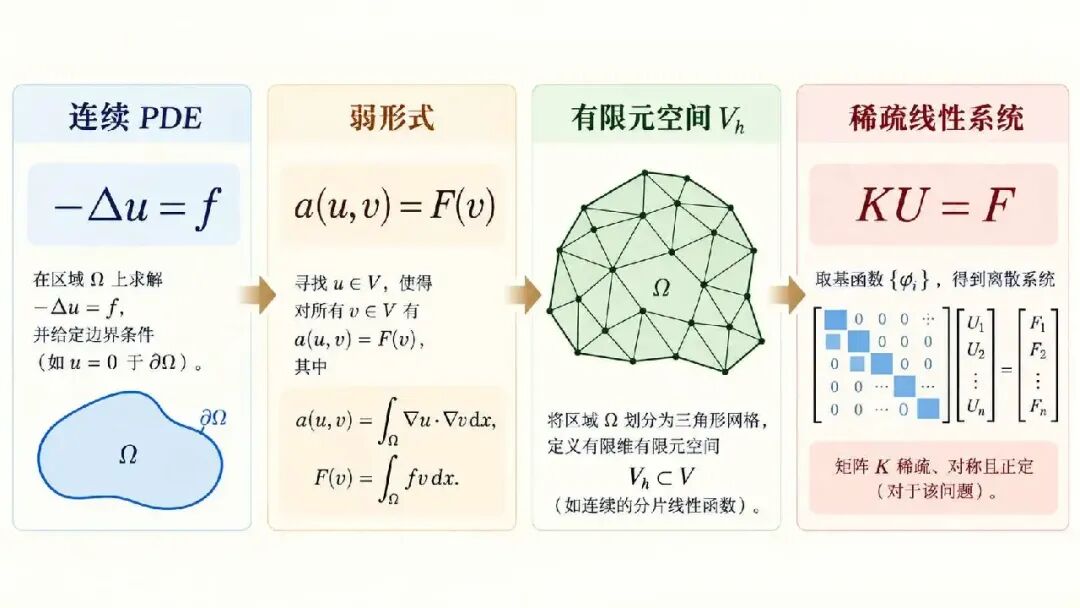
图 6:有限元通常从弱形式出发;刚度矩阵就是双线性型在有限维基函数上的坐标表示。  

弱形式的地位从这里看得出来:一头连着存在性理论、能量估计和 Sobolev 空间,另一头连着 Galerkin 方法和有限元矩阵。连续 PDE 与离散线性代数之间最常走的那座桥,就是弱形式。

“弱解”不是结论,而是一个起点

回到最初的问题:为什么 PDE 要研究弱解?

因为微分方程要描述的对象未必足够光滑。点载荷会造出折角,守恒律会造出激波,非线性流体里可能出现暂时排除不掉的奇性,极小化序列的极限也不保证还带着经典导数。把“每一点都能算出所有导数”写进解的定义,代价就是很多物理上自然、数学上稳定的对象从一开始就被排除在外。

弱解放松逐点微分的要求,同时尽量保住原方程经过积分、守恒和能量表达出来的那些关系。

更有意思的部分在下一步。有了弱解以后,可以接着问:它是不是其实更光滑?是否唯一?间断应该满足什么熵条件?奇性集中在哪里?数值离散能不能逼近这个弱解? 经典解与弱解因此上是互相竞争的两套理论,常见的分析路线是:


要是最后能证明      足够光滑,弱解就变回经典解;证明不了,弱形式也至少保证方程在光滑性失效之后,仍然有一套能分析、能逼近、能计算的语言可用。

参考文献

  1. L. C. Evans, Partial Differential Equations, 2nd ed., American Mathematical Society, 2010.


来源:有限元先生
非线性理论Mathematica控制
著作权归作者所有,欢迎分享,未经许可,不得转载
首次发布时间:2026-10-23
最近编辑:44分钟前
有限元先生
博士 我们穷极一生,究竟在追寻什么?
获赞 46粉丝 48文章 126课程 0
点赞
收藏
作者推荐

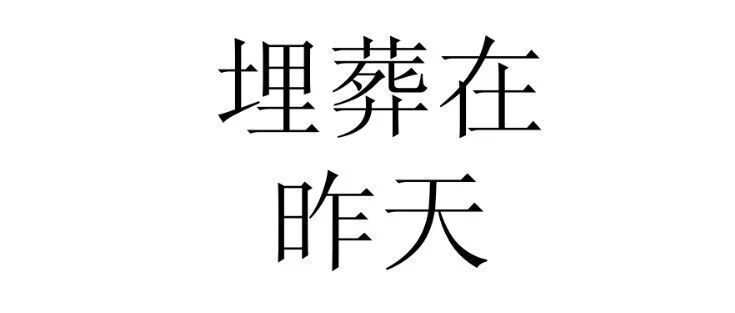
我不得不把才华埋葬在昨天

前几天,DeepSeek v4.1 发布了,将小模型能力的高度又向上推进了一个档次。AI 发展的速度远远超过了所有人的预期。从那个只会咿呀学语地聊天、上下文长度只有几千 token 的初版 ChatGPT,到具有推理能力的 OpenAI o1、DeepSeek R1 与 Kimi K1.5 Thinking,只不过短短两年;从推理模型到如今能够流畅地在各类 harness 工具中执行命令、完成复杂任务的智能体,也不过一年半。很难想象,倘若再等上一年、两年、三年,彼时的 AI 会成为什么样子,会有多么强大,会不会已经具备了自我进化的能力,并深度渗透进了具身智能等领域。AI 越来越会写算子了AI 在我所从事的算子设计、编写这一领域同样进步飞速,在短短一年的时间内,他已经从一个只能帮我查查文档、读读代码、找找 bug 的小助手,蜕变成了一位能够独立阅读 CUDA、PTX 与 SASS 编码、通过专业工具分析每条指令的停顿时间、进而独立优化算子的算子大师。相信在不久的未来,它也能拥有自己独立设计算子调度、评估不同调度方案的性能、将其实现并优化的能力。我当然为 DeepSeek v4.1 的成功而骄傲 —— 毕竟它的主 Attention 算子都是我写的 [1],它的优秀正是对我的算子的一份肯定。但是,时代的车轮滚滚向前,技术的发展无人能挡。我很清楚,再过上半年或者一年,AI 写的算子大概率就会和我写得同样优秀,甚至将我超越。AI 能一秒思考 300 个 token、半秒敲出一行命令、二十秒写完一份代码,而我不行;AI 能在模型深度、思考强度、工具调用量(和环境交互的频率)、甚至并行度等方面都能不断提升,而我不能。人类在毁灭自己这件事情上,自古以来都表现得毫不犹豫。为什么在明知“我算子写得越好,我们的新模型的训练、推理速度就会越快,模型能力进步就会更快,我就会更早地被取代”的情况下,我仍然选择尽力优化算子呢?一方面确实是因为写算子对我来说就像打游戏一样,能为我提供极大的快 感。我在发明了一种新技术、或者看到自己算子的性能上升的那一刻,心中的激动程度不亚于游戏的速通玩家打破了自己过往的记录。同时,当看到自己的算子的性能远超厂商官方的算子时,我心中也会萌生极大的自豪感。但除此之外,一个更重要的原因是,哪怕我就此“摆烂”甚至故意下绊子耽误模型训练,其它家的模型也会照常发展并最终将我照杀不误。“我当然希望自己不要被革命,但如果非被革命不可的话,我希望革我自己命的人是我自己”。在大家都这么执着于毁灭自己的时候,我也不得不加入这场残酷的军备竞赛。那我呢等到 AI 写算子的水平真的高于我的那天,届时的我会怎么样呢?我的判断是:我不至于会“失业”,但必须要“转业”。我的饭碗尚且能保住,但这可能会导致我再也没机会从事那份我曾热爱过的工作。我曾经对时代的变化与我个人在未来的处境做出过一个判断:由于时代变化真的太快(上文的 AI 发展就是一个很好的例子),我完全无法预知五年、十年后会发生什么,但不论如何,我相信凭借着自己的眼界、判断力、主观能动性与智力,留在时代的牌桌上,并重新立于时代的潮头。但是,这个判断只能保证我不会“失业”,而无法保证我不需要“转业”,倒不如说这个判断鼓励我通过转业来避免失业。那转业代表什么呢?它代表着我需要放弃我深耕已久并充满热爱的算子设计、编写、优化领域,转而去做 Agent 的“机甲驾驶员”。在之前,我的兴趣、我所擅长的、以及工业界所需要的,三者是基本对齐的;而现在,AI 让我所擅长的变成了它更擅长的,也让工业界的需求从“会写高性能算子的人”漂移到了“能用 AI 更快地产出高性能算子的人”。为了适应工业界的需求,我势必要放弃之前那个我热爱的方向,转向一个未知的新方向。我相信我能凭借着自己对于工程学、上层模型需求和底层硬件的理解,继续高质量、高效率地产出算子,我也知道我可能会热爱这个新方向(也可能不会),但被夺走热爱的感觉,确实不太好受。那份坐在工位上静心写上一下午算子的清欢,可能会在这个夏天成为绝唱。我不得不把才华埋葬在昨天,去做一位机甲驾驶员。我的手中多了些齿轮,但心中少了些节拍。可以打个形象的比方:你精通织毛衣技术,尤其擅长各种图案的织造与各色 色彩的搭配。你所织出的毛衣质量过硬且花纹美观,十里八乡的富人都来请你为他们织毛衣,你借此赚到了不少钱。同时,你十分享受着那种坐在窗边,沏一壶清茶,望着窗外的青山、绿水、牛羊与炊烟,静静地织上一下午毛衣的感觉。但有一天,有人发明出了一台神奇的机器,只需提供毛线与图案,便可自动织出毛衣,质量与纹理都不亚于你亲手织造的,且速度远快于你。你很清楚,你的同行可以凭着这台机器轻松达到你曾经的水平,因此你不得不也去用它。你也知道,凭借着你过去二十年攒下的织毛衣技术,哪怕大家都有机器,你织毛衣的速度与质量也还能超过同行。但那份临窗听雨、引针穿线、慢度光阴的意趣,终究还是被机器的轰鸣碾碎了。我知道这很无奈,但没办法。饭碗可以保住,但旧日的热爱大概率是要放弃的。我是一个理性和感性分离得比较开的人,在需要用理性处理问题时可以很理性,但有时也会表现出感性的一面。我记得我在搬离住了一年的出租屋时,还大哭了一场,舍不得和过去的记忆分别。今天和之前那个手写算子、人脑优化的时代告别,无疑比这更加残酷。不知道有没有读者有类似的感受,但我想这事儿也只能这样了。那人们呢在 AI 不断进步的同时,我也对一些问题表示担忧:现在的学生是不是大概率会更倾向于使用 AI 完成作业,特别是偏向于实践的各种 Lab?想象一下,如果面前有两个选择,一个是苦哈哈地用八小时时间完成一个 Lab,或许还拿不到满分;另一个则是启动 AI 模型,用几毛钱的成本、几分钟的时间,直接让 AI 编写满分代码,那大部分学生会选择哪个呢?上面一点会导致大量学生的工程能力严重不足,包括组织代码的能力、构建系统的能力、思考未来潜在需求并提前在设计上应对的能力、抽象的能力等等。那么在 AI 能力不断变强的背景下,这部分“工程能力”是否还是必须的呢?这些工程能力是会向旧日的“熟练编写 x86 汇编”的能力那样逐渐被时代抛弃,还是会像“理解从软件到系统再到硬件的整套计算机系统”的能力那样永远具有价值?如果是后者的话,那就危险了 —— 一个工程能力很差的人,在搭配上 AI 后,产出屎山的效率可以达到先前的数倍,进而给系统埋下各式祸患,让这个世界变得更加草台。在未来社会中,权力(power)是不是会比技术或智商更加重要?这些问题,或许就需要时代本身来回答了。结语伴随着 AI 的发展,未来的社会可能会趋向于两个极端:共产主义与赛博朋克 2077。在前者中,生产力得到极大的解放,人们的生活水平有了明显的提高(就写这些吧不然我怕过不了审);而在后者中,少数科技公司控制着大部分资源,只有极少数人能够使用最先进的 AI 和各式科技,获得接近“机械飞升”的效果,大部分人则只能用上很孱弱的 AI。阶层跨越将越来越难实现:你得先有最强的 AI,才能跨越阶层,形成了一种死循环。你猜猜如果 Anthropic 公司永远掌握着这个世界上最先进的 AI,未来社会是会变成共产主义还是 2077 呢?你猜?所以,我还是相信,最前沿的智能应该以一种开放、廉价的方式,供应给所有人。我不信任 Anthropic 或者 OpenAI 能这样做,特别是不希望 Anthropic 掌握最先进的人工智能或 AGI,夸张点说其严重性不亚于让希特勒先于盟军掌握原子弹技术。这也是为什么我选择并坚持留在了 DeepSeek:我们研究强大、快速、普惠的人工智能并将其开源,或许能把世界从 2077 那端拉回来一些。愿未来的世界一切安好。May all the beauty be blessed.[1] “主 Attention”仅包括 head dim = 512 的 MQA attention,不包括用于选出 top-k 重要的 token 的 indexer,那部分是由其他(水平也非常强的)同事(以及他们的 AI Agent)编写的。来源:有限元先生

未登录
还没有评论
课程
培训
服务
行家
VIP会员 学习计划 福利任务
下载APP
联系我们
帮助与反馈