
2-51 针对296 组煤气炉数据,怎样用 IFP-FCM 识别一个 6 规则 T-S 模糊模型?
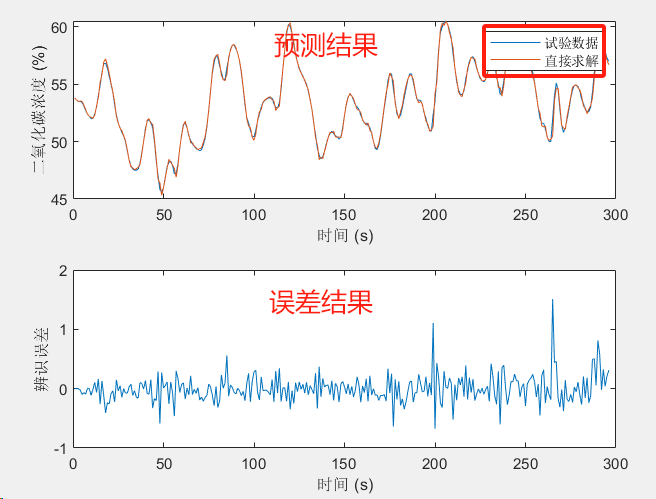
MATLAB IFP-FCM 改进模糊聚类 + Box-Jenkins 煤气炉 T-S 模糊模型辨识程序
一句话介绍: 这套 MATLAB 程序读取 box_data.mat 中 296 组煤气炉输入/输出数据,先构造由当前输入、历史输入和历史输出组成的 6 维动态回归向量,再用 IFP-FCM 把输入空间划成 6 个模糊区域,最后把隶属度嵌入线性回归,得到 6 条 T-S 局部规则的结论参数,并输出模型拟合序列与辨识残差。
先看它解决什么问题
Box-Jenkins 煤气炉数据不是一个“把 x 代入公式就得到 y”的静态问题。当前输出不仅和当前输入有关,还和前面若干时刻的输入、输出状态有关。
如果只用一个全局线性模型,很难同时描述不同工作区域下的局部关系;如果直接用普通 FCM 做前提聚类,又可能得到重叠较宽的模糊分区,使多条局部规则在较大范围内同时参与输出。
当前程序采用的思路是:
煤气炉原始数据 → 6 维滞后回归向量 → IFP-FCM 前提聚类 → 6 组隶属度 → T-S 加权回归矩阵 → 最小二乘结论参数 → 拟合输出与辨识误差
其中最关键的改动不是换一个聚类中心公式,而是重新定义隶属度更新方式,让样本更倾向于归属于离它最近的局部区域,同时保留模糊边界。
1. 当前工程里真正有哪些文件?
项目编号为 51,工程名为 matlab_IFP_FCM。压缩包中的主链非常清晰:一个 IFP-FCM 主函数、三个子函数、一份煤气炉辨识示例、一份数据和一篇配套论文。
文件 | 当前作用 |
|---|---|
IFP_FCM.m | IFP-FCM 主函数,管理参数、迭代和停止条件 |
initifp_fcm.m | 随机初始化隶属度矩阵,并把每个样本的隶属度归一化到和为 1 |
stepifp_fcm.m | 更新聚类中心、距离、隶属度和目标函数 |
distifp_fcm.m | 计算样本到各聚类中心的欧氏距离 |
IFP_FCM_T_S_box_test.m | Box-Jenkins 煤气炉数据的 T-S 模糊模型辨识主示例 |
box_data.mat | 296 × 2 的煤气炉输入/输出数据 boxco2 |
Improved fuzzy partitions for fuzzy regression models.pdf | IFP 思路的配套论文资料 |
真正需要直接运行的是 IFP_FCM_T_S_box_test.m,其余 .m 文件由它调用。
2. 296 组原始数据怎样变成 6 维模型输入?
box_data.mat 中只有一个变量 boxco2,尺寸为 296 × 2。当前脚本把第一列作为输入 u,第二列作为输出 y,其中绘图标签把输出解释为二氧化碳浓度。
为了描述动态过程,程序不是只用当前 u(t),而是构造 6 个输入量:
u(t)、u(t-1)、u(t-2)、y(t-1)、y(t-2)、y(t-3)
于是原始 2 列数据被转换成一个 296 × 6 的回归矩阵 x。
这里有一个很实际的源码细节:x 先用 0 初始化,因此开头几行没有历史样本的位置会被补 0。也就是说,前 3 个样本的部分滞后项并不是真实历史测量值,而是当前脚本人为补出的初始值。
另外,脚本使用 t=1:n 生成横轴,同时把横轴标成“时间 (s)”。工程中没有另外提供采样间隔,因此更稳妥的理解是:这里首先是 1~296 的样本索引,不能仅凭当前源码断言相邻两点严格间隔 1 s。
3. IFP-FCM 和普通 FCM 最关键的区别在哪里?
当前代码仍保留了 FCM 的一个核心结构:聚类中心由隶属度平方加权得到,相当于固定使用 m=2 的中心更新方式。
对第 i 个聚类中心,可以概括为:
vᵢ = Σⱼ(uᵢⱼ²xⱼ) / Σⱼuᵢⱼ²
真正的改进发生在隶属度更新。
对样本 j,先计算它到所有中心的平方距离,并找出最近中心的平方距离 dminⱼ²。当前程序再定义一个临时权重:
wᵢⱼ = 1 / [dᵢⱼ² - dminⱼ² + ε]
最后归一化:
uᵢⱼ = wᵢⱼ / Σₖwₖⱼ
这里的 ε 就是源码中的 fuzzy_degree。
这组关系很直观:距离最近的中心,其分母直接变成 ε;其他中心还要额外加上“比最近中心多出来的平方距离”。因此最近中心通常会得到更高的隶属度,模糊分区也会更接近清晰的局部区域。
配套论文把这种构造进一步解释成一种接近 Voronoi 分区的模糊化方式。当前 MATLAB 代码并没有显式创建 Voronoi 图,而是直接通过“平方距离减去最小平方距离”的形式实现这一效果。
4.fuzzy_degree=0.1 到底控制什么?
测试脚本使用:
options = [100; 1e-5; 1; 0.1]
其中最后一个值 0.1 就是 IFP-FCM 新引入的模糊度参数 ε。源码注释给出的建议范围是 0.01~0.2,但函数本身并没有对这个范围做强制校验。
从隶属度公式可以直接看出它的作用:
ε 越小,最近中心的权重优势越明显,分区更接近清晰划分;
ε 越大,各中心之间的权重差异被压缩,边界会更模糊;
ε=0.1 是当前示例的默认实验值。
需要特别区分:这个 fuzzy_degree不是传统 FCM 中的指数型模糊因子 m。当前中心更新仍然使用 U.^2,也就是平方隶属度;fuzzy_degree 只参与 IFP 的距离基准和隶属度更新。
5. 一次 IFP-FCM 迭代具体经历什么?
IFP_FCM.m 的主循环可以压缩成一条链:
随机初始化 U → 计算新中心 → 计算欧氏距离 → 更新 IFP 隶属度 → 计算目标函数 → 判断是否停止
当前测试参数规定:
最大迭代次数:100;
相邻两次目标函数变化阈值:1e-5;
迭代信息显示:开启;
模糊度 ε:0.1。
initifp_fcm.m 使用 rand 生成初始隶属度,再按列归一化,因此每个样本对 6 个聚类的隶属度之和为 1。
这也带来一个必须如实说明的复现条件:当前脚本没有固定随机种子。 因此不同 MATLAB 会话或不同随机状态下,初始 U、聚类迭代轨迹、最终中心和实际迭代次数可能有所不同。
项目说明把 IFP-FCM 定位为改善传统 FCM 对初值敏感、收敛慢和局部极小等问题,但当前工程没有提供普通 FCM 的对照脚本,也没有固定种子做重复统计,所以不能把“速度提升多少”或“完全消除初值影响”写成当前程序已经量化证明的结果。
6. 为什么这里最终会得到 6 条 T-S 模糊规则?
测试脚本设置:
r=6,表示每个样本有 6 个动态输入变量;
c=6,表示 IFP-FCM 把输入空间划成 6 个聚类,也就是 T-S 模糊模型使用 6 条规则。
聚类完成后,U 的尺寸为 6 × 296。其中第 i 行就是第 i 个局部区域对全部 296 个样本的隶属度。
因此,IFP-FCM 在这套程序里承担的是 T-S 模型前提部分的结构辨识:它决定每个样本应该由哪些局部规则参与解释,以及参与程度有多大。
7. 6 条规则的结论参数是怎样求出来的?
当前 T-S 结论部分采用一阶线性局部模型。每条规则都包含:
1 个常数项 + 6 个输入系数 = 7 个结论参数
6 条规则合计就是:
6 × 7 = 42 个参数
这正是脚本构造 xx 矩阵的原因。每个样本的一行由两部分组成:
6 个规则隶属度 + 6 组“隶属度 × 6 维输入”
所以 xx 的尺寸是 296 × 42。
整个 T-S 输出可以概括为:
ŷ(t) = Σᵢ₌₁⁶ uᵢ(t) · [βᵢ₀ + Σₖ₌₁⁶ βᵢₖxₖ(t)]
脚本最后通过普通最小二乘求出 42 维参数向量。源码写法是:
β = (XᵀX)⁻¹Xᵀy
在程序里,这个结论参数向量仍然命名为 a。它和 stepifp_fcm.m 内部用于 IFP 距离修正的临时变量 a 只是同名变量,作用完全不同。
8. 程序最后输出的“结果”应该怎样理解?
结论参数求出后,程序直接计算:
y_d = xx*a
然后给出两类最直接的结果:
原始输出 y 与模型输出 y_d 的重合情况;
辨识残差 y-y_d 的变化情况。
IFP_FCM.m 本身还返回:
center:聚类中心;
U:各样本的模糊隶属度;
obj_fcn:实际迭代过程中的目标函数序列。
这里最重要的边界是:同一批 296 个样本既用于聚类和最小二乘参数辨识,也用于生成y_d和残差图。 当前脚本没有训练集、验证集和测试集划分,也没有独立预测段。
因此,这里的误差图应当理解为 建模样本上的拟合残差,不能直接当成未知数据上的泛化误差或预测精度。
9. 为什么这种组合适合当前煤气炉辨识问题?
首先,6 个滞后变量把动态系统的短期历史状态带进了模型,不再把煤气炉过程当成纯静态映射。
其次,IFP-FCM 把 6 维输入空间划成若干局部区域,让不同区域可以拥有不同的线性结论模型;这比只用一个全局线性关系更适合表达分段变化的非线性过程。
再次,IFP 的隶属度更新会强化离最近局部区域更近的样本,使单条局部规则在其主要作用区域内更突出,同时在区域边界仍保留连续的模糊过渡。这正适合 T-S 模型“局部线性、整体非线性”的结构。
但当前工程没有提供普通 FCM、神经网络或其他系统辨识方法的同数据对比,因此这里只能说明 结构上为什么匹配,不能宣称当前代码已经实验证明它在精度或速度上必然优于所有替代方法。
10. 它适合用在哪里?
IFP-FCM 算法教学与参数实验
这套工程把初始化、距离计算、隶属度更新、目标函数和停止条件全部拆成独立 .m 文件,很适合观察 fuzzy_degree、聚类数和初始隶属度怎样改变模糊分区。
T-S 模糊系统辨识教学
示例从动态输入构造、前提聚类、规则隶属度到结论最小二乘全部串通,可以直接理解“数据怎样变成 6 条 T-S 规则”。
小规模离线动态数据建模
如果用户自己的数据同样是已经采集完成的输入/输出序列,并且可以明确构造有限阶滞后变量,这套两阶段流程可以作为离线模型辨识和方案验证的起点。
它当前并不是实时在线辨识平台,也没有交叉验证、独立测试集、自动阶次选择、规则数优化或在线参数更新模块,因此更适合教学、实验和前期方法验证,而不是直接当作完整工业部署系统。
11. 换成自己的数据时,最需要注意什么?
第一,当前示例把 r=6 和 c=6 同时设为 6,而且 stepifp_fcm.m 复 制内部向量时使用的是 size(center,2)。因此当前煤气炉示例能够正常对齐,但如果直接把“聚类数”改成与“特征维数”不同的值,这一行可能造成矩阵维度不匹配。所以现有IFP_FCM函数并不能在不检查源码的情况下直接视为任意维数、任意聚类数的通用实现。
第二,滞后输入是手工构造的。换数据时不仅要替换 box_data.mat,还要重新确认输入列、输出列、滞后阶数和前几行的初始处理方式,不能只改文件名。
第三,结论参数采用 inv(xx'*xx)*xx'*y 直接求正规方程逆矩阵,没有正则化或病态矩阵保护。数据高度相关或样本不足时,可能出现数值不稳定甚至不可逆问题。
第四,当前 IFP_FCM.m 注释把 center 描述成 cluster_n × 1,但对多维数据实际返回的是 cluster_n × 特征维数。二次开发时应以实际矩阵运算为准。
12. 哪些参数最值得修改?
当前程序里真正值得做实验的参数主要集中在聚类结构、模糊程度和停止条件,而不是绘图设置。
参数 | 当前值 | 为什么值得改 | 调整后的主要影响 |
|---|---|---|---|
c | 6 | 决定 T-S 规则数量 | 增大可细分更多局部区域,但参数量和过拟合风险也会上升;当前源码还存在 c 与特征维数的耦合问题 |
fuzzy_degree | 0.1 | 直接控制 IFP 隶属度的清晰/模糊程度 | 变小更接近清晰分区,变大则规则过渡更柔和 |
max_iter | 100 | 限制聚类最多迭代次数 | 增大可给未收敛任务更多迭代机会,但计算时间增加 |
min_impro | 1e-5 | 决定目标函数变化多小时提前停止 | 阈值更小通常要求更严格收敛,也可能增加迭代次数 |
如果要改变滞后阶次,不应只修改 r;还必须同步重写 x 的构造和后面的加权回归矩阵结构。
13. 怎么运行?
把压缩包中的 .m 文件和 box_data.mat 放在同一个 MATLAB 当前目录或已经加入路径的位置,然后直接运行:
IFP_FCM_T_S_box_test
主脚本会自动加载 box_data.mat,构造 296 × 6 输入矩阵,调用 IFP_FCM 完成 6 类聚类,再构造 296 × 42 的 T-S 回归矩阵并求结论参数。
当前测试脚本把 options(3) 设为 1,因此命令行会打印每一次迭代的目标函数信息;迭代结束后会绘制原始输出与拟合输出,以及辨识残差。
从当前源码依赖看,核心算法没有调用 MATLAB Fuzzy Logic Toolbox 的 fcm,IFP-FCM 所需函数已经全部包含在工程中。换电脑运行时最重要的是保证这几个 .m 文件与 box_data.mat 可被 MATLAB 找到。
需要复现实验时,建议先显式设置随机种子,否则 initifp_fcm.m 中的 rand 会让不同运行拥有不同初始隶属度。
14. 一句话看懂这个项目
这是一个IFP-FCM + T-S 模糊模型辨识程序:它读取 296 × 2 的 Box-Jenkins 煤气炉数据,构造 u(t)、u(t-1)、u(t-2)、y(t-1)、y(t-2)、y(t-3) 六维动态输入,用 6 类 IFP-FCM 生成前提隶属度,再把 6 条规则的隶属度与 6 维输入组合成 296 × 42 回归矩阵,通过最小二乘得到 42 个 T-S 结论参数,最终输出拟合序列和辨识残差;当前实现更适合算法教学、离线系统辨识和前期方法验证,使用时尤其要注意随机初始化、同数据拟合与评价、滞后项零填充以及聚类数与特征维数的源码耦合。


