跑ANSYS总崩、求解慢?学生党工作站别乱买:核数、内存、显卡、算例规模对照表
做仿真的人基本都踩过同一个坑:花大价钱买了“高配”,结果ANSYS一提交求解就崩,或者核数拉满但速度没快多少。问题往往不在钱花得少,而在配置思路错了——把游戏本逻辑、跑分逻辑套到CAE上,天然会翻车。
下面按“为什么会崩→CPU怎么选→内存怎么估→显卡值不值→算例规模对照表→学生三档配置”讲清楚。顺带说一句,仿真这件事“硬件只解决一半问题”,模型简化、网格、求解器设置不对,再贵的机器也救不了。
一、ANSYS总崩、慢,先查这5个原因
1)内存不够,被迫走磁盘交换
隐式结构求解对内存极敏感。经验口径:每百万自由度约需1–1.5GB内存,具体随单元类型、求解器和算法变化;内存不足时会用磁盘做临时空间,速度会断崖式下降,严重时直接内存溢出崩。能incore(全进内存)就别out-of-core。
2)核数开太多,并行效率反降
ANSYS支持SMP/分布式并行,但不是“核越多越快”。小模型用很多核,通信开销比计算还大;Workbench里还受物理核数、许可证核数、超线程设置影响。一般建议关超线程、按物理核设并行,别直接填逻辑核数。
3)显卡买错,前处理卡、求解不提速
很多学生买“游戏显卡”跑大装配,画图转视角卡、显存爆;但又把“显卡”当成求解加速主力,结果Fluent/结构某些求解器根本没用到GPU。显卡在ANSYS里分“显示”和“计算加速”两件事,买前必须分开看。
4)硬盘I/O成瓶颈
分布式求解会写多组临时文件,机械盘、慢SSD、C盘空间不足都会让求解变慢甚至报错。中大模型建议NVMe SSD放临时目录,DMP场景对随机读写更敏感。
5)模型本身不合理
网格过密、接触对过多、非线性步长太小、无必要用高阶单元,都会让硬件投入打水漂。学生作业崩,很多时候是先建模问题,不是先硬件问题。
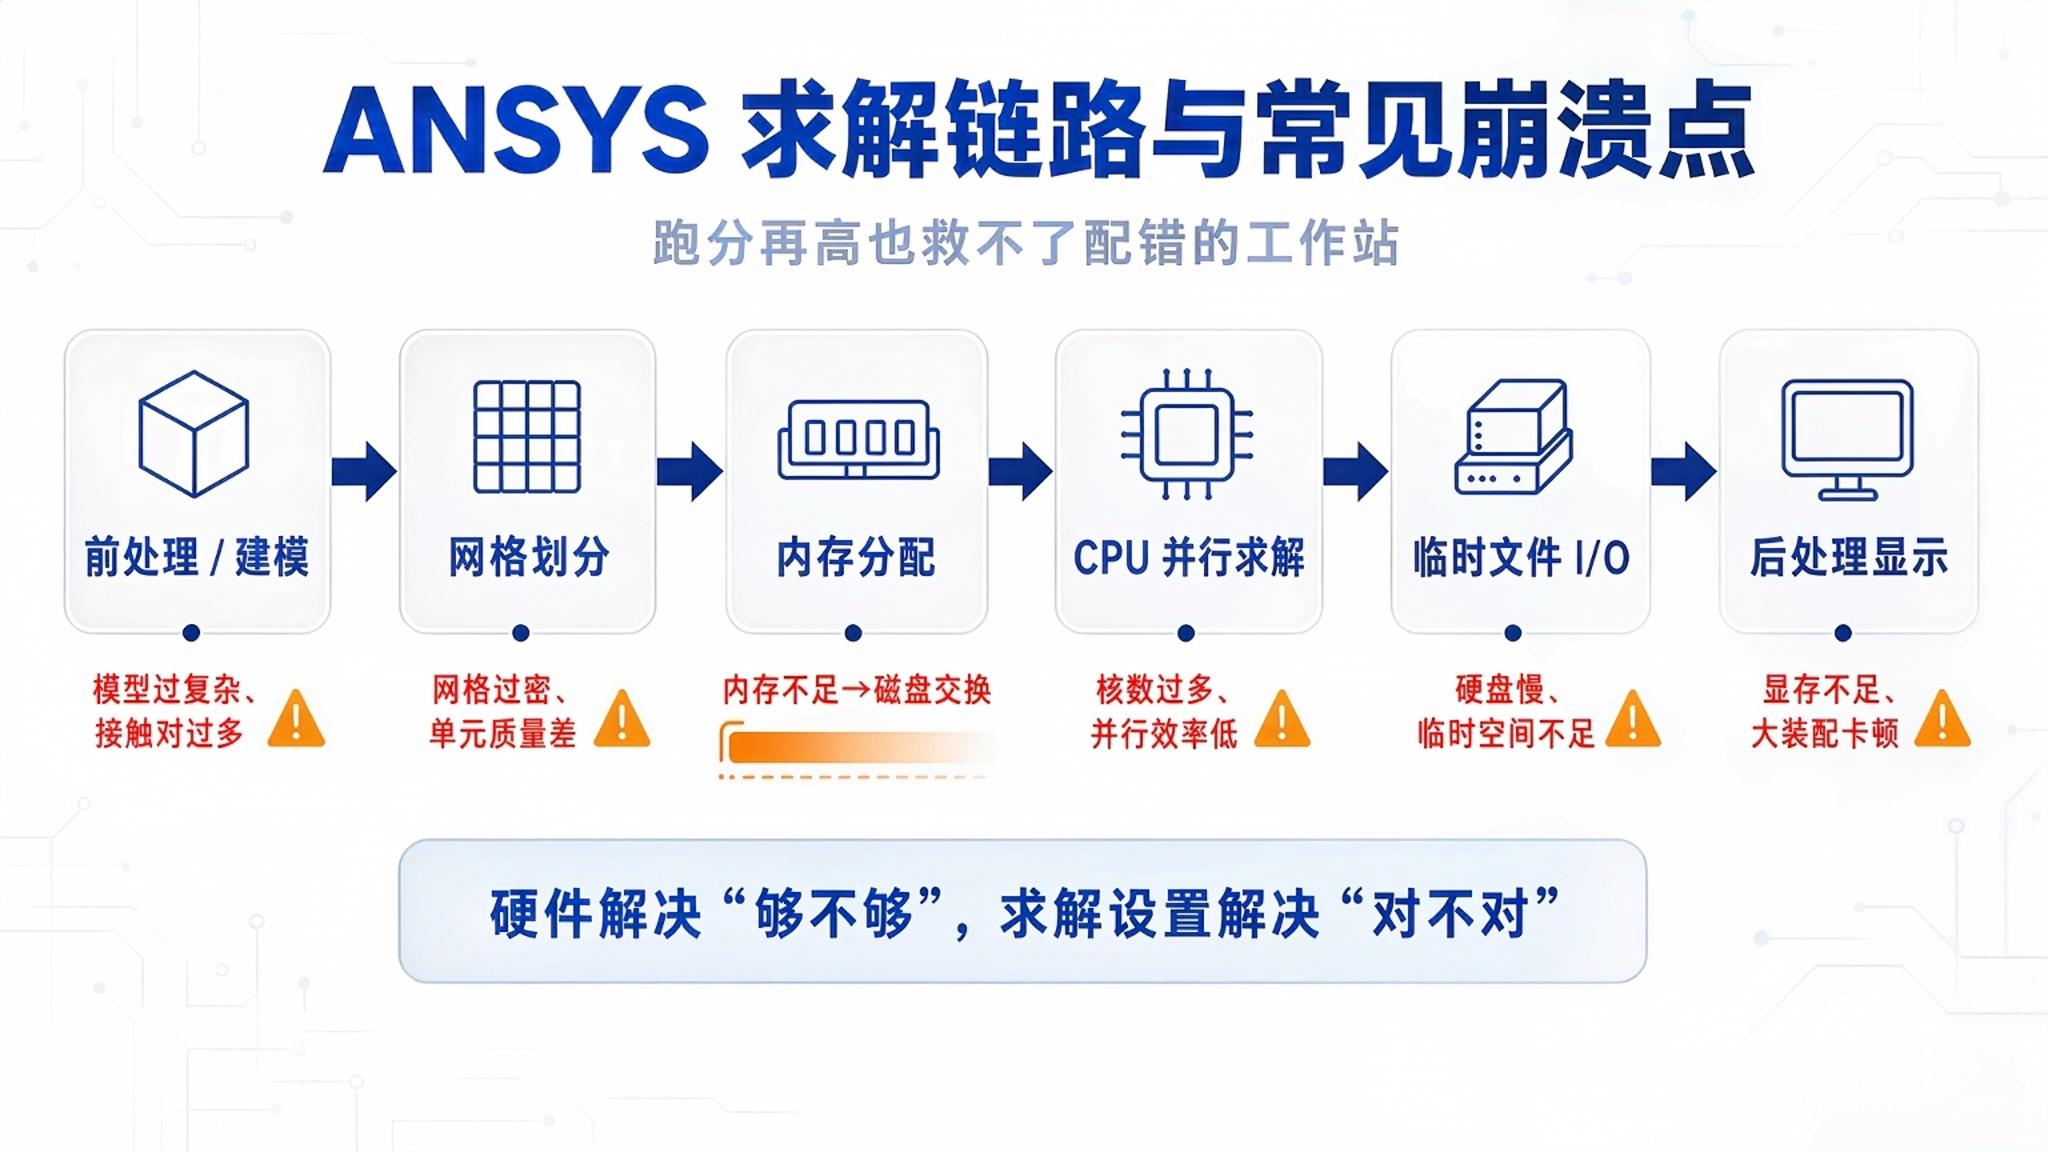 ANSYS求解链路图——前处理/网格→内存→CPU并行→临时文件I/O→后处理,标注常见崩溃点
二、CPU核数:别盲目追多,看算例规模
并行基本逻辑
串行改多核:小模型提速明显有上限;
SMP单机多核:适合单任务中模型;
DMP分布式:适合大模型、多节点,但要求软件设置、许可证、网络/磁盘都跟得上;
许可证限制:很多教学/单机授权可用核数有限,物理核再多也按授权走。
经验选型
课程小算例(教材例题、毕业设计小结构/小流体):4–8物理核够用,重点看单核频率和内存;
中型有限元(百万级自由度、千万级节点以内):16–32核工作站更平衡;
大型非线性/显式/多物理场:32核以上,或转向集群/SMP服务器;千万节点以上通常不建议纯单机凑合。
超大规模HPC:按节点规划,别用“买个56核工作站”硬刚集群任务。
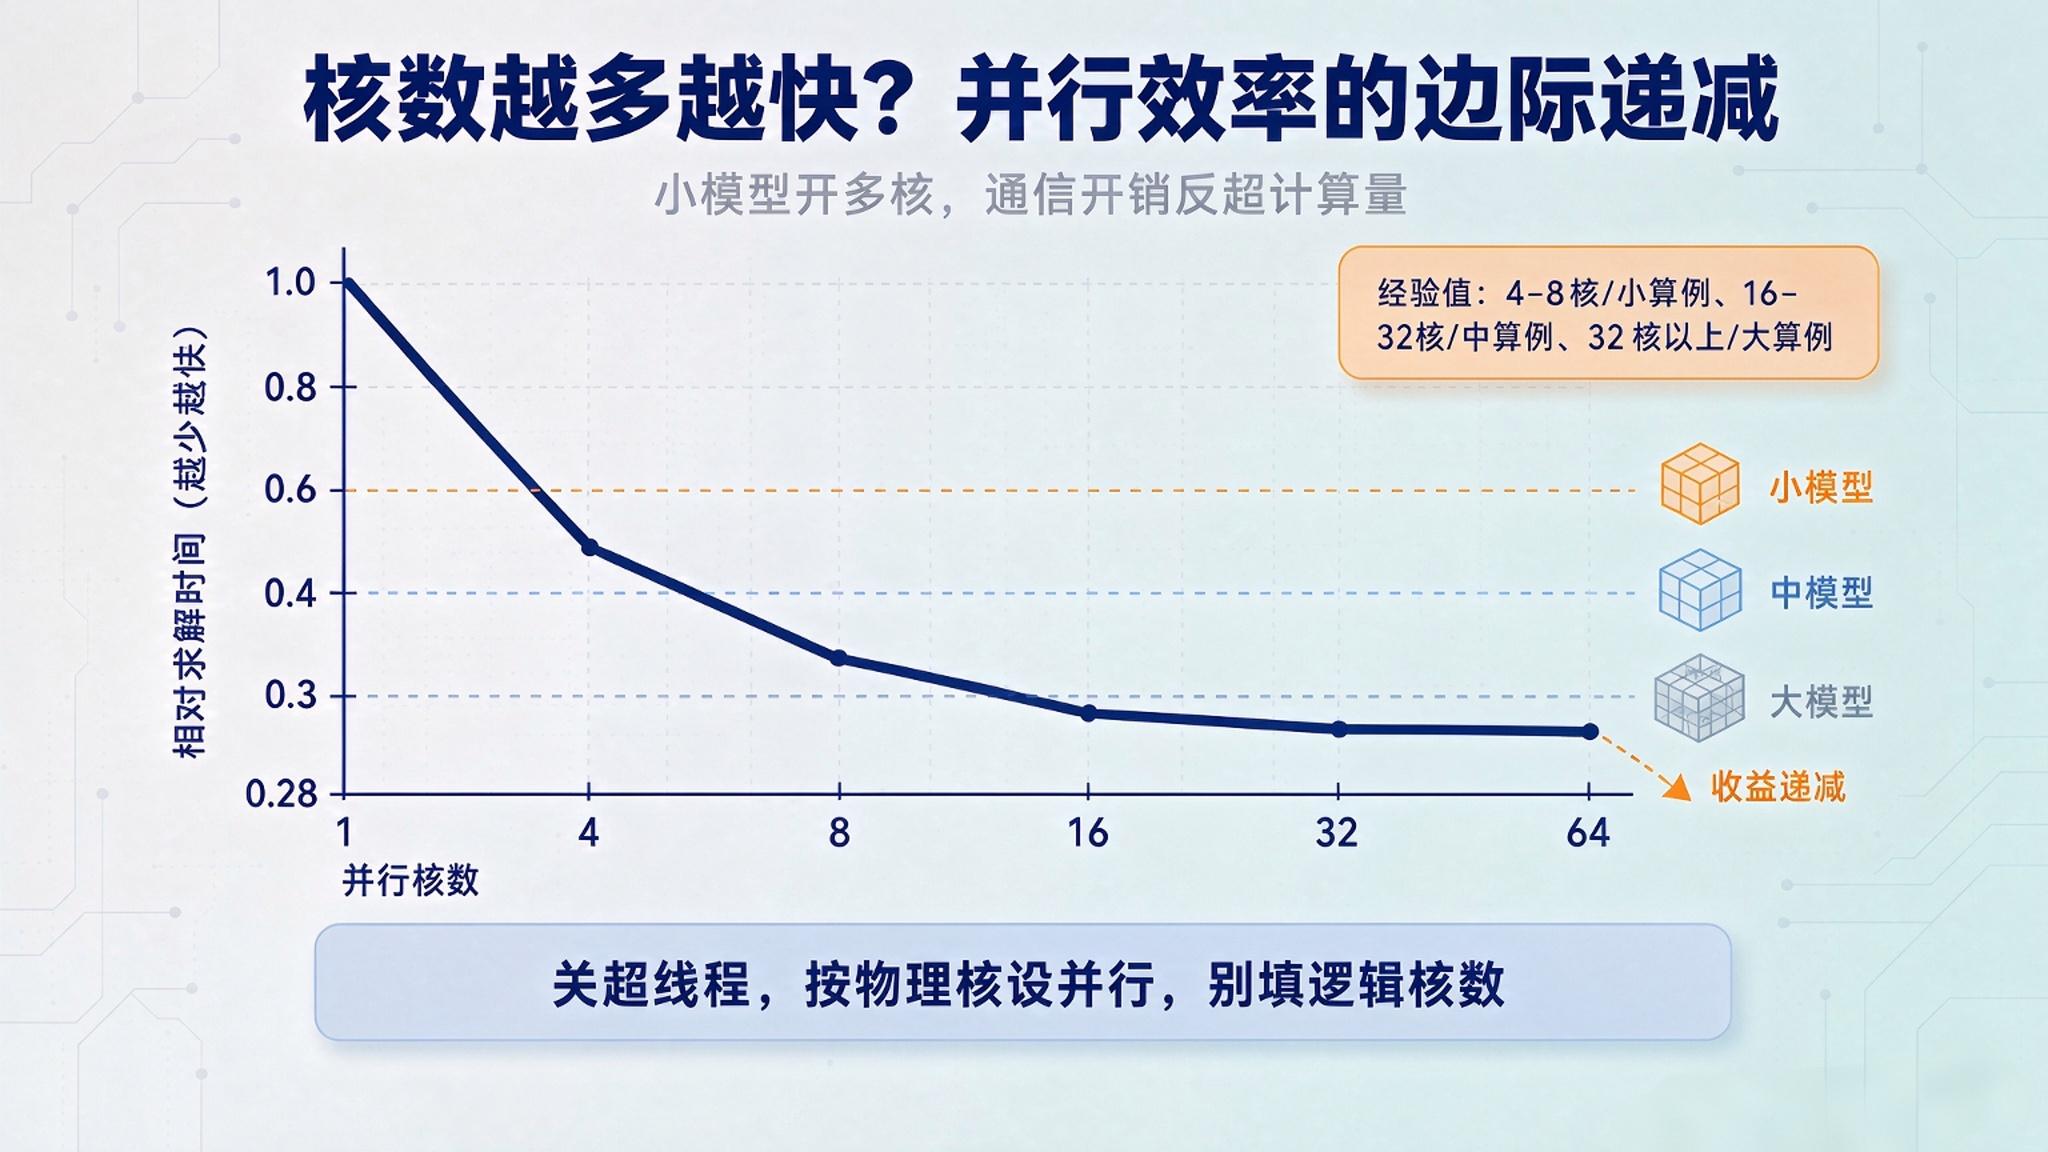 实践建议:Workbench里Tools→Solve Process Settings→Advanced设物理核数,开Distributed Solution;超线程通常关闭再测,取最优核数。
三、内存:ANSYS最容易被低估的项
隐式结构、热固耦合、大装配接触,内存比核数更重要。可参考的估算与配置原则:
粗估公式:内存需求 ≈ 自由度数量 ×(1–1.5)GB/百万自由度;仅作预算估算,实际受单元、求解器、稀疏/迭代设置影响很大。
每核配内存:工作站经验可按每核8GB以上规划,多通道内存比“单条大容量”更关键;
优先incore:内存够大可避免磁盘交换,隐式求解通常明显更快;
ECC问题:长期跑大任务、不想静默出错,工作站/服务器平台可考虑ECC;纯学生作业机可不强制,但稳定性要求高时建议上。
举例:
100万自由度 → 约1–1.5GB(小意思);
500万自由度 → 约5–7.5GB(16GB勉强,32GB舒服);
2000万自由度 → 约20–30GB(32GB会紧,64GB更稳);
5000万自由度以上 → 128–256GB起步,继续加大或上集群。
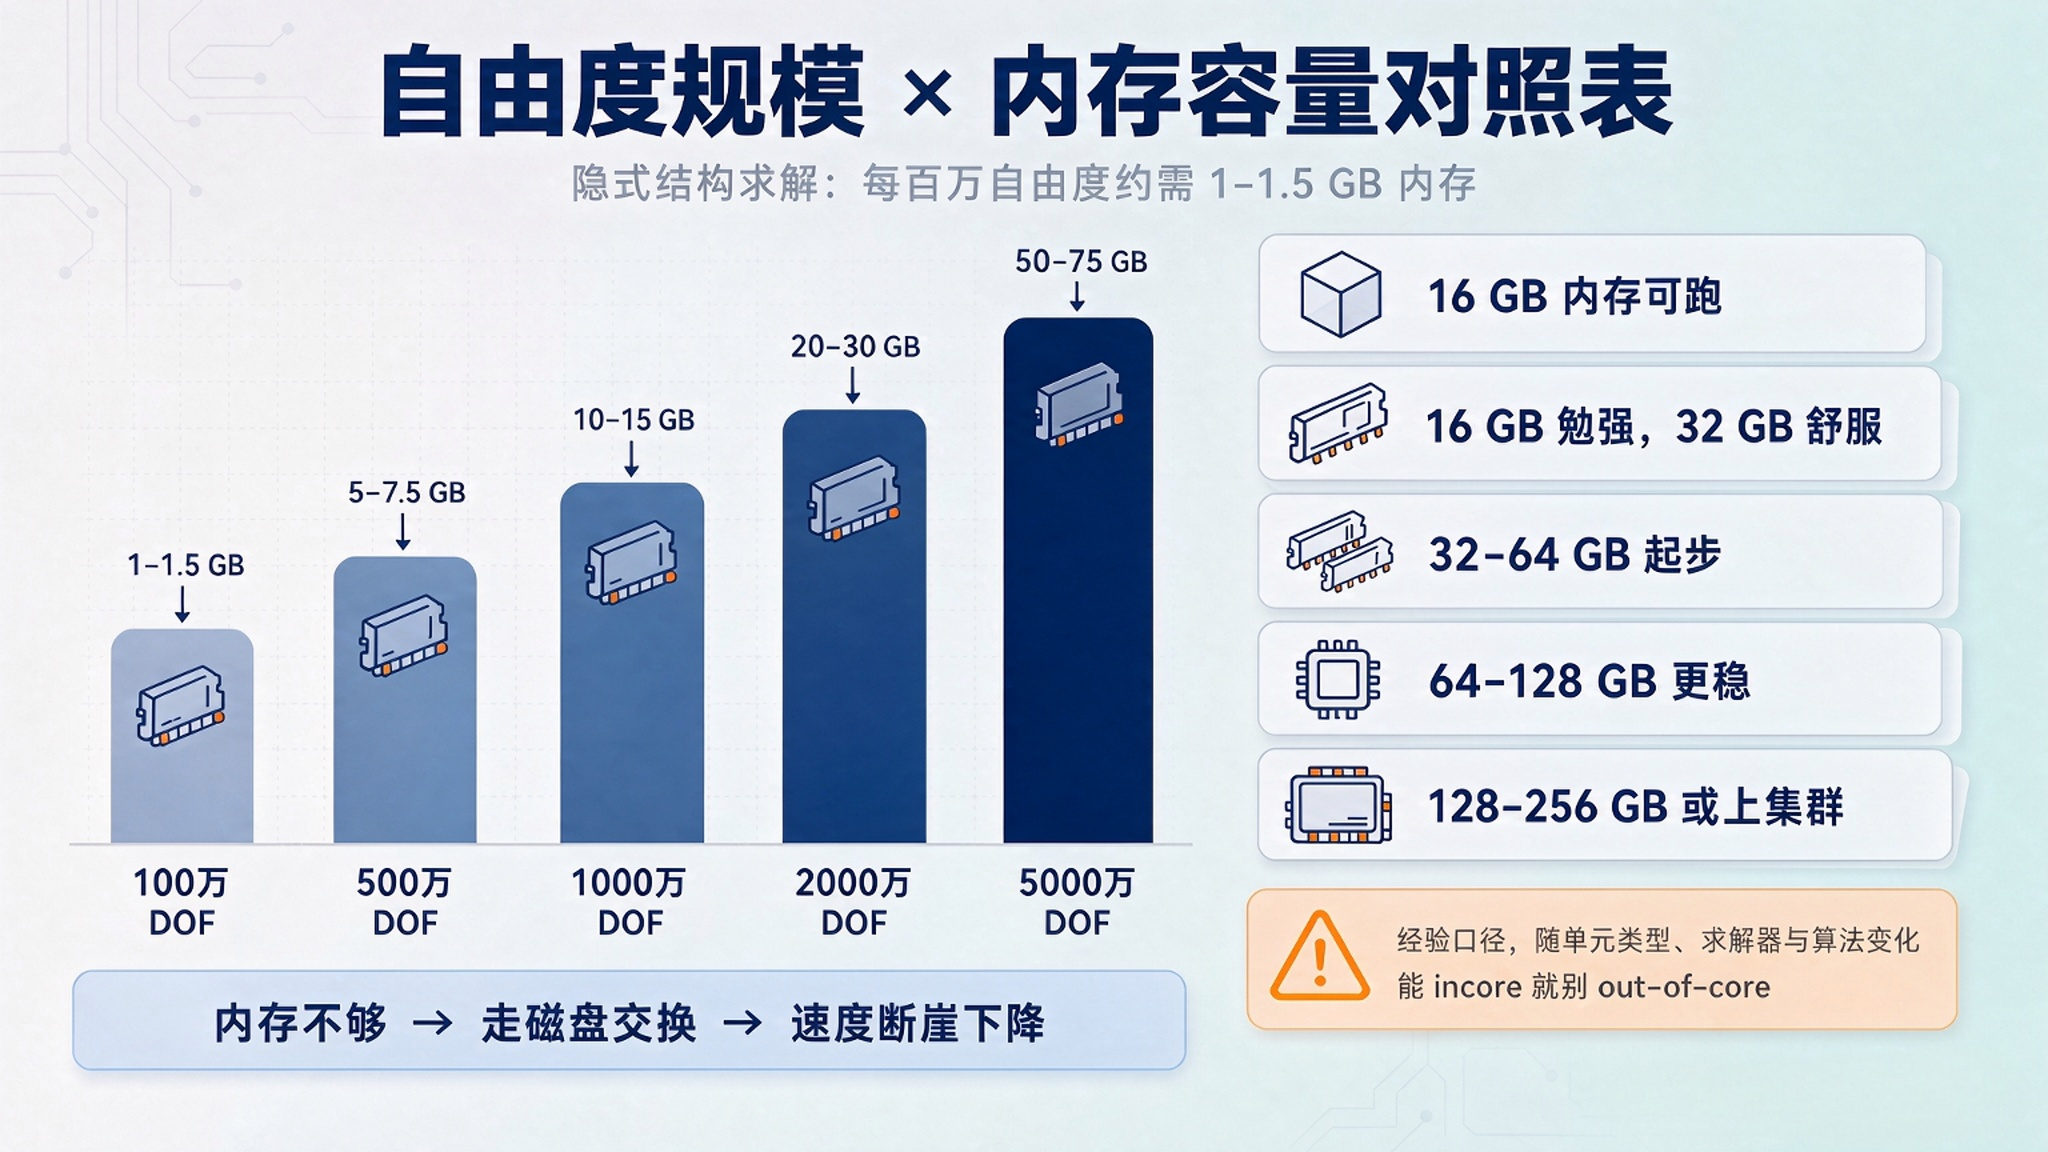 自由度规模→内存容量对照柱状图
四、显卡:分“看图”和“算题”两件事
前处理/后处理显示
大装配、复杂曲面、数百万单元后处理,专业图形卡或大显存卡更稳。高校图形工作站采购常见要求是专业独立显卡、8GB以上显存,复杂CAD/CAE显示场景会提到更高显存。
学生如果只是小模型教学,游戏卡也能用;但大装配转视角卡、后处理崩,就要考虑显存和专业驱动。
求解GPU加速
ANSYS部分求解器/场景支持GPU,例如Mechanical、Fluent、HFSS等有GPU加速相关能力,但具体支持版本、求解类型、单/多GPU和许可证限制差异很大;Fluent GPU在部分大规模CFD上有显著加速案例,但别默认“买张卡就全场景快”。
学生采购原则:
只做结构小模型:优先把钱给CPU+内存,显卡够显示即可;
做大型装配/后处理:专业卡或大显存游戏卡都行,看预算;
做Fluent大模型且版本明确支持GPU:再单独评估数据中心/工作站GPU,别拿普通游戏卡硬上生产;
买前查官方GPU支持表+自己版本+许可证,不靠商家话术。
五、算例规模×硬件对照表(学生可直接套)
| 场景 | 典型规模 | 推荐CPU | 内存 | 显卡 | 存储 | 备注 |
| 课程/毕设小结构 | 十万–百万自由度,简单静力/模态 | 4–8物理核,高单核频率 | 16–32GB | 普通独显/专业卡2–4GB | 512GB SSD | 笔记本可跑,别开过多核 |
| 中型结构/热应力 | 数百万自由度,接触/非线性 | 12–24物理核 | 32–64GB | 专业卡4–8GB或大显存游戏卡 | 1TB NVMe | 关超线程测最优核数 |
| 中型Fluent/CFD | 百万–千万网格,稳态/简单瞬态 | 16–32核,看并行效率 | 64GB起 | 显示卡为主;若GPU求解再单独配 | 1–2TB NVMe | 瞬态、湍流、多相更吃内存和I/O |
| 大型结构非线性 | 千万–数千万自由度 | 32–64核或集群 | 128–256GB | 专业卡8–48GB按后处理规模 | 2TB+ NVMe | 千万节点以上考虑SMP/集群 |
| 大型CFD/多物理场 | 千万网格以上、流固/热流固 | 多节点HPC | 按子任务配256GB+/节点 | GPU按求解器单独评估 | 高速并行存储 | 单工作站不划算 |
教学采购可作参照:某高校图形工作站要求i7级别16核、16GB起可扩128GB、专业8GB显存;另一高校CAE工作站要求36核+、256GB DDR5 ECC、2TB NVMe、专业大显存卡——这是科研级,不是学生必选。
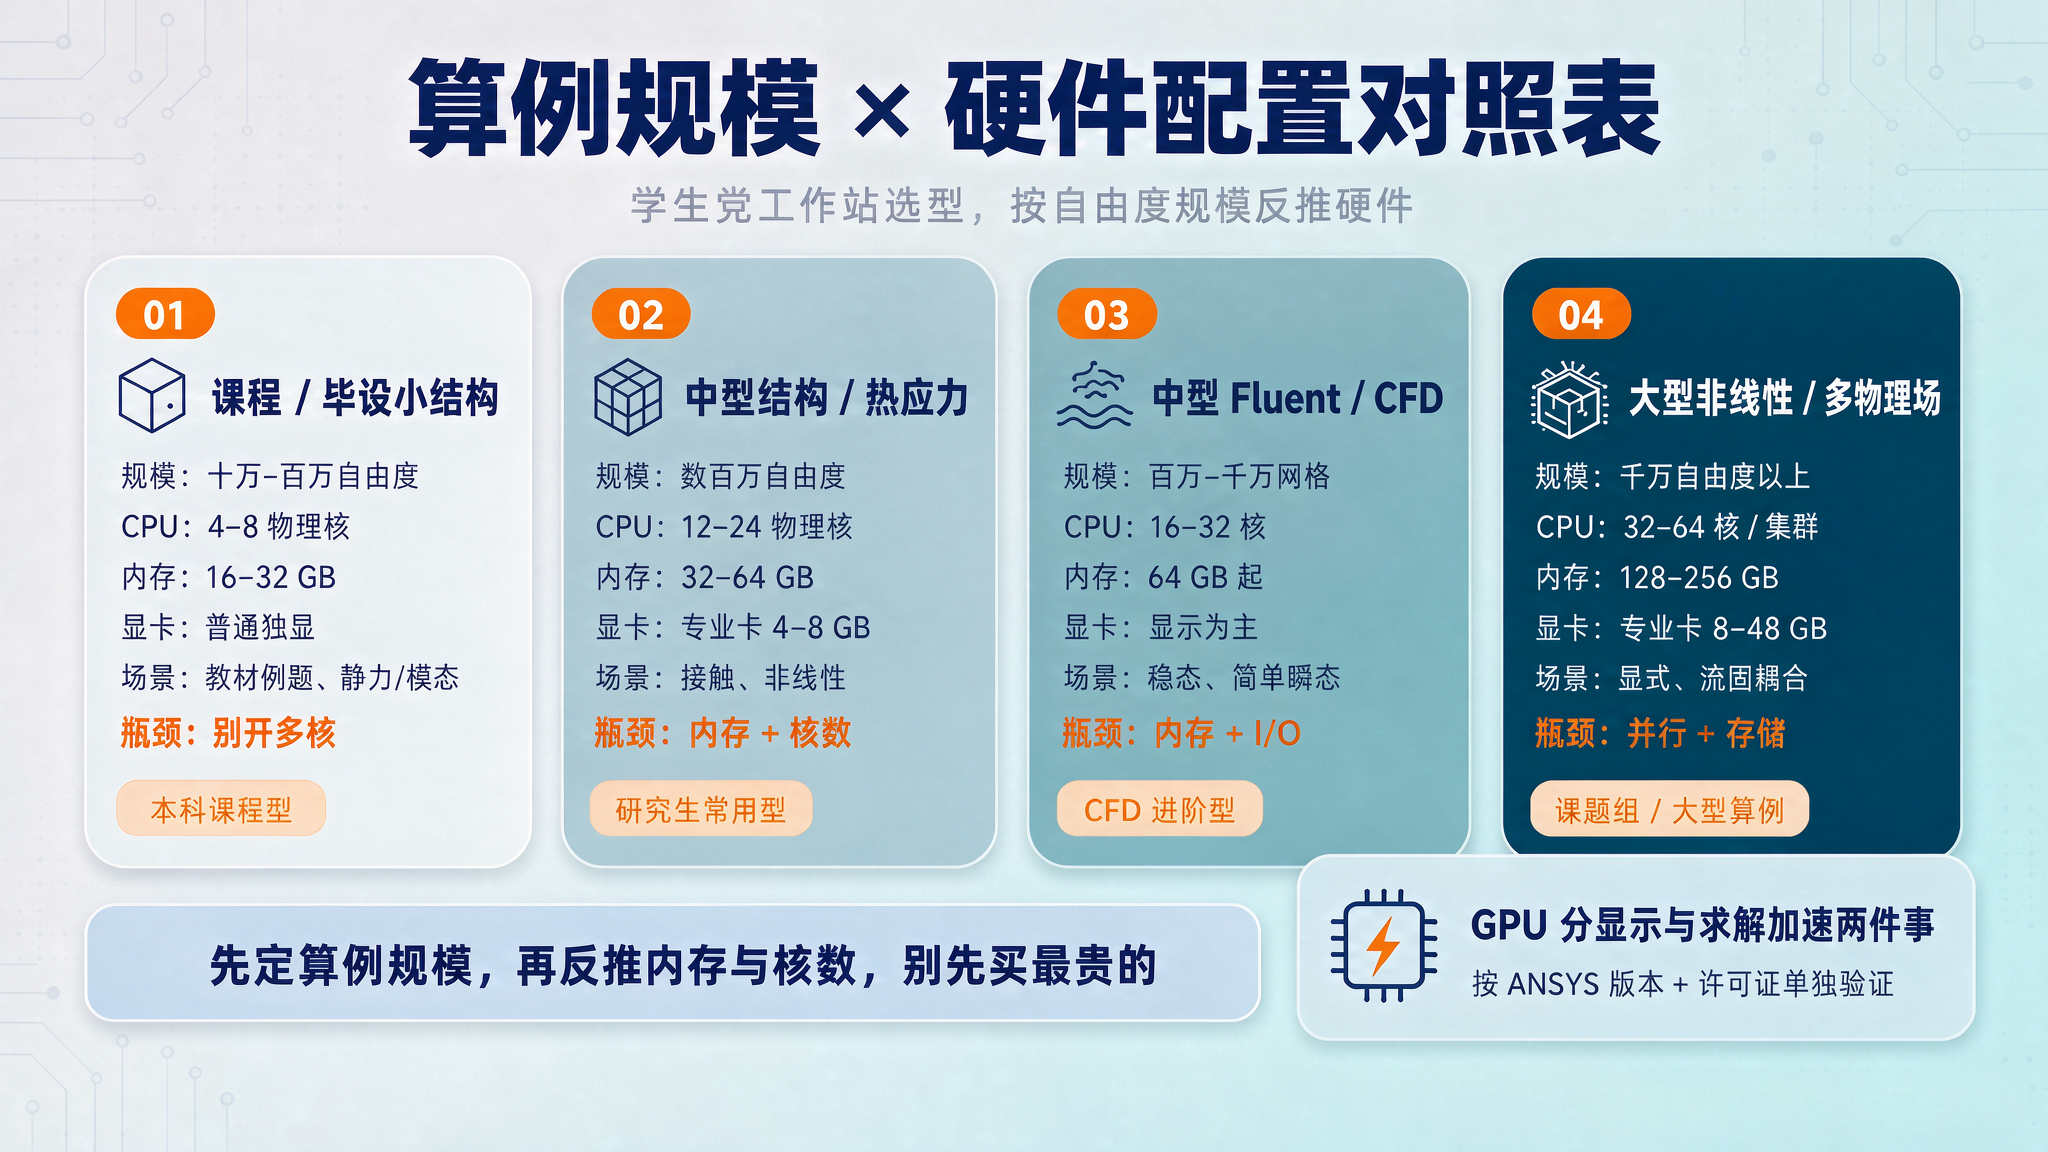 对照表信息图
六、学生党三档配置建议(不瞎堆料)
1)预算有限/本科课程型
笔记本或迷你工作站即可;
6–8物理核、32GB内存可扩、512GB–1TB SSD、普通独显;
跑教材例题、小结构、小Fluent教学模型。 避坑:别买4GB内存轻薄本跑Workbench,别开16核“显得快”。
2)毕设/研究生常用型
台式工作站:16–24核、64GB起可扩128GB、1–2TB NVMe、专业卡或8GB以上大显存;
结构非线性、模态、热应力、中型Fluent都能覆盖;
Workbench并行设物理核,临时文件放NVMe。
3)课题组/大型算例型
双路工作站或上集群:32核以上、128–256GB起、专业卡按后处理选、2TB+ NVMe;
若Fluent大模型做GPU求解,单独按ANSYS版本和许可证测;
不建议个人学生自购“56核+四显卡”在家跑,电费、散热、软件授权都不划算。
七、软件设置比“换硬件”更先做的事
设并行核数:Solve Process Settings→Advanced→物理核,别填逻辑核;
大内存机优先incore,减少out-of-core;
DMP临时目录放SSD,保证剩余空间大于预计内存/中间文件;
小模型别用分布式,直接少核SMP更稳;
非线性模型先简化接触、调步长、做模态/线性预跑,再上全模型;
经常崩就先看Solution Information、内存占用、write文件、license核数限制,而不是先加钱。
硬件能解决“够不够”,仿真经验解决“对不对”。很多学生不是机器差,是网格和求解器没调明白。
如果想系统补这部分,仿真秀上有结构、流体、Workbench实操、HPC并行和算例调参类课程,跟着做一遍比自己试错省很多时间;平台2018年起做工程仿真与CAX垂直内容,覆盖结构/流体/热/电磁/多物理场,高校学员和工程技术人员服务量已超120万。
八、一句话选型结论
小算例:少核+大内存+SSD,不追求多核;
中算例:16–32核+64GB级内存+专业显示卡;
大算例:32核以上+128–256GB+NVMe,评估集群;
GPU:显示卡必看显存,求解加速按具体ANSYS版本/求解器/许可证单独验证;
学生别先买最贵,先按“自由度规模×求解器类型”反推内存和核数。
仿真秀作为工程仿真知识服务平台,也可为高校课题组提供Workbench/结构/流体实战课程,为企业与科研团队提供仿真内训、技术咨询和项目攻关;个人打基础、企业搭团队,都能按场景匹配专家与案例库。
您可以直接点击发布仿真秀需求,有专职人员1个小时联系您,给您服务提供服务
也可以联系业务负责人-小欣,直接反馈您的需求