马上 TO 了,noise 报告上还挂着十几条违例,waive 还是不 waive?
做后端的大概都经历过这个场面:项目马上 TO,timing 签了、DRC 清了,PT 的 noise 报告上还挂着十几条违例。
场面还很像:全是数据通路上 buffer 的输入 pin,slack type 是 height,最差的一条离阈值只差零点零几伏,换算下来不到阈值的 5%。修过几轮了,修掉两条又冒出新的——noise 这东西,动一根线影响一片,越修越像在打水漂。
这时候就剩一个问题:waive 还是不 waive?
Waive 吧,报告上挂着红字流片,万一回来芯片真有问题,这口锅是签字的人背;不 waive 吧,为几条贴线的违例再动已收敛的版图,ECO 引入新 DRC、新 timing 问题的风险是实打实的,TO 日期又不等人。会上讨论半小时,最后往往变成"要不再修修看"——下一轮还是修不掉。
我的看法是:纠结的根源不在于违例本身,而在于大多数人手里没有一套判断"能不能 waive"的依据,只有"buffer 应该没事吧"的直觉。这篇文章就是把这套依据补齐。
先从那个最常见的直觉说起:"buffer 嘛,这点小 bump 传播不下去的,不用修。"
这个直觉对一半。而恰恰是错的另一半,最容易在评审上翻车。
先说对的一半。Buffer 是恢复型逻辑,增益大于 1,输入端一个离翻转阈值还有距离的窄 bump,经过它之后输出只是个更小更窄的突起,再走一两级就衰减没了。它不像 glitch 打在 latch、异步 set/reset、memory 或者模拟端口上那样会出功能事故。所以这类违例的实际后果通常只是一点 delta delay,而不是逻辑翻错。
但"传播不下去"这个说法,细究是有毛病的。
PT 判 noise 违例,不是拿 bump 跟 Vdd/2 比,是跟这个接收 cell 的 noise immunity 比——一条 height 乘 width 的双曲线,bump 落在曲线之上才报违例。换句话说,报出来的那一刻,bump 已经跨过了"会被滤掉"的分界线,进入了可能被再生放大的区域。Buffer 的增益是双刃剑:阈值以下它衰减,阈值以上它把 bump 恢复成全摆幅 glitch 传下去,传得比输入还干净。
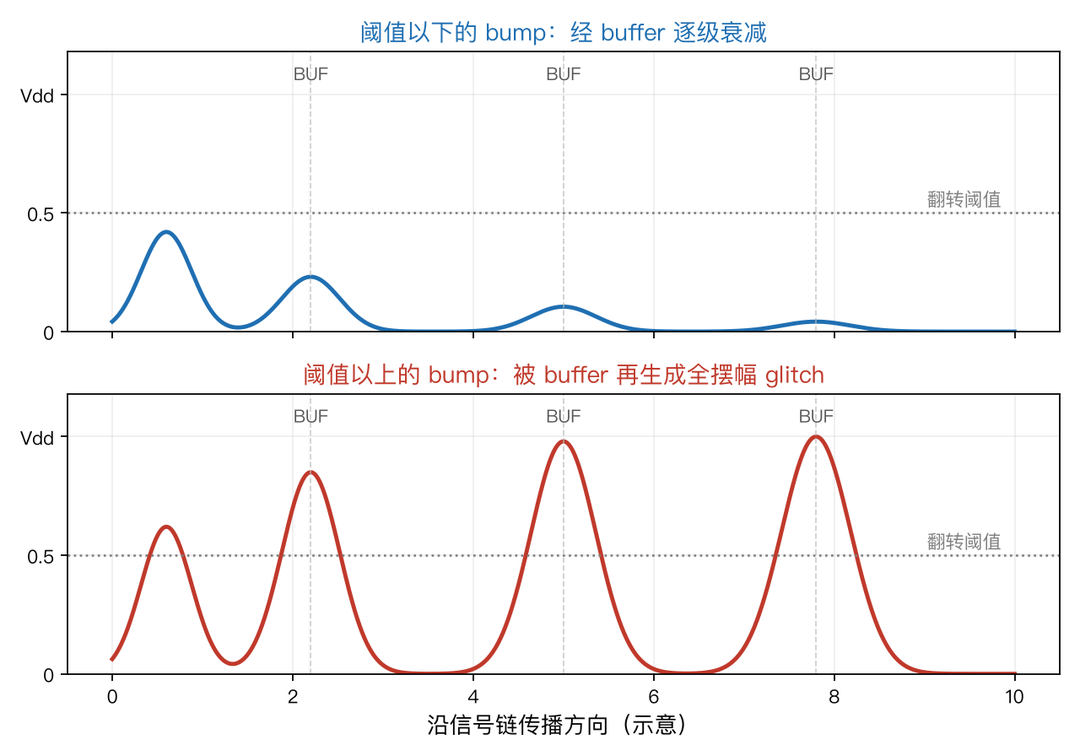
所以严格的说法是:bump 只是略超阈值,处于衰减和再生的边界,实际后果有限。而不是"buffer 上的 noise 都可以忽略"——这句话只要被找出一个反例(比如时钟树上的 buffer),整个 waiver 的可信度都会被拖下水。
那"剩下的违例全在 buffer 上",能不能反过来证明没问题?
也不能。这是用结果特征代替判断依据,里面有两个窟窿。
第一个窟窿:你看到的"全集"可能不是全集。report_noise 默认只报每个区域最差的一批,违例列表可能被截断过。如果下游时序单元上躺着更大的违例、只是没显示出来,"都是 buffer"这个观察本身就是错的。下任何结论之前,先把限制放开看完整违例集,这是整个论证的地基。
第二个窟窿更隐蔽:下游"干净",可能是工具帮你"弄干净"的。
PT 的 noise 传播分析是有开关的。默认配置下,传播出去的高度会在超阈值时被压到 immunity 的一个固定比例——也就是说,下游不报违例,有一部分是工具限幅限出来的,不是电路真实衰减。拿默认配置的报告跟评审说"传播分析证明下游没问题",懂行的一句话就能戳穿。
想坐实"衰减"这件事,得自己动手验证。社区里流传一个思路(和工具文档一致):source 模式下的违例不一定真的传播到触发器,可以把分析模式切到 endpoint——只有传播到 endpoint 仍然违例的点,才是必须修的。方向是对的,但直接照做有几个坑,下面这几条命令是我按文档核对过的完整姿势:
# 1. 先看当前配置(确认原来是 report_at_source、propagation 没开)
report_noise_parameters

# 2. 切到 endpoint 模式,同时打开传播——两个选项要一起给,
#    只切模式不开传播,bump 不会穿过 cell 往下算
set_noise_parameters -enable_propagation -an alysis_mode report_at_endpoint

# 3. 强制全量重算——必须做,否则拿的是旧模式下缓存的数据
update_noise -full

# 4. 看完整违例集
report_noise -all_violators
有一个细节让这条路比听起来更靠谱:那个"传播限幅"的变量,文档明确写了只作用于 report_at_source 模式。也就是说切到 endpoint 模式之后,传播高度不被限幅,"下游干净"是真实算出来的,不是工具压出来的——限幅变量不用手动关。
结果的解读要反过来:endpoint 模式下,如果原来那批 source 违例一条都不剩,说明 bump 全在数据通路的组合逻辑里衰减掉了,这就是 waiver 的核心证据;如果冒出新的落在时序单元上的违例,那些才是真正必须修的。另外两点提醒:换模式后不能用旧数据直接出报告,update_noise -full 必不可少;开传播加全量重算的 runtime 不小,建议单独起一个 session 跑,别动正在收敛的 signoff 环境。
还有一个更直接的量化手段:PT 有专门的属性能读出 bump 到达某个 pin 时"由传播贡献"的分量——拿违例 buffer 输入端的 bump 高度,和它输出端传播到下游负载的 bump 高度做个对比,前者明显大于后者,衰减态就有了数字证据。这个数字不是工具拍脑袋估的,是库里面 CCS noise 模型算出来的,可信度等同于 signoff 工具本身。
当然,endpoint 这条路也不是万能的:它只覆盖"glitch 会不会被触发器采到"这一种失效机理,noise 对 timing 的 delta delay 影响是另一条线,归 SI-on 的 setup/hold 签核管;时钟树、异步控制、latch、memory、模拟接口这些场景,"写进触发器"的框架本身就不适用。所以它是 waiver 论据里的一条腿,不是全部。
到这儿,还值得一问:这条"阈值线"本身合理吗?
我翻了下流程里的 signoff 设置,发现这批违例的判据有点特殊:用 set_noise_margin 给所有输入 pin 统一压了一个 flat 判据——取 Vdd 的某个固定比例,直接把库自带的 immunity 曲线覆盖掉了。要说明的是,这不是业界的通行做法,多数工艺直接用库里的 immunity 模型就够了,只有少数工艺会在 signoff 里额外提这种要求。但工具文档对这个判据的特性说得很坦白:纯高度判据更快、更保守;对于"高而窄"的 bump,它是悲观的——一些用宽度感知的 immunity 曲线能放行的 bump,会被 flat 判据判成 failure。
回头看那批违例:bump 宽度都在零点几纳秒以内,典型的高而窄,高度只超 flat 线几个百分点。这正好落在文档明说"会误报"的那一类里。
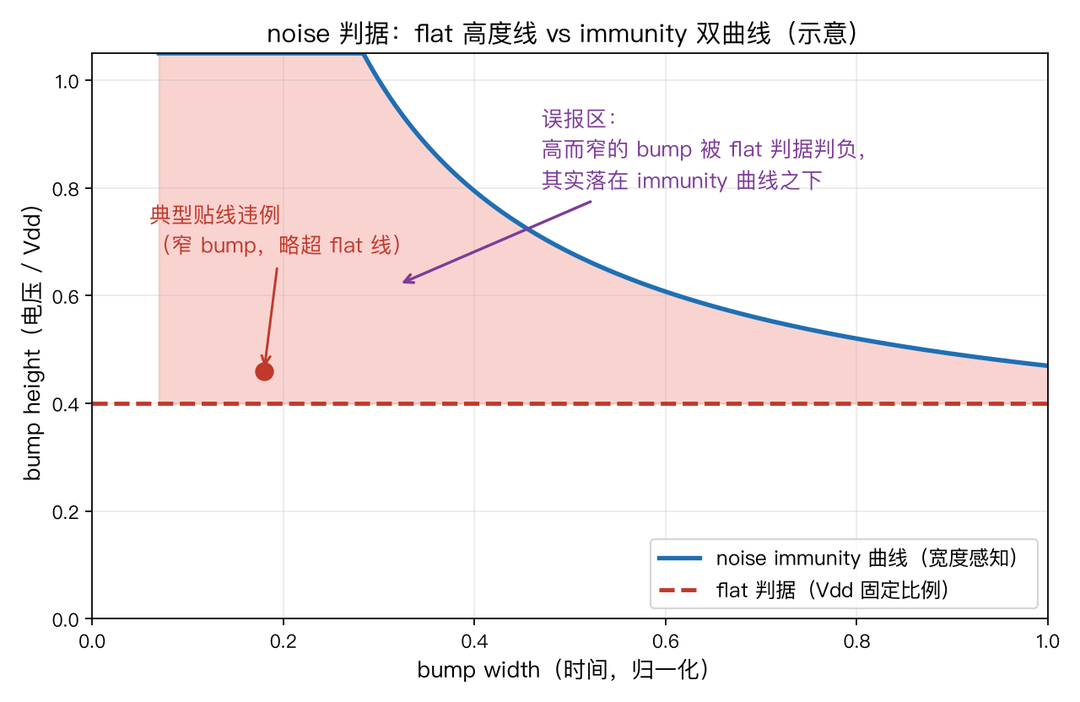
想验证也简单:挑最差的一条,临时把 noise margin 撤掉、让工具用回库里的 immunity 曲线重算一次,如果转 PASS,这就是 waiver 文档里最有分量的一页证据。
当然,分寸要把握好。Flat 判据既然是方法论定的 signoff 要求,waiver 的性质就是"对这条强制判据申请豁免",论证重点要落在实际风险小,而不是证明这条要求不合理——那是改方法论的事,不归一次 waiver 管。
所以最后,一份能过评审的 waiver 论据长这样,四条缺一不可:
完整违例集确认只有这批(报告没有截断);切到 endpoint 模式、打开传播、全量重算后下游依然干净;slack 全部贴在阈值的几个百分点以内,且 bump 都是窄 bump;接收端和下游全是数据通路的恢复型逻辑,不碰时钟、异步、存储和模拟端口。再补一句 timing 已在 SI 开启的条件下收敛,防止评审把 glitch 和 delta delay 两个问题搅在一起。
反过来,有几种情况这套说辞一概不适用:违例挂在时钟树上,没得谈,必须清零;slack 很深——比如 bump 高度超线百分之几十——哪怕全在 buffer 上也要修,模型误差在这个量级下足以让真实硅片更差;接收端或下游沾到模拟接口,数字那套"5% 余量"的算法不成立,得按接口自己的 spec 评估。
回到开头那个 TO 前的场景。纠结要不要 waive 的时候,真正该做的不是在会上反复权衡感觉,而是把上面四件事查一遍——多半情况下,查完答案自己就出来了。这次的经历让我印象最深的,也不是那十几条违例最后怎么签掉的,而是发现"工具报告的样子"和"工具实际算了什么"之间的差距:报告会截断,传播有开关,限幅有默认值,判据可能是被人为加严的 flat 线。每一条默认设置单看都合理,叠在一起,报告的解读方式就完全不同了。
你们项目里的 noise 违例是怎么签掉的?是一律清零,还是也走过 waiver?欢迎评论区聊聊。