首页/文章/ 详情

基于数字孪生的物理知情自编码器在不平衡样本条件下的滚动轴承故障诊断(下)
6月前浏览909

工业设备"看病难"?故障数据稀缺让AI诊断频频"误诊"!天津工业大学团队最新研究将数字孪生与物理神经网络深度融合,让AI不仅"看懂"振动信号,更"理解"轴承背后的力学规律,在故障样本极少的情况下仍能达到99.86%的诊断准确率,为智能工厂的设备运维开辟了新路径。  

本期推荐的这篇是天津工业大学机械工程学院教授尚志武的文章,本文系统综述了基于数字孪生的物理信息自编码器(PIAE-DT:Physics-Informed Auto-Encoder based on Digital Twin)在不平衡样本条件下滚动轴承故障诊断中的应用,针对工业场景中故障数据稀缺导致的类别不平衡难题,提出了一种融合物理机理与数据驱动的数据增强新范式;该方法通过将无量纲轴承动态特征嵌入自编码器隐空间,实现刚度、阻尼等关键物理参数的精确辨识与概率分布建模,并基于数字孪生空间的重采样机制生成高保真、多样化的合成故障样本;在凯斯西储大学(CWRU:Case Western Reserve University)公开数据集与高速轴承故障模拟实验平台(HFHP:High-speed Bearing Fault Simulation Experiment Platform)私有数据集上的对比实验表明,PIAE-DT在100:1至1:1的不平衡比例范围内均显著优于合成少数类过采样技术(SMOTE:Synthetic Minority Over-sampling Technique)、变分自编码器VAE(VAE:Variational Autoencoder)、带梯度惩罚的瓦瑟斯坦生成对抗网络(WGAN-GP:Wasserstein GAN with Gradient Penalty)等方法,最高诊断准确率达97.60%与99.86%,为智能制造背景下小样本故障诊断提供了兼具可解释性与鲁棒性的技术路径。  

由于文章篇幅过长,小编将分两次为大家翻译介绍这篇论文,第一篇推文(点击直达)提出了基于数字孪生的物理信息自编码器框架,针对滚动轴承故障诊断中故障样本稀缺导致的数据不平衡问题,通过将无量纲物理信息模块嵌入自编码器,实现刚度、阻尼等动态模型参数的精确辨识,并将这些参数映射到概率分布空间进行重采样,从而生成兼具物理一致性与统计多样性的合成故障数据;该方法设计了包含重构损失、无量纲微分损失和数字孪生物理一致性损失的复合损失函数及两阶段训练策略,为后续数据增强与故障诊断奠定理论基础。  

本篇推文聚焦实验验证与性能评估,系统开展生成数据质量分析与故障诊断效果验证。首先通过最大均值差异和均方根误差量化评估生成样本的分布相似性与波形保真度,PIAE-DT在两项指标上均显著优于对比方法。随后构建不平衡数据集进行诊断性能测试,结果表明随着不平衡比例从100:1逐步改善至1:1,PIAE-DT持续保持领先,准确率提升幅度最大达36.6%。消融实验进一步揭示了物理信息模块与自编码器结构的协同作用机制,超参数分析确定了最优批次大小、网络深度与学习率配置。t-SNE可视化直观展示了PIAE-DT生成数据具有更清晰的类别可分性,为方法有效性提供了有力佐证。  

论文基本信息

论文题目: Physics-informed auto-encoder based on digital twin for rolling bearing  fault diagnosis under imbalanced sample conditions

论文期刊:Engineering Applications of Artificial Intelligence

Doi:https://doi.org/10.1016/j.engappai.2025.113017

作者:  Ziyu Wang a,b , Cailu Pan a,b , Wanxiang Li c,d , Maosheng Gao e  
论文时间: 2025年  
机构:   

a School of Mechanical Engineering, Tiangong University, Tianjin, 300387, China 

b Tianjin Modern Electromechanical Equipment Technology Key Laboratory, Tianjin, 300387, China

c TBEA Beijing Tianjin Hebei Intelligent Technology Co., Ltd, Tianjin, 301701, China 

d TBEA Tianjin Transformer Co., Ltd, Tianjin, 300300, China 

e TBEA Electrical Equipment Group Co., Ltd, Tianjin, China

作者简介:尚志武,男,1977年2月生,天津工业大学机械工程学院教授、正高级工程师、博士生导师。2003年获天津大学机械制造及其自动化专业博士学位。任中国振动工程学会机械动力学专委会委员,兼任天津经济技术开发区正高级职称评委会委员、国家科技奖励评审专家、国际TRIZ协会(MATRIZ)认证专家、甘肃省产业竞争力战略咨询委员会委员 。研究方向涵盖智能诊断与动态测控、机电一体化技术、创新方法与创新设计等领域。(来源:ResearchGate)  

摘要

在滚动轴承故障诊断中,故障样本稀缺导致故障数据远少于正常数据,引发样本不平衡问题,严重影响诊断准确率。生成式神经网络虽能补充故障数据,但无法确保生成数据充分捕捉轴承动力学特性,从而损害可靠性。本文提出了一种基于数字孪生的物理信息自编码器,用于不平衡条件下的可解释数据增强。通过将融入轴承动态特性的无量纲物理信息模块嵌入自编码器,实现了动态模型参数的辨识,并确保每个学习特征对应具有物理意义的参数,提升了可解释性。辨识后的参数被映射至概率分布,进而通过重采样在数字孪生空间中开发故障数据增强方法,以增加增强数据的多样性。此外,从这些参数重构振动信号进一步提升了增强数据的可靠性,实验结果验证了物理信息模块的有效性。最终,应用PIAE-DT辨识已知样本的动态参数,在数字孪生空间中实现故障数据增强,有效缓解了诊断中的不平衡问题。该方法在公开数据集和私有数据集上进行了评估,最高诊断准确率分别达到97.60%和99.86%,优于其他数据增强方法。
关键词:数据增强;动态模型;故障诊断;不平衡数据;数字孪生

目录

1 引言

2 相关工作

   2.1 自编码器

   2.2 物理信息神经网络

   2.3 数字孪生

3 所提方法

   3.1 轴承数字孪生模型

   3.2 轴承数字孪生空间

   3.3 基于数字孪生的物理信息自编码器

   3.4 不平衡样本故障诊断总体框架

4 实验

   4.1 数据集描述

   4.2 不平衡数据集构建

   4.3 实验设置

   4.4 训练结果分析

   4.5 应用于故障诊断

5 结论


注:小编能力有限,如有翻译不恰之处,请多多指正~
     若想进一步拜读完整版,请下载原论文进行细读。

4 实验

4.1 自编码器数据集描述

实验在一个公开数据集和一个实验室私有数据集上进行。公开数据集来自凯斯西储大学(Neupane and Seok, 2020),其试验台主要包括驱动电机、扭矩传感器、功率计和电子控制器(图5)。测试对象为SKF6205驱动端轴承,在1797 rpm转速下以12 kHz进行降采样,采集的加速度信号涵盖内圈故障、外圈故障、滚动体故障及正常类别,故障尺寸为7 mil、14 mil和21 mil。实验室私有数据集来自HD-FD-H-03P转子齿轮箱故障模拟试验台(图6),该试验台主要由磁粉制动器、轴承模块、飞轮、扭矩转速计、单向传感器和电机组成;测试对象为SKF6205轴承,在1500 rpm转速下以12 kHz进行降采样,采集的加速度信号包括内圈故障、外圈故障及正常类别,故障尺寸为0.3 mm、0.4 mm和1 mm。
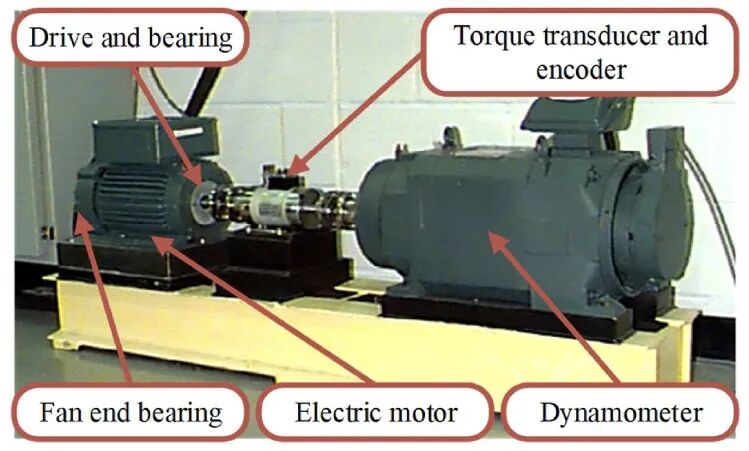
   

图5 轴承试验台架在凯斯西储大学( Neupane and Seok , 2020)
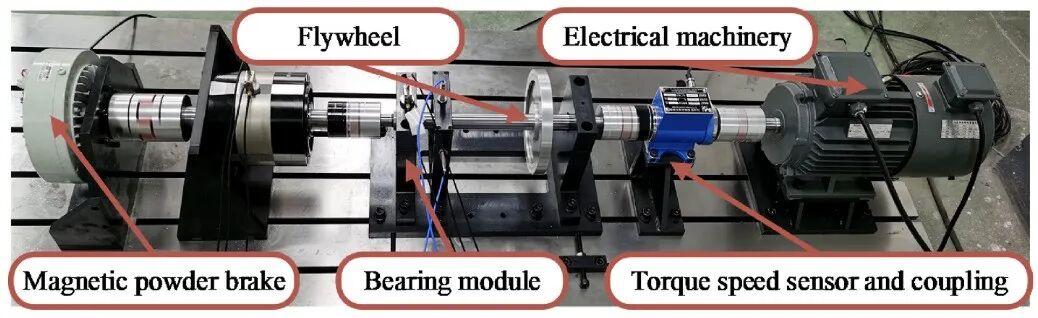
   

图6 HFHP自建轴承故障模拟实验平台(潘文卿等, 2023)

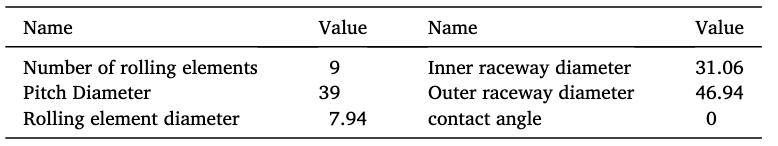
本文两个数据集的实验轴承均为SKF6205,该轴承的具体参数如表1所示。

表1 SKF6205轴承参数
         

4.2 不平衡数据集构造

为更好地模拟工业应用中故障样本稀缺的实际场景,对原始数据集进行人工处理以构建不平衡数据集。首先,采用滑动窗口对原始振动信号进行样本分割,窗口长度为1024,滑动步长(stride)为512。随后,从CWRU和HFHP数据集分别获得10 × 600和7 × 600个样本。每个数据集被随机划分为训练集和测试集,后者记为数据集A(Dataset A),分别包含10 × 100和7 × 100个样本。

在训练集中,所有正常(健康)样本被指定为数据集B(Dataset B,1 × 500),同时随机选取1%的故障样本并标记为数据集C(Dataset C,CWRU为9 × 5,HFHP为6 × 5)。剩余故障样本被标记为数据集D(Dataset D,CWRU为9 × 495,HFHP为6 × 495)。数据集B与C共同构成不平衡比为1:100的不平衡数据集,用于训练故障诊断模型。同时,数据集C作为训练生成模型的已知故障样本,数据集D用于评估生成数据的质量。人工生成的故障样本记为数据集E(Dataset E)。通过调整数据集E的样本数量,将数据集B、C和E组合,构建具有不同不平衡比的数据集用于模型训练。具体的数据划分汇总于表2。

表2 CWRU和HFHP数据集的使用
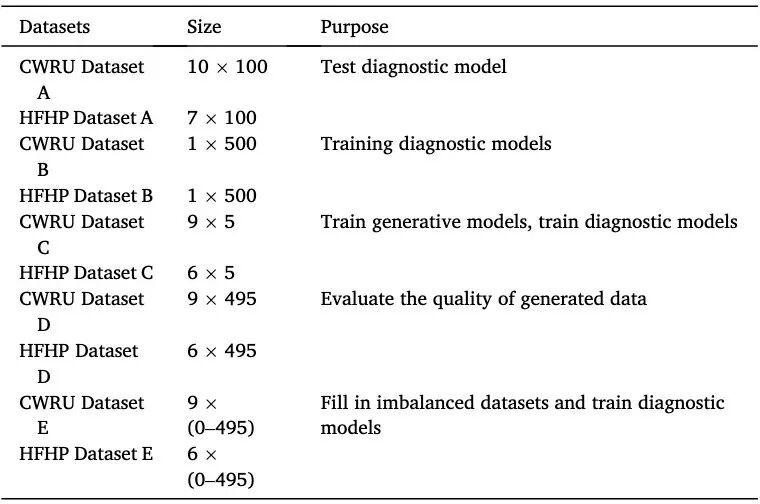
   

通过上述样本划分与处理策略,CWRU和HFHP数据集均被划分为多个子集(数据集A–E),随后用于模型训练、测试及生成样本的评估。这一全面配置支持故障诊断模型的实验开发与验证,特别是在极端类别不平衡条件下模型的鲁棒性与泛化能力方面。

4.3 自编码器数据集描述

计算硬件配置包括16 GB内存和NVIDIA RTX 4060图形处理器。实现采用Python 3.10,核心依赖库为PyTorch 2.2和NumPy。为确保结果的鲁棒性,性能评估在10次重复独立实验中进行,以减少固有随机性的影响。

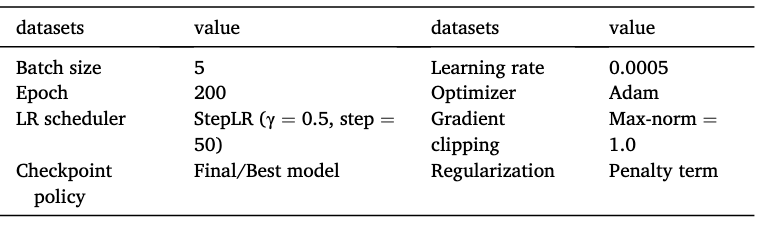
模型训练200轮,批量大小为5。初始学习率设为0.0005,采用Adam优化器进行优化。为增强收敛稳定性,应用StepLR学习率调度器,每50轮将学习率衰减0.5倍。采用最大范数为1.0的梯度裁剪防止梯度爆炸。在损失函数中加入惩罚项作为正则化形式。模型存储方面,保存检查点,保留200轮后的最终模型以及取得最佳训练性能的模型。

为清晰展示网络架构,所提PIAE-DT的结构设计汇总于表3,本研究采用的训练超参数列于表4。

表3 参数PIAE-DT
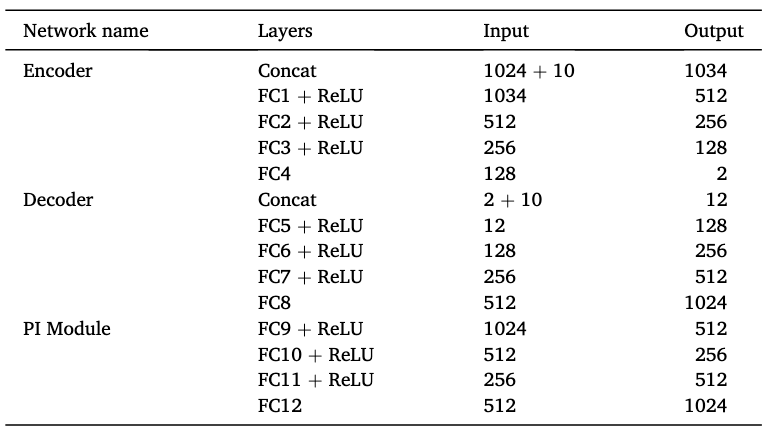
         

表4 训练超参数
   

4.4 自编码器数据集描述训练结果分析

4.4.1. 训练损失结果分析

与纯粹数据驱动的生成模型相比——后者虽能丰富少数类样本,但往往缺乏物理可解释性且与现实系统动力学的一致性不足——数字孪生(DT:Digital Twin)技术提供了一种物理一致的数据增强方法(Cui et al., 2024)。相比之下,DT技术通过融合基于物理的仿真与真实传感器数据,实现了物理一致的数据增强,为解决上述局限性提供了有前景的途径(Yi et al., 2023; Zhang et al., 2023)。
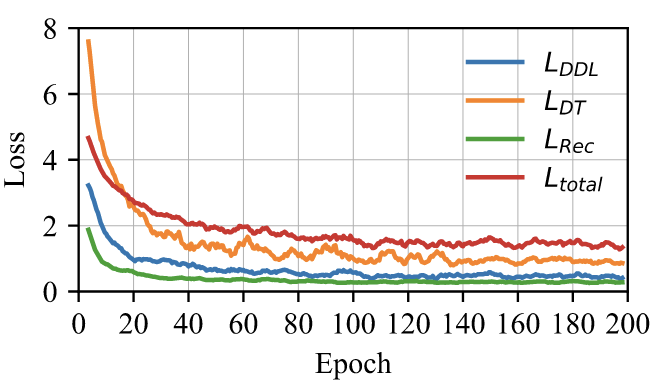
   

图7 训练过程中不同损失项的训练损失曲线

从不同损失项的表现来看,重建损失        在早期迅速下降并逐渐稳定,表明模型能够有效完成重建任务;而无量纲微分损失        和数字双胞胎损失        下降相对较慢,但显示出类似的稳定收敛趋势,表明它们的正则化约束正在逐渐满足;总损失        则保持下降趋势,最终在相对较低的水平上稳定下来,进一步证明了各损失项之间的协调性。总之,所提出的方法能够在训练过程中有效降低误差,并在长时间的迭代周期内保持稳定状态,充分验证了该方法的有效性和可训练性。

如图8所示,本文的总体损失函数为不同的子损失项引入了自适应权重系数        、        、        ,分别对应         、         、         。随着训练的进行,这些权重系数可进行动态调整,以平衡各任务在不同阶段对总体优化的贡献。
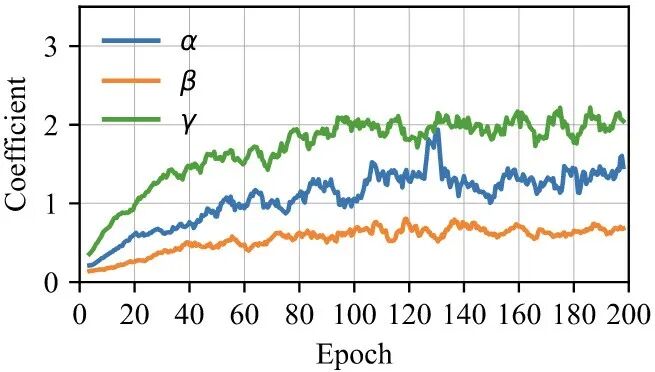
   

图8 训练过程中自适应权重系数曲线

具体而言,系数         (对应于          )在整个训练过程中保持在相对较高的水平(接近2),表明在优化开始时,模型强调重建损失的重要性,从而确保生成结果与输入质量的一致性;系数         (对应于         )在早期训练阶段逐渐增加,并在后期趋于稳定在约 1 左右,反映出对判别约束的持续关注,这有助于提高模型的判别能力;系数         (对应于          )整体保持在相对较低的水平,表明该约束在整体优化中所占比例较小,主要起到辅助作用。

这种自适应加权机制使损失函数能够根据训练过程中不同任务的优化需求自动调整权重,从而避免单一损失项的主导,确保模型在收敛时兼顾重构质量与判别能力,实现更加稳定高效的训练效果。

4.4.2. 数字孪生空间结果分析

使用包含已知故障样本的数据集C训练生成模型,获取关键动力学参数的概率分布,从而构建CWRU数字孪生空间(图9)。结果表明,当缺陷尺寸变化较小时,无量纲刚度和阻尼参数基本保持稳定,且与缺陷尺寸或类型相关性较弱,更多地受到轴承模型和采集环境的影响。虽然使用固定参数值不会损害振动响应的真实性,但会限制样本多样性;这一问题可通过将参数直方图转换为概率分布并从中采样来缓解。按照相同流程,获得了HFHP数据集C的动力学参数分布(图10)。尽管源自相同的轴承模型,两个数据集却呈现出不同的参数分布,表明动力学参数不仅由缺陷特性决定,还对实验设置、环境噪声及传感器特性敏感。总体而言,图9和图10表明这些参数分布与缺陷尺寸和类型相关性较弱,但强烈反映了测试环境特征。
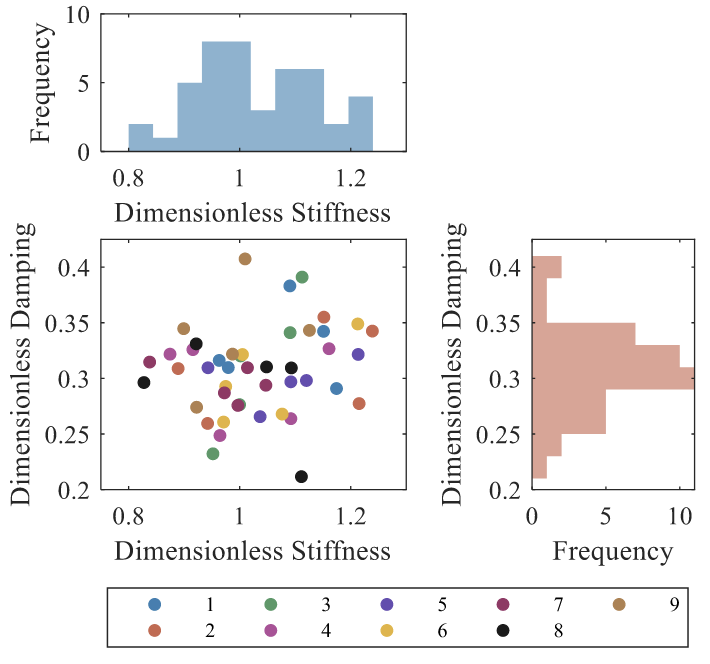
   

图9 CWRU数字孪生空间
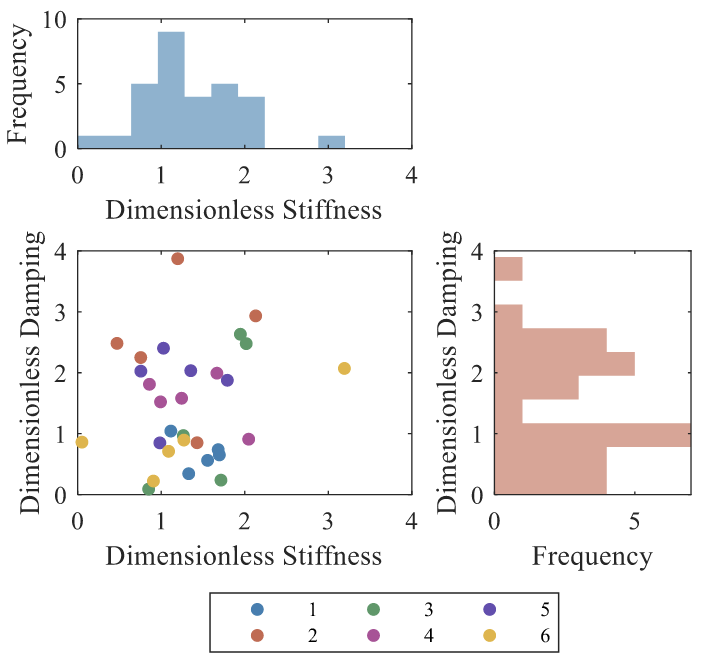
         

图10 HFHP数字孪生空间

综上所述,基于概率动力学参数构建数据驱动的数字孪生空间,不仅保持了振动信号的物理真实性,还增强了多样性与泛化能力,为稳健的样本生成及下游模型训练奠定了基础。

4.4.3. 生成数据可靠性分析

通过从两个数据集的数字孪生空间中随机采样,并将采样得到的参数与其对应标签相结合,生成新的故障数据样本。随后将这些参数输入训练好的权重共享解码器以重构振动信号。如图11和图12所示,生成信号在两个数据集中均与原始数据高度吻合。对于CWRU数据集(图11),生成数据在整体波形形状和幅值分布上与真实信号良好对齐。在HFHP数据集(图12)中,生成信号展现出可比拟的幅值范围和时域模式。值得注意的是,在缺陷区域观察到更为明显的振动行为,而非缺陷区域的信号保持平坦且一致。有趣的是,非缺陷区段的生成信号甚至比真实数据更加平滑,表明模型不仅捕捉了关键时序特征,还可能在合成过程中对其进行了增强。
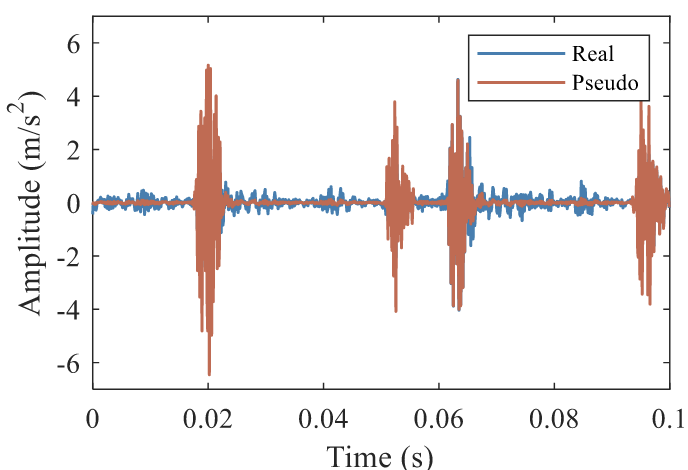
   

图11 CWRU真实数据与生成数据的对比
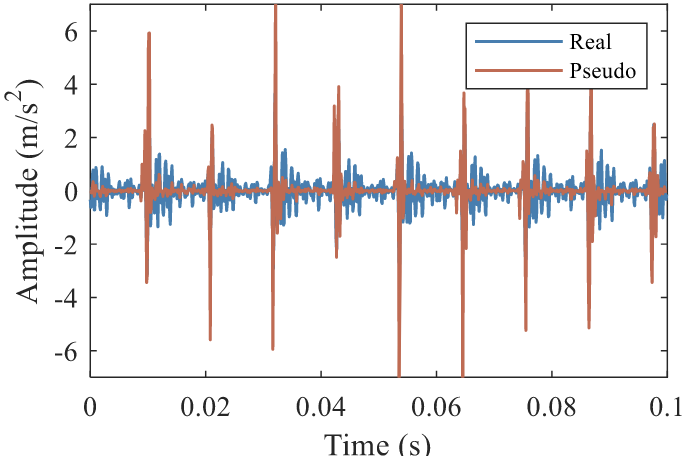
           

图12 HFHP真实数据与生成数据的对比

综上所述,合成信号在保留关键故障相关特征的同时,提升了平滑性和一致性,展示了所提方法在生成用于下游任务的高保真度和可靠故障数据方面的能力。

4.5 应用于故障诊断

4.5.1. 量化评价指标和不平衡率设计

为量化模拟数据与实测数据之间的差异,本文采用两种指标:最大均值差异 MMD(Zhang et al., 2022b)和均方根误差 RMSE(Lei et al., 2012)。MMD用于评估数据分布的差异,而RMSE主要关注模拟数据与实测数据之间的幅值差异。数学定义如下:

此外,采用分类准确率评估故障诊断性能,其定义为:

其中,        表示真实类别为        且预测类别为        的样本数量,       代表类别数。

为构建不同的不平衡场景,设计了如表5所示的样本比例。

表5 不平衡比率
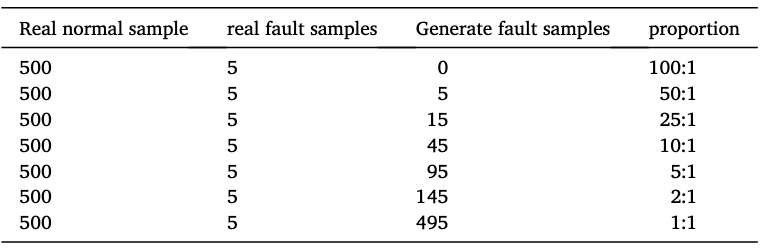
           

在不平衡分类实验中,采用数据集B中的500个真实正常样本和数据集C中每类故障的5个真实故障样本作为训练集。每类故障的生成样本数量从0逐步增加至495,使不平衡比从100:1逐渐降低至1:1。数据集A中的所有数据均用作分类网络的测试集。为进一步验证所提方法处理不平衡样本的有效性,所有实验在相同参数设置下采用统一的诊断网络(WDCNN:Wide Deep Convolutional Neural Network)(Zhang et al., 2017)。

4.5.2. 极端不平衡情景的基准

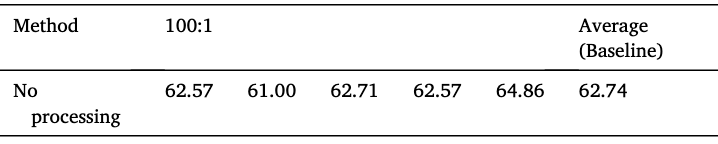
首先,我们在极端不平衡的100:1场景下评估无任何增强时的基线诊断性能,以建立参考基准。如表6(CWRU数据集)和表7(HFHP数据集)所示,所有模型的诊断准确率仅徘徊在62%左右,表明严重的类别不平衡导致故障识别能力显著下降。

表6 在CWRU数据集上的基线诊断准确率( 100:1 )
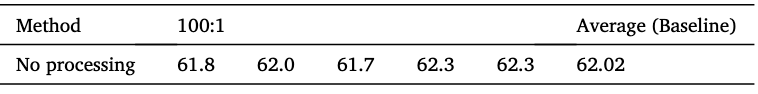
         

表7 在HFHP数据集上的基线诊断准确率( 100:1 )
         

4.5.3. 不同不平衡比例下的对比实验

在本研究中,对比模型包括SMOTE、VAE、WGAN-GP以及动力学模型。动力学模型采用与文献中相同的仿真参数求解微分方程。

接下来,我们在最具挑战性的不平衡水平(100:1)下评估生成样本的质量,因为高保真数据生成是有效增强的基础。为此,采用MMD 和RMSE 指标定量测量合成样本与真实样本之间的分布相似度和波形保真度。如图13(a)所示,所提模型在CWRU数据集的全部九类故障中始终取得最小的MMD值,表明生成样本的分布与真实数据最为接近,从而展示了捕捉底层数据分布的优越能力。从图13(b)可观察到类似现象,所提模型同样记录了最低的RMSE分数,进一步证实生成样本与原始信号最为相似。在HFHP数据集上观察到可比拟的趋势:如图14所示,PIAE-DT 同样获得最低的MMD和RMSE值,验证了其在不同数据集上的优异泛化能力,并突出了合成样本的高保真度。
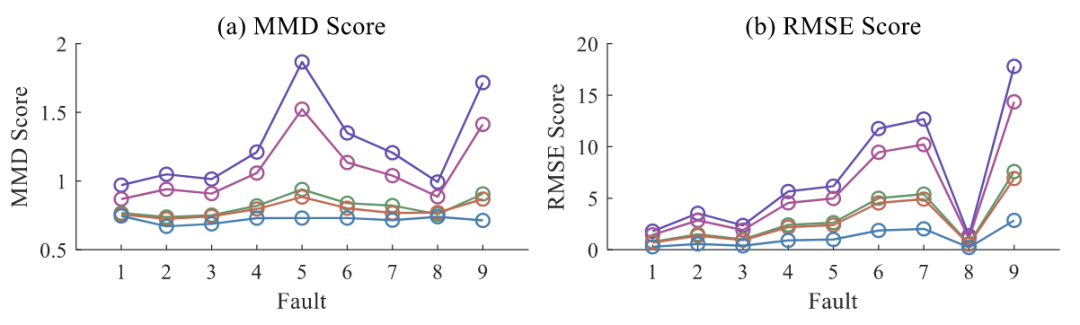
           

图13 生成样本在CWRU数据集上的MMD和RMSE得分
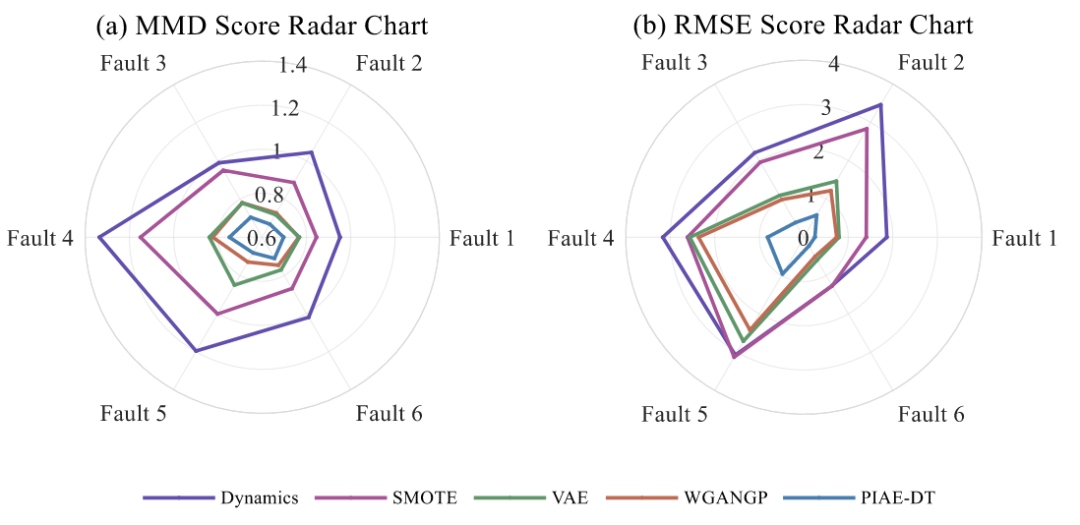
             

图14 生成样本在HFHP数据集上的MMD和RMSE得分

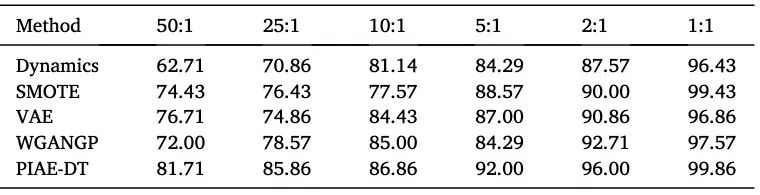
在上述展示的高质量数据生成能力基础上,我们进一步评估了随着不平衡比从50:1逐步放宽至1:1,样本增强后下游诊断性能的演变情况。如表8和表9所示,所有增强策略均带来准确率的显著提升,证实了合成样本补充对缓解不平衡的积极作用。值得注意的是,所提PIAE-DT 模型在每个不平衡设置下始终优于所有对比方法。特别是当类别分布达到完全平衡(1:1)时,PIAE-DT在CWRU数据集上达到97.6%的峰值准确率,在HFHP数据集上达到99.86%的峰值准确率,充分展示了其通过高保真样本生成缓解数据不平衡并提升诊断性能的卓越能力。

表8 在CWRU数据集上不同不平衡比例下的诊断准确率
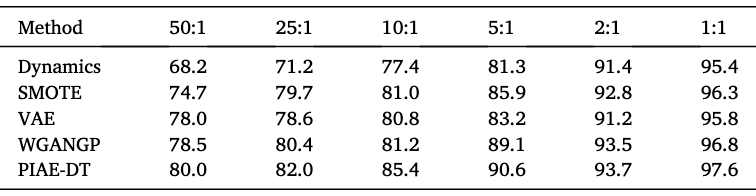
             

表9 在HFHP数据集上不同不平衡比例下的诊断准确率
         

建立轴承故障动力学模型对于开发精确的轴承数字孪生至关重要。该模型能够在真实工况下模拟各种故障模式,从而增强预测性维护能力。通过将轴承故障简化为单自由度非线性模型,我们在保持对广泛轴承数据集适应性的同时,最小化了模型复杂度。

在这些令人鼓舞的结果基础上,图15展示了随着不平衡比从50:1逐步放宽至1:1,不同增强方法的诊断准确率提升演变情况。随着类别分布趋于更加平衡,所有方法均表现出逐步增加的性能增益,证实了合成样本补充的积极作用。其中,SMOTE 和VAE 在中等不平衡度下显示出稳定的改进,而WGAN-GP 在相对平衡的场景中产生显著提升。值得注意的是,所提PIAE-DT 在所有设置下始终取得最大的准确率增益,并在CWRU和HFHP数据集的1:1比例下分别达到36.6%和37.1%的峰值改进,从而展示了其通过高保真样本生成缓解数据不平衡并提升诊断性能的卓越能力。
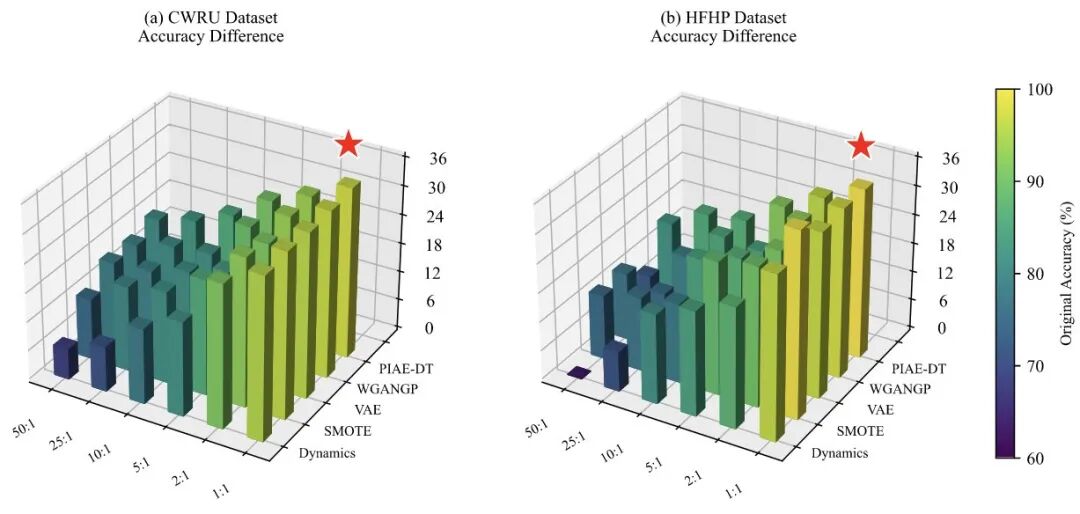
             

图15 不同增强方法在不同不平衡比下诊断准确率的提升

在100:1的高度失衡环境下,所有模型的诊断准确率显著下降至约62%,突显出严重类别不平衡对故障识别的有害影响。然而,利用高保真度的合成样本进行数据增强有效地缓解了这一问题。通过MMD和RMSE的定量评估表明,PIAE-DT生成的样本在分布和波形特性上与真实数据具有最一致性,显示出强大的数据建模能力。随后,在不同的不平衡比例(从50:1到1:1)下进行的诊断实验显示,所有增广策略均提高了准确率,且随着类别分布的逐渐平衡,性能提升也愈加明显。值得注意的是,PIAE-DT始终优于竞争方法,在CWRU数据集上达到峰值准确率97.6%,在HFHP数据集上达到99.86%,并在1:1比例下实现了最大准确率增幅,分别为36.6%和37.1%。这些结果证明了PIAE-DT在缓解数据不平衡和通过高质量样本生成提升故障诊断能力方面的卓越能力。

4.5.4. 不同不平衡比下的烧蚀实验

如图1所示,本研究开发的轴承数字孪生模型通过改变故障尺寸获取不同类别的缺陷位移数据,并将其嵌入动力学模型中。

为进一步阐明所提框架中各结构组件在缓解样本不平衡和提升诊断性能方面的独立贡献,我们通过逐步移除或修改模型的关键模块来进行消融研究。此类研究至关重要,因其使我们能够:(i)定量评估各模块对整体性能的重要性;(ii)验证模型设计的合理性;(iii)为模型的未来开发及实际部署简化提供指导。通过系统比较不同消融配置在各种不平衡比下的诊断准确率,我们旨在深入洞察各架构元素的有效性和必要性。

为此,构建了五种对比模型:

模型1(完整模型)代表原始PIAE-DT(Physics-Informed Auto-Encoder Based on Digital Twin:基于数字孪生的物理信息自编码器)框架,该框架集成了物理信息(PI:Physics-Informed)模块和自编码器(AE:Autoencoder)模块。模型2(w/o PI)移除PI模块,仅保留AE,以评估物理信息融入对样本生成保真度和诊断性能的贡献。模型3(w/o AE)舍弃AE模块而保留PI,从而检验AE在信号重构和特征保持中的作用。模型4(AE → CNN)将AE的全连接结构替换为卷积神经网络(CNN:Convolutional Neural Network),以研究局部感受野建模对生成性能的影响。最后,模型5(AE → RNN)将AE替换为循环神经网络(RNN:Recurrent Neural Network),以探索序列建模能力是否更适合振动信号生成。

在后续实验中,对这五种模型在50:1至1:1的不同不平衡比下进行评估,从而对所提故障诊断框架中各组件的功能性和有效性进行全面分析。

在消融研究中,我们首先在最严重的不平衡场景(100:1)下使用定量指标MMD 和RMSE 评估生成样本的质量。如图16和图17所示,模型5展现出最高的生成质量,其次是模型4,而模型1表现中等,模型3和模型2相对较差。这些结果表明,将全连接AE 结构替换为RNN(模型5)或CNN(模型4),由于其更强的时序动力学和局部特征模式建模能力,能够相对于原始架构(模型1)提升生成样本的保真度。
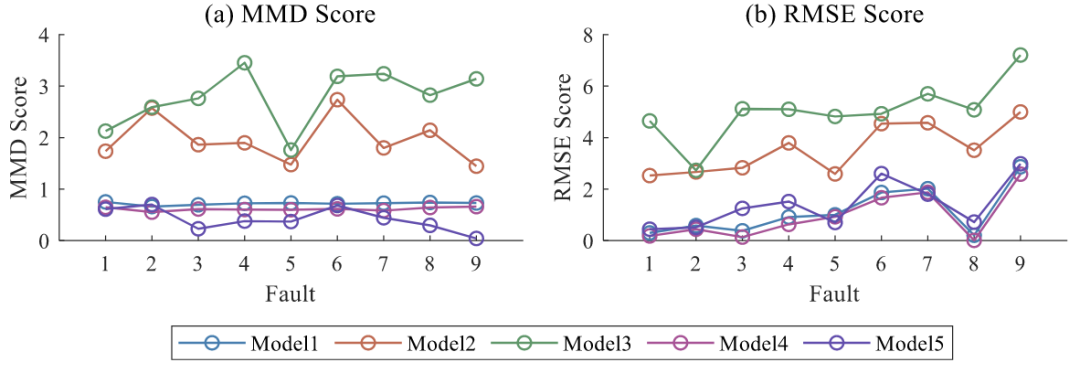
             

图16 生成样本在CWRU数据集上的MMD和RMSE得分
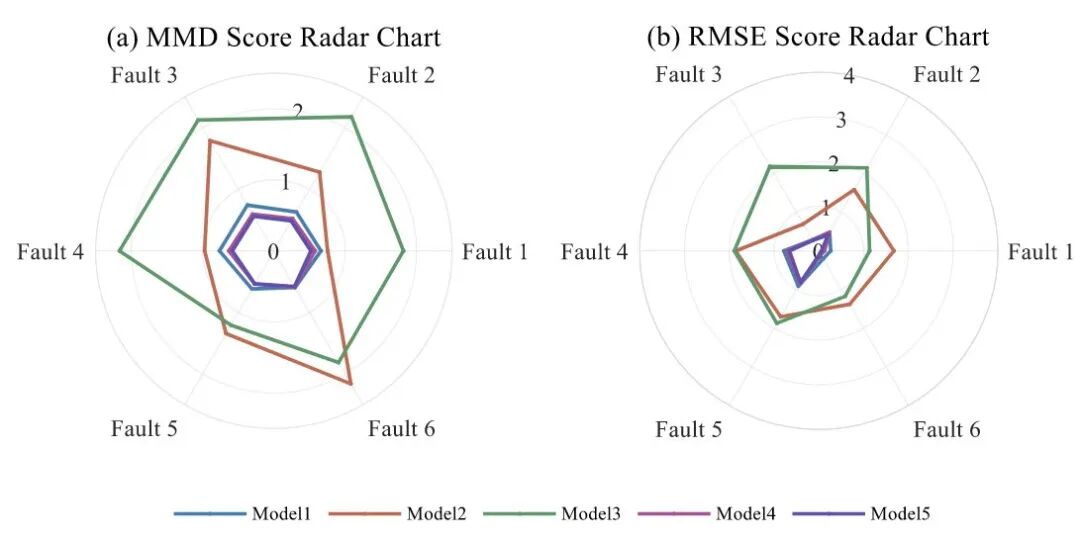
                 

图17 生成样本在HFHP数据集上的MMD和RMSE得分

然而,应当注意的是,模型4和模型5极低的MMD/RMSE分数可能源于对有限少数类故障样本的过拟合,这并不一定转化为下游诊断任务中泛化能力的提升。

相比之下,模型1在生成保真度与泛化能力之间取得了更为平衡的权衡,这对于实际数据增强至关重要。诊断性能结果将在下文呈现以进一步支持这一观察(图18)。基于上述生成质量的观察,我们进一步检验这些差异是否能在 varying 不平衡比下转化为下游诊断性能的改进。五种模型在CWRU和HFHP数据集上的分类准确率分别汇总于表10和表11。
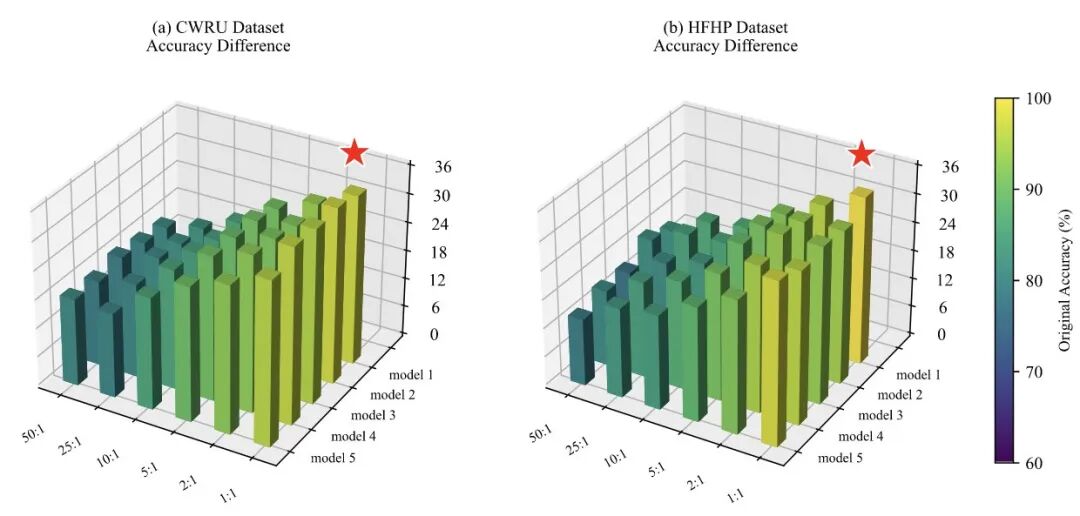
                 

图18 不同增强方法在不同不平衡比下诊断准确率的提升

表10 在CWRU数据集上不同不平衡比例下的诊断准确率
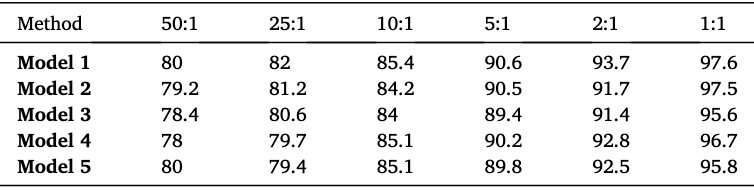
                     

表11 在HFHP数据集上不同不平衡比例下的诊断准确率
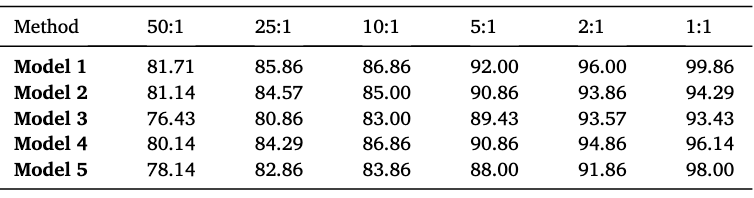
                 

如表所示,模型1在两个数据集的大多数不平衡比下始终提供卓越的诊断准确率,特别是当类别分布趋于相对平衡时(例如,CWRU数据集上2:1和1:1的准确率达到93.7%/97.6%,HFHP数据集上达到96.00%/99.86%)。尽管模型4和模型5在极端不平衡或中等不平衡场景下偶尔取得略优的性能(例如,CWRU数据集的50:1和HFHP数据集的10:1),但其诊断准确率随比例变化波动更为显著,表明稳定性和泛化能力较弱。相比之下,移除 PI 模块或 AE 模块的模型2和模型3,在所有设置下均显示出诊断性能的明显下降,突出了所提架构中两个组件的必要性。

这些结果证实,在类别不平衡条件下,生成与诊断之间的平衡权衡,而非合成样本的绝对保真度,是有效性能提升的关键。所提模型1很好地实现了这一平衡,从而带来总体更优且更稳定的诊断结果。

4.5.5. 模型结构与超参数分析

在极端类别不平衡和有限样本量条件下,模型性能对训练超参数和网络架构高度敏感。系统性实验结果表明,批量大小、网络深度、损失系数配置和学习率均对识别准确率产生决定性影响,各因素均呈现"适度最优"模式。这些发现凸显了精心选择架构和训练设置以确保此类挑战性场景下稳定性和泛化能力的重要性。

具体而言(见图19),关于批量大小,将其从1增加至5带来性能的逐步提升,在批量大小为5时达到最优。在此设置下,每个训练批次涵盖每类所有5个可用样本,从而实现更具代表性的梯度更新。然而,当批量大小进一步增加(≥10)时,性能显著恶化,表明小批量训练更有利于泛化。关于网络深度,从1层扩展至3–4层显著改善性能,表明适度深度增强特征提取能力;尽管如此,将深度增加至5层或更多导致性能下降,这可能是由于小样本条件下过拟合和梯度传播困难所致。对于损失系数策略,自适应方案(Method1)取得最佳结果,因为损失权重的动态调整有效平衡了训练过程中不同项的贡献。相比之下,移除正则化项(Method2)使性能退化,凸显其对稳定性和泛化能力的重要性,而固定系数(Method3)产生最差结果,表明缺乏灵活性阻碍学习。最后,学习率(learning rate)实验揭示出明显的先升后降趋势:当学习率从0.0001增加至0.0005时性能改善,但提升至0.001或更高时性能急剧下降。这表明过大的学习率导致不稳定收敛或发散,而过小的学习率则导致欠优化;在收敛速度与稳定性之间取得平衡,0.0005成为最优选择。
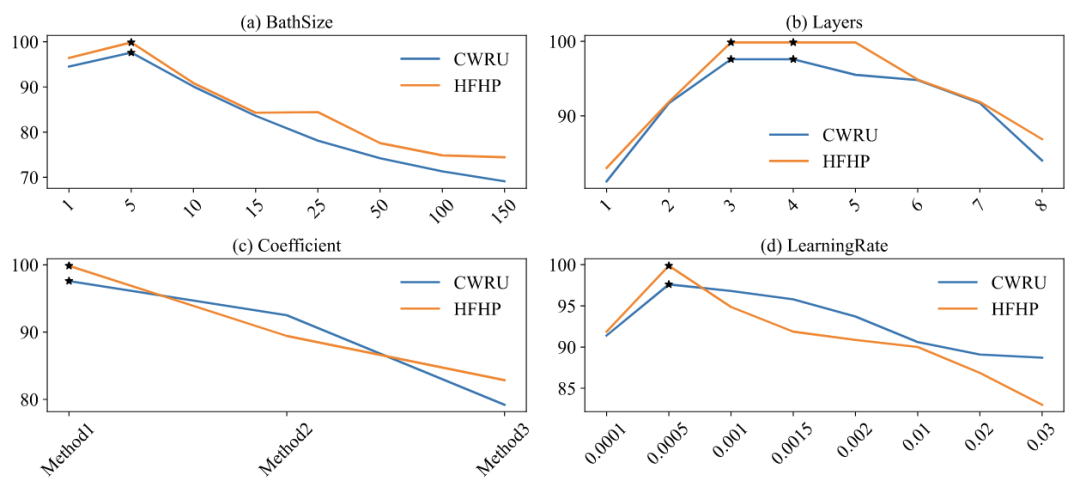
   

图19 超参数配置的烧蚀研究。考察( a )批次大小,( b )网络深度,( c )损失系数策略,( d )学习率对模型性能的影响

综上所述,在小样本和高度不平衡条件下,模型训练应遵循"适度最优"原则。小批量大小(例如,5)、适度网络深度(3–4层)、带正则化的自适应损失系数机制以及中等学习率(0.0005)共同提供最优越的性能和泛化能力。这些结果不仅确定了关键因素的最优配置范围,还为类似问题设置下的模型设计与优化提供了有价值的指导。

4.5.6. 可视化分析

为进一步评估所提模型的有效性,采用t分布随机邻域嵌入(t-SNE:t-distributed Stochastic Neighbor Embedding)对100:1不平衡条件下诊断分类器的隐藏层和输出层特征进行可视化。如图20所示,所有网络的隐藏层特征分布显示,故障类型2(绿色)、5(黄色)、3(粉色)和1(橙色)倾向于紧密聚类,表明这些类别相对难以区分。尽管如此,所提模型(图20(f))展现出比对比网络(图20(a)–(e))明显更清晰的聚类边界,后者的特征分布严重重叠。尽管各模型生成的样本相对于无增强基线(图20(a))均提供一定改善,但基于数字孪生的物理信息自编码器产生的合成数据实现了显著更丰富且更具可分性的表示。
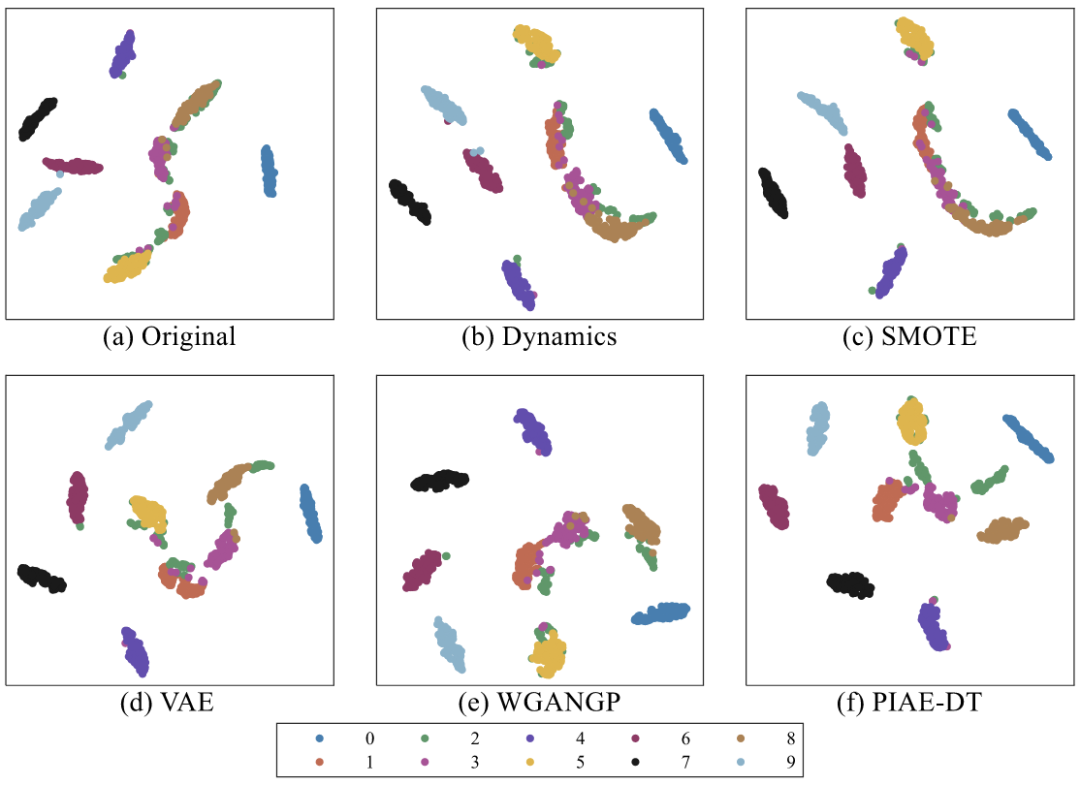
   

图20 1:1比例尺下各种生成方法的T - SNE图

类似地,图21可视化了分类器的输出层特征。在无增强情况下(图21(a)),大多数故障类型未能清晰界定,证实了严重不平衡导致诊断可分性较差。尽管模型2–5(图21(b)–(e))在一定程度上改善了聚类效果,但故障类型5(黄色)和4(紫色)仍难以区分,可能是由于生成的样本过于相似所致。相比之下,所提模型(图21(f))在所有故障类别上形成了分离良好、紧凑的聚类,表明基于数字孪生的物理信息自编码器不仅提升了诊断准确率,还通过提供高保真、高判别性的合成数据增强了特征提取质量。
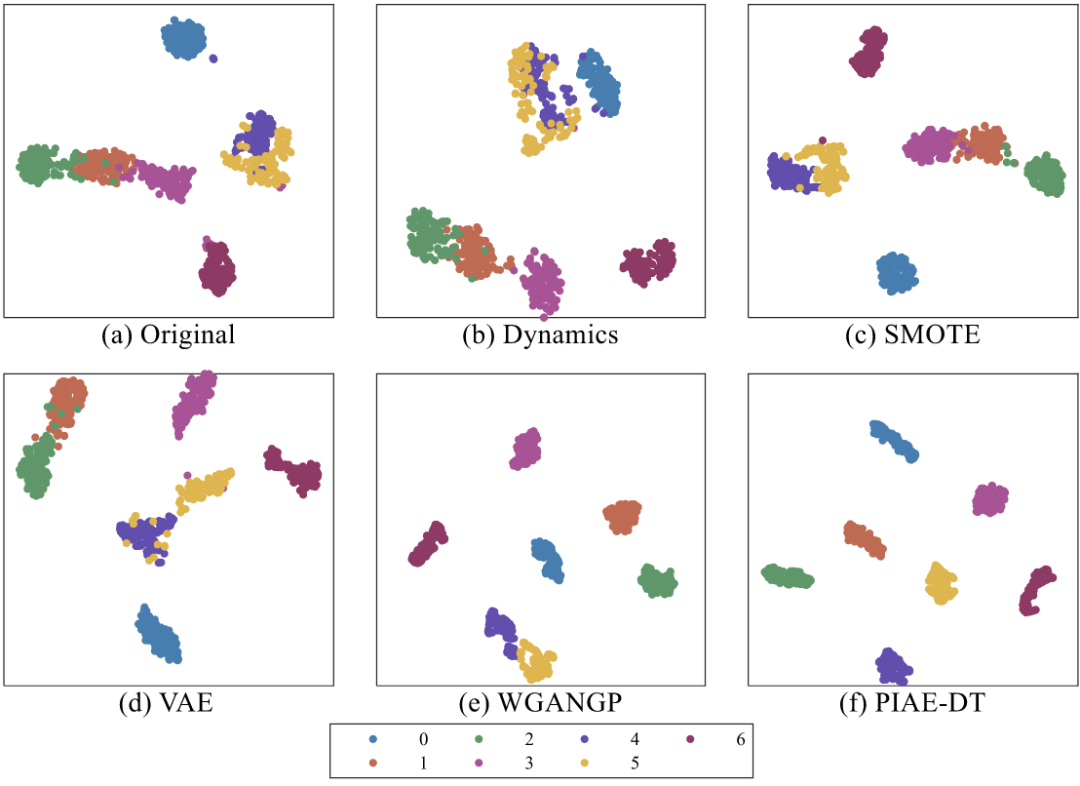
   

图21 1:1比例尺下各种生成方法的T - SNE图

5 结论

本研究开发了一种基于数字孪生的物理信息自编码器,用于增强不平衡样本条件下的轴承故障诊断。通过将无量纲物理信息模块嵌入自编码器框架,该方法识别出具有明确物理意义的动力学模型参数,从而提升了可解释性。利用这些参数的概率分布映射,在数字孪生空间中生成多样且动力学一致的故障数据,并通过重构振动信号验证了增强样本的物理合理性。在公开数据集和私有数据集上的实验表明,所提方法在不平衡条件下分别达到了97.60%和99.86%的诊断准确率,优于现有增强方法,显示出提升轴承故障诊断可靠性的巨大潜力。在两个数据集上,所提方法均改善了诊断性能,在解决类别不平衡方面效果最为显著。增强信号与实测特征高度吻合,支持了该方法在不同条件下的可靠性和适用性。这些改进在少数类故障中尤为明显,表明物理引导的约束有助于保持关键动力学特征,并增强严重不平衡条件下分类器的鲁棒性。

展望未来,轴承故障诊断有望朝着更先进的、物理引导的神经网络架构发展,将数据驱动方法的适应性与物理建模的可解释性相结合。随着数字孪生技术在工业监测中的日益普及,未来研究将把时间卷积网络、Transformer或其他高效特征提取器融入基于数字孪生的物理信息自编码器,并开发更精细的轴承动力学模型,以更好地捕捉复杂的运行行为并提升生成故障数据的准确性。当前网络结构虽然有效,但限制了更高保真度信号重构的能力,且其性能主要在故障特征清晰明确的条件下得到验证。在低保真度数字孪生或噪声更强的环境中,诊断性能可能会略有下降。基于先进架构与精细动力学模型融合的前景,该框架将得到改进,并可能具备应用于实时监测和零样本故障诊断的潜力,同时也有望部署于标注故障数据稀缺或不可用的环境中。通过进一步改进,该方法还可能具备在变化及前所未见的条件下进行测试的能力,以帮助确保鲁棒性并拓宽其在实际工业场景中的适用性。 

编辑:赵栓栓

校核:李正平、陈凯歌、曹希铭、赵学功、白亮、任超、海洋、陈宇航、Kira、Tina、王金、赵诚、肖鑫鑫、张优

该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除

来源:故障诊断与python学习
Mechanical振动非线性航空电子python海洋UM理论电机Electric爆炸创新方法数字孪生控制工厂
著作权归作者所有,欢迎分享,未经许可,不得转载
首次发布时间:2026-03-20
最近编辑:6月前
故障诊断与python学习
硕士 签名征集中
获赞 87粉丝 153文章 335课程 0
点赞
收藏
作者推荐

中科院一区Top论文学习|基于深度神经网络和双指数模型的混合剩余寿命预测方法

本期给大家推荐基于深度神经网络和双指数模型的混合剩余寿命预测方法。在剩余寿命(Remaining Useful Life, RUL)预测中,既要预测得准,又要知道“有多不确定”,一直是难题。本文提出了一种融合物理模型与深度学习的混合方法:用双指数退化模型刻画整体退化趋势,用GRU网络捕捉随机波动,再通过贝叶斯神经网络实现不确定性量化。该方法在三个锂电池数据集上的实验表明,即使在小样本条件下,也能实现更稳定、更准确的寿命预测,并且相比传统经验模态分解方法具有明显优势。研究为少样本场景下的可靠寿命预测提供了一种新思路。论文链接:通过点击最左下角的阅读原文进行在线阅读及下载。论文基本信息论文题目:A hybrid approach based on deep neural network and double exponential model for remaining useful life prediction 论文期刊:Expert Systems With ApplicationsDoi:https://doi.org/10.1016/j.eswa.2024.123563作者:Junyuan Liang (a), Hui Liu(b), Ning-Cong Xiao* (a) 论文时间: 2024年 机构: a: School of Mechanical and Electrical Engineering, University of Electronic Science and Technology of China, No. 2006, Xiyuan Avenue, West Hi-Tech Zone, Chengdu, Sichuan 611731, Chinab: School of Intelligent Medicine, Chengdu University of Traditional Chinese Medicine, No. 1166, Liutai Avenue, Wenjiang District, Chengdu, Sichuan 611137, China作者简介:肖宁聪,教授,博士生导师,电子科技大学与美国罗格斯大学联合培养博士,四川省学术与技术带头人后备人选,中国机械工程学会机械设计分会青年委员,《机械设计》青年编委,入选美国斯坦福大学和爱思唯尔联合发布的全球前2%顶尖科学家榜单,机械工程领域高质量科技期刊分级目录评审专家,国家级及省部级科技项目评审专家等。现研究方向为可靠性工程及装备健康管理(不确定性量化、结构可靠性、剩余寿命预测、机器学习、退化建模等)。工作以来,主持国家自然科学基金面上、四川省科技支撑计划和研究所委托横向等科研项目共15项;主研国家自然科学基金重点、国家863计划子课题等国家级项目8项;获得国家授权发明专利8项。荣获教育部自然科学二等奖、国防科学技术进步二等奖等省部级奖项共5项;电子科技大学研究生/本科生优秀论文指导教师奖、顶级期刊《Reliability Engineeirng and System Safety》授予的Outstanding Reviewer奖等荣誉;担任20余个国际知名学术期刊的审稿人。曾担任《IEEE Access》等客座主编;国际会议(如APARM、PHM、QR2MSE)分会场主席等。 发表学术论文70余篇,所做工作已被国际著名学者如Mahadevan、Zio、Sudret、中国科学院及中国工程院院士等引用,google学术引用2500余次,单篇最高引用400余次(第一作者),ESI高被引论文3篇、热点论文1篇。另外,发表在国际知名期刊Reliability Engineering and System Safety、Engineering Failure Analysis 的学术论文曾分别入选Top Cited RESS/EFA Articles榜单的第2名。(摘自电子科技大学教师个人主页)通讯作者邮箱:ncxiao@uestc.edu.cn 摘要为提高剩余寿命(Remaining Useful Life, RUL)预测精度和不确定性量化水平,学界已提出多种方法,包括基于模型的方法、数据驱动方法和混合方法。然而,基于模型的方法难以处理复杂关系和不确定性问题;数据驱动方法可能忽略先验知识,且在数据有限时表现不佳;用于RUL的混合模型则面临两大核心挑战:物理信息利用不充分以及难以准确量化不确定性。针对RUL中存在的非线性、小样本量和缺乏不确定性量化等问题,本文提出一种混合方法,旨在实现少样本场景下的RUL与不确定性量化。本研究结合基于模型的方法和数据驱动方法,提出一种混合方法以实现精准的RUL预测,并基于贝叶斯框架进行不确定性度量。具体而言,该方法通过双指数退化模型(Double-Exponential Degradation Model, DEDM)构建退化趋势模型,利用门控循环单元(Gated Recurrent Unit, GRU)网络预测退化波动,从而实现RUL的点估计;随后采用集成学习方法,通过贝叶斯神经网络(Bayesian Neural Network, BNN)整合不同模块,完成不确定性量化。通过在三个锂电池数据集上进行案例研究,验证了所提方法的适用性和有效性,并与常用的基于经验模态分解(Empirical Mode Decomposition, EMD)的方法进行了对比分析。实验结果表明,该方法在数据泄露和无数据泄露场景下均表现良好,且在小样本数据集下比单一方法更能实现准确的RUL预测。最后,本研究致力于在未来的研究中整合物理模型和数据驱动模型,以应对数据漂移问题。关键词:剩余寿命预测,经验模型,门控循环单元,贝叶斯神经网络,不确定性量化,混合方法 目录1 引言2 所提方法2.1 概述2.2 数据分析2.3 双指数退化模型2.4 GRU-CNN网络2.5 混合网络3 案例研究3.1 实验数据集3.2 预处理和模型结构3.3 评估指标3.4 可行性分析3.5 结果与讨论3.6 消融实验4 结论1 引言预测与健康管理(Prognostics and Health Management, PHM)利用传感器数据和其他信息源(Zio,2022)监测结构、系统和部件(Structures, Systems, and Components, SSCs)的健康状态。其目标是在潜在问题发生前对其进行识别,进而采取纠正措施,防止灾难性故障发生,最大限度减少停机时间并降低维护成本(Xu和Saleh,2021)。剩余寿命(Remaining Useful Life, RUL)预测是PHM的核心组成部分之一,因为它能为维护决策提供有用信息,避免非计划停机,提高结构、系统和部件的安全性与可靠性。通常,准确的RUL预测需要整合来自传感器、历史数据和先验知识等多种来源的数据。目前已开发出多种RUL预测方法和技术,包括基于模型的方法(Liao和Köttig,2014;Downey等,2019;Lui等,2021)、数据驱动方法(Severson等,2019;Nguyen等,2022;Li等,2021;Xu等,2021;Zhan等,2023)以及混合方法(Liao和Köttig,2014;Tang和Yuan,2022;Liu等,2021;Yao等,2022)。基于模型的方法(也称为基于物理的方法)依赖于描述SSCs物理化学过程的数学模型来预测其行为。例如,利用电化学模型描述锂电池容量的退化轨迹(Lyu等,2017;Khodadadi Sadabadi等,2021),利用疲劳裂纹萌生和扩展机制构建轴承退化模型(Corbetta等,2015;An等,2013)。然而,构建准确的物理模型需要对SSCs有深入的理解,且耗费大量资源。为简化这一过程,许多研究者利用专家知识推导经验模型,例如锂电池的指数退化模型(He等,2011)、轴承的加速失效时间模型(Moustafa等,2021)、储气库注采管柱的渐进退化模型(Zhang等,2021)。综上,基于模型的方法计算效率高,能详细揭示SSCs的行为规律,但对模型不确定性敏感,且需要获取结构、系统和部件物理特性及退化机制的准确知识,这在实际应用中往往难以实现。相比之下,数据驱动方法依赖统计和机器学习技术从数据中提取模式和退化趋势。这类方法假设结构、系统和部件的行为可通过数据推断得出,无需深入理解其潜在的物理化学原理。数据驱动方法主要可分为两类:统计方法和机器学习方法。统计方法包括时间序列回归技术和随机过程,例如自回归积分滑动平均模型(Autoregressive Integrated Moving Average, ARIMA)(Zhou和Huang,2016;Ordóñez等,2019)、维纳过程(Hu等,2018;Atam等,2018)。近年来,机器学习因其能够处理复杂数据并识别传统统计技术难以捕捉的数据模式而受到广泛关注。常用的机器学习方法包括支持向量机(Support Vector Machine, SVM)(Patil等,2015;Meng等,2018)、深度神经网络(Lu等,2022;Pillai和Vadakkepat,2021;Wen等,2023;Wen和Lin,2024)。然而,数据驱动模型可能无法利用系统的先验知识,且需要充足的样本数据(Mohajer等,2023)。如前所述,基于模型的方法受限于物理模型的准确性,而数据驱动方法依赖于数据质量。在实际应用中,SSCs的复杂性使得建立准确的物理模型面临挑战;同时,受成本限制,部署大量传感器以获取高质量数据也存在困难。为克服这些局限性,混合方法作为一种具有潜力的方案被应用于RUL预测领域。与纯数据驱动方法相比,混合方法所需数据更少;与纯模型方法相比,混合方法对噪声和异常值更具鲁棒性。目前,已有大量文献采用混合方法进行SSCs的RUL预测。Yao等(2022)提出了粒子群寻优-极限学习机-相关向量机模型,用于带不确定性表达的RUL预测;Liu等(2023)设计了无迹卡尔曼滤波-动态贝叶斯网络(Unscented Kalman Filter-Dynamic Bayesian Networks, UKF-DBNs)模型,利用DBNs进行不确定性分析,采用UKF进行RUL预测;Li 等(2021)设计了基于粒子滤波(Particle Filter, PF)和支持向量回归(Support Vector Regressor, SVR)的集成模型,用于多步超前预测和不确定性量化;Tang等(2022)采用自适应噪声完整集 合经验模态分解将测量数据分解为高频和低频序列,并结合这两个序列的预测结果评估RUL;Xiong等(2023)基于多种失效模型开发了长短期记忆(Long Short-Term Memory, LSTM)预测模型;Ma等(2023)提出了一种混合DBN-LSTM网络用于健康状态估计。可见,上述混合方法可分为两类:一类包含不确定性量化(Yao等,2022;Liu等,2023;Li等,2021),另一类不包含不确定性量化(Tang和Yuan,2022;Xiong等,2023;Ma等,2023)。现实世界中收集的数据通常存在不准确、不完整的问题。为提高模型的泛化能力和鲁棒性,对RUL进行不确定性分析至关重要,这有助于顺利开展预防性维护,提高维护计划的合理性。然而,现有混合模型主要采用统计方法(如UKF、PF)进行不确定性量化,依赖机器学习技术(如SVR、极限学习机)进行RUL预测,极少有方法将物理模型与机器学习模型相结合。这是由于物理模型构建难度大,且传统机器学习方法难以提供不确定性量化结果。为在有限数据下实现准确的RUL预测,不应忽视SSCs的物理退化机制。因此,将退化机制与深度学习相结合是一种具有吸引力的解决方案。为实现小样本量下的SSCs预测,需利用SSCs的退化机制。为此,本文引入集成学习这一常用的模型融合技术。集成学习的基本思想是训练多个模型,每个模型捕捉输入特征与输出之间不同方面的关联,将这些模型组合起来,可得到比单一模型更准确、更鲁棒的最终预测结果。在RUL预测中,尤其是针对复杂且含噪声的数据集,集成学习具有良好的效果。Xing等(2013)融合指数退化模型和多项式退化模型,用于跟踪锂电池的退化趋势;Lin等(2020)开发了多阶段线性模型,用于多阶段RUL预测。然而,这些经验退化模型基于数学表达式描述,无法捕捉运行条件变化对RUL预测的影响。为解决这一问题,Li等(2019)集成了循环神经网络和SVM等多种模型,以提高预测精度;Tong等(2021)提出了ADLSTM网络,用于准确的早期RUL预测。但随之而来的问题是,传统神经网络只能提供RUL的点估计,降低了预测的可信度。在不确定性量化方面,贝叶斯神经网络(Bayesian Neural Network, BNN)通过将贝叶斯方法融入神经网络中,受到了广泛关注。将神经网络扩展为BNN,可实现不确定性量化。在RUL预测中,Kim等(2021)提出了一种贝叶斯深度学习框架,数值研究表明该框架提高了预测性能;Li等(2021)构建了贝叶斯深度学习框架,并通过液压断路器验证了其有效性。这些研究采用BNN量化RUL的不确定性,但忽略了SSCs的退化机制,无法应用于少样本场景。综上,本文识别出RUL预测中需要进一步关注的两大挑战:(1)现有研究较少关注神经网络与物理模型的结合,忽略了可从退化机制中获取的有价值信息;(2)当前神经网络模型仅考虑点估计,而带有不确定性量化的RUL预测对于优化维护策略至关重要。针对上述问题和挑战,本文提出一种新型混合RUL预测方法。本文的主要贡献如下:(1)提出一种新型混合方法,通过集成学习整合经验模型和神经网络,在小样本场景下表现出良好性能;(2)将BNN作为元模型,提供RUL的不确定性量化结果。现有许多RUL预测方法需要大量数据来建立模型,这意味着需要产品的早中期数据作为训练集,因此这些方法仅在产品生命周期的后期才可靠。相比之下,本文提出的方法利用先验知识,显著减少了所需数据量,能够更早地进行RUL预测,为早期维护决策提供依据。综上,本研究旨在通过开发一种新型方法,解决少样本场景下RUL预测和不确定性量化的挑战。为应对第一个挑战,本文尝试设计一种混合方法,整合SSCs的退化机制与监测数据,以在有限数据条件下实现准确的RUL点估计。该方法将指数退化模型等经验模型与门控循环单元(Gated Recurrent Unit, GRU)模型等循环神经网络相结合:经验模型在少样本场景下捕捉SSCs的退化趋势,随着监测数据的积累,神经网络模型进一步提高RUL预测精度。为应对第二个挑战,该方法引入贝叶斯框架,用于SSCs的不确定性量化。通过采用BNN,整合经验模型和深度神经网络,量化两个模型相关的不确定性,最终实现RUL不确定性的量化。本文其余部分结构如下:第2节介绍基于BNN的双指数退化模型(Double-Exponential Degradation Model, DEDM)和门控循环单元-卷积神经网络(GRU-CNN)混合方法;第3节基于多个电池数据集验证所提方法;第4节给出结论与总结。2 所提方法2.1 概述所提方法主要包含三个部分:基于模型的部分、数据驱动的部分和混合部分。方法概述如图1所示,主要分为以下四个步骤: 步骤1:分析实验数据,采用适当的预处理方法; 步骤2:建立经验退化模型,利用先验物理知识和实验数据跟踪结构、系统和部件的退化趋势; 步骤3:构建GRU-CNN,建立数据驱动模型,以实验数据为输入,捕捉退化状态的波动; 步骤4:构建混合模型,将前三个步骤的输出作为输入,采用BNN进行RUL的不确定性量化。 图1 所提方法概述 具体而言,模型1为DEDM,能够捕捉SSCs的退化趋势;DEDM模型是一种经验模型,因其简洁性而被广泛用于RUL预测(He等,2011;Xing等,2013)。该模型通过假设两阶段退化过程来捕捉SSCs的退化趋势:在初始阶段,SSCs的退化速率相对较慢,代表正常老化过程;当接近寿命末期时,第二阶段的退化速率显著增加,表明快速劣化。双指数退化模型通过两个指数项捕捉这种两阶段退化行为,然后通过非线性最小二乘法(Non-Linear Least Squares, NLLS)拟合模型参数。模型2致力于利用失效数据训练GRU-CNN,捕捉短期波动。GRU是循环神经网络的一种,因其能够在特定时间段内保留信息而被开发,广泛应用于RUL预测(Ding等,2023;Cao等,2023)。GRU利用更新门和重置门等门控机制来调节网络内的信息流。CNN通过可学习的滤波器提取相关特征并学习局部模式。在模型2中,这种组合利用了两种模型的优势,实现准确的RUL预测。为实现RUL预测和不确定性量化,在模型3中通过BNN整合上述两个模型。BNN将贝叶斯推理技术融入深度神经网络,与传统神经网络仅产生点估计不同,BNN将模型权重和偏置建模为概率分布,从而能够量化模型预测相关的不确定性,使其在不确定性估计至关重要的场景中具有重要价值(Zhu等,2022;Wang等,2022)。下文第2.2节描述监测数据的预处理;第2.3节和第2.4节分别详细介绍数据驱动方法和基于模型的方法;最后,第2.5节通过BNN整合两个训练好的模型。2.2 数据分析2.2.1 数据泄露在RUL预测领域,文献中提出的许多方法往往存在数据泄露问题。然而,作为预测与健康管理的关键组成部分,RUL预测不应容忍此类问题。因此,本节将详细阐述数据泄露的原因及其可能带来的潜在后果,并讨论避免数据泄露的方法。在后续章节中,将进一步理解和应用这些方法,以确保所提方法的可靠性和准确性。 数据泄露可简单定义为在模型开发过程中使用训练数据集之外的数据。具体而言,最常见的情况是测试数据集的信息被无意中泄露到训练数据集中。数据泄露会导致模型在训练阶段获取到本不应有的知识,进而使模型失效。换句话说,数据泄露可能导致模型在训练数据集上表现良好,但在现实场景中的新数据上表现不佳,因此该模型准确性极低,无法用于决策。 RUL预测是一项时间序列预测任务。在RUL预测中,需将时间序列划分为训练集和测试集。一种常见的数据集划分方式如图2所示,将时间序列的前半部分作为训练集,后半部分作为测试集。 图2 时序数据划分图2中,绿色 区域对应“过去”,代表已知数据;红色 区域对应“未来”,代表需要预测的未知数据。在RUL预测中,数据预处理阶段最容易发生数据泄露,尤其是对于涉及多个时间步长的预处理方法,例如Z-score归一化、经验模态分解(Empirical Mode Decomposition, EMD),如图3和图4所示。从图3可以看出,整个数据集的Z-score归一化结果(红线)高于训练集(蓝线);类似地,图4显示,对整个数据集应用EMD得到三个本征模态函数(Intrinsic Mode Functions, IMF),而仅对训练集应用EMD仅得到两个本征模态函数IMF。这是因为在预处理过程中包含了“未来”信息,而在实际应用中,未来信息是未知的。在RUL预测中,若在划分数据集之前对数据进行预处理,会导致“未来”信息泄露到整个数据集中,使模型在训练过程中获取到测试集的信息,从而提升模型在训练集上的性能,但在实际应用中,由于未来变化未知,预测结果可能不准确。因此,在RUL预测中,正确的做法是先划分数据集,再对数据进行预处理,如图5所示。 图3 Z-score归一化 图4 B18的EMD结果 图5 正确的时间序列数据预处理方法 值得注意的是,训练集和测试集之间存在偏差,这是由时间序列的特征(如均值、方差)随时间变化引起的。这对准确的时间序列预测构成了挑战,因为模型需要在特定时间范围内保持泛化能力,并预测未来数据分布的变化。因此,区间估计更适合用于衡量未来数据变化的范围。 2.2.2 数据预处理时间序列数据通常是非平稳的,即其均值、方差和自相关等统计特性随时间变化。非平稳时间序列会使预测任务变得困难,因为难以捕捉推理过程中统计特性的变化。 由于非平稳时间序列会导致预测不准确和模型性能不可靠,因此需要将非平稳时间序列转换为平稳时间序列。通常可采用差分方法实现这一转换。给定时间序列 ,可得到该时间序列的差分为: 其中, 为D阶差分算子,L为滞后算子,定义为 。一阶差分可表示为: 同理,二阶差分可推导为: 通过差分,非平稳时间序列被转换为平稳序列,且该方法不存在数据泄露问题,从而提高了所提方法的可靠性。2.3 双指数退化模型2.3.1 经验退化模型为在保持简洁数学表达式的同时准确捕捉退化轨迹的非线性关系,本文探索了两种经验模型,用于跟踪SSCs的非线性退化并确定相应参数。第一种模型包含两个指数项和四个系数,表达式如下: 其中,M为模型输出,t为充放电循环次数,a、b、c、d为需要通过测量数据拟合的模型系数。该模型被广泛用于锂电池容量预测(Downey等,2019;He等,2011)。需要注意的是,式(4)存在多种变体。例如,Downey等(2019)开发了一种类似模型,考虑正负极活性物质的演变: 通过基于观测数据拟合模型参数,实现对退化轨迹的跟踪。本研究采用NLLS拟合式(4),因其应用更为广泛。2.3.2 非线性最小二乘法NLLS是一种常用于曲线拟合问题的优化技术。在训练过程中,通过最小化观测值与预测值之间残差的平方和来拟合非线性函数的参数。其数学表达式如下: 其中, 为非线性函数,X为自变量向量, 为未知参数向量。对于一组包含n个观测值的数据集 ,NLLS的目标是找到参数向量。本研究中,经验退化模型仅有四个未知参数,通常采用迭代算法求解该优化问题,例如列文伯格-马夸尔特算法或信赖域反射算法。本研究通过Python的Scipy库(Virtanen等,2020)实现非线性最小二乘拟合。2.4 GRU-CNN网络GRU是LSTM的简化版本,性能相当,但参数更少、计算速度更快。GRU的结构包含两个门:重置门和更新门。直观地说,重置门控制单元何时遗忘状态,更新门控制新状态被旧状态替换的程度。GRU的计算流程和结构如图6所示。 图6 GRU的结构数学上,假设输入为批次 ,在给定时间步t计算每个组件如下: 其中, 为时间步t的重置门矩阵, 为更新门矩阵, 为候选隐藏状态, 为时间步t的隐藏状态, 为前一隐藏状态矩阵, 为sigmoid激活函数,tanh为双曲正切函数, 为逐元素乘法算子。 、 、 、 、 、 以及 、 、 为可学习的权重矩阵和偏置。然而,由于GRU在每个时间步都会产生输出,因此需要实现一个用于特征提取的神经网络,以确保能够在下一个时间步做出准确预测。为此,本文采用一维卷积神经网络,从多个尺度提取输入特征,捕捉GRU中固有的时间序列关系。最后,结合两种模型的优势,构建简单有效的GRU-CNN。该深度神经网络的整体框架如图7所示。 图7 GRU-CNN的框架综上,所提出的GRU-CNN的网络结构描述如下:(1)原始数据为一维时间序列,采用GRU进行时间序列预测;(2)通过长度为n的滑动窗口获取神经网络的输入,如图8所示。为准确预测下一个时间步的容量,采用一维卷积神经网络从前n个时间步提取信息;(3)基于卷积层,将提取的信息传递到全连接层,实现RUL预测。 图8 GRU-CNN的输入和输出2.5 混合方法2.5.1贝叶斯神经网络 通过将贝叶斯推理融入深度神经网络,BNN可用于不确定性量化。具体而言,BNN采用概率分布近似RUL的后验分布,实现更灵活、更鲁棒的RUL预测。BNN的工作流程如图9所示。在RUL预测中,计算BNN输出与实际值之间的KL散度,通过随机变分推理(Stochastic Variational Inference, SVI)将该KL散度转换为证据下界(Evidence Lower Bound, ELBO),最后采用SGD更新贝叶斯神经元的参数。 图9 BNN工作流程给定训练集 ,BNN对参数引入先验假设 ,将不确定性纳入神经网络。先验分布 通常假设服从混合尺度高斯先验(Blundell等,2015),表达式如下: 该分布使得基于输入 和参数w预测 的概率模型可表示为 : 然而,根据贝叶斯理论,后验分布 计算如下: 在式(10)中, ,这意味着需要遍历所有可能的参数w才能获得该积分,因此 难以直接计算。除了一些特殊情况(例如 和 均满足高斯假设的卡尔曼滤波),实际应用中常见的是非高斯问题。为求解式(10),采用变分推理作为近似解决方案。2.5.2 变分推理为解决后验分布 的求解问题,采用变分推理进行近似求解。变分推理已成为概率深度学习领域中一种流行的统计技术,用于近似复杂的后验分布。与传统贝叶斯方法需要计算难以处理的后验分布不同,变分推理采用更简单、更易处理的分布(如高斯分布)近似真实后验分布。本研究中,采用一种更简单的分布近似后验分布 ,该分布也称为变分分布。 变分推理的目标是找到与真实后验分布接近的变分分布,这通过最小化变分分布 与真实后验分布 之间的KL散度实现,其中 由一组参数控制(例如高斯分布中的 )。KL散度用于衡量两个概率分布之间的差异,定义如下: 将式(9)代入式(10),可得: 重新整理后得到: 其中, 为变分分布, 为真实后验分布, 为数据集D和模型参数w的联合分布, 为关于 的期望。右侧第一项为 的熵,衡量 中的不确定性;第二项为 与 之间的交叉熵,衡量通过 近似真实后验分布所获得的信息量;最后一项与 无关,在给定数据集D下为常数。 变分推理的核心是ELBO,它是变分分布 和模型参数w的函数。ELBO为数据集D的边际似然提供了一个下界,其优化可得到后验分布的近似解,用于RUL预测。ELBO定义如下: 结合式(13)和式(14),可得BNN的目标函数: 其中, 为常数,因此只需最大化ELBO即可。通常采用蒙特卡洛方法求解ELBO,并通过SGD优化式(13)。2.5.3 蒙特卡洛和梯度下降具体而言,给定联合分布 和变分分布 ,可采用蒙特卡洛方法估计ELBO: 其中, 是从变分分布 中抽取的一组样本,S为用于估计的样本数量。 为优化ELBO,采用SGD最大化上述ELBO的蒙特卡洛估计值,以更新变分参数 。具体而言,通过链式法则计算ELBO关于 的梯度: 利用该梯度,沿最大化ELBO的方向更新变分参数。通过多次迭代,可得到一组优化后的变分参数,用于近似RUL预测的后验分布: 其中,S是从分布 中抽取的样本数量。3 案例研究本节将验证所提方法的性能。为此,本文对比了三个数据集(详见第3.1节),并在第3.2节描述了模型结构、参数和预处理方法,第3.3节介绍了所提方法的评估指标,第3.4节讨论了数据泄露和模型可行性,第3.5节研究了所提方法在锂电池RUL预测和不确定性量化中的应用,最后在第3.6节进行了消融实验,以验证所提方法的有效性。3.1 实验数据集为验证所提方法的有效性,选取了NASA艾姆斯预测卓越中心(Prognostics Center of Excellence, PCoE)电池数据集(Yang等,2018)、NASARandom Walk(RW)数据集(Bole等,2014)和牛津大学电池退化数据集(Raj,2020)。这些数据集具有短期波动和多种容量退化曲线特征。许多相关研究已验证了这些电池数据集在RUL预测中的有效性(Downey等,2019;Liu等,2021;Chen等,2022)。 第一个数据集来自NASA PCoE,包含四个不同的电池,分别记为B05、B06、B07和B18,如图10(a)所示。电池在三种不同的运行模式下工作:充电、放电和阻抗测试。当电池容量降至额定容量的70%(从2Ah降至1.4Ah)时,达到寿命终止(End-Of-Life,EOL)标准,实验终止。 第二个数据集为NASARW数据集,包含四个电池,分别记为RW9、RW10、RW11和RW12,如图10(b)所示。每个电池在-4.5A至4.5A的电流范围内进行循环操作(称为RW操作)。这些电池的额定容量为2.1Ah,失效阈值设定为1.4Ah。 第三个数据集来自牛津大学,电池标记为Cell1、Cell2、Cell3和Cell4,每个电池的额定容量为0.74Ah,四个电池的退化曲线如图10(c)所示。 图10 三个电池数据集3.2 预处理和模型结构在实际应用中,所有电池容量的退化轨迹都是非线性、非单调的过程。在充放电循环过程中,可能会出现容量恢复现象和局部波动。因此,有必要采用差分方法将序列转换为平稳时间序列。如第2.2.2节所述,差分方法的优势在于易于实现且避免了数据泄露,比基于EMD的方法更可靠。图11展示了B06和B18的一阶及更高阶差分结果。可以看出,一阶差分和二阶差分之间存在显著差异,而三阶差分后差异变得微弱。因此,本研究考虑一阶和二阶差分。 图11 高阶差分随后,将差分信号和原始信号输入所提方法,进行容量预测和不确定性量化。表1提供了三个电池数据集案例研究中使用的模型结构和超参数细节。 表1 超参数和网络结构 将差分信号和原始信号输入GRU-CNN模块,其中B = 8表示批次大小, 表示滑动窗口宽度, 表示三个输入特征:原始数据、一阶差分和二阶差分。通过第一个GRU层后, ;然后, 和 分别表示卷积操作后缩减的时间长度和特征维度; 表示GRU-CNN模块的最终输出维度。将DEDM的输出和其他特征输入BNN,其中 表示四个输入,即DEDM的输出、原始数据、一阶差分和二阶差分。输出拼接为 ,BNN层的特征维度为 和 。此外,学习率设置为0.004,采用早停策略防止过拟合,GRU-CNN采用Adam优化器训练,BNN采用SVI训练。本研究的实验在配备Intel i5-7300H CPU和Nvidia GTX1050GPU的笔记本电脑上进行,使用的软件为Python 3.10.9和PyTorch 2.0。3.3 评估指标为评估所提方法的性能,采用以下常用指标来衡量RUL预测的准确性和可信度。 第一个指标是平均绝对误差(Mean Absolute Error, MAE),用于衡量预测RUL与实际RUL之间的平均绝对差异,定义为: 第二个指标是均方根误差(Root Mean Squared Error, RMSE),用于衡量预测RUL与实际RUL之间平方差的平均值的平方根,定义为: 其中,n为样本数量, 为真实RUL, 为预测RUL。 除MAE和RMSE外,还采用预测区间(Prediction Interval, PI)覆盖概率(PI Cover Probability, PICP)和预测区间归一化平均宽度(Prediction Interval Normalized Averaged Width, PINAW)评估预测RUL相对于实际RUL的不确定性性能。PICP衡量实际RUL值落在PI内的次数百分比,PINAW衡量PI的平均宽度相对于实际RUL值范围的比例。PICP越高,表明PI越能准确捕捉RUL估计的不确定性;PINAW越低,表明PI越窄、越精确。PICP定义为: 其中,当 时, ,否则 ; 和 分别为PI的下界和上界, 为真实RUL值。理想情况下,PICP应设置为预定义的置信水平(如95%),以确保PI能准确捕捉不确定性。 PINAW的数学定义为: 其中, , 和 分别为真实RUL的最大值和最小值。PINAW是PI宽度的归一化度量,值越低表明RUL不确定性的估计越精确。 最后,基于这些指标,将所提方法与文献中的现有方法进行性能对比。3.4 可行性分析目前,已有多项研究基于EMD方法提出了新型锂电池RUL预测模型(Tang和Yuan,2022;Liu等,2021)。然而,如第2.2.2节所讨论的,这些方法在时间序列问题中容易出现数据泄露。因此,本节对所提方法进行可行性分析,以确保模型的可用性和可靠性。 本节将所提方法与基于EMD的方法进行对比,研究数据泄露的影响,如图12所示。模型1为EMD+高斯过程回归(GaussianProcessRegression, GPR)+LSTM,对完整数据集应用EMD会导致数据泄露;模型2同样为EMD+GPR+LSTM,但仅对训练集应用EMD,避免了数据泄露;模型3为所提方法,差分方法不会导致数据泄露。此外,表2显示所提方法在大多数性能指标上表现优异,明显优于模型2,与模型1相当。从图12(c)可以看出,差分方法与训练集大小无关,这表明所提方法在无数据泄露的情况下实现了出色的性能。 图12 B06的可行性分析 表2 以80为起始点的方法性能比较 3.5 结果与讨论3.5.1 案例研究Ⅰ本节利用NASAPCoE数据集验证所提方法的有效性。该数据集锂电池的RUL预测结果如图13所示,包括电池B05、B06、B07、B18。所提方法的上述指标RMSE、MAE、PICP、PINAW如表3所示。随着训练集规模的增大,置信区间变窄,表明模型能够有效量化噪声的影响,并提供更高水平的不确定性估计。从图13可以看出,所提方法能够准确估计电池容量,在不确定性量化方面表现良好。例如,在B06电池的案例中,起始点为60时,电池容量终止于1.185Ah,预测结果为1.217Ah,置信区间为[1.175, 1.261]。 图13 NASAPCoE数据集上的RUL预测结果 表3 本文提出的方法在不同起始点下的预测结果 为进一步验证所提方法的有效性和优越性,表4给出了所提方法与现有方法的对比结果。从表中可以看出,所提方法在RMSE和MAE方面优于大多数现有方法;在不确定性量化方面,所提方法在PICP和PINAW上均表现出显著性能。总体而言,本文提出的混合方法在锂电池容量预测的准确性和不确定性量化方面均表现出可靠的性能。 表4 以60为起始点,不同方法的比较结果。 3.5.2 案例研究Ⅱ 本节利用NASARW数据集验证所提方法的泛化性和鲁棒性。本实验的模型结构与前一节一致,仅调整了部分超参数:由于NASA RW数据集的循环次数有限,学习率设置为0.001。此外,为进行对比,选取起始点为10、15和20。不同起始点的仿真结果如图14所示,相应的指标值如表5所示。 图14 NASA RW数据集的RUL预测结果 表5 本文提出的方法在不同起始点下的预测结果 值得注意的是,在RW12电池中,起始点为15时的预测性能低于起始点为10时的性能,这可能是由于在第15次循环时恰好出现了容量恢复现象,对模型产生了影响。总体而言,所提方法在点估计和不确定性量化指标上均保持较小的值,在不同起始点下均表现出优异的预测性能,表明其能够适应不同的数据集,具有较强的鲁棒性和泛化能力。 同样,将所提方法与现有方法在RW9、RW10、RW11和RW12电池上进行了对比,对比结果如表6所示。 表6 以10为起始点,不同方法的比较结果 从表中还可以看出,所提方法在大多数情况下表现良好。在RW10电池中,所提方法的RMSE与Tang和Yuan(2022)的结果仅相差0.0005,MAE与Wang等(2022)的结果仅相差0.0012。此外,Liu等(2021)在不确定性量化中表现出更小的PINAW,表明置信区间更窄,但较低的PICP表明这些区间可能无法覆盖真实值,意味着预测结果不可靠。 3.6 消融实验 本节通过消融实验验证所提方法的有效性源于多个模块的组合,而非单一模块的影响。具体而言,将所提方法与以下模型进行对比,实验采用牛津大学电池数据集: 模型1*(M1*):所提模型; 模型2*(M2*):仅DEDM; 模型3*(M3*):仅GRU-CNN; 模型4*(M4*):不含GRU-CNN的模型; 模型5*(M5*):不含DEDM的模型; 模型6*(M6*):不含差分处理的模型。 同样,模型结构和指标与案例研究一致。但由于篇幅限制,本实验仅在Cell1(C1)和Cell2(C2)上进行,起始点设置为20。消融实验结果如图15和表7所示。可以看出,模型1在点估计方面显著优于其他模型,RMSE和MAE均达到最小值;在不确定性量化方面,模型1的PICP为1,确保了所有真实值都被覆盖,表明不确定性量化可靠。值得注意的是,在C1案例中,模型5的标准化平均预测区间宽度(Normalized Mean Prediction Interval Width,NMPIW)与最优值仅相差0.017,但仅覆盖了一半的真实值,表明其提供的置信区间不可靠;此外,在模型5的C2案例中,NMPIW达到最优值,这表明经验模型(本研究中为DEDM)的准确性对不确定性量化有显著影响,因此经验模型的选择是未来的研究方向之一。 图15 消融实验结果表7 不同模型的结果对比 最后,进一步讨论数据泄露问题,并对比差分方法与基于EMD方法的结果,如表8所示。基于EMD的模型1(EMD1)和模型2(EMD2)与第3.4节中的定义一致。对比模型1和模型6,可以看出差分数据对于点估计性能有显著影响,主要是因为差分提供了关于退化波动的信息;此外,对比模型1 *和EMD1,EMD1在NMPIW上优于所提方法,但这种优势源于数据泄露——EMD1模型在训练过程中从测试集获取了信息,在数据集中表现良好,但在实际应用中不可靠。此外,当训练集仅包含20个数据点时,EMD2仅能得到残差,无法分离出IMFs,导致GPR无法拟合IMFs,从而丧失了不确定性量化能力,这表明EMD方法在小样本数据集下存在不足。 表8 基于EMD方法的对比结果 值得注意的是,由于C1案例的退化曲线较为平缓,EMD2的RMSE优于所提方法,但在C2案例中,样本量不足导致EMD无法分解出IMFs,从而阻碍了GPR对退化波动的预测。总体而言,所提方法采用差分方法捕捉高频信息(而非IMFs),利用DEDM处理残差以捕捉低频信息,在少样本场景下实现了预测准确性,且无数据泄露问题。4 结论少样本条件下RUL的准确预测和不确定性量化是一项具有挑战性的任务。本研究提出一种用于少样本场景下RUL预测的混合模型。为解决小数据集下的信息缺失问题,该模型利用专门的组件整合先验知识和监测数据,具体包括:(1)经验退化模型,捕捉锂电池的退化趋势;(2)GRU-CNN,使深度神经网络能够过滤监测数据中的噪声,捕捉电池容量的短期波动;(3)BNN,用于结果的不确定性量化。在多个数据集上的实验表明,所提模型在MAE、RMSE、PI和PINAW等指标上均表现出优异性能。最后,本研究探讨了混合模型的未来发展方向:(i)识别潜在的退化模型;(ii)考虑数据分布漂移;(iii)更深入地整合基于模型的方法和数据驱动方法,实现可解释的混合模型。 编辑:陈宇航校核:李正平、陈凯歌、曹希铭、赵学功、白亮、任超、海洋、赵栓栓、Kira、Tina、王金、赵诚、肖鑫鑫、张优该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除来源:故障诊断与python学习

未登录
还没有评论
课程
培训
服务
行家
VIP会员 学习计划 福利任务
下载APP
联系我们
帮助与反馈