实战演练|最新版CARLA 0.9.16结合NVIDIA COSMOS进行数据合成
作者 | 张峻川
编辑 | 李慢慢
出品 | 车路漫漫
仿真最前沿干货来袭,建议先收藏。
CARLA官方最新发布的版本 《CARLA 0.9.16 发布啦》 大家都看了嘛?其中包含了和NVIDIA联合开发的三项重大前沿功能:Cos mos Transfer,SimReady和NuRec,今天笔者就Cos mos Transfer合成数据功能进行简单尝试。不知道Cos mos的小伙伴戳这个链接可以补补课《英伟达的Cos mos是个什么东东》。
CARLA和Cos mos的联合仿真的官方文档可见文末参考链接[1]。首先进行整体思路介绍:
1、CARLA根据保存的场景回放或新搭建场景录制数据,产生如物体边缘edge视频、深度depth视频、分割semantic_segmentation视频等;
2、上面这些视频作为NVIDIA cos mos transfer1的控制条件输送给推理模型,推理模型根据提示词prompts生成所需要风格的视频数据。
如下是实操过程,想看效果的请直接跳转至文末。
1. CARLA视频生成
安装编译CARLA 0.9.16版本软件后,根目录下包含以下脚本PythonAPI/examples/nvidia/cos mos/client/carla_cos mos_gen.py,该脚本可以读取PythonAPI/examples/nvidia/cos mos/client/example_data/logs/inverted_ai路径下CARLA提供的示例场景记录log,还原仿真场景并渲染出传感器数据,合成视频输出。命令如下:
python carla_cos mos_gen.py \
-f ${PWD}/example_data/logs/inverted_ai/iai_carla_synthetic_log_1731622446_actorPOV4641_startTime3.7s_log.log \
--sensors cos mos_aov.yaml \
--class-filter-config filter_semantic_classes.yaml \
-c 4641 -s 0.0 -d 5.0 -o output
需要注意的是,在carla_cos mos_gen.py脚本的video_writer_worker函数中,记录视频的长度被固定成了120帧(帧率fps是24,120帧也就是5s时长),读者可按需修改。但需要注意增长时长给后面cos mos transfer1推理带来的性能压力。
carla_cos mos_gen.py运行成功后,会在执行目录下保存rgb、rgb_edge、semantic_segmentation、depth、rgb_masked、instance_segmentation等视频,部分效果如图1所示。
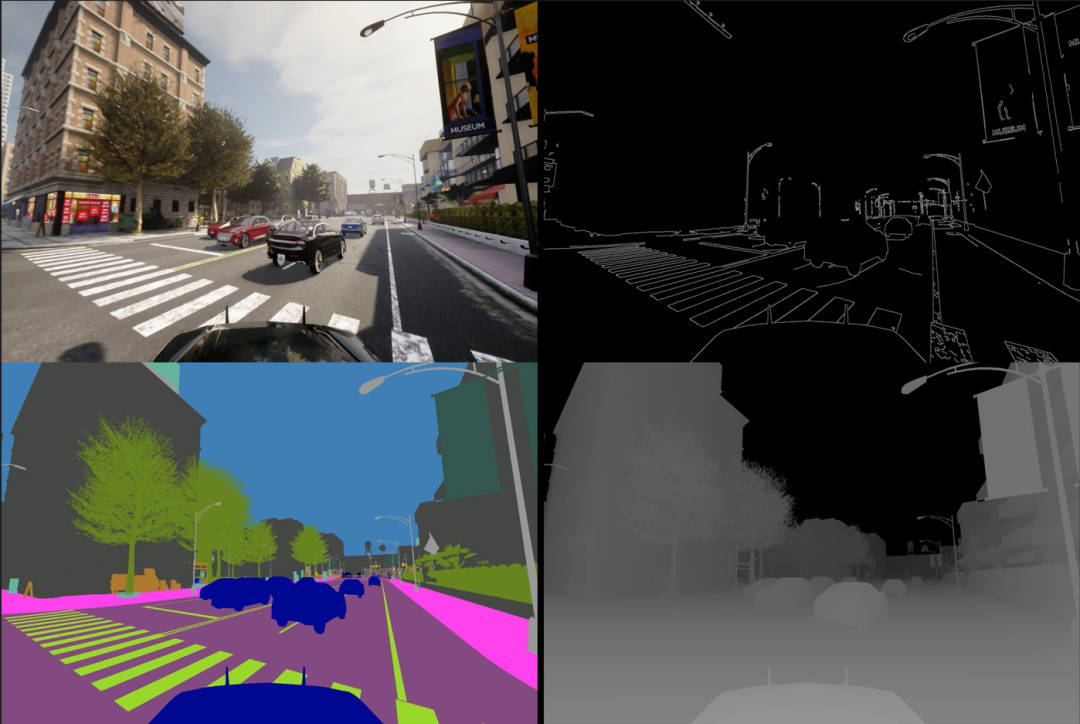
图1-CARLA仿真生成的视频
2. cos mos transfer1推理部署
官方文档给出了两个进行cos mos transfer1推理的option:一个是使用官方在NVIDIA Brev云服务器上部署好的服务(图2),另一个是将官方提供的推理docker部署在用户本地。
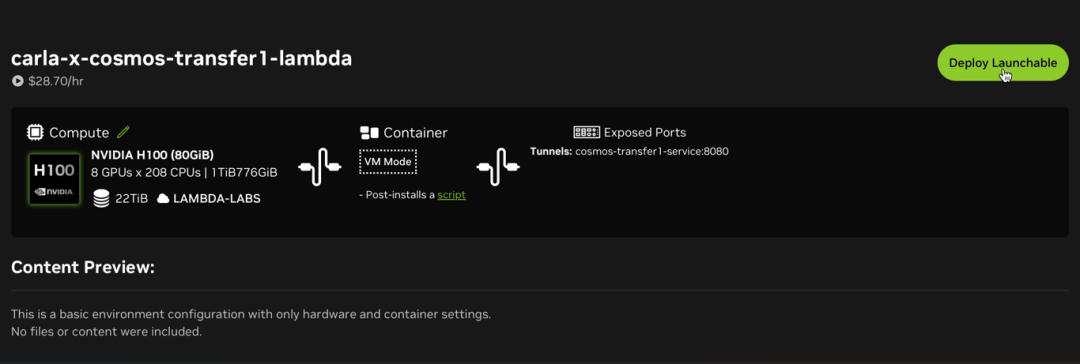
图2-NVIDIA Brev云服务器
CARLA官方在NVIDIA Brev配备的是H100多卡算力,价格昂贵,所以笔者决定使用第二种方法。
由于笔者没有本地的高算力显卡,所以也需要在云服务器上做部署,但在云服务器中再部署docker,需要处理复杂的网络proxy问题,因此第二种方法也不太方便实现。
通过研究PythonAPI/examples/nvidia/cos mos下的client和server两个文件夹下的代码,我发现,CARLA在server端使用web应用开发框架gradio实现了一个app interface,包裹了一下cos mos transfer1的模型调用代码,在client端cos mos_client.py也将通过gradio将一次推理所需的提示词、控制条件等传输给server,server再调用co s mos transfer1完成推理。
cos mos_client.py的调用示例如下:
python cos mos_client.py http://url_to_server:port \
example_data/prompts/rain.toml \
--output outputs/ \
--input-video example_data/artifacts/rgb.mp4 \
--edge-video example_data/artifacts/edges.mp4 \
--depth-video example_data/artifacts/depth.mp4 \
# optional
--seg-video example_data/artifacts/semantic_segmentation.mp4 \
--vis-video example_data/artifacts/vis_control.mp4 \
# optional
--seed 2048
因此我们完全可以省略官方docker和其中的gradio框架,直接将cos mos transfer1部署在所选用的云服务器上。
cos mos transfer1的github链接[2]中有详细的部署步骤,在此不再赘述。[2]中的examples文件夹下有cos mos transfer1推理的详细介绍,只要和[1]进行对照,我们就可以很方便地将[1]中cos mos_client.py给server输入的参数转换成cos mos transfer1所需要的输入,直接调用模型进行推理。
在此补充一些笔者实际部署时的配置:
虽然官方文档中强调需要使用H100进行推理,但实践证明A100单卡也可以完成推理任务。笔者的配置是CPU 64核,96G内存,A100,80G显存。运行推理时的巅峰内存消耗在50G+,显存消耗60G。完成一个CARLA toml配置文件中的任务,合成5s视频所需时长约20分钟。关键配置参数中,减少num_steps也就是减少diffusion步数会显著缩短推理时间,但显然也会导致输出质量下降。
3. cos mos transfer1合成效果
最后,附上几个视频展示cos mos transfer1的视频合成效果。以下CARLA视频全部来自PythonAPI/examples/nvidia/cos mos/client/example_data/logs/中的记录,提示词等输入全部来自PythonAPI/examples/nvidia/cos mos/client/example_data/prompts/文件夹。
效果1:右转
效果2:左转
效果3:直行
参考链接:
1. https://carla.readthedocs.io/en/latest/nvidia_cos mos_transfer/
2. https://github.com/nvidia-cos mos/cos mos-transfer1
以上,本文完。
后续,车路漫漫还会继续推出关于世界模型/3DGS等新型仿真技术的应用探索,欢迎各位小伙伴持续关注。