
2-48 二维高斯样本,EM 怎样从概率分配迭代到 3 类聚类?
MATLAB 高斯混合模型 EM 聚类与收敛过程可视化程序
一句话介绍: 这套 MATLAB 程序先随机生成 1000 个来自 3 个二维高斯分量的混合样本,再以固定的高斯混合模型初值启动 EM 迭代,通过 E 步计算各样本属于不同分量的后验概率、M 步更新权重/均值/协方差,直到对数似然变化小于 10⁻⁶,并输出原始样本分布、EM 聚类结果和收敛曲线。
先看它解决什么问题
一批二维散点混在一起时,如果只知道“它们大致来自几个不同群体”,却不知道每个点到底属于哪一类,就不能直接计算每一类准确的均值和分布。
这里会形成一个循环问题:
不知道类别 → 无法准确估计每一类参数 → 参数不准确 → 又无法准确判断类别。
EM 的思路不是一开始就给每个样本一个绝对标签,而是在“估计归属概率”和“重新估计模型参数”之间反复迭代:
二维混合样本 → 初始化高斯混合参数 → E 步计算归属概率 → M 步更新权重/均值/协方差 → 计算对数似然 → 判断是否收敛 → 输出聚类结果
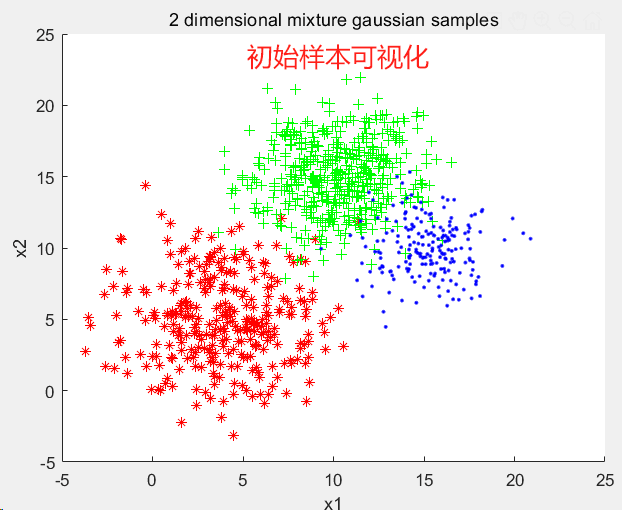
当前工程还把样本生成时的真实分量和 EM 最终得到的类别分别画出来,因此可以直观看到:
原始混合高斯数据是什么样 → EM 最后把这些点分成了什么样 → 优化过程什么时候趋于稳定。
需要特别说明的是,从源码实际实现看,EM 没有直接构造“类间距最大、类内距最小”的距离目标函数。当前程序真正迭代优化的是高斯混合模型对全部样本的对数似然;类内更集中、不同分量更容易区分,是模型拟合后的表现。
1. 当前工程到底由哪些程序组成?
文件 | 主要作用 |
|---|---|
demo.m | 主入口,生成样本、初始化参数、执行 EM、绘制聚类与收敛结果 |
Generate_Sample.m | 按给定均值、协方差和比例随机生成二维混合高斯样本 |
Exception.m | 实际承担 EM 的 E 步,计算各分量加权概率、后验责任度和对数似然 |
Maximization.m | 实现 M 步,重新估计混合权重、均值和协方差 |
Init_Random2.m | 当前 demo.m 默认启用的固定初始参数 |
Init_Random.m | 另一组固定初始参数 |
Init_Kmeans.m | 先做 K-means,再据此初始化 GMM 参数 |
draw.m | 将 K-means、random1、random2 三种初始化的收敛曲线叠加比较 |
2. 程序默认生成的 1000 个样本是什么样?
主程序运行时直接调用 mvnrnd 生成二维高斯样本。
默认一共生成:n = 1000 个二维样本,k = 3 个高斯分量。
三个真实分量的设置如下:
分量 | 样本数量 | 均值 | 协方差 |
|---|---|---|---|
第 1 类 | 300 | (4, 5) | [9,0; 0,9] |
第 2 类 | 500 | (10, 15) | [6,0; 0,6] |
第 3 类 | 200 | (15, 10) | [4,0; 0,4] |
所以真实混合比例为:0.3 : 0.5 : 0.2
这三个分量并不完全相同。
第 1 类协方差最大,散点相对更分散;第 3 类协方差最小,分布相对更紧;第二类又拥有最多的 500 个样本。
因此当前程序测试的不是“3 个完全一样的圆团”,而是:
样本数量不同、中心不同、离散程度也不同的三分量二维高斯混合数据。
3. EM 开始之前,程序给出的初始模型离真实分布有多远?
当前 demo.m 实际启用的是:[W,M,V] = Init_Random2();
对应三类初始混合权重:W = (1/6, 2/3, 1/6)
初始均值分别为:
第 1 类:(3, 5)、第 2 类:(5, 8)、第 3 类:(7, 10)
而生成样本时的真实中心是:(4,5)、(10,15)、(15,10)
可以看到,除了第一个初始中心比较靠近真实第 1 类外,其余两个中心都没有直接放到最终真实中心附近。
三个初始协方差也不是生成样本时使用的协方差:
第 1 类:[8,2; 2,3]、第 2 类:[2,0; 0,10]、第 3 类:[5,-2; -2,8]
这使当前例子能够比较清楚地展示:
EM 怎样从一组并不准确的 GMM 参数出发,通过反复迭代重新移动均值、调整类别权重和修改分布形状。
4. E 步到底在计算什么?
完成的是 EM 中的 Expectation,也就是 E 步。
它先计算第 j 个高斯分量对第 i 个样本的加权概率:
qᵢⱼ = wⱼ · N(xᵢ | μⱼ, Σⱼ)
这里包含三部分信息:
当前类别权重 wⱼ;
当前均值 μⱼ;
当前协方差 Σⱼ。
然后把同一样本在所有类别上的加权概率归一化:
γᵢⱼ = qᵢⱼ / Σₘ qᵢₘ
得到的 γᵢⱼ 就是源码矩阵 E 中对应的值。
简单理解:
E 步暂时不修改任何高斯参数,只回答“按照现在这套模型,这个样本分别有多大程度属于第 1、2、3 类?”
例如一个点可能不是简单得到“属于第 2 类”,而是先形成类似:(0.03, 0.91, 0.06)这样的软概率分配。
这也是 EM 与一开始直接给出硬分类标签的思路不同之处。
5. M 步又怎样利用这些概率更新模型?
有了每个样本对每个类别的责任度以后,Maximization.m 开始重新估计模型参数。
先把第 j 类获得的总责任度记为:
Nⱼ = Σᵢ γᵢⱼ
新的混合权重为:
wⱼ = Nⱼ / n
也就是说:所有样本合起来给这一类分配了多少概率质量,就决定这一类新的混合比例。
均值则变成责任度加权平均:
μⱼ = (Σᵢ γᵢⱼ xᵢ) / Nⱼ
因此,越像第 j 类的样本,对该类新中心位置的影响越大。
协方差继续按照同一组责任度更新:
Σⱼ = [Σᵢ γᵢⱼ (xᵢ - μⱼ)(xᵢ - μⱼ)ᵀ] / Nⱼ
所以一次 M 步会同时改变:
类别比例 + 类别中心 + 类别形状与离散程度。
完成 M 步以后,程序再拿这些新参数进入下一次 E 步。
6. 程序为什么还要计算对数似然?
EM 必须知道:
现在还要不要继续迭代?
在计算责任度之前,同时计算当前模型下全部样本的对数似然:
L = Σᵢ ln(Σⱼ qᵢⱼ)
它衡量的是:当前这套高斯混合参数,对现有 1000 个样本整体解释得有多合适。
主程序把每次迭代的 L 保存下来。
当新的参数不断改善模型时,对数似然通常会逐渐提高;随着模型趋于稳定,相邻两次的变化会越来越小。
所以收敛曲线真正展示的是:
GMM 对样本的解释程度怎样随 EM 迭代逐步稳定。
它不是“类别距离曲线”,也不是分类准确率曲线。
7. 当前程序怎样判断 EM 已经收敛?
demo.m 设置的终止阈值是:e = 0.000001
从第二次迭代开始,程序计算:
EPS = |Lₜ - Lₜ₋₁|
只要:EPS < 10⁻⁶循环就结束。
因此当前停止条件不是固定迭代 50 次或 100 次,而是:
只要相邻两次对数似然已经几乎不再变化,就认为参数进入稳定状态。
这种写法的好处是,不同随机样本、不同初始化条件可以自动得到不同的迭代长度。
代价也很直接:10⁻⁶ 对总对数似然来说属于比较严格的停止阈值,某些数据和初始化下可能需要较多次迭代。
8. 最终每个样本是怎样获得聚类标签的?
EM 内部一直使用的是软责任度。
但绘制最终聚类结果时,程序需要把每个样本变成一个明确类别。
demo.m 对第 i 个样本执行的逻辑是:
比较E(i,:)中三个责任度 → 找到最大值所在位置 → 用对应类别的颜色和标记绘制。
也就是:labelᵢ = 责任度最大的高斯分量
所以程序形成了两个层次:
EM 计算阶段:软概率归属
结果显示阶段:最大责任度对应的硬标签
这使模型既保留了概率聚类的计算方式,又能以普通散点分类图的形式直观展示最终结果。
9. “聚类前后结果”在这套程序里具体怎么看?
Generate_Sample.m 在生成三个高斯分量时,会直接使用不同的颜色和点型绘制它们。
由于程序知道每个随机样本最初是由哪个高斯分量产生的,因此这里展示的是:
样本生成阶段的真实分量归属。
EM 完成以后,demo.m 再按照最大责任度重新给全部样本绘制类别。
于是可以直接观察:
生成时真实分量 → EM 根据数据重新估计出的类别
除此之外,程序还保存每一步的 L,绘制:迭代次数 → 对数似然的收敛曲线。
当前代码并没有继续计算:
聚类准确率;轮廓系数;类内平方和;类间距离;混淆矩阵。
因此这套工程的主要评价方式是:通过真实生成分量与 EM 聚类散点进行直观比较,再结合对数似然曲线观察算法是否收敛。
10. 为什么工程里还保留三种初始化方式?
EM 的一个重要特点是:
结果和收敛过程会受到初始参数影响。
工程为此准备了三条初始化路线:
K-means 初始化
Init_Kmeans.m 先对当前样本执行 kmeans。
随后根据 K-means 得到的类别计算:
初始混合比例;初始均值;初始协方差。
它相当于先用距离聚类给 GMM 找一个起点。Init_Random.m这是一组人工给定的固定初始参数。
Init_Random2.m
这是另一组人工给定的固定初始参数,也是当前 demo.m 默认启用的方案。
辅助函数 draw.m 专门准备了三条曲线,图例分别为:
kmeans、random1、random2
因此如果要研究初始化敏感性,可以分别切换三种初始化,保存三次运行返回的 L 和 count,再调用:
draw(L1,L2,L3,count1,count2,count3)
这样可以直接比较:
不同起点 → 不同收敛路径 → 不同迭代次数与最终稳定位置。
需要注意,demo.m 当前只运行 Init_Random2,三种方案不会在一次执行中自动全部比较。
11. 这套 EM 程序适合用在哪里?
EM 与高斯混合模型教学
当前工程把样本生成、E 步、M 步、收敛判断全部拆成独立函数,没有把关键过程封装成 MATLAB 的 GMM 黑盒调用。
因此它很适合用来观察:
责任度怎样变化 → 均值怎样移动 → 协方差怎样重新估计 → 对数似然怎样趋于稳定。
聚类初始化敏感性实验
工程已经保留 K-means 和两套固定初始化,并提供了三条收敛曲线的比较函数。
因此可以比较:
初值不同会不会导致收敛速度和最终解发生变化。
二维高斯混合聚类可视化实验
当前数据就是二维坐标,每个样本可以直接画在平面上。
这比高维数据更适合直观看懂 GMM 的概率聚类过程。
EM 算法修改与二次实验
E 步、M 步和初始化被拆成多个 .m 文件,因此可以继续实验:
修改混合比例;改变均值位置;改变协方差;调整类别数;修改停止阈值;替换初始化方式。
但当前工程本质上仍是一套二维合成数据上的离线算法演示程序。
它没有外部数据导入、模型保存、在线数据流、自动评价指标或生产部署接口,因此不应直接理解成通用工业聚类平台。
12. 哪些参数最值得修改?
当前程序里真正会明显改变实验行为的参数主要是下面几项。
参数 | 当前值 | 为什么值得改 | 调整后的主要影响 |
|---|---|---|---|
mean | 3 个二维中心 | 决定真实类别在平面上的位置 | 中心越接近,类别重叠通常越明显 |
covariance | [9,9]、[6,6]、[4,4] 量级 | 决定各类散布范围和方向 | 方差增大后聚类难度通常会上升 |
partion | 0.3, 0.5, 0.2 | 决定三个分量的样本比例 | 可模拟类别均衡或不均衡数据 |
初始化方式 | Init_Random2 | EM 对起始参数敏感 | 可比较 K-means、random1、random2 的收敛差异 |
e | 10⁻⁶ | 直接决定停止精度 | 阈值放宽通常更快停止,缩小则要求更充分收敛 |
n | 1000 | 决定样本规模 | 增大后统计分布更充分,同时每轮计算量增加 |
如果只是做 EM 原理实验,优先修改:
初始化方式、三个真实均值、协方差和停止阈值。
这几项最容易观察到聚类结果与收敛曲线的变化。
13. 怎么运行?
运行主入口:demo
生成 1000 个二维样本 → 使用Init_Random2初始化 → 执行 EM → 输出耗时和计数 → 显示聚类结果 → 显示对数似然收敛过程
Generate_Sample.m 使用了 mvnrnd,因此按当前源码直接运行需要 MATLAB 中提供该函数的 Statistics and Machine Learning Toolbox。
如果切换到 Init_Kmeans.m,还会调用 kmeans。
当前代码没有调用 rng 固定随机种子,因此:
每次运行生成的 1000 个样本都会变化,最终参数、收敛曲线和迭代次数也可能随之变化。
这意味着文章中不应把某一次运行得到的迭代次数或最终似然值当成固定结果。
另外还有一个源码层面的计数细节:循环末尾执行 count = count + 1 后才退出,因此控制台打印的 count 会比 L 中实际保存的迭代点数量多 1;收敛曲线本身使用的是 count-1,解读控制台“Iteration count”时需要注意这一点。
如果要比较三种初始化,可以在 demo.m 中分别启用:
Init_Kmeans、Init_Random、Init_Random2
依次保存三组 L 和 count,最后再使用 draw.m 进行叠加比较。
14. 一句话看懂这个项目
这是一个面向 EM 聚类原理与收敛过程展示的 MATLAB 二维高斯混合模型程序:它默认生成 1000 个来自 3 个不同均值、协方差和样本比例的二维随机样本,以Init_Random2给出的固定 GMM 参数为起点,通过Exception.m计算后验责任度与对数似然,再由Maximization.m更新混合权重、均值和协方差,并持续迭代到相邻对数似然变化小于 10⁻⁶;最终利用最大责任度给样本分配类别并绘制聚类与收敛结果,同时保留 K-means 和两套固定初值用于比较初始化敏感性。当前代码优化的是高斯混合模型对数似然,而不是显式的类间距/类内距目标,更适合用于 EM/GMM 教学、二维聚类可视化和初始化敏感性实验。


