
给Codex装上nature-skills,读论文、内容润色、做汇报都是怎么用的?
精读卡、润色结果和可编辑PPT都生成了。过程中也有一些返工,自动提取漏了三个图题,PPT里一句解释写得过宽,需要回原文核对。这篇就把实际输入、提示词和结果放在一起,看看这套技能怎么用。
一、先认识这个skill
nature-skills是开发者维护的开源科研技能集 合。
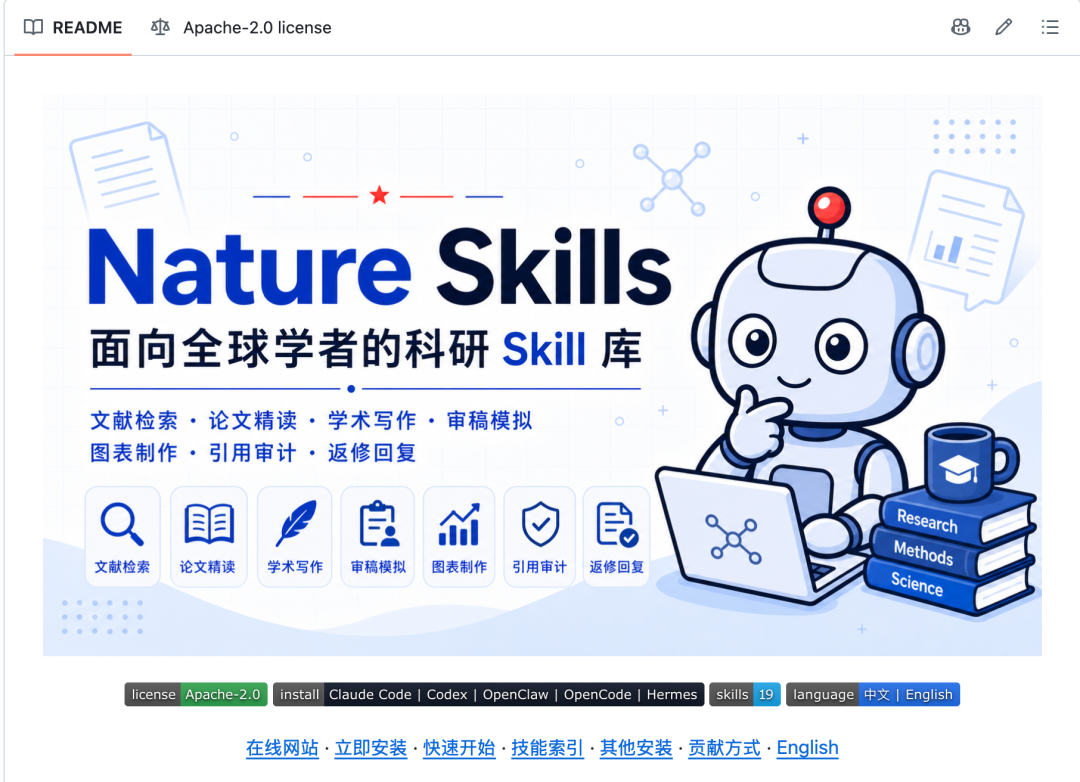
nature skills在github上的展示图
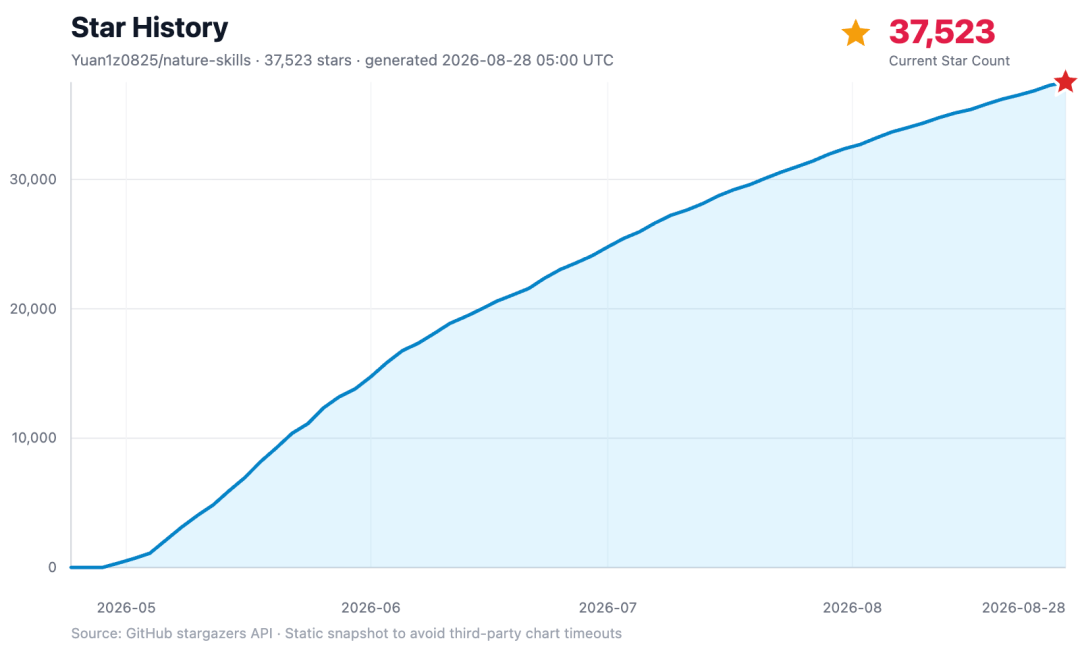
现在这个仓库已经接近4万⭐了。
它把读论文、写作表达、科研绘图和审稿回复等任务分别做成技能,让Agent按相应流程处理材料。可以按手头的事来选。
想逐段看中英对照,可以了解 nature-reader;想弄清一篇论文的方法和结论,用nature-paper-card。已有段落需要修改,用 nature-polishing;根据已有结果起草章节,对应nature-writing。需要汇报文件,用 nature-paper2ppt;科研图另有nature-figure。
这次只运行精读、润色和论文转PPT三个技能。仓库里的Stable、Beta、Draft 是维护者标的状态,不能代替实际检查。开源技能也不意味着运行它的模型服务免费。第一次安装,可以把github链接交给Codex,这样说就够了。
帮我给当前项目安装nature-skills中的nature-paper-card、nature-polishing和nature-paper2ppt,需要的nature-shared共享包也一起装上。保留完整技能目录,装好后检查能不能找到。其他技能和自动更新先不用装。
nature-shared是共享资料包,不用单独把它当作第四个功能来调用。装好以后,提供论文或段落,说明自己想得到什么即可。
二、读论文要先问清它做了什么
演示材料是Liu等发表于TACL 2024的《Lost in the Middle》。论文研究语言模型怎样使用长上下文,全文可以从ACL论文页面下载。
我在Codex里发送的提示词是这段。
用nature-paper-card帮我读《Lost in the Middle》。它具体测了什么,最重要的发现是什么,还有哪些结论不能往外推?先在聊天里用中文讲明白,关键判断给我原文位置,完整精读卡另外保存。
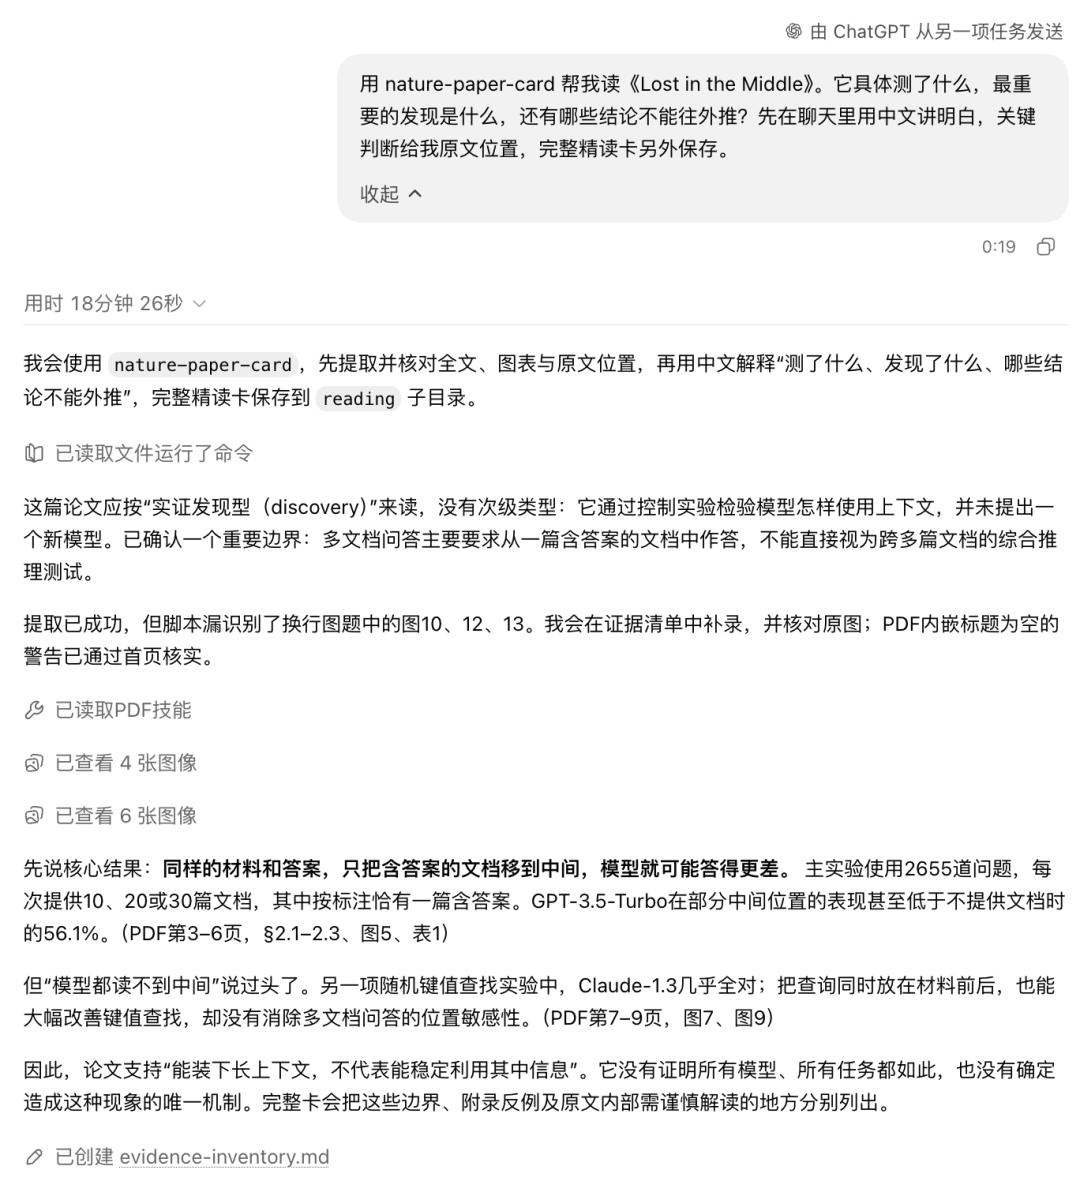
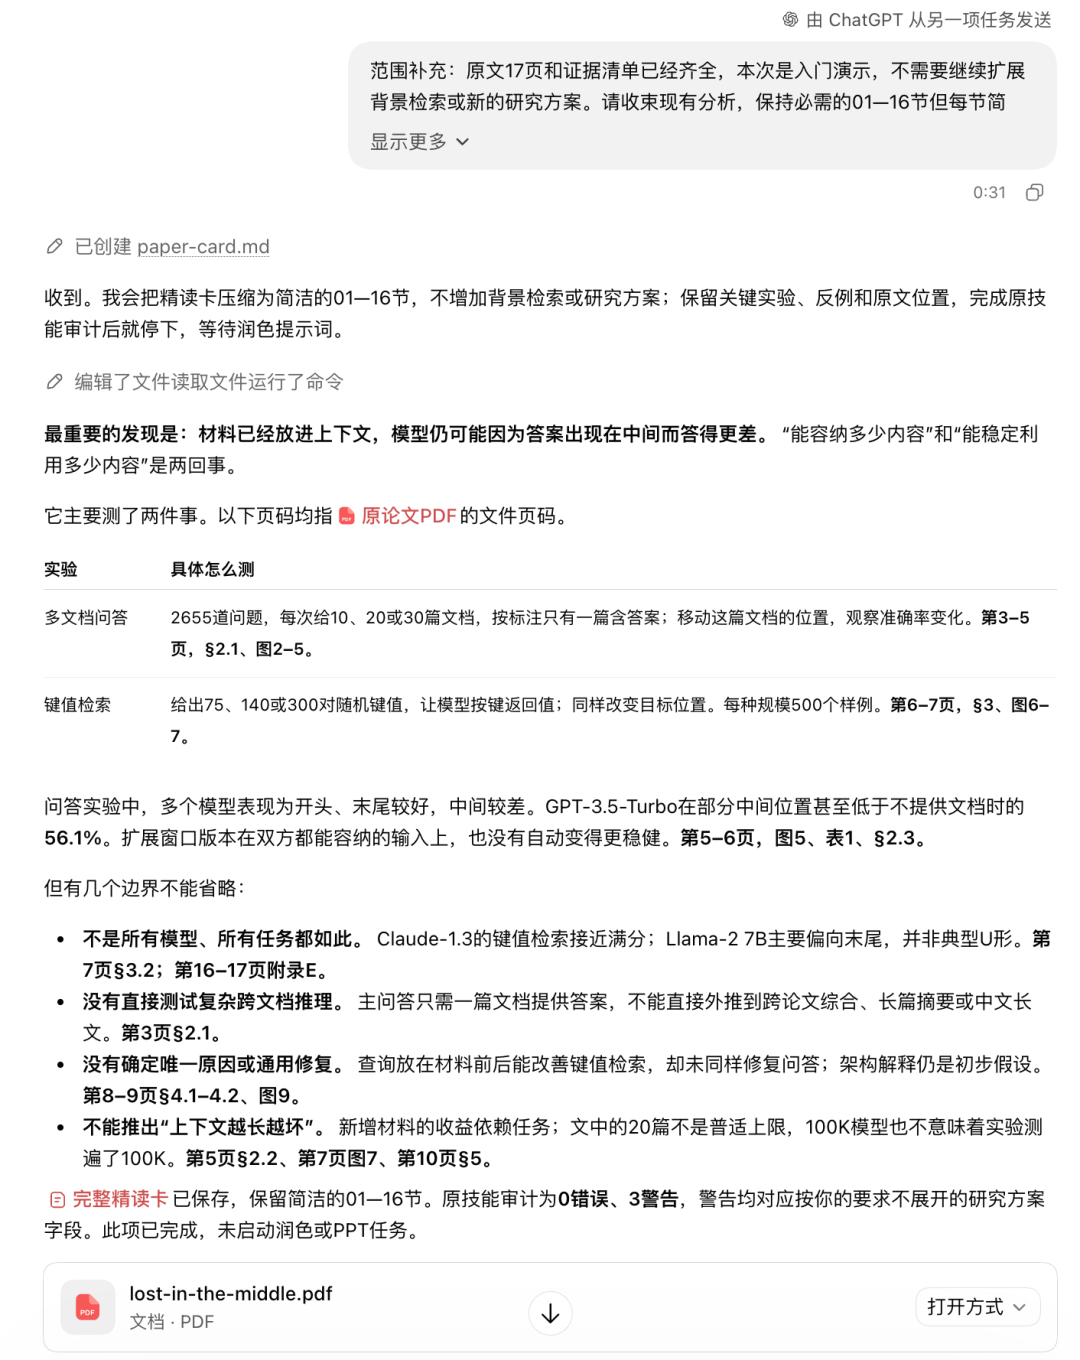
Codex把两类实验分开讲清楚了。多文档问答使用2655道问题,每次给10、20或30篇文档,按标注只有一篇含答案;另一类是从随机键值对中找出对应的值。这些设置能回到PDF第3至7页检查。
反馈里有一个容易忽略的区别。论文的主问答任务只需要一篇文档提供答案,不能直接等同于跨多篇论文的综合推理。它还指出如果Claude在所测键值检索任务里接近满分,不能把论文概括成所有模型都读不到中间。
完整精读卡保留了研究问题、实验与结论、作者承认的局限和分析者自己的判断,共16个栏目。用它回看论文,能找到具体依据,不必只凭一段流畅的总结判断可信度。
但自动提取会漏东西。这次有三个图题因为换行没有被识别出来,Codex对照原页后另行补录。拿到精读卡,至少挑两条关键结论,回原文检查一次。 有页码不代表一定引用正确。
三、内容润色重点是不能改变原来的意思
这里用的是一段新写的中文文献笔记,用来转述刚读过的论文。本次润色输出为学术英文,观察重点放在表达是否简洁、引用和结论范围是否保留。
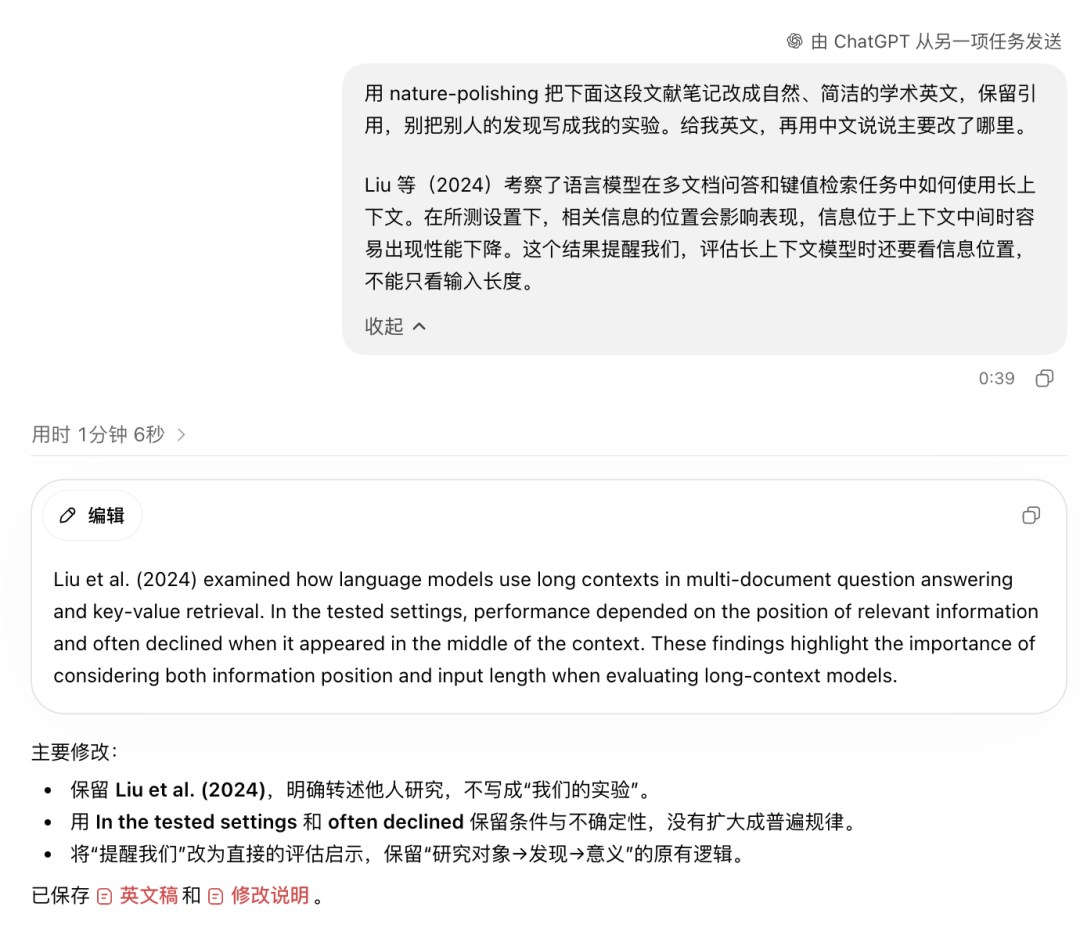
完整输入如下,换成自己的段落就能使用。
用nature-polishing把下面这段文献笔记改成自然、简洁的学术英文,保留引用,别把别人的发现写成我的实验。给我英文,再用中文说说主要改了哪里。
Liu 等(2024)考察了语言模型在多文档问答和键值检索任务中如何使用长上下文。在所测设置下,相关信息的位置会影响表现,信息位于上下文中间时容易出现性能下降。这个结果提醒我们,评估长上下文模型时还要看信息位置,不能只看输入长度。
下面是这次实际得到的英文。
Liu et al. (2024) examined how language models use long contexts in multi-document question answering and key-value retrieval. In the tested settings, performance depended on the position of relevant information and often declined when it appeared in the middle of the context. These findings highlight the importance of considering both information position and input length when evaluating long-context models.
我主要检查了三处。开头保留了Liu et al. (2024),发现仍归属于原作者;In the tested settings留下实验范围;often declined也没有把“经常下降”写成“必然下降”。没有新增数字或实验。
中文原稿本来就不长,因此这次变化主要是表达整理,不能夸成重建了一篇论文的论证。你如果想改引言、讨论或结果段,顺手说明章节和目标读者,比只说“帮我高级一点”更容易检查效果。
四、做汇报,直接要可编辑的PPT
读完之后,我继续在同一任务里提出汇报要求。
用nature-paper2ppt把这篇论文 做成6页中文组会PPT,讲5分钟左右。把研究问题、做法、关键结果和局限讲清楚,关键图用论文原图并注明出处,每页加几句讲解备注。请生成能继续编辑的PPT文件。做好后检查每一页有没有文字截断或图看不清,并给我页面预览。
PPT文件已经生成。六页都带中文讲解备注,正文和实验示意可以继续编辑,三张论文原图作为独立图片插入。原图里的曲线仍是位图,不能把它说成可编辑的数据图表。
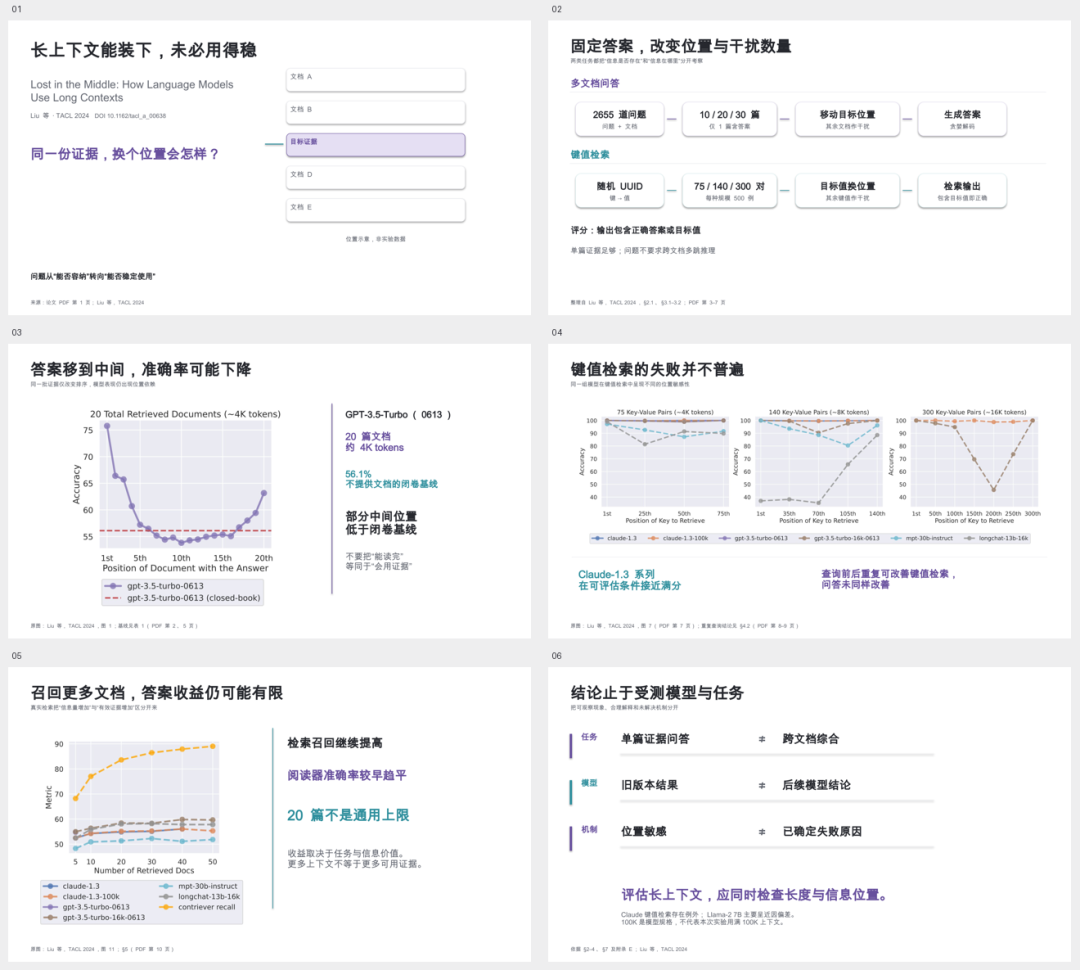
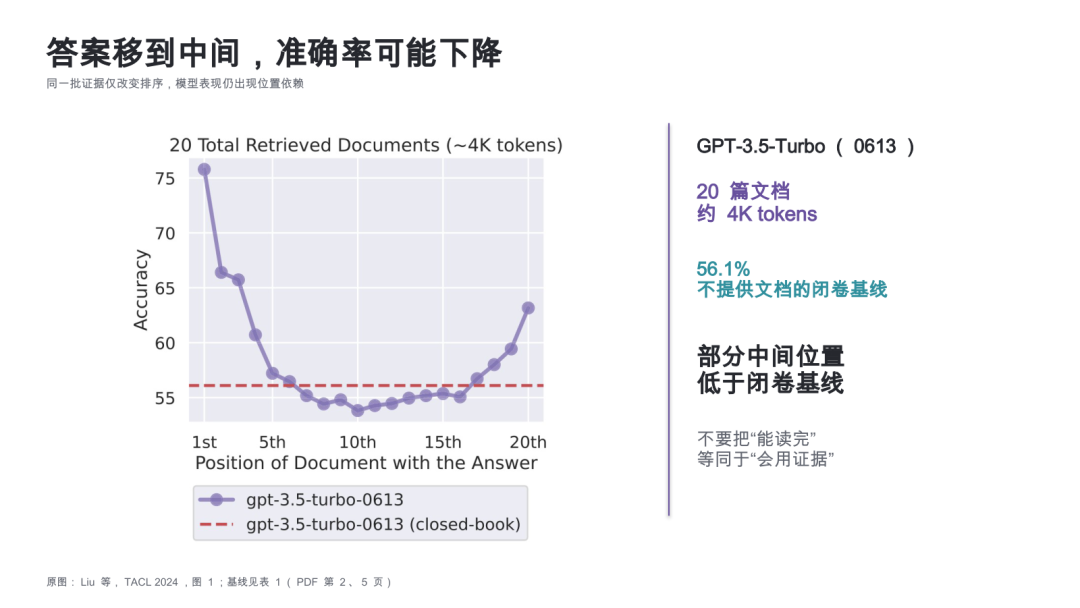
第3页用论文原图解释位置效应。图里的56.1%是原研究中GPT-3.5-Turbo不提供文档时的准确率,不是这次Codex的测试分数。
第6页把任务、模型和机制的边界分别列出来。汇报时可以据此说明,旧版本模型的结果不能直接替今天的所有模型下结论,100K的模型规格也不表示论文实验用满了100K上下文。
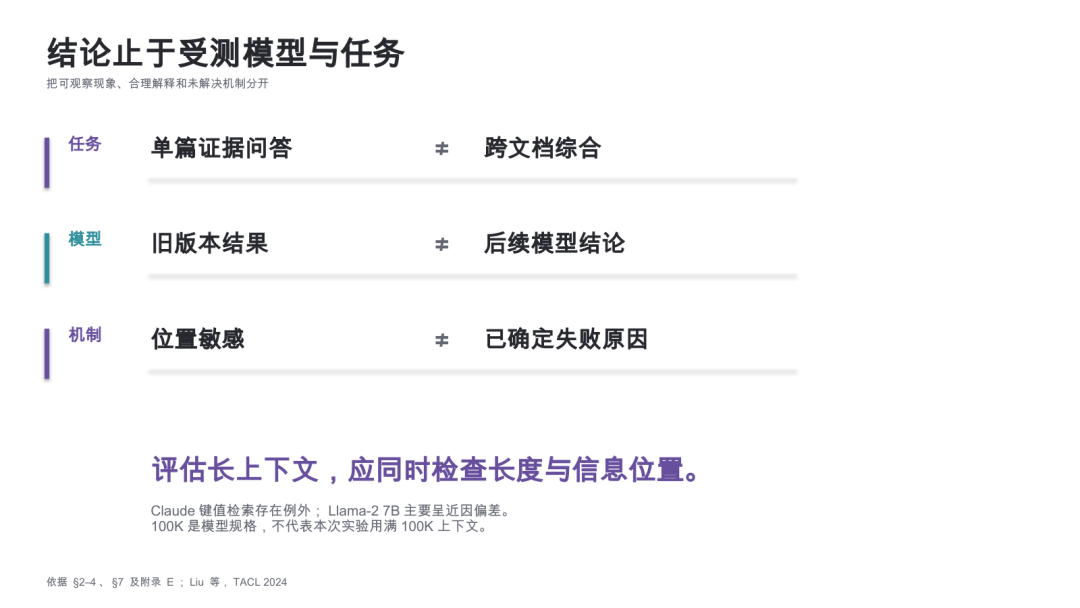
初稿也需要改。第4页曾把特定键值任务的改善写成较笼统的机制解释,核对后收紧了这句话,并同步修改备注。六页重新渲染检查,未发现截字或重叠;第4页多面板图的图例比较密,投影时仍要留意。
自己跟做,材料比长提示词重要
这三项任务用一上来就写一大串参数。读论文时把全文给够,改段落时贴出原文,做汇报时说明时长、页数和听众。短提示词后面接上完整材料,Agent才有实际内容可处理。
结果出来后,精读卡回查原文位置,润色稿对照作者归属与限定词,PPT打开看实际页面和备注。这次的图题漏识别和措辞返工,都来自这些检查。
本篇是三个功能的上手演示,没有做同条件的无Skill对照,也没有重新运行原论文实验。读论文、润色和汇报都有了具体产物;是否适合你的学科,还需要换自己的材料再试。
有基础稿以后,可以接着这样用
上面的润色任务有一个前提,手里已经有一段能表达意思的材料。Skill可以帮助整理表达,论文要研究什么、证据够不够,仍然需要作者判断。
如果现在只有题目,想先形成便于修改的论文初稿,也可以了解一下 千笔-AIWritePaper。它是一款AI论文生成平台,适合把初稿准备和后续精修分开安排。拿到基础稿后,挑出需要处理的段落交给Agent,明确哪些数据、引用和结论不能改,再检查润色结果。平台生成的内容同样需要核对文献、数据和学校要求,不能替代真实研究。


