
CONVERGE借助英特尔新一代 CPU,加速技术创新

每一位计算流体动力学(CFD)工程师,都体会过想要尽快拿到仿真结果的紧迫感:无论是赶新产品上市、紧急排查现场设备故障,还是希望按时完成博士课题研究。
想要缩短仿真运行时间,业内有不少计算优化手段:采用简化模型、使用更粗糙的网格,或是选择性忽略部分复杂物理效应。但有时,这些方法 会带来精度的大幅损失,得不偿失;即便用上全部加速技巧,仿真耗时依旧高得让人难以接受。这种情况下该怎么办?
可以从计算硬件层面寻找突破口。选用性能更强的处理器运行仿真,无需牺牲仿真精度,就能更快输出计算结果。英特尔等硬件厂商一直在持续研发性能更强的中央处理器(CPU),以此满足当下 CFD 仿真的各类算力需求。
为直观展示处理器性能的迭代提升,我们与英特尔合作,针对其新一代 CPU 开展性能测试。在三代英特尔至强处理器上运行同一仿真算例,测试结果表明,每一代全新处理器性能均实现迭代突破,仿真计算速度再创新高。
基于超声速流动开展处理器性能测试
本次测试选用 CONVERGE CFD 5.1.1 版本软件,模拟通道内部的超声速流动,该算例模拟对象为超燃冲压发动机。
超燃冲压发动机:飞行器自身不携带氧化剂,依靠大气中的氧气维持燃烧反应。飞行器在高空环境飞行时,空气稀薄,因此必须达到极高飞行速度,让进气道充分压缩空气,以此保障燃烧反应持续进行。
仿真正常运行后,通道内部会形成稳定的激波串结构,附着点可预测且状态稳定(见图 1 仿真视频)。为捕捉激波 边界层的相互作用,仿真采用双方程 k ε 大涡模拟(LES)湍流模型;入口边界条件叠加湍流脉动,还原真实大气湍流环境,出口设置为定压出口。
网格生成方面,CONVERGE 具备自主网格划分能力,仿真运行过程中自动生成高质量笛卡尔网格。本次基准仿真未开启自适应网格加密(AMR),保证不同代处理器下的网格单元数量完全一致,确保测试公平。
硬件测试配置
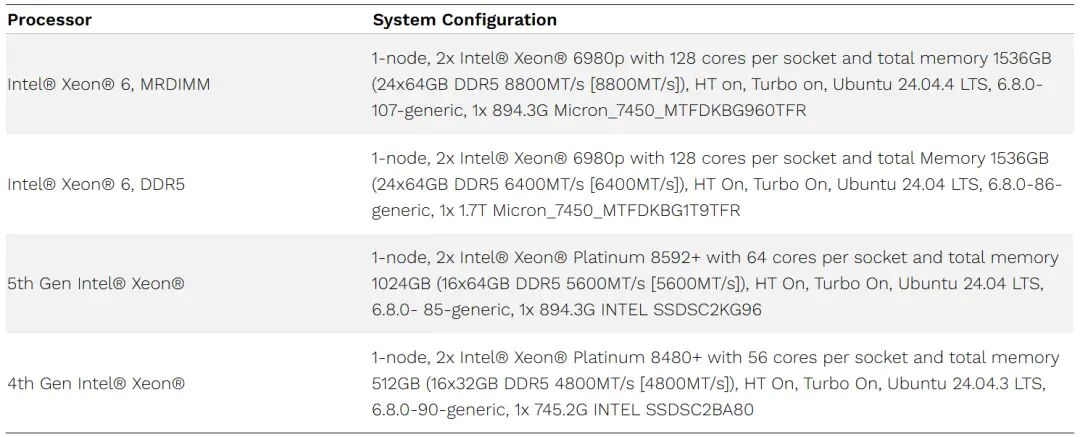
本次仿真分别在单节点的第四代、第五代、第六代英特尔至强处理器上完成。第六代至强处理器同时测试两种内存方案:DDR5、MRDIMM(多路复用列内存模组)。
MRDIMM 是英特尔创新的全新内存技术,相比传统 DDR5 内存,拥有更高内存带宽、更低延迟;可直接替代普通 DDR5 内存,现有主板与软件代码无需做任何修改。 本次测试 CONVERGE 5.1.1 基于英特尔 oneAPI DPC++/C++ 编译器 2025.1.1 编译,搭配英特尔MPI 2021.15 运行库。
测试结果:仿真时间直接减半
下表以第五代英特尔至强处理器单节点作为性能基准,展示各处理器相对加速比。可以看到,每一代新产品的单节点性能都大幅超越前代;最新一代处理器,仿真运行时间相比上一代直接减半。
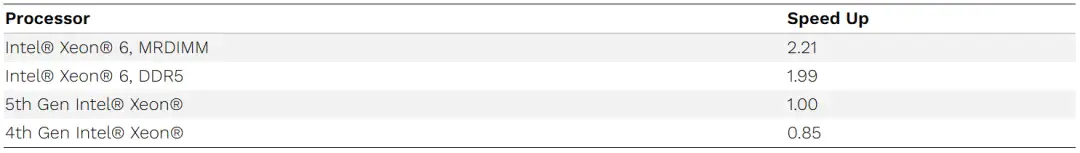
同时对比可见,MRDIMM 内存方案相比传统内存,还能带来额外的性能提升。CFD 仿真大多属于内存带宽受限型计算任务,更高的内存带宽至关重要。
“现代处理器每秒可以完成海量浮点运算,但运算单元性能发挥的前提,是数据能够快速供给。很多 CFD 计算需要反复读取场变量、相邻网格单元数据与网格信息,每读入一份数据,实际计算量却并不大。这种场景下,内存带宽往往会成为性能瓶颈。” ——Convergent Science 公司高性能计算团队高级研发工程师 Josin Tom
内存带宽提升可以直接缩短仿真耗时。实测在至强 6 平台上搭配 MRDIMM 技术运行 CONVERGE,可实现超 10% 的额外加速。
开启自适应网格加密:兼顾仿真速度与计算精度
完成基准测试后,我们开启自适应网格加密(AMR)再次运行同一算例,验证该功能在保证精度的同时提升仿真速度的效果。 本次同时启用基于压力、速度两种自适应网格加密模式:在梯度变化剧烈的区域加密网格,精准解析激波与湍流扰动;其余区域自动粗化网格,以此减少整体计算耗时。
分别在第五代、第六代英特尔至强处理器上运行开启 AMR 的算例,并和关闭 AMR 的结果做性能对比。数据证明,自适应网格加密可以显著加速复杂高精度仿真。
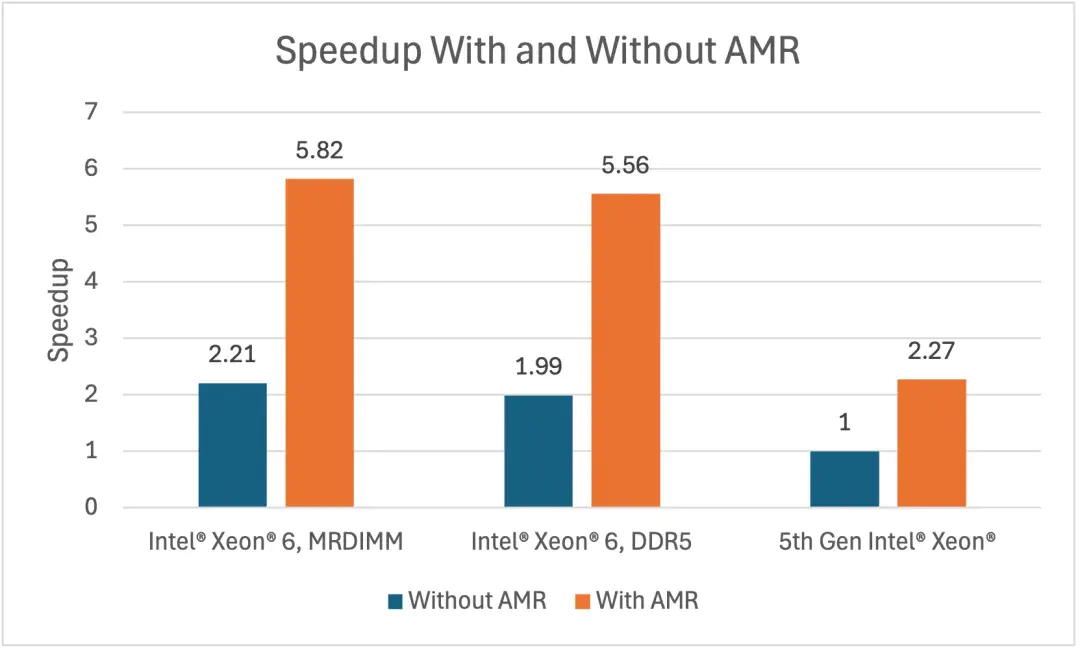
图 2:不同代英特尔至强处理器平台,开启 / 关闭自适应网格加密后的加速效果
“该算例中自适应网格加密效果十分突出:流动核心区接近层流状态,我们可以使用相对粗糙网格;而在边界层分离、斜激波这些关键位置,针对性加密网格。开启 AMR 之后,激波区域网格分辨率是关闭 AMR 的 4 倍。如果不使用 AMR 想要达到同等分辨率,网格单元数量需要达到 5300 万,内存占用会暴涨 20 倍以上。” ——Convergent Science 新应用方向研发工程师 Killian Whyte
自适应网格加密的价值不局限于航空航天领域。无论是内燃机火焰传播仿真、电池包热失控分析,还是海上风力发电机波浪冲击仿真,都可以借助这项技术,在可控的计算成本下捕捉复杂多物理场耦合现象,输出有价值的仿真结论,助力技术迭代。
落地应用,真实工程价值
以上测试结果对于 CFD 工程师意味着什么? 产品优化、新技术研发,需要对大量设计方案开展仿真探索。CFD 仿真的核心优势,就是在制造昂贵物理样机之前,通过虚拟仿真完成方案测试与优化。
仿真时间大幅缩短,意味着工程师可以进一步压缩产品研发周期,更快把升级后的新产品推向市场;同时,可评估的设计方案数量更多,优化更加充分,最终产品品质也会得到提升。仅仅升级前沿硬件,就可以收获上述全部收益。
“当前高性能计算(HPC)生态日趋异构化,但现代 CPU 依旧是大量科学计算任务极具竞争力的平台,兼顾优异性能与广泛易用性。” ——Convergent Science 高性能计算团队研发工程师 Sidarth Narayanan
英特尔数据中心软件部软件技术咨询工程师Zhang Yantao,深度参与本次联合测试,他表示: “很高兴看到英特尔 CPU 每一代的性能迭代,可以为 CONVERGE 用户带来实实在在收益。用户无需大幅改动现有工作流,就可以实现仿真速度提升。”
将新一代 CPU 强大算力,结合 CONVERGE 完善的仿真建模能力,工程师可以兼得高精度仿真结果与更短计算时间。本次测试充分展现计算硬件技术的长足进步,赋能仿真效率提升、工程研发优化,驱动技术创新突破。
想要了解如何加快你的仿真计算?欢迎联系我们!
声明与免责
实际性能受使用场景、系统配置以及其他多重因素影响;
性能测试结果基于文档标注时间、对应配置完成,不一定包含全部公开版本更新;
不同用户的使用成本、实际运行结果存在差异;
© 英特尔公司。英特尔、英特尔 logo 以及其他英特尔商标,归属英特尔公司及其子公司所有。其余品牌名称归各自产权方所有。


