
2-30从身份证照片中自动定位并识别 18 位号码:图像分割 + BP 神经网络身份证号码识别
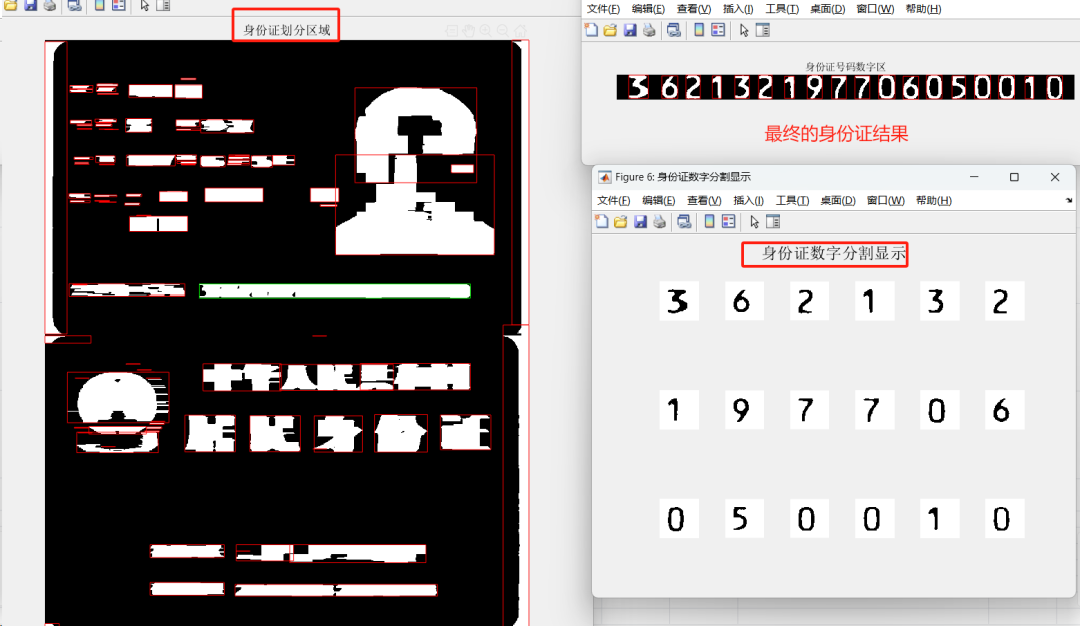
一句话介绍: 这套程序读取身份证照片,通过二值化、形态学膨胀和连通域分析自动找到身份证号码区域,再把 18 个字符逐个分割成 100×100 二值图,送入已经训练好的神经网络识别,最后利用第 18 位校验码判断整串号码是否识别正确,并把通过校验的结果保存到 TXT 文件。
先看它解决什么问题
如果直接把整张图片送给数字分类器,分类器并不知道哪里才是号码。
这套程序先解决“号码在哪里”,再解决“每个字符是什么”:
身份证照片 → 统一尺寸 → 二值化 → 横向连接字符 → 定位号码行 → 分割 18 个字符 → 神经网络逐字符识别 → 校验第 18 位 → 输出号码文本
需要先明确一点:
当前源码实际识别的是身份证上的 18 位号码,不是对姓名、性别、民族、地址等全部证件字段做 OCR。
1. 这个工程真正包含什么?
核心文件只有 4 个:
文件 | 作用 |
|---|---|
| 主程序,完成号码定位、字符分割、神经网络识别和校验 |
| 从号码区域中依次提取单个字符 |
| 已训练好的字符识别神经网络 |
| 工程自带测试身份证图像 |
程序识别成功后还会生成:身份证号码.txt用于保存最终通过校验的 18 位号码。
2. 程序首先怎样处理身份证照片?
随后把整张图统一缩放到:2560 × 2100并转换为双精度图像。
程序分别尝试 0.4 和 0.3 两个二值化阈值,其中后续真正用于号码定位的是:阈值 0.3
之后再使用半径约为:2 像素
的圆盘结构元素进行一次膨胀。
这样做的目的不是直接识别字符,而是先增强文本区域,让后续区域连接和定位更稳定。
3. 为什么还要连续做 3 次横向膨胀?
身份证号码中的 18 个字符原本彼此分开。
如果直接做连通域分析,程序会看到很多单独数字,很难把它们整体判断成“身份证号码这一行”。
所以程序先把二值图取反,让文字成为前景,再使用:
长度 20、方向 0° 的水平线结构元素
连续膨胀 3 次。
这个操作会把同一行中距离较近的字符沿水平方向连接起来。
可以理解为:
3 6 2 1 … → 一整条横向文本区域
于是身份证号码行就从“18 个小目标”转变成“一个长而窄的连通区域”。
4. 程序怎样从整张身份证里找到号码区域?
横向连接完成后,程序调用 regionprops 获取所有连通区域的外接矩形。
然后根据号码行的几何特征进行筛选:
宽度接近 1200 像素
并且:
高度接近 62 像素
具体允许范围约为:
|width - 1200| < 80
|height - 62| < 10
也就是说,程序利用的是:
身份证号码区域“横向很长、纵向较窄”的版式特征。
对工程自带 身份证.jpg 按源码流程复现,最终找到的候选号码区域约为:
1174 × 64 像素
正好落在源码设定的筛选范围内。
5. 号码行找到以后,18 个字符怎样分开?
号码区域提取完成后,程序再次执行连通域分析。
get_number.m 使用字符高度作为筛选条件:
字符外接矩形高度 > 20 像素
满足条件的区域被看作身份证号码字符。
程序随后按照区域顺序依次提取:
第 1 个字符 → 第 2 个字符 → … → 第 18 个字符
如果筛选后不是恰好 18 个字符,程序会提示:
身份证号码识别错误
对工程自带样本复现时,这一步能够筛出:
恰好 18 个字符区域
说明当前样本与源码预设的版式和尺度是匹配的。
6. 为什么每个字符还要放进 100×100 图像?
不同数字的实际外接矩形尺寸略有不同。
如果直接把不同大小图片送入神经网络,输入维数就无法保持一致。
所以程序建立统一的:100 × 100白色画布。
每个分割字符都被放到画布中,从第 21 行、第 21 列附近开始排列。
这样每个识别样本都会变成:100 × 100 = 10000 个像素
随后再拉直成:10000 × 1的输入向量。
因此整个预处理完成了:
不同尺寸字符 → 固定尺寸神经网络输入
7. NET_new.mat 里的神经网络是什么结构?
对 NET_new.mat 实际读取后,可以确认网络结构为:
10000 输入 → 50 个隐藏神经元 → 1 个输出
其中:
输入层对应 100×100 二值字符的 10000 个像素;
隐藏层有 50 个神经元;
隐藏层使用 logsig Sigmoid 激活函数;
输出层只有 1 个神经元,使用线性 purelin 输出。
所以它不是常见的“11 个输出节点分别对应 0~9 和 X”。
当前网络使用的是:单输出数值编码。
网络输出一个实数 a,然后程序执行:
class = round(a)
将输出四舍五入成整数类别。
8. 数字 0~9 和字母 X 怎样编码?
程序把普通数字直接编码为:
0、1、2、…、9
身份证最后一位可能出现的:X
则编码为:10
因此识别逻辑是:
网络输出 ≈ 0~9 → 对应数字
网络输出 ≈ 10 → 对应 X
最后写入 TXT 时,如果第 18 位结果等于 10,程序就输出字符:X
而不是字符串“10”。
9. 神经网络为什么能识别字符?
可以把当前两层网络理解为:
h = sigmoid(W₁x + b₁)
a = W₂h + b₂
其中:
x:10000 维二值字符;
W₁、W₂:训练得到的网络权重;
b₁、b₂:偏置;
h:50 维隐藏特征;
a:最终数值输出。
隐藏层并不是直接按照“第几个像素黑了”做判断,而是通过训练得到的权重,把大量像素组合成能够区分不同字符形状的内部特征。
最终输出再通过 round 映射到:0~10中的一个类别。
10. 为什么识别完 18 个字符以后还要做校验?
单字符识别即使每一位准确率都很高,18 位连续识别仍然可能出现某一位误判。
身份证号码本身提供了一个非常有用的额外条件:
第 18 位不是任意字符,而是由前 17 位按照固定权重计算得到的校验位。
程序使用的 17 个权重为:
[7, 9, 10, 5, 8, 4, 2, 1, 6, 3, 7, 9, 10, 5, 8, 4, 2]
先计算:S = Σ(i=1→17) IDᵢ × wᵢ
再计算:r = S mod 11
最后根据余数查表得到正确的第 18 位。
校验位表对应:[1, 0, X, 9, 8, 7, 6, 5, 4, 3, 2]
源码内部用数字 10 表示 X。
11. 校验码对识别有什么实际价值?
假设神经网络输出了 18 个字符,但中间某一位识别错了。
即使这个错误字符看起来“很像”,重新计算出来的第 18 位通常也会和网络识别的最后一位不一致。
程序因此增加了一层:
字符识别 → 整串号码合法性检查
只有当:计算得到的校验位 = 识别得到的第 18 位
才显示:身份证信息识别成功
并保存 TXT。否则程序直接提示识别错误。
所以这个工程不是单纯依赖神经网络,而是把:
图像识别结果 + 身份证号码自身规则
组合起来提高最终输出的可信度。
12. 工程自带样本的实际识别效果
对 身份证.jpg 按源码处理流程复现:
能够定位到符合尺寸条件的号码行;
能够分割出 18 个有效字符;
18 个字符输入 NET_new.mat 后,网络输出与样本图中的号码一致;
根据前 17 位重新计算的校验位与第 18 位一致;
整串号码通过源码中的合法性验证。
因此对工程自带示例来说,完整流程能够走通:
定位成功 → 18 字符分割成功 → 神经网络识别成功 → 校验成功
出于证件信息隐私考虑,这里不展示样本中的完整身份证号码。
13. 为什么不直接对整张身份证做神经网络分类?
当前网络的任务只是:识别一个已经分割好的单字符。
如果直接把整张身份证缩放成 100×100,号码只占其中很小一部分,姓名、人像、背景纹理都会成为巨大干扰。
所以程序先利用身份证固定版式做:号码区域定位
再利用连通域做:字符切分
最后才让网络解决:单字符分类
这样相当于把一个复杂问题拆成:在哪里? → 分成谁? → 每个字符是什么?
比让一个小型 BP 网络一次理解整张证件更加符合当前工程的能力范围。
14. 这种方法理论上为什么适合当前身份证样本?
优势一:版式几何信息先缩小搜索范围
身份证号码通常位于固定区域,并且是一条长文本。
横向膨胀和外接矩形筛选先把无关的人像、姓名和地址区域排除,让字符网络只处理真正需要识别的位置。
优势二:连通域适合分离印刷数字
当前样本中的 18 位号码字符之间有明显间隔。
二值化后,每个字符可以形成独立连通区域,因此可以直接按高度和位置切分。
优势三:固定 100×100 输入让网络结构简单明确
所有字符统一成 10000 维输入后,同一个网络就能处理 0~9 和 X,不需要针对字符大小设计不同模型。
优势四:校验码提供识别后的二次验证
图像分类只判断“长得像什么”,校验位则判断“整串号码在规则上是否成立”。
两者结合比只看单字符输出更完整。
15. 程序最终能得到什么?
运行成功后,程序主要得到:
身份证号码区域;18 个单字符二值图;18 个网络识别结果;校验码验证结果;
身份证号码.txt:通过验证后的号码文本。
同时主程序还会把分割出的 18 个字符临时保存为:1.bmp ~ 18.bmp
这些图片就是送入神经网络的标准化字符样本。
16. 怎么运行?
主程序是:new_ID.m
运行后选择需要识别的 JPG 或 BMP 身份证图片即可。
程序依赖图像处理函数,如 imresize、im2bw、strel、imdilate、regionprops,同时 NET_new.mat 使用 MATLAB 传统 Neural Network Toolbox 网络格式,通过 sim(net, BMP) 完成识别。
如果使用工程自带 身份证.jpg,当前固定尺寸、区域宽高筛选和字符高度规则能够直接匹配该样本。
17. 一句话看懂这个项目
这是一个身份证 18 位号码识别程序:它把证件照片缩放到 2560×2100,以 0.3 阈值二值化并进行形态学处理,再通过约 1200×62 的长条连通区域定位号码行,筛出 18 个字符并统一成 100×100 二值图;NET_new.mat 使用 10000 输入、50 隐层神经元和 1 个线性输出完成 0~9 / X 的数值分类,最后再用前 17 位的加权模 11 校验验证第 18 位,只有整串号码通过校验后才写入 身份证号码.txt。


