
2-29CEEMD + Sample Entropy 特征提取
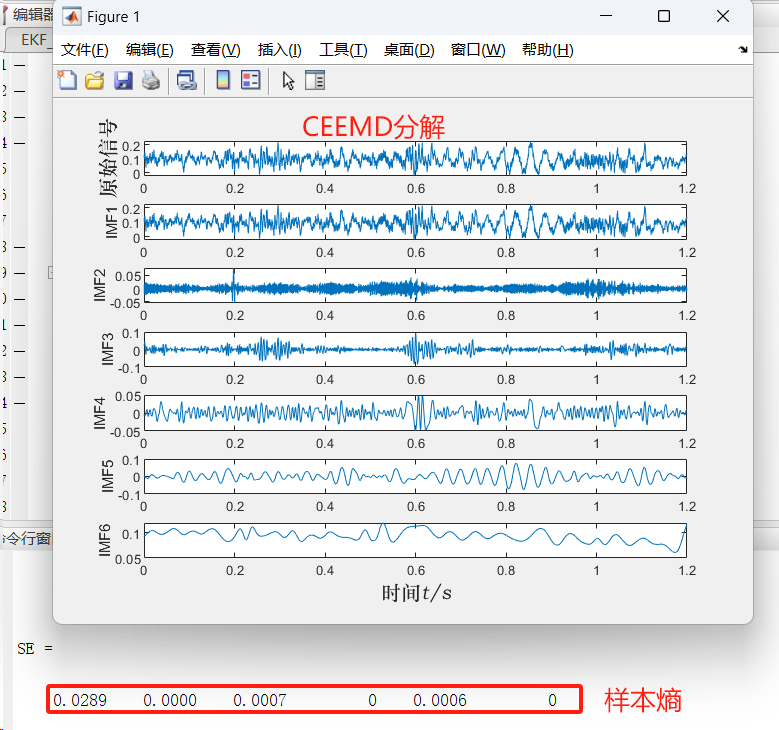
一句话介绍: 这套程序读取一段时间序列,先利用 CEEMD 加入成对正负高斯噪声,把原始信号分解成多个 IMF 模态和趋势项,再计算各分量与原始信号的相关系数,并用样本熵把每个分量的复杂程度转换成数值特征。
先看它解决什么问题
机械振动、阀门状态或其他非平稳信号往往不是单一频率。
一段原始波形里可能同时混有:
快速振荡;中等时间尺度变化;缓慢趋势;噪声和局部不规则波动。
如果直接对整段信号只计算一个统计量,不容易知道这些不同尺度分别发生了什么。
这套程序采用:
原始数据 → CEEMD 多尺度分解 → 相关性计算 → 各分量样本熵 → 特征向量
也就是说,它先把复杂信号“拆开”,再分别量化每个尺度的复杂程度。
1. 当前工程包含什么?
核心文件只有 4 个:
文件 | 作用 |
|---|---|
| 读取数据、执行 CEEMD、计算相关系数和样本熵 |
| CEEMD 核心分解 |
| 搜索局部极大值、极小值并处理包络端点 |
| 计算时间序列样本熵 |
2. 当前样本的时间长度是多少?
源码设置:采样频率 fs = 2560 Hz、采样点数 L = 3072
所以采样周期为:Ts = 1 / 2560 s
整段数据持续时间约为:T = 3072 / 2560 = 1.2 s
程序构造的时间轴从 0 开始,一直到约 1.2 s。
3. CEEMD 为什么要先给信号加噪声?
普通 EMD 依靠局部极值点逐步筛分 IMF。
如果信号中不同时间尺度混在一起,可能出现:
一个 IMF 同时包含明显不同频率成分,或者同一类振荡被拆到多个 IMF。
CEEMD 的思路是:
主动加入白噪声,让不同尺度在统计意义上得到更均匀的参考,再通过多次集 合平均抵消噪声。
当前程序先把信号除以自身标准差进行尺度归一化,然后加入高斯白噪声。
噪声标准差比例为:Nstd = 0.02
也就是加入噪声的标准差约为归一化信号标准差的 2%。
4. “C” 为什么叫 Complementary?
这份 ceemd.m 的关键不是只加一份噪声。
对于每一组随机噪声 e(t),程序同时构造:
X⁺(t) = Y(t) + e(t)
X⁻(t) = Y(t) - e(t)
然后分别进行 EMD 分解。
最后把正噪声和负噪声两次结果平均。
因为:
[Y+e + Y-e] / 2 = Y
理想情况下,成对噪声本身会在平均过程中相互抵消。
所以 CEEMD 相比普通 EEMD 又增加了一层:
互补噪声抵消机制。
5. 当前程序一共做多少次分解?
主程序调用:CEEMD(x, 0.02, 4, 4)
这里分别表示:
噪声比例:0.02、集 合次数 NE:4、提取 IMF 数量 TNM:4
每个集 合成员又包含:+噪声一次分解 + -噪声一次分解
因此总共实际执行:4 × 2 = 8 次 EMD
再把对应模态进行平均。
这种集 合平均可以降低一次随机噪声对最终 IMF 的影响。
6. 单次 EMD 是怎样得到一个 IMF 的?
对于当前待分解信号,extrema.m 先找到:
局部极大值;局部极小值。
程序再分别使用三次样条插值得到:
上包络 u(t)、下包络 l(t)
两条包络的局部均值为:
m(t) = [u(t) + l(t)] / 2
然后执行筛分:
h(t) = x(t) - m(t)
当前每提取一个 IMF,固定进行:5 次筛分
筛分后的高频振荡部分保存为 IMF,剩余部分继续提取下一阶模态。
这个过程重复 4 次,最后剩余部分作为趋势项。
7. CEEMD 最终真正返回什么?
这是理解当前程序最重要的一点。
ceemd.m 返回的 allmode 一共有:
TNM + 2 = 6 列
实际结构是:
第 1 列:原始信号
第 2~5 列:4 个 CEEMD IMF
第 6 列:最终趋势 / 残余项
因此真正的分解关系可以理解为:
x(t) ≈ IMF₁ + IMF₂ + IMF₃ + IMF₄ + R
其中 R 为剩余趋势。
第 1 列本身又保存了一份原始输入,所以它并不是额外的 IMF。
8. 为什么程序还计算 IMF 与原始信号的相关系数?
主程序对每个输出分量计算:
ρᵢ = corr(IMFᵢ, x)
相关系数可以写成:
ρ = cov(a,b) / (σₐσ_b)
其绝对值越接近 1,说明两个序列的线性变化越同步;
越接近 0,说明线性相关性越弱。
在 CEEMD 分解后,这个量可以帮助判断:
哪些模态和原始信号之间的关联更明显。
9. 样本熵到底测量什么?
样本熵 Sample Entropy 用来量化时间序列的:不规则程度和复杂程度。
基本思想是:
如果两段长度为 m 的短序列已经很相似,再多比较一个采样点以后,它们是否仍然保持相似?
如果大多数相似模式延长以后仍然相似,信号比较规则;
如果延长一个点以后大量模式失去匹配,信号更复杂。
因此通常可以理解为:
样本熵较小 → 序列重复性较强、结构较规则
样本熵较大 → 序列更复杂、更不规则
10. 程序怎样判断两段短序列是否相似?
对于长度为 m 的两个模板:
Xᵢ = [xᵢ, …, xᵢ₊ₘ₋₁]
Xⱼ = [xⱼ, …, xⱼ₊ₘ₋₁]
程序使用最大绝对差作为距离:
d(Xᵢ,Xⱼ) = maxₖ |xᵢ₊ₖ - xⱼ₊ₖ|
如果:d < r就认为这两个模板匹配。
然后分别统计:
长度 m 的模板匹配概率 B(m)
长度 m+1 的模板匹配概率 B(m+1)
最终样本熵为:
SampEn = -ln[B(m+1) / B(m)]
如果长度增加以后匹配概率明显下降,SampEn 就会变大。
11. 当前样本熵使用什么参数?
主程序固定:m = 2、r = 0.1
所以程序比较:
长度 2 的模式;长度 3 的模式;并把最大元素差小于 0.1 视为匹配。
这里的 r=0.1 是:直接作用在当前数据幅值上的绝对阈值。
因此如果以后换成幅值尺度明显不同的数据,样本熵数值也会受到尺度影响。
当前输入标准差约为 0.0386,而 r=0.1,因此这个匹配阈值相对于当前信号幅值并不小。
12. 最终特征向量是什么?
主程序对 imfn 中每一行都调用一次 SampEn:
SE(k) = SampEn(component_k, 2, 0.1)
所以按当前实际代码:SE 是一个 1×6 向量
它对应:
[原始信号熵, IMF₁熵, IMF₂熵, IMF₃熵, IMF₄熵, 趋势项熵]
如果应用目标只是用 CEEMD 的 4 个 IMF 作为故障特征,则可以取中间 4 项:
[SE_IMF1, SE_IMF2, SE_IMF3, SE_IMF4]
这样就得到一个紧凑的多尺度复杂度特征向量。
13. 为什么“CEEMD + 样本熵”比直接算一个样本熵更有信息?
如果直接对原始信号计算一次 SampEn,只能得到:
整段信号总体复杂程度。
但原始信号可能同时包含:
高频局部波动;中频周期成分;低频慢变化。
CEEMD 先把这些时间尺度分开。
然后每个 IMF 再单独计算样本熵:
原始复杂信号 → 多尺度模态 → 每个尺度各有一个复杂度
这样可以进一步回答:
复杂性变化主要发生在哪一个时间尺度。
这也是两种方法组合起来比单独使用其中一种更有价值的地方。
14. 为什么不用固定带通滤波器直接分频?
传统滤波器需要提前确定:
截止频率;通带;阻带。
但非平稳信号的有效频率可能随时间变化,而且不同数据的特征频带不一定完全固定。
CEEMD 不需要用户先人为规定 4 个固定频带,而是:
根据当前信号自身的局部极值和包络逐步提取模态。
所以它属于一种数据驱动的自适应分解方式。
随后样本熵又不依赖简单幅值大小,而是进一步描述每个模态内部模式的重复性。
15. 程序最终能得到什么?
运行 main.m 后
xiangguanxishu:各输出分量与原始信号的相关系数;
SE:各输出分量对应的样本熵。
真正用于特征分析时,核心信息可以压缩成:
4 个 CEEMD IMF + 4 个相关系数 + 4 个样本熵
16. 它适合用在哪里?
非平稳振动特征提取
先通过 CEEMD 把不同时间尺度拆开,再分别计算复杂度,适合观察振动状态变化。
机械故障诊断前端
可以把多个 IMF 的样本熵组成低维特征向量,再送入 SVM、神经网络等分类模型。
CEEMD 与熵特征教学
这份代码把:
互补噪声 → EMD 筛分 → IMF → 相关系数 → SampEn
串成一个完整流程,非常适合理解“信号分解 + 非线性复杂度特征”的组合方法。
17. 怎么运行?
main.m直接运行即可。
当前最关键的三个分析设置是 CEEMD 噪声比例 0.02、集 合次数 4 和样本熵参数 m=2 / r=0.1,它们分别影响辅助噪声强度、集 合平均程度和模板匹配判据。
18. 一句话看懂这个项目
这是一个 CEEMD + 样本熵特征提取程序,CEEMD 使用噪声比例 0.02、4 组集 合成员和正负互补噪声进行 8 次 EMD,并固定每个 IMF 筛分 5 次,最终得到 4 个 IMF 和一个趋势项;随后程序计算各分量与原始信号的相关系数,并以 m=2、r=0.1 计算样本熵,把不同时间尺度上的复杂程度转换成可用于状态识别的数值特征。


