
声学调参、仿真校准和小样本决策:贝叶斯学习有什么用?
做工程的人,应该都熟悉一种感觉:
手里有一些数据,但不够多; 有一些经验,但不敢完全相信; 有一个模型,但里面很多参数并不确定。
比如在 CAE 里,我们做跌落仿真,材料卡来自数据库,边界条件做了简化,试验样本又不多。仿真结果显示某个位置接近材料极限,这时候我们真正想知道的,不只是“应力是多少”,而是:
我到底有多大把握相信这个结果?
类似的问题,在声学算法里也很常见。
比如做耳机的通话降噪、波束形成、回声消除或者风噪抑制时,工程师经常要调很多参数:滤波器系数、增益门限、噪声估计速度、语音活动检测阈值、后处理强度等。
如果参数太激进,噪声是压下去了,但人声可能变闷、变断、变机械。
如果参数太保守,人声自然了,但地铁、办公室、风声又压不住。
这时候也不是简单问:
哪一组参数最好?
更现实的问题是:
在目前这些测试录音和主观听感反馈下,哪一组参数更可能稳定?
如果换一个说话人、换一个噪声场景,这个判断还可靠吗?
新测试数据来了以后,原来的参数选择要不要修正?
再比如做产品可靠性、传感器标定、电池寿命预测、制造良率分析时,也经常遇到类似情况:数据不完整,噪声不少,但又必须做决策。
贝叶斯学习的价值,就在这里。
贝叶斯学习不是一个神秘公式,而是一种很工程化的思维方式:
先带着已有经验做判断,再根据新证据不断修正判断。
它关心的不是“我能不能一次算出唯一正确答案”,而是:
在已有信息下,我现在应该相信什么?新数据来了以后,我的相信程度应该怎么更新?
工程判断里的不确定性更新
贝叶斯学习到底是什么?
如果用一句话说:
贝叶斯学习,就是用新数据不断更新我们对一个问题的相信程度。
它的核心公式大家可能都见过:
后验概率 ∝ 先验概率 × 似然
换成更通俗的话:
新判断 = 原来的判断 × 新证据的支持程度
这里有三个关键词。
先验,就是在看到新数据之前,我们已经有的判断。
它可能来自经验、历史数据、材料手册、专家判断,也可能来自上一轮试验。
似然,就是新数据对某个假设的支持程度。
如果新试验结果和某个假设非常吻合,这个假设的可信度就会上升。
后验,就是综合先验和新证据之后,我们更新后的判断。
所以贝叶斯学习并不是“凭感觉”。
恰恰相反,它是把“原来的经验”和“新的证据”放在同一个框架里更新。这也是《Bayesian Data Analysis》这类经典教材反复强调的核心思想:贝叶斯方法不是只给一个点估计,而是用概率分布表达不确定性,并随着数据更新这种不确定性 [1]。
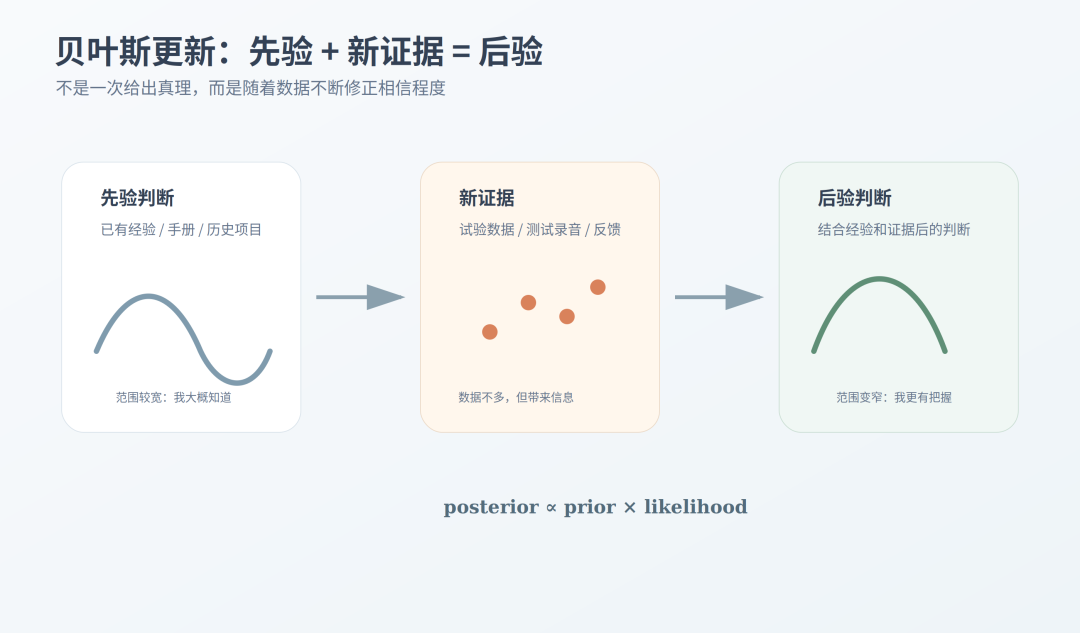
贝叶斯更新:先验 + 新证据 = 后验
一个简单例子:材料强度到底该相信多少?
假设我们要评估一种塑胶材料的强度。
材料手册上写,拉伸强度大约是 60 MPa。
但我们知道,不同批次、不同湿度、不同成型工艺都会影响结果。
所以我们一开始不会把 60 MPa 当成绝对真值,而是把它当成一个先验判断:
这个材料强度大概率在 60 MPa 附近,但可能有波动。
后来我们做了 5 个试样,测出来分别在 54 到 58 MPa 之间。
如果按很粗暴的方式,我们可能直接取平均值,然后把材料强度改成 56 MPa。
但贝叶斯的思路会更谨慎。
它会问:
• 原来材料手册的信息可信度有多高?
• 这 5 个试样数量够不够?
• 试验离散性有多大?
• 新数据是否足以推翻原来的判断?
最后得到的不是一个单点答案,而是一个更新后的分布。
也就是说,它可能告诉你:
现在我们认为材料强度更可能在 56–59 MPa 之间,而不是简单地说它就是 56 MPa。
这对工程判断很重要。
因为工程里很多问题,真正有用的不是一个漂亮数字,而是这个数字背后的不确定性。
贝叶斯学习和普通机器学习有什么不同?
普通机器学习经常给人一种感觉:
给它很多数据,它训练一个模型,然后输出一个预测结果。
比如输入几何参数、材料参数、载荷条件,模型预测最大应力或变形。
但贝叶斯学习更关心另一个问题:
这个预测有多确定?
这点对工程很关键。
如果一个模型说:
最大应力是 120 MPa。
这只是一个结果。
但如果它进一步说:
最大应力大概率在 110–130 MPa 之间;在当前数据下,超过材料极限的概率约为 15%。
这就更像工程决策需要的信息。
因为工程设计不是只看“预测值”,还要看风险。
尤其在这些场景里,贝叶斯思想会很有用:
• 样本很少;
• 试验成本很高;
• 数据噪声很大;
• 模型假设不完美;
• 需要根据新试验不断更新判断;
• 决策必须考虑风险,而不是只看平均值。
这也是为什么贝叶斯推断在模式识别、机器学习和工程建模里长期占有一席之地。Bishop 的《Pattern Recognition and Machine Learning》就把概率视角作为理解机器学习模型的重要基础 [2]。
贝叶斯学习为什么适合 CAE?
CAE 里有大量不确定性。
材料参数不确定。 载荷边界不确定。 制造偏差不确定。 接触、摩擦、阻尼、失效准则也不一定完全准确。
很多时候,我们不是在求一个“唯一正确”的答案,而是在不断缩小不确定性。
贝叶斯学习正好适合这种过程。
1. 用试验结果更新仿真模型
比如一开始仿真预测某结构一阶模态是 120 Hz,但实测是 112 Hz。
这时我们可能怀疑:
• 材料模量偏高;
• 边界刚度设得太硬;
• 某些连接简化不合理;
• 质量分布有误差。
贝叶斯方法可以把这些未知参数当成待估计变量,根据试验数据反推它们更可能的范围。
这类问题通常叫 Bayesian updating,也就是贝叶斯更新。
它不是简单地“调参让曲线对上”,而是更系统地问:
哪些参数组合最能解释当前试验结果?
更新后模型的不确定性还剩多少?
2. 小样本下做更稳健的判断
工程里经常没有海量数据。
你不可能每个材料批次都做上千次试验,也不可能每个结构方案都做大量破坏性测试。
这时候,贝叶斯方法可以把已有经验作为先验,再用少量新数据进行修正。
它不会因为 3 个样本就轻易推翻全部历史经验,也不会完全忽略新试验带来的信息。
这点很像有经验的工程师。
一个新工程师可能看到一次试验失败,就觉得方案全错了。
一个老工程师会说:先别急,看看这个试验本身有没有异常,再结合历史项目判断。
贝叶斯学习其实是在数学上表达这种“带经验地更新判断”。
3. 给优化和试验设计提供方向
贝叶斯学习还常常和 贝叶斯优化 放在一起用。
比如我们想优化一个结构参数,但每次仿真都很贵,一次可能要跑几个小时甚至更久。
这时不适合盲目扫参数。
贝叶斯优化会做两件事:
1. 根据已有仿真点建立一个带不确定性的代理模型;
2. 决定下一次最值得算哪个点。
它既会考虑当前看起来最优的区域,也会考虑不确定性很大的区域。
这很像一个聪明的试验工程师:
不只是试最可能好的方案,也要试那些信息量最大的方案。
Snoek 等人在 2012 年的工作把贝叶斯优化用于机器学习算法超参数优化,也让这类方法在“昂贵试验 / 昂贵仿真”的参数搜索里被更多人关注 [4]。
在声学算法里,它可以怎么用?
声学算法其实特别适合用贝叶斯思路理解。
因为声学调参经常面对三件事:
第一,场景多。
办公室、地铁、马路、风噪、键盘声、多人说话,噪声类型不一样。
第二,指标冲突。
降噪越强,人声越可能失真;保真越强,噪声越可能残留。
第三,评价不完全客观。
除了客观指标,还会有主观听感:闷不闷、断不断、刺不刺、自然不自然。
这时候,如果只靠手工调参,很容易变成经验试错。
贝叶斯优化可以把每一轮测试结果作为新证据,不断更新“哪些参数组合更值得尝试”的判断。
例如通话降噪算法里,我们可以把几个关键参数作为搜索变量:
• 噪声估计更新速度;
• 语音活动检测阈值;
• 后处理抑制强度;
• 风噪触发门限;
• 回声消除残差抑制参数。
每一组参数跑一批测试录音,得到客观指标和主观评分。贝叶斯优化根据这些结果决定下一轮最值得试哪几组。
这比随机试参数更有方向。
也比只凭工程师直觉更容易留下可追溯记录。
当然,这不是说贝叶斯优化可以替代声学工程师。
它更像一个帮助工程师安排试验顺序的助手:少试一些没希望的组合,多试一些可能有收获、或者能减少不确定性的组合。
在音频和声学相关研究里,也能看到贝叶斯优化被用于噪声抑制参数、混响算法参数、麦克风阵列布局等问题 [6][7][8]。这些工作不一定能直接搬到 TWS 产品调参里,但说明“声学参数 + 昂贵评估 + 不确定性搜索”确实是贝叶斯方法可以发挥作用的一类问题。
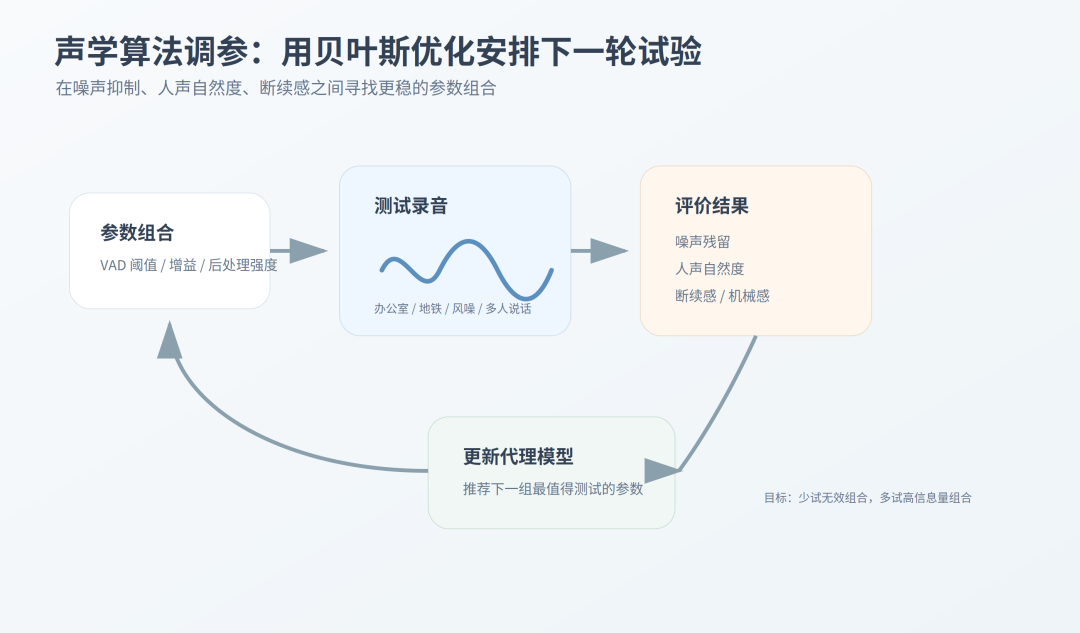
声学算法调参里的贝叶斯优化闭环
常见方法有哪些?
如果不展开太深,可以把常见方法理解成几类。
1. 贝叶斯更新
这是最基础的思想。
有一个先验判断,新数据来了以后,更新成后验判断。
工程模型校准、参数识别、可靠性分析里都能看到这种思想。
2. 贝叶斯网络
贝叶斯网络用图结构表示变量之间的概率关系。
比如一个产品失效可能和材料、温度、载荷、制造偏差、使用环境有关。
贝叶斯网络可以把这些关系组织起来,用来做故障诊断或风险推断。
它适合表达“多个因素互相影响”的问题。
3. 高斯过程
高斯过程常用于小样本建模和代理模型。
它不仅能预测一个结果,还能给出预测不确定性。
所以它经常出现在贝叶斯优化、昂贵仿真的代理建模中。
Rasmussen 和 Williams 的《Gaussian Processes for Machine Learning》是理解这一类方法的经典参考 [3]。
4. 贝叶斯神经网络
普通神经网络通常学习一组固定权重。
贝叶斯神经网络则认为权重本身也有不确定性。
它的好处是可以在预测时给出不确定性估计。
Blundell 等人的 Weight Uncertainty in Neural Networks 是贝叶斯神经网络方向的代表性工作之一 [5]。
不过实际工程中,贝叶斯神经网络计算成本更高,实现也更复杂,并不是所有场景都适合。
5. MCMC 和变分推断
这两个更偏计算方法。
因为很多贝叶斯模型的后验分布没法直接算出来,就需要近似计算。
MCMC 更像通过大量采样逼近真实分布。
变分推断则是用一个比较简单的分布去近似复杂分布。
工程应用里不一定每个人都要手写这些算法,但理解它们的作用有助于知道贝叶斯方法为什么有时会比较“重”。
它的价值,不只是提高精度
很多人评价一个模型,第一反应是看它准不准。
但贝叶斯学习的价值,很多时候不只是提高预测精度,而是让我们知道:
模型在什么地方有把握,什么地方没把握。
这在工程里非常重要。
因为一个错误但非常自信的模型,是危险的。
一个略有误差但知道自己不确定的模型,反而更有用。
比如两个模型都预测最大应力约为 100 MPa。
第一个模型只给一个数字:100 MPa。
第二个模型说:大概率在 90–130 MPa 之间,而且在某些工况下不确定性明显增大。
从决策角度看,第二个模型提供的信息更多。
它提醒工程师:这里可能需要补试验、加安全系数,或者重新审视边界条件。
贝叶斯学习也不是万能的
当然,贝叶斯学习不是银弹。
它也有几个现实问题。
第一,先验怎么选,很关键。
先验如果选得太主观,结果可能被带偏。先验如果太宽,又可能起不到约束作用。
第二,计算成本可能比较高。
尤其是复杂模型、高维参数、多物理场仿真,直接做贝叶斯推断可能非常重。
第三,结果解释需要经验。
贝叶斯方法给出的是分布和概率,不是一个简单答案。
工程师需要理解这些概率代表什么,不能机械地把它当成“系统自动给出的真理”。
第四,它依赖数据质量。
如果试验数据本身有问题,或者仿真模型假设错了,贝叶斯更新也只是把错误信息更系统地吸收进去。
所以贝叶斯学习不能替代工程判断。
它更像是一个帮助工程师组织不确定性、更新判断、安排下一步试验的工具。
对工程师来说,最该记住什么?
如果只记三句话,我觉得可以是:
第一,贝叶斯学习不是玄学,而是 用新证据更新旧判断。
第二,它最适合那些 数据少、不确定性大、试验成本高 的工程问题。
第三,它的价值不只是预测结果,而是告诉你 预测有多不确定。
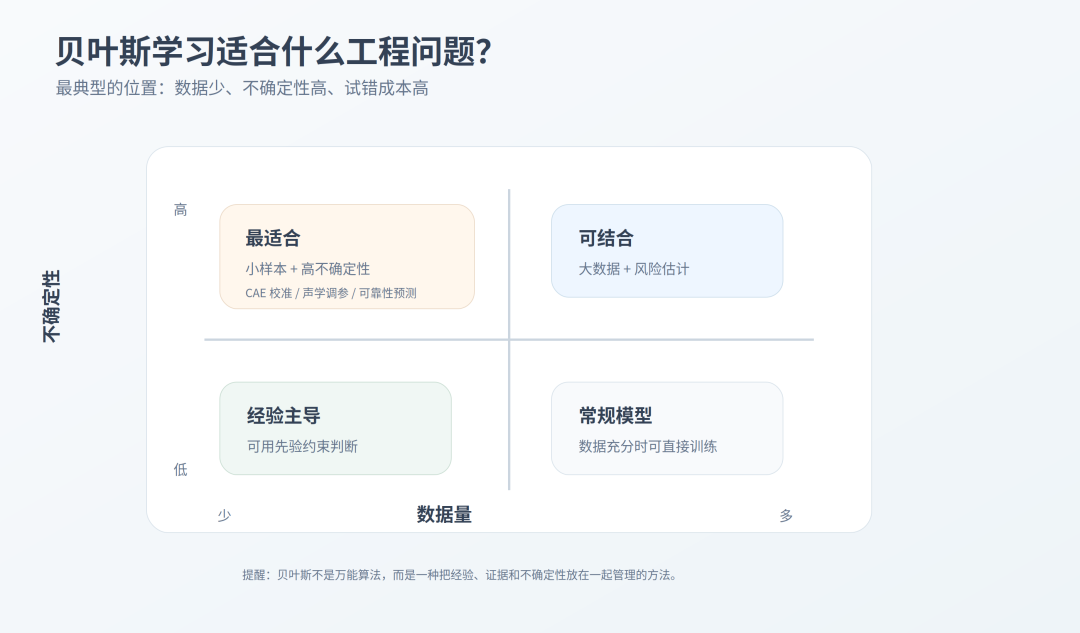
贝叶斯学习适合什么工程问题
在 AI 很火的今天,很多模型都在追求更大、更强、更通用。
但工程现场常常不是这样。
工程师面对的是有限数据、复杂假设、昂贵试验和必须负责的决策。
这时候,贝叶斯学习提供了一种很朴素但很重要的思路:
不要假装自己一开始就知道答案。
带着已有经验出发,看到新证据后,诚实地修正判断。
这其实很像工程本身。
仿真,不仅是算一个结果。
很多时候,也是不断更新我们对真实世界的理解。
参考文献
1. Andrew Gelman, John B. Carlin, Hal S. Stern, David B. Dunson, Aki Vehtari, Donald B. Rubin, Bayesian Data Analysis, 3rd Edition, 2013.
2. Christopher M. Bishop, Pattern Recognition and Machine Learning, Springer, 2006.
3. Carl Edward Rasmussen, Christopher K. I. Williams, Gaussian Processes for Machine Learning, MIT Press, 2006.
4. Jasper Snoek, Hugo Larochelle, Ryan P. Adams, Practical Bayesian Optimization of Machine Learning Algorithms, NeurIPS 2012.
5. Charles Blundell, Julien Cornebise, Koray Kavukcuoglu, Daan Wierstra, Weight Uncertainty in Neural Networks, ICML 2015.
6. Noise Cancellation Method Based on TVF-EMD with Bayesian Parameter Optimization, Algorithms, 2023.
7. Automatic Parameters Tuning of Late Reverberation Algorithms for Audio Augmented Reality, Audio Mostly, 2022.
8. Optimal Microphone Array Placement Design Using the Bayesian Optimization Method, 2024.


