
SCI一区期刊TCYB论文学习 |时频双流图神经网络驱动的多步预测模型
本期分享发表于一区Top期刊TCYB的论文,时频双流图神经网络驱动的多步预测模型。针对现有模型主要关注实时的当前步预测,而忽视了提前的多步预测的问题,文章提出了一个时频双流图神经网络驱动的多步预测模型,通过多图注意力层,从图论视角建模工艺变量间的动态耦合关系。最后,在垃圾焚烧数据集上验证方法的有效性与可行性。
论文基本信息
论文题目:A Graph-Based Time–Frequency Two-Stream Network for Multistep Prediction of Key Performance Indicators in Industrial Processes
论文期刊: IEEE TRANSACTIONS ON CYBERNETICS
论文时间:2024年
作者: Feng Yan, Xinmin Zhang, Chunjie Yang
机构:The State Key Laboratory of Industrial Control Technology, College of Control Science and Engineering, Zhejiang University,Hangzhou 310000, China.
论文下载:https://doi.org/10.1109/TCYB.2024.3447108
作者简介:
严锋,浙江大学控制科学与工程学院,2021级博士生,研究方向为工业过程建模与智能感知,目前以第一作者身份在IEEE TCYB、TNNLS、TII、TIE等权威期刊上发表学术论文10余篇;以第一发明人授权或公开发明专利10余项,其中美国专利1项。博士期间参加国家自然科学基金重大项目课题。曾获得2023年和2024年博士研究生国家奖学金、浙江大学五好研究生称号、浙江大学优秀研究生称号、湖南省优秀硕士学位论文、硕士研究生国家奖学金等。
作者邮箱:yanfeng555@zju.edu.cn
摘要
关键词: 时频特征、双流图网络、短时傅里叶变换
目录
2.2 双流网络的构建
2.3 时频特征融合
1 引言
在工业过程中,关键性能指标(KPI)的准确估计对于智能制造具有重要意义。在过去几十年中,基于深度学习的软测量模型主要包括两种代表性方法:基于自编码器(AE)的方法和基于递归神经网络(RNN)的方法。近年来,由于图神经网络(GNN)在提取变量潜在相互依赖性方面的迅猛发展,基于GNN的工业过程软测量建模研究也开始蓬勃兴起。例如,陈等人[189]提出了一种新型的堆叠图卷积网络,通过自适应邻接矩阵从过程变量中提取知识,捕捉与工业过程相关的特征,从而提高了软测量的准确性和模型的可解释性。文献[95]设计了一种动态多跳注意力图卷积网络,能够实时提取细粒度空间特征。在真实的煤磨设备上的实验结果表明,该模型的性能优于其他方法。上述研究进展表明,基于GNN的软测量建模是探索过程变量之间相互依赖关系的一个有前景的方向。
目前,大多数研究集中于当前步的软测量建模。然而,在实际工程应用中,关键性能指标(KPI)的多步预测能够为现场工作人员提供充足的时间,以调整相关工艺参数,从而确保工业生产的正常运行。例如,在烧结过程中,烧结终点(BTP)反映了燃烧过程中燃料被烧透的位置。为了提高烧结矿的质量和数量,实现BTP的多步预测显得尤为重要,这将为现场工作人员提供提前调整台车速度的指导。
目前,多步预测方法主要包括传统统计方法和深度学习方法。传统统计方法如自回归滑动平均(ARIMA)模型、向量自回归(VAR)模型以及指数加权移动平均法等,广泛应用于时间序列分析。而基于深度学习的多步预测模型也已在时间序列分析中得到了广泛应用,例如SCINet[131]、LTSF-Linear[190]。在实现工业过程中关键性能指标(KPI)的多步预测方面,已有一些研究取得了进展。例如,Yan等人[191] 提出了一种降噪时空编码解码(DSTED)框架,用于提前预 测烧结终点(BTP)。尽管DSTED考虑了潜在变量与目标变量之间的相关性,但仍然忽视了过程变量之间复杂的空间耦合关系。此外,DSTED采用门控循环单元(GRU)来捕捉时间域的动态特征,这对于长期依赖建模来说显得不足。
综上所述,现有的多步预测方法仍面临两个主要挑战:
(1)复杂的耦合关系。现有大多数方法基于欧几里得空间建模变量之间的耦合关系,这不可避免地导致拓扑结构数据的一些信息损失。新的研究[192]表明,图神经网络(GNN)能够有效地从非欧几里得数据中提取空间耦合关系。然而,基于GNN的方法在建模生产条件变化时的动态耦合关系方面存在局限。此外,现实工业场景中,变量之间通常存在多种复杂的多类型关系,而现有多步预测方法往往仅考虑了变量之间的单一关系。
(2)长期依赖性挖掘。从本质上讲,多步预测任务可视为一个长期依赖学习问题,其主要瓶颈在于提取长期依赖的复杂时间模式。大多数时间序列模型仅在时间域进行了长期依赖分析,而对频域分析的关注仍然不足。因此,如何将频域特征有效融入深度学习模型,成为一个具有挑战性的问题。
以废物焚烧过程为例,多步预测主蒸汽流量是大型废物焚烧炉正常生产的必要前提。对于发电厂而言,在固定废物量的条件下,高输出的主蒸汽流量能够带来更高的经济效益。在燃烧过程中,必须确保炉温高于850℃。然而,原材料使用的波动及现场工作人员的变动可能导致整个废物焚烧过程出现较大的延迟。目前,过程参数的调整主要依赖于现场工作人员的经验,这导致参数的估计和控制不够准确。当主蒸汽流量超过炉子的额定容量时,可能会导致严重的参数波动,从而给电厂带来重大损失。在实际电厂中,现场工作人员需根据实际工程需求调整操作参数,以确保主蒸汽流量的正常运行。因此,精准的多步预测框架对于实际工业应用的早期预警和部署具有重要意义。
鉴于上述理论挑战和实际工业需求,本章旨在超越以往的时间域建模,提出一种基于图的时频双流网络(GTFTS),从时域和频域角度对工业数据进行建模,以实现关键性能指标(KPI)的多步预测。本章的主要目标是从新的视角增强深度学习的预测能力,使其能够进行频谱分析。由于时间序列中的潜在时间相关性与频率分析密切相关,这有助于挖掘长期依赖性。在工业过程中,由于不同操作参数导致的多工况条件,通常存在周期性数据分布漂移的问题。一般而言,短时间尺度的依赖性(例如短期异常工作状态)主要集中在低频域区域,而长时间尺度的依赖性(例如正常工作状态)则因现场工作人员的调整而往往出现在高频区域。基于上述动机,本章采用时间-频率变换方法,将原始时间序列分解为从低频到高频的子序列。因此,有效发现和分离不同频率的工作模式将有助于趋势学习,从而提高预测的准确性。
在技术层面,对于挑战1,构建了一个多图注意力学习层(multi-GAT),捕捉过程变量之间的复杂动态耦合关系。多图能够从不同角度识别过程变量之间的潜在相关性。同时,自注意力机制嵌入到图网络中,显式地建模动态趋势。对于挑战2,开发了特征融合模块,使用最小冗余和最大相关性方法来结合时间-频率特征。首先,利用最小冗余目标函数来减少两种特征之间的重叠信息,同时基于最大相关性原则增强融合特征与目标序列之间的相关性。两个真实世界数据集的结果分析和讨论表明,所提出的GTFTS模型在工业过程中展现了优越性和可行性。本章的主要贡献如下:
(1)时频联合框架。提出了一种双流网络框架,从复杂工业数据中提取具有区分性和信息量的时间-频率特征。与以往研究不同,这是一种新的尝试,旨在将频率信息集成到工业预测模型,为工业过程中的时域建模提供了补充信息。
(2)多图注意力网络。构建了一种多图注意力层,用于建模工业过程变量之间的动态复杂耦合关系。所提出的multi-GAT可以全面考虑变量之间的多重交互关系,生成更符合工业过程的图结构,从而弥补单一图结构的不足。
(3)特征融合模块。设计了一种最小最大学习范式的特征融合模块MRMC,该模块有效地结合时间和频率特征,增强融合后特征的表达能力。具体而言,采用最小冗余方法来减轻时间域和频域特征之间的重叠信息。同时,计算最大相关性以确保融合特征与目标变量之间的强相关性。
2 方法理论
如图1所示,本章提出的GTFTS框架图有三部分组成:数据生成模块、多图注意力模块和特征融合模块。首先,将原始数据进行预处理,例如采用最大最小归一化方法。随后,使用滑动窗口技术获得一系列时间片段,并沿时间轴将整个数据集划分为训练集、验证集和测试集。然后,将过程变量的时间序列通过短时傅里叶变换技术转换为频率信息。在此基础上,构建多层图注意力网络以提取时域特征和频域特征。接着,设计特征融合模块,以结合这两种特征,并将融合后的特征作为长短期记忆网络(LSTM)的输入,以实现多步预测任务。最后,构建整体损失函数,基于反向传播算法训练模型,将训练好的模型部署到工业系统中。下面详细介绍GTFTS的结构。
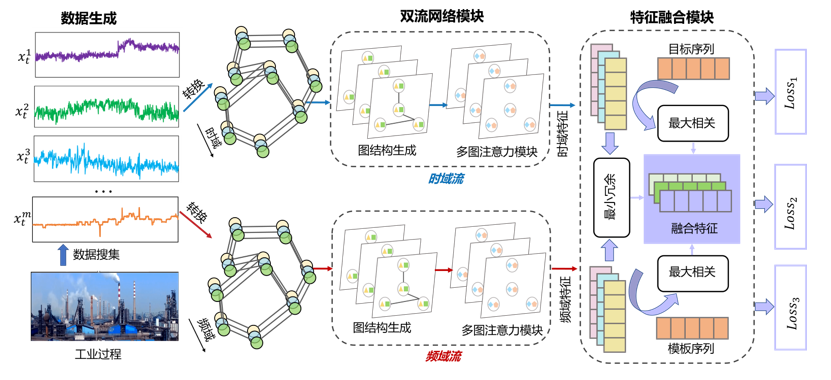
图1 GTFTS框架图
2.1 多图注意力层
工业系统中存在各种设备单元,每个设备均配备多个传感器以收集信号。每个信号被视为过程变量,从而生成多元时间序列,并且过程变量之间存在强耦合特性。例如,在废物焚烧系统中,主蒸汽流量不仅受到给水流量的影响,还与第一个空气调节阀密切相关。在正常工作条件下,增加给水流量可以改善主蒸汽流量,因为主蒸汽流量本质上源于给水流量的变化。当给水流量增加时,第一个空气调节阀应提供更多的氧气以支持炉子的燃烧。以上分析发现,过程变量之间的关系可以视为非欧几里得图结构。因此,有必要使用图神经网络来建模空间依赖关系。
合理生成图结构是图神经网络建模的前提。如果生成的图结构不能有效编码工业数据的信息,将会妨碍图网络的学习。然而,完全理解工艺机理是极其困难的,现有方法也缺乏具体的计算方式来精确预定义图结构。通过反复实验发现,目前没有一种标准的度量方法能够生成最优图结构以解决工业预测建模问题。在真实的工业系统中,不同变量之间的关系往往是隐式的,且难以直接利用距离方法进行计算。更重要的是,过程变量之间可能存在多种依赖关系。以废物焚烧案例为例,主蒸汽流量与给水流量之间的相互作用是动态且复杂的。单一的度量方法无法全面反映它们之间的交互影响,这表明不同传感器测量之间存在多种类型的边。因此,针对这一问题,需要探索更为灵活和综合的图结构生成方法,以准确捕捉过程变量间的复杂关系。
为了解决上述挑战,本章构建了一种多图注意力网络,综合不同表征形式的邻接矩阵,以全面反映过程变量之间的复杂关系。这些邻接矩阵包括基于距离的方法、基于相关性的方法和基于互信息的方法。如图2所示,多图注意力网络的构建包括两个步骤:确定邻居节点和重新分配邻居节点的权重。邻接矩阵的主要目标是判断两个节点之间是否存在边。接下来,将分别采用三种不同的邻接矩阵形式进行建模。其中,高斯核距离通过计算节点之间的空间近邻性来表征节点之间的关系。
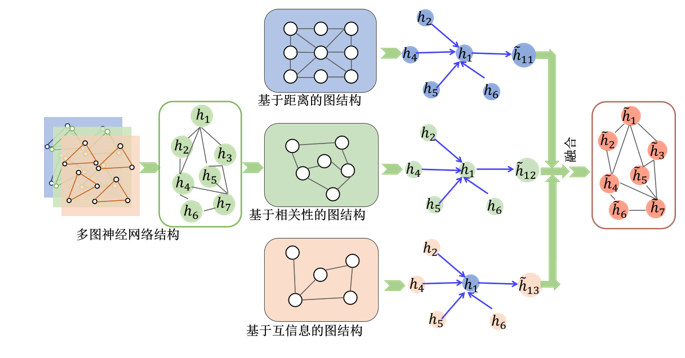
图2 多图注意力网络结构
其中, 为指数函数, 为节点 和节点 之间的欧式距离, 为超参数, 为高斯核距离的权重系数。同理,可以计算出皮尔逊相关性:
其中, , 分别代表节点 和节点 上的时间序列, , 分别代表对应节点的标准差, 为皮尔逊相关性的权重系数。基于互信息指数的权重如下:
其中, 代表概率分布函数, 为互信息指数的权重系数。最后,对这三个邻接矩阵取平均值构成多图网络。
接下来,对这三个权重进行归一化,并使用平均操作将三个图( 、 和 )合并为一个图 。使用极大极小方法将三个权重归一化到 [0,1],例如 、 和 融合后的邻接矩阵 表达如下:
其中, 是三个权重( 、 和 )归一化后的平均值。 代表 的元素, 是其阈值。
在确定邻接矩阵之后,下一步是重新分配邻居节点的权重。在实际工业生产中,由于原材料的波动,过程数据展现出较强的时变特性,这导致图的空间结构随之变化。为了动态建模过程变量之间的耦合关系,本章采用图注意力网络(GAT)实时量化相邻节点之间的重要性。GAT的核心思想是将自注意力机制嵌入图网络中,以实现权重的自动学习。具体的计算过程如下:
其中, 表示图网络的第层 。 和 分别代表第 层中第 和 个节点的特征 是掩码注意力函数, 是第 层的权重矩阵, 表示激活函数。掩码注意力函数 的计算方法如下。
其中, 表示不同节点之间的重要性。 是一种简单的Bahdanau 注意力机制,其中 、 和 都是可学习的参数。为了与该文献保持一致,使用邻接矩阵 基于元素乘积来掩蔽注意力得分。掩码注意力的目标是计算两个邻居节点之间的 ,而不是所有边。最后,使用softmax函数对它们进行归一化:
其中, 代表图中节点 和节点 之间所有邻居的集 合。
2.2 双流网络的构建
对于时间序列分析,通常从两个方面研究:时域方法和频域方法[193]。前者主要探讨信号(或变量)的动态变化,后者则展示每个信号在一系列频率范围内的振幅分布情况,这些信息均可以作为原始数据的潜在特征。目前,大多数时间序列模型仅关注时域建模,忽视了频域信息[194]。为了充分利用数据信息,一个直观的思路是同时融合两个领域的信息。在深度学习模型中,关键任务是从原始数据中学习尽可能多的有用特征。相关文献[193]也证明,频谱表示有助于根据各个频率中的隐藏趋势推断时间序列的未来状态。
在工业过程中,由于原料波动和现场工人的调整,工况存在周期性变化。原料通常在固定时间段内更新(例如一周或一个月),导致过程变量呈现出周期性变化。此外,每台机器(例如垃圾焚烧炉)都配备了不同的工人来调整相关参数,以维持工业现场的正常运行。不同工人具有各自的操作设置,这也会引起工况的波动。因此,添加额外的频域特征信息有助于提升工业过程中的多步预测能力。基于上述观察,本章建立了一个时频双流网络,从时频域的角度挖掘工业数据中的隐藏信息。
(1)时域流建模
在时间维度,时域流使用多图注意力网络(multi-GAT)捕捉不同过程变量之间的耦合相关性。为方便起见,每个时域流和频域流的输入序列分别表示为 和 。当 输入到多重图注意力学习层时,提取的时域特征 表示为:
其中, 表示时域流中多图注意力层的映射函数, 是可学习的权重矩阵。 和 分别是时域中的图结构和邻接矩阵。 表示图网络中的隐藏神经元数量。
(2)频域流建模
一般来说,时域信号可以通过傅里叶变换转换为频域。工业过程存在多工况和强非线性特性,导致过程数据具有非线性和非平稳特性。传统的傅里叶变换方法难以捕捉短期瞬态,短时傅里叶变换(STFT)[195]是一种典型的离散信号处理方法。STFT的主要思想是将长信号划分为一些长度相等的短片段,并采用傅里叶变换处理这些短片段。新的研究成果表明[196],STFT能够从时间序列中提取重要信息。在此基础上,本章利用STFT在工业领域进行频率分析。给定一个时间窗口函数 ,信号 的STFT定义为:
其中, 表示虚数单位。对于工业时间序列,上述方程的离散化形式如下:
在频域中,使用该方程将所有原始时间序列数据 转换为频谱信息。经过计算,可以获得所有节点上不同频率的幅度 。整体转换过程如下:
其中, 和 分别表示时域和频域的长度。 的每个元素表示对应的频率和幅度。同样,频域流经过多重图注意力操作后的输出 如下所示。
其中, 代表频域流中的映射模型, 代表模型参数。 和 分别表示频域中的图结构和邻接矩阵。
2.3 时频特征融合
在从双流网络中分别提取时域和频域特征后,如何将这两种特征结合起来也是一个关键步骤。通过文献分析,特征融合有两种著名策略:串行融合[197]和并行融合[198]。串行特征融合方法是将不同的特征向量组合成一个联合长向量。尽管这种方法简单,但会导致融合特征与目标序列之间的相关性较弱。并行特征融合策略是通过将两个向量相加生成一个复合向量。该方法通常会破坏原始数据的信息,忽略了两种特征之间的内在关系。
在垃圾焚烧过程中,不同的过程变量对主蒸汽流量的影响存在较大差异。例如,给水流量是一个与主蒸汽流有较强相关性的过程变量。相比之下,第一空气挡板与主蒸汽流之间的相关性并不是很强。在这种情况下,为每个特征分配不同的权重可以提高模型训练的收敛速度。传统的特征融合方法并没有保证融合特征与主蒸汽流之间的最大相关性。为了弥补这些不足,提出了一种最小冗余最大相关性(MRMC)方法,用于融合时域和频域特征表示,如图3所示。这种融合方法不仅可以从时频特征中获取不同域的独有信息,还能消除冗余信息。该模块能够确保融合特征与目标序列之间的最大相关性,有助于后续建模任务。
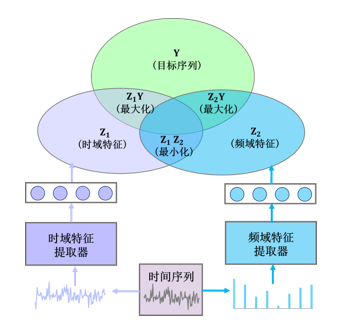
图3 基于最小最大原则的特征融合模块
(1)最小冗余
受局部保持投影(LPP)[199]思想的启发,本章提出最小冗余方法,以消除时域特征和频域特征之间的重叠信息。该方法使用一个简单的全连接层将时域特征 和频域特征 投影到潜在空间 。
其中, 和 分别表示两个全连接层的输出。 、 、 和 都是可学习的参数。投影变换的目标是通过优化以下目标函数,最小化这两种特征在流形空间中的冗余。
其中, 是通过计算两个原始特征 之间的距离得到的权重矩阵。 是一个超参数。 是两个原始特征之间的欧几里得距离。与通过广义特征值分解求解的LPP不同,本章提出的最小冗余方法通过将集成到损失函数中来优化目标函数。该方法可以降低计算复杂度,并指导网络使用反向传播算法融合这两组特征。
(2)最大相关
此外,为了捕捉与目标序列高度相关的有价值特征,需要考虑融合特征与目标变量之间的相关性。常用的特征融合方法包括典型相关分析(CCA)[200],它广泛用于提取不同特征之间的隐含关系。尽管 CCA 可以描述两组特征向量之间的相关性,但它属于线性子空间学习方法,无法刻画非线性关系。因此,本章开发了一种最大相关性分析方法,利用滑动点积来促进模型学习与目标相关的特征。给定特征 的一个序列 ,计算 与目标序列 之间的相关性如下。
其中 是非线性Sigmoid 激活函数。 与 之间的相关性也可以表示为:
其中, 表示 的第一个序列。投影特征 , 与目标序列 之间的最大相关性可以表示为:
(3)三元损失函数
基于MRMC方法,融合后的特征如下:
最后,融合后的特征 被输入到输出层(即LSTM),以实现多步预测任务。我们可以得到最终的预测序列 ,因此损失函数 通过均方误差计算如下:
同时,MRMC的损失函数表示为:
总三元损失函数由三个部分组成:
该三元损失函数可以促使模型学习时间域和频域表示之间一致且互补的特征。相应地,MRMC的权重参数 通过整体损失函数进行优化。下面使用随机梯度下降方法来更新网络参数。
假设 表示学习率,这些可学习参数在负梯度方向上进行迭代优化:
当GTFTS模型在数据集上进行训练时,整体损失函数使用“推”和“拉”操作学习模型参数,以引导模型捕捉与目标相关的时频特征,从而促进长期依赖学习。根据上述理论分析,可以发现所提出的模型能够学习多变量耦合特性和上下文时间信息,实现BTP多步预测任务。
3 实验案例
3.1 数据集介绍与实验设置
垃圾焚烧是一种将城市固体废物转化为电能的高温热处理技术,已在发电厂得到广泛应用[201]。经典的焚烧炉由三个系统组成:炉排系统、阻尼器系统和炉膛系统。在整个燃烧过程中,主蒸汽流进入涡轮单元,完成热能转换。生成的主蒸汽流越多,发电厂带来的经济效益就越高。目前,主蒸汽流的估算主要依赖于现场工人的经验,这使得提前准确预测变得异常困难。因此,有必要采用数据驱动建模方法。根据先进传感器收集的历史过程数据来提前预 测主蒸汽流。经过机理分析,确定了14个关键变量,包括CO含量、第一空气阻尼器、给水流量等。
本章将所提出的 GTFTS模型与十个典型基线模型进行比较,包括最先进的模型:LSTM、TCN、ConvLSTM、Seq2Seq、LSTNet、DSTED、Informer、LTSF-Linear和 TG-Att。原始废物焚烧数据每分钟实时从电厂收集。前7000个片段、1000个片段和剩余的500个片段分别用作训练集、验证集和测试集。所有实验独立重复十次(Intel Core i7 CPU @ 2.90GHz,40 GB内存),报告平均结果。本章使用历史过程数据(即 )来预测接下来的3、6和9分钟的蒸汽流量( =3,6,9)。本章选择了三种常见指标来评估不同方法的性能,包括平均绝对误差(MAE)、均方根误差(RMSE)和平均绝对百分比误差(MAPE)。
GTFTS模型在PyTorch框架上实现,输入数据通过极小值-极大值归一化处理,缩放到 [0,1] 的范围内。所有深度学习模型的参数使用Adam优化器进行更新。图注意力层的数量、隐含神经元的数量( )和潜在空间的维度( )分别设置为2、20和30。邻接矩阵的阈值 设置为0.6。模型训练迭代次数为15,批量大小和学习率分别为20和0.001。
3.2 实验结果与分析
表1列出了所有模型在测试数据上的评估结果,其中输出步长分别为3、6和9。从结果对比中可以观察到,所提出的GTFTS模型在所有评估指标上表现最佳。GTFTS获得的均方根误差(RMSE)、平均绝对误差(MAE)和平均绝对百分比误差(MAPE)值分别为1.007、0.758和1.206%。TCN和LSTM等模型仅考虑短期时间依赖性,其长期预测能力受到限制。相对而言,经典的Seq2Seq模型凭借其编码-解码结构,在多步预测问题上具有天然优势。此外,LSTNet通过整合CNN、RNN和自回归模型的优势,能够捕捉长期模式,因此取得了相对较好的性能表现。然而,LSTNet仅考虑时间相关性,忽视了过程变量之间复杂的耦合关系。ConvLSTM模型将卷积嵌入LSTM中以捕捉空间特征。从表1可以看出,ConvLSTM的表现优于LSTM,但由于无法学习长期依赖性,其预测误差仍大于Seq2Seq和LSTNet。目前,先进模型LTSF-linear无法处理非线性工业数据,因此未能获得理想效果。相比之下,其他先进模型如SCINet、Informer和TG-At的表现均优于LSTNet。此外,DSTED模型利用空间注意机制学习潜变量与目标变量之间的关系,从而超越了大多数基线模型。GTFTS模型则利用图结构来建模不同变量之间的空间相关性。同时,GTFTS采用图注意层研究频域特征,从而提高了多步预测的性能。
表1 不同模型多步预测性能对比
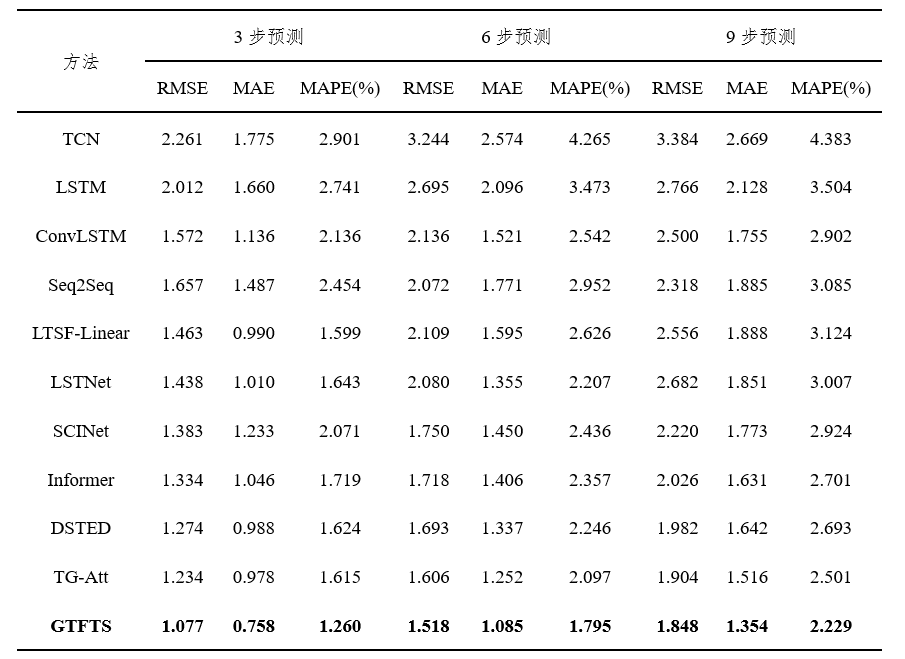
此外,根据不同预测步长的性能分析,所有方法的RMSE、MAE和MAPE随着预测步数的增加而逐渐增大。因为随着预测步长的延长,随机因素的干扰会逐渐增强。由于篇幅限制,本章仅展示了性能排名前四的方法在未来三步内对主蒸汽流的预测细节。如图4所示,与其他基线模型相比,本章提出的GTFTS模型具有更好的拟合效果,从而证明了其优越性。
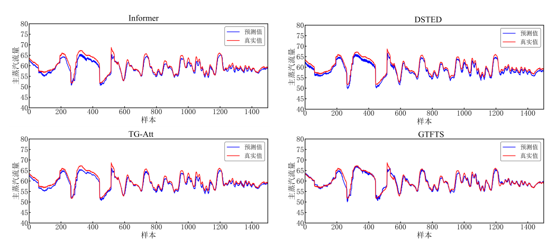
图4 不同模型预测对比图(top-4)
3.3 消融实验
为了验证关键组件对GTFTS 模型的贡献,本章对主蒸汽流的后三步预测进行了消融研究。GTFTS的变体如下。
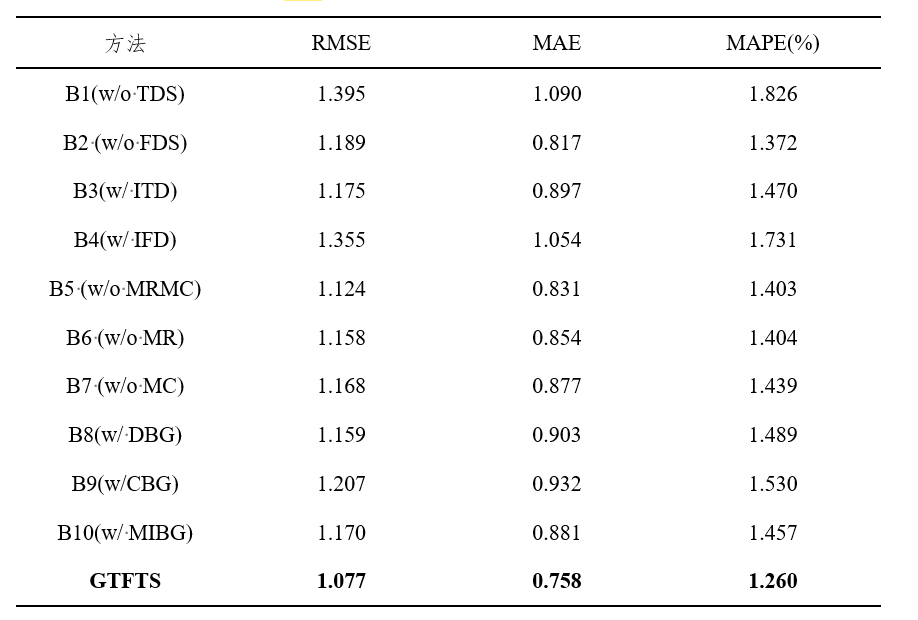
B1 w/o TDS: 不含时间域流模块的GTFTS,仅使用频域流提取频率特征,直接实现多步预测任务。 B2 w/o FDS: 不含频域流模块的GTFTS,仅考虑时间特征,使用一个基于时间的特征提取器,忽略频谱特征。 B3 w/ ITD: 双流网络由两个相同的时间域流组成。 B4 w/ IFD: 双流网络由两个相同的频域流组成。 B5 w/o MRMC: 不含特征融合模块的GTFTS,用简单的线性连接方法替代最小冗余最大相关(MRMC)方法。 B6 w/o MR: 去除了特征融合模块的最小冗余项(MR)。 B7 w/o MC: 去除了特征融合模块的最大相关项(MC)。 B8 w/ DBG: 三个图学习层均基于距离图。 B9 w/ CBG: 三个图学习层均基于相关性图。 B10 w/ MIBG: 三个图学习层均基于互信息图。
表2提供了不同变体的预测性能结果,根据对比结果分析,可以总结出以下三点:
结果表明,双流网络的表现优于单流网络,说明从工业数据中提取时间特征和频率特征能够提供更丰富的信息。同时,这也揭示了上述两类特征是互补的,能够增强多步预测的性能。B2的预测结果显示,时间域流网络学习了大部分有用特征,但仍然丢失了一些频域信息。同时,B1的性能显著低于GTFTS,这意味着频域流无法从时间序列中学习到重要的时间相关性。此外,本章在双流结构中进行了多个相同领域信息提取模块的消融实验。通过比较两对变体模型(B1与B4,B2与B3)的性能,发现两个相同领域的特征提取并未显著提升预测效果。例如,两个时间域网络提取的时间特征相同,因此无法获得更多有用信息。 从表2可以观察到,包含特征融合模块的GTFTS模型的表现优于仅采用简单连接方式的B5。B6去除了最小冗余模块,其表现低于GTFTS模型,因为该模型无法有效消除两个分支流网络中的冗余信息。此外,B7的均方根误差(RMSE)大于GTFTS,这表明其未能最大化融合特征与目标变量之间的相关性。基于以上分析,可以发现本章设计的融合模块对预测具有重要贡献。该融合模块促使GTFTS模型自适应地学习融合特征与目标序列之间的相关性,从而提高了预测的准确性。 根据B8、B9和B10的预测性能可以看出,使用相同类型图结构的多图学习层的表现略优于单一图结构。这是因为相同的图结构只能捕捉到相似的信息,无法有效学习变量之间的多重关系。相比之下,包含不同种类图结构的GTFTS模型能够学习到更具区分性的特征表达。因此,完整模型GTFTS的性能优于所有变体模型。
表2 不同消融变体模型预测性能对比
3.4 多图注意力网络分析
为了研究本章构建的多图注意层的效果,下面进行了一系列比较实验,即采用不同的方式计算图邻接矩阵(A)。
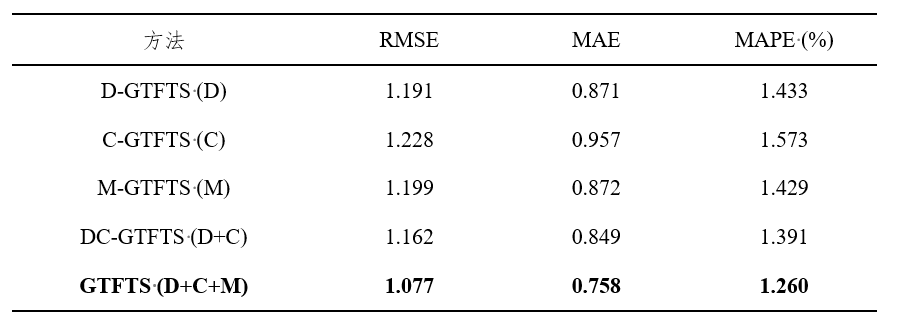
D-GTFTS:仅使用基于距离的邻接矩阵生成图结构。 C-GTFTS:仅使用基于相关性的邻接矩阵生成图结构。 M-GTFTS:仅使用基于互信息的邻接矩阵生成图结构。 DC-GTFTS:同时使用基于距离和基于相关性的邻接矩阵生成图结构。 GTFTS(完整模型):使用三种类型的邻接矩阵生成图结构。
表3提供了不同形式邻接矩阵的预测性能,结果显示,使用三种形式邻接矩阵的GTFTS模型表现最佳。仅使用单一邻接矩阵的三个变体(D-GTFTS、C-GTFTS 和 M-GTFTS)的误差明显高于GTFTS模型。这一结果表明,单一类型的图邻接矩阵无法充分反映工业数据中过程变量之间复杂的空间耦合关系。工业过程通常具有高度非线性和强耦合特性,因此融合多种图关系能够更好地建模变量之间的空间依赖性。DC-GTFTS模型结合了基于距离的图和基于相关性的图,其性能优于任何单一模型,但仍不及GTFTS模型。一种潜在的解释是互信息图包含了一些主蒸汽流预测的独特数据特征。因此,可以认为过程变量的多重关系能够生成不同的图结构。将多种图结构融合到双流网络中,可以为工业过程中的关键性能指标提供更准确的预测。
表3 不同图结构模型预测性能对比
3.5 图结构可视化
本章可视化了不同邻接矩阵的图结构,并利用训练损失研究它们的收敛性。为了简化分析,本章以时间域流为例,探讨不同图结构的性能。如图5所示,通过比较这四个热图,发现融合图结构在距离图、相关性图和互信息图的基础上得到了显著提升。为方便比较,使用两个红框作为例子来对比不同邻接矩阵的差异。根据图5(a)的第一个红框,变量 (CO)和变量 (HCl)在距离图结构中具有强耦合关系。相反,在图 5(b)和(c)中, 与 之间没有连接关系。实际的工业机理表明,CO与HCl之间不存在物理和化学反应,导致两者的依赖性较弱。上述结果表明,距离图在描述变量间依赖性方面存在偏差,而相关性图和互信息图则能够更好地反映实际生产情况。如图5(d)所示,融合图模型综合考虑了三种图结构。类似地,在图5(a)至(d)的大框中,融合图基于少数服从多数的原则,结合了三种图结构的优点。不同图结构的变化源于这三种度量方法的差异。实际上,没有一种精确的度量方法能够计算出最优图结构。考虑到这一点,融合图能够全面代表过程变量之间的相互依赖关系。此外,图5(e)展示了不同图结构的训练损失曲线。显然,融合图的损失最小,这进一步验证了多图学习层的有效性。
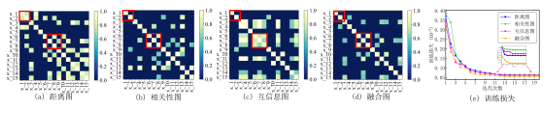
图5 不同图结构可视化及收敛性分析
3.6 TFTS中窗函数分析
频谱泄漏是信号处理过程中常见的现象。为了减少频域测量中的频谱泄漏,窗函数被广泛应用于解决信号进行傅里叶变换时的频谱泄漏问题。为此,表4对四种窗函数的性能进行了分析和比较,包括矩形窗、三角窗、高斯窗和汉宁窗。可以观察到,在短时傅里叶变换中采用不同类型的窗函数时,预测结果存在显著差异。从表4中可以看出,汉宁窗表现出最佳性能,说明其在消除频谱泄漏方面具有较强的能力。汉宁窗的主瓣宽度较小,生成的谱图比其他窗函数更为清晰。相反,矩形窗的缺点在于旁瓣较大,因此容易受到高频干扰和泄漏的影响。虽然三角窗和高斯窗的表现优于矩形窗,但仍然不及汉宁窗。基于上述分析,在GTFTS模型中采用汉宁窗,以有效减少短时傅里叶变换(STFT)的频谱泄漏。
表4 TFTS中不同窗函数下的预测性能对比
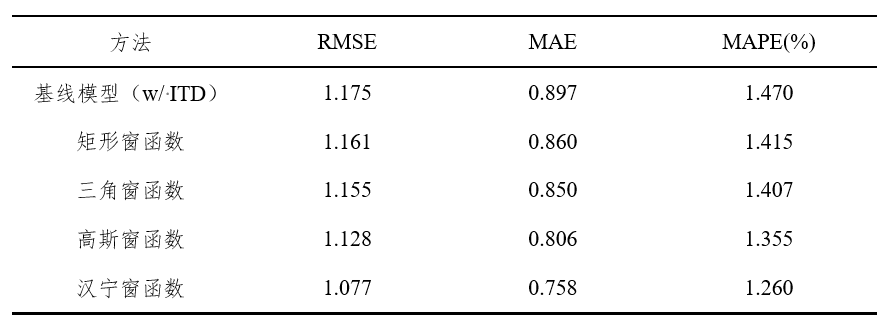
此外,本章还选择 w/ ITD(两个相同的时间域流)作为基准模型,以分析频谱泄漏的影响。结果表明不同窗函数的时频双流网络均取得了优越的性能。其原因在于,时间域流可以提取出大部分有用信息,而频域流则旨在提供互补的频域特征。上述实验结果进一步揭示了STFT对于时间-频率融合方法的有效性和可行性,促使GTFTS模型在多步预测任务中超越了时间域建模方法。
3.7 超参数分析
图6讨论了关键超参数对模型预测性能的影响。从图6(a)中可以观察到,Adam优化器的准确率高于SGD和AdaGrad方法。SGD算法通常会遇到梯度消失或爆炸的问题,而AdaGrad则容易产生早熟现象。因此,基于这些观察,选择Adam作为GTFTS模型的优化器。如图6(b)所示,当图注意层的数量设置为2时,GTFTS模型获得了最小的预测误差。这主要是由于图网络具有较强的表达能力,过多的层数可能导致过平滑现象。在邻居节点特征的多次聚合后,所有节点特征变得相似,从而无法有效区分。一般来说,图注意层的数量应不超过3层。此外,如图6(c)所示,随着隐藏神经元数量的增加,GTFTS的均方根误差(RMSE)先下降后上升,最佳神经元个数设置为20。隐藏神经元的数量代表了网络的宽度,确保每一层能够学习到丰富的特征。如果宽度过窄,网络将无法充分捕捉隐藏信息,限制其性能;而过宽的网络可能会提取许多重复特征,并增加计算负担。隐藏神经元的数量通常应小于输入层的两倍。在图6(d)中可以看到,当潜在空间的维度设置为30时,模型误差达到最小。邻接矩阵的阈值在图学习中起着重要作用,它决定了过程变量之间的连接性。适当的阈值能够过滤掉弱相关变量之间的连接,而过于稠密的邻接矩阵可能会引入无关的连接边。在图6(e)中,通过范围 [0.4, 0.5, 0.6, 0.7, 0.8] 内的调试,适度增大阈值有助于模型的训练,但阈值过大则会导致图结构的不完整。阈值过小则可能增加邻接矩阵的密度,从而引发过拟合问题。最后,图6(f)研究了学习率的影响,理想的学习率为0.001。学习率控制着模型更新权重参数时的收敛速度。过小的学习率会增加模型训练时间,并使模型陷入局部最优解;而过大的学习率则会导致参数更新过快,从而引发训练不稳定。
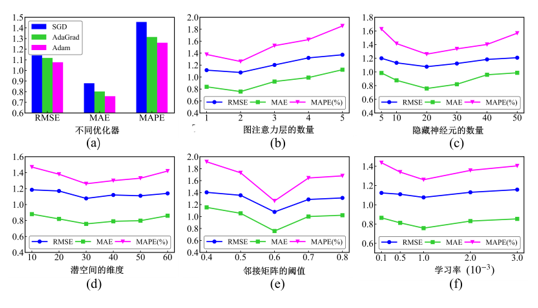
图6 不同超参数的灵敏性分析
4 总结
文章提出了一种时间-频率双流网络,以实现工业过程中关键指标的多步预测。首先,开发了一种多图注意层(multi-GAT),用于捕捉不同过程变量之间的动态空间相关性。同时,提出了一种双流网络,分别学习时间域和频率域特征。此外,提出了一种特征融合方法,将时间和频率特征融合应用于下游的多步预测任务。最后,在两个工业案例中验证了所提方法的有效性和可行性。
编辑:Tina
校核:李正平、陈凯歌、曹希铭、赵学功、白亮、任超、海洋、陈宇航、陈莹洁、赵栓栓、王金、赵诚、肖鑫鑫、张优
该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除


