
中科院1区论文推荐 | 工业大小模型协同框架CoLLM
近年来,大型模型(LMs)在各种工业应用中展现出革命性的进展,包括异常检测、任务规划和预测性维护。然而,由于计算成本高和输出不可靠的问题,其工业部署仍然面临挑战。
小模型面对单一任务单一来源数据具备良好的预测能力和较低的计算成本,但泛化性不足。如何结合两者的优点进行协作成为了学界和工程界的热点。
北航团队于IEEE Transactions on Fuzzy Systems提出了CoLLM,一种样本级工业大小模型协同框架。能够在样本级别实现细粒度的大小模型动态决策,降低了计算成本,提高了预测可靠性。
论文基本信息
论文题目:CoLLM: Industrial Large-SmallModel Collaborationwith FuzzyDecision-makingAgent and Self-Reflection
论文期刊:IEEE TRANSACTIONS ON FUZZY SYSTEMS
论文日期:2025
论文链接:https://ieeexplore.ieee.org/document/11104131
作者:HaitengWang (Graduate StudentMember, IEEE) , Lei Ren(SeniorMember, IEEE), Tuo Zhao, Lu Jia
通讯作者邮箱:
renlei@buaa.edu.cn
作者简介:
王海腾为本文第一作者,北京航空航天大学三年级博士生,首批国家自然科学基金青年学生基础研究项目负责人,入选首批中国科协青年人才托举工程博士生专项,从事工业大模型与AIGC研究。
任磊教授为本文通讯作者, 国家杰青、国家重点研发计划工业软件专项首席科学家、复杂产品智能制造系统技术全国重点实验室专委会副主任。从事工业互联网与工业软件、工业人工智能与工业大模型相关研究。
赵拓,北京航空航天大学二年级硕士生,从事工业大模型与动态神经网络研究
焦璐,北京航空航天大学一年级硕士生,从事工业大模型与工业时间序列分析研究
目录
摘要
1 问题背景
2 CoLLM整体架构
2.1 工业大小模型协同框架
2.2 模糊决策智能体
2.3 自我反思机制
3 实验
3.1 对比实验
3.2 消融实验
3.3 置信度实验
4 结论
摘要
在工业应用中,大型模型已经展现出优于较小模型的泛化能力,这是较小模型无法达到的。然而,在面对边缘场景和高度多样化的工业样本时,由于其高昂的计算成本和不可靠的输出,这些大型模型的部署仍然具有挑战性为了克服这些挑战,我们提出COLLM,这是一个模糊的。大型-小型模型协作框架,可以根据样本展示的特征动态地在小型和大型模型之间进行选择。具体来说,这种方法通过估计输入样本的不确定性来指导模型选择:低不确定性的样本由小型模型处理以提高效率,而高不确定性或复杂的样本则被路由到大型模型以获得更高的准确性。首先,它基于模糊神经网络(FNN)构建一个模决策代理,以评估样本复杂性并确定合适的推理模型。此外,还提出了一种自我反思机制来优化大型模型的输出,从而降低产生不可靠输出的风险。工业时间序列数据集的实验结果证明,我们的框架在维持或提高预测准确性的同时,将大型模型的计算效率提高了多达14.54倍。
关键词:基础模型、工业大模型、大语言模型:(LLM)、工业时间序列、专家混合模型(MoE)。
1 问题背景
小模型面对单一任务单一来源数据具备良好的预测能力和较低的计算成本,但泛化性不足。大模型具备强大的泛化能力和多任务处理的优势,但其高昂的计算成本和输出不可靠性限制了工业实际部署。如何结合两者的优点进行协作决策是学界和工程界的热点。
最近,研究人员探索了利用大小模型协作推理策略。一些研究采用任务级协作策略将查询输入分配给不同的专家模型进行处理,提高决策精度。然而现有的协同推理框架方法面对以下问题:
工业结构化数据难度评估:现有方法主要针对自然语言处理任务,基于离散语义单元(如语义相似度、主题分布)进行难度评估。但工业应用多涉及连续型时序数据(如传感器信号、工艺参数曲线),其动态变化与模糊边界使得复杂性难以准确评估,导致大小模型之间的资源分配效率低下。
工业大小模型纠错机制:大多模型路由方法默认大模型在所有样本优于小模型,但这一假设在工业应用中并不成立。小模型往往更擅长捕捉局部特征,而大模型由于过度参数化,反而可能在部分场景中产生严重偏差甚至灾难性错误。同时,当前协同框架普遍缺乏针对单个样本的动态纠错机制,使得大模型在低置信度预测时仍可能直接输出结果,从而影响整体可靠性。
2 CoLLM整体架构
为应对上述挑战,我们提出了一种工业大小模型协同框架 CoLLM,其目标是在降低计算成本的同时提升大型模型的可靠性。其核心思想在于:工业样本往往呈现多样化特征,不同样本对模型能力的依赖程度并不一致,部分样本更适合由小模型处理,而另一些则需要大模型才能获得更优结果。基于这一现象,我们提出CoLLM,其能够根据样本特征动态选择合适的大模型或小模型,实现自适应协同推理。
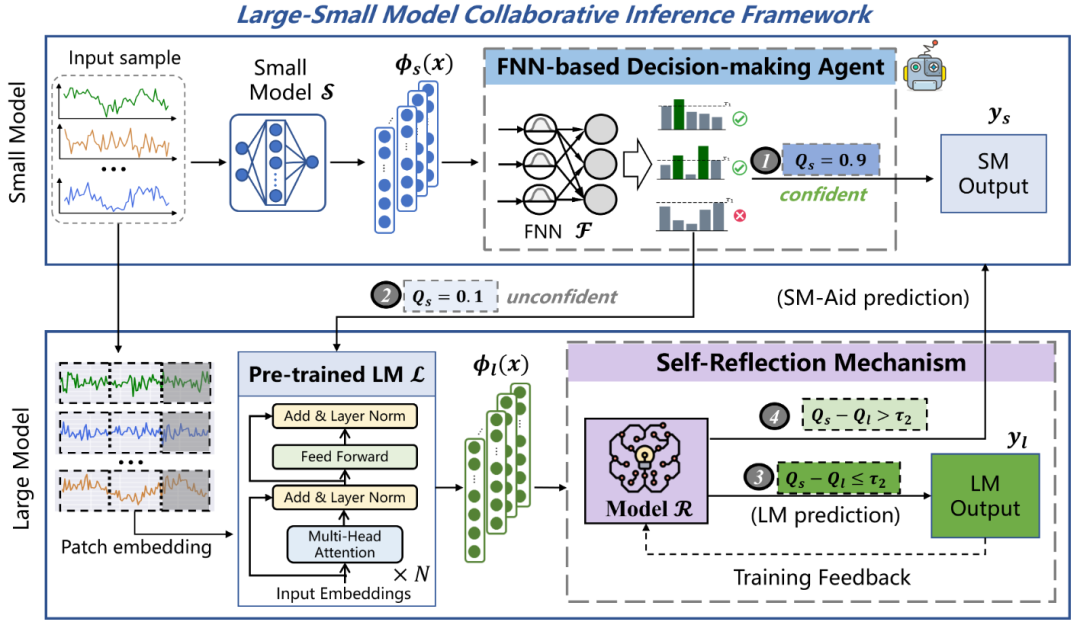
工业大-小模型协同框架
2.1 工业大小模型协同框架
小模型快速推理:在获取到工业系统输出的待处理的时间序列数据时,通过小模型对所述时间序列数据进行特征提取,得到所述时间序列数据的第一特征矩阵。
基于模糊神经网络的决策智能体:为了决定是否调用大型模型,构建了一个基于模糊神经网络(FNN)的模糊决策智能体F。该智能体根据输入样本生成一个置信度评分,若置信度分数低于预设的阈值,则调用大模型推理。
大型模型深度推理和自我反思:引入自我反思机制R,在决定调用大模型预测时,提取出大模型的置信度分数。判断在所述第二置信度分数大于所述第一置信度分数时,将所述大模型基于所述第二特征矩阵得到的推理结果作为目标推理结果;在所述第二置信度分数小于或等于所述第一置信度分数时,通过所述小模型确定所述目标推理结果。
2.2 模糊决策智能体
模糊决策智能体主要利用模糊神经网络(FNN)为小模型生成置信度评分,首先分解小模型生成的特征表示,独立处理每个维度并对每个特征维度d定义一个单独的模糊隶属函数。此外,采用置信度分数策略,判断小模型的置信度分数QS,是否小于阈值[数学公式],以此决定是否使用小模型进行预测。
2.3 自我反思机制
自我反思模型R采用全连接网络(FCN)实现。其输入是大模型提取的潜在时间序列特征矩阵,自我反思模型根据特征表示量化潜在的预测偏差,生成置信度评分Q1,将Q1与Q2的置信度差异与阈值[数学公式]相比,判断是否接受大模型的预测。
在低置信度预测时仍可能直接输出结果,从而影响整体可靠性。
3 实验
3.1 对比实验
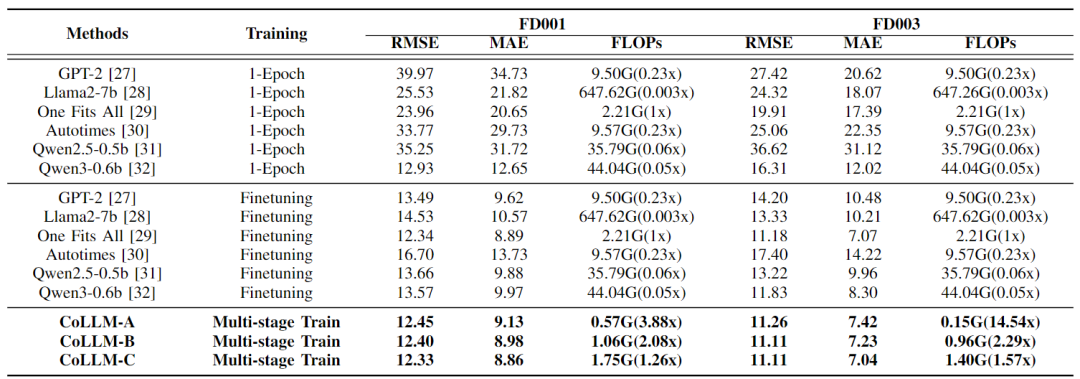
在FD001和FD003数据集上使用了大型模型GPT-2、Llama2-7b和One Fits All进行了实验,实验结果表示尽管性能和数据集存在差异,CoLLM仍能加速计算(最高可达14.54倍),同时可以保持着最小的精度损失,甚至能实现更好的性能。
比如,在FD001数据集上,CoLLM-A实现了RMSE为12.45,MAE为9.13,准确率分别为99.1%和97.3%,同时FLOP减少了3.88倍。CoLLM-C实现了RMSE为12.33,MAE为8.86,准确率分别为100.1%和100.3%,同时FLOP减少了1.26倍。
各方法在FD001和FD003上的比较
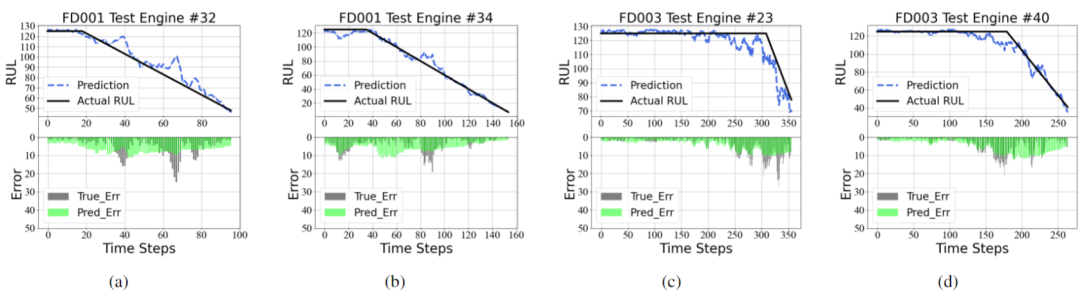
RUL预测结果可视化
3.2 消融实验
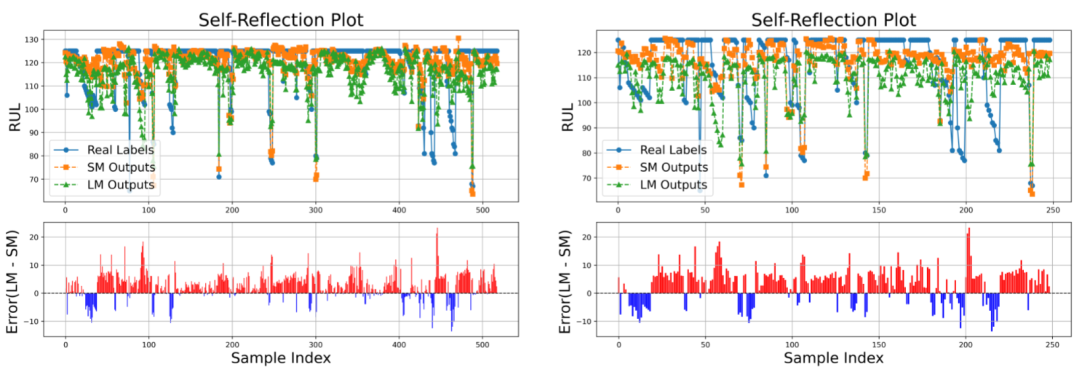
大模型自反思机制可视化
3.3 置信度实验
为了验证模糊决策智能体的有效性,我们对置信度进行了相关实验,可视化结果随着置信度分数的增加,RMSE降低,这表明置信度分数有效地反映了预测RUL与实际RUL之间的差异。这一趋势验证了置信度预测策略在捕捉不确定性方面的有效性。
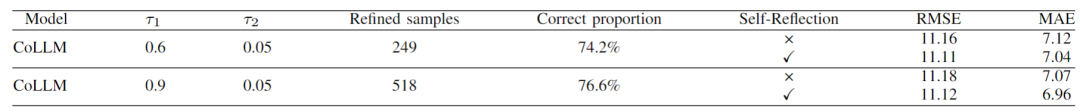
自我反思机制的评估
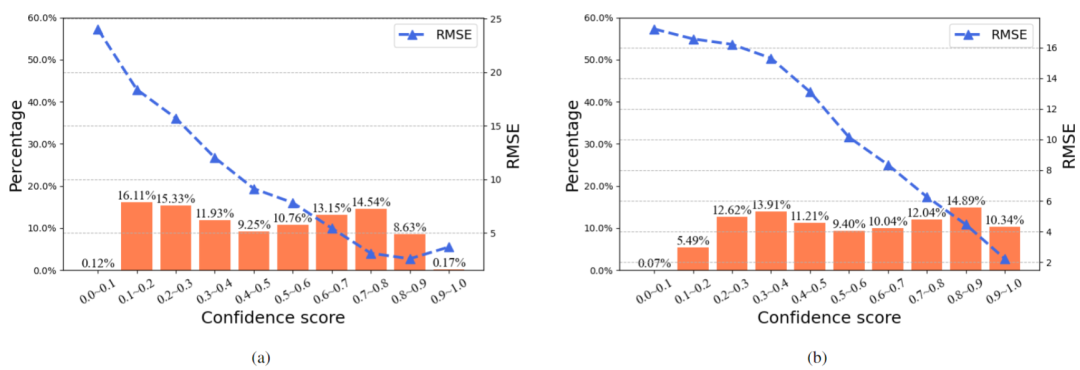
RMSE与置信分数区间内的样本分布
4 结论
本文提出了一种工业大小模型协同框架CoLLM,旨在优化工业大型模型的计算效率和可靠性。通过构建一个模糊决策智能体,该框架根据工业时间序列数据的不确定性量化动态选择大型或小型模型,解决了静态任务级协同的局限性。此外,自反思机制通过将大型模型输出与小型模型校正进行交叉验证,以减轻灾难性错误,提高决策可靠性。实验表明,CoLLM在保持准确性的同时,将大型模型的计算成本降低了90%,为工业大型模型的部署提供了实用解决方案。


