只有蛋白序列,没有三维结构?AlphaFold 3 从预测到 GROMACS 完整实操
大家好,我是刘建川,14 年深耕 GROMACS 分子模拟领域,始终专注分子模拟实战。蛋白结构分析或者分子动力学模拟时,我们经常会遇到一个很现实的问题:手里有目标蛋白的氨基酸序列,却缺少适合当前研究体系直接使用的三维结构。
这时候,AlphaFold Server 可以提供一个很方便的结构预测入口。但实际使用并不是简单的“复 制序列 → 下载模型”。如果一开始选错序列、拷贝数设错,或者生成结构后完全不检查置信度,后面的分析很可能从第一步就出现偏差。
AlphaFold Server :https://alphafoldserver.com/welcome
这篇文章不展开复杂算法,直接通过真实界面完整走一遍:
UniProt 获取序列 → AlphaFold Server 提交任务 → 查看运行状态 → 判断模型质量 → 下载结果 → PyMOL 检查 → GROMACS 前处理
本文以人源 CTCF 蛋白为例,UniProt ID 为 P49711。
需要提前说明的是,CTCF 并不是一个“完全没有实验结构”的蛋白,目前已经存在多个 CTCF 相关实验结构和复合物结构。这里选择它,主要是为了演示从 UniProt 到 AlphaFold Server 的完整操作流程。
科研中如果目标蛋白已经存在适合研究体系的高质量实验结构,建议优先评估实验结构,而不是默认使用 AlphaFold 预测模型。
另外,AlphaFold 给出的是预测结构,不是实验结构,也不是经过分子动力学充分平衡后的结构。一张看起来很漂亮的三维模型,并不代表其中每一个区域都同样可靠。
01|先在 UniProt 确认目标蛋白
进行结构预测的第一步,不是急着打开 AlphaFold,而是先确定一条可靠的氨基酸序列。最常用的蛋白数据库之一就是 UniProt,可以通过蛋白名称、Gene Name 或 UniProt ID 进行搜索。
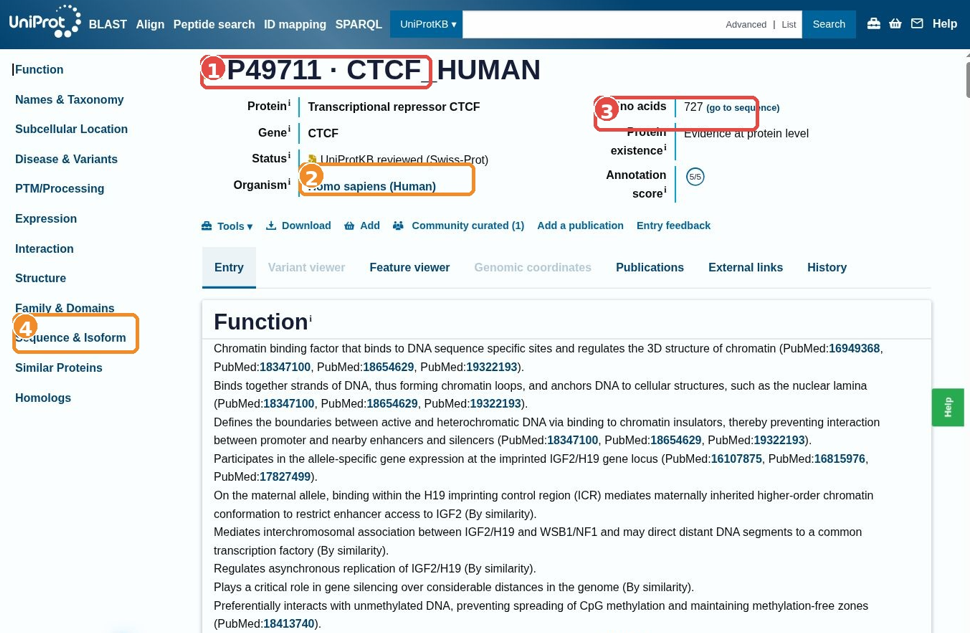
进入目标蛋白页面后,建议至少确认四项信息:蛋白名称、物种、UniProt 条目以及序列长度。
以 CTCF 为例,可以看到条目为:
P49711 · CTCF_HUMAN
物种为 Homo sapiens,蛋白长度为 727 个氨基酸。
这里有一个很容易被忽略的问题:名称相同,并不代表序列一定相同。
不同物种、不同剪接体以及人工构建的突变体,都可能存在明显差异。如果你准备复现论文中的具体体系,还需要结合实验材料和原始文献确认:作者真正使用的到底是哪一个序列版本。
02|复 制完整的氨基酸序列
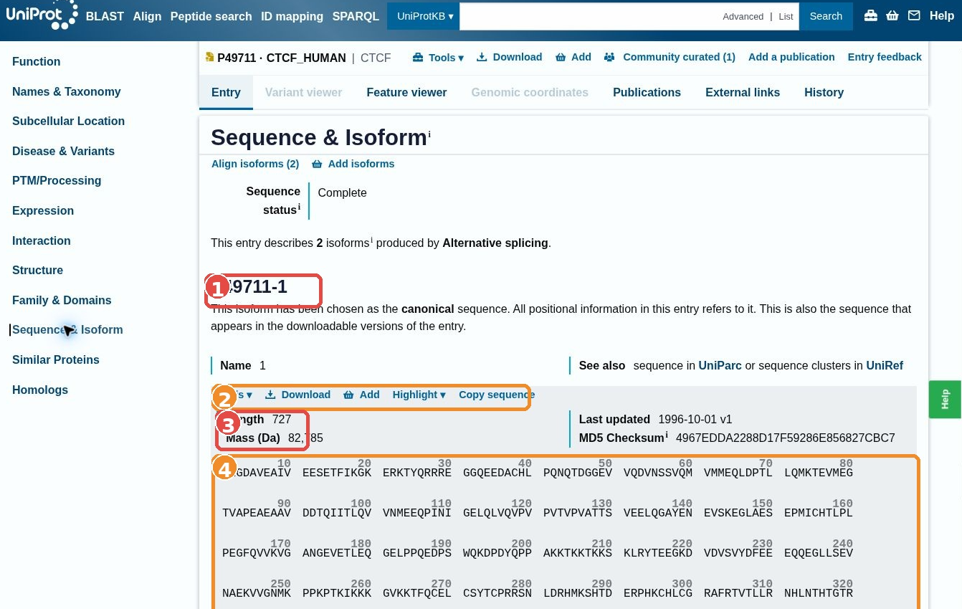
进入 Sequence & Isoform 后,先看这个蛋白是否存在多个 isoform。
UniProt 通常会标记 canonical sequence,也就是当前条目默认采用的标准序列。本例中,P49711-1 为 canonical sequence,长度 727 aa。
确认后,可以点击 Copy sequence 复 制完整氨基酸序列。
如果你的研究对象是突变体、截短体或者人工设计序列,不要直接复 制数据库完整序列,而应该根据真实实验体系进行修改。
为了减少复 制过程中混入异常字符,也可以保存成 FASTA 格式。格式示例如下:
>CTCF_HUMAN_P49711
MEGDAVEAIVEESETFIKGKERKTYQRRREGGQEEDACHLPQNQTDGGEVVQDVNSSVQMVMMEQLDPTLLQMKTEVMEGTVAPEAEAAVDDTQIITLQVVNMEEQPINIGELQLVQVPVPVTVPVATTSVEELQGAYENEVSKEGLAESEPMICHTLPLPEGFQVVKVGANGEVETLEQGELPPQEDPSWQKDPDYQPPAKKTKKTKKSKLRYTEEGKDVDVSVYDFEEEQQEGLLSEVNAEKVVGNMKPPKPTKIKKKGVKKTFQCELCSYTCPRRSNLDRHMKSHTDERPHKCHLCGRAFRTVTLLRNHLNTHTGTRPHKCPDCDMAFVTSGELVRHRRYKHTHEKPFKCSMCDYASVEVSKLKRHIRSHTGERPFQCSLCSYASRDTYKLKRHMRTHSGEKPYECYICHARFTQSGTMKMHILQKHTENVAKFHCPHCDTVIARKSDLGVHLRKQHSYIEQGKKCRYCDAVFHERYALIQHQKSHKNEKRFKCDQCDYACRQERHMIMHKRTHTGEKPYACSHCDKTFRQKQLLDMHFKRYHDPNFVPAAFVCSKCGKTFTRRNTMARHADNCAGPDGVEGENGGETKKSKRGRKRKMRSKKEDSSDSENAEPDLDDNEDEEEPAVEIEPEPEPQPVTPAPPPAKKRRGRPPGRTNQPKQNQPTAIIQVEDQNTGAIENIIVEVKKEPDAEPAEGEEEEAQPAATDAPNGDLTPEMILSMMDR
03|在 AlphaFold Server 建立预测任务
进入 AlphaFold Server 后,新建一个预测任务。对于普通单链蛋白,可以先按照下面的方式设置:
Entity type:Protein
Copies:1
Sequence:粘贴完整氨基酸序列
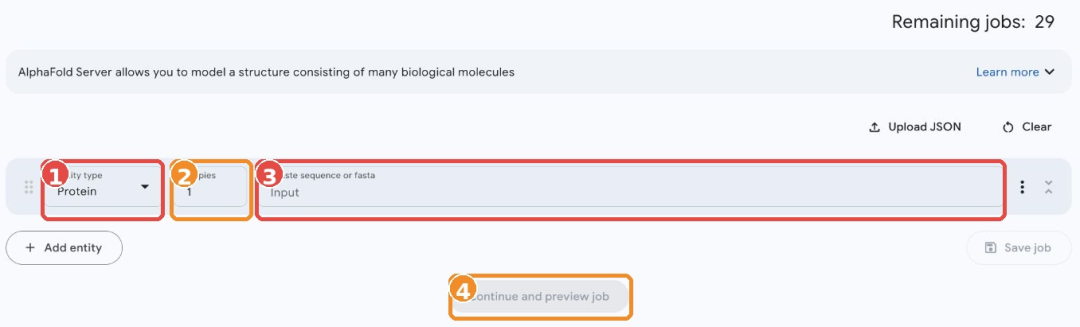
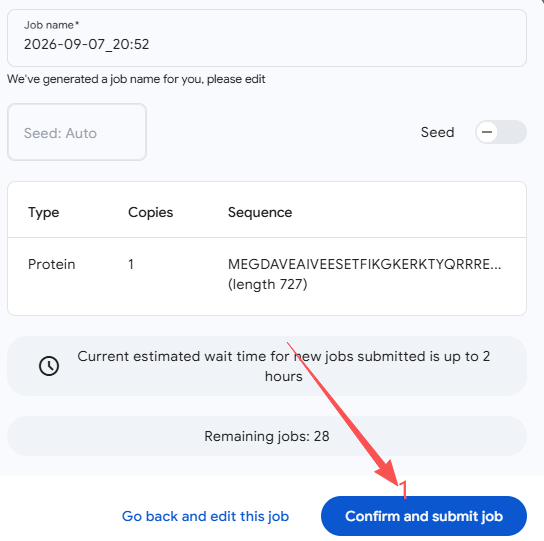
Copies 表示这个体系中相同分子的拷贝数。研究单体蛋白时通常设置为 1;如果你的真实研究对象明确是同源二聚体、三聚体或者更高聚体,才需要相应增加 Copies。
如果是蛋白-蛋白复合物,则应该分别添加不同蛋白;蛋白-DNA、蛋白-RNA、蛋白-离子等体系,也应该按照真实体系组成进行设置。
不要为了“试试看能不能形成复合物”或者为了追求更高评分,就随意增加 Copies。
体系设置首先应该服从真实的生物学和实验背景,而不是服从预测结果。
预览任务时,也建议设置一个容易识别的名称,例如:
CTCF_monomer
ProteinA_ProteinB_complex
ProteinA_DNA_complex
服务器支持的分子类型、任务额度及使用规则可能发生变化,因此正式提交时应以 AlphaFold Server 当前页面显示的信息为准。
另外需要特别注意:AlphaFold Server 当前有自己的使用条款,其 Server 输出不能直接用于 docking 或 screening tools。因此本文重点讨论结构预测、结构检查以及后续分子动力学前处理,不把 AlphaFold Server 输出直接用于分子对接流程。
04|提交后在哪里看运行状态?
任务提交完成后,可以在 History 中查看运行状态。
页面通常可以根据 Completed、Saved draft、In progress、Examples 和 Failed 等状态进行筛选。
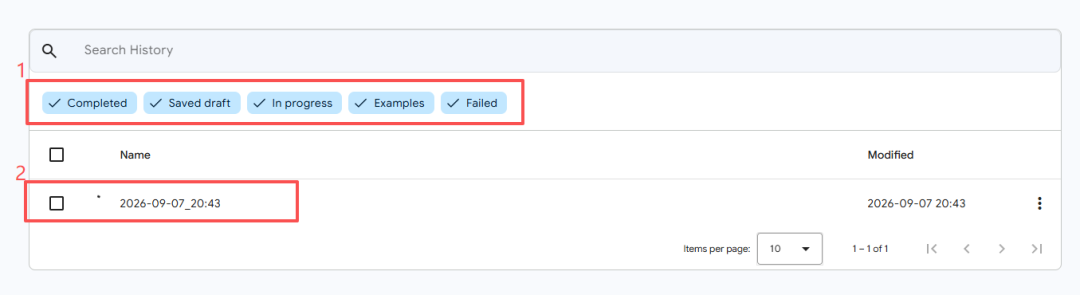
任务耗时会受到体系大小和服务器负载等因素影响,一般没有必要一直刷新。
如果任务失败,建议首先查看页面给出的错误提示,再判断问题来自序列字符、输入格式、体系大小还是服务器端临时异常,不要一看到 Failed 就重新乱改参数提交。
05|结果出来后,千万别只看三维结构
这是整篇教程中非常重要的一步。
很多初学者看到模型成功生成,第一反应就是:结构已经有了,直接下载。
但真正决定这个模型能不能继续用于分析的,是它的置信度信息。
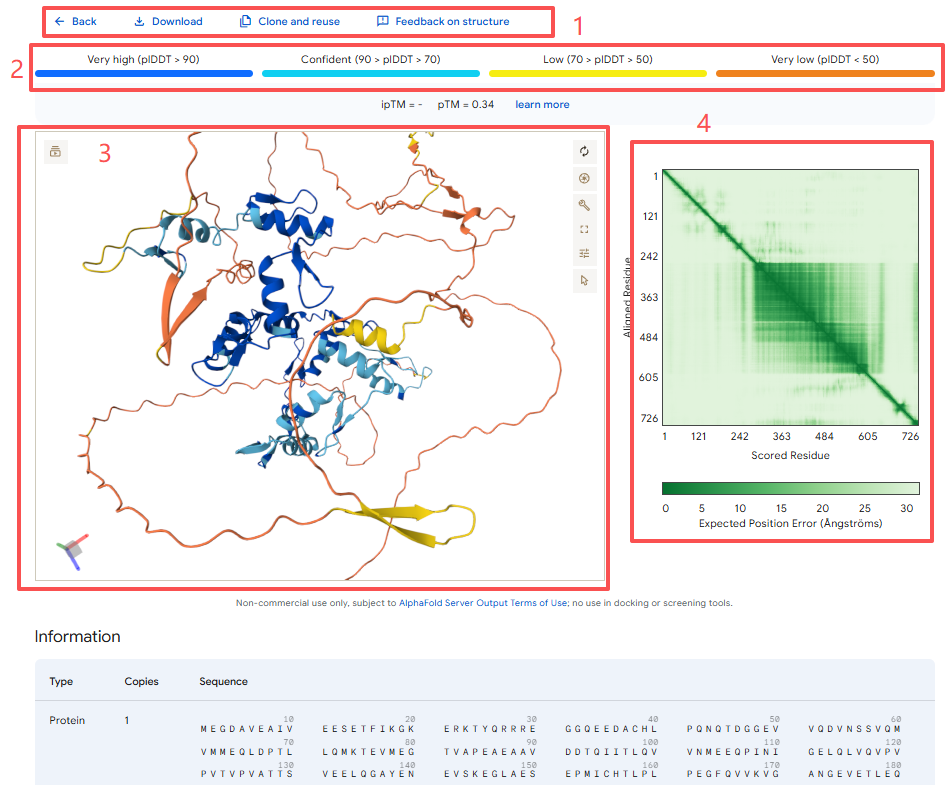
pLDDT:看局部结构是否可靠
pLDDT 是 AlphaFold 提供的局部结构置信度指标,范围为 0–100,数值越高通常说明模型对该位置越有信心。
需要注意的是,AlphaFold 3 中的 pLDDT 已经细化到了原子级,而不能简单理解成每个氨基酸只有一个固定分数。
对于普通蛋白质区域,仍然可以使用下面这套经验区间进行快速判断:
pLDDT > 90      很高置信度
pLDDT 70–90     较高置信度
pLDDT 50–70     低置信度,需要谨慎
pLDDT < 50      很低置信度
蛋白末端、长 loop 或天然无序区域出现低 pLDDT 并不少见。低分并不一定说明“AlphaFold 算错了”,更常见的含义是:这个区域本身可能高度柔性,或者模型无法唯一确定它的稳定构象。
因此,不能把低置信度区域和高置信度结构域放在同一个层级进行精细结构解释。
pTM 与 ipTM:看整体结构和复合物界面
pTM 更偏向反映整个模型的整体拓扑以及不同结构域相对排布的可信程度。
有时候会出现一种情况:每个结构域内部的 pLDDT 都很高,但两个结构域之间的相对方向并不确定。这种情况下,只看局部 pLDDT 就容易误判。
对于多链复合物,还应该重点关注 ipTM。它更侧重不同链或不同分子之间相互作用界面的可信度。
作为一个快速参考,可以记住:
pTM > 0.5
整体折叠更有可能与真实结构相似

ipTM > 0.8
复合物界面通常具有较高可信度

ipTM 0.6–0.8
属于灰色 区域,需要结合其他证据

ipTM < 0.6
需要高度谨慎
注意:这些只是经验参考,不是“超过某个数字就证明结构真实”。尤其对于复合物,最好结合实验信息、已知界面残基和其他结构证据一起判断。
PAE:不是接触图,也不是距离矩阵
PAE 全称为 Predicted Aligned Error。
它描述的是模型对于不同结构单元之间相对位置和方向的不确定程度。对于普通蛋白质,可以近似理解为不同残基之间相对位置的预测误差。
如果一个蛋白中,每个结构域内部都是低 PAE,而不同结构域之间 PAE 很高,常见解释就是:
模型很确定每个结构域自身长什么样,但并不确定这些结构域之间应该如何排列。
对于 AlphaFold 3 的蛋白-DNA、蛋白-RNA或其他复杂体系,则不要简单把 PAE 图两个坐标轴全部理解成“氨基酸残基”。
06|为什么有时看不到三维模型?
AlphaFold Server 的在线三维结构查看依赖浏览器图形功能。如果 WebGL 无法 正常工作、硬件加速被关闭,或者显卡驱动存在异常,结果页可能出现三维模型加载失败的情况。
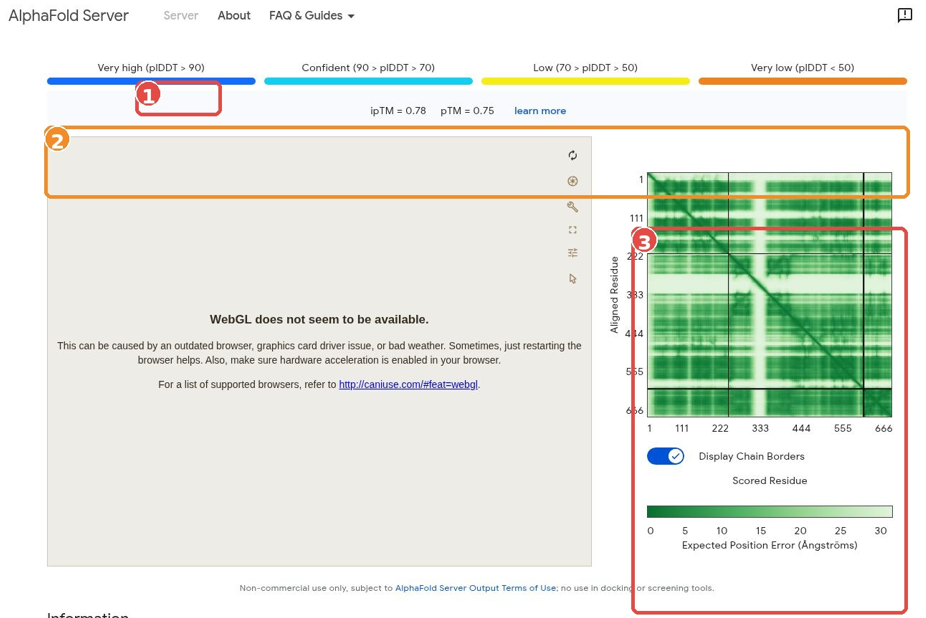
遇到这种情况,可以尝试更换 Chrome 或 Edge 浏览器、打开浏览器硬件加速,并重新启动浏览器。
即使网页端暂时无法 正常显示三维模型,只要结果文件已经成功生成并可以下载,后续仍然可以使用 PyMOL 或 ChimeraX 打开结构。
07|下载时哪些文件值得保留?
确认预测结果具有进一步分析价值后,可以点击结果页中的 Download。
下载包中通常会包含预测结构以及多种置信度相关数据。建议至少保留下面这些文件:
*.cif
预测结构坐标

*_summary_confidences.json
pTM、ipTM 等汇总置信度指标

*_full_data.json
更完整的置信度与预测数据

*_job_request.json
本次任务的原始输入信息
不要只留下一个 CIF,然后把其余文件全部删除。
后面写论文、整理补充材料,或者重新分析某个界面时,JSON 文件里的置信度信息往往非常有价值。
另外,AlphaFold Server 并不是简单只计算一个结构。一次任务内部可能生成多个预测样本,网页优先展示排名较高的结果,而完整下载包则保留更多模型和评分信息。
所以遇到复杂体系时,不要只因为排名第一的模型“看起来最好看”,就完全忽略其他预测结果。
08|下载后的 CIF 怎么用 PyMOL 打开?
AlphaFold Server 下载的结构通常为 CIF/mmCIF 格式,PyMOL 可以直接读取。
最基础的操作可以这样写:
load model.cif, af_model
hide everything
show cartoon, polymer.protein
bg_color white
orient
如果是多链复合物,可以根据链进行着色:
color cyan, chain A
color yellow, chain B
如果体系中还有有机小分子,也可以单独显示:
show sticks, organic
准备论文配图时,可以进一步提高渲染分辨率:
set ray_opaque_background, off
ray 2400, 1800
png alphafold_structure.png
如果后面准备进入 GROMACS,还可以在检查完结构后导出 PDB:
save model_for_gromacs.pdb, af_model
但要特别注意:从 CIF 保存为 PDB 绝不是简单“换一个扩展名”。导出后仍然应该重新检查 chain ID、残基编号、原子名称、金属离子、配体和非标准残基是否完整保留。
09|AlphaFold 结构能不能直接拿去做 GROMACS?
可以把 AlphaFold 预测结果作为分子动力学的初始结构来源之一,但不建议下载之后不做任何检查,就直接开始 pdb2gmx。
比较稳妥的流程应该是:
AlphaFold 下载 CIF → PyMOL/ChimeraX 检查 → 转换并整理 PDB → 检查结构与置信度 → 处理特殊组分 → pdb2gmx → 体系构建 → EM → NVT → NPT → Production MD
至少还要检查下面几个问题。
① 低置信度区域到底要不要保留?
一段连续的低 pLDDT 区域,可能对应柔性末端、天然无序区域,也可能是因为真实体系中缺少了某些能够稳定它的结合伙伴。
因此,处理低置信度区域不能简单采用:
pLDDT低 → 全部删除
应该结合蛋白功能、实验信息和研究目的综合判断。
② 质子化状态是否合理?
AlphaFold 解决的是结构预测问题,并不会替你完整解决特定 pH 环境下的质子化状态。
后续进行分子动力学时,尤其要注意 His、Asp、Glu、Lys 以及活性中心附近残基的质子化状态。
③ 配体和非标准残基有没有参数?
预测模型中即使出现了配体,也不代表它已经自动拥有 GROMACS 可以直接使用的拓扑、电荷和力场参数。
小分子、辅因子以及非标准残基通常还需要单独参数化,并确认与所选蛋白力场兼容。
④ 复合物界面到底可不可信?
对于多链体系,不能只看三维模型“贴得很紧”。
至少应该结合 ipTM、PAE、已知界面残基、实验数据和已有结构信息进行判断。
⑤ CTCF 还有一个特别重要的问题:Zn²⁺
本文采用的 CTCF 并不是一个普通蛋白。
CTCF 含有 11 个 C2H2 型锌指结构域,Zn²⁺ 对这些结构域的稳定非常重要。
因此,如果你后续真的准备对 CTCF 进行分子动力学模拟,就不能只做:
预测结构
↓
pdb2gmx
↓
直接模拟
还需要结合实验结构和具体研究体系,确认 Zn²⁺ 是否存在、数量是否正确、配位残基是否合理,以及应该采用怎样的金属离子参数化方法。
对于金属蛋白,随手删除 Zn²⁺ 后直接进行常规蛋白模拟,很可能导致原本稳定的锌指结构在模拟中失去正确构象。
因此,对于 CTCF 这样的体系,一个更完整的思路应该是:
确认序列与体系
↓
AlphaFold结构预测
↓
检查pLDDT / pTM / ipTM / PAE
↓
与已有实验结构进行对照
↓
检查Zn²⁺及配位环境
↓
处理质子化状态
↓
处理非标准组分
↓
转换和整理PDB
↓
pdb2gmx与体系构建
↓
能量最小化
↓
NVT / NPT平衡
↓
生产期分子动力学
AlphaFold 3 真正有价值的地方,并不只是快速生成一张漂亮的三维结构图,而是为缺乏合适实验结构的研究体系提供一个可以继续检查、验证和优化的结构起点。
第一次使用时,可以把整个流程记成五件事:
选对序列 → 设对体系 → 检查评分 → 保存完整结果 → 做好模拟前处理
尤其需要记住一点:
AlphaFold 的预测结束,并不意味着分子模拟的结构准备已经结束。
只有把结构来源、置信度、特殊残基、金属离子、质子化状态和力场参数都检查清楚,后面的 PyMOL 结构分析以及 GROMACS 分子动力学模拟才真正具有意义。