迁到麒麟后,那200个__try全失效了
去年冬天,一家做工业软件的客户把跑了十二年的Windows桌面程序搬到麒麟上。
前期改宏、替换API,好不容易把编译报错全部清掉,程序编译通过、启动正常,界面流畅得让人以为事情成了。然后测试同事导入了一份客户的STEP模型 —— 整个进程直接消失,日志最后一行停在 “开始读取几何”。
没有弹窗,没有错误码,没有core dump。
工程师第一反应是环境问题,第二反应是驱动版本,第三反应是 “是不是这颗国产CPU的锅”。查了两周,真相很朴素:
原来Windows上大量用来捕获异常的 `__try/__except` 是MSVC专属扩展,Linux/GCC工具链根本不支持。移植的时候为了编译通过,前人加了条件编译,把这两百多处异常捕获代码整块注释/宏屏蔽掉了,编译器不会告警。STEP解析里那一处几何报错,原本会被`__except`接住、输出错误信息、优雅降级;现在异常直接穿透,进程无声崩溃。
这件事的本质从来不是简单的代码移植,是“错误处理契约的移植”。而契约这种东西,不会写在需求文档里,只会在出事的那一秒,才显形。🙂
一、先把话说准:__try抓的不是异常
很多人把 __try/__except当成try/catch的方言。不是一回事。
try/catch抓的是throw出来的C++异常,本质是"我主动报告一个错误",走的是栈展开。
__try/__except抓的是SEH——CPU和操作系统告诉进程"你已经违规了":访问了不属于你的地址、整数除以零、栈踩穿保护页、执行了非法指令、内存页读不进来。
它抓的是硬件层面的现场,不是语言层面的协议。这也解释了为什么很多老代码用它来兜住第三方模块——因为第三方SDK崩起来,catch是接不住的。
到了Linux系国产系统,对应的是信号:
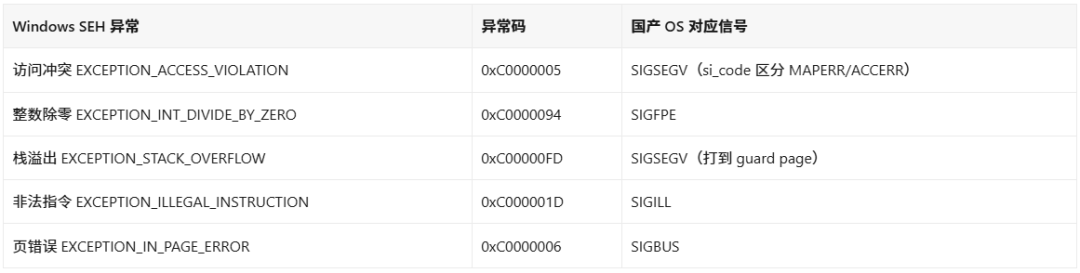
看着能一一对应,其实埋着一个根本性差别:Windows的SEH允许你在 __except里返回EXCEPTION_EXECUTE_HANDLER,处理完继续往下跑,这是一个明确定义的"可恢复"语义。而POSIX信号机制从设计之初,就不是为了让你恢复执行的。
这是整个迁移里最容易被低估的一句话。⚠️
二、"照着signal写一遍"为什么一定翻车
我们见过太多项目在这里栽第二次。四个坑,一个比一个深。
坑一:默认动作是杀进程。不装handler就是SIG_DFL,进程直接没。装了也不代表安全,见下一条。
坑二:handler返回,等于重新执行那条故障指令。这是Linux与 Windows 最要命的行为差异。signal处理函数return之后,CPU会回到出错的那条指令继续执行——于是同一个错误再来一次,无限循环。想跳出这个循环,只能用 siglongjmp 跳走。
坑三:栈溢出的时候,你没有栈。 报错发生在栈上,handler也要用栈。必须sigaltstack 建一块独立栈+SA_ONSTACK标志,否则你连崩溃日志都打不出来。
坑四:跳出去之后,堆是脏的。这一条最贵。如果崩溃发生在 malloc/free内部,堆的锁可能永远不释放;C++对象析构不会执行;文件句柄、共享内存、图形上下文全部泄漏。程序看着还活着,下一次分配就死锁。另外 siglongjmp必须配 sigsetjmp(buf, 1),savemask传0的话信号掩码会残留,SIGSEGV被永久屏蔽——这种bug排查起来极其折磨。
还有一个国产平台特有的坑,很多团队根本没想到:SIGBUS。飞腾、龙芯上,非对齐访问、mmap的文件被截断后继续读、设备内存访问越界,都可能给你一个SIGBUS。而Windows代码里几乎没有处理SIGBUS的肌肉记忆。迁移后那些"偶发崩溃、现场复现不了"的问题,一大半来自这里。
三、我们最后怎么做的:不追求"恢复",追求"隔离"
在方案定下来之前,我们先跟客户对齐了一句话:SEH的"恢复并继续"语义,在Linux上不应该被复刻。
原因很实在:恢复的前提是"我知道现场还能不能用",而堆和锁的状态你其实不知道。硬复刻的结果是把一次明确的崩溃,换成一次隐蔽的数据错乱——后者更难查。
所以目标改成:一个模块崩了,整个软件还能活,用户的活儿不丢。 分三层落地。
L1 源码兼容层:把异常降级成错误码
定义一组IFD_TRY / IFD_EXCEPT/IFD_FINALLY 宏,内部用 sigaltstack+sigsetjmp建立保护区,用siginfo_t拿到地址和错误类型,再按映射表翻译成内部错误码。__finally用GCC/Clang的 __attribute__((cleanup)) 或者RAII作用域守卫替代——这一条在国产工具链上完全可用,而且比手写goto干净得多。
业务逻辑一行没改,__try 是按清单逐条处理的:哪些是真的在防第三方崩溃、哪些只是历史包袱。两百多处里,最后真正需要保留的不到一半。
L2 进程隔离层:进程级的 "__except"
对不可控的第三方SDK,信号层再稳也不敢赌。做法是worker进程 +共享内存+超时回收:父进程发任务、waitpid等结果,子进程崩了父进程只收到一个退出码,重启一个就是。
这里有个细节要注意:多线程进程fork之后,子进程只剩调用线程,父进程里其他线程持有的锁在子进程里永远锁着。所以我们的做法是 fork前预分配好内存、子进程里只做纯计算,或者干脆用常驻worker+IPC。
代价是每次隔离调用多几十毫秒,收益是堆坏了也伤不到主进程。对一个要跑几小时网格的软件来说,这笔账很划算。
L3 可观测层:让崩溃留痕
handler 里只允许做 async-signal-safe 的事:write到预先打开的管道、用预分配的buffer抓frame pointer快照,绝不能在handler里 malloc、printf、调日志库。栈的符号化、聚类、复现,全部放到事后离线做。
改造完最直接的变化是:原来"偶发、无痕",现在每次崩溃都有栈、有输入文件特征、有可聚类的指纹。能复现的问题,才有资格谈修复。
四、三个反直觉的结论,送给正在排期的你
第一,-fnon-call-exceptions 是个陷阱。GCC确实能打开它,让部分陷入指令走C++异常,网上也有demo跑得通。但它在真实工程里的可靠边界极窄,不要写进生产方案,更不要拿它去说服评审。
第二,别指望MinGW/Wine那套SEH仿真。那套东西是给WindowsABI的 unwind表和personality routine服务的,搬不回Linux原生ABI。成本高,而且同样不解决"堆是脏的"这个问题。
第三,迁移的不是代码,是契约。把"捕获一切硬件异常并继续跑"改成"隔离、上报、可重试",这句话如果立项时没跟业务方谈拢,后面一定要用返工来付账。
五、为什么这类活,最好找做过工业软件的人
优飞迪做了十六年工业软件——从MSC、Cadence这类仿真工具链的授权与咨询,到CAD/CAE上下游的定制开发;也做了多年国产化适配,麒麟、统信,飞腾、鲲鹏、龙芯都落过项目。
我们见过太多"编译通过、验收卡住"的迁移。这类问题不在编译器,在运行时语义;不在功能清单,在崩溃边界。而崩溃边界这种东西,只有真的在产线上陪客户跑过几轮,才知道哪里会疼。
我们现在能提供的,是一条完整的链:迁移前的代码风险扫描(__try 清单、内嵌汇编、第三方库依赖、工具链差异)、异常与崩溃治理方案、国产平台的性能与精度对标、许可与部署,以及迁移之后长期的陪跑。
说白了,我们不是帮你"编译通过",是帮你"敢上线"。