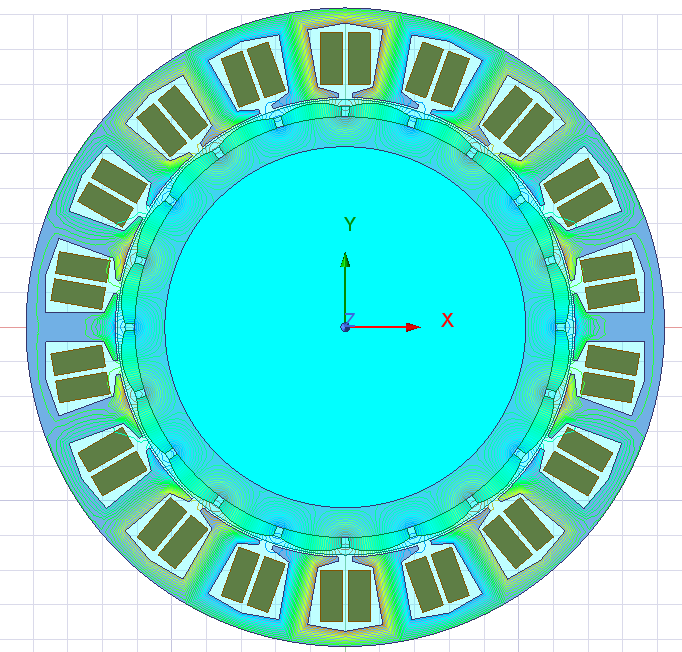
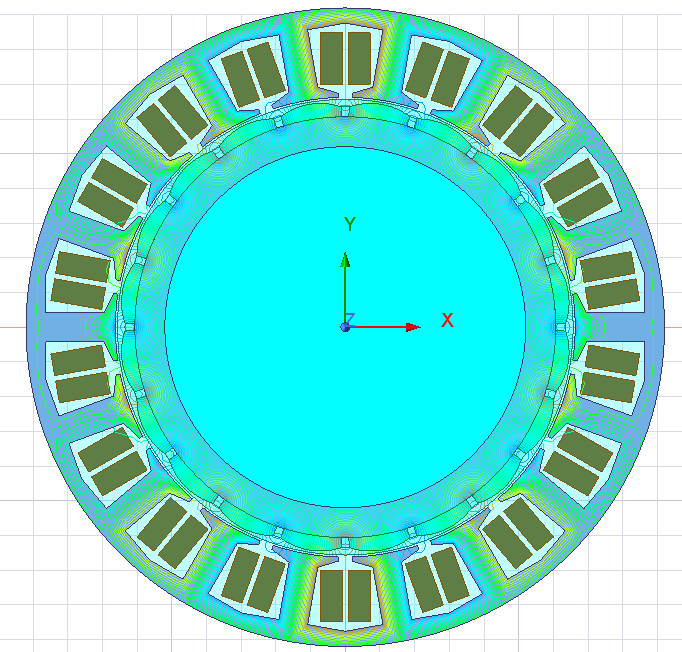
模型画好了,绕组和磁钢还要逐项设置?我们做了个 Maxwell 插件
模型画好了,绕组和磁钢还要逐项设置?我们做了个 Maxwell 插件
电机视窗 · 研发工具实战 01 ·
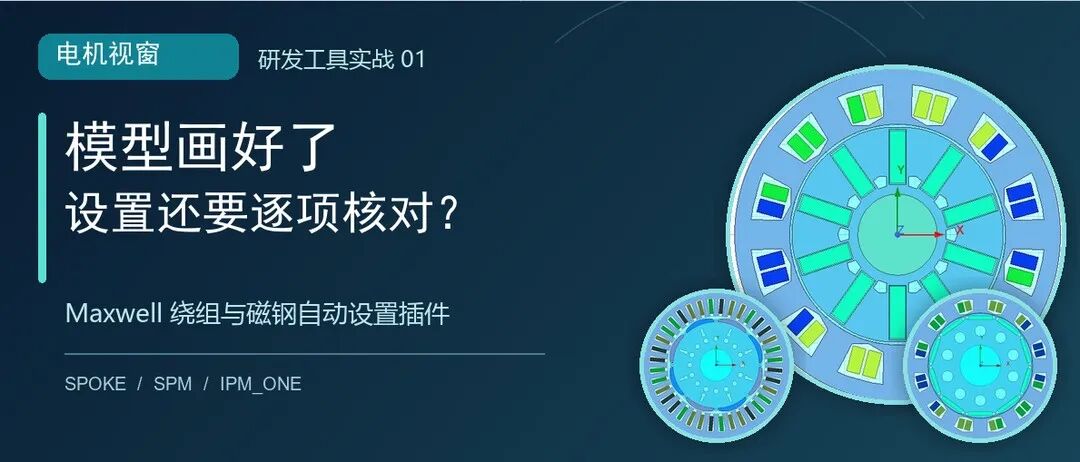
我们做了一个插件,把绕组、磁钢方向和 Motion 初始角设置串起来。用三个转子类型、四个实际模型,演示从安装到结果核对的操作过程。
电机模型画好了,但距离开始分析,中间还隔着一整段设置工作。
绕组要分组,线圈要对应到三相激励;永磁体要设置磁化方向,相邻磁极的极性要核对;转子运动还需要检查 Motion 初始角。换一个结构、换一组参数,往往又要把这些步骤重新走一遍。
这些操作直接影响计算结果。几何看起来合理,并不代表绕组相位、磁极方向和运动参考已经一致。设置遗漏后,问题可能直到求解结果出来才暴露,排查时还要重新追溯前面的操作。
我们开发的 Maxwell 2D 绕组磁钢与 Motion 自动设置插件 v0.0.10,围绕这一段工作展开,将对象选择、参数核对、只读检查、应用设置和结果反馈串成一个流程。本期介绍它已经能做什么、适合哪些模型,以及当前版本在哪些代表结构上已经验证。
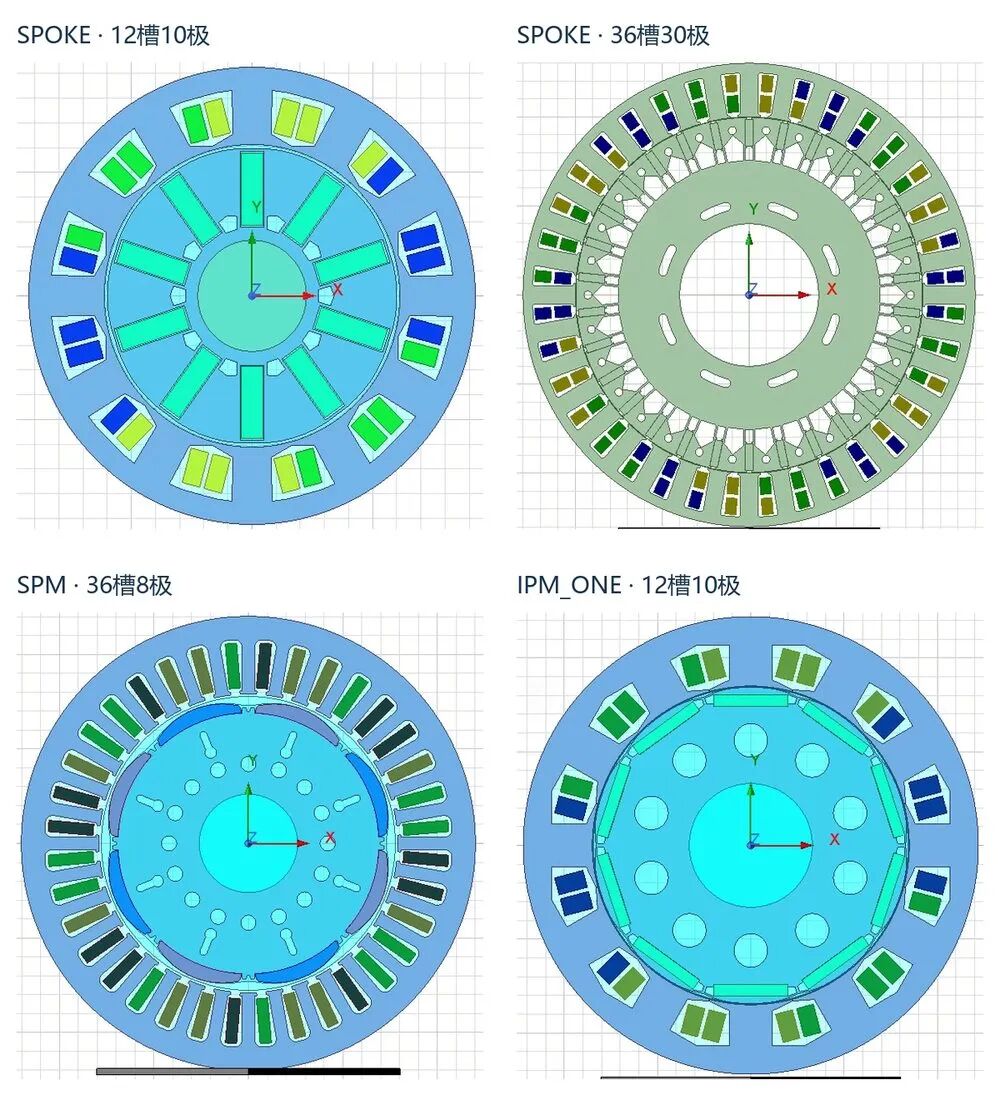
图 1|三种转子、四个案例。左起为两个切向式 SPOKE、一个表贴式 SPM、一个一字型内置式 IPM_ONE。
该插件的目的是什么
这款插件不是要替代你对电机设计本身的判断,而是把 Maxwell 2D 里最容易被忽略、最容易反复出错的一段设置工作,组织成一套可检查、可确认、可读回的流程。
它适合谁
如果你日常需要在 Maxwell 2D 中反复建立三相绕组、为每一块磁钢设置磁化坐标,并核对 Motion 初始角,这套插件值得在工程副本里先试一轮。它也适合需要交接模型的团队——报告能留下输入参数、检查结果、失败位置和读回角度,下一位工程师有机会追溯当时的设置依据。更具体的适用对象包括:建立新模型的电机工程师、复核他人 AEDT 工程的仿真工程师,以及希望把 SPOKE、SPM、IPM_ONE 三类代表结构纳入统一检查流程的小团队。
它针对哪些实际问题
重复操作容易遗漏。 绕组相组、线圈激励、磁钢 Face CS、Orientation 和 Motion Data 分散在不同界面。手工逐项设置时,漏选一个对象或沿用上一模型的参数,都可能留下隐患。插件把对象选择、参数核对、只读检查、应用与结果报告排成固定次序。
几何相同,极性也可能不同。 IPM_ONE 的扁平磁钢轮廓给得出中心角,却给不出绝对 N/S 极性,插件会展示锚点并要求人来确认;SPOKE 与 SPM 遇到整体相反的磁极方案时,同样需要核对设计目标。这样安排保留了工程师对物理方向的判断权。
Motion 角缺少可追问的依据。 当前角是 0° 还是某个非零值,都无法单凭数字判断它是否适合实际的绕组与磁钢。两项设置齐备后,插件结合三相空间基波、磁钢 N 极轴和运动约定核算空载参考角,展示当前值与建议值,经确认后写入绝对角度并读回;核验条件不满足时,保留原值。
等待期间需要知道进度。 v0.0.10 把界面消息处理与串行 AEDT 操作分开,顶部显示阶段与已用时间,并临时锁定按钮,操作仍可能持续数秒到数十秒,但界面不会假死。
一句话概括:针对已验证的三类完整转子,它把绕组、磁钢方向和 Motion 初始角,放进一套可检查、可确认、可读回的流程里。是否采用,取决于你的模型是否落入支持范围,以及在工程副本中的复核结果。
一、把分散的设置集中起来
当前插件面向 AEDT 2024 R1 下的 Maxwell 2D 完整 360° 三相永磁电机模型。项目指南记录的代表性结构包括 SPOKE、SPM 和平直单层内埋式 IPM_ONE。
它处理的核心工作有三项:绕组分组与三相激励、永磁体方向设置与极性检查、Motion 初始角计算与确认写入。下面先把插件装好,再逐项看每个功能在真实模型上怎么走。
0. 先安装:解压、放入 PersonalLib、从 Toolkit 菜单启动
本文对应 Maxwell2D_MotorSetup_v0.0. 10. zip解压到独立目录,入口脚本 电机自动设置_2024R1.py 与整个 motor_setup_lib 文件夹必须保持同级。
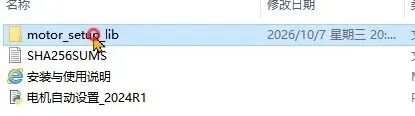
图 2
(这是本电脑的实际路径,其他电脑应以 AEDT 配置的 PersonalLib 路径为准,用户名和文档目录位置可能不同):
C:\Users\Administrator\Documents\Ansoft\PersonalLib\Toolkits\Maxwell2D
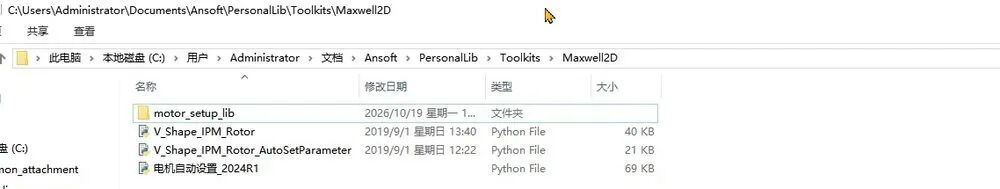
图 3
打开 AEDT 2024 R1 中的工程副本,激活目标 Maxwell 2D 设计,再选择:Maxwell 2D → Toolkit → PersonalLib → 电机自动设置_2024R1。若菜单中暂未出现入口,可在同一 Toolkit 菜单中使用 Update Menu 更新;首次试用也可通过 Tools > Run Script... 直接运行解压目录中的入口脚本。
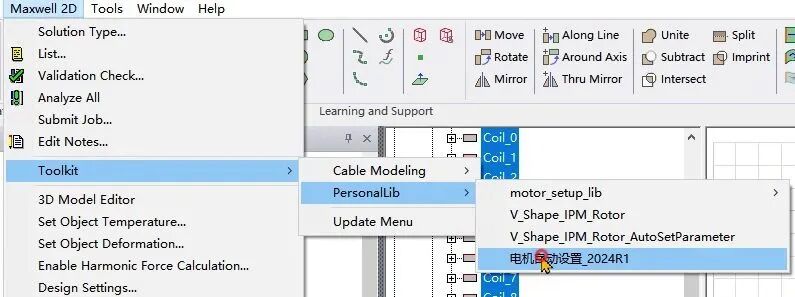
图 4|四个案例使用相同的脚本入口;启动后确认窗口版本显示 0.0.10,顶部工程和设计名称与当前副本一致。若 AEDT 加载过旧版插件,先重启 AEDT 再运行新版本,避免模块混用。
1. 绕组分组与三相激励设置
选择目标导体对象,核对槽数、极数、绕组层数、匝数、节距及并联支路等参数后,先执行检查,再应用绕组设置。
这种流程让操作者在写入前就能看到检查结果,应用后再核对 PhaseA、PhaseB、PhaseC 及对应线圈。需要强调,参数应与实际设计一致;软件给出的识别结果或默认值仍需工程人员确认,不能直接作为设计依据。
下面以第一组 SPOKE 模型为例,录屏最终填写的参数为 12 槽、10 极、53 匝、节距 1、并联支路 2(这些数值对应本次模型,其他设计需重新填写)。参数核对后,再执行“仅检查”和“应用绕组设置”,以填写完成并经检查的参数为准。
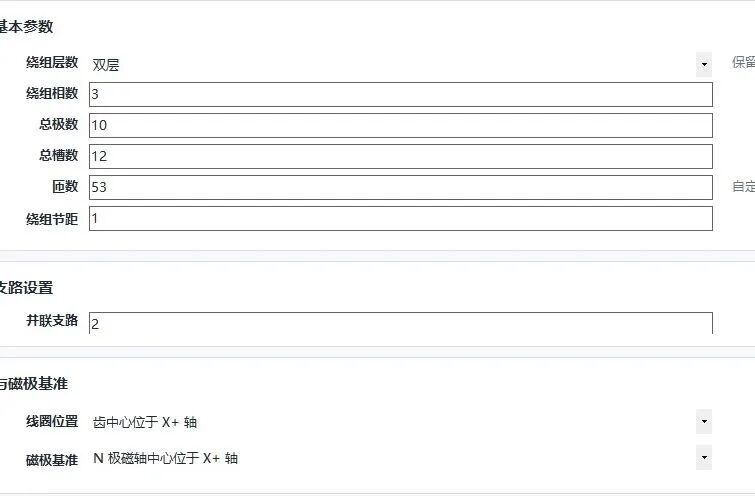
图 5|SPOKE 案例一的绕组参数核对界面;先仅检查,再应用,并在应用后回读 PhaseA / B / C 与对应线圈。
2. 永磁体方向设置与极性检查
选取全部目标永磁体,核对磁体数量、转子中心、材料和几何轮廓后,插件按支持的结构生成或复用 Face CS,并设置磁体 Orientation。
这一步的价值,是把对象与磁化方向的对应关系纳入统一检查流程,方便应用后逐一核对相邻磁极。对于 IPM_ONE,几何信息不足以独立确定绝对 N/S 极性,插件需要操作者确认基准磁体极性;其他结构遇到整体极性选择时,也需要结合原设计和磁场方向判断。磁化方向有物理含义,自动化可以减少逐个配置的操作,但设计意图仍需要明确输入。
自动识别时,界面可能弹出两种整体 N/S 极性方案——几何上成立的两套相反极性,需要工程人员作出选择,取消则停止这一项操作。
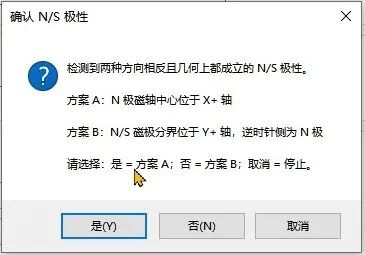
图 6|SPOKE 案例一的整体磁极极性选择;两套相反极性在几何上都成立,需结合原设计确认。
3. Motion 初始角计算与确认写入
当绕组和磁钢设置信息满足条件时,插件结合三相空间基波轴、磁极参考及运动约定,计算建议的 Motion 初始角。
操作者可以对照当前角度与建议角度,再决定是否写入。确认后,插件写入绝对机械角,并读取结果核对;拒绝或取消时保留原值。依据不足时,也保留原值并给出诊断。这里的角度用于建立空载基波参考,负载工况下的最佳电流角还需要结合具体工况另行分析。
以 SPOKE 案例一为例,磁钢设置与绕组信息齐备后,确认窗口给出 33° 机械角,随后在 Motion 属性中可以看到 Initial Position 为 33 deg。数值反映该模型的设置参考,不作为同槽极组合的固定答案。
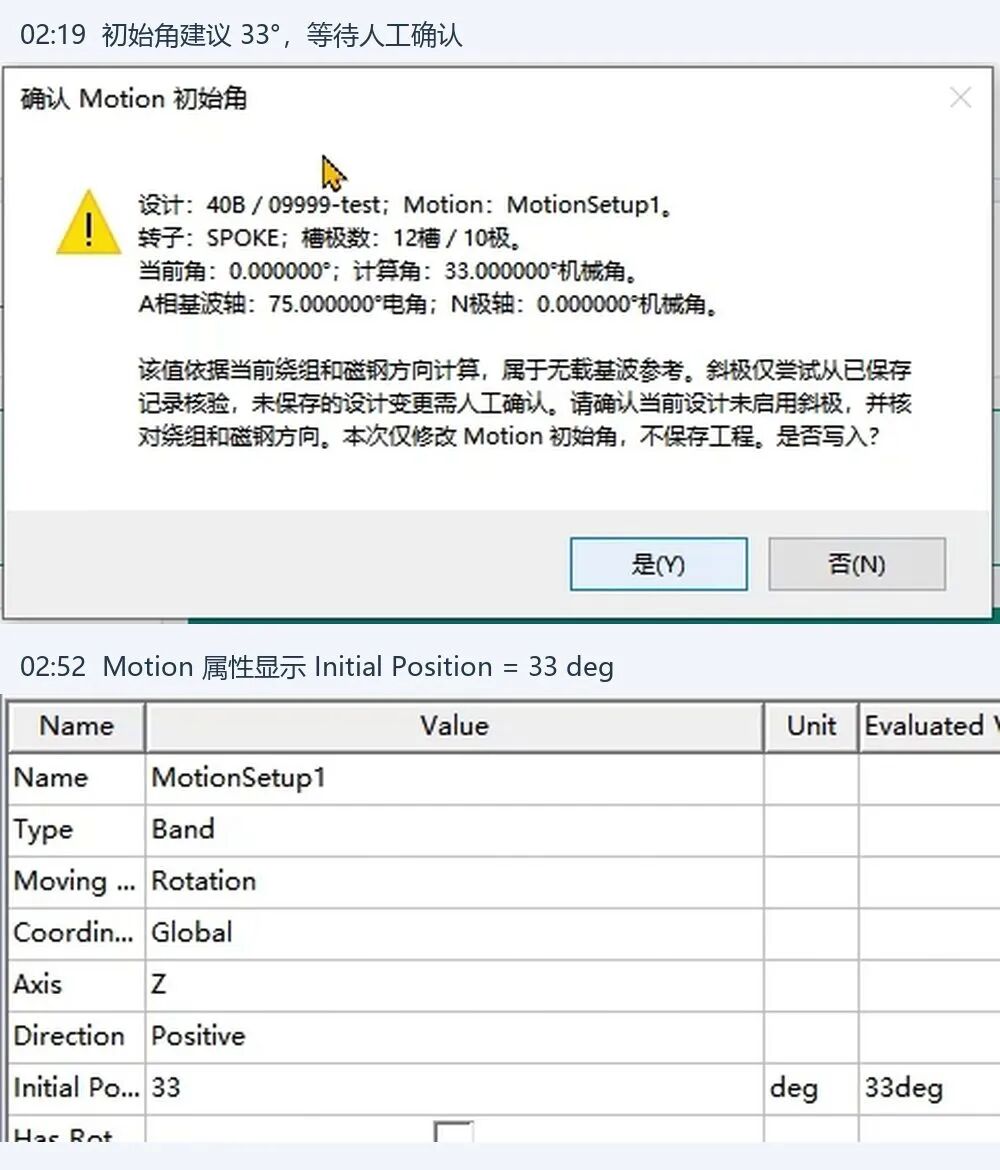
图 7|SPOKE 案例一的 Motion 初始角建议与属性读回。
二、它帮助我们解决什么问题?
减少重复设置带来的操作负担
对反复建立和调整电机模型的工程人员而言,绕组、磁钢及运动设置具有较强的重复性。把它们集中到统一入口,可以减少在多个界面之间来回切换,并让每轮设置按相同顺序开展。目前尚未进行统一条件下的人工耗时对照测试,因此本文不承诺固定的节省比例;实际收益需要结合模型规模和原有工作方式评估。
让问题更早暴露
“仅检查”步骤可以先输出计划和诊断,无需立即改动目标设置。导体或磁体对象选错、参数不匹配、已有设置冲突等情况,应该尽量在应用阶段之前发现;操作者可以根据提示修正,再次检查,减少带着疑问继续求解的情况。
保留人工设置的边界
自动化工具进入已有模型时,需要尊重模型里已经存在的工作。指南说明,遇到同名绕组组、未知人工 Orientation 等情况,插件会提示检查或停止相关操作;对符合条件的已有自动设置,则支持安全复用。这一边界有助于降低重复应用和接管既有设置时的风险,首次使用仍建议在项目副本中进行。
让交接与复查有记录可看
项目交接常常面临一个问题:接收者能看到模型,却不容易还原当时的设置过程。插件集中反馈输入参数、检查结果、失败位置及角度回读结果,让工程人员更容易确认做过哪些操作、哪里需要继续检查;这些记录也为后续建立可重复的仿真流程提供基础。
三、当前版本走到了哪一步?
根据项目使用指南及验收记录,v0.0.10 已在 AEDT 2024 R1 中,针对代表性模型开展按钮操作闭环验证。本文实际覆盖了四个案例,SPOKE 包含两个不同槽极组合。
四个角度对应各自验收算例,不可直接套用到其他模型。SPOKE 两个案例的 33° 与 11° 差异,也提醒我们每个模型都需要独立核对自己的绕组参考、磁极方向与初始角。
项目资料还记录了 554 项 Python 回归测试通过,这提供了软件回归检查的证据;不同几何、材料和工况下的工程适用性,仍需逐项验证。当前发布重点是设置流程,模型应用完成后,仍应核对磁极方向、空载反电动势相位,以及正转条件下的转矩方向等物理结果。
下面按演示顺序,给出插件在剩余三个代表性模型(SPOKE 案例二、SPM、IPM_ONE)上的实际设置画面。
SPOKE 案例二,36 槽 30 极
第二组 SPOKE 换成 36 槽、30 极,录屏填写双层、三相、31 匝、节距 1、并联支路 3,并对完整转子的 30 块磁钢进行识别和设置。槽极数、匝数与并联支路均按当前模型重新填写。
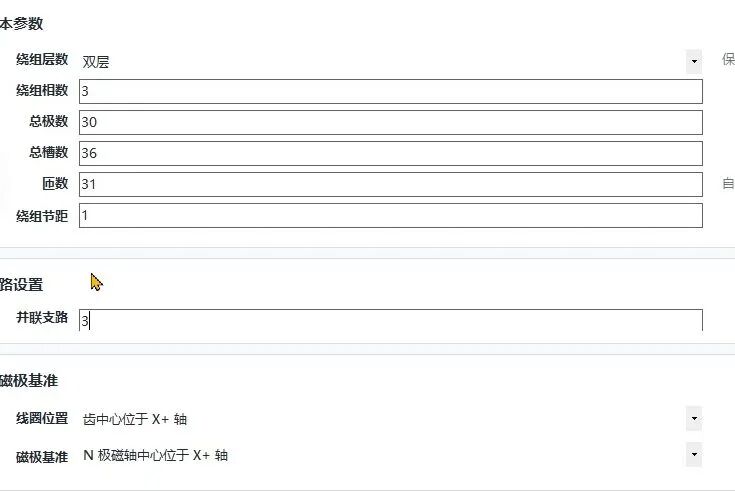
图 8|SPOKE 案例二的绕组参数;同一设置流程应用到不同槽极组合。
应用后,报告显示识别并新建了 30 块磁钢的设置,模型中可见方向坐标系。
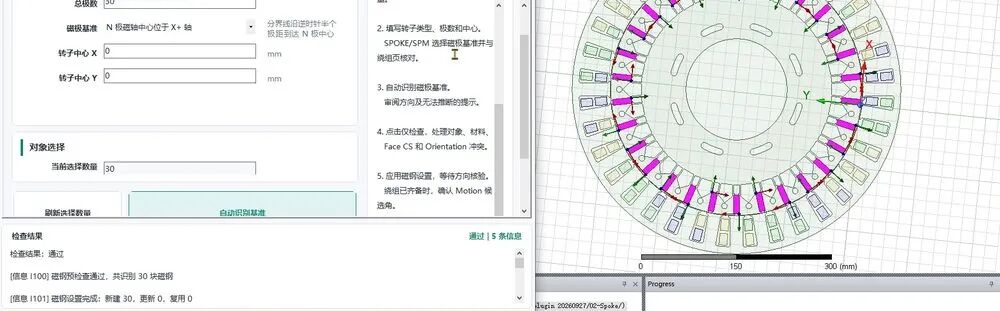
图 9|SPOKE 案例二的磁钢方向与应用报告;原图可放大查看。
本次 Motion 建议值为 11° 机械角,在 Data 页读回的 Initial Position 同样为 11 deg,通过 Maxwell 自身的 Motion 窗口复核写入结果。
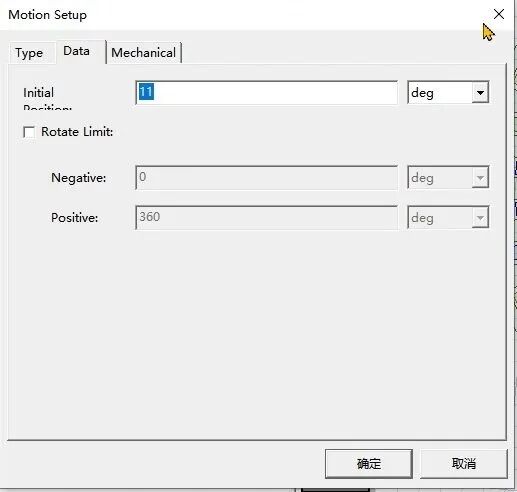
图 10|SPOKE 案例二的 Motion 建议值与属性读回。
SPM 案例,36 槽 8 极
切换到表贴式 SPM 后,先把转子类型改为对应选项。录屏中最终参数为单层三相、36 槽、8 极、50 匝、节距 5、并联支路 1。注意插件刚打开时仍可能显示预填示例,应以填写完成并经检查的参数为准。
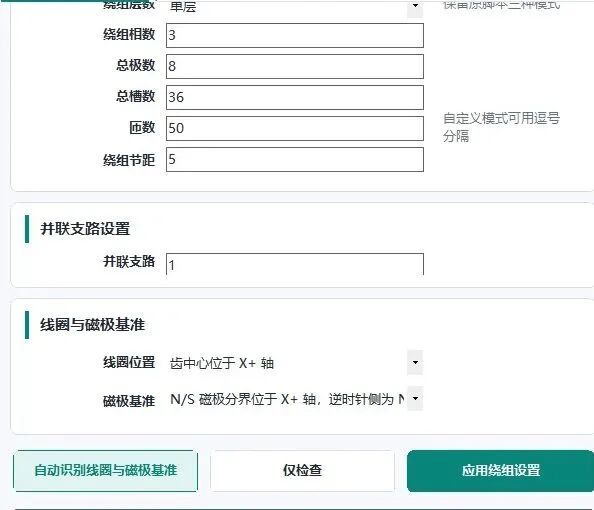
图 11|SPM 的绕组参数;相同的界面入口,使用当前模型自己的参数。
磁钢页选择完整的 8 块表贴磁体,核对极数、转子中心和磁极基准。应用后,模型树中可见对应的 PM_AUTO_CS_* 坐标系,并可逐块查看磁体方向。
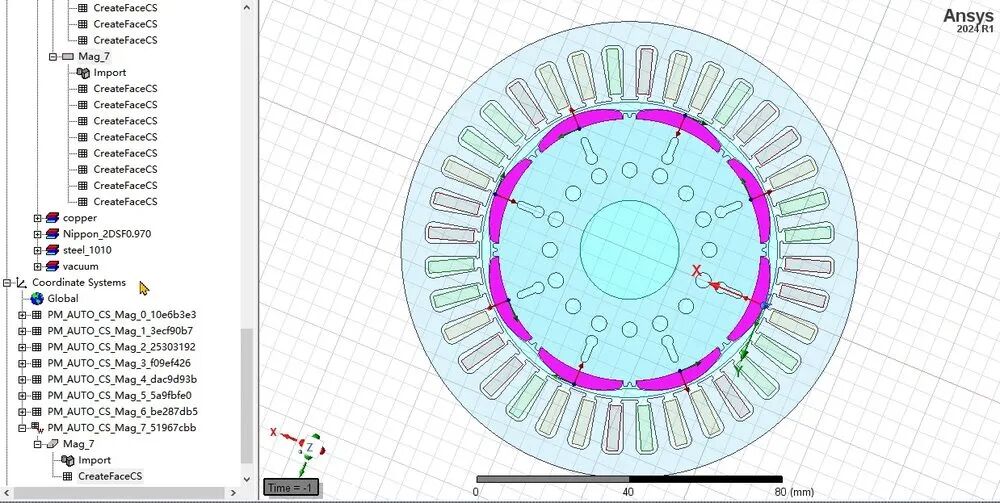
图 12|SPM 的 8 块磁体方向设置可在模型和坐标系树中继续核对。
本次 SPM 的建议机械角为 7.5°,随后在 Motion Data 页读回 7.5°。
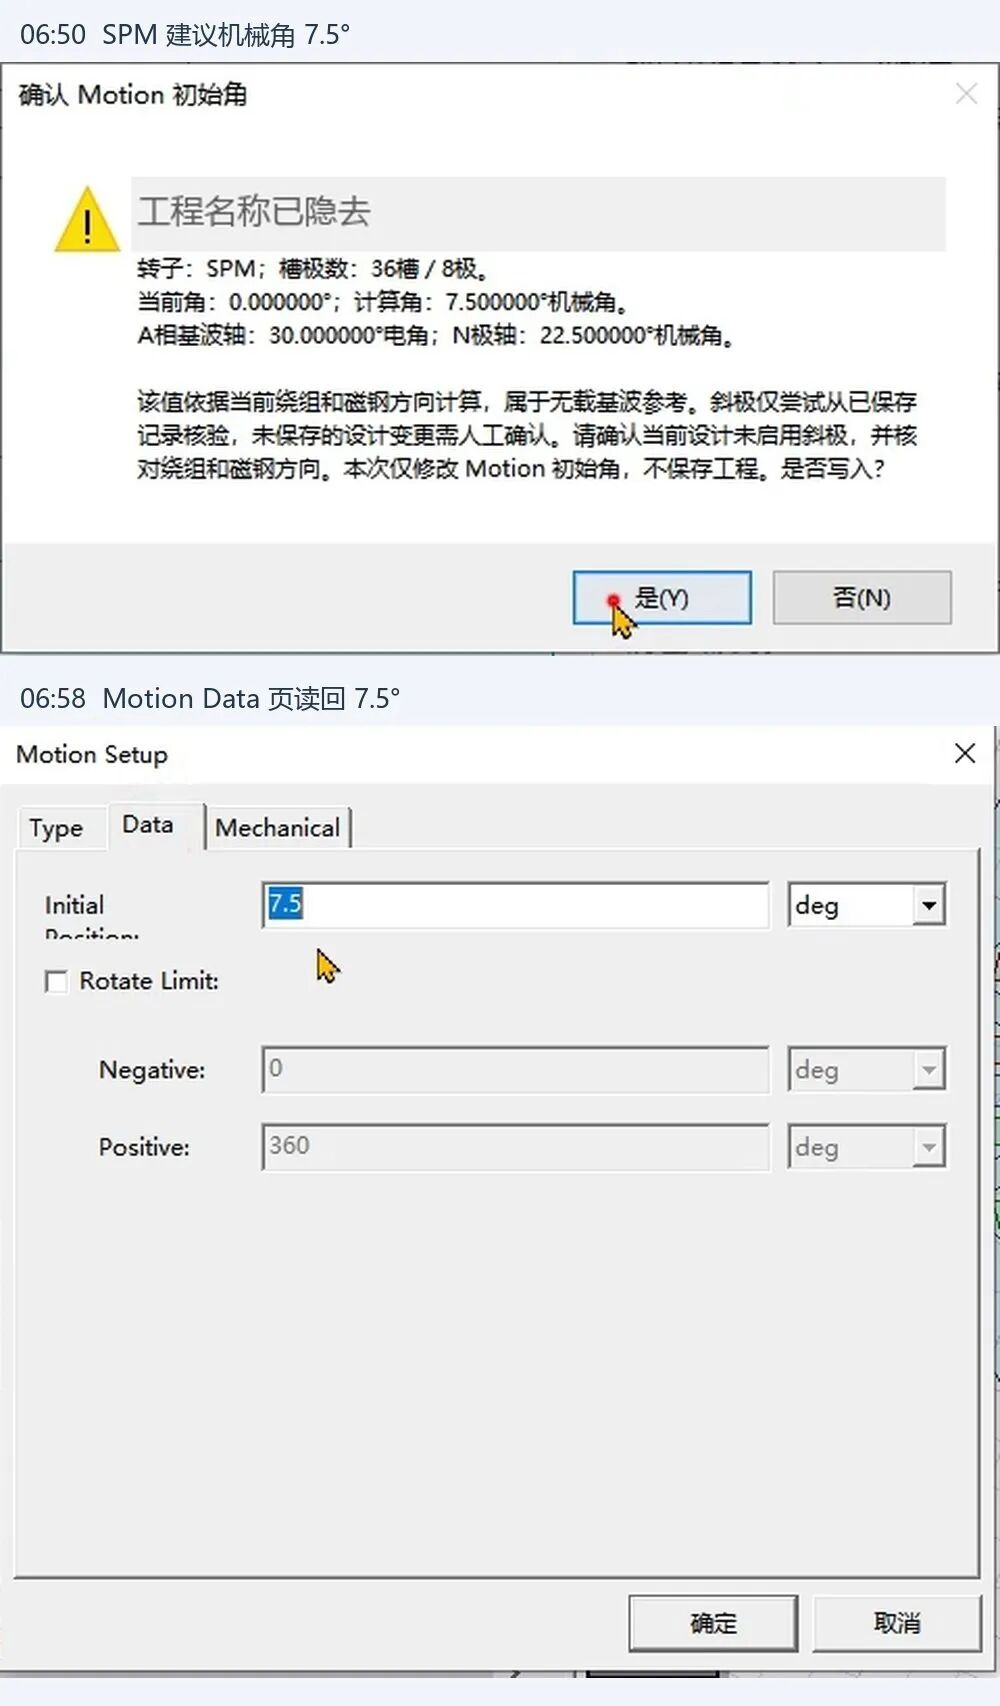
图 13|工程名称已遮蔽。
IPM_ONE 案例,先确认锚点极性
一字型内置式 IPM_ONE 使用 12 槽、10 极、双层三相绕组,录屏最终填写 55 匝、节距 1、并联支路 2。绕组可以先检查与应用;磁钢方向尚未核验时,Motion 仍可能保留原值。
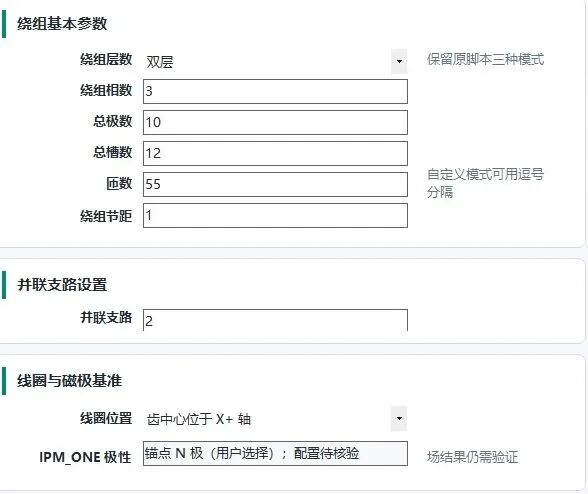
图 14|IPM_ONE 的绕组参数。
这个案例中,插件识别到几何锚点 Mag1_0,中心角为 18°。几何信息不足以确定绝对 N/S 极性,因此由操作者确认锚点为 N 极或 S 极;界面上的“是”“否”分别有明确含义,不能凭习惯点击。确认的是磁体锚点极性,后续还要核对磁场方向。
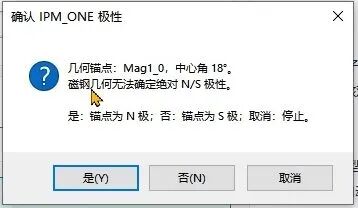
图 15|IPM_ONE 的锚点磁极极性确认窗口。
完成磁钢设置后,可以在属性中看到 Orientation 指向插件建立的 Face CS,核对对象属性与坐标系名称的对应关系。
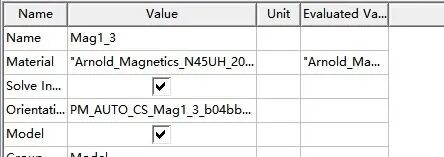
图 16|IPM_ONE 的磁体 Orientation 属性,指向插件建立的 Face CS。
本次 IPM_ONE 的建议机械角为 15°,录屏末尾的 Motion 属性显示 Initial Position 为 15 deg。
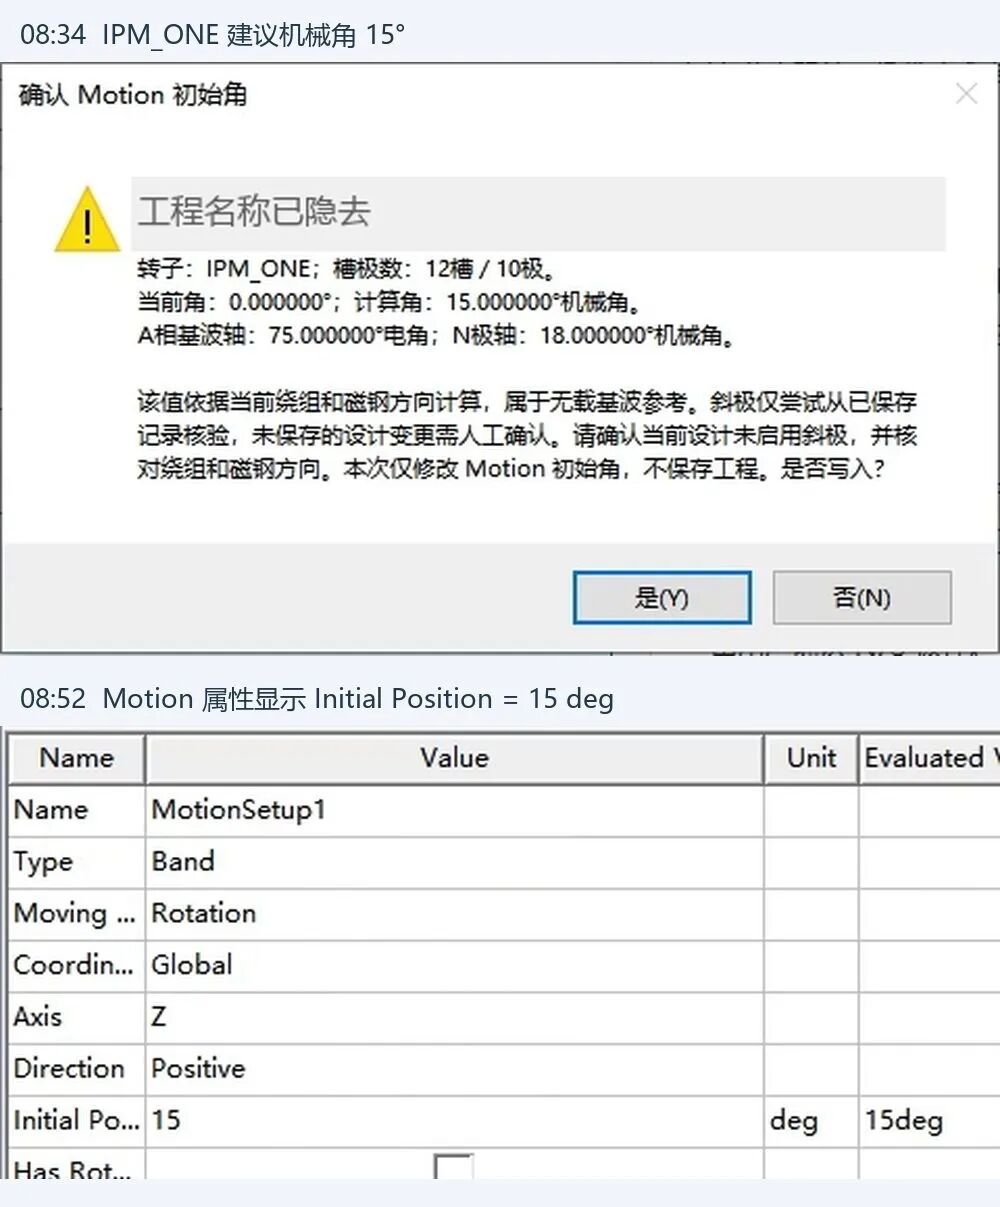
图 17|工程名称已遮蔽。
完整操作演示
看完分步截图,如果想核对完整过程,这段录屏按文章顺序记录了全部操作:从解压安装包、放入 PersonalLib、从 Toolkit 菜单启动开始,依次完成 SPOKE 案例一(12 槽 10 极)、SPOKE 案例二(36 槽 30 极)、SPM(36 槽 8 极)、IPM_ONE(12 槽 10 极)的绕组参数核对、磁钢方向设置与 Motion 初始角确认写入,并包含结果报告与告警确认画面。建议先对照文中分步图,再跟着视频完整走一遍。
完整操作演示(约 9 分钟):从插件安装到四类转子的绕组、磁钢与 Motion 设置全流程实录;文中截图均取自本视频。
四、使用前需要知道的边界
当前适用范围有明确条件,包括完整 360° 模型、偶数极数、每极一块磁体,以及支持的几何轮廓。转子中心、长度单位和三相导体选择也必须与实际模型一致。周期扇区、IPM-V、每极多块磁体、斜槽斜极及任意导入轮廓,当前尚未纳入已验证范围。
Motion 计算还依赖运动与相位约定。指南中的条件包括 Global Z 正向旋转、Gamma 为 0°、无斜极等,超出条件时应重新确认适用性。插件当前不会自动保存项目,应用后需要人工保存,并建议重新打开检查关键设置。
读懂报告同样重要。录屏中可以看到“通过,包含警告”的状态,例如绕组可应用时,基准或相位证据仍可能不完整,报告会提示 Motion 保持当前值。W405 即提示基准或相位证据存在缺口,不能据“通过”二字判断 Motion 已经写入。
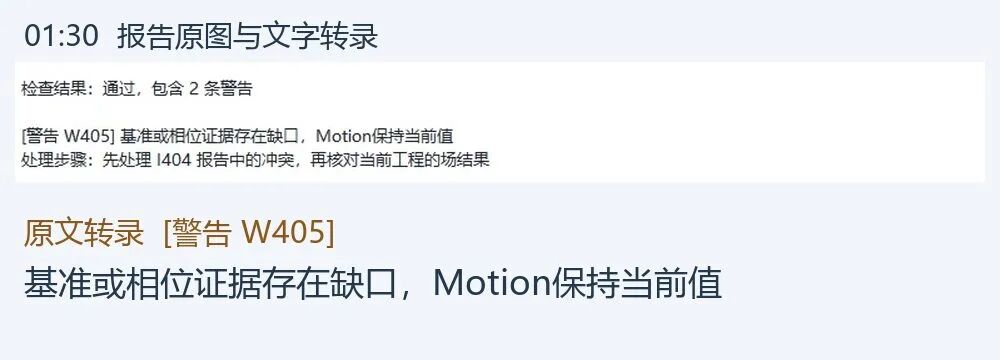
图 18|W405 提示基准或相位证据存在缺口,需结合报告判断,而非仅看“通过”。
已有磁极方案与本次选择冲突时,插件会弹出整体极性切换确认(E302),涉及整体 N/S 极性切换,操作者应核对当前值、期望值和影响,再决定是否继续。
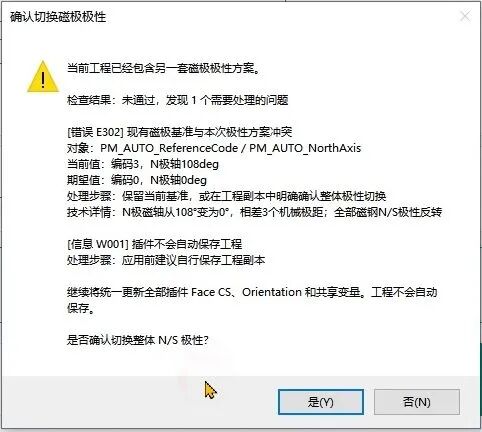
图 19|已有磁极方案冲突时的确认窗口,必须结合当前模型判断。
本次录屏展示了安装、参数填写、设置应用和当前会话中的角度读回。第一组 SPOKE 的 Maxwell 消息区还出现了 Property 'Material' does not exist,其触发原因仍需结合日志和工程复核;现有画面不能支撑“四个案例全程无错误”的表述。插件不会自动保存工程,完成操作后,应人工保存副本、关闭重开,检查激励、Orientation 和 Initial Position,再通过求解检查气隙磁密 N/S 方向、空载反电势相位及转矩方向——本次录屏未完整覆盖这些后续验收步骤。
写在最后
这款插件当前的工作重点,是把容易分散、容易反复的电机设置流程组织起来,让参数有检查、写入有确认、结果有反馈。
对于需要反复调整电机模型,或希望统一团队设置流程的工程人员,可以先从满足条件的项目副本开始试用,核对设置与物理结果,再评估是否纳入日常工作。也欢迎向“电机视窗”反馈具体使用问题:提供结构类型、槽极数、AEDT 版本、操作步骤及报错信息,会更有助于定位问题;涉及企业设计资料时,请先脱敏,并遵守所在单位的数据管理要求。