故障诊断大模型 | 可靠性感知的动态图融合与基于大语言模型的轴承故障诊断助手 (下)
接上篇故障诊断大模型 | 可靠性感知的动态图融合与基于大语言模型的轴承故障诊断助手 (上),论文提出了一种融合动态知识协作、分层证据融合与大语言模型的轴承故障诊断框架。研究通过 VAE 提取全局运行状态,利用图注意力网络(GAT)动态构建诊断智能体之间的协作关系,并引入类似学术同行评审的“回答者—评审者”机制;进一步结合离线可靠性校准与双层 Dempster–Shafer 证据融合,提高噪声干扰、传感器失效及工况变化下的诊断鲁棒性。最后,借助 LLM 与检索增强生成(RAG),将诊断结果及中间证据转化为可追溯、可核查的自然语言报告。下篇主要介绍实验和讨论。
论文基本信息
论文题目:
Reliability-aware dynamic graph fusion and LLM-based diagnostic assistant for bearing faults
论文日期:2026(online)
发表期刊:
Advanced Engineering Informatics 74 (2026), 104720
论文链接:
https://doi.org/10.1016/j.aei.2026.104720
作者:
Tantao Linᵇ,Zhijun Renᵃ˒ᵇ˒*,Kai Huangᵇ,Xinzhuo Zhangᵇ,Hamid Reza Karimiᶜ,Yongsheng Zhuᵇ,Jun Hongᵇ
作者单位:
ᵃ Frontier Institute of Science and Technology, Xi'an Jiaotong University, Xi'an 710049, China.
ᵇ Key Laboratory of Education Ministry for Modern Design and Rotor-Bearing System, Xi'an Jiaotong University, Xi'an 710049, China.
ᶜ Department of Mechanical Engineering, Politecnico di Milano, Milano 20156, Italy.
作者简介:
任智军,机械工程博士,西安交通大学前沿科学技术研究院助理教授、硕士生导师。(来源:https://faculty.xjtu.edu.cn/renzhijun/)
目录
摘要
1. 引言
2. 预备知识
3. 方法
4. 实验
4.1. 实验 1
4.1.1. 数据集与预处理
4.1.2. 实现细节
4.1.3. 基线与比较方法
4.1.4. 性能评价
4.2. 实验 2
4.2.1. IB 数据集描述与预处理
4.2.2. 实现细节
4.2.3. 性能评价
4.3. 消融实验
4.3.1. 关键组件消融实验
4.3.2. 外层类别加权消融实验
4.4. 可视化与可解释性分析
4.5. 参数敏感性
4.5.1. 最大回答者数量与评审者数量的敏感性
4.5.2. 图演化步数的敏感性分析
5. 结论
4. 实验
为了验证所提出的多智能体协作诊断方法在多源融合故障诊断任务中的有效性和优越性,本文开展两组实验:(1)在公开轴承数据集上进行多源融合诊断,评价所提出方法的性能和鲁棒性;(2)在使用自行采集的私有数据集的智能轴承(IB)系统上部署基于 LLM 的多智能体诊断助手,验证其诊断性能、实际适用性和用户体验。
4.1. 实验 1
4.1.1. 数据集与预处理
首先,在公开数据集上评价所提出方法进行多源融合故障诊断的有效性。数据来自 Paderborn Bearing Dataset [50],如图 4 所示。该数据集包含多种工况下的轴承运行数据,涵盖健康状态及多种故障类型。利用六个传感器采集信号,包括振动、电流、转速、力和扭矩传感器。振动和电流通道的采样频率为 64 kHz,其余传感器为 4 kHz。健康状态包括正常、内圈故障、外圈故障和复合故障。故障通过人工加工缺陷或加速寿命试验引入。
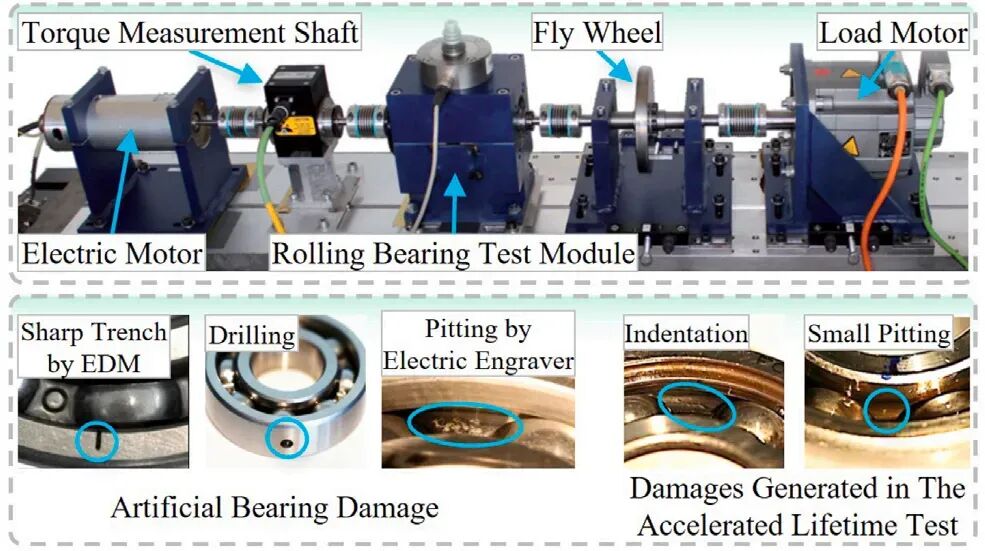
图 4. Paderborn 轴承数据集概览 [50]。
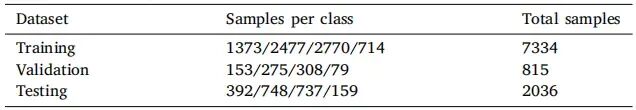
将原始文件分割为互不重叠的样本,每个样本包含 1 s 的多源数据。对于振动信号,使用快速傅里叶变换(FFT)提取频域功率谱特征。对于电流信号,考虑到供电基频 及其谐波的污染,首先在 处进行陷波滤波,然后提取功率谱。对于采样率较低的传感器(转速、力、扭矩),直接使用时域信号作为输入特征。因此,每个样本包含来自六个传感器、对应不同传感器类型的特征向量。为了统一输入维度并方便实验评价,将所有信号特征截断为固定长度 1024。采用逐通道 -score 标准化,训练集、验证集和测试集的划分见表 1。通过数据增强缓解类别不平衡问题,即向少数类样本注入弱噪声,以获得更均衡的数据分布。
表 1. Paderborn 轴承数据集。
4.1.2. 实现细节
(1)诊断智能体模型池与 VAE 构建
在实际应用中,用于融合的模型池可能包括:(1)每个通道使用一个诊断模型;(2)单个通道使用多个诊断模型(例如不同架构的深度模型);(3)使用一个接受多通道输入的诊断模型;(4)上述三种配置的组合。
本实验重点考虑“一个传感器对应一个模型”的配置,从而能够客观评价决策级融合方法整合异构证据的能力。对于每个传感器,采用表 2 所示的轻量级一维深度可分离卷积神经网络(1D-DSCNN)作为基础诊断模型。各模型独立训练,以确保它们在对应传感器数据上具有竞争力的诊断性能。
表 2. 用于每个传感器的 1D-DSCNN 架构。
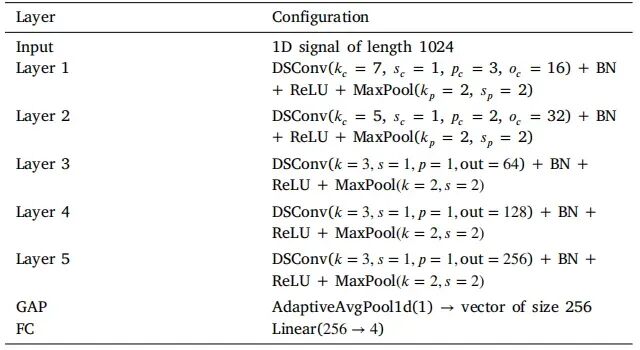
DSConv:深度可分离卷积; :卷积核大小; :步长; :填充; :输出通道数;BN:批归一化;ReLU:修正线性单元;MaxPool:最大池化; :池化核大小; :池化步长;GAP:全局平均池化;FC:全连接层。
除了六个诊断智能体外,还使用一个一维 CNN-VAE 提取用于图条件化的全局运行状态表示。其架构汇总于表 3。VAE 在图学习之前预训练,并在 GAT 训练期间冻结其编码器。
表 3. 用于全局状态提取的 1D CNN-VAE 架构。
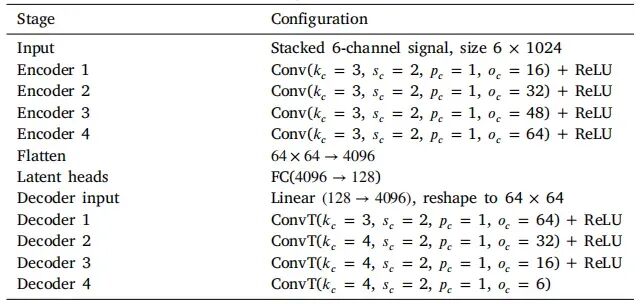
Conv:卷积;ConvT:转置卷积; :卷积核大小; :步长; :填充; :输出通道数;ReLU:修正线性单元;FC:全连接层。
(2)超参数设置
诊断智能体模型池包含 个智能体,对应六个传感器。GAT 注意力机制的隐藏维度设为 128。基于随机游走的评审者采样的邻域大小为 ,回答者智能体数量为 。初始邻接矩阵 定义为不包含自环的均匀先验图:所有非对角元素初始化为 0.5,对角元素固定为 0。训练期间,回答者—评审者融合权重设为 。图演化步数 设为 4。离线校准的锐化因子取 和 。GAT 结构头和置信度头的损失权重分别为 和 。正确强化和错误衰减的步长分别为 和 ,剪枝阈值为 。采用 Adam 优化器训练,初始学习率为 0.001,批大小为 64,训练 100 个 epoch。所有实验均使用不同的随机种子重复五次,并报告性能指标的均值与标准差。
4.1.3. 基线与比较方法
为了评价所提出方法的有效性,选择以下多源融合故障诊断方法作为基线。为公平比较,所有方法均采用相同的预处理流程,以及每个传感器相同的基础诊断模型(1D-DSCNN),唯一的区别是融合策略。
数据级融合方法: 数据级融合直接组合来自多个传感器的原始信号,形成联合表示,然后将其送入诊断模型。一种常见策略是按通道拼接信号,记为信号拼接(Signal Concatenation,Sig-Con)。
特征级融合方法: 特征级融合组合从不同传感器提取的特征表示,得到联合特征向量,再将其输入诊断模型。典型方法是特征拼接(Feature Concatenation,Feat-Con)。
决策级融合方法: 决策级融合聚合多个传感器专属模型的诊断输出,获得综合决策。广泛使用的方法是软投票(Soft-Voting),即对类别概率输出进行平均或加权。
近期决策级融合方法: 还纳入近期发表的几种故障诊断决策级融合方法进行比较,分别为 Enhanced-Voting [51]、UQ-Fusion [19]、DS-Confidence [20] 和 Weighted-DS [21]。UQ-Fusion 的实现是一种受 Xu 等人 [19] 启发、经过适配的不确定性感知决策级融合基线。与原始思想一致,融合权重依据各子模型预测的不确定性确定,即不确定性越低,权重越高。不同之处在于,原始框架依赖多尺度概率神经网络并包含多个考虑不确定性的融合分支;本文的实现则适配为包含六个独立模型的多传感器轴承诊断配置,仅保留软决策融合分支。通过蒙特卡洛 Dropout 估计不确定性,并将其分解为预测不确定性、偶然不确定性和认知不确定性,用于融合。
4.1.4. 性能评价
(1)整体性能
为了量化两种方法之间的性能差异,定义效应量 :
其中, 分别为方法 1 的均值和标准差, 分别为方法 2 的均值和标准差。效应量 衡量性能差距的大小;通常, 被视为较大的效应量,表示方法 1 显著优于方法 2。
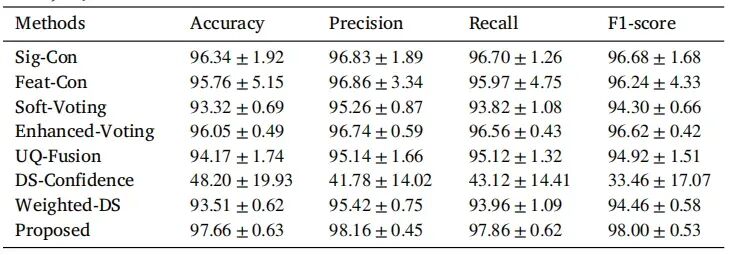
表 4 报告了整体性能指标。与最好的决策级融合基线 Enhanced-Voting 相比,所提出方法的准确率绝对提高 1.61 个百分点(97.66% 对 96.05%),估计效应量为 2.02,表明取得 了显著且稳健的增益。与 Soft-Voting 相比,绝对提升达到 4.34 个百分点。这说明在多源冲突场景下,简单 平均已接近其性能上限,而本文框架通过冲突感知与可靠性校准的融合,能够进一步利用模型之间的互补性。Precision、Recall 和 F1 分数持续优于其他方法(均值最高且方差处于最低水平之列),说明该方法在检测完整性和精确性之间取得了均衡。
表 4. 不同方法在 Paderborn 轴承数据集上的整体准确率(均值 ± 标准差,%)。
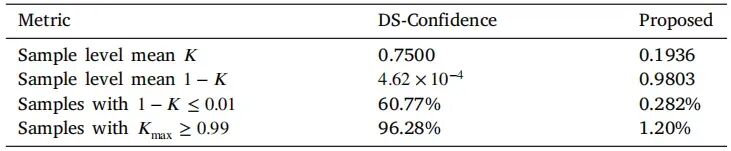
混淆矩阵如图 5 所示。当类别边界模糊时,传统拼接方法(图 5(a)–(b))往往受到“最强”通道支配,导致 C2 与 C3(内圈故障与外圈故障)之间出现系统性混淆。决策级平均(图 5(c))在一定程度上降低了过拟合风险,但在证据冲突时,会产生反映概率折中结果的模糊决策。Enhanced-/Weighted-DS(图 5(d)–(g))通过启发式或学习得到的加权方式,提高了主对角线的占比;不过,在少数高度冲突的样本中,C2 与 C3 之间仍然存在非对称误分类。所提出方法(图 5(h))在全部四个类别上表现出明显更加集中的主对角线模式,并有效抑制 C2–C3 之间的混淆,说明对内圈故障和外圈故障具有更强的区分能力。DS-Confidence(图 5(f))的性能异常低下,这与表 5 的冲突统计结果一致。其样本级平均冲突系数 远高于所提出方法,而 Dempster 规则中的样本级分母 显著减小。此外,60.77% 的样本满足 ,96.28% 的样本表现出 ,说明冲突严重累积,使 Dempster 规则的归一化接近奇异状态。相比之下,所提出方法保持数值稳定性,突出了显式冲突管理的必要性。
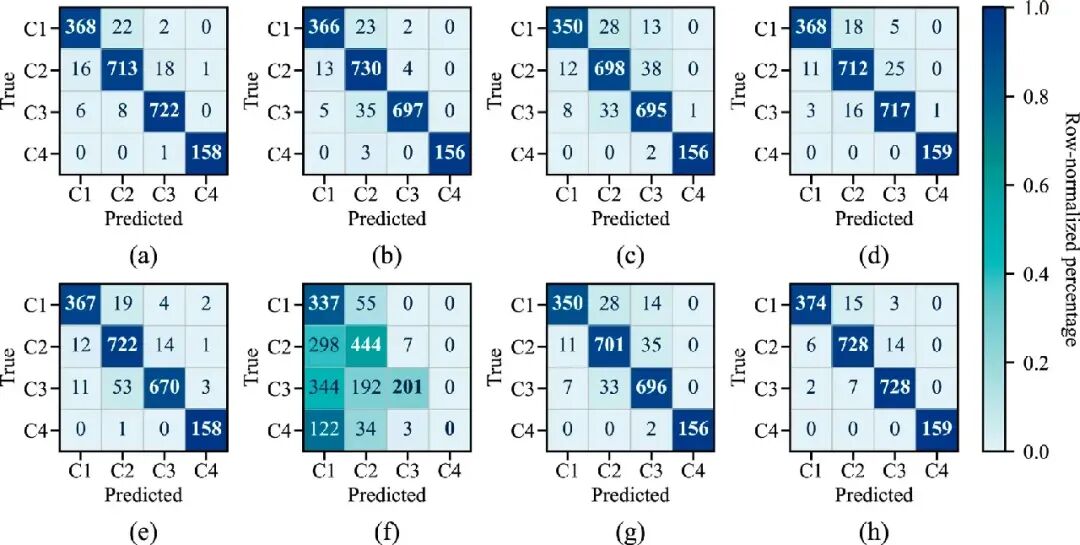
图 5. 所提出方法在 Paderborn 轴承数据集上的混淆矩阵。(a)Sig-Con;(b)Feat-Con;(c)Soft-Voting;(d)Enhanced-Voting;(e)UQ-Fusion;(f)DS-Confidence;(g)Weighted-DS;(h)Proposed。
表 5. Paderborn 轴承数据集上 DS-Confidence 与所提出方法的冲突统计对比。
(2)抗噪声分析
通过比较不同噪声水平下的诊断性能,进一步评价方法的鲁棒性。考虑四种噪声:(a)加性高斯白噪声(AWGN),用于模拟基本的传感器热噪声/电子噪声;(b)粉红噪声(PINK),用于模拟机械系统中的低频背景噪声;(c)带限噪声(BAND),通过使白噪声经过带通滤波器获得,以模拟结构/设备共振频带或窄带干扰(1–5 kHz);(d)脉冲噪声(IMPULSE),用于模拟间歇性大幅值尖峰(例如电磁干扰、开关操作、电接触不良)。对于每种噪声,将信噪比(SNR)设置为 30 dB、20 dB、15 dB、10 dB、5 dB 和 0 dB。
结果如图 6 所示。随着 SNR 增大,所有方法的性能均呈单调上升趋势,而所提出方法在所有 SNR 水平下均排名第一,在低 SNR 区间(0–10 dB)的优势最为明显,表明其对强噪声干扰的抑制能力更好。AWGN(a)注入宽带加性噪声,性能退化相对平缓。PINK 噪声(b)的能量集中在低频,容易掩盖转动特征(基频、谐波和调制边带),导致大多数方法出现更加明显的性能下降。所提出方法对后三种结构性噪声表现出特别强的抵抗能力,说明其融合策略并非简单能量平均,而是通过显式降低不可靠证据的权重、放大稳定证据来发挥作用。UQ-Fusion 在中高 SNR 区间表现尚可,但在极低 SNR 下失去优势,意味着仅依赖单模型不确定性不足以解决跨源冲突;而 Weighted-DS 的鲁棒性增益主要体现在中高 SNR 区间。
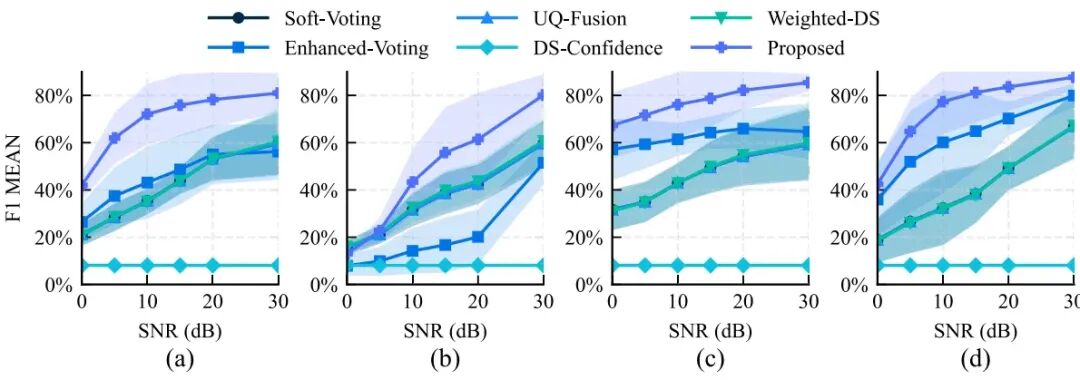
图 6. Paderborn 轴承数据集上的噪声鲁棒性分析。(a)AWGN;(b)PINK;(c)BAND;(d)IMPULSE。阴影区域表示五次运行的标准差。
(3)传感器缺失分析
进一步模拟传感器缺失情形,以评价感知信息不完整条件下的诊断性能。对每个样本、每个通道独立应用伯努利丢弃,缺失概率分别为 0.1、0.3、0.5 和 0.7。结果如图 7 所示。随着随机缺失概率 从 0.1 增加到 0.7,所提出方法在中等缺失程度( )下仍保持较高的 Accuracy 和 F1,其小提琴图的中位数始终处于最高位置,说明该方法能够在样本和通道两个层面动态降低缺失信息源或低置信度信息源的权重。在严重缺失条件下( ),所有方法的性能均出现不同程度的下降,但所提出方法的离散程度更小、长尾案例更少,体现出更强的鲁棒性。随着 增大,Soft-Voting 的性能明显恶化,凸显等权重策略对可用证据源数量减少的敏感性。UQ-Fusion 能够部分调整单源可靠性,但无法应对具有结构性的多源缺失模式;DS-Confidence 则在整个 取值区间均表现失效。这些观察结果与工程实 践一致:在传感器掉线、连接器松动或个别通道饱和等实际场景下,以冲突管理为核心的融合机制比简单 平均或静态加权更具实用性。
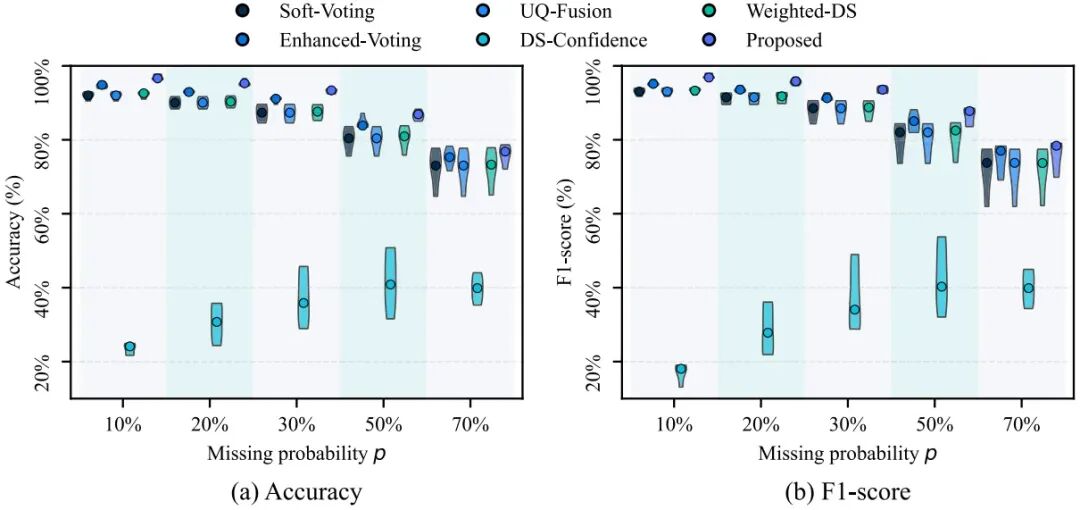
图 7. Paderborn 轴承数据集上的传感器缺失分析。(a)准确率;(b)F1 分数。
4.2. 实验 2
4.2.1. IB 数据集描述与预处理
为了验证完整系统的有效性,在实验室环境中构建了一个 IB 测试平台,如图 8 所示。该平台由电动机单元驱动,动力依次传递至测试轴承座。将 IB 单元安装在 7014AC 轴承的端面,集成 轴、 轴振动传感器以及一个声学传感器,以实现轴承运行状态的多维监测。采集到的信号经过数字化转换后,通过无线方式传输至上位机系统,并在其中部署基于 LLM 的智能诊断助手,执行实时轴承故障诊断及报告生成。
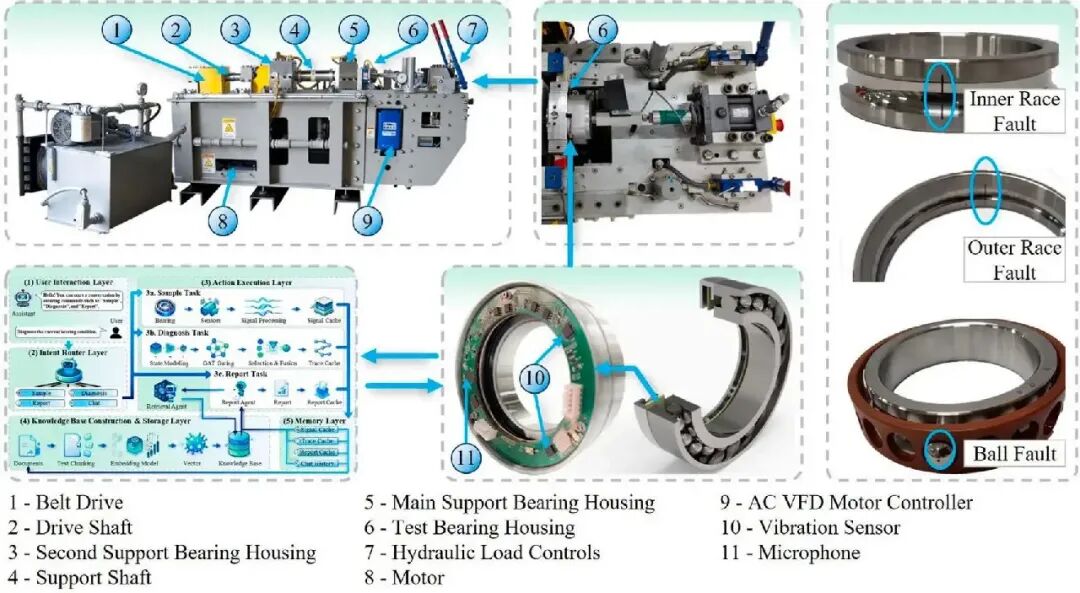
图 8. IB 测试平台。
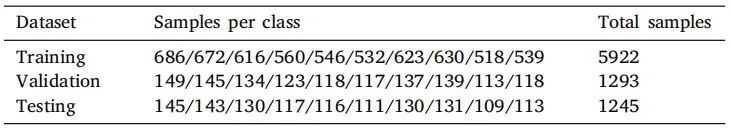
通过激光切割引入轴承故障,健康状态包括正常、内圈故障、外圈故障和滚动体故障,缺陷尺寸分别为 0.4 mm、0.6 mm 和 0.8 mm。通过调整图 8 中的部件 7 和部件 9,使轴承在不同转速(900 rpm、1500 rpm、2100 rpm)和载荷(1 kN、2 kN、3 kN)下运行。振动传感器采样频率为 32 kHz,声学传感器为 48 kHz。原始信号被分割成不重叠的样本,每个样本包含 0.1 s 的多源数据。IB 数据集的情况汇总于表 6。
表 6. IB 数据集。
4.2.2. 实现细节
(1)诊断智能体模型池构建和超参数设置
在许多实际场景中,单个信号通道可能关联多个诊断模型。为反映这一情况,构建了三通道配置,为每个通道配备两个使用不同输入形式的轻量级 1D-DSCNN 基础模型(表 2),输入形式分别为时域波形和频域谱。每个模型独立训练,以确保在对应传感器数据上具有竞争力的诊断性能。这种设计同样得到总共六个诊断模型,构成多源模型池。
所有超参数均与实验 1 完全一致。
(2)知识库构建
知识库(KB)的构建是诊断助手系统的一个关键组成部分。知识库中存储的知识涵盖以下类别:(1)IB 系统的基本配置和工作原理;(2)常见故障类型及其特征描述;(3)所提出的诊断方法与融合策略,包括整体工作流;(4)解释与报告生成的示例模板。
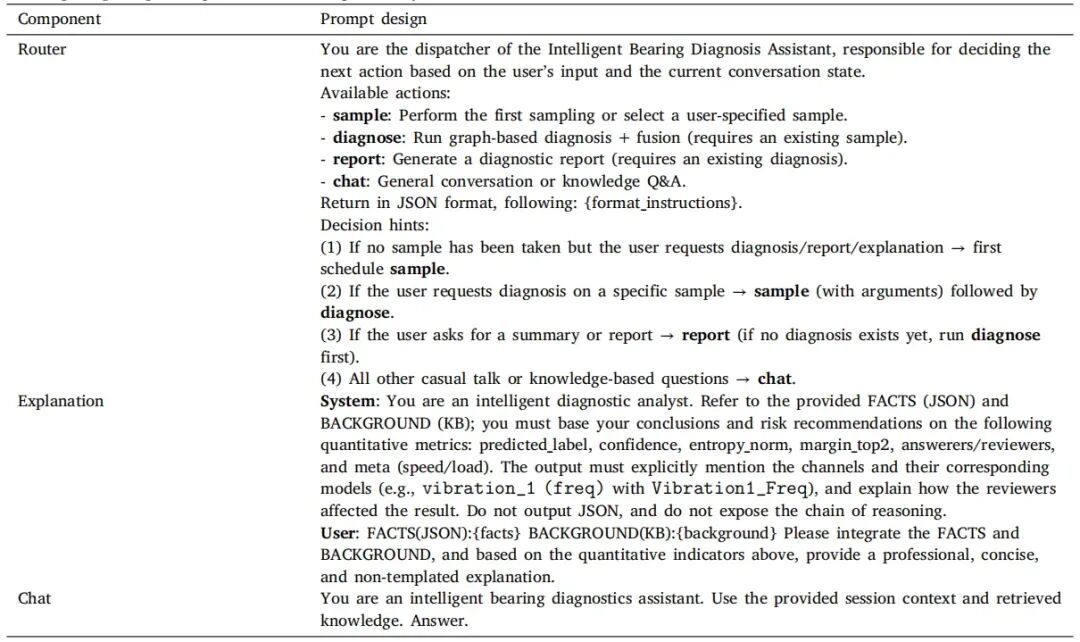
(3)LLM-Agent 提示词设计
在诊断助手系统中,需要 LLM 参与的组件主要包括意图路由器(Intent Router)、解释(Explanation)和聊天(Chat)功能。针对这些组件设计专门的提示词,引导 LLM 执行对应任务,具体汇总于表 7。
表 7. IB 诊断系统的 LLM-Agent 提示词设计。
4.2.3. 性能评价
(1)整体性能
如表 8 所示,所提出方法在四项指标上均取得最高分,同时具有最小的方差(99.97% ± 0.04%)。与最强基线 Feat-Con(99.61% ± 0.25%)相比,Accuracy 绝对提高 0.36 个百分点,估计效应量为 1.42,对应幅度适中但具有统计意义的改进。其他指标表现出类似趋势,说明所提出方法在该实验平台上同样具有较强的融合有效性和鲁棒性。与 Weighted-DS 的性能差距更大(提高 0.50 个百分点,效应量 ),相对于 Soft-Voting 的改进为 0.52 个百分点( )。这些结果表明,对于单源模型性能已接近上限的 IB 数据集,简单拼接或等权重策略很难进一步提升性能,而冲突感知、可靠性校准的决策级融合方案仍然能够提取稳定且不容忽视的增益。
表 8. IB 数据集上不同方法的整体性能比较。
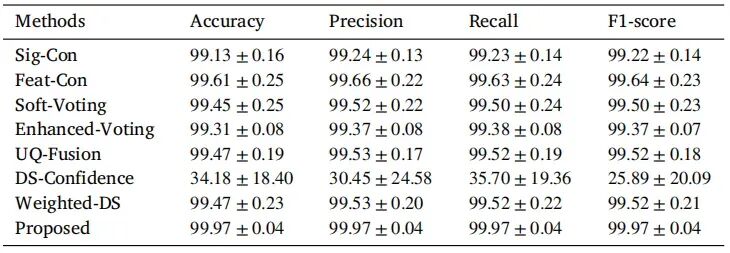
值得注意的是,DS-Confidence 在该数据集上仍然失效,其平均性能和方差均明显恶化。推测其根本原因与实验 1 中观察到的现象一致。由于 IB 数据集具有较高的可分性,许多方法在高 SNR、无传感器缺失的理想条件下,都能接近“近乎完美”的性能区域。在这种接近饱和的状态下,方差差异及长尾样本上的表现就具有更强的区分性。所提出方法的标准差最小,表明其在极端样本上具有更高的稳定性,后续鲁棒性实验进一步证实了这一点。
(2)抗噪声分析
噪声鲁棒性结果如图 9 所示。除 PINK 噪声在低 SNR 区间(0–10 dB)的情况外,所提出方法在 0–30 dB 的整个 SNR 范围内均位居第一。在 10 dB 时,该方法的性能已接近 100%,而大多数基线需要更高的 SNR 才能收敛到性能上限(参见各子图右上角的放大视图)。与此同时,所提出方法始终保持更优的性能和更小的波动,体现出其能够自动降低不可靠或受污染证据的权重,并突出稳定证据。这种行为与仅对预测进行平均的 Soft-Voting 形成鲜明对比,其表现也优于 UQ-Fusion。
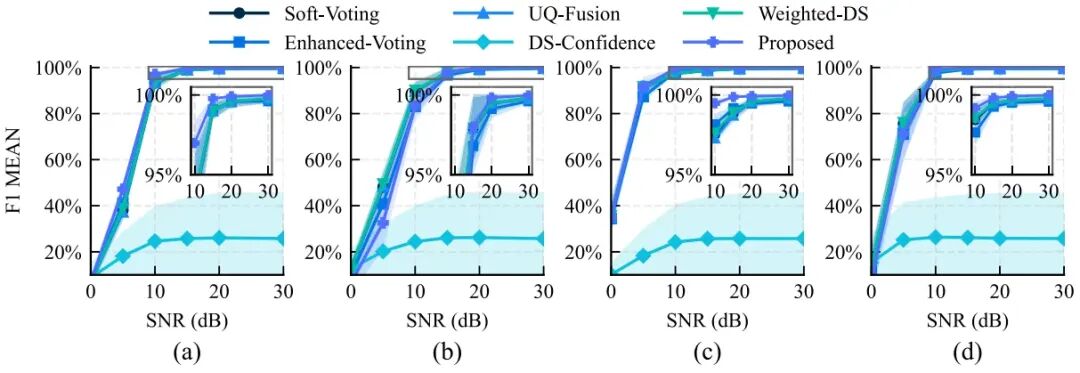
图 9. IB 数据集上的噪声鲁棒性分析。(a)AWGN;(b)PINK;(c)BAND;(d)IMPULSE。阴影区域表示五次运行的标准差。
(3)传感器缺失分析
传感器缺失实验结果如图 10 所示。随着缺失概率 从 0.1 增大到 0.7,所提出方法在 时仍将 Accuracy 和 F1 维持在“接近完美”的区间。不同方法的散点分布显示,所提出方法具有更高的中位数和更小的离散程度。当 时,所有方法均开始明显退化;然而,所提出方法的下须线更短、离群点更少,说明其对于极端缺失情形具有更强的抵御能力。随着 增大,Soft-Voting 的性能下降更快,而 UQ-Fusion 在高缺失率条件下的鲁棒性有限。DS-Confidence 再次表现出较大的波动和显著的性能退化;有趣的是,当缺失率变得非常高时,其性能略有改善,这可能是因为模型间冲突减少,从而在一定程度上缓解了其固有的不稳定性。这些观察 结果与工程实践一致:在样本级和通道级独立缺失的场景中,显式冲突管理结合可靠性校准的效果优于简单 平均和静态加权。这一结论与案例 1 一致,并且在高性能(接近上限)的数据集上得到了进一步验证。
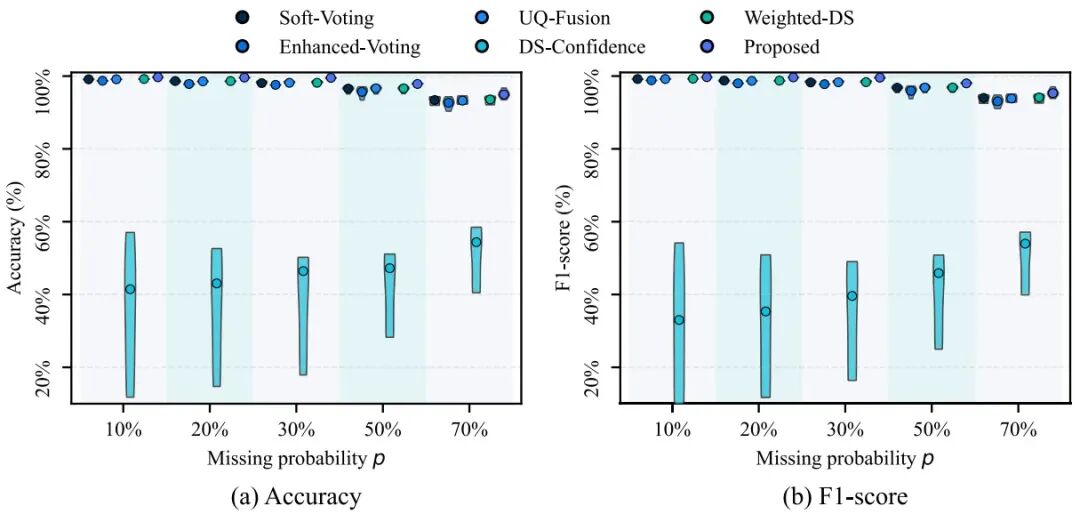
图 10. IB 数据集上的传感器缺失分析。(a)准确率;(b)F1 分数。
(4)跨工况分析
为了进一步评价所提出框架在未见工况下的泛化能力,开展了跨工况验证实验。具体而言,将 IB 数据集中转速为 1500 rpm、载荷为 2 kN 和转速为 1500 rpm、载荷为 3 kN 的工况样本用于测试,分别记为 UC1 和 UC2;其余工况的样本用于训练。参与比较的方法限定为其他决策级融合方法。实验结果汇总于表 9。
表 9. 不同方法在未见工况下的准确率比较(均值 ± 标准差,%)。
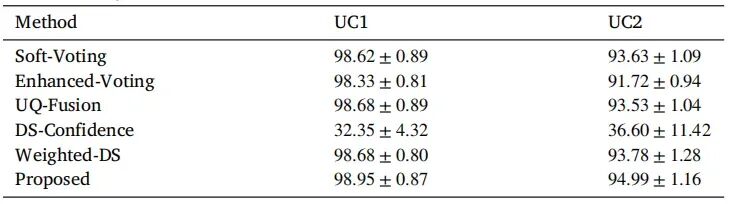
如表 9 所示,所提出方法在两个未见工况下均取得最高的平均准确率,UC1 达到 98.95%,UC2 达到 94.99%。与最强基线 Weighted-DS 相比,所提出方法在 UC1 上将平均准确率提高了 0.27 个百分点,在 UC2 上提高了 1.21 个百分点。与 UQ-Fusion 相比,对应增益分别为 0.27 和 1.46 个百分点。这些结果表明,随着测试工况变得更具挑战性,所提出框架能够维持更加明显的性能优势;尤其是在所有方法的整体准确率均有所下降的 UC2 工况下,这一优势更加突出。
(5)基于 LLM 的助手性能分析
在完整的智能诊断助手系统中,LLM 与多源融合模块协作执行故障诊断,并对轴承状态生成解释。工作流包括:(1)用户通过自然语言界面发起诊断请求;(2)系统根据请求进行数据采集;(3)多源融合模块诊断采集的数据,并输出故障类别及其置信度;(4)LLM 根据诊断结果及知识库生成详细解释和报告。IB 数据集中的一个示例如图 11 所示。
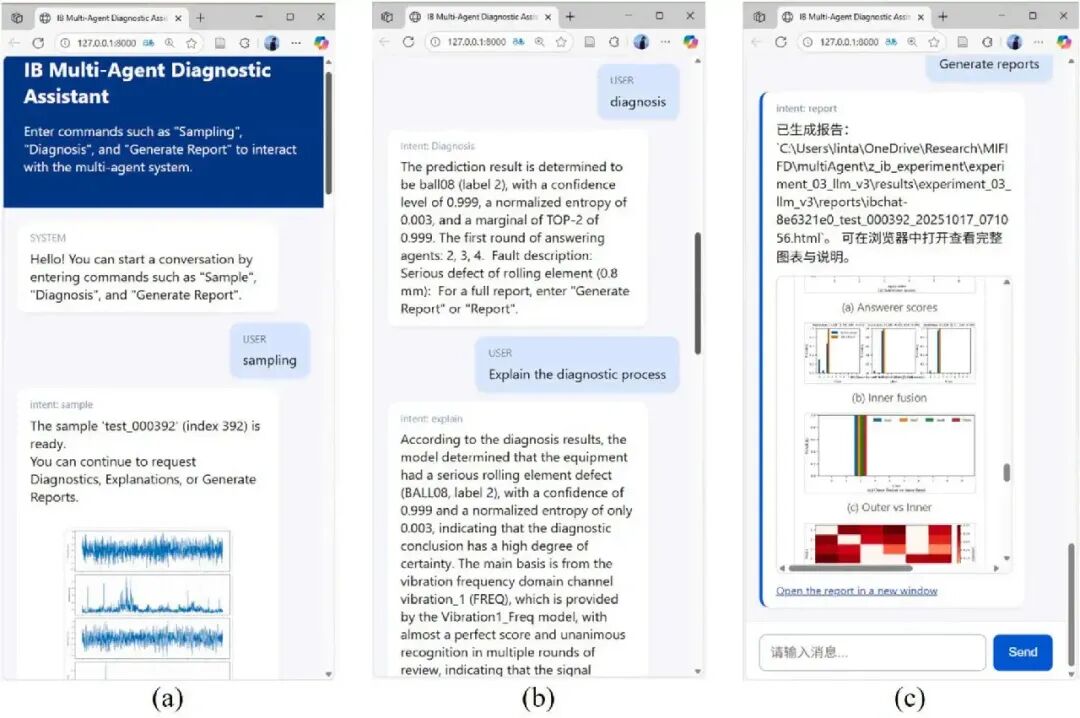
图 11. IB 数据集上 LLM 驱动的可解释融合示例。(a)采样;(b)诊断与解释;(c)报告生成。
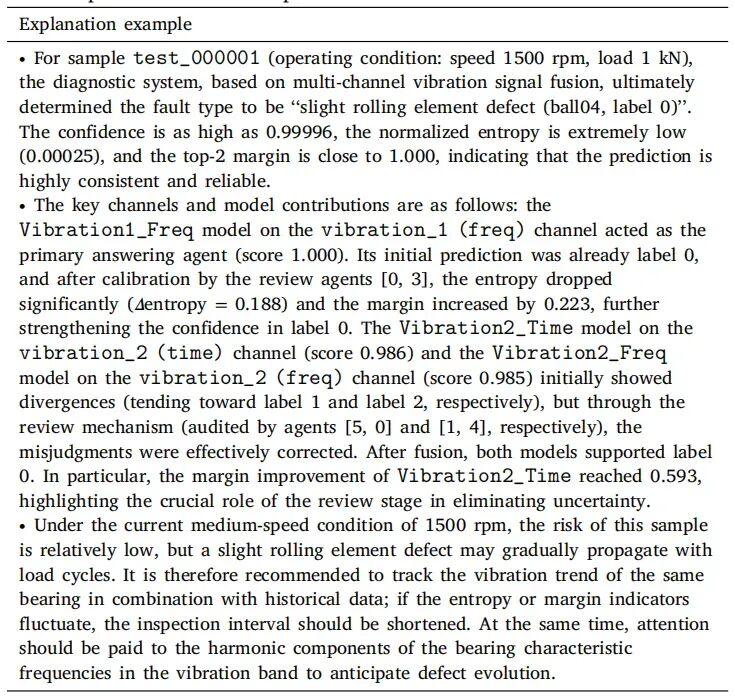
表 10 展示了一个具有代表性的模型解释示例。对于样本 test_000001,诊断系统融合多通道振动信号,最终将故障类型识别为轻微滚动体缺陷(ball04,标签 0),置信度高达 0.99996,表明预测具有高度一致性和可靠性。
表 10. IB 数据集上 LLM 驱动的可解释融合示例。
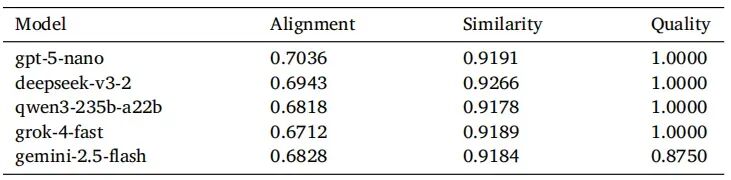
在解释任务中,将中间诊断轨迹与知识库检索结果(包括设备、传感器、模型和融合流程的信息)相结合,生成更加准确的解释与报告。底层通用 LLM 的实用性和成本效益是重要考量因素。因此,选取五种主流 LLM 的轻量化变体,对比它们在该任务上的表现。在 LLM 的实现中,模型并未部署于本地,而是通过第三方 API 服务调用。采用两个量化指标:融合对齐度(Fusion Alignment),用于衡量 LLM 生成的解释与知识库中融合流程描述之间的语义相似性;样本相似度(Sample Similarity),用于衡量同一 LLM 多次生成的解释之间的语义一致性。此外,采用 LLM-as-judge 方案评估生成解释的质量,使用表 11 中汇总的准则及关键要点。每条准则的分值为 0.125,得分越高表示解释质量越好。
表 11. LLM 生成解释的质量评价指标。
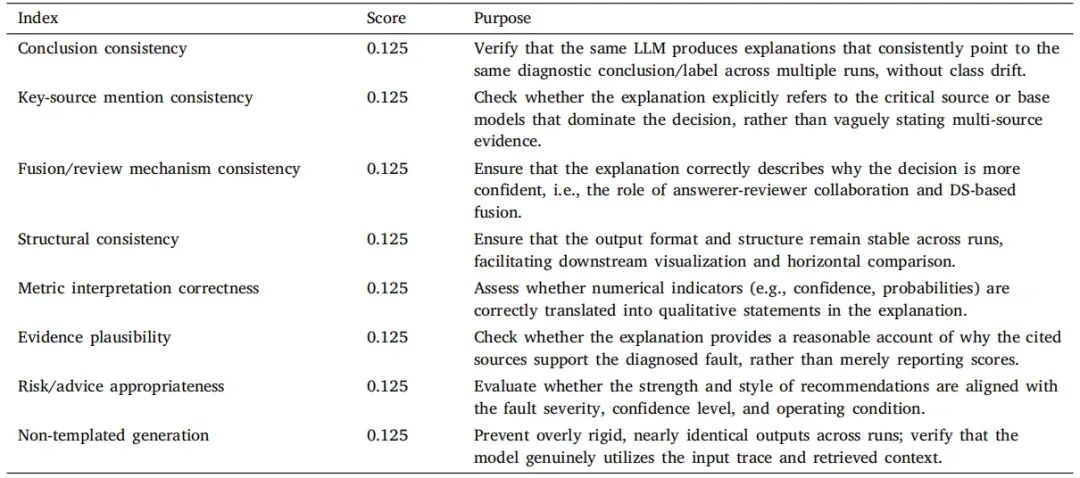
结果汇总于表 12。总体来看,所有模型的样本相似度均超过 0.917,说明所提出的基于 LLM 的多智能体诊断框架能够有效约束生成随机性,并对相似样本保持较高一致性。在此基础上,各模型在融合对齐度指标上仍存在可区分的差异,其中 gpt-5-nano 的得分最高(0.7036),说明其与所定义的多源融合流程、关键源选择策略和证据聚合过程具有更好的语义对齐程度。
在质量得分方面,除 gemini-2.5-flash(0.8750)之外,所有模型均达到 1.0000 的满分,说明这些轻量级 LLM 能够为该任务生成高质量的解释文本。综合来看,gpt-5-nano 在所有指标上取得最佳总体表现,可视为该应用的首选模型。
表 12. IB 数据集上不同 LLM 的融合对齐度和样本相似度指标比较。
(6)计算效率与部署可行性
为了评价不同决策级融合方法的计算效率及实际可部署性,在 IB 测试集上进行了效率比较。全部实验均在配备 NVIDIA RTX 4070 Ti GPU 的设备上通过 CUDA 加速运行。为保证公平比较,所有模型都预先加载到 GPU 显存中,仅测量批大小为 1 时纯诊断推理的时间。模型加载时间、离线校准时间以及可选的基于 LLM 的解释模块均不计入计时统计。
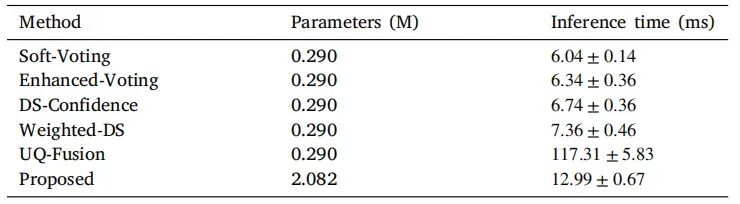
如表 13 所示,五种基线方法具有相同的参数量。这是因为它们都基于由六个诊断子模型构成的同一个基础模型池,而其融合阶段几乎没有或完全没有引入额外可学习参数。相比之下,由于引入了基于 VAE 和 GAT 的协作融合模块,所提出方法的总参数量增加至 2.082M。尽管这一数值高于纯投票或 DS 融合基线,但从绝对数值来看,整个模型的规模仍然适中。
在推理效率方面,所提出方法每个样本需要 12.99 ms。尽管慢于 Soft-Voting、Enhanced-Voting、DS-Confidence 和 Weighted-DS,但仍显著快于 UQ-Fusion。由于本文的 UQ-Fusion 实现采用了蒙特卡洛采样,因此会产生高得多的计算开销。同时,所提出方法和大多数比较方法的单样本推理时间均处于毫秒级,在实际诊断场景中的差距并不大。
表 13. IB 测试集上不同方法的参数量与单样本推理时间比较。
所提出框架进一步支持基于 LLM 的解释生成。为了描述启用解释模块后的实际开销,分析了五个代表性案例的平均时间统计结果。
如表 14 所示,诊断主流程本身每个案例仅需 0.028 s,而解释模块的额外时间成本主要由检索和 LLM 生成决定。在这些阶段中,LLM 生成在解释开销中占比最大,其次是检索;诊断阶段在总延迟中只占很小一部分。这说明所提出框架在决策诊断层面仍能保持快速响应,额外时间成本主要来自可选的高层解释服务,而不是诊断主干模型本身。
表 14. 五个代表性案例上基于 LLM 的解释流程的平均耗时统计。
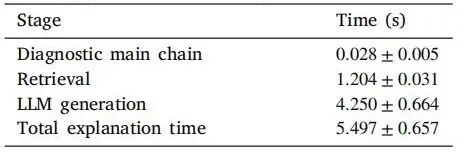
所有模型及离线校准量均在计时前预加载。解释总耗时包括检索、LLM 生成,以及提示词构建、结果封装和缓存写入等其他开销。
从部署角度来看,所提出方法的诊断延迟仍明显低于当前 0.1 s 的采样时间窗,表明其核心诊断模块在当前设定下能够满足实时在线应用要求。相比之下,解释模块的运行时间处于秒级,因此更适合按需提供面向人的解释、事后报告生成或专家辅助决策支持。
因此,该框架在实践中仍具有可部署性:前端监测环路能够维持实时诊断,而当需要可解释性或自动生成报告时,可以异步触发信息更加丰富的 LLM 解释功能。
4.3. 消融实验
4.3.1. 关键组件消融实验
在融合诊断框架中,构建四类消融基线,以量化每个组件的边际贡献:
基线 1: 不进行融合的单源诊断。在实验 1 中,变体分别为 B1-1(电流 1)、B1-2(电流 2)、B1-3(振动 1)、B1-4(力)、B1-5(转速)和 B1-6(扭矩)。在实验 2 中,变体分别为 B1-1( 轴振动时域)、B1-2( 轴振动频域)、B1-3( 轴振动时域)、B1-4( 轴振动频域)、B1-5(声学信号时域)和 B1-6(声学信号频域)。
基线 2: 不包含关系图评审机制的 DS 证据理论融合,记为 B2。
基线 3: 不使用 DS 融合的可靠性加权平均,记为 B3。
基线 4: 使用固定邻接矩阵(基于 softmax 归一化的概率相似度),不使用动态图注意力,记为 B4。
Paderborn 数据集上的结果报告于表 15。B1 揭示了不同信息源在可分性方面存在明显差异,并具有互补性:性能最好的单一信息源(振动,B1-3)的准确率达到 95.18%,而电流和转速等信息源仅达到约 35%–44%,说明单一信息源无法稳定覆盖所有故障场景。进行多源融合后,纯 DS 组合(B2)受到冲突系数 的严重影响,准确率仅为 93.54%。将 DS 替换为可靠性加权平均(B3),准确率显著提高到 96.47%。在此基础上,引入采用固定邻接关系的关系图评审机制(B4),进一步将准确率提高到 97.62%,说明关于“谁更可靠”和“谁与谁更相似”的结构化信息能够有效缓解多源冲突,并放大稳定证据。
表 15. Paderborn 轴承数据集上的消融实验(均值 ± 标准差,%)。
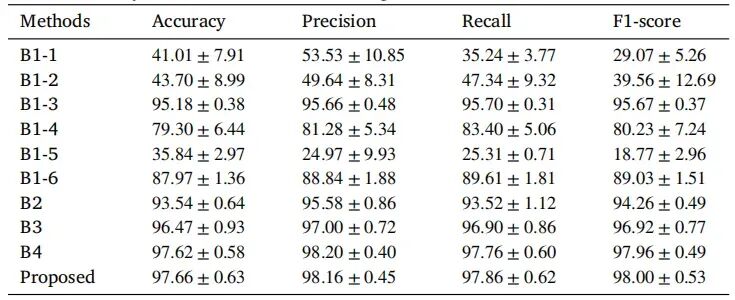
完整方法的准确率达到 97.66%。尽管与 B4 的均值差异较小,但相对于 B3 和 B2 的差距分别对应效应量 和 ,代表从中等到非常大的效应;Precision、Recall 和 F1 表现出一致的趋势。与 B4 相比,Proposed 的精确率略低,但召回率明显更高,因此在检测完整性和精确性之间取得了更好的平衡,表现出更强的适应性。总体而言,关系图评审机制和基于 DS 的冲突管理是性能增益的主要来源,动态图注意力门控则为非理想样本提供额外的鲁棒性收益,相关证据如上所述。
IB 数据集上的结果汇总于表 16。由于整体可分性较高,观察到一种“近饱和”的上限效应,多个融合方案的四项指标均接近 100%。即使在这种情况下,各组件的逐步贡献仍然清晰可见:B2、B3 和 B4 的准确率分别为 99.58%、99.76% 和 99.95%,而完整方法进一步提高到 99.97%。从统计角度来看,所提出方法相对于 B4 的增益对应一个较小的效应量( ),但相对于 B3 和 B2 的改进分别达到 和 ,表明具有明显的效应。此外,完整方法在所有四项指标上均具有最小(或并列最小)的标准差,反映出其对长尾样本具有更强的抑制能力。结合前述噪声和传感器缺失分析,可以将这些发现概括如下:当数据集接近饱和时,动态图门控的主要优势在于降低方差和收紧尾部风险;当存在明显冲突、噪声或数据缺失时,其优势则表现为平均性能更加明显的提升。
表 16. IB 数据集上的消融实验(均值 ± 标准差,%)。
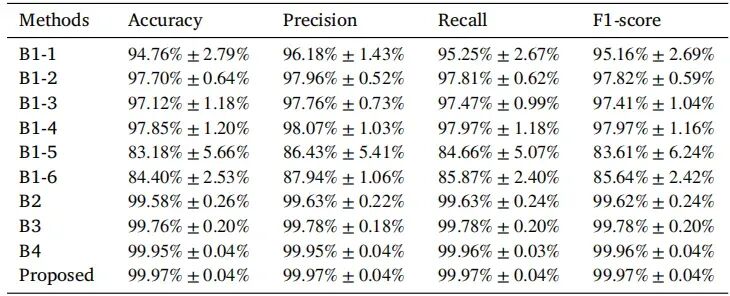
总之,两组消融实验从两个角度提供了相互一致的证据。一方面,单源模型之间的巨大性能差距证实了不同模态之间真实存在的互补性,而简单拼接或等权重融合无法充分利用这种互补性。另一方面,从 B2 → B3 → B4 → Proposed 的逐步提升清楚地表明,稳健融合增益沿着一条关键路径实现:首先通过可学习的可靠性加权抑制不可靠信息源,随后通过关系图执行结构化同行评审,最后在 DS 框架内进行冲突管理与校准。
4.3.2. 外层类别加权消融实验
为了论证第 3.2.3 节所采用的外层统一类别权重 的合理性,开展了消融实验:固定内层 DS 融合,仅改变外层类别权重。具体考察三种设置:MU,在外层采用统一类别权重;MA,在每个委员会中使用回答者的类别权重;MG,使用委员会全部成员的平均类别权重。
表 17. 外层类别加权的消融结果(准确率,均值 ± 标准差,%)。
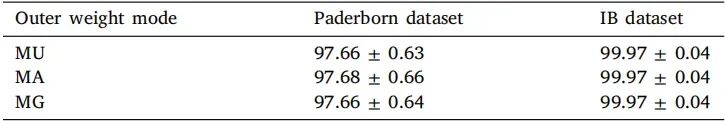
表 17 显示,三种设置在两个数据集上产生几乎完全相同的结果。这说明所提出方法对外层类别权重的具体选择并不敏感。因此,统一类别加权是一种合理的简化选择,因为类别级可靠性已在内层完成建模。
4.4. 可视化与可解释性分析
为了刻画多回答者—评审者机制的运行模式及其对不确定性的影响,本文提供评审图的统计可视化,以及评审前后概率分布的比较。图 12 和图 13 分别对应 Paderborn 数据集和 IB 数据集。
在 Paderborn 数据集上(图 12),图 12(a) 显示智能体之间存在明确的角色分工:智能体 6 在评审者一侧最为活跃,而智能体 3 和 4 更经常作为回答者出现,呈现功能专门化。图 12(b) 中,仅有少数回答者—评审者配对表现出较高的共同出现概率,反映出稀疏但稳定的评审偏好,这有利于有针对性地纠正容易混淆的类别。图 12(c) 中的平均邻接关系呈现“核心—边缘”结构,高权重集中于少量关键边,说明在高度冲突的条件下,门控机制倾向于关注少数高可靠性专家,以抑制不稳定证据的影响。
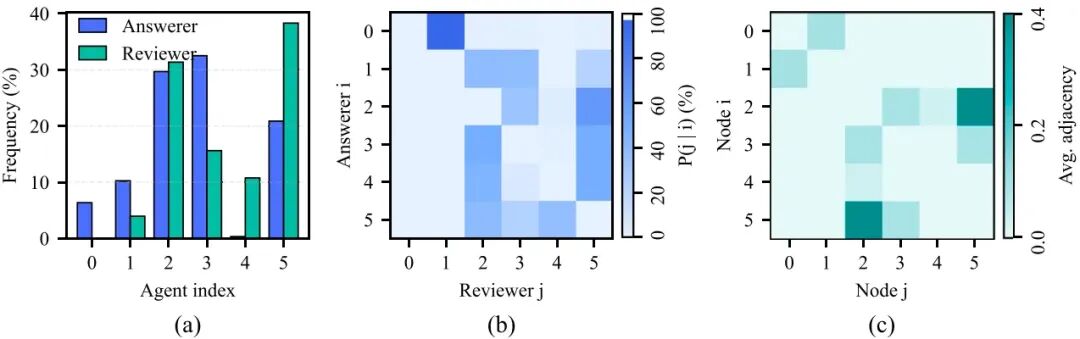
图 12. Paderborn 轴承数据集上的评审图可视化。(a)回答者和评审者出现频率;(b)回答者—评审者共同出现情况;(c)平均邻接矩阵。
相比之下,IB 数据集上的结构(图 13)更加均衡。在图 13(a) 中,回答者和评审者角色在智能体之间分布得更加均匀;图 13(b) 的共同出现矩阵更接近均匀的浅色模式,没有极亮的块;图 13(c) 的平均邻接矩阵更加稠密,分布也更加分散。这说明在类别高度可分、冲突较低的条件下,系统无需严重依赖少量核心评审者,就能维持稳定的高性能;这一点与消融及鲁棒性实验中观察到的“近饱和、低方差”现象一致。
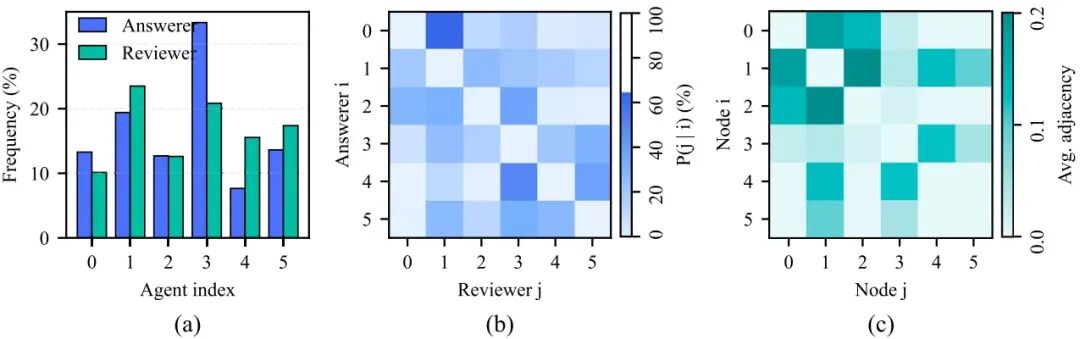
图 13. IB 数据集上的评审图可视化。(a)回答者和评审者出现频率;(b)回答者—评审者共同出现情况;(c)平均邻接矩阵。
为了量化评审过程对置信度和不确定性的影响,图 14 比较了 Paderborn 数据集上评审前后的 softmax 分布。设类别集 合 上的预测概率向量为 ,最大类别概率为 ,真实类别概率为 ,归一化熵为:
并定义真实类别概率增量 。如图 14(a)–(b) 所示,评审后, 和 的密度分布均向右移动,且峰值更加集中,说明输出置信度显著提高,增益主要集中在真实类别上。图 14(c) 显示, 主要集中于正值区间,证实评审机制系统性地增强了真实类别概率。图 14(d) 中, 的分布明显向左移动,尾部也更加收紧,意味着预测不确定性受到有效抑制。结合关系图中观察到的“核心—边缘”模式,可以将这些现象归因于评审过程中的冲突识别与可靠性校准:不可靠信息源被降低权重,稳定证据被放大,因此在提高最终决策可解释性和鲁棒性的同时,也改善了准确率与校准表现。
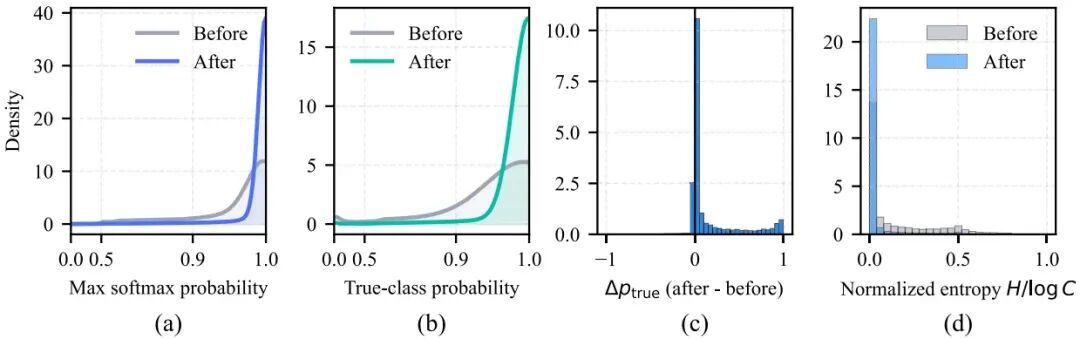
图 14. Paderborn 轴承数据集上评审前后 softmax 分布的比较。(a)最大类别概率;(b)真实类别概率;(c)真实类别概率变化;(d)不确定性(熵)变化。
4.5. 参数敏感性
4.5.1. 最大回答者数量与评审者数量的敏感性
图 15 和图 16 展示了每个样本的最大回答者智能体数量 对整体性能的影响。在 Paderborn 数据集上,平均准确率随 增大而缓慢提升,随后趋于饱和,在 附近达到最优。与此同时,当 时,小提琴图明显更加紧凑,长尾样本减少,说明允许更多候选回答者有助于抑制少数弱专家造成的偶然波动。
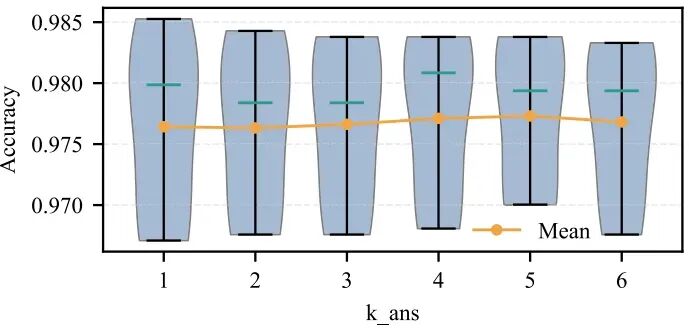
图 15. Paderborn 轴承数据集上最大回答者数量 的敏感性分析。
在 IB 数据集上,由于其可分性更高、基线性能接近饱和, 对均值的影响较小,但 仍然产生最稳定的性能(方差最小或接近最小)。从机制上看, 充当上限:门控机制针对每个样本自适应地选择数量不超过 的回答者子集。当 过小时(例如 ),互补信息不足,决策容易受到单个专家偏差的影响;当 过大时(例如 ),冗余和冲突增多,边际增益可以忽略,甚至略微变为负值。综合考虑平均准确率和离散程度,两个数据集均表明 能够实现有利的折中。
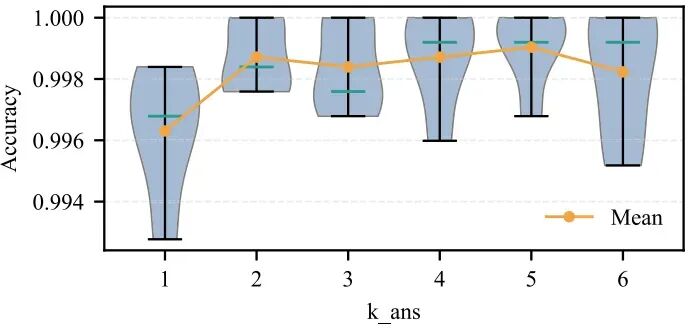
图 16. IB 数据集上最大回答者数量 的敏感性分析。
固定 后,图 17 和图 18 展示了评审者数量对性能的影响。在 Paderborn 数据集上,将评审者数量从 1 增加到 3,能够同时改善平均准确率及其置信区间;随后,在评审者数量为 3–5 的范围内,性能基本保持稳定;当评审者数量增加到 6 时,不再观察到进一步增益。这体现了“适度评审”原则:少量高质量评审者足以有效缓解回答之间的冲突,而过多评审者会引入噪声和额外计算开销。在 IB 数据集上,仅有一名评审者时获得最高的准确率和最小的方差;随着评审者数量增加,平均准确率略有下降,方差增大,表明在高度可分的条件下,过度评审可能引入不必要的复杂性和不稳定性。
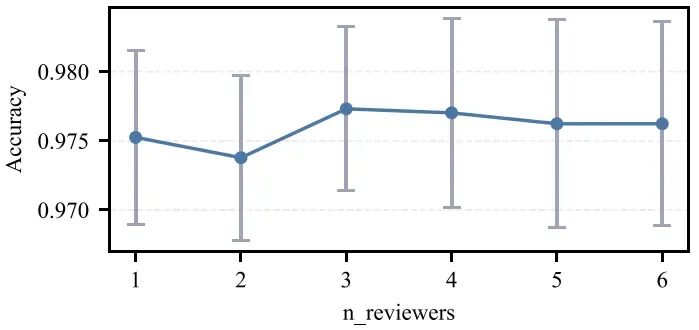
图 17. Paderborn 轴承数据集上,最大回答者数量 时的评审者数量分布。
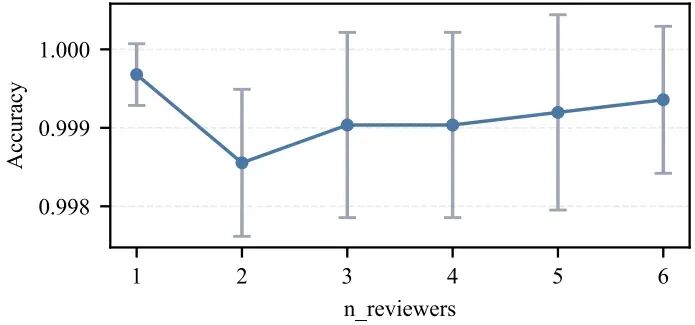
图 18. IB 数据集上,最大回答者数量 时的评审者数量分布。
总而言之,参数敏感性分析得出明确的实践指导原则:将最大回答者数量设置为 ,并采用 3–5 名评审者,能够在两个数据集上实现准确率与稳定性之间的良好平衡,同时保持较好的计算效率和可部署性。
4.5.2. 图演化步数的敏感性分析
为了研究动态图更新机制的收敛行为,以及对图演化步数 的敏感性,在 Paderborn 轴承数据集上进一步开展实验,取 。
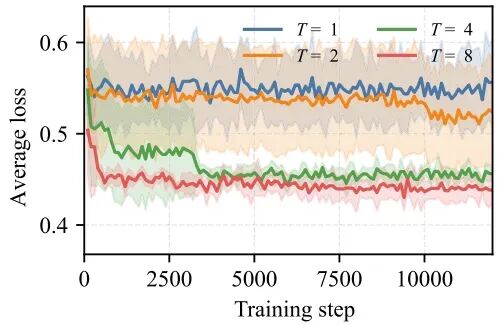
图 19. 不同 下图更新过程的收敛情况。阴影区域表示五次运行的标准差。
表 18. Paderborn 轴承数据集上 的敏感性分析(均值 ± 标准差,%)。
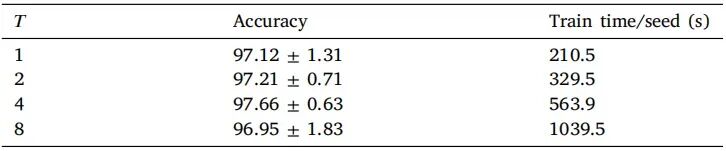
如图 19 所示,图演化步数较小的设置( 和 )表现出相对较差的收敛行为,损失停留在更高的平台,说明动态图更新执行得不够充分,无法充分细化协作拓扑并优化图一致性目标。相比之下, 和 的收敛行为更好,损失轨迹更低、更稳定,而且 时损失在训练初期下降得更快。然而,如表 18 所示,超过 后,这种优化行为的改善并未转化为更好的诊断性能,同时还导致计算成本显著增加。虽然更大的 会使图一致性目标更容易拟合,但这并不必然带来更高的分类准确率。这说明过度增加图演化步数,主要是在付出更多训练时间的代价下改善辅助图优化过程的拟合效果,而非进一步提高最终诊断任务的性能。
5. 结论
本文提出一种图驱动的多源证据融合框架,将基于 VAE 的全局状态建模、基于 GAT 的自适应智能体编排以及双层 DS 决策融合方案有机结合,形成面向多源轴承信号的动态诊断机制。在此结构之上,进一步构建基于检索增强 LLM 的多智能体诊断助手,使融合结果能够转化为可验证的自然语言报告。这一设计改善了传统模型在实际现场部署中的可解释性和可审计性。
在 Paderborn 轴承数据集和 IB 实验平台上,所提出方法在准确率、召回率和 F1 分数方面均取得领先表现,同时显著降低输出方差和熵。消融实验及敏感性分析表明,基于图的评审机制能够有效抑制来自低置信度智能体的噪声,并维持稳定可靠的诊断性能。噪声和传感器缺失实验验证了该方法在非理想条件下的鲁棒性,而对 LLM 生成解释的评价则证明了所构建智能诊断助手的实际效用。
未来工作将沿三个方向展开:(1)面向更加多样化的传感器和跨设备场景开发迁移学习策略,以提升框架的泛化能力;(2)探索与工业数字孪生和实时调度系统更紧密的集成,形成诊断、预测与维护之间的闭环;(3)引入 LLM-Agent 安全审计,并系统性评价人机协作界面,以进一步确保可解释诊断的可信性