
从"天"级到"小时"级: VirtualFlow 原生 GPU 求解器做了什么

卡在算力,不卡在方法
冷板液冷要抠微通道的流阻均匀性,浸没液冷要处理气泡动力学。两条路线的技术底座是同一个:气液相变换热的仿真能力。
难题不在方程,在规模。一块冷板的微通道优化要试上百种流道;一个浸没 Tank 要做系统级热管理,得把芯片、服务器、机柜、CDU 塞进同一个模型。冷却液域网格上千万,机柜级模型直接冲到亿级。
传统 CPU 集群靠堆核堆节点,但 MPI 通信开销随核数上升越来越重,内存带宽先撞墙。很多团队的真实体验是——加机器,加速比却越来越难看。
关键在"原生"两个字
GPU 天生适合 CFD:几千个计算核心,显存带宽数倍于 CPU。但把 CPU 求解器"搬"到 GPU 上,不等于 GPU 加速——部分算子 offload 会让数据在内存和显存之间来回搬运,开销把收益吃掉大半。
VirtualFlow 的原生 GPU 求解器,整条求解链路跑在显存里。
相变冷却典型算例 · 同一算例对比
加速比约 8
1 张 GPU 对比 16 核 CPU 方案
(对标某国际主流商软)
实测案例
相变冷却散热
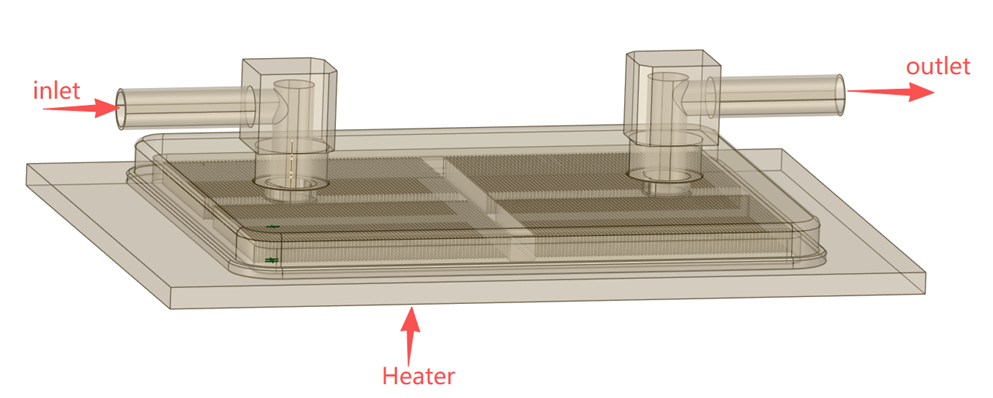
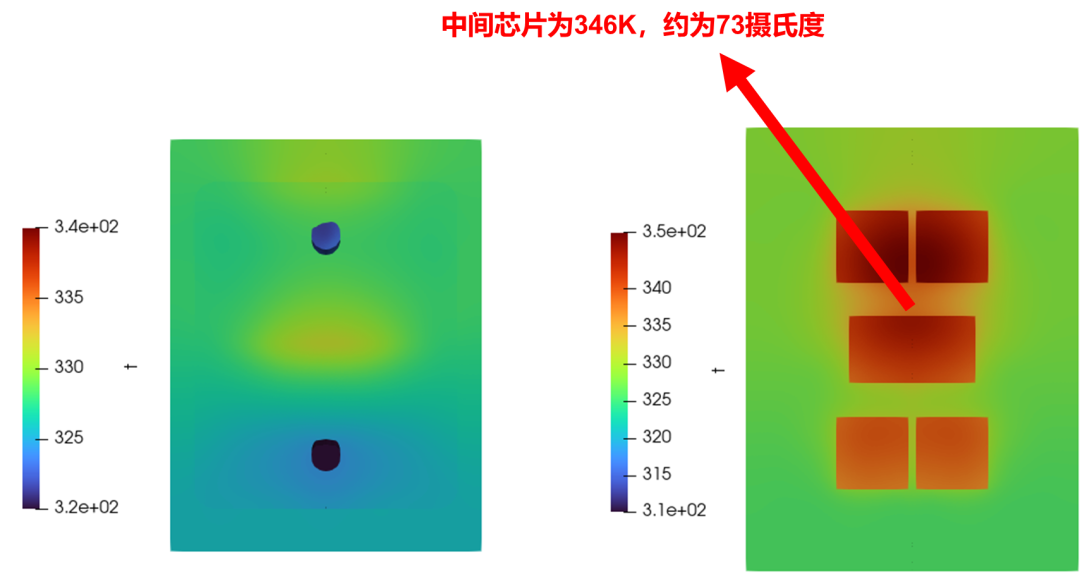
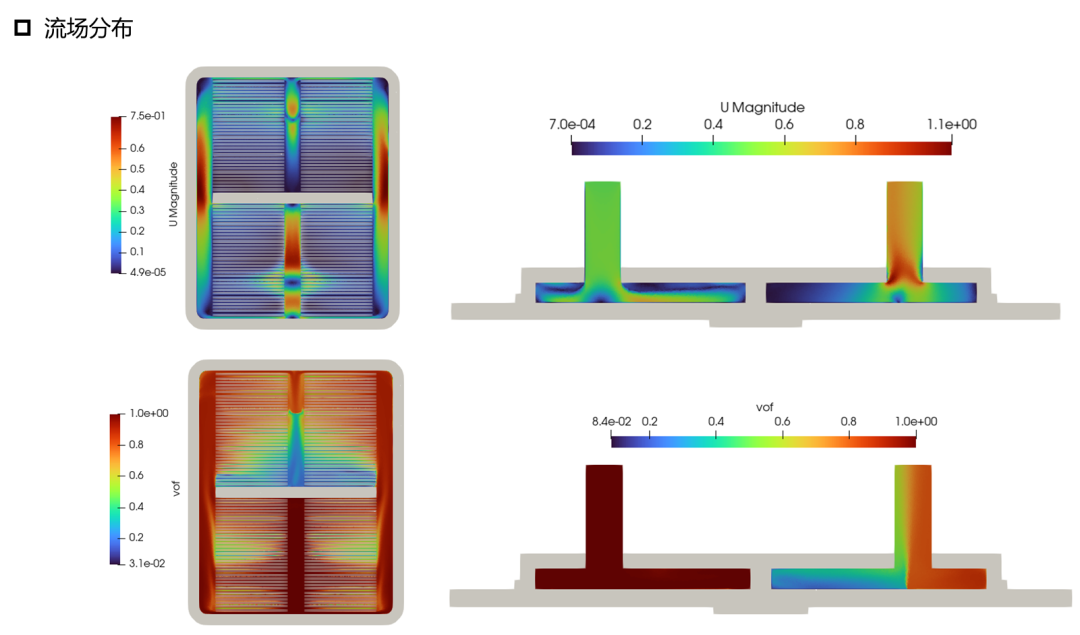
案例的输出覆盖速度场、温度场、压力场、相分布等关键物理量。
能力速览
| 维度 | 能力 |
| GPU | |
| AI | |
| UDF | |
| 模型 |
30 年开发验证历史,2000+ 工程案例。适用冷板式液冷、浸没式液冷、单相/相变换热、微通道设计。
液冷时代,仿真先行。算力这一关过了,方案迭代的节奏才会变。
登录后免费查看全文
著作权归作者所有,欢迎分享,未经许可,不得转载
首次发布时间:2026-10-23
最近编辑:41分钟前

仿真成就智造


相关推荐
最新文章
热门文章
