32 万参数的小模型,把推箱子干到了 98%

StateLeWM-0.1 更新:新增Two-room与Reacher场景,三个场景的成绩全部刷新
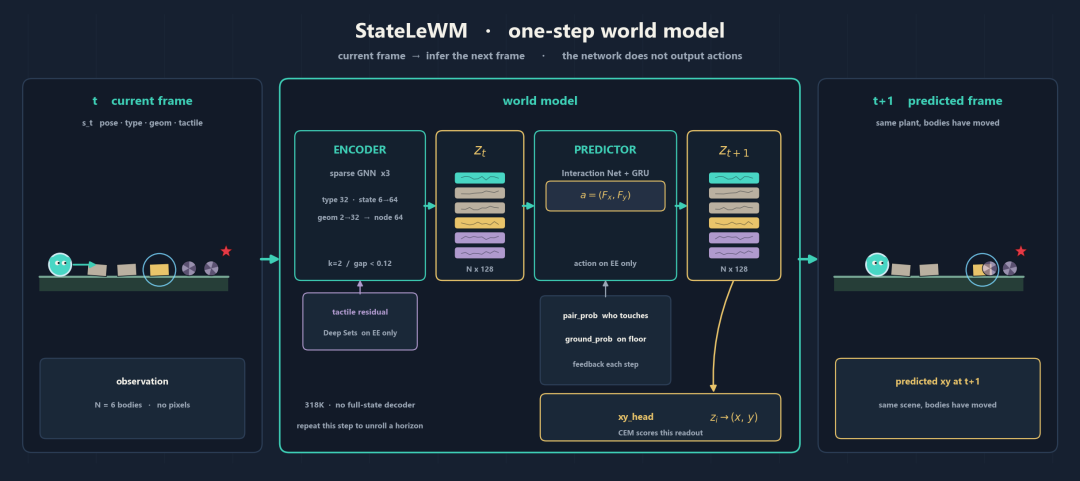
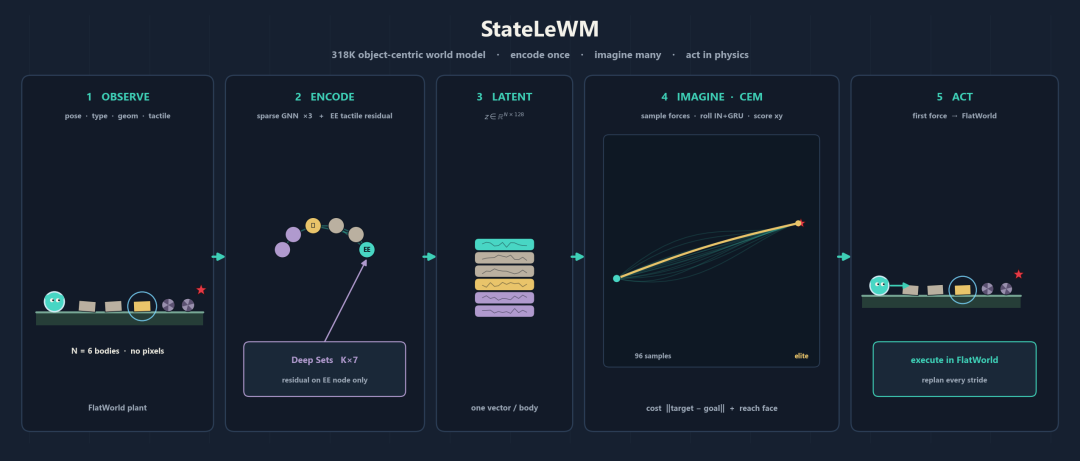
先交代一句这个模型是什么:它不学 pixels,也没有像素编码器。输入的本来就是物理状态(每个物体的位置、速度、角度、形状)再加末端执行器的触觉,输出只是"下一帧物体在哪"。整张网 32 万参数。规划时用一个 CEM:在模型脑子里想象一批力,挑最好的那个执行。
成绩单
PushToGoal(推物堆,50 局,CEM 规划 H=32)
最左目标:49/50 = 98% 最右目标:48/50 = 96% 随机目标:48/50 = 96%
Two-room(穿门,50 局):49/50 =98%
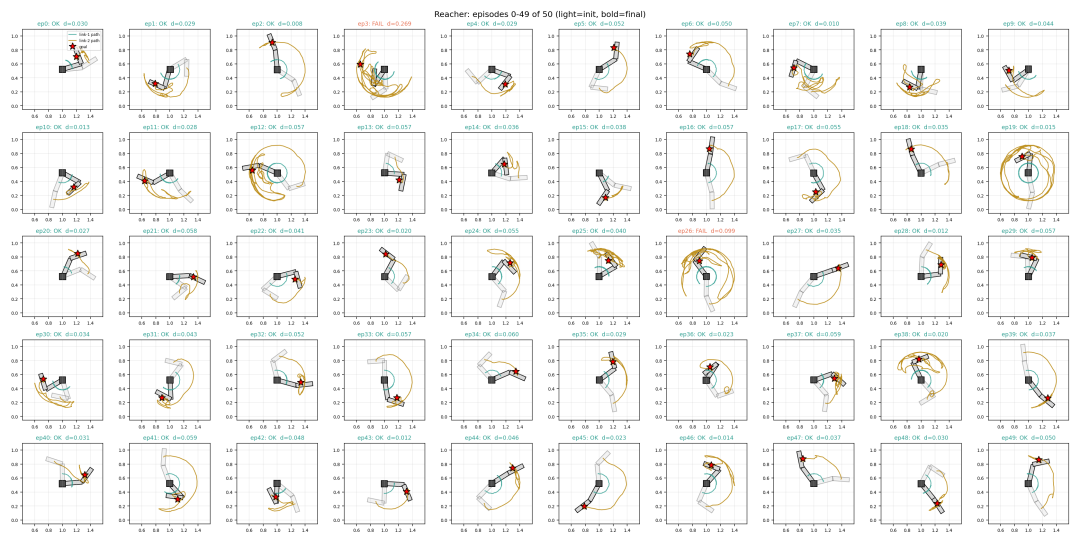
Reacher(机械臂,50 局):48/50 =96%
这次更新改了什么
1. 权重终于"各回各家"
由于现在做了多个场景,现在统一:
checkpoints/push_game/ (PushToGoal)checkpoints/two_room/checkpoints/reacher/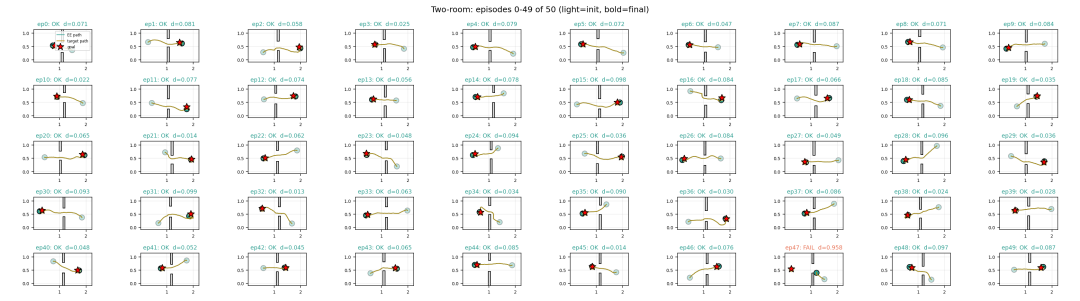
2. 两个新场景:同一套配方,只是换了场景
Two-room 和 Reacher 不是什么新架构,就是同一套配方(从随机交互里学世界模型,再用 CEM 规划)换了两类新物体:
Two-room:中间一堵墙,留一个门,目标永远在你起始房间的另一边 —— 所以模型必须自己找到门。最妙的是代价函数里压根没写"墙"这回事,全靠世界模型在脑子里想象着绕过去。 Reacher:重力下的二连杆机械臂,动作是关节角目标。
架构一个字没动,只换了数据,加了 typed edge 和 (x, y, θ) 的读出。
3. 和几个知名模型摆一起看
Two-room 和 Reacher 是像素系潜变量世界模型(LeWM 那一批)用的同名任务,所以能对上号。成功率(%):
本仓库 StateLeWM(状态 + 触觉):Two-Room 98 / Reacher 96 LeWM:87 / 86 Fast-LeWM:98 / 88 DINO-WM:100 / 79 PLDM:97 / 78
但必须说清楚:这不是同一个操场上的比赛。人家是像素输入、自己的局数和成功阈值;我们是 6 维物理状态 + 末端触觉、50 局实测。所以这只是一个量级参照,不是"我们赢了"。
所以这件事的意义在哪
32 万个参数,没有像素编码器,也没有全状态解码器,只学一件事 —— "当前帧 + 力 → 下一帧的位置"。
然后同一套配方,在三个完全不同的场景上(推一堆积木 / 穿门 / 关节机械臂)都能跑到 96%~98%。每换一个新场景,只换数据,架构不动。
这就是"状态 + 触觉"这条路的好处:当观测本身就是物理状态的时候,世界模型可以小得超乎想象。
代码和权重:https://github.com/swaggyliu/FlatWorld