
2-45 一段带噪语音,怎样用递推滤波压低噪声并对比前后频谱?
MATLAB RLS 递推滤波 + FFT 声音信号去噪分析程序
一句话介绍: 这套 MATLAB 程序读取带噪双声道语音和独立噪声样本,取第一声道后用 32 阶、遗忘因子 0.98 的递推滤波过程训练权系数,再把最终系数用于带噪语音滤波;工程同时提供 FFT 脚本,对带噪信号、噪声和滤波结果的频谱进行对照分析,并支持替换为自己的声音文件继续实验。
先看它解决什么问题
一段声音里混入噪声后,只看原始波形往往很难直接判断:
哪些变化属于语音本身;
哪些成分来自噪声;
滤波前后到底发生了什么;
某种滤波参数改变后,结果会不会随之变化。
当前工程没有调用现成的 RLS 滤波器对象,而是在 RLS.m 中直接写出权系数递推过程。
它的主链可以概括成:
独立噪声 → 构造训练信号 → 递推更新滤波器权系数 → 得到最终 32 阶权值 → 对带噪语音滤波 → 输出语音波形 → FFT 频谱对比
这里最值得读懂的并不是“画了几张图”,而是:
程序怎样先利用噪声样本得到一组滤波器系数,再把这组系数应用到实际带噪语音上。
1. 当前工程里有哪些真正参与主流程的文件?
工程很精简,核心由两个 MATLAB 脚本和几组 WAV 数据组成。
文件 | 当前作用 |
|---|---|
RLS.m | 读取噪声和带噪语音,递推训练 32 阶滤波器,并生成滤波结果 s |
freq_an alyse.m | 分别对带噪语音、噪声和 filter.wav 做 FFT 幅值谱分析 |
signalnoise.wav | 当前待处理的带噪声音 |
noise.wav | 用于训练滤波器的独立噪声样本 |
filter.wav | 工程中已经保存的一份滤波结果 |
filter5.wav | filter.wav 的约 5 倍增益版本,用于改善较小的播放音量 |
2. 当前处理的声音数据是什么规模?
对工程内 WAV 文件直接核对,可以得到:
文件 | 采样率 | 声道 | 样本点数 | 时长 |
|---|---|---|---|---|
signalnoise.wav | 48000 Hz | 2 | 158880 | 3.31 s |
noise.wav | 48000 Hz | 2 | 226080 | 4.71 s |
filter.wav | 48000 Hz | 1 | 158849 | 3.309 s |
filter5.wav | 48000 Hz | 1 | 158849 | 3.309 s |
signalnoise.wav 有 158880 个采样点,而最终 filter.wav 有 158849 个采样点,两者正好相差 31 点。
这不是偶然,因为程序使用 32 阶窗口,只有从第 32 个样本开始才能组成完整的 32 点输入向量,所以最终有效输出长度为:
158880 - 32 + 1 = 158849
这与工程内保存的 filter.wav 长度完全对应。
3. 程序为什么先拿 noise.wav 训练,而不是直接处理语音?
RLS.m 首先没有马上对语音滤波,而是读取独立的 noise.wav。
源码设定:d = 0.002
然后构造:x₁ = 10n + d
这里:
n 是 noise.wav 第一声道;
10n 把噪声幅值放大 10 倍;
d 是长度与噪声一致、值恒为 0.002 的期望输出。
所以训练阶段实际上是在建立下面的关系:
放大的噪声样本 + 很小的直流目标 → 递推调整 32 个滤波器权系数
程序注释把这个过程概括为:
“用噪声训练滤波器权系数矢量,再进行滤波。”
这意味着当前程序并不是一边播放语音、一边在线估计噪声,而是:
先使用一段独立噪声离线训练 → 再把训练结束后的固定权系数用于语音。
因此它更接近一个 RLS 思路的声音滤波实验,而不是完整的实时自适应降噪系统。
4. 32 阶递推过程到底怎样更新权系数?
程序设置:
滤波器阶数 M = 32;遗忘因子 L = 0.98;初始权系数 w = 0;初始矩阵 T = 200I。
每到一个新的噪声采样位置,先取最近 32 个点组成输入向量:
xₙ = [xₙ, xₙ₋₁, …, xₙ₋₃₁]
然后计算当前输入对应的二次量:uₙ = xₙ Tₙ₋₁ xₙᵀ
增益向量:kₙ = Tₙ₋₁ xₙᵀ / (L + uₙ)
预测误差:eₙ = dₙ - xₙwₙ₋₁ᵀ
再更新 32 个权系数:
wₙ = wₙ₋₁ + kₙᵀeₙ
直觉上可以理解成:
如果当前滤波器输出离目标值还比较远,就利用当前误差和输入方向继续修正权系数;随着样本逐个进入,权值不断被重新估计。
这也是 RLS 类递推方法和一次性固定 FIR 系数最大的区别之一:
滤波器参数不是预先写死,而是由训练数据迭代得到。
5. 遗忘因子 0.98 在这里起什么作用?
当前程序把遗忘因子固定为:
L = 0.98
简单理解,遗忘因子决定了递推过程中:
旧样本和新样本各自有多大影响。
它越接近 1,历史信息保留得越充分,参数通常变化更平稳;
减小以后,近期数据的影响会相对增强,权系数可能跟得更快,但也更容易随局部变化波动。
当前设置 0.98 属于明显偏向保留历史信息的一侧。
不过这里需要注意:
参数效果必须和当前源码实际使用的矩阵更新方式一起理解,不能只按标准 RLS 教材公式推断。
因为当前代码在协方差矩阵更新处有一个非常重要的实现差异。
6. 当前源码和标准 RLS 有什么关键差别?
这一点是理解当前程序时不能跳过的。
源码写的是:T = (T - x*k*T) / L
根据当前变量维度:x 是 1×32 行向量;
k 是 32×1 列向量;x*k 因而是一个标量。
所以当前式子实际上相当于:
Tₙ = [Tₙ₋₁ - (xₙkₙ)Tₙ₋₁] / L
也就是用一个标量整体缩放矩阵 T。
而标准 RLS 中更常见的逆相关矩阵递推结构是:
Tₙ = [Tₙ₋₁ - kₙxₙTₙ₋₁] / L
两者最明显的差别是乘法顺序:
当前代码:x*k*T
标准形式:k*x*T
后者的 k*x 是 32×32 矩阵,会产生真正的秩一修正;当前实现中的 x*k 却只是标量。
由于初始值又是:
T = 200I
因此按当前源码运行时,T 会一直保持“标量 × 单位阵”的形式,只改变整体尺度,而不会像标准 RLS 那样形成完整的相关矩阵结构。
所以更准确的表述应该是:
工程以 RLS 递推结构为设计思路,但当前T更新公式与经典标准 RLS 存在关键实现差异。
这不妨碍我们分析当前程序实际输出,但如果后续用于严格的算法验证或论文复现,建议首先核对这一行。
7. 训练结束后,程序怎样真正处理带噪语音?
噪声训练循环结束后,程序保留最后得到的 32 个权系数 w。
随后重新遍历 signalnoise.wav。
每一个输出样本都由最近 32 个带噪语音点加权得到:
sₙ = Σⱼ₌₁³² wⱼ · xnₙ₋ⱼ₊₁
因此这里本质上已经变成一个使用最终权值的:
32 阶 FIR 加权滤波器。
完整关系是:
noise.wav→ 递推训练w→ 固定最终w→ 对signalnoise.wav做 32 点滑动加权 → 得到s
按当前源码对提供的音频进行等价复算。
等价复算结果与现有 filter.wav 的波形相关系数约为 0.9998,说明工程内保存的 filter.wav 与当前这套权系数递推及滤波流程高度一致。
8. 当前滤波结果最直观的变化是什么?
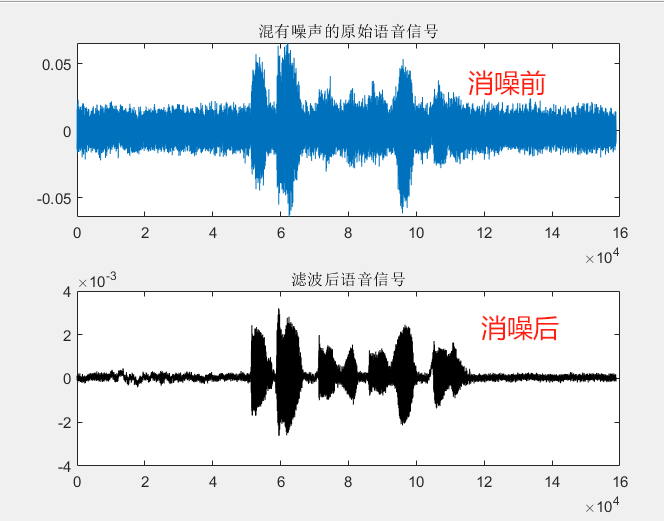
首先是输出幅值明显减小。
以第一声道归一化后的 RMS 作为幅值尺度核对:
信号 | RMS |
|---|---|
signalnoise.wav | 约 0.00917 |
filter.wav | 约 0.000423 |
filter5.wav | 约 0.00211 |
也就是说,filter.wav 的整体 RMS 只有输入带噪信号的大约:1 / 21.7这和工程备注完全吻合。
当前滤波器对原始带噪信号进行了很强的幅值与频谱重塑,但定量的语音保真度和 SNR 改善仍缺少干净参考信号验证。
9. FFT 脚本怎样比较滤波前后的频率成分?
freq_ana lyse.m 分三次读取:
signalnoise.wav、noise.wav、filter.wav
每次都只取第一声道,然后调用:fft
再使用:abs(X)得到频谱幅值。
频率轴由:f = (0:N-1)Fs/N直接生成。
因此脚本做的是:
带噪语音 FFT → 噪声 FFT → 滤波语音 FFT
这样可以从频域观察:
原始混合信号有哪些主要成分;
独立噪声集中在哪些频率;
滤波以后原来的频谱结构发生了怎样的变化。
对工程当前文件重新核对,signalnoise.wav 和 noise.wav 的较强频谱峰值主要分布在约 1.6~3.3 kHz 一带,而 filter.wav 中最强的一批频率成分转移到约 105~308 Hz 的较低频区域。
这说明当前滤波结果确实大幅改变了输入的频谱组成。
但同样需要保留一个判断边界:
频谱发生变化可以用来观察滤波效果,却不能在没有干净语音基准的情况下自动等同于“所有被削弱的频率都是噪声”。
10. 为什么第三组 FFT 要把滤波结果乘以 5?
freq_ana lyse.m 对滤波结果使用的并不是:
fft(s_single)
而是:
fft(5*s_single)
这里的 5 并没有重新改变滤波器。
它只是把已经很小的滤波后信号幅值整体放大以后再绘制频谱,使曲线更容易观察。
如果时域信号整体乘 5,那么 FFT 幅值也会整体乘约 5,但:频率位置不会因此发生变化。
所以这一处理更准确地说是:频谱显示增益,而不是新的去噪步骤。
也正因为第三条频谱被乘了 5,三张频谱图的纵轴幅值不能在不说明缩放关系的情况下直接做绝对值比较。
真正更适合观察的是:主要频率位置、频谱形状以及能量分布变化。
11. 当前频谱分析还有哪些实现边界?
freq_ana lyse.m 可以直接完成基本 FFT 对比,但有三个细节值得注意。
第一,当前画的是完整 FFT 频率轴
程序使用:0 → 接近 Fs的完整频率范围,而不是语音分析中常见的:0 → Fs/2单边频谱。
对于实信号来说,后半部分会包含与前半部分对应的共轭镜像信息。
如果后续重点分析语音有效频率,更常见的做法是只保留 Nyquist 频率以前的单边谱。
第二,幅值没有按样本数统一归一化
当前直接绘制:abs(fft(x))
因此不同长度文件的绝对频谱幅值会同时受到样本点数影响。
这套工程里的输入长度本身就不同:
噪声:226080 点;
带噪语音:158880 点;
滤波结果:158849 点。
所以当前图非常适合观察“形状”,但如果要做严格的幅值定量对比,最好先建立统一的归一化规则。
第三,滤波结果又额外乘了 5
因此第三组频谱纵轴进一步带有显示增益。
当前 FFT 更适合作为:滤波前后频率分布的直观对照工具,而不是已经严格标定的功率谱测量程序。
12. 当前源码还有哪些运行时要特别注意的地方?
除了前面的 RLS 矩阵更新差异,还有三个直接影响使用的细节。
RLS.m 默认不会重新写出 filter.wav
源码最后两行是:
% audiowrite(s,Fs,'filter.wav');
% audiowrite(5*s,Fs,'filter5.wav');
也就是说,这两个保存动作目前都被注释掉了。
因此直接运行 RLS.m:
会在 MATLAB 工作区里重新算出s,但不会更新磁盘上的filter.wav。
紧接着运行 freq_an alyse.m 时,它读取的仍然可能是工程原来附带的旧 filter.wav。
如果希望 FFT 分析严格对应刚刚这一轮的新结果,应先取消对应的 audiowrite 注释,或者自己把 s 保存成 filter.wav。
备注文件与 FFT 脚本使用的文件名并不完全一致
备注中写的是:
filter_singnal滤波后的语音信号.wav
但 freq_an alyse.m 实际读取:
filter.wav
因此替换或整理文件时,应以脚本真实读取的文件名为准,或者同步修改 audioread 路径。
e 曲线不能直接当作严格对齐的输出残差
滤波阶段虽然继续写 e,但代码使用:
xn(n-M+1)-s(n-M+1)
而当前的 s(n-M+1) 实际由一直到 xn(n) 的 32 点窗口计算得到,两者在时间索引上并没有严格对齐。
同时数组 e 还复用了前面噪声训练阶段的长度。
所以程序绘制的“误差”更适合作为代码中的辅助观察量,不宜直接拿它计算严谨的滤波误差指标。
13. 想换成自己的声音文件,需要改什么?
这套工程支持更换音频,而且不需要修改核心循环。
最直接的方法是准备:一段自己的带噪声音;一段用于训练的噪声声音。
然后分别替换:signalnoise.wav和:noise.wav
程序会自动通过 audioread 获取声音长度。
不过为了让结果有可比性,建议自己的数据至少满足:
两个文件使用相同采样率;
采样率与后续频谱分析保持一致;
两个文件至少有 32 个采样点;
噪声样本能够代表待处理声音中真正想抑制的噪声特征;
如果是多声道文件,要知道当前程序只处理第一声道;
不要让两个文件的幅值尺度相差过于悬殊。
如果修改了文件名,则需要同步修改 RLS.m 和 freq_an alyse.m 中的 audioread 路径。
尤其要注意:
替换新语音以后,应重新运行权系数训练、重新保存filter.wav,然后再执行 FFT 分析,否则频谱脚本可能仍在分析旧输出。
14. 哪些参数最值得修改?
当前代码里的数值很多,但真正会明显改变滤波行为的主要是下面几项。
参数 | 当前值 | 为什么值得改 | 调整后的主要影响 |
|---|---|---|---|
M | 32 | 决定 FIR 权系数数量和时间窗口长度 | 增大会提升模型自由度,同时增加计算量和过拟合、收敛问题的可能 |
L | 0.98 | 控制历史样本在递推中的保留程度 | 越接近 1 越重视长期数据,减小时近期数据影响更大 |
噪声增益 | 10 | 直接改变 RLS 训练输入 x1 的尺度 | 会改变递推增益、权系数和最终输出幅值 |
d | 0.002 | 是训练阶段固定的期望输出 | 修改后会改变滤波器试图逼近的目标及最终权值 |
T 初值 | 200I | 决定递推开始阶段的矩阵尺度 | 会影响前期增益和参数调整速度 |
其中最值得优先实验的是:
M、L和训练噪声本身。
因为即使保持同一套代码,只要换了一种噪声环境,原来训练得到的 32 个权系数也未必仍然适合新的声音。
15. 怎么运行这套程序?
先运行:RLS程序会读取两段声音、完成递推训练并生成滤波后的数组 s,随后显示带噪语音、滤波语音和误差曲线。
如果只是查看工程自带结果,可以直接继续运行:freq_an alyse
它会读取现有的 filter.wav 并绘制三组 FFT 频谱。
如果希望分析刚刚重新计算的新结果,则应先把 RLS.m 尾部的:
audiowrite(s,Fs,'filter.wav');
取消注释,再运行一次 RLS,确认新的 filter.wav 已经写出,然后执行:freq_an alyse
如果觉得新生成的声音播放音量过小,可以同时启用:audiowrite(5*s,Fs,'filter5.wav');
工程现有备注也明确提醒,滤波后声音本身比较小,试听时需要适当提高播放音量。
这套程序使用的主要都是 MATLAB 自带的矩阵、音频读写、FFT 和绘图功能,核心递推算法也是源码直接实现,没有依赖一个额外封装好的 RLS 算法对象。
16. 一句话看懂这个项目
这是一个声音信号递推滤波与 FFT 对比程序:当前工程以 48 kHz 的noise.wav第一声道作为训练噪声,构造x1=10n+0.002,使用 32 阶权系数、遗忘因子 0.98 和T=200I逐样本递推,再把最终权值应用到 3.31 s 的signalnoise.wav第一声道,得到 158849 点滤波结果;工程附带的filter.wav与按当前源码等价复算的输出高度一致,滤波后 RMS 从约 0.00917 降到约 0.000423,频谱也发生明显重分布,同时freq_an alyse.m可以继续比较带噪语音、噪声和滤波结果的 FFT。需要注意,当前T=(T-x*k*T)/L与经典 RLS 的矩阵更新顺序存在关键差异,输出保存语句默认又被注释,因此这套程序更适合作为递推滤波、语音去噪和 FFT 分析的 MATLAB 实验案例;如果用于严格算法评价,还应修正 RLS 更新形式,并加入干净语音基准、SNR 等定量指标。


