初学者入门教程|| 手把手带你入门各种深度学习网络(上)
目录
0 引言
1 全连接神经网络MLP
1.1 MLP是什么?
1.2 MLP由哪些部分组成?
1.3 数据在MLP中是怎样处理的?
1.4 MLP在故障诊断中怎么使用?
1.5 MLP有什么优点和局限?
1.6 总结
2 卷积神经网络CNN
2.1 CNN是什么?
2.2 CNN由哪些部分组成?
2.3 数据在CNN中是怎样处理的?
2.4 CNN在故障诊断中怎么使用?
2.5 CNN有什么优点和局限?
2.6 总结
3 循环神经网络RNN
3.1 RNN是什么?
3.2 RNN由哪些部分组成?
3.3 数据在RNN中是怎样处理的?
3.4 RNN在故障诊断中怎么使用?
3.5 RNN有什么优点和局限?
3.6 总结
4 图神经网络GNN
4.1 GNN是什么?
4.2 GNN由哪些部分组成?
4.3 数据在GNN中是怎样处理的?
4.4 GNN在故障诊断中怎么使用?
4.5 GNN有什么优点和局限?
4.6 总结
5 注意力网络Transformer
6 编码与重构网络
7 生成模型
注:小编能力有限,如有不恰之处,请多多指正~
0.引言
随着传感器技术、工业互联网和计算能力的发展,机械设备运行过程中产生了大量振动、电流、声音、温度和压力等监测数据。如何从这些数据中准确提取设备状态特征,并及时识别潜在故障,已经成为智能故障诊断领域的重要研究内容。
传统故障诊断方法通常依赖人工提取时域、频域或时频域特征,再结合支持向量机、决策树等机器学习方法进行分类。这类方法具有较好的可解释性,但诊断效果往往依赖研究人员的经验和特征设计能力。当数据规模增大、运行工况复杂或故障特征不明显时,人工设计特征可能难以充分描述设备状态。
深度学习通过构建多层神经网络,可以直接从原始数据或低层特征中学习更加复杂的特征表示,实现从数据输入、特征提取到故障分类的端到端建模。目前,深度学习已经广泛应用于轴承、齿轮箱、电机、风力发电机和船舶综合电力系统等设备的故障诊断。
需要注意的是,深度学习并不是某一种固定网络,而是包含多种网络结构和学习方式。不同网络具有不同的信息处理特点:
MLP通过全连接层学习特征之间的非线性关系; CNN通过卷积提取局部特征; RNN通过隐藏状态建模时间依赖; GNN通过节点与边描述设备或传感器之间的关系; 注意力机制能够突出重要特征并建立不同位置之间的联系; 编码与重构网络通过压缩和恢复数据学习潜在特征; 生成模型通过学习数据分布生成新的样本。
本系列将按照“基本概念—网络结构—数据处理流程—故障诊断应用—优点与局限”的逻辑,依次介绍全连接神经网络MLP、卷积神经网络CNN、循环神经网络RNN、图神经网络GNN、注意力网络、编码与重构网络以及生成模型。
需要特别说明的是,这些网络并不是相互独立或彼此替代的。在实际故障诊断中,CNN、RNN、注意力机制和GNN等经常组合使用。例如,CNN可以提取局部振动特征,LSTM可以进一步建模时序关系,注意力机制可以突出关键时间步,MLP则负责完成最终分类。
因此,理解不同网络的关键,不只是记住网络名称,而是弄清楚三个问题:输入数据是什么形式?网络通过什么方式提取信息?这种结构适合解决什么故障诊断问题?掌握这些基本逻辑后,面对CNN-LSTM、CNN-BiLSTM-Attention、时空图神经网络等复杂模型时,就能够看清各个模块在网络中的实际作用。
1 全连接神经网络MLP
1.1 MLP是什么?
这一部分主要解决:MLP到底是什么?它在深度学习中处于什么位置?MLP的英文名称是Multi-Layer Perceptron,中文名称是多层感知机。它是一种由多个全连接层组成的前馈神经网络。所谓前馈,是指数据按照固定方向,从输入端逐层传递到输出端:
输入数据
→ 输入层
→ 隐藏层
→ 输出层
→ 预测结果
MLP不会像RNN一样保存前一时刻的信息,也不会像CNN一样使用卷积核提取局部特征。它主要通过多个全连接层,对输入特征进行逐层变换和组合,最终完成分类或回归任务。可以用一句话概括: MLP通过多层全连接运算,学习输入特征之间的非线性关系,并完成分类或预测。
虽然MLP结构相对简单,但它是理解其他深度学习网络的重要基础。CNN、RNN和Transformer等网络中,也经常使用全连接层或MLP作为最终的分类模块。
1.2 MLP由哪些部分组成?
这一部分主要解决:MLP内部的网络结构是什么样的?如图1所示,一个典型的MLP通常包含三个部分:
输入层; 一个或多个隐藏层; 输出层。 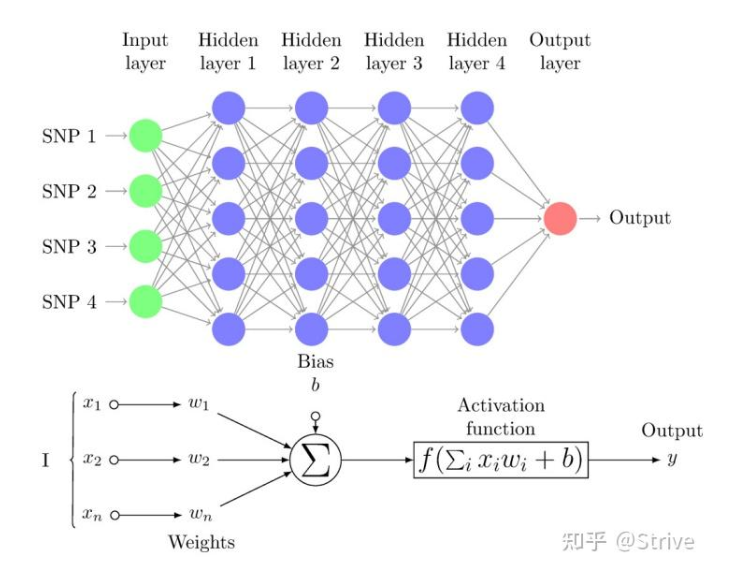
图1 MLP结构示意图
其基本结构为:
输入层
→ 隐藏层1
→ 隐藏层2
→ 输出层
例如,在一个四分类故障诊断任务中,输入样本包含10个特征,可以设计如下网络:
10维输入特征
→ 64个隐藏神经元
→ 32个隐藏神经元
→ 4个输出神经元
可以简写为:
其中:
10表示输入特征的数量; 64和32表示隐藏层的神经元数量; 4表示需要识别的故障类别数量。
例如四种状态分别为:
正常状态; 内圈故障; 外圈故障; 滚动体故障。
那么输出层就可以设置为4个神经元。
1.2.1 输入层
输入层负责接收数据。
MLP的输入通常是固定长度的特征向量,例如:
在故障诊断中,输入可以是:
均值; 标准差; 均方根; 峭度; 偏度; 峰值因子; 频谱能量。
1.2.2 隐藏层
隐藏层位于输入层和输出层之间。它的主要作用是:对输入特征进行组合、变换和提取,形成更适合分类的中间特征。需要注意的是,隐藏层描述的是网络中的位置,并不是一种固定的运算。
在MLP中,隐藏层通常是全连接层。
在CNN中,卷积层也可以是隐藏层。
在RNN中,LSTM层也可以是隐藏层。
1.2.3 输出层
输出层负责给出最终预测结果。如果是四分类任务,输出层通常包含4个神经元,每个神经元对应一个类别。
1.3 数据在MLP中是怎样处理的?
这一部分主要解决:输入数据进入MLP以后,具体发生了什么? MLP中的数据处理可以分为以下几个步骤。
1.3.1 加权求和
假设一个神经元接收到多个输入:
每个输入都有对应的权重:
神经元首先进行加权求和:
其中, 表示偏置。也可以写成矩阵形式:
1.3.2 激活函数
加权求和后的结果会送入激活函数:
常见的激活函数包括:
ReLU; Sigmoid; Tanh; Leaky ReLU; GELU。
MLP隐藏层中最常用的是ReLU:
激活函数的主要作用是引入非线性。如果MLP中的每一层都只进行线性变换,那么无论堆叠多少层,最终仍然可以等价为一次线性变换。因此,激活函数使MLP具备学习复杂非线性关系的能力。
1.3.3 逐层传播
假设MLP结构为:
第一层隐藏特征可以表示为:
第二层隐藏特征可以表示为:
输出层为:
输出结果:
这些输出值通常称为Logits,也就是网络对不同类别给出的原始分数。
1.3.4 输出类别概率
通过Softmax,可以将Logits转换为类别概率:
例如:
正常状态:0.03
内圈故障:0.85
外圈故障:0.08
滚动体故障:0.04
概率最大的类别就是模型的预测结果。
1.3.5 训练网络
MLP的训练过程可以表示为:
输入训练样本
→ 前向传播
→ 得到预测结果
→ 计算损失
→ 反向传播
→ 更新网络参数
在分类任务中,输入数据首先经过MLP进行前向传播,得到每个类别对应的原始分数,也就是Logits;随后,Softmax可以将这些分数转换为各类别的预测概率;接着,交叉熵损失函数会将预测结果与真实标签进行比较,计算模型当前的分类误差;最后,Adam或SGD等优化器根据反向传播得到的梯度更新MLP中的权重和偏置,使模型在不断训练后逐渐减小分类误差并提高识别准确率。
1.4 MLP在故障诊断中怎么使用?
这一部分主要解决:MLP在实际故障诊断任务中,输入什么数据?输出什么结果?MLP在故障诊断中的使用方式主要有两种。
1.4.1 直接对人工特征进行分类
首先从原始振动信号中提取特征,例如:
均值; 标准差; 均方根; 峭度; 偏度; 峰值因子; 波形因子; 频带能量。
然后将这些特征组成一个固定长度的向量:
再输入MLP进行分类:
原始振动信号
→ 提取时域和频域特征
→ MLP
→ 故障类别
例如:
10个故障特征
→ Linear(10, 64)
→ ReLU
→ Linear(64, 32)
→ ReLU
→ Linear(32, 4)
→ 四类故障结果
1.4.2 作为其他网络的分类头
MLP不仅可以独立使用,也经常作为CNN、RNN和Transformer最后的分类器。
例如:
原始振动信号
→ CNN提取局部特征
→ MLP分类头
→ 故障类别
或者:
时间序列
→ LSTM提取时序特征
→ MLP分类头
→ 故障类别
还可以是:
振动信号
→ Transformer提取全局特征
→ MLP分类头
→ 故障类别
因此,MLP在故障诊断中具有两种常见身份:一种是独立的故障分类网络,另一种是复杂网络最后的分类头。
1.5 MLP有什么优点和局限?
这一部分主要解决:什么情况下适合使用MLP?什么情况下不适合?
1.5.1 MLP的优点
MLP的主要优点包括:
网络结构简单; 容易理解和实现; 训练过程相对直接; 能够学习特征之间的非线性关系; 适合固定长度的特征向量; 适合人工提取特征和表格数据; 经常作为其他深度学习网络的分类头。
对于已经提取好时域、频域或统计特征的数据,MLP通常是一种简单有效的分类方法。
1.5.2 MLP的局限
MLP的主要局限包括:
不会主动利用输入数据的局部结构; 不擅长建模时间顺序; 输入维度较大时,参数量会迅速增加; 样本较少时容易过拟合; 直接处理长振动信号时,效果不一定理想。
例如,将长度为2048的振动信号直接输入一个包含512个神经元的全连接层,其参数量为:
仅一个全连接层就包含超过100万个参数。这是因为全连接层中的每个输入,都需要与下一层的每个神经元连接。相比之下,CNN通过局部连接和权重共享,可以使用更少的参数提取局部特征。
因此:MLP更适合处理已经提取好的低维特征(人工提取特征),而原始长振动信号通常更适合使用CNN、RNN或Transformer。
1.6 总结
MLP是一种由多个全连接层组成的前馈神经网络。其基本流程为:
输入特征
→ 全连接层
→ 激活函数
→ 隐藏特征
→ 输出层
→ 分类结果
MLP的核心特点包括:
通过全连接层处理输入特征; 通过隐藏层逐步进行特征变换; 通过激活函数学习非线性关系; 可以单独用于故障分类; 也可以作为CNN、RNN和Transformer的分类头。
MLP将输入看作普通的特征向量,不能主动利用振动信号中的局部关系。 为了解决这一问题,CNN引入了局部连接和权重共享机制,这也是下一节将要介绍的内容。
MLP学习参考链接:
https://blog.csdn.net/m0_73798143/article/details/136636647
https://zhuanlan.zhihu.com/p/1988204416914985913
2. 卷积神经网络CNN
在上一节中,我们介绍了多层感知机MLP。MLP通过全连接层处理输入特征,但它会将输入数据看成一个普通向量,无法主动利用相邻数据点之间的局部关系。对于图像、振动信号、声音信号等数据,相邻位置往往具有较强联系。为了更有效地提取这些局部特征,卷积神经网络应运而生。卷积神经网络的英文名称是Convolutional Neural Network,通常简称为CNN。
2.1 CNN是什么?
CNN是一种以卷积运算为核心的深度神经网络。它通过卷积核在输入数据上滑动,自动提取局部特征,并将简单特征逐层组合为更加复杂的高级特征。CNN的基本流程可以表示为:
输入数据
→ 卷积层
→ 激活函数
→ 池化层
→ 多层特征提取
→ 分类器
→ 输出结果
可以用一句话概括:CNN通过局部连接和权重共享,从原始数据中自动提取局部特征,并完成分类或预测任务。CNN最早广泛应用于图像识别,但现在也常用于:
一维振动信号; 声音信号; 时间序列; 频谱; 时频图; 医学图像; 工业故障诊断。
在故障诊断中,CNN可以直接从原始振动信号或时频图中学习故障特征,减少对人工特征提取的依赖。
2.1.1 CNN与MLP有什么不同?
MLP中的全连接层会让上一层的每个神经元都连接到下一层的所有神经元。CNN则主要采用局部连接。例如,对于长度为1024的振动信号,卷积核可能每次只观察其中连续的5个、7个或15个采样点。CNN不会一次处理整个信号,而是通过卷积核在信号上滑动,提取不同位置的局部模式。
两者的核心区别可以概括为:
2.2 CNN由哪些部分组成?
如图2所示,一个典型的CNN通常包含以下几个部分:
输入层; 卷积层; 激活函数; 池化层; 分类头。 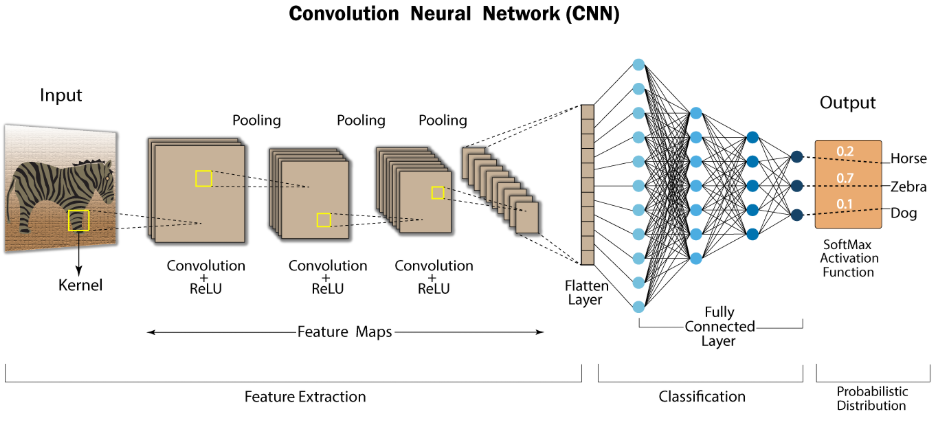
图2 CNN网络结构与计算示意图
其基本结构可以表示为:
输入
→ 卷积层
→ 激活函数
→ 池化层
→ 卷积层
→ 激活函数
→ 池化层
→ 全连接分类器
→ 输出类别
2.2.1 输入层
CNN可以处理不同形式的数据。对于一维振动信号,输入可以表示为:
其中:
表示输入通道数; 表示信号长度。
例如,单个振动传感器采集长度为2048的信号:
对于二维时频图,输入可以表示为:
其中:
表示图像通道数; 表示图像高度; 表示图像宽度。
2.2.2 卷积层
卷积层是CNN最核心的部分。卷积核会在输入数据上滑动,并与局部区域进行加权计算,卷积计算过程和原理如图3所示。
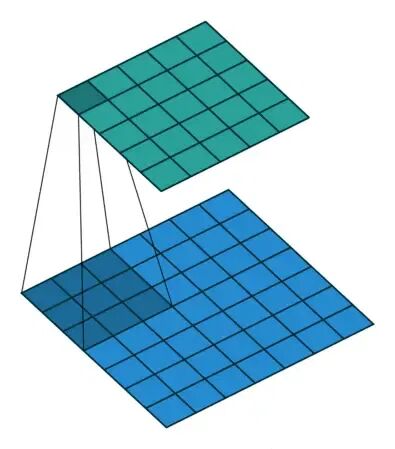
图3 卷积计算过程和原理
对于一维信号,卷积运算可以表示为:
其中:
表示输入信号; 表示卷积核参数; 表示卷积核大小; 表示偏置; 表示卷积输出。
例如,一个长度为3的卷积核:
会依次处理:
同一个卷积核会在整个信号上重复使用。 这就是CNN中的权重共享。
2.2.3 激活函数
卷积层后通常会加入激活函数,例如ReLU:
激活函数可以为网络引入非线性,使CNN能够学习复杂的故障特征。
常见结构为:
卷积层
→ 批归一化
→ ReLU
也就是:
Conv
→ BatchNorm
→ ReLU
2.2.4 池化层
池化层用于压缩特征图,减少数据尺寸和计算量。
常见的池化方式包括:
最大池化; 平均池化; 全局平均池化。
最大池化会保留局部区域中的最大值。
例如:
使用大小为2的最大池化后,可以得到:
池化层的主要作用包括:
减少特征尺寸; 降低计算量; 扩大感受野; 保留重要特征; 缓解过拟合。
不过,现代CNN并不一定都使用传统池化,也可以通过步长卷积完成降采样。
2.2.5 分类头
经过多层卷积提取特征后,CNN通常需要通过分类头输出类别。
常见分类头为:
卷积特征
→ 全局平均池化
→ 全连接层
→ 输出类别
其中,全连接层或MLP负责将CNN提取的高级特征映射为不同故障类别的Logits。因此,一个完整CNN通常由两部分组成:
CNN特征提取器
+
MLP分类头
2.3 数据在CNN中是怎样处理的?
这一部分主要回答:原始数据进入CNN后,是怎样逐层变成分类结果的?
假设输入是一段长度为2048的一维振动信号:
一个简单的CNN可以设计为:
输入信号
→ Conv1D
→ ReLU
→ MaxPool
→ Conv1D
→ ReLU
→ MaxPool
→ 全局平均池化
→ 全连接层
→ 故障类别
2.3.1 卷积核提取局部特征
第一层卷积核通常提取比较基础的特征,例如:
局部波动; 幅值变化; 边缘; 短时冲击; 高频变化。
对于轴承振动信号,第一层卷积核可能对局部冲击信号产生较强响应。不同卷积核会学习不同的特征模式。
例如:
卷积核1:关注尖峰冲击
卷积核2:关注周期波动
卷积核3:关注高频振动
卷积核4:关注低频趋势
因此,卷积层的输出通常包含多个通道。假设输入通道数为1,卷积层输出通道数为16,则输出可以表示为:
这16个通道分别表示16种不同的卷积特征。
2.3.2 深层卷积组合高级特征
浅层卷积主要提取简单局部特征。随着网络层数增加,深层卷积会将简单特征逐渐组合成更复杂的模式。
例如:
浅层特征
→ 局部冲击、幅值变化、频率成分

中层特征
→ 周期冲击、调制现象、频带能量

深层特征
→ 内圈故障、外圈故障、滚动体故障的类别特征
因此,CNN中的特征通常具有层次性:浅层学习基础特征,深层学习与具体任务相关的高级特征。
2.3.3 池化和降采样压缩特征
经过卷积后,特征长度通常仍然较大。池化或步长卷积可以逐渐缩短特征长度。
例如:
2048
→ 1024
→ 512
→ 256
→ 128
随着特征长度减小,卷积通道数通常会增加:
1通道
→ 16通道
→ 32通道
→ 64通道
→ 128通道
CNN逐渐压缩空间或时间长度,同时增加特征通道数量。
2.3.4 分类头输出结果
经过多层卷积后,可以使用全局平均池化,将每个通道压缩为一个数。例如:
经过全局平均池化后:
然后输入全连接层:
如果需要识别4种状态,则输出为:
这些数是不同类别的Logits。再通过交叉熵损失训练网络。完整流程可以表示为:
原始输入
→ 局部卷积特征
→ 多通道特征
→ 深层高级特征
→ 全局特征向量
→ MLP分类头
→ 故障类别
2.4 CNN在故障诊断中怎么使用?
CNN在故障诊断中主要有两种常见使用方式:
直接处理一维原始信号; 处理二维图像或时频图。
2.4.1 一维CNN处理原始振动信号
一维CNN通常用于:
振动信号; 电流信号; 声音信号; 压力信号; 转速时间序列。
输入形式为:
例如:
2048点振动信号
→ 1D-CNN
→ 全局平均池化
→ MLP分类器
→ 故障类别
具体结构可以是:
Input(1, 2048)
→ Conv1D(1, 16, kernel_size=7)
→ ReLU
→ MaxPool1D
→ Conv1D(16, 32, kernel_size=5)
→ ReLU
→ MaxPool1D
→ Conv1D(32, 64, kernel_size=3)
→ ReLU
→ Global Average Pooling
→ Linear(64, 4)
其中:
输入通道数为1; 经过三层卷积后得到64通道特征; 最后输出4种故障类别。
一维CNN的优势是可以直接处理原始信号,不需要先转换为图像。
2.4.2 二维CNN处理时频图
振动信号也可以先经过信号处理方法转换为二维图像,例如:
短时傅里叶变换; 连续小波变换; 小波包变换; 希尔伯特频谱; Gramian角场; 递归图。
基本流程为:
原始振动信号
→ 时频变换
→ 二维时频图
→ 2D-CNN
→ 故障类别
二维CNN输入通常表示为:
二维卷积核会在图像的高度和宽度方向滑动,提取:
局部纹理; 能量分布; 时间变化; 频率变化; 时频联合特征。
2.4.3 1D-CNN和2D-CNN有什么区别?
不能简单说1D-CNN和2D-CNN谁一定更好。
选择取决于:
输入数据形式; 数据规模; 计算资源; 故障特征表现形式; 是否需要时频分析。
2.4.4 CNN与其他网络组合
CNN还经常与其他网络组合使用。
例如:
原始振动信号
→ CNN提取局部特征
→ LSTM提取时序特征
→ MLP分类头
→ 故障类别
也可以加入注意力机制:
原始振动信号
→ CNN
→ SE或CBAM注意力
→ MLP分类头
→ 故障类别
还可以用于迁移学习:
源域数据和目标域数据
→ CNN特征提取器
→ 特征分布对齐
→ 故障分类
因此,CNN既可以独立完成故障诊断,也可以作为复杂模型中的特征提取器。
2.4.5 常见CNN网络
CNN不是某一个固定网络,而是一大类以卷积为核心的网络。
常见CNN架构包括:
LeNet; AlexNet; VGG; GoogLeNet; ResNet; DenseNet; MobileNet; EfficientNet。
(1)VGG
如图4所示,给出常见VGG的模型结构。VGG的核心思想是使用多个小尺寸卷积核不断堆叠,加深网络层数。VGG中常用3×3的小卷积核。
其结构比较规则:
多个3×3卷积
→ 池化
→ 多个3×3卷积
→ 池化
→ 全连接分类器
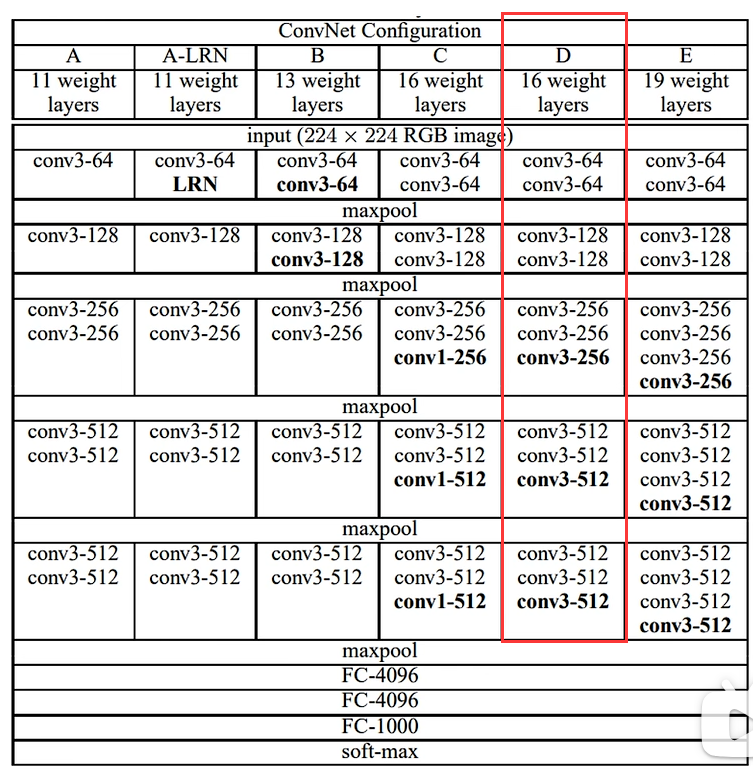
图4 常见VGG模型与结构
常见版本包括:
VGG16; VGG19。
VGG结构简单,但参数量较大,特别是传统VGG末端的全连接层包含大量参数(如图5以VGG16为例)。
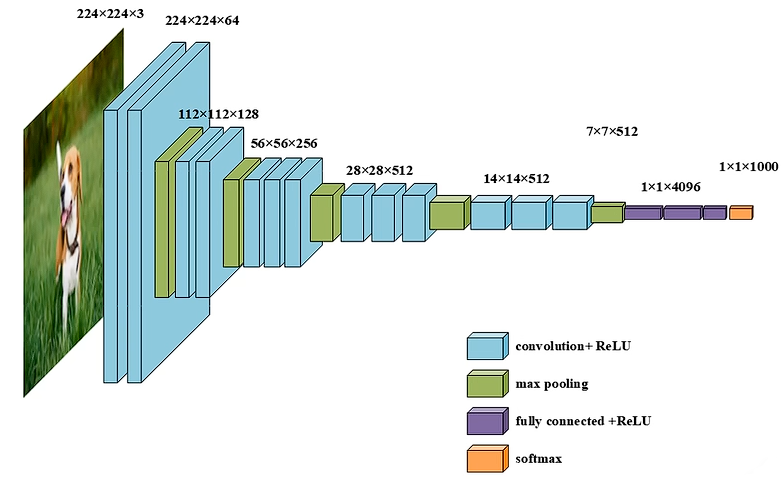
图5 VGG16网络结构
(2)ResNet
随着网络变深,普通CNN可能出现梯度消失、梯度传播困难和性能退化问题。ResNet引入了残差连接:
其中:
是输入; 是卷积层学习的残差特征; 是输出。
残差结构可以表示为:
输入x
├──────────────┐
↓              │
卷积层          │
→ 卷积层        │
↓              │
F(x)            │
├──── 相加 ←────┘
↓
输出F(x)+x
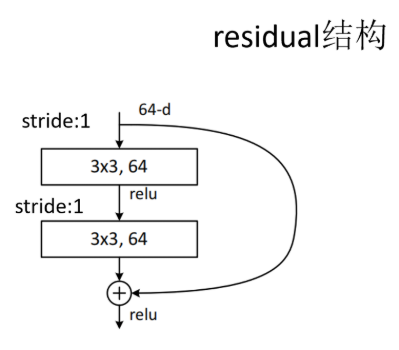
残差连接让信息和梯度可以更直接地在网络中传播,因此可以训练更深的CNN。
常见版本包括:
ResNet18(如图7所示); ResNet34; ResNet50; ResNet101。
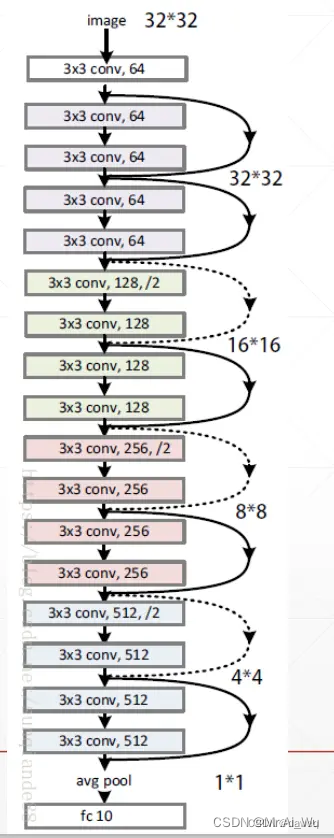
图7 ResNet18网络结构
在故障诊断中,一维ResNet通常将二维卷积替换为一维卷积,用于处理原始振动信号。
2.5 CNN有什么优点和局限?
这一部分主要回答: CNN适合解决什么问题?又有哪些不足?
2.5.1 CNN的优点
(1)自动提取特征
CNN可以直接从原始信号或图像中学习特征,减少对人工特征设计的依赖。
(2)擅长提取局部特征
卷积核能够捕捉:
局部冲击; 波形变化; 边缘; 纹理; 局部频率模式。
这与机械故障信号中常见的局部冲击特征较为契合。
(3)权重共享
同一个卷积核会在整个输入上重复使用,因此参数量通常比同规模全连接网络更少。
假设一维卷积层:
输入通道为1; 输出通道为64; 卷积核大小为7。
参数量为:
而将长度为2048的信号连接到64个神经元,参数量为:
因此,卷积层通常比全连接层更加节省参数。
(4)具有一定平移适应能力
相同故障冲击即使出现在信号中的不同位置,卷积核仍然可以检测到相似模式。
(5)容易构建深层网络
通过多层卷积,可以逐步学习从低级到高级的层次化特征。
2.5.2 CNN的局限
(1)更擅长局部关系
普通CNN主要通过局部卷积提取特征。如果需要直接建模序列中相距很远的位置关系,往往需要:
堆叠更多卷积层; 使用更大的卷积核; 使用空洞卷积; 与LSTM或Transformer结合。
(2)对网络结构比较敏感
卷积核大小、步长、通道数、层数和池化方式都会影响模型性能。
(3)可能丢失细节
池化和步长卷积会压缩特征尺寸。 如果降采样过快,可能丢失弱故障或瞬态故障信息。
(4)需要足够的训练数据
CNN虽然可以自动提取特征,但当数据量过少时,仍然可能过拟合。
(5)二维时频方法依赖预处理
如果使用2D-CNN处理时频图,结果还会受到以下因素影响:
时频变换方法; 窗口大小; 图像分辨率; 颜色映射; 信号预处理方式。
因此,二维图像并不一定天然优于一维原始信号。
2.6总结
CNN是一种以卷积运算为核心的深度神经网络。其基本流程为:
输入数据
→ 卷积层提取局部特征
→ 激活函数引入非线性
→ 池化或步长卷积压缩特征
→ 多层卷积提取高级特征
→ MLP分类头
→ 输出类别
CNN的核心特点包括:
局部连接; 权重共享; 自动特征提取; 层次化特征学习; 适合处理图像、信号和具有局部结构的数据。
在故障诊断中:
1D-CNN可以直接处理原始振动信号; 2D-CNN可以处理频谱图和时频图; VGG通过堆叠小卷积核加深网络; ResNet通过残差连接解决深层网络训练困难; CNN还可以与LSTM、注意力机制和迁移学习方法结合。
可以用一句话概括:CNN通过卷积核在输入数据上滑动,利用局部连接和权重共享自动提取故障特征,是目前故障诊断中最常用的深度学习网络之一。
不过,CNN主要擅长提取局部特征,对于时间序列中的长期依赖关系并不具备天然优势。为了进一步建模数据在不同时间步之间的关系,下一节将介绍循环神经网络RNN,以及LSTM和GRU。
CNN学习参考链接:
https://zhuanlan.zhihu.com/p/561991816
https://zhuanlan.zhihu.com/p/27715976701
https://blog.csdn.net/ai_aijiang/article/details/149255318
3.循环神经网络RNN
在上一节中,我们介绍了卷积神经网络CNN。CNN通过卷积核提取输入数据中的局部特征,特别适合识别振动信号中的局部冲击、波形变化和频率模式。但是,许多故障信号不仅具有局部特征,还具有明显的时间顺序。例如,当前时刻的振动状态可能与前一时刻有关,设备的退化过程也会随着时间逐渐发展。为了处理这种具有前后顺序的数据,可以使用循环神经网络。循环神经网络的英文名称是Recurrent Neural Network,通常简称为RNN。
3.1 RNN是什么?
RNN是一种专门用于处理序列数据的神经网络。 它与MLP和CNN最大的不同是:RNN在处理当前时刻的数据时,还会利用前面时刻保留下来的信息。
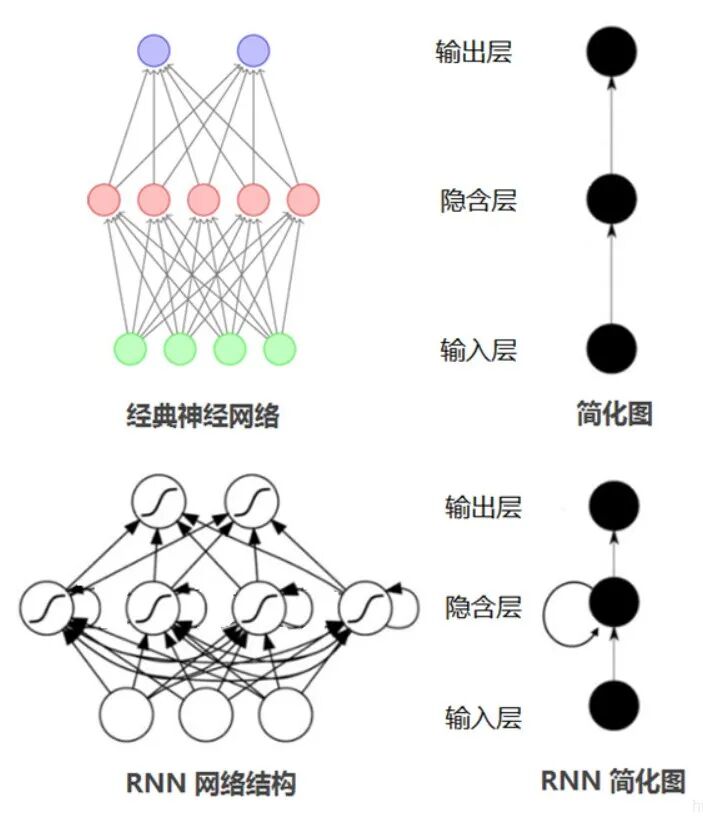
图8 RNN与CNN网络结构对比
3.1.1 RNN的核心思想
RNN引入了循环结构。每一个时间步,如图10所示,RNN不仅接收当前输入,还会接收上一时刻的隐藏状态:
当前时刻输入
+
上一时刻隐藏状态
→ RNN单元
→ 当前时刻隐藏状态
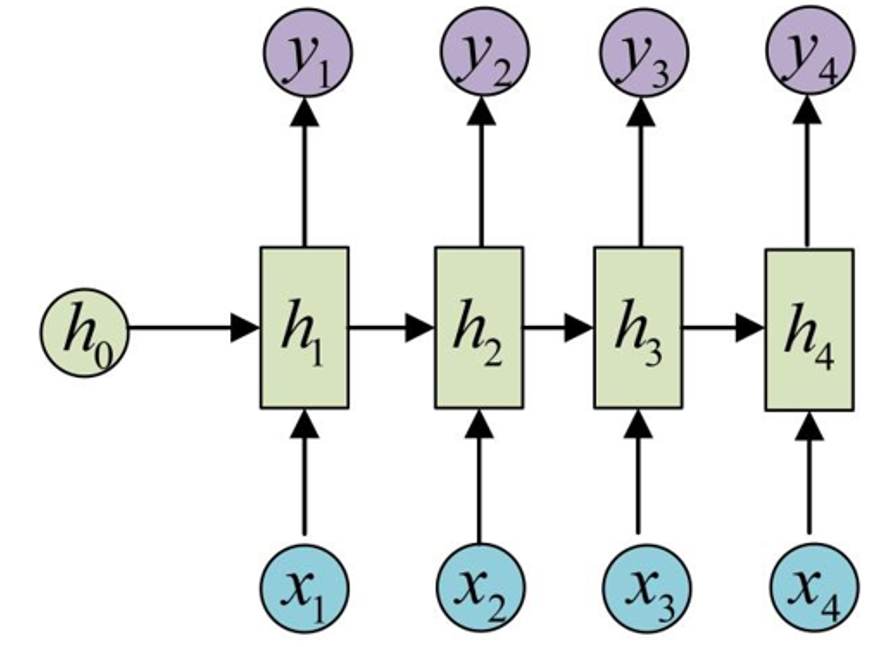
图10 RNN网络结构和计算过程
假设输入序列为:
RNN会按照时间顺序依次处理:
x₁ → RNN → h₁
             ↓
x₂ → RNN → h₂
             ↓
x₃ → RNN → h₃
             ↓
            ……
             ↓
xₜ → RNN → hₜ
其中:
表示第 个时间步的输入; 表示第 个时间步的隐藏状态; 隐藏状态用于传递前面时间步的信息。
因此,可以用一句话概括: RNN通过循环传递隐藏状态,学习序列中不同时间步之间的依赖关系。
3.1.2 RNN适合处理什么数据?
RNN主要适合具有先后顺序的数据,例如:
振动时间序列; 电流信号; 声学信号; 设备运行状态序列; 设备退化过程; 自然语言; 语音信号。
在故障诊断中,RNN不仅可以用于故障分类,还可以用于设备状态预测、退化阶段识别和剩余寿命预测。
3.2 RNN由哪些部分组成?
一个用于故障分类的RNN通常包含输入序列、循环层、隐藏状态、特征汇总模块和分类头。
其基本结构为:
输入序列
→ RNN循环层
→ 时序隐藏特征
→ 特征汇总
→ MLP分类头
→ 故障类别
3.2.1 输入序列
RNN的输入通常由多个时间步组成。单个样本可以表示为:
其中:
表示序列长度; 表示第 个时间步的输入特征。
如果每个时间步只有一个振动采样值,则:
一段长度为2048的单通道振动信号可以表示为:
也可以将2048个采样点划分为64个时间片,每个时间片包含32个采样点:
此时:
序列长度为64; 每个时间步的输入维度为32。
3.2.2 RNN循环层
在第 个时间步,RNN同时接收当前输入 和上一时刻隐藏状态 :
其中:
表示输入到隐藏状态的权重; 表示隐藏状态之间的循环权重; 表示偏置; 表示激活函数。
该公式说明:当前隐藏状态既包含当前输入的信息,也包含前面时间步传递过来的信息。
3.2.3 隐藏状态
隐藏状态是RNN最核心的组成部分之一。它可以理解为网络对当前时刻之前信息的压缩表示。
h₁:主要包含第1个时间步的信息

h₂:包含第1和第2个时间步的信息

h₃:包含前3个时间步的综合信息

……

hₜ:包含当前时刻之前的序列信息
假设隐藏维度为128,则每个时间步的隐藏状态为:
隐藏维度越大,网络能够保存的信息通常越丰富,但模型参数量和计算量也会增加。
3.2.4 特征汇总
RNN处理完整个序列后,会得到所有时间步的隐藏状态:
为了进行分类,需要将这些时序特征汇总成一个固定长度的向量。
(1)使用最后一个时间步
这种方法直接将最后时刻的隐藏状态作为整个序列的特征。
(2)平均池化
这种方法对所有时间步的隐藏状态取平均。
(3)最大池化
这种方法保留不同特征维度上的最大响应。
(4)注意力加权
其中, 表示第 个时间步的注意力权重。
3.2.5 分类头
汇总后的时序特征通常输入全连接层或MLP分类头:
RNN时序特征
→ 全连接层
→ 输出Logits
→ 故障类别
如果需要识别4种设备状态,则输出层包含4个神经元:
训练时,通常使用交叉熵损失计算预测结果与真实标签之间的差异。
3.3 数据在RNN中是怎样处理的?
假设输入序列为:
RNN会按照时间顺序依次处理每一个输入。
3.3.1 初始化隐藏状态
在处理第一个时间步前,需要初始化隐藏状态。通常将其设置为全零向量:
3.3.2 按照时间步循环计算
(1)处理第一个时间步
由于 通常为0,因此 主要包含第一个时间步的信息。
(2)处理第二个时间步
此时, 不仅包含 的信息,还间接包含 的信息。
(3)继续处理后续时间步
RNN在所有时间步中使用同一组参数,因此它能够处理不同长度的序列。
3.3.3 提取序列特征
处理完所有时间步后,可以使用最后一个隐藏状态,也可以对所有隐藏状态进行平均池化、最大池化或注意力加权。
3.3.4 输出分类结果
最终时序特征输入全连接分类器:
如果是四分类任务,则输出:
完整数据处理流程为:
输入时间序列
→ 按时间步依次读取
→ 隐藏状态循环传递
→ 得到时序特征
→ 汇总序列信息
→ MLP分类头
→ 输出故障类别
3.4 RNN在故障诊断中怎么使用?
RNN适合处理具有明显时间顺序和状态变化的数据。
3.4.1 直接处理原始振动信号
可以将每个振动采样点作为一个时间步:
原始振动信号
→ RNN
→ 时序特征
→ MLP分类头
→ 故障类别
例如,一段长度为2048的单通道振动信号可以表示为:
这种方式能够保留完整的时间顺序,但序列较长时,训练速度可能较慢。
3.4.2 分段后输入RNN
可以将连续信号划分成多个小片段。
例如,将2048点信号划分为64段,每段包含32个采样点:
处理流程为:
2048点振动信号
→ 划分为64个时间片
→ 每个时间片包含32个采样点
→ RNN提取时间片之间的关系
→ 故障分类
3.4.3 输入时序统计特征
也可以先对连续信号分窗,再从每个窗口中提取统计特征:
连续监测信号
→ 滑动窗口
→ 提取均方根、峭度等特征
→ 构成时间序列
→ RNN
→ 状态识别或趋势预测
例如,每个时间步包含5个特征:
整个样本可以表示为:
这种方法常用于设备状态监测、退化阶段识别和剩余寿命预测。
3.4.4 CNN与RNN组合
CNN和RNN经常组合使用:
原始振动信号
→ CNN提取局部特征
→ RNN提取时序关系
→ MLP分类头
→ 故障类别
其中:
CNN负责提取局部冲击和波形特征; RNN负责建模特征随时间的变化; MLP负责完成最终分类。
常见组合包括:
CNN-RNN; CNN-LSTM; CNN-GRU; CNN-BiLSTM。
需要注意的是:如果样本之间相互独立,不存在真实的连续时间关系,那么增加RNN不一定能够提高诊断效果。
3.4.5 LSTM和GRU
普通RNN、LSTM和GRU之间的关系为:
循环神经网络
├── 普通RNN
├── LSTM
└── GRU
LSTM和GRU都属于RNN的改进结构,主要用于缓解普通RNN难以学习长期依赖的问题。
(1)LSTM
LSTM的英文名称是Long Short-Term Memory,中文名称是长短期记忆网络。
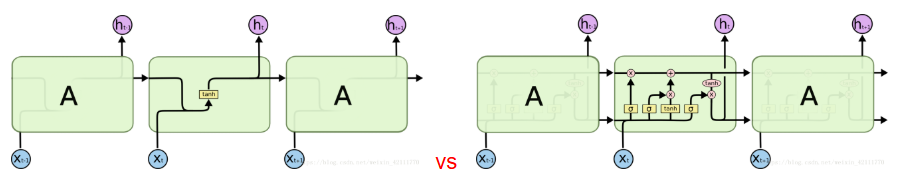
图11 RNN和LSTM网络结构对比
它在普通RNN基础上增加了记忆单元和门控结构,主要包括:
遗忘门:遗忘门决定以前的信息哪些不再重要; 输入门:输入门决定当前的新信息哪些值得记住; 输出门:输出门决定当前要从记忆中拿出哪些信息用于判断; 细胞状态:细胞状态相当于长期记忆本。
其基本过程为:
当前输入
+
上一时刻隐藏状态
+
上一时刻细胞状态
→ 遗忘旧信息
→ 写入新信息
→ 更新细胞状态
→ 输出当前隐藏状态
LSTM通过门控结构控制信息的保留、遗忘和输出,因此比普通RNN更适合处理较长序列。
(2)GRU
GRU的英文名称是Gated Recurrent Unit,中文名称是门控循环单元。
GRU主要包含:
更新门:决定最终状态中,旧信息和新信息各占多少; 重置门:决定计算当前新状态时,要参考过去多少信息。
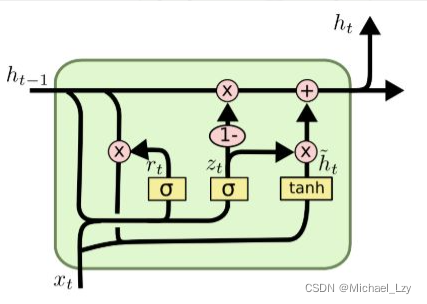
图13 GRU结构
与LSTM相比,GRU没有单独的细胞状态,结构更加简单,参数通常更少,训练速度也可能更快。
3.4.6 LSTM和GRU的区别
不能简单认为LSTM一定优于GRU,实际效果需要结合数据规模、序列长度和任务类型进行实验比较。
3.4.7 双向RNN与BiLSTM
普通RNN只按照一个方向处理序列:
x₁ → x₂ → x₃ → …… → xₜ
双向RNN会同时从两个方向处理序列:
正向:x₁ → x₂ → x₃ → …… → xₜ

反向:xₜ → …… → x₃ → x₂ → x₁
两个方向的特征通常进行拼接:
如果双向结构使用LSTM单元,就称为BiLSTM;如果使用GRU单元,就称为BiGRU。
双向结构适合完整序列分类,但在实时在线诊断中,由于未来数据尚未产生,通常不能直接使用反向信息。
3.4.8 RNN和残差连接有什么相似与不同?
RNN和残差连接在“将前面的信息继续向后传递”这一点上有些相似,但二者并不是同一种结构。
RNN主要沿时间方向传递隐藏状态:
残差连接主要沿网络深度方向传递输入特征:
二者的核心区别是:
RNN用于建模不同时间步之间的依赖关系; 残差连接用于改善深层网络中的信息与梯度传播; RNN不同时间步通常共享参数; 不同残差块通常具有各自的网络参数; 普通RNN会对上一隐藏状态进行变换,而残差连接通常将输入直接与变换结果相加。
可以简单理解为:RNN是在时间维度上传递记忆,残差连接是在网络深度维度上传递特征。
LSTM的细胞状态更新在形式上与残差连接更相似:
它同样包含“保留旧信息并加入新信息”的过程,但LSTM通过门控机制控制信息保留比例,而普通残差连接通常直接保留原输入。
3.5 RNN有什么优点和局限?
3.5.1 RNN的优点
(1)能够处理序列数据
RNN可以按照时间顺序读取输入,适合分析信号随时间的变化。
(2)能够建模时间依赖
隐藏状态能够传递历史信息,因此RNN可以学习前后时刻的联系、周期性变化和状态演化过程。
(3)可以处理不同长度的序列
由于不同时间步共享同一组参数,RNN能够在一定程度上处理长度不同的输入序列。
(4)适合动态故障诊断
RNN可以用于:
故障分类; 状态预测; 退化阶段识别; 故障趋势分析; 剩余寿命预测。
(5)容易与其他网络结合
例如:
CNN
→ LSTM
→ Attention
→ MLP分类器
3.5.2 RNN的局限
(1)容易出现梯度消失
当序列较长时,梯度需要沿多个时间步传播,可能逐渐变小,导致网络难以学习早期时间步的信息。
LSTM和GRU通过门控结构缓解了这一问题。
(2)可能出现梯度爆炸
梯度在时间方向传播时也可能变得非常大,导致训练不稳定。
常见解决方法包括:
梯度裁剪; 调整学习率; 合理初始化参数; 使用LSTM或GRU。
(3)难以完全并行计算
RNN必须按照时间顺序计算:
只有得到 后,才能计算 ,因此长序列训练速度通常较慢。
(4)长序列计算成本较高
如果将每一个振动采样点作为一个时间步,一段长度为4096的信号就需要循环计算4096次。
(5)并不适合所有故障分类任务
如果故障特征主要表现为局部冲击或频率模式,而且样本之间没有真实的连续时间关系,那么CNN可能更加直接有效。
3.6 总结
RNN是一种专门处理序列数据的循环神经网络。
其基本流程为:
输入时间序列
→ 按时间步依次处理
→ 隐藏状态循环传递
→ 提取时序特征
→ MLP分类头
→ 输出故障类别
RNN的核心特点包括:
按照时间顺序处理数据; 使用隐藏状态传递历史信息; 能够建模不同时间步之间的依赖关系; 适合时间序列分类、预测和设备状态监测; LSTM和GRU是普通RNN的改进结构; BiLSTM和BiGRU可以同时利用前后方向的信息。
https://zhuanlan.zhihu.com/p/652712909
https://blog.csdn.net/2401_85327249/article/details/142249393
https://blog.csdn.net/bestrivern/article/details/90723524
https://blog.csdn.net/mary19831/article/details/129570030
https://blog.csdn.net/Michale_L/article/details/122778270
https://blog.csdn.net/weixin_42111770/article/details/80900575
4.图神经网络GNN
前面介绍的MLP、CNN和RNN,通常将输入数据表示为向量、规则网格或时间序列。例如:
MLP处理固定长度的特征向量; CNN处理一维信号或二维图像; RNN处理具有前后顺序的时间序列。
但是,现实中的很多工业系统并不是简单的向量、图像或序列,而是由多个相互连接的设备、部件或传感器组成。为了处理这种具有连接关系的数据,可以使用图神经网络。 图神经网络的英文名称是Graph Neural Network,通常简称为GNN。
4.1 GNN是什么?
GNN是一类专门处理图结构数据的神经网络。
图结构数据不仅包含每个对象自身的信息,还包含对象之间的连接关系。一个图通常表示为:
其中:
表示节点集 合(下图A到E); 表示边集 合。s 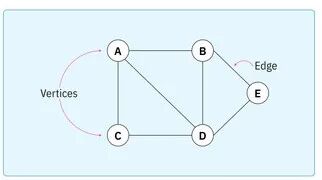
图14 图结构示意图
例如,在设备系统中:
节点可以表示传感器、零部件或设备; 边可以表示物理连接、空间邻近、能量传递或功能关系。
4.1.1 什么是图结构数据?
传统数据通常具有规则结构。
例如,一维振动信号可以表示为:
二维图像可以表示为规则像素矩阵:
但是,图结构数据中的每个节点连接数量可能不同,节点之间也不一定按照规则顺序排列。
例如:
传感器1 ─── 传感器2
   │           │
   │           ├── 传感器4
   │           │
传感器3 ─── 传感器5
这里的每个传感器可以作为一个节点,传感器之间的连接可以作为边。
因此,图结构数据主要包含三类信息:
节点; 边; 节点和边的特征。
4.1.2 GNN的核心思想
GNN的核心思想是: 每个节点通过聚合邻居节点的信息,更新自己的特征表示。例如,节点 不仅使用自身特征,还会接收邻居节点的信息:
节点自身特征
+
邻居节点特征
→ 信息聚合
→ 节点新特征
可以写成:
其中:
表示第 层中节点 的特征; 表示节点 的邻居集 合; 表示邻居信息聚合; 表示节点特征更新。
GNN通过在图中传播和聚合信息,学习节点及其连接关系所包含的特征。
4.2 GNN由哪些部分组成?
一个典型的图神经网络通常包含:
图结构; 节点特征; 边或邻接关系; 图消息传递层; 特征汇总模块; 分类器。 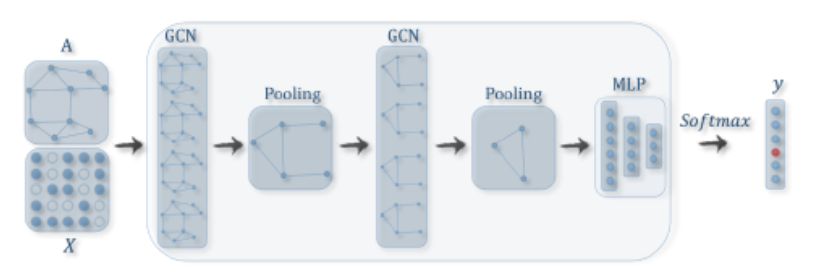
图15 图级分类任务GNN网络结构
其基本结构可以表示为:
图结构与节点特征
→ 图神经网络层
→ 节点信息传播与聚合
→ 节点或全图特征
→ MLP分类头
→ 预测结果
4.2.1 节点
节点用于表示图中的基本对象。在故障诊断中,节点可以表示:
不同传感器; 不同机械部件; 不同电气设备; 不同测点; 不同时间片; 不同频率成分。
每个节点可以包含一个特征向量:
其中, 表示节点特征维度。
例如,一个传感器节点的特征可以包括:
如果一共有 个节点,则节点特征矩阵可以表示为:
其中:
表示节点数量; 表示每个节点的特征维度。
4.2.2 边
边用于描述节点之间的关系。在工业系统中,边可以根据以下关系构建:
物理连接关系; 空间距离; 机械传动关系; 电气拓扑关系; 信号相关性; 功能耦合关系; 因果或知识关系。
例如:
电动机
→ 联轴器
→ 齿轮箱
→ 轴承
可以将相邻部件之间建立边。
边也可以带有特征,例如:
节点之间的距离; 信号相关系数; 连接阻抗; 能量传递强度; 相似度。
4.2.3 邻接矩阵
图的连接关系通常可以使用邻接矩阵表示。
假设图中有 个节点,则邻接矩阵为:
如果节点 和节点 之间存在连接,则:
如果不存在连接,则:
对于加权图, 也可以是连续数值,例如两个传感器信号之间的相关系数。
4.2.4 图消息传递层
图消息传递层是GNN的核心部分。每个节点会接收邻居发送的信息:
然后结合自身特征更新节点状态:
经过一层GNN后,每个节点可以获得一阶邻居的信息。经过两层GNN后,每个节点可以间接获得二阶邻居的信息。
例如:
第1层GNN:聚合直接相邻节点的信息

第2层GNN:聚合邻居及邻居的邻居信息

第3层GNN:获得更大范围的图结构信息
因此,增加GNN层数可以扩大节点在图中的感受范围。
4.2.5 特征汇总模块
GNN经过多层消息传递后,会得到每个节点的新特征:
如果任务是节点分类,可以直接使用每个节点的特征进行预测。
如果任务是整个图的分类,则需要将所有节点特征汇总为一个图级特征。
常见方法包括:
(1)平均池化
(2)求和池化
(3)最大池化
(4)注意力池化
其中, 表示不同节点的重要程度。
4.2.6 分类头
汇总后的节点或图特征通常输入MLP分类头:
图特征
→ 全连接层
→ 激活函数
→ 输出层
→ 故障类别
如果需要识别4种故障状态,则输出为:
训练时,可以使用交叉熵损失完成分类。
4.3 数据在GNN中是怎样处理的?
GNN的数据处理过程通常包括图构建、节点特征初始化、邻居信息聚合、节点特征更新和分类输出。
4.3.1 构建图结构
使用GNN之前,首先需要确定:
什么对象作为节点; 节点之间如何建立边; 节点包含哪些特征; 边是否需要权重。
例如,一个多传感器故障诊断系统可以构建为:
每个传感器
→ 一个节点

传感器之间的物理距离或相关性
→ 节点之间的边

传感器采集的时域和频域特征
→ 节点特征
图的构建方式会直接影响GNN学习到的信息。
因此:GNN的关键不仅是选择网络,还包括如何合理地构建图。
4.3.2 初始化节点特征
假设图中有 个传感器,每个传感器提取 个特征,则输入节点特征矩阵为:
例如,图中有8个传感器,每个传感器提取16个特征:
节点特征既可以是人工特征,也可以由CNN、RNN等网络提取。
例如:
各传感器原始振动信号
→ 1D-CNN提取局部特征
→ 得到节点特征
→ GNN进行多传感器信息融合
4.3.3 聚合邻居信息
对于节点 ,GNN首先收集邻居节点的信息:
也可以使用平均聚合:
然后将邻居信息与节点自身信息结合:
其中:
表示节点自身特征; 表示邻居聚合特征; 和 表示可学习参数; 表示激活函数。
4.3.4 更新节点特征
经过一层GNN后,每个节点的新特征不仅包含自身信息,还包含周围节点的信息。
例如:
轴承节点原始特征
+
相邻齿轮箱节点特征
+
相邻电动机节点特征
→ 更新后的轴承节点特征
经过多层传播后,可以进一步获得整个设备系统中的关联信息。
4.3.5 输出预测结果
根据任务不同,GNN可以输出不同结果。
(1)节点分类
判断每个节点的状态,例如:
传感器节点
→ 正常或异常

设备节点
→ 故障类型
(2)图分类
判断整个系统或整个样本的状态,例如:
整个设备图
→ 正常
→ 内圈故障
→ 外圈故障
→ 滚动体故障
(3)边预测
预测两个节点之间是否存在关系,或者关系是否发生异常。
(4)图级回归
预测整个设备系统的健康指数、退化程度或剩余寿命。
完整流程可以表示为:
原始多源数据
→ 构建节点和边
→ 提取节点特征
→ GNN消息传递
→ 获得节点或图特征
→ MLP分类器
→ 输出故障结果
4.4 常见GNN网络及其在故障诊断中的应用
GNN不是某一个固定网络,而是一类图神经网络的统称。
常见模型包括:
GCN; GAT; GraphSAGE; 图池化网络; 时空图神经网络。
4.4.1 GCN
GCN的英文名称是Graph Convolutional Network,中文名称是图卷积网络。
如图16所示,GCN可以理解为将卷积思想扩展到图结构数据中。
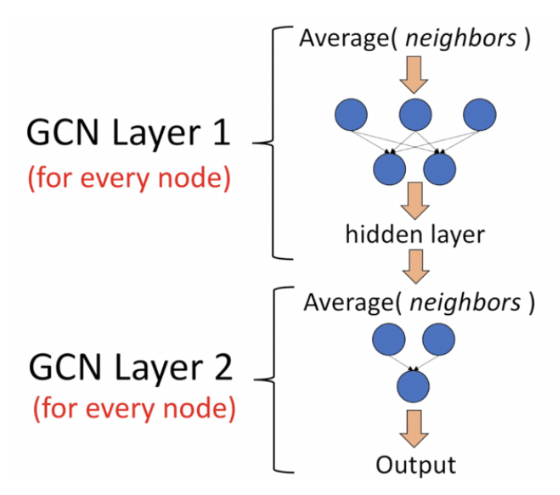
图16 GCN结构
经典GCN的一层传播可以写成:
其中:
表示加入自连接后的邻接矩阵; 表示单位矩阵; 表示节点度矩阵; 表示第 层节点特征; 表示可学习参数; 表示激活函数。
加入自连接是为了让节点在聚合邻居信息的同时,也保留自身信息。
GCN的基本过程为:
节点自身特征
+
相邻节点特征
→ 归一化聚合
→ 线性变换
→ 激活函数
→ 新节点特征
GCN通常默认相邻节点的信息都参与聚合,但不同邻居的重要程度主要由图结构和归一化系数决定。
4.4.2 GAT
GAT的英文名称是Graph Attention Network,中文名称是图注意力网络。GAT在GNN中引入注意力机制,让网络自动学习不同邻居节点的重要程度。
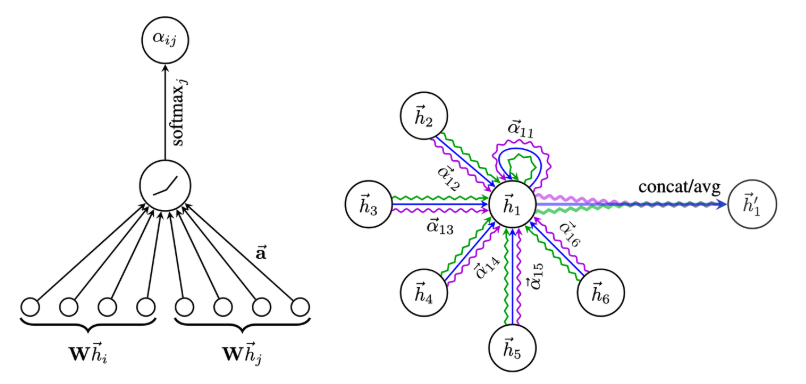
节点 和节点 之间的注意力分数可以表示为:
经过Softmax归一化后:
然后对邻居特征进行加权聚合:
其中:
表示邻居节点 对节点 的重要程度; 表示特征拼接; 和 表示可学习参数。
例如,在多传感器故障诊断中:
传感器1对当前故障最敏感
→ 较高注意力权重

传感器2受到噪声干扰
→ 较低注意力权重
因此,GAT可以自适应地选择重要邻居。需要注意的是:图注意力是一种注意力机制,而GAT是使用图注意力机制构建的图神经网络。。
4.4.3 GraphSAGE
GraphSAGE是一种基于邻居采样和信息聚合的图神经网络。它不会在每次训练时使用节点的全部邻居,而是从邻居中进行采样。
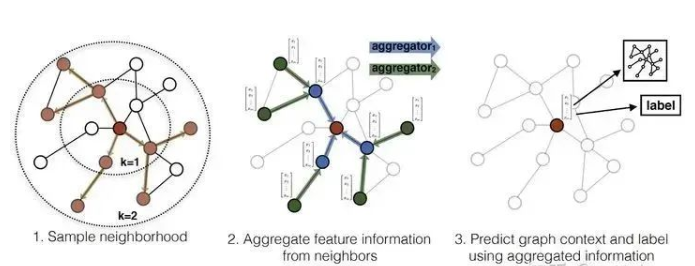
图18 GraphSAGE样本和增强方法示意图
基本过程为:
采样部分邻居节点
→ 聚合邻居特征
→ 与节点自身特征拼接
→ 得到新节点表示
常见聚合方式包括:
平均聚合; 最大池化聚合; LSTM聚合。
GraphSAGE适合处理节点数量较多的大规模图。
4.4.4 时空图神经网络
时空图神经网络同时建模:
节点之间的空间关系; 数据随时间变化的动态关系。
其基本结构可以表示为:
多传感器时间序列
→ 时间特征提取
→ 图结构空间聚合
→ 时空特征融合
→ 故障分类或预测
常见组合包括:
GCN-RNN; GCN-LSTM; GCN-GRU; GAT-LSTM; 时空图卷积网络。
例如,在多传感器设备中:
GNN负责建模不同传感器之间的关系; LSTM负责建模各传感器特征随时间的变化。
4.4.5 GNN在故障诊断中的常见使用方式
(1)多传感器融合
多个传感器信号
→ 每个传感器作为节点
→ 传感器关系作为边
→ GNN融合多节点信息
→ 故障类别
(2)设备拓扑故障诊断
发电机、母线、变压器、负载
→ 构建设备拓扑图
→ GNN传播设备状态
→ 定位故障设备
(3)机械部件关系建模
电机
→ 轴
→ 齿轮箱
→ 轴承

各部件作为节点
→ 机械连接作为边
→ GNN分析故障传播关系
(4)时频图转图结构
可以将不同频带、时频区域或特征分量作为节点,再根据相似性建立边。
(5)知识图谱故障诊断
将设备、故障、现象、原因和维修措施表示为不同节点,构建设备故障知识图谱。
然后使用GNN进行:
故障原因推理; 故障定位; 维修决策; 知识补全。
4.5 GNN有什么优点和局限?
4.5.1 GNN的优点
(1)能够利用节点之间的关系
传统神经网络通常只关注样本自身特征,而GNN可以同时使用节点特征和连接关系。
(2)适合处理不规则数据
图中的节点数量和连接方式不需要像图像像素一样规则排列。
(3)能够融合多传感器信息
GNN可以通过图消息传递,将多个传感器的信息进行关联和融合。
(4)可以建模故障传播关系
在复杂工业系统中,某个设备故障可能沿着机械连接、电气连接或功能关系传播。
GNN可以通过图结构描述这种传播过程。
(5)适用于多种任务
GNN可以用于:
节点故障分类; 故障设备定位; 整体系统状态识别; 故障关系预测; 剩余寿命预测; 知识图谱推理。
(6)容易与其他网络结合
例如:
CNN
→ 提取每个传感器的局部特征
→ GNN融合传感器关系
→ MLP分类器
也可以是:
GNN
→ 建模空间关系
→ LSTM建模时间变化
→ 故障预测
4.5.2 GNN的局限
(1)图构建比较困难
GNN通常需要提前确定节点和边。
如果图结构不合理,模型可能学习到错误或无意义的关系。
例如,需要考虑:
节点应该表示传感器还是部件; 边应该根据物理连接还是信号相关性建立; 是否保留弱连接; 是否设置边权重。
因此,图构建是GNN应用中的关键问题。
(2)并不是所有数据都适合使用GNN
如果输入只是单个传感器的一维振动信号,而且不存在明确的节点关系,那么直接使用CNN或RNN可能更加自然。
不能仅仅为了使用GNN,就人为构造缺乏物理意义的图。
(3)可能出现过平滑问题
随着GNN层数增加,节点不断聚合邻居信息,不同节点的特征可能变得越来越相似。
这种现象称为过平滑。
最终可能导致不同节点难以区分。
(4)深层GNN训练困难
GNN层数过多时,可能出现:
节点特征过平滑; 信息过度压缩; 梯度传播困难; 计算量增加。
因此,很多GNN并不会堆叠得特别深。
(5)计算成本可能较高
对于节点和边数量较多的大规模图,消息传递需要较大的存储和计算开销。
(6)图结构可能随工况变化
工业系统中的传感器相关性和设备状态可能随运行工况改变。如果使用固定图结构,可能无法准确描述动态关系。
这时可以考虑:
动态图神经网络; 自适应邻接矩阵; 图注意力网络; 时空图神经网络。
4.5.3 GCN和GAT如何选择?
如果节点关系比较明确,并且邻居作用较为接近,可以优先考虑GCN。如果不同传感器或不同部件对故障诊断的贡献差异较大,可以考虑GAT。但最终仍需要通过实验比较。
4.6 总结
GNN是一类专门用于处理图结构数据的神经网络。
其基本流程为:
构建图结构
→ 设置节点和边
→ 初始化节点特征
→ 聚合邻居信息
→ 更新节点特征
→ 获得节点或图级表示
→ MLP分类头
→ 输出故障结果
GNN的核心特点包括:
同时利用节点特征和连接关系; 通过消息传递聚合邻居信息; 适合处理多传感器、设备拓扑和部件关联数据; GCN通过图卷积聚合邻居信息; GAT通过注意力机制学习不同邻居的重要程度; 时空图神经网络可以同时建模空间关系和时间变化。
在故障诊断中,GNN特别适合以下场景:
多传感器信息融合; 复杂设备系统故障定位; 机械部件关系建模; 电力系统拓扑诊断; 故障传播分析; 设备知识图谱推理。
GNN通过在节点之间传递和聚合信息,使模型不仅能够分析单个设备或传感器的特征,还能够学习整个系统中的连接关系和故障传播规律。
需要注意的是,GNN并不是CNN和RNN的简单替代。CNN擅长提取局部信号特征,RNN擅长学习时间依赖,而GNN擅长建模多个对象之间的连接关系。
在实际故障诊断中,它们经常组合使用:
CNN提取局部特征
+
RNN提取时间特征
+
GNN建模节点关系
→ 完成复杂系统故障诊断
GNN主要负责学习数据之间的关联关系,而另一类网络则主要通过压缩和重构输入数据学习特征。
为了让网络更加灵活地选择重要信息,并直接建立不同位置之间的联系,下一节将介绍注意力机制与Transformer网络。
GNN学习参考链接:
https://blog.csdn.net/qq_43787862/article/details/113830925
https://zhuanlan.zhihu.com/p/660987867
https://zhuanlan.zhihu.com/p/75307407
https://blog.csdn.net/weixin_47332746/article/details/144554395
https://cloud.tencent.com/developer/article/2284994
注:本期下篇将介绍注意力网络、编码与重构网络以及生成模型的在故障诊断中的相关概念和知识点。
编辑:Leo
校核:李正平、陈凯歌、曹希铭、赵学功、白亮、王金、陈莹洁、陈宇航、任超、海洋、Tina、赵诚
该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除