
2-34GA-WNN用遗传算法先找好起点,再让小波神经网络预测股票指数
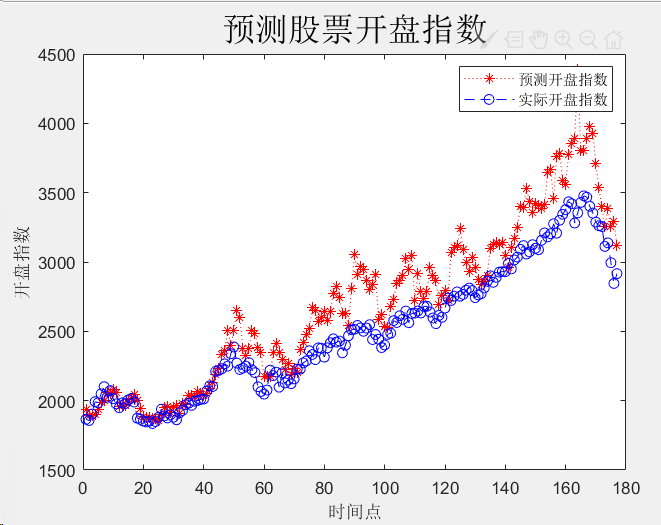
一句话介绍: 这套程序把遗传算法 GA 和小波神经网络 WNN 结合起来,先用 GA 搜索网络权值以及小波伸缩、平移参数的较优初值,再用梯度学习继续训练 Morlet 小波神经网络,最后对 177 组股票指数测试数据进行预测,并计算拟合优度、均方根误差和相对误差。
先看它解决什么问题
股票指数属于明显的非线性时间序列。
如果直接建立一个普通线性模型,很难描述复杂的波动关系;而普通 BP 神经网络虽然具有非线性拟合能力,但训练结果比较依赖随机初始值,初值不好时可能:
收敛较慢;停留在较差的局部解附近;不同运行得到不同预测效果。
这套程序采用:
股票数据 → 归一化 → GA 搜索 WNN 初始参数 → 小波神经网络继续训练 → 测试集预测 → 反归一化 → 误差评价
核心思想可以概括成:GA 负责“先找到一个更好的起跑位置”,WNN 再负责“沿着误差方向做精细学习”。
1. 这个工程真正包含什么?
核心内容可以压缩为 5 个部分:
文件 | 作用 |
|---|---|
| 主程序,完成 GA 搜索、WNN 训练和股票预测 |
| 计算 GA 个体对应的小波网络误差 |
| Morlet 小波隐层激活函数 |
| Morlet 函数导数,用于梯度更新 |
| 股票训练与测试数据 |
工程还附带经典 MATLAB Genetic Algorithm Toolbox gatbx,用于完成二进制编码、选择、交叉、变异和重插入。
同时附有论文:《基于遗传算法的小波神经网络在股票预测中的应用》
可以用于理解该程序的理论设计和实验背景。
2. 当前数据到底有多大?
因此整个模型采用:6 个输入变量 → 1 个预测目标
训练样本为:4400 组;测试样本为:177 组
配套论文说明数据用于预测上证指数开盘指数,时间范围为:1990-12-20 ~ 2009-08-19
当前 MAT 文件本身没有保存 6 个输入列的字段名称,所以文档不额外猜测每一列具体对应哪一个行情字段。
不过从数据关系可以直接核对出:output 与第一输入列向后移动 2 条记录完全对应。
因此当前数据实际上建立了一个:根据当前 6 维信息预测约两条记录之后第一目标序列的监督学习问题。
3. 为什么所有数据先做归一化?
6 个输入变量的量级差异非常大。
例如数据中有的变量处于几千量级,有的变量可以达到数百亿量级。
如果直接输入网络,大数值变量很容易在加权求和时占据过强影响。
程序使用 mapminmax 对:
训练输入;训练输出;分别进行归一化,并把同样的输入缩放规则应用到测试数据。
预测完成后,再使用训练输出的归一化参数把结果恢复到原始股票指数尺度。
所以完整关系是:
原始数据 → 统一数值尺度 → 神经网络计算 → 预测值反归一化
4. 当前小波神经网络是什么结构?
程序设置:输入层:6 个节点、隐含层:7 个小波节点、输出层:1 个节点
与普通 BP 网络不同,隐藏节点不是 Sigmoid,而是使用 Morlet 小波函数。
第 j 个隐藏节点先计算:zⱼ = [Σₖ Wⱼₖxₖ - bⱼ] / aⱼ
其中:
Wⱼₖ:输入到第 j 个小波节点的权值;
bⱼ:小波平移参数;
aⱼ:小波伸缩参数。
随后计算 Morlet 响应:ψ(z) = exp(-z²/2) · cos(1.75z)
最终网络输出为:ŷ = Σⱼ Vⱼψ(zⱼ)
因此网络不仅能调整普通连接权值,还能够调整每个小波节点的:位置 b + 尺度 a
这比只有固定激活函数的普通网络增加了新的可调自由度。
5. Morlet 小波为什么适合做非线性拟合?
Morlet 函数由:高斯包络 × 余弦振荡组合而成。
在某一个局部区域附近具有较明显响应,而离开该区域以后响应逐渐衰减。
因此多个不同:
伸缩尺度 a;平移位置 b;连接权值;的小波节点组合以后,可以从不同局部区域逼近复杂非线性关系。
简单理解:
每个隐藏节点负责描述输入空间中的一种局部变化,多个小波节点再组合成最终预测曲线。
这也是小波神经网络相对于普通固定 Sigmoid 网络的主要理论特点之一。
6. GA 到底优化了多少个参数?
遗传算法不是优化网络层数,而是优化 WNN 的初始连续参数。
当前网络共有:输入层 → 隐层权值6 × 7 = 42 个
小波平移参数 b:7 个
小波伸缩参数 a:7 个
隐层 → 输出层权值:7 × 1 = 7 个
所以总参数数为:42 + 7 + 7 + 7 = 63
即:NVAR = 63一个 GA 个体就代表一套完整的 WNN 初始参数。
7. GA 怎样寻找较好的网络初值?
当前主程序使用:
种群数量:40;最大遗传代数:50;代沟 GGAP:0.9;单点交叉概率:0.7
63 个参数都编码在:0~1范围内。
每个连续变量使用 63 位二进制 / Gray 编码,因此一条染色体总长度为:63 × 63 = 3969 bit
每一代主要进行:
评价误差 → 排序适应度 → SUS 随机遍历选择 → 单点交叉 → 位变异 → 优良子代重新插入种群
其中代沟 0.9 对 40 个个体意味着每代约选择:36 个个体参与产生新一代候选。
8. 为什么 GA 和 WNN 要组合,而不是只用其中一个?
只用梯度训练 WNN
网络能够根据预测误差不断修改参数,但训练方向由当前参数位置决定。
如果随机初始点比较差,可能需要更长时间才能找到好区域。
只用 GA
GA 具有全局随机搜索能力,但如果完全依靠遗传迭代精细调整 63 个连续参数,搜索效率通常不如局部梯度更新。
GA-WNN
当前设计采用:GA 大范围搜索 → WNN 梯度精细调整
也就是:
全局搜索能力和局部学习能力分工。
这是整个 GA-WNN 模型最核心的组合逻辑。
9. GA 找到初值以后,WNN 怎样继续训练?
遗传阶段结束后,程序把得到的参数拆回:
Wjk;Wij;a;b;然后进行普通迭代学习。
当前脚本设置:连接权学习率 lr1 = 0.01、伸缩 / 平移参数学习率 lr2 = 0.001、训练轮数 maxgen = 100
每输入一个训练样本,就计算:预测误差 = 期望输出 - 网络输出
再利用 d_mymorlet.m 中的 Morlet 导数更新:
输入权值;输出权值;小波平移参数;小波伸缩参数。
因此 GA 并不替代网络训练,而是负责提供网络训练的初始参数。
10. 程序怎样预测测试数据?
训练完成以后,程序把:177 × 6
测试输入按照训练集的 inputps 归一化。
随后逐条计算:6 维输入 → 7 个 Morlet 隐层响应 → 1 个归一化预测值
得到:177 个预测值
11. 程序怎样评价预测效果?
主程序计算了三个主要指标。
拟合优度 R²
R² = 1 - Σ(y-ŷ)² / Σ(y-ȳ)²
R² 越接近 1,说明预测曲线对真实变化解释得越充分。
均方根误差 RMS
RMSE = √[(1/N)Σ(y-ŷ)²]
它直接表示预测值和真实值之间平均偏差的量级。
相对误差
e_rel = (ŷ - y) / y
可以观察每一个测试点的预测偏差占真实值的比例。
所以程序不只是输出预测曲线,也给出了定量预测精度指标。
12. 配套论文给出了怎样的实际结果?
工程自带论文对普通 WNN 和 GA-WNN 做了实验比较。
论文报告结果为:
指标 | WNN | GA-WNN |
拟合均方误差 | 119.4435 | 70.9349 |
预测均方误差 | 64.6568 | 60.6935 |
最大相对误差 | 11.49% | 8.82% |
拟合优度 | 97.18% | 98.16% |
运行时间 | 429.6861 | 422.8493 |
论文还说明:
GA 搜索大约在 15 代附近已经找到较稳定的优良解。
从论文实验结果看,GA-WNN 相比普通 WNN:
拟合误差降低;预测误差降低;
最大相对误差从 11.49% 降到 8.82%;
拟合优度由 97.18% 提高到 98.16%。
需要注意,论文表格中的 WNN 训练迭代次数是 200,而当前 ga_wavenn_bp.m 中后续 WNN 训练设置为 100,因此论文表格属于配套实验结果,不应把它当成当前脚本每次直接运行都必然得到的固定数值。
13. 为什么不直接使用普通 BP 网络?
普通 BP 网络同样可以逼近非线性函数,但当前 GA-WNN 多用了两层机制。
小波激活函数
通过 a、b 调整局部尺度和位置,使隐藏节点具有更灵活的局部逼近能力。
遗传算法初值搜索
普通 BP 从随机参数开始,GA-WNN 则希望先在更大搜索范围里挑选一组更好的初始参数。
所以相比“随机初始化 + BP”,当前设计希望形成:
更好的初值 + 更灵活的隐层函数 + 梯度精细训练
14. 当前源码中一个影响 GA-WNN 实际执行的关键点
从算法设计上,GA 应该把最终种群中的最佳染色体解码后传给 WNN。
但当前主程序在 GA 结束后使用:bestchrom = C_x(I,:)
其中 C_x 是遗传开始前的初始种群解码结果,并没有随着最终 Chrom 更新。
同时,当前 objfun.m / objfun_1.m 在遍历训练集时没有逐样本重置内部 y、net,并且误差是在整个循环结束后才计算一次。
因此,如果希望当前源码严格实现论文描述的:
“GA 根据整个训练集误差优化 WNN 初值”
运行前应先把这两处 GA 与 WNN 的衔接逻辑校正。
这一点会直接决定“遗传算法找到的最优参数是否真正进入后面的网络训练”,属于理解当前代码结果时最重要的源码细节。
15. 程序最终能得到什么?
运行完成后,最核心的结果包括:
trace:GA 每一代目标值变化;
ynn:177 个测试样本的预测指数;
r2:测试数据拟合优度;
RMS:测试预测均方根误差;
abs_eror:177 个测试点的相对误差;
Wjk、Wij、a、b:训练后的 WNN 参数。
所以这个工程最终得到的不只是一个网络模型,而是:
GA 搜索过程 + WNN 训练 + 177 点股票预测 + 多种误差指标
组成的一套完整时间序列预测实验。
16. 它适合用在哪里?
股票指数预测算法教学
可以理解如何把 6 维历史信息转换成一个未来指数预测值。
GA 优化神经网络实验
程序完整展示了:
染色体编码 → 适应度 → 选择 / 交叉 / 变异 → 网络参数解码
怎样与神经网络连接起来。
小波神经网络学习
Morlet 不只是用来做传统小波分解,也可以直接作为神经网络隐藏层函数参与非线性映射。
非线性时间序列预测
如果把 stock_index.mat 换成其他 6 输入 1 输出的数据,并重新组织训练 / 测试集,相同结构也可以用于其他回归预测实验。
17. 怎么运行?
主程序是:ga_wavenn_bp.m
推荐先按第 14 节校正 GA 最优染色体解码和目标函数逐样本误差累计逻辑,再运行完整 GA-WNN 流程。
当前最值得调整的只有 隐藏节点数、GA 种群 / 代数和 WNN 学习率,它们分别影响网络表达能力、全局搜索量和后续局部训练速度。
18. 一句话看懂这个项目
这是一个GA-WNN 股票指数预测程序:stock_index.mat 提供 4400 组 6 维训练样本和 177 组测试样本,网络结构为 6→7→1,7 个隐藏节点使用 ψ(z)=exp(-z²/2)cos(1.75z) 的 Morlet 小波;GA 用 40 个个体、50 代搜索 Wjk、Wij、7 个伸缩参数 a 和 7 个平移参数 b,共 63 个网络参数,再由梯度学习继续训练 WNN,并输出 177 个指数预测值、R²、RMSE 和相对误差。配套论文报告 GA-WNN 的预测均方误差为 60.6935、最大相对误差 8.82%、拟合优度 98.16%,但当前源码的 GA 最优染色体衔接与适应度累计逻辑需要先校正,才能严格复现“GA 优化 WNN 初值”的设计流程。


