你的Modelica模型为什么这么慢?我用一个乘法公式讲清楚
- 作者优秀
- 优秀教师/意见领袖/博士学历/特邀专家/独家讲师
- 平台推荐
- 内容稀缺

导读:自《2026研发仿真开学季-让AI接入仿真研发》主题月开展以来,研发工程师案例征集活动随之而来。我们收到了来自行业一线研发工程师的踊跃投稿。每一篇来稿都源自真实项目的打磨与沉淀,凝聚着实战中的思考、踩坑与提炼——也正因如此,这些经验更具参考价值,更能引发同行的共鸣。
我们希望通过这个栏目,让更多一线工程师的声音被听见,让散落在各项目中的宝贵经验流动起来,共同推动仿真技术在产业中的落地与深化。今天与大家分享的,是来自南京远思智能科技有限公司易思强工程师的投稿——《你的Modelica 模型为什么这么慢?》。
南京远思智能科技 易思强
在仿真实践中,"模型跑得慢"几乎是每个建模工程师都会遇到的痛点。多数人的第一反应是换求解器、调容差、加内存,却往往"药不对症"。在这篇文章中,作者跳出经验主义的调试思路,用一个简洁的乘法公式(总耗时 ≈ 步数 × 每步耗时)将复杂的仿真性能问题拆解为两个可定位、可分析的维度,并结合真实场景给出了一张可直接对照排查的提速对照表。无论你是刚接触 Modelica 的新手,还是有多年建模经验的工程师,这篇文章都能帮你建立一套系统化的性能分析框架,从"凭感觉调参"走向"按逻辑定位"。以下是正文:
一、一个乘法公式讲清楚
不讲玄学,只讲「步数× 每步耗时」这两个数是怎么被你写坏的。
先看两个真实到扎心的场景:
1、甲模型跑完 250 ms 仿真只要 250 ms,乙模型也是250 ms。两个连到一起——12.75 秒,慢了 25 倍。
2、一个小球落地弹跳的模型,前 12 秒顺风顺水,之后突然「粘」在地上走不动,日志里写着「状态事件次数:141128」。
这两件事看起来毫无关系,其实是一个原因的两种表现。
绝大多数人优化仿真速度的方式是:换求解器、调容差、加内存、换电脑。这些手段偶尔有用,但经常「药不对症」——因为你根本不知道时间花在哪了。
这篇文章给你一个可以一直用下去的分析框架。看完之后,你看到任何一个慢模型,都能在 30 秒内判断出:它到底是「步太多」,还是「每步太贵」。
二、先花 60 秒,搞懂它是怎么算的
Modelica 仿真就像拍定格动画,在两个动作之间来回切换:
S 步(稳态求解步)= 摆场景。把"当前这一瞬间"的所有未知量一次性解出来——压力、温度、流量、电流……在这一刻,它们必须同时满足全部方程。本质是解一个方程组。
T 步(积分推进步)= 按快门、翻页。把状态变量往前推一格,x_new = x_old + der(x) × Δt。就是一次加法。
初始化 →S 步 → T 步 →S 步 → T 步 →S 步 → T 步 → ……
这里有个关键认知,值得停下来记住:
状态变量本身在 S 步里是「已知量」,它的导数 der(x) 才是「待求未知量」。
用大白话说:这一帧照片里,位置是已知的,速度是待求的;求出速度,才能翻到下一帧算出新位置。
顺带也就明白了一件事——Modelica 里根本不存在"从上到下、从左到右一路算下去"这回事。你写的方程没有先后之分,内核会把它们全部打散、重新排序、约减,最后凑成一个(或几个)矩阵一次性求解。这个特点,是后面几乎所有"反直觉现象"的根源。
1、一个最小案例:跟着内核走三帧
光有比喻还不够,我们拿一个能心算的模型,把 S 步、T 步一步步走一遍。一个 12 V 电源、一个 1 kΩ 电阻、一个 1000 μF 电容,串成一个回路。整个模型只有两个方程:
电阻:i = (12 − u_C) / 1000
电容:der(u_C) = i / 0.001
状态变量只有电容电压 u_C(时间常数 τ = RC = 1 s)。假设内核用 0.5 s 的固定步长——先用最笨的方式,我们把前三帧完整走完:
帧 | 时刻 t | 已知(上一帧带来的) | S 步解出 | T 步翻页 |
0 | 0 s | u_C = 0 V(初值) | i = 12 mA,der(u_C) = 12 V/s | u_C = 0 + 12×0.5 = 6 V |
1 | 0.5 s | u_C = 6 V | i = 6 mA,der(u_C) = 6 V/s | u_C = 6 + 3 = 9 V |
2 | 1.0 s | u_C = 9 V | i = 3 mA,der(u_C) = 3 V/s | u_C = 9 + 1.5 = 10.5 V |
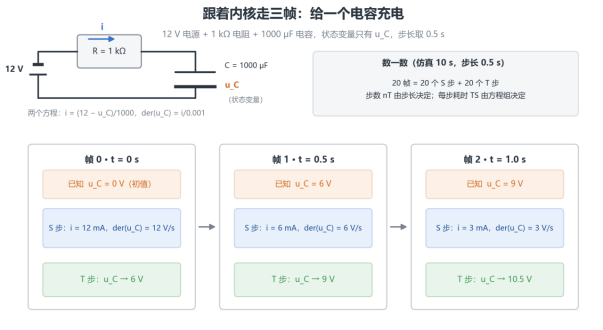
这张表把前面所有抽象概念全部坐实了:u_C 是唯一能"活过"一步的量(它就是快门底片),电流 i、导数 der(u_C) 都是"一次性"的,每帧现算、用完即扔——所以第 1 帧的 i 是 6 mA 而不是 12 mA。而 T 步永远只是一次加法,不管模型多复杂,翻页的成本都可以忽略;慢,从来不慢在 T 步,慢的是 S 步的方程组和步数的多少。
最后数一数:仿真 10 s、步长 0.5 s,就是 20 帧 = 20 个 S 步 + 20 个 T 步。既然仿真是"摆场景 → 翻页"的循环,那总耗时只由两个数决定:
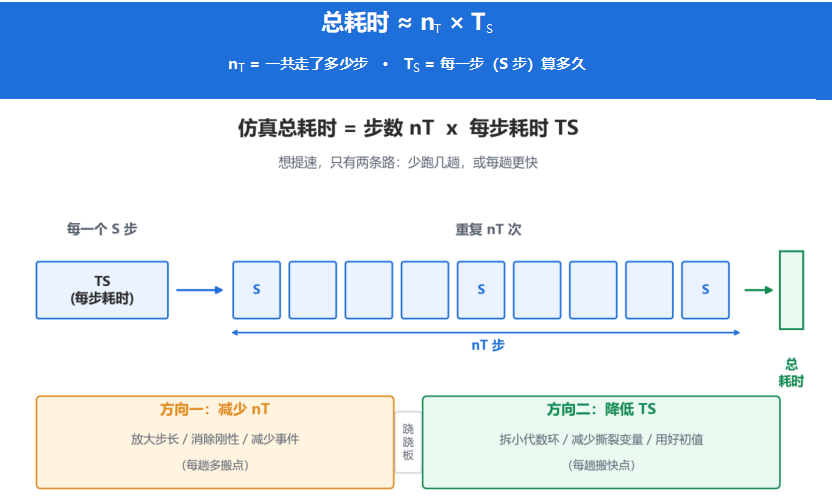
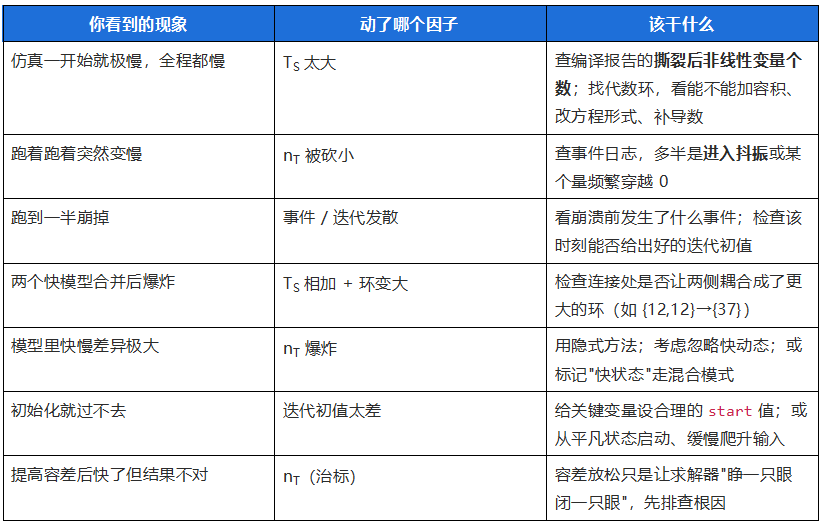
nT 是步数,主要由刚性(最快时间常数)、积分方法的阶、步长自适应、事件决定;TS 是每步耗时,主要由非线性代数环的大小、牛顿迭代的收敛性决定。开篇那两个案例,用这个公式一看就清楚:两个模型合并后慢 25 倍,是 TS 出了问题(两套方程每步都要解,还长出更大的环);小球弹到后来卡死,是nT 出了问题(14 万次事件把步长反复砍碎)。想提速,要么减少步数,要么降低每步成本——下面这张对照表,覆盖了实践中最常见的七种情况。
三、提速对照表:照着查就行
四、写在最后
回到开头那个问题:模型为什么慢?
现在你知道了,答案永远可以归结成一句话——

最后送一张"建模工程师段位表",看看你在第几层:
第一层:模型跑不动就改参数,改到能跑为止
第二层:会看报错信息,知道去翻日志
第三层:知道"慢"分两种,会去查步数和每步耗时
第四层:看得懂编译报告里的撕裂变量个数,能主动拆解代数环
第五层:写方程时就想好了这个假设会把成本推到哪一头
前三层靠经验堆,后两层靠理解。希望这篇文章,能帮你跨过第三层。
本期要点回顾:
(1)总耗时 ≈ nT(步数)× TS(每步耗时)
(2)nT 由最快时间常数(刚性)、积分阶数、步长自适应、事件决定
(3)TS 由撕裂后非线性变量个数、牛顿迭代收敛性、雅可比复用率决定
(4)合并系统:nT 取最大,TS 取求和
(5)建模假设 = 成本在 nT 与 TS 之间搬家,没有免费午餐
参考文献
2026研发仿真开学季是仿真秀面向研发工程师推出的主题活动月,9月1日至10月31日以"从工具到智能——让AI接入仿真研发"为主线,覆盖结构、流体、电磁、多物理场和AI驱动仿真五个方向。仿真秀力邀企业资深研发工程师,围绕LS-DYNA、Workbench、Abaqus、Star-CCM+、HyperWorks、Maxwell、Fluent、CST、Flotherm、SolidWorks、ANSYS等主流软件,演示如何用LLM、Agent、Codex、Claude、DeepSeek等大模型能力打通建模、求解、后处理与优化全流程,让仿真从"手工操作"升级为"AI驱动";
此外仿真秀精选100余门研发仿真精品视频课限时秒杀1元起售,并叠加专属券,秒杀课程覆盖从基础到前沿的完整学习路径;活动期间,仿真秀还发起案例征集,以"我的研发仿真故事——从工具到智能的进阶之路"为题,面向工程师征集攻坚实录、工具进化、AI接入、成长与团队四类真实故事,图文或视频,通过即获“满意现金稿酬和百人千万"内容扶持计划,优秀作品还将在仿真秀APP、官网、公 众号、视频号四端专题展示并邀请连麦直播。整个主题月既是一场系统化的技术充电,也是工程师用AI重塑研发工作流的一次集中练兵。