
2-32递推最小二乘 RLS 参数辨识
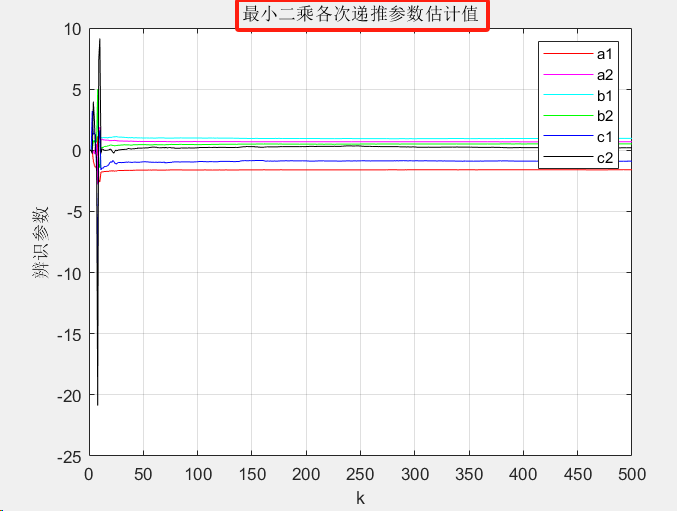
一句话介绍: 这套程序先用 M 序列激励一个已知的二阶离散系统,再人为加入随机噪声,随后只根据逐步到来的输入、输出和噪声历史量,使用递推最小二乘法在线估计 6 个模型参数,并观察估计值是否逐渐收敛到真实参数。
先看它解决什么问题
很多动态系统都可以写成:
当前输出 = 过去输出的影响 + 过去输入的影响 + 噪声影响
实际工程里,系统结构可能知道,但参数往往不知道。
例如已经确定系统大致满足二阶差分模型,却不知道:
前一时刻输出到底占多大权重;前两时刻输出的影响是多少;输入对输出的增益是多少;噪声动态怎样进入系统。
这套程序做的就是:
设计激励信号 → 让模型产生输出 → 逐点读取数据 → 递推更新参数 → 得到最终参数估计
它展示的是一个很典型的:在线系统参数辨识过程。
1. 当前程序辨识的模型是什么?
源码开头直接给出了真实系统:
y(k) - 1.6y(k-1) + 0.7y(k-2) = u(k-1) + 0.5u(k-2) + λ[v(k) - v(k-1) + 0.2v(k-2)]
整理成当前输出形式:
y(k) = 1.6y(k-1) - 0.7y(k-2) + u(k-1) + 0.5u(k-2) + λv(k) - λv(k-1) + 0.2λv(k-2)
其中:
y(k):系统输出;
u(k):外部输入;
v(k):均值为 0 的高斯随机噪声;
λ:控制噪声强度。
程序最终希望辨识出的 6 个参数为:a₁ = -1.6\a₂ = 0.7\b₁ = 1\b₂ = 0.5\c₁ = -1\c₂ = 0.2
2. 为什么程序先生成一个 M 序列?
辨识系统参数之前,必须让系统“动起来”。
如果输入始终不变,很多参数无法从有限数据中区分出来。
程序使用四级移位寄存器生成周期:L = 15的 M 序列。
一个周期为:0、1、1、1、1、0、0、0、1、0、0、1、1、0、1
然后不断重复扩展,作为系统输入:u(k)
当前辨识使用:500 个采样点
所以程序实际上用一个持续变化的二值伪随机输入不断激励系统。
M 序列的价值可以简单理解为:
它变化丰富、周期明确,能够让系统在不同状态下产生足够的信息,从而帮助算法区分各个参数。
3. 程序怎样构造随机噪声?
程序使用:v(k) ~ N(0,1)生成 500 点高斯白噪声。
当前设置:λ = 0.17
噪声经过系统中的动态关系形成输出扰动:e(k) = 1.6e(k-1) - 0.7e(k-2) + λ[v(k) - v(k-1) + 0.2v(k-2)]
因此真正叠加到输出中的并不是简单独立白噪声,而是经过差分模型形成的相关扰动。
源码还计算:η = √[Σe²(k) / Σu²(k)]
并把它记为 yinta。当 λ=0.17 时,源码注释说明这个量大约为:0.3
更准确地说,它表示代码定义下的:
噪声响应与输入信号之间的均方根能量比例。
4. 为什么还要计算噪声方差?
程序对随机序列 v(k) 计算:COV = (1/500)Σv²(k)
因为 v(k) 使用标准正态分布生成,所以样本数足够多时,这个值应该接近:1
这相当于顺便检查:
当前生成的随机噪声是否符合单位方差白噪声的预期。
由于每次运行都会重新生成随机数,所以 COV 不会固定等于 1,只会在 1 附近波动。
5. 系统输出 y(k) 是怎样产生的?
程序先给定:y(1) 和 y(2)
然后从 k=3 开始递推:
y(k) = 1.6y(k-1) - 0.7y(k-2) + u(k-1) + 0.5u(k-2) + λ[v(k)-v(k-1)+0.2v(k-2)]
因此当前样本并不是外部文件读取的数据,而是:
由一个已知真实模型自动生成的仿真辨识数据。
这样做的好处是,最后可以把辨识结果和真实参数直接比较,判断 RLS 是否收敛正确。
6. 怎样把模型写成“线性参数”形式?
递推最小二乘的关键,是把当前输出写成:y(k) = hᵀ(k)θ + λv(k)
程序构造回归向量:
h(k) = [-y(k-1), -y(k-2), u(k-1), u(k-2), v(k-1), v(k-2)]ᵀ
对应参数向量:θ = [a₁, a₂, b₁, b₂, λc₁, λc₂]ᵀ
真实值为:θ = [-1.6, 0.7, 1, 0.5, -0.17, 0.034]ᵀ*
最后再把第 5、6 个估计值除以 λ,就恢复:c₁ = -1,c₂ = 0.2
这里的 λv(k) 相当于当前时刻无法提前知道的随机创新项,参数估计主要利用过去已知量解释当前输出。
7. 递推最小二乘到底怎样更新参数?
程序从一个很小的初始参数开始:
θ̂(0) = [0.001, 0.001, 0.001, 0.001, 0.001, 0.001]ᵀ
同时设置很大的初始协方差矩阵:P(0) = 10⁶I
表示开始时对参数非常不确定。
每来一个新样本,就先计算增益:
K(k) = P(k-1)h(k) / [1 + hᵀ(k)P(k-1)h(k)]
再计算预测误差:ε(k) = y(k) - hᵀ(k)θ̂(k-1)
然后更新参数:θ̂(k) = θ̂(k-1) + K(k)ε(k)
最后更新协方差:P(k) = P(k-1) - K(k)hᵀ(k)P(k-1)
整个过程重复到第 500 个采样点。
8. 为什么叫“递推”最小二乘?
普通批量最小二乘需要先收集一整批数据,再一次性计算参数。
RLS 的思路不同:
第 3 个样本 → 更新一次
第 4 个样本 → 再更新一次
……
第 500 个样本 → 得到最终估计
每次只需要:上一次参数估计;上一次 P;当前新数据。
因此非常适合:
数据不断实时到来的在线辨识。
不需要每加入一个新样本,就把前面全部 500 个数据重新做一次完整最小二乘计算。
9. 增益 K(k) 在算法里起什么作用?
参数更新可以写成:新参数 = 旧参数 + K × 当前预测误差
所以 K 决定:
当前这一条新数据应该把参数拉动多少。
开始时 P 很大,算法认为参数还很不确定,因此新数据通常会产生比较明显的调整。
随着越来越多数据被吸收,P 会逐渐收缩,参数更新也会趋于稳定。
这就是程序中参数估计曲线通常表现为:前期变化较快 → 后期逐渐靠近真实值并稳定的原因。
10. 最终怎样判断辨识结果好不好?
源码已经知道真实参数:[-1.6, 0.7, 1, 0.5, -1, 0.2]
所以它对每一次递推结果计算绝对误差:
e₁(k) = |â₁(k) - (-1.6)|
e₂(k) = |â₂(k) - 0.7|
其余参数同理。
如果算法工作正常,应该看到:
参数估计逐渐靠近真实值;
六条绝对误差整体减小;
后期估计值在真实参数附近波动。
由于每次运行都会生成新的随机噪声,所以第 500 点的具体数字并不完全固定。
但最终应该接近:
参数 | 理论目标 |
|---|---|
a₁ | -1.6 |
a₂ | 0.7 |
b₁ | 1 |
b₂ | 0.5 |
c₁ | -1 |
c₂ | 0.2 |
这 6 个目标值就是判断辨识是否成功最直接的标准。
11. 为什么 M 序列 + RLS 很适合做参数辨识教学?
优势一:输入具有足够变化
M 序列不是单调或恒定输入,它会持续在 0 和 1 之间变化,能够产生比较丰富的系统响应信息。
优势二:参数更新过程可以实时观察
RLS 每一个采样点都会给出一套新的参数估计,所以不仅能看最终结果,还能看到:
参数是怎样一步一步收敛的。
优势三:真实参数已知,可以直接验证
当前程序属于仿真实验。
先用真实模型生成 y(k),再故意假装参数未知去辨识,所以最终结果可以直接和理论值比较。
优势四:计算量适合在线更新
RLS 不需要每次重新处理全部历史数据,而是利用已有 θ̂ 和 P 接收新样本,因此非常适合实时系统辨识的基本思想演示。
12. 为什么不直接用一次性最小二乘?
如果所有数据已经一次性采集完成,普通最小二乘当然也可以估计参数。
但它更像:收集全部数据 → 建矩阵 → 一次求解
当前程序更关注的是:数据逐点到来 → 参数逐点更新
因此 RLS 更适合演示:
在线辨识;实时参数跟踪;参数收敛过程。
如果以后把真实系统参数改成随时间缓慢变化,还可以进一步扩展到带遗忘因子的递推最小二乘,用于跟踪时变参数。
13. 程序最终能得到什么?
运行 bianshi.m 后,MATLAB 工作区主要得到:
u:M 序列输入;
v:高斯随机噪声;
y:500 点系统输出;
yinta:源码定义的噪声/输入比例;
COV:噪声样本方差;
theta:6 个参数从初始值到第 500 点的全部递推估计;
a1、a2、b1、b2、c1、c2:六条参数估计序列;
e1~e6:对应真实参数的绝对误差。
所以这份程序最核心的结果不是单独一个最终数字,而是:
六个未知参数从“不知道”逐渐收敛到真实值的完整辨识过程。
14. 它适合用在哪里?
自动控制系统辨识教学
可以把离散差分模型、伪随机输入和 RLS 递推估计连成一个完整实验。
在线参数估计入门
适合理解为什么实时系统不一定要等全部实验结束以后再辨识模型。
最小二乘算法学习
程序把回归向量、增益、参数更新和协方差更新全部直接写出,便于理解 RLS 每一步数学关系。
噪声环境下的辨识实验
修改 λ 可以直接观察噪声增强以后,参数收敛速度和最终波动怎样变化。
15. 怎么运行?
主程序只有一个:bianshi.m直接运行即可,不依赖外部数据文件。
程序会自动完成:
生成 M 序列 → 生成随机噪声 → 构造 500 点系统输出 → RLS 递推 498 次 → 输出 6 个最终参数 → 计算参数绝对误差
由于 v=randn(...) 没有固定随机种子,所以每次运行的噪声、yinta 和最终参数末位小数都会略有不同。
如果做扩展实验,最值得改变的是 噪声系数 λ、采样点数 t 和初始协方差 P(0),它们分别影响噪声强度、可用于辨识的数据量和算法初始参数不确定程度。
16. 一句话看懂这个项目
这是一个递推最小二乘参数辨识程序:它用四级移位寄存器生成周期 15 的 M 序列作为输入,在 λ=0.17 的随机噪声下构造 500 点二阶 SISO 离散系统输出,再用 h(k)=[-y(k-1),-y(k-2),u(k-1),u(k-2),v(k-1),v(k-2)]ᵀ 建立回归模型,通过 RLS 增益 K、参数 θ̂ 和协方差 P 的逐点更新,在线辨识 a₁、a₂、b₁、b₂、c₁、c₂ 六个系数,理论目标分别为 [-1.6, 0.7, 1, 0.5, -1, 0.2]。


