初学者入门教程||手把手教你划分常见数据集,并跑通诊断过程
目录
1 引言
2 西储大学数据集
2.1 数据集文件介绍
2.2 数据集提取划分
2.3 故障分类示例
2.4 结果演示
3 华中科技大学轴承数据集
3.1 数据集文件介绍
3.2 数据集提取划分
3.3 故障分类示例
3.4 结果演示
4 江南大学轴承数据集
4.1 数据集文件介绍
4.2 数据集提取划分
4.3 故障分类示例
4.4 结果演示
5 渥太华轴承数据集
5.1 数据集文件介绍
5.2 数据集提取划分
5.3 故障分类示例
5.4 结果演示
6 WT-行星齿轮箱数据集
6.1 数据集文件介绍
6.2 数据集提取划分
6.3 故障分类示例
6.4 结果演示
注:小编能力有限,如有不恰之处,请多多指正~
1 引言
对于故障诊断方向而言,数据处理是开展深度学习研究的第一步。公开故障数据集通常包含振动、电流、转速和负载等监测信息,但不同数据集在文件格式、信号长度、变量名称和标签组织方式上存在较大差异。很多初学者下载数据集后,首先遇到的问题并不是如何搭建复杂模型,而是看不懂文件中保存了什么数据,也不知道应该如何读取、切割和划分样本。
2 西储大学轴承数据集
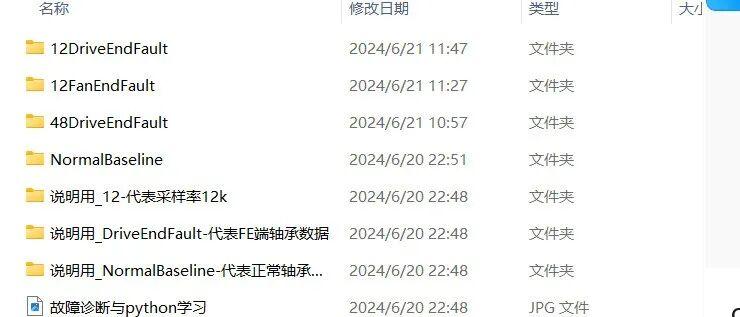
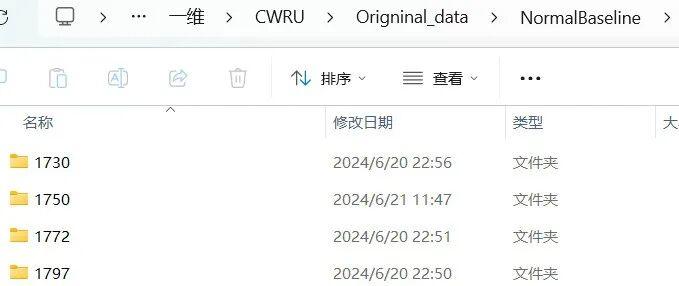
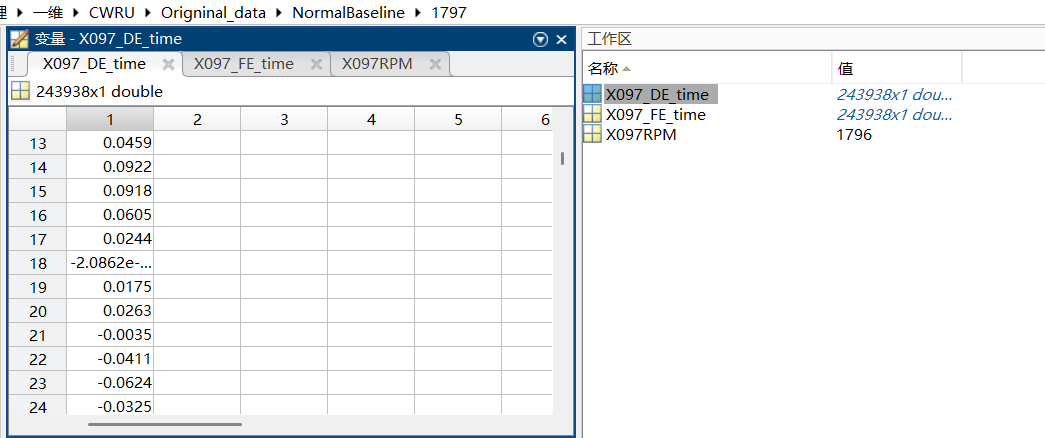
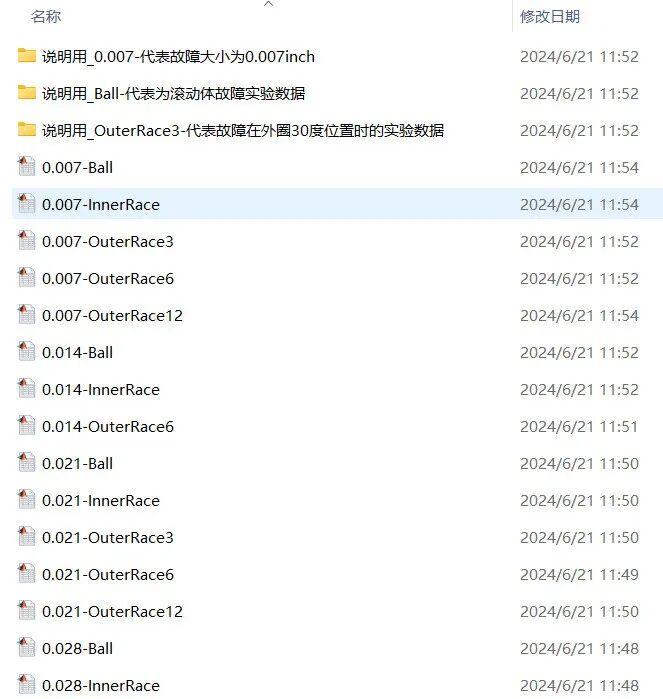
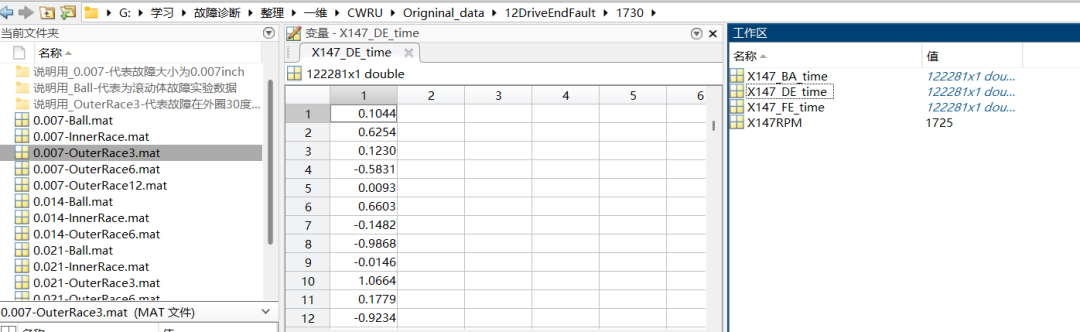
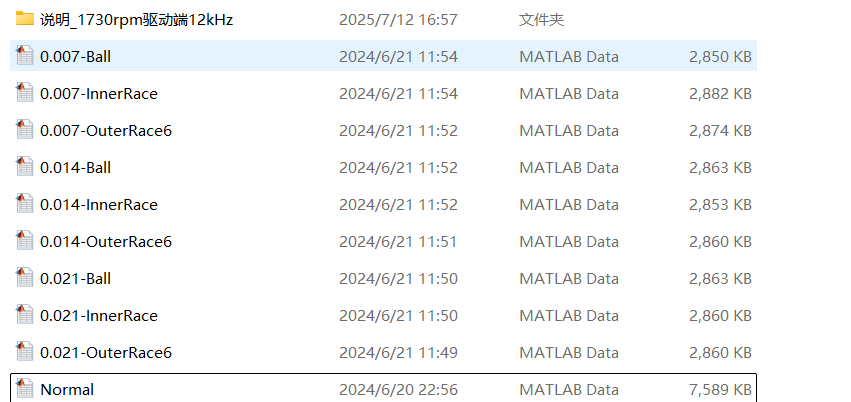
.mat 振动信号,并检查文件、变量名、信号长度及异常值;随后不是先滑窗再随机划分,而是先将每类原始连续信号按 6:2:2 划分为训练、验证和测试区域,并在相邻区域之间设置隔离段,以避免重叠窗口导致训练集与测试集发生数据泄漏;之后仅利用训练区域计算可选的全局 Z-score 归一化参数,再分别对三个区域进行长度为 1024、步长为 512 的滑动窗口采样,其中只随机打乱训练集;最后将训练集、验证集、测试集、类别名称、归一化参数、样本数量及数据制作配置统一保存到一个 cwru_dataset.pt 文件中,并重新加载该文件,对张量形状、数据类型和标签范围进行校验,从而得到一个结构清晰、可复现且可直接供后续 LSTM 等模型训练使用的数据集。(代码如下,也可点击左下角阅读原文获取)from __future__ import annotationsfrom pathlib import Pathimport randomfrom typing import Dict, List, Tupleimport numpy as npimport torchfrom scipy.io import loadmat# -------------------------# 1. 基础配置# -------------------------SEED = 100DATA_DIR = Path(r"G:\学习\故障诊断\整理\一维\CWRU\experimental_data")OUTPUT_FILE = Path("cwru_dataset.pt")MAX_POINTS = 120_000WINDOW_SIZE = 1_024STRIDE = 512SPLIT_RATIOS = (0.6, 0.2, 0.2)# 在相邻数据区域之间留出隔离点,进一步减弱边界附近样本的相关性。# 因为是先分区再滑窗,即使设为 0 也不会发生采样点直接重叠。GAP_POINTS = WINDOW_SIZE# 可选值:"train_global_zscore" 或 "none"NORMALIZATION = "none"CLASS_SPECS = [{"name": "Normal", "label": 0, "file": "Normal.mat", "key": "X100_DE_time"},{"name": "0.007-Ball", "label": 1, "file": "0.007-Ball.mat", "key": "X121_DE_time"},{"name": "0.007-InnerRace", "label": 2, "file": "0.007-InnerRace.mat", "key": "X108_DE_time"},{"name": "0.007-OuterRace6", "label": 3, "file": "0.007-OuterRace6.mat", "key": "X133_DE_time"},{"name": "0.014-Ball", "label": 4, "file": "0.014-Ball.mat", "key": "X188_DE_time"},{"name": "0.014-InnerRace", "label": 5, "file": "0.014-InnerRace.mat", "key": "X172_DE_time"},{"name": "0.014-OuterRace6", "label": 6, "file": "0.014-OuterRace6.mat", "key": "X200_DE_time"},{"name": "0.021-Ball", "label": 7, "file": "0.021-Ball.mat", "key": "X225_DE_time"},{"name": "0.021-InnerRace", "label": 8, "file": "0.021-InnerRace.mat", "key": "X212_DE_time"},{"name": "0.021-OuterRace6", "label": 9, "file": "0.021-OuterRace6.mat", "key": "X237_DE_time"},]def set_seed(seed: int) -> None:random.seed(seed)np.random.seed(seed)torch.manual_seed(seed)set_seed(SEED)print(f"数据目录:{DATA_DIR}")print(f"输出文件:{OUTPUT_FILE.resolve()}")
## 2. 数据读取与检查##每个类别由一条配置记录描述,避免多个平行列表顺序错位。加载时会检查文件、MAT 键名、信号长度以及非有限值def load_signal(data_dir: Path, spec: Dict, max_points: int | None) -> np.ndarray:file_path = data_dir / spec["file"]if not file_path.exists():raise FileNotFoundError(f"找不到数据文件:{file_path}")mat = loadmat(file_path)key = spec["key"]if key not in mat:available = [name for name in mat.keys() if not name.startswith("__")]raise KeyError(f"文件 {file_path.name} 中不存在变量 {key}。可用变量:{available}")signal = np.asarray(mat[key], dtype=np.float32).reshape(-1)if max_points is not None:signal = signal[:max_points]if signal.size < WINDOW_SIZE:raise ValueError(f"{spec['name']} 的有效长度为 {signal.size},小于窗口长度 {WINDOW_SIZE}")if not np.isfinite(signal).all():raise ValueError(f"{spec['name']} 中存在 NaN 或 Inf")return signalsignals: Dict[int, np.ndarray] = {}for spec in CLASS_SPECS:signal = load_signal(DATA_DIR, spec, MAX_POINTS)signals[spec["label"]] = signalprint(f"{spec['label']:>2} | {spec['name']:<20} | length={len(signal)}")
## 3. 先划分原始连续信号,再分别滑窗#原代码将所有重叠窗口混合后随机切分,训练集与测试集可能共享大量相同采样点。本版本先对每条原始信号划分连续区域,再在各区域内部生成窗口。#隔离区不会进入任何集 合,用于减弱分界点附近的高度相似性。def validate_split_ratios(ratios: Tuple[float, float, float]) -> None:if len(ratios) != 3:raise ValueError("SPLIT_RATIOS 必须包含训练、验证、测试三个比例")if any(r <= 0 for r in ratios):raise ValueError("三个划分比例都必须大于 0")if not np.isclose(sum(ratios), 1.0):raise ValueError(f"划分比例之和必须为 1,当前为 {sum(ratios)}")def split_contiguous_signal(signal: np.ndarray,ratios: Tuple[float, float, float],gap_points: int,) -> Dict[str, np.ndarray]:validate_split_ratios(ratios)if gap_points < 0:raise ValueError("gap_points 不能为负数")n = len(signal)train_end = int(n * ratios[0])val_end = int(n * (ratios[0] + ratios[1]))regions = {"train": signal[:train_end],"val": signal[min(train_end + gap_points, n):val_end],"test": signal[min(val_end + gap_points, n):],}for split_name, region in regions.items():if len(region) < WINDOW_SIZE:raise ValueError(f"{split_name} 区域长度 {len(region)} 小于窗口长度 {WINDOW_SIZE}。""请减小 GAP_POINTS、WINDOW_SIZE,或增加原始数据长度。")return regionsregions_by_class: Dict[int, Dict[str, np.ndarray]] = {label: split_contiguous_signal(signal, SPLIT_RATIOS, GAP_POINTS)for label, signal in signals.items()}for spec in CLASS_SPECS:lengths = {k: len(v) for k, v in regions_by_class[spec["label"]].items()}print(f"{spec['name']:<20} -> {lengths}")
## 4. 仅使用训练区域计算归一化参数#默认采用所有训练区域共同计算的全局均值与标准差。这样不会读取验证集和测试集统计量,同时保留不同故障类别之间的相对幅值关系。若不需要归一化,将 `NORMALIZATION` 改为 `"none"`。def fit_normalizer(regions: Dict[int, Dict[str, np.ndarray]],method: str,) -> Dict[str, float | str]:if method == "none":return {"method": "none", "mean": 0.0, "std": 1.0}if method != "train_global_zscore":raise ValueError(f"不支持的归一化方法:{method}")train_values = np.concatenate([class_regions["train"] for class_regions in regions.values()]).astype(np.float64, copy=False)mean = float(train_values.mean())std = float(train_values.std())if std < 1e-12:raise ValueError("训练数据标准差接近 0,无法执行 Z-score 标准化")return {"method": method, "mean": mean, "std": std}def apply_normalizer(signal: np.ndarray, normalizer: Dict[str, float | str]) -> np.ndarray:if normalizer["method"] == "none":return signal.astype(np.float32, copy=False)mean = float(normalizer["mean"])std = float(normalizer["std"])return ((signal - mean) / std).astype(np.float32, copy=False)normalizer = fit_normalizer(regions_by_class, NORMALIZATION)print("归一化配置:", normalizer)
## 5. 生成窗口并组装张量#只打乱训练集。验证集和测试集保持确定顺序,便于复现和定位错误样本。def make_windows(signal: np.ndarray, window_size: int, stride: int) -> np.ndarray:if window_size <= 0 or stride <= 0:raise ValueError("window_size 和 stride 必须为正整数")if len(signal) < window_size:raise ValueError("信号长度小于窗口长度")windows = np.lib.stride_tricks.sliding_window_view(signal, window_size)[::stride]return np.ascontiguousarray(windows, dtype=np.float32)def build_split(regions: Dict[int, Dict[str, np.ndarray]],split_name: str,window_size: int,stride: int,normalizer: Dict[str, float | str],) -> Tuple[torch.Tensor, torch.Tensor, Dict[int, int]]:x_parts: List[np.ndarray] = []y_parts: List[np.ndarray] = []counts: Dict[int, int] = {}for spec in CLASS_SPECS:label = spec["label"]normalized = apply_normalizer(regions[label][split_name], normalizer)windows = make_windows(normalized, window_size, stride)x_parts.append(windows)y_parts.append(np.full(len(windows), label, dtype=np.int64))counts[label] = len(windows)x = np.concatenate(x_parts, axis=0)y = np.concatenate(y_parts, axis=0)# 训练集随机打乱;验证集和测试集保持稳定顺序。if split_name == "train":rng = np.random.default_rng(SEED)order = rng.permutation(len(y))x, y = x[order], y[order]return torch.from_numpy(x), torch.from_numpy(y), countsprepared = {}count_report = {}for split_name in ("train", "val", "test"):x, y, counts = build_split(regions_by_class,split_name,WINDOW_SIZE,STRIDE,normalizer,)prepared[split_name] = {"x": x, "y": y}count_report[split_name] = countsprint(f"{split_name:>5}: x={tuple(x.shape)}, y={tuple(y.shape)}")
## 6. 保存单一数据文件#保存内容包括三个数据集、类别名称、归一化参数、数据制作配置以及每类样本数量。训练 Notebook 不再依赖 CSV 或 Joblib 中间文件。dataset_bundle = {"train": prepared["train"],"val": prepared["val"],"test": prepared["test"],"class_names": [spec["name"] for spec in CLASS_SPECS],"class_specs": CLASS_SPECS,"normalizer": normalizer,"sample_counts_by_class": count_report,"config": {"seed": SEED,"max_points": MAX_POINTS,"window_size": WINDOW_SIZE,"stride": STRIDE,"split_ratios": SPLIT_RATIOS,"gap_points": GAP_POINTS,"normalization": NORMALIZATION,},}torch.save(dataset_bundle, OUTPUT_FILE)print(f"已保存:{OUTPUT_FILE.resolve()}")print(f"文件大小:{OUTPUT_FILE.stat().st_size / 1024 / 1024:.2f} MB")
## 7. 保存后校验#重新读取文件并检查形状、数据类型和标签范围。该单元用于发现保存过程或路径配置问题。def safe_torch_load(path: Path):try:return torch.load(path, map_location="cpu", weights_only=False)except TypeError: # 兼容较旧版本 PyTorchreturn torch.load(path, map_location="cpu")loaded = safe_torch_load(OUTPUT_FILE)num_classes = len(loaded["class_names"])for split_name in ("train", "val", "test"):x = loaded[split_name]["x"]y = loaded[split_name]["y"]assert x.dtype == torch.float32assert y.dtype == torch.int64assert x.ndim == 2 and x.shape[1] == WINDOW_SIZEassert len(x) == len(y)assert int(y.min()) >= 0 and int(y.max()) < num_classesprint(f"{split_name:>5}: samples={len(y)}, "f"x_dtype={x.dtype}, y_range=[{int(y.min())}, {int(y.max())}]")print("数据文件校验通过。")
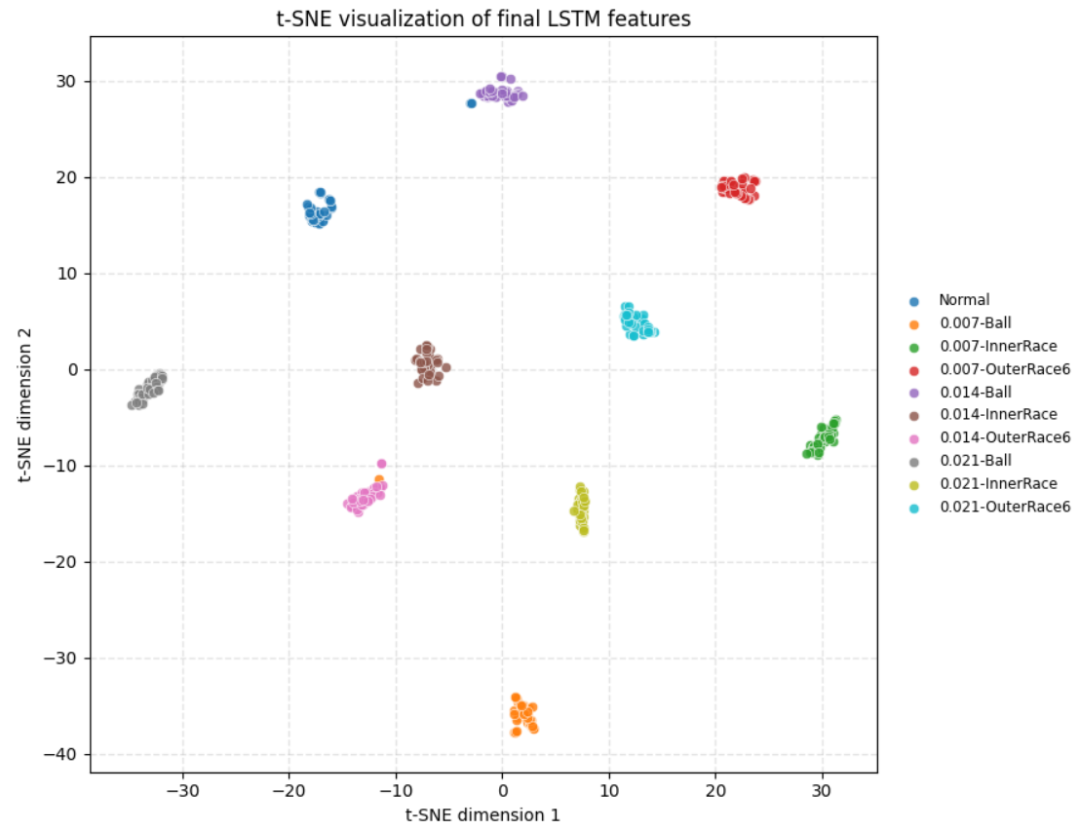
FRAME_SIZE 自动重塑为 LSTM 所需的三维时序输入,例如由 [batch, 1024] 转换为 [batch, 32, 32];随后通过多层隐藏维度依次为 256、128 和 64 的 LSTM 提取时序特征,选取最后一层最后一个时间步的输出,并经过全连接层、ReLU、Dropout 和最终分类层得到各故障类别的预测结果;训练阶段使用交叉熵损失和 Adam 优化器,并结合梯度裁剪、验证集评估、早停机制和最佳模型参数保存,提高训练稳定性并防止过拟合;训练结束后重新加载验证准确率最高的模型,在测试集上输出分类报告和混淆矩阵,同时提取最后一层 LSTM 特征进行 t-SNE 可视化,此外还可通过 torchinfo.summary 查看各层输出形状和模型参数量,从而形成从数据加载、模型构建、训练验证到测试分析的完整故障诊断流程。(代码如下,也可点击左下角阅读原文获取)from __future__ import annotations"""纯堆叠 LSTM 故障分类完整代码数据要求--------默认读取由“CWRU数据集制作_重构版.ipynb”生成的 cwru_dataset.pt。文件结构应包含:bundle["train"]["x"], bundle["train"]["y"]bundle["val"]["x"], bundle["val"]["y"]bundle["test"]["x"], bundle["test"]["y"]bundle["class_names"]bundle["config"]["window_size"]模型结构--------一维信号 -> 自动分帧 -> 多层堆叠 LSTM -> 最后时间步 -> 全连接分类头说明----1. 特征提取部分只使用 LSTM,不使用 CNN、注意力、LayerNorm 或帧编码器。2. 通过 FRAME_SIZE 控制输入重塑方式。3. 验证集和测试集不打乱、不丢弃最后一个批次。4. 保存真正的最佳 state_dict,测试前重新加载。5. 不保存多余的中间数据文件;默认也不保存图片。"""import copyimport osimport randomimport timefrom pathlib import Pathfrom typing import Dict, Optional, Sequence, Tupleimport matplotlib.pyplot as pltimport numpy as npimport torchimport torch.nn as nnfrom sklearn.manifold import TSNEfrom sklearn.metrics import (ConfusionMatrixDisplay,classification_report,confusion_matrix,)from torch.utils.data import DataLoader, TensorDataset
# ============================================================# 1. 参数配置# ============================================================SEED = 100# 数据文件:由数据集制作代码生成DATASET_FILE = Path("cwru_dataset.pt")# 仅保存一个最佳模型检查点OUTPUT_DIR = Path("lstm_outputs")CHECKPOINT_FILE = OUTPUT_DIR / "best_stacked_lstm_checkpoint.pt"# 数据加载BATCH_SIZE = 32NUM_WORKERS = 0 # Windows/Jupyter 环境建议设为 0CPU_NUM_THREADS = min(4, os.cpu_count() or 1)# 训练参数EPOCHS = 100LEARNING_RATE = 1e-3WEIGHT_DECAY = 0.0PATIENCE = 15 # 设为 0 表示关闭早停GRAD_CLIP_NORM = 5.0 # 设为 None 表示关闭梯度裁剪# 模型参数# 对于长度为 1024 的信号:# FRAME_SIZE=32 -> [B, 32, 32]# FRAME_SIZE=16 -> [B, 64, 16]# FRAME_SIZE=64 -> [B, 16, 64]FRAME_SIZE = 32HIDDEN_SIZES = [256, 128,64]CLASSIFIER_DIM = 64DROPOUT_RATE = 0.5# 结果展示SHOW_TORCHINFO = TrueRUN_TSNE = TrueSAVE_FIGURES = False # 默认只显示图片,不保存图片文件DEVICE = torch.device("cuda" if torch.cuda.is_available() else "cpu")
# ============================================================# 2. 通用工具# ============================================================def set_seed(seed: int) -> None:"""固定随机种子,尽量提高实验可复现性。"""random.seed(seed)np.random.seed(seed)torch.manual_seed(seed)if torch.cuda.is_available():torch.cuda.manual_seed(seed)torch.cuda.manual_seed_all(seed)# 确定性设置可能略微降低运行速度torch.backends.cudnn.deterministic = Truetorch.backends.cudnn.benchmark = Falsedef safe_torch_load(path: Path, map_location: str | torch.device = "cpu"):"""兼容不同 PyTorch 版本的 torch.load。"""try:return torch.load(path,map_location=map_location,weights_only=False,)except TypeError:return torch.load(path, map_location=map_location)def validate_dataset_bundle(bundle: dict) -> None:"""检查数据文件是否包含训练所需字段。"""required_splits = ("train", "val", "test")for split_name in required_splits:if split_name not in bundle:raise KeyError(f"数据文件缺少字段:{split_name}")split = bundle[split_name]if "x" not in split or "y" not in split:raise KeyError(f"数据文件中的 {split_name} 必须包含 x 和 y")x = split["x"]y = split["y"]if not isinstance(x, torch.Tensor):raise TypeError(f"{split_name}.x 必须是 torch.Tensor")if not isinstance(y, torch.Tensor):raise TypeError(f"{split_name}.y 必须是 torch.Tensor")if x.ndim != 2:raise ValueError(f"{split_name}.x 应为 [样本数, 信号长度],"f"实际形状为 {tuple(x.shape)}")if y.ndim != 1:raise ValueError(f"{split_name}.y 应为一维标签,"f"实际形状为 {tuple(y.shape)}")if len(x) != len(y):raise ValueError(f"{split_name} 的样本数与标签数不一致:"f"{len(x)} != {len(y)}")if len(x) == 0:raise ValueError(f"{split_name} 中没有样本")if "class_names" not in bundle:raise KeyError("数据文件缺少 class_names")def create_data_loader(x: torch.Tensor,y: torch.Tensor,batch_size: int,shuffle: bool,seed: int,) -> DataLoader:"""创建 DataLoader。"""dataset = TensorDataset(x.float(), y.long())generator = Noneif shuffle:generator = torch.Generator()generator.manual_seed(seed)return DataLoader(dataset,batch_size=batch_size,shuffle=shuffle,drop_last=False,num_workers=NUM_WORKERS,pin_memory=(DEVICE.type == "cuda"),generator=generator,)
# ============================================================# 3. 纯堆叠 LSTM 分类模型# ============================================================class StackedLSTMClassifier(nn.Module):"""多层堆叠 LSTM 故障分类模型。输入----x: [batch_size, signal_length]模型内部自动重塑为------------------[batch_size, time_steps, frame_size]其中----time_steps = signal_length // frame_size特征提取部分只由多个 LSTM 层组成。"""def __init__(self,frame_size: int,hidden_sizes: Sequence[int],num_classes: int,classifier_dim: int = 64,dropout_rate: float = 0.5,) -> None:super().__init__()if frame_size <= 0:raise ValueError("frame_size 必须为正整数")if not hidden_sizes:raise ValueError("hidden_sizes 不能为空")if any(size <= 0 for size in hidden_sizes):raise ValueError("hidden_sizes 中的维度必须为正整数")if num_classes <= 1:raise ValueError("num_classes 必须大于 1")if not 0.0 <= dropout_rate < 1.0:raise ValueError("dropout_rate 必须位于 [0, 1)")self.frame_size = int(frame_size)self.hidden_sizes = list(hidden_sizes)# 各层隐藏维度可以不同,因此使用 ModuleList 分别构建。self.lstm_layers = nn.ModuleList()current_input_dim = self.frame_sizefor hidden_dim in self.hidden_sizes:self.lstm_layers.append(nn.LSTM(input_size=current_input_dim,hidden_size=hidden_dim,num_layers=1,batch_first=True,))current_input_dim = hidden_dim# 分类头不承担时序特征提取,只负责类别映射。self.classifier = nn.Sequential(nn.Linear(self.hidden_sizes[-1], classifier_dim),nn.ReLU(),nn.Dropout(dropout_rate),nn.Linear(classifier_dim, num_classes),)def reshape_signal(self, x: torch.Tensor) -> torch.Tensor:"""把一维信号自动划分成多个连续小帧。"""if x.ndim != 2:raise ValueError("模型期望输入形状为 [batch_size, signal_length],"f"实际输入形状为 {tuple(x.shape)}")signal_length = x.size(1)if signal_length % self.frame_size != 0:raise ValueError(f"信号长度 {signal_length} 不能被 "f"FRAME_SIZE={self.frame_size} 整除")# -1 自动计算时间步数。return x.reshape(x.size(0), -1, self.frame_size)def forward_features(self, x: torch.Tensor) -> torch.Tensor:"""返回最后一层 LSTM 最后一个时间步的特征。该特征可用于 t-SNE 或其他特征分析。"""sequence = self.reshape_signal(x)for lstm_layer in self.lstm_layers:sequence, _ = lstm_layer(sequence)return sequence[:, -1, :]def forward(self, x: torch.Tensor) -> torch.Tensor:features = self.forward_features(x)logits = self.classifier(features)return logits
# =========================# 创建纯堆叠 LSTM 模型# =========================NUM_CLASSES=10SIGNAL_LENGTH=1024model = StackedLSTMClassifier(frame_size=FRAME_SIZE,hidden_sizes=HIDDEN_SIZES,num_classes=NUM_CLASSES,classifier_dim=CLASSIFIER_DIM,dropout_rate=DROPOUT_RATE).to(DEVICE)# =========================# 查看网络结构及参数量# 输入形状:[batch_size, signal_length]# 模型内部会将 [32, 1024] 重塑为 [32, 32, 32]# =========================from torchinfo import summarysummary(model,input_size=(BATCH_SIZE, SIGNAL_LENGTH),device=str(DEVICE))
# ============================================================# 4. 单轮训练与验证# ============================================================def run_epoch(model: nn.Module,loader: DataLoader,criterion: nn.Module,optimizer: Optional[torch.optim.Optimizer] = None,) -> Tuple[float, float]:"""运行一个训练轮次或验证轮次。optimizer 不为 None:训练模式optimizer 为 None:验证/测试模式"""is_training = optimizer is not Nonemodel.train(is_training)total_loss = 0.0total_correct = 0total_samples = 0for signals, labels in loader:signals = signals.to(DEVICE, non_blocking=True)labels = labels.to(DEVICE, non_blocking=True)if is_training:optimizer.zero_grad(set_to_none=True)with torch.set_grad_enabled(is_training):logits = model(signals)loss = criterion(logits, labels)if is_training:loss.backward()if GRAD_CLIP_NORM is not None:nn.utils.clip_grad_norm_(model.parameters(),max_norm=GRAD_CLIP_NORM,)optimizer.step()current_batch_size = labels.size(0)total_loss += loss.item() * current_batch_sizetotal_correct += (logits.argmax(dim=1) == labels).sum().item()total_samples += current_batch_sizeif total_samples == 0:raise RuntimeError("DataLoader 中没有可用样本")average_loss = total_loss / total_samplesaccuracy = total_correct / total_samplesreturn average_loss, accuracy
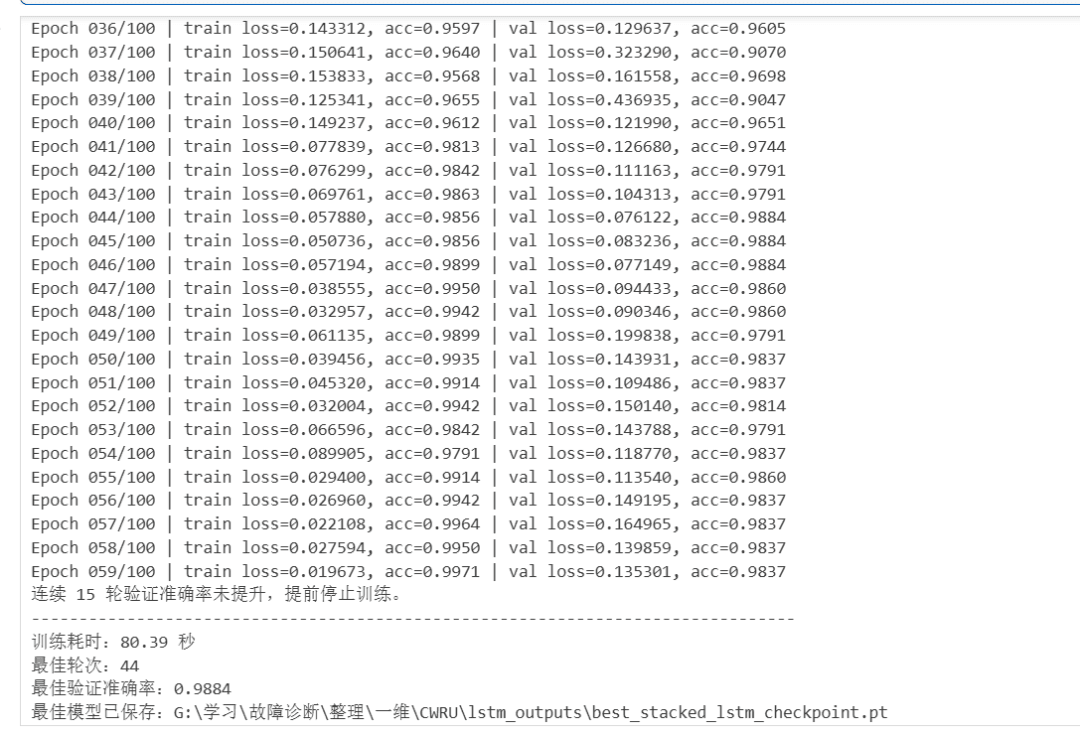
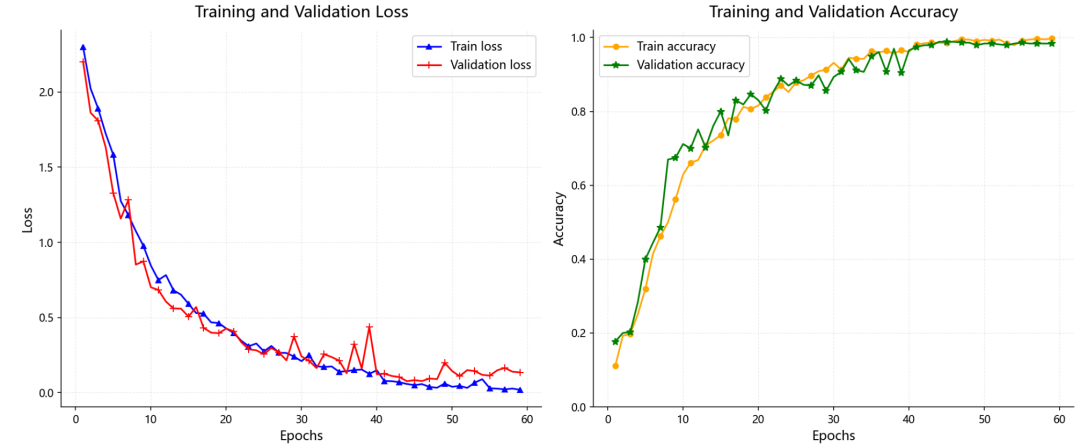
# ============================================================# 5. 完整训练流程# ============================================================def train_model(model: nn.Module,train_loader: DataLoader,val_loader: DataLoader,criterion: nn.Module,optimizer: torch.optim.Optimizer,epochs: int,patience: int,checkpoint_file: Path,model_config: Dict,class_names: Sequence[str],dataset_config: Dict,) -> Tuple[Dict[str, list], int, float]:"""训练模型,并保存验证集准确率最高的参数。"""history = {"train_loss": [],"train_accuracy": [],"val_loss": [],"val_accuracy": [],}best_state = copy.deepcopy(model.state_dict())best_val_accuracy = float("-inf")best_epoch = 0epochs_without_improvement = 0start_time = time.time()for epoch in range(1, epochs + 1):train_loss, train_accuracy = run_epoch(model=model,loader=train_loader,criterion=criterion,optimizer=optimizer,)with torch.no_grad():val_loss, val_accuracy = run_epoch(model=model,loader=val_loader,criterion=criterion,optimizer=None,)history["train_loss"].append(train_loss)history["train_accuracy"].append(train_accuracy)history["val_loss"].append(val_loss)history["val_accuracy"].append(val_accuracy)print(f"Epoch {epoch:03d}/{epochs:03d} | "f"train loss={train_loss:.6f}, "f"acc={train_accuracy:.4f} | "f"val loss={val_loss:.6f}, "f"acc={val_accuracy:.4f}")if val_accuracy > best_val_accuracy:best_val_accuracy = val_accuracybest_epoch = epochbest_state = copy.deepcopy(model.state_dict())epochs_without_improvement = 0else:epochs_without_improvement += 1if patience > 0 and epochs_without_improvement >= patience:print(f"连续 {patience} 轮验证准确率未提升,提前停止训练。")break# 将内存中的模型恢复到真正的最佳状态。model.load_state_dict(best_state)checkpoint_file.parent.mkdir(parents=True, exist_ok=True)checkpoint = {"model_state_dict": best_state,"model_config": model_config,"best_epoch": best_epoch,"best_val_accuracy": best_val_accuracy,"history": history,"class_names": list(class_names),"dataset_config": dataset_config,"seed": SEED,}torch.save(checkpoint, checkpoint_file)elapsed = time.time() - start_timeprint("-" * 80)print(f"训练耗时:{elapsed:.2f} 秒")print(f"最佳轮次:{best_epoch}")print(f"最佳验证准确率:{best_val_accuracy:.4f}")print(f"最佳模型已保存:{checkpoint_file.resolve()}")return history, best_epoch, best_val_accuracy
# ============================================================# 6. 加载最佳模型# ============================================================def load_best_model(checkpoint_file: Path,device: torch.device,) -> Tuple[StackedLSTMClassifier, dict]:"""从检查点重新构造并加载最佳模型。"""checkpoint = safe_torch_load(checkpoint_file,map_location=device,)model = StackedLSTMClassifier(**checkpoint["model_config"]).to(device)model.load_state_dict(checkpoint["model_state_dict"])model.eval()return model, checkpoint
# ============================================================# 7. 测试预测与中间特征提取# ============================================================def predict_with_features(model: StackedLSTMClassifier,loader: DataLoader,) -> Tuple[np.ndarray, np.ndarray, np.ndarray]:"""返回真实标签、预测标签以及 LSTM 特征。"""true_labels = []predicted_labels = []feature_list = []model.eval()with torch.no_grad():for signals, labels in loader:signals = signals.to(DEVICE, non_blocking=True)features = model.forward_features(signals)logits = model.classifier(features)predictions = logits.argmax(dim=1)true_labels.append(labels.cpu().numpy())predicted_labels.append(predictions.cpu().numpy())feature_list.append(features.cpu().numpy())return (np.concatenate(true_labels),np.concatenate(predicted_labels),np.concatenate(feature_list),)
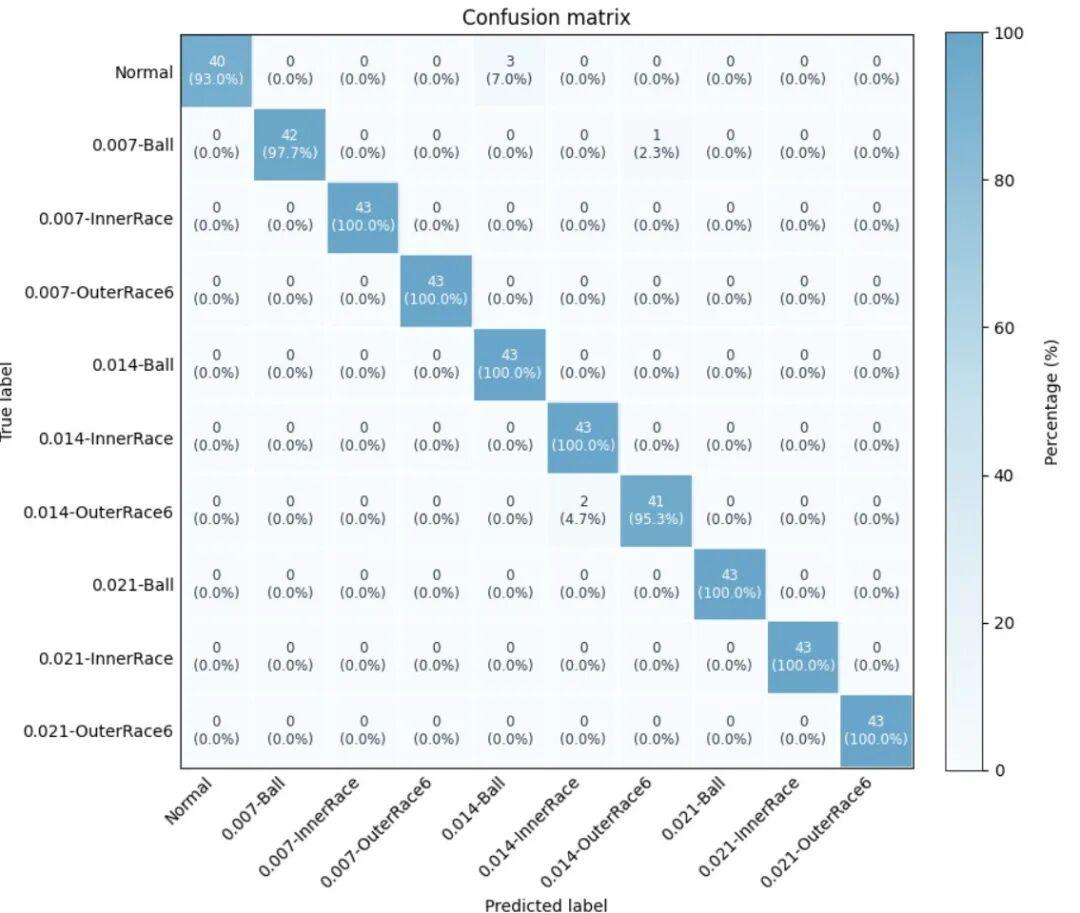
# ============================================================# 8. 结果绘图# ============================================================from sklearn.preprocessing import StandardScalerfrom matplotlib.colors import LinearSegmentedColormapdef plot_training_history(history: Dict[str, list],save_figures: bool = False,) -> None:"""在同一张画布中绘制训练过程。左图:训练损失和验证损失;右图:训练准确率和验证准确率。"""epochs = np.arange(1,len(history["train_loss"]) + 1,)# 中文字体设置plt.rcParams["font.sans-serif"] = ["Microsoft YaHei","SimHei","Arial Unicode MS","DejaVu Sans",]plt.rcParams["axes.unicode_minus"] = False# 创建一行两列子图fig, axes = plt.subplots(1,2,figsize=(14, 6),dpi=150,)# 为防止训练轮数较多时标记过于密集,# 大约每隔总轮数的1/20显示一个标记marker_interval = max(1, len(epochs) // 20)# ========================================================# 左图:训练损失和验证损失# ========================================================axes[0].plot(epochs,history["train_loss"],label="Train loss",color="blue",linewidth=1.6,marker="^",markersize=5,markevery=marker_interval,)axes[0].plot(epochs,history["val_loss"],label="Validation loss",color="red",linewidth=1.6,marker="+",markersize=7,markevery=marker_interval,)axes[0].set_xlabel("Epochs",fontsize=12,)axes[0].set_ylabel("Loss",fontsize=12,)axes[0].set_title("Training and Validation Loss",fontsize=15,pad=12,)axes[0].tick_params(axis="both",labelsize=10,)axes[0].legend(fontsize=11,frameon=True,)axes[0].grid(True,linestyle="--",linewidth=0.6,alpha=0.3,)axes[0].set_axis below(True)# ========================================================# 右图:训练准确率和验证准确率# ========================================================axes[1].plot(epochs,history["train_accuracy"],label="Train accuracy",color="orange",linewidth=1.6,marker="o",markersize=5,markevery=marker_interval,)axes[1].plot(epochs,history["val_accuracy"],label="Validation accuracy",color="green",linewidth=1.6,marker="*",markersize=7,markevery=marker_interval,)axes[1].set_xlabel("Epochs",fontsize=12,)axes[1].set_ylabel("Accuracy",fontsize=12,)axes[1].set_title("Training and Validation Accuracy",fontsize=15,pad=12,)axes[1].tick_params(axis="both",labelsize=10,)axes[1].legend(fontsize=11,frameon=True,)axes[1].grid(True,linestyle="--",linewidth=0.6,alpha=0.3,)axes[1].set_axis below(True)# 准确率若采用0~1表示,可固定纵轴范围axes[1].set_ylim(0.0, 1.02)# 去掉顶部和右侧边框,使图像更加简洁for ax in axes:ax.spines["top"].set_visible(False)ax.spines["right"].set_visible(False)# 自动调整子图间距fig.tight_layout()# 保存整张训练过程图if save_figures:OUTPUT_DIR.mkdir(parents=True,exist_ok=True,)fig.savefig(OUTPUT_DIR / "training_history.png",dpi=300,bbox_inches="tight",)plt.show()def plot_confusion_matrix(y_true: np.ndarray,y_pred: np.ndarray,class_names: Sequence[str],save_figures: bool = False,) -> None:"""绘制学术风格混淆矩阵。颜色表示每个真实类别内部的预测百分比,单元格同时显示样本数量和所占百分比。"""labels = list(range(len(class_names)))# 原始计数混淆矩阵cm = confusion_matrix(y_true,y_pred,labels=labels,)# 按真实类别进行行归一化row_sums = cm.sum(axis=1, keepdims=True)cm_percent = np.divide(cm,row_sums,out=np.zeros_like(cm, dtype=float),where=row_sums != 0,) * 100.0figure_width = max(9, len(class_names) * 0.9)figure_height = max(8, len(class_names) * 0.8)fig, ax = plt.subplots(figsize=(figure_width, figure_height))# 自定义浅蓝色学术风格色图academic_blue = LinearSegmentedColormap.from_list("academic_blue",["#F8FBFD","#E5F1F7","#C7E1ED","#98C5DB","#68A5C8",],)image = ax.imshow(cm_percent,interpolation="nearest",cmap=academic_blue,vmin=0,vmax=100,aspect="equal",)# 颜色条colorbar = fig.colorbar(image,ax=ax,fraction=0.046,pad=0.04,)colorbar.set_label("Percentage (%)",rotation=90,labelpad=12,)colorbar.outline.set_linewidth(0.6)# 坐标轴刻度ax.set_xticks(np.arange(len(class_names)))ax.set_yticks(np.arange(len(class_names)))ax.set_xticklabels(class_names,rotation=45,ha="right",)ax.set_yticklabels(class_names)ax.set_xlabel("Predicted label")ax.set_ylabel("True label")ax.set_title("Confusion matrix")# 单元格标注:数量 + 百分比threshold = 60.0for row_index in range(cm.shape[0]):for column_index in range(cm.shape[1]):count = cm[row_index, column_index]percentage = cm_percent[row_index, column_index]text_color = ("white"if percentage >= thresholdelse "#263746")ax.text(column_index,row_index,f"{count}\n({percentage:.1f}%)",ha="center",va="center",fontsize=8.5,color=text_color,)# 绘制浅色单元格边界ax.set_xticks(np.arange(-0.5, len(class_names), 1),minor=True,)ax.set_yticks(np.arange(-0.5, len(class_names), 1),minor=True,)ax.grid(which="minor",color="white",linestyle="-",linewidth=1.2,)ax.tick_params(which="minor",bottom=False,left=False,)ax.tick_params(axis="both",which="major",length=0,)fig.tight_layout()if save_figures:OUTPUT_DIR.mkdir(parents=True,exist_ok=True,)fig.savefig(OUTPUT_DIR / "confusion_matrix.png",dpi=300,bbox_inches="tight",)plt.show()def plot_tsne(features: np.ndarray,labels: np.ndarray,class_names: Sequence[str],save_figures: bool = False,) -> None:"""使用最后一层 LSTM 特征绘制学术风格 t-SNE 图。"""sample_count = len(features)if sample_count < 6:print("测试样本过少,跳过 t-SNE。")return# perplexity 必须小于样本数量perplexity = min(30,max(5, (sample_count - 1) // 3),)# 特征标准化,减小不同特征尺度对 t-SNE 的影响standardized_features = StandardScaler().fit_transform(features)# t-SNE降维embedding = TSNE(n_components=2,perplexity=perplexity,init="pca",learning_rate="auto",random_state=SEED,).fit_transform(standardized_features)fig, ax = plt.subplots(figsize=(9, 7))# 使用Matplotlib的标准分类配色color_map = plt.get_cmap("tab10",len(class_names),)for class_index, class_name in enumerate(class_names):mask = labels == class_indexif not np.any(mask):continueax.scatter(embedding[mask, 0],embedding[mask, 1],s=36,alpha=0.82,color=color_map(class_index),edgecolors="white",linewidths=0.45,label=class_name,zorder=3,)ax.set_xlabel("t-SNE dimension 1")ax.set_ylabel("t-SNE dimension 2")ax.set_title("t-SNE visualization of final LSTM features")# 设置网格位于散点下方ax.set_axis below(True)ax.grid(True,linestyle="--",linewidth=1,alpha=0.35,)# 去除顶部和右侧边框ax.spines["top"].set_visible(True)ax.spines["right"].set_visible(True)# 减弱左侧和底部边框ax.spines["left"].set_linewidth(0.8)ax.spines["bottom"].set_linewidth(0.8)# 图例放在图像右侧,避免遮挡散点ax.legend(loc="center left",bbox_to_anchor=(1.02, 0.5),fontsize=8.5,frameon=False,borderaxespad=0.0,)ax.margins(0.06)fig.tight_layout()if save_figures:OUTPUT_DIR.mkdir(parents=True,exist_ok=True,)fig.savefig(OUTPUT_DIR / "tsne_features.png",dpi=300,bbox_inches="tight",)plt.show()plt.show()
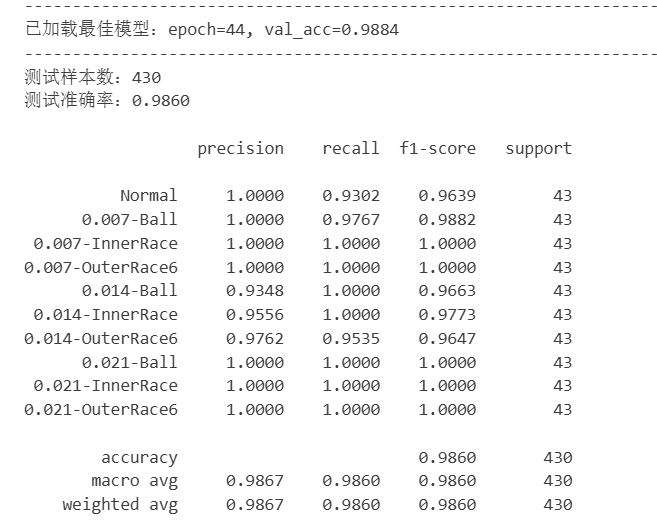
# ============================================================# 9. 主程序# ============================================================def main() -> None:set_seed(SEED)if DEVICE.type == "cpu":torch.set_num_threads(CPU_NUM_THREADS)print(f"运行设备:{DEVICE}")if DEVICE.type == "cpu":print(f"PyTorch CPU 线程数:{torch.get_num_threads()}")if not DATASET_FILE.exists():raise FileNotFoundError(f"找不到数据文件:{DATASET_FILE.resolve()}\n""请先运行数据集制作代码生成 cwru_dataset.pt。")bundle = safe_torch_load(DATASET_FILE,map_location="cpu",)validate_dataset_bundle(bundle)class_names = list(bundle["class_names"])num_classes = len(class_names)train_x = bundle["train"]["x"].float()train_y = bundle["train"]["y"].long()val_x = bundle["val"]["x"].float()val_y = bundle["val"]["y"].long()test_x = bundle["test"]["x"].float()test_y = bundle["test"]["y"].long()signal_length = int(train_x.shape[1])if val_x.shape[1] != signal_length or test_x.shape[1] != signal_length:raise ValueError("训练、验证和测试集的信号长度不一致")if signal_length % FRAME_SIZE != 0:raise ValueError(f"信号长度 {signal_length} 不能被 "f"FRAME_SIZE={FRAME_SIZE} 整除")all_labels = torch.cat([train_y, val_y, test_y])if all_labels.min().item() < 0:raise ValueError("标签中存在负数")if all_labels.max().item() >= num_classes:raise ValueError("标签最大值超过 class_names 对应的类别数")time_steps = signal_length // FRAME_SIZEprint("-" * 80)print(f"类别数量:{num_classes}")print(f"类别名称:{class_names}")print(f"单个样本长度:{signal_length}")print(f"LSTM 输入形状:[batch, {time_steps}, {FRAME_SIZE}]")print(f"训练/验证/测试样本数:"f"{len(train_x)}/{len(val_x)}/{len(test_x)}")train_loader = create_data_loader(train_x,train_y,batch_size=BATCH_SIZE,shuffle=True,seed=SEED,)val_loader = create_data_loader(val_x,val_y,batch_size=BATCH_SIZE,shuffle=False,seed=SEED,)test_loader = create_data_loader(test_x,test_y,batch_size=BATCH_SIZE,shuffle=False,seed=SEED,)model_config = {"frame_size": FRAME_SIZE,"hidden_sizes": HIDDEN_SIZES,"num_classes": num_classes,"classifier_dim": CLASSIFIER_DIM,"dropout_rate": DROPOUT_RATE,}model = StackedLSTMClassifier(**model_config).to(DEVICE)parameter_count = sum(parameter.numel()for parameter in model.parameters()if parameter.requires_grad)print("-" * 80)print(model)print(f"可训练参数量:{parameter_count:,}")if SHOW_TORCHINFO:try:from torchinfo import summarysummary(model,input_size=(BATCH_SIZE, signal_length),device=str(DEVICE),)except ImportError:print("未安装 torchinfo,跳过网络结构摘要。""可执行:pip install torchinfo")except Exception as exc:print(f"torchinfo 摘要生成失败:{exc}")criterion = nn.CrossEntropyLoss()optimizer = torch.optim.Adam(model.parameters(),lr=LEARNING_RATE,weight_decay=WEIGHT_DECAY,)history, best_epoch, best_val_accuracy = train_model(model=model,train_loader=train_loader,val_loader=val_loader,criterion=criterion,optimizer=optimizer,epochs=EPOCHS,patience=PATIENCE,checkpoint_file=CHECKPOINT_FILE,model_config=model_config,class_names=class_names,dataset_config=bundle.get("config", {}),)plot_training_history(history,save_figures=SAVE_FIGURES,)# 测试前重新从磁盘加载最佳模型,避免误用最后一轮模型。best_model, checkpoint = load_best_model(CHECKPOINT_FILE,DEVICE,)print("-" * 80)print(f"已加载最佳模型:epoch={checkpoint['best_epoch']}, "f"val_acc={checkpoint['best_val_accuracy']:.4f}")y_true, y_pred, test_features = predict_with_features(best_model,test_loader,)test_accuracy = float(np.mean(y_true == y_pred))print("-" * 80)print(f"测试样本数:{len(y_true)}")print(f"测试准确率:{test_accuracy:.4f}")print()print(classification_report(y_true,y_pred,labels=list(range(num_classes)),target_names=class_names,digits=4,zero_division=0,))plot_confusion_matrix(y_true,y_pred,class_names,save_figures=SAVE_FIGURES,)if RUN_TSNE:plot_tsne(test_features,y_true,class_names,save_figures=SAVE_FIGURES,)
3 华中科技大学轴承数据集
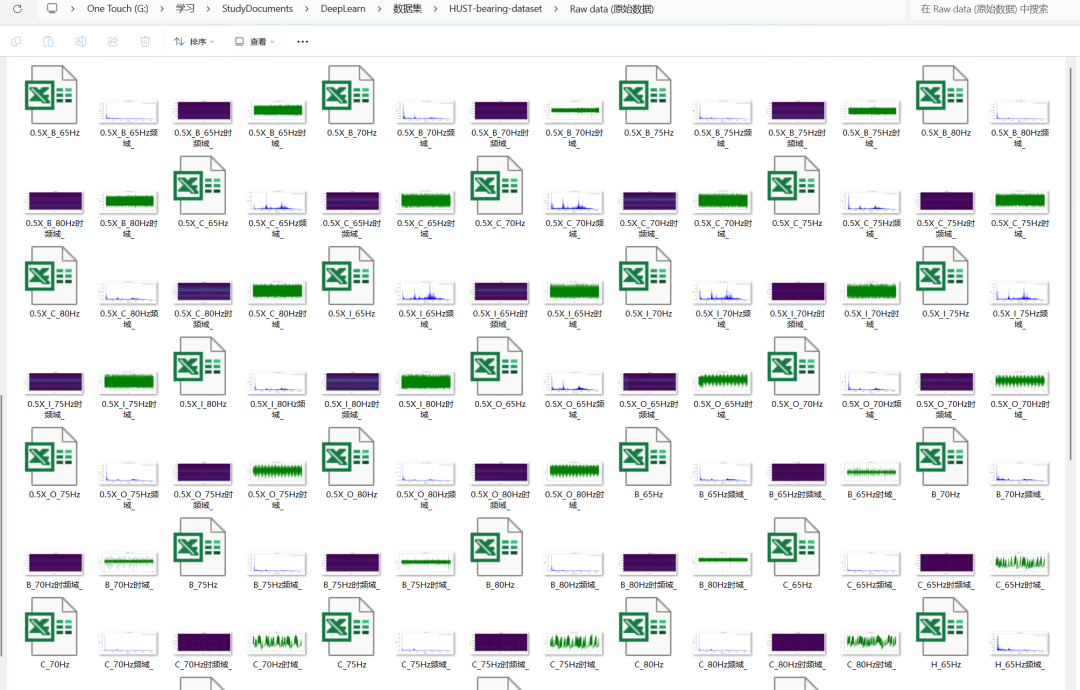
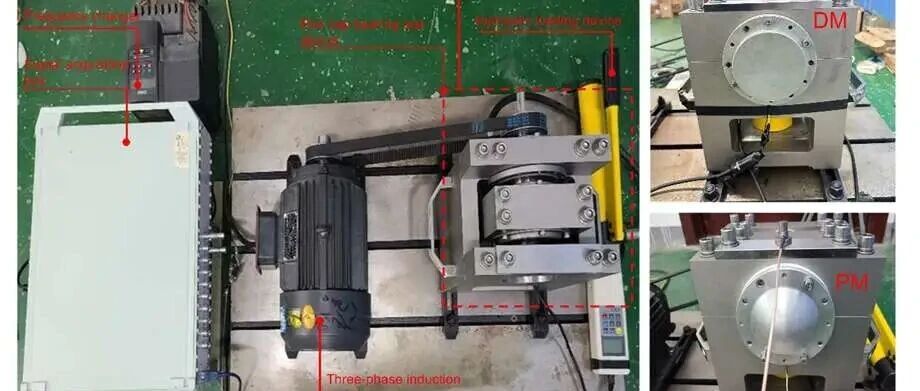
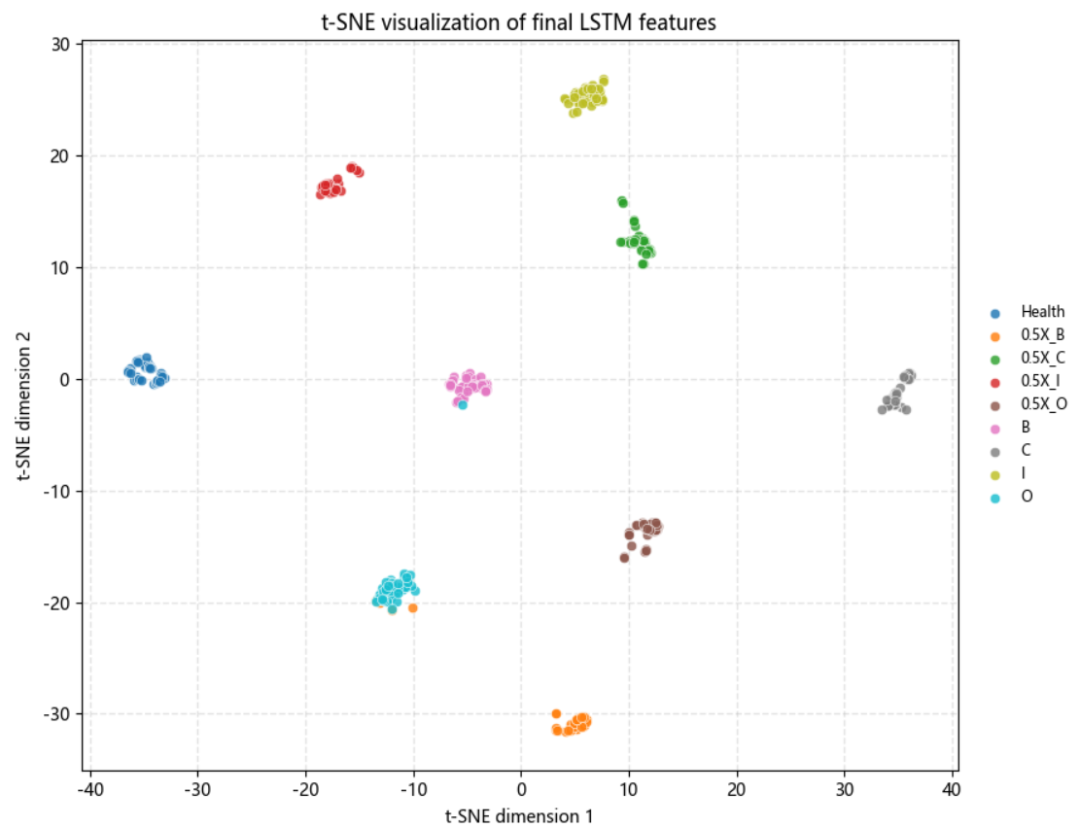
原始数据文件包括36个文件(9个状态乘以4个工作条件),每个文件为Excel格式。例如,文件名“0.5X_B_65Hz”表示在65Hz工作条件下发生滚动体中度故障,其中0.5X表示中度故障。
H:健康 I:内圈故障 O:外圈故障 B:球故障 C:组合故障
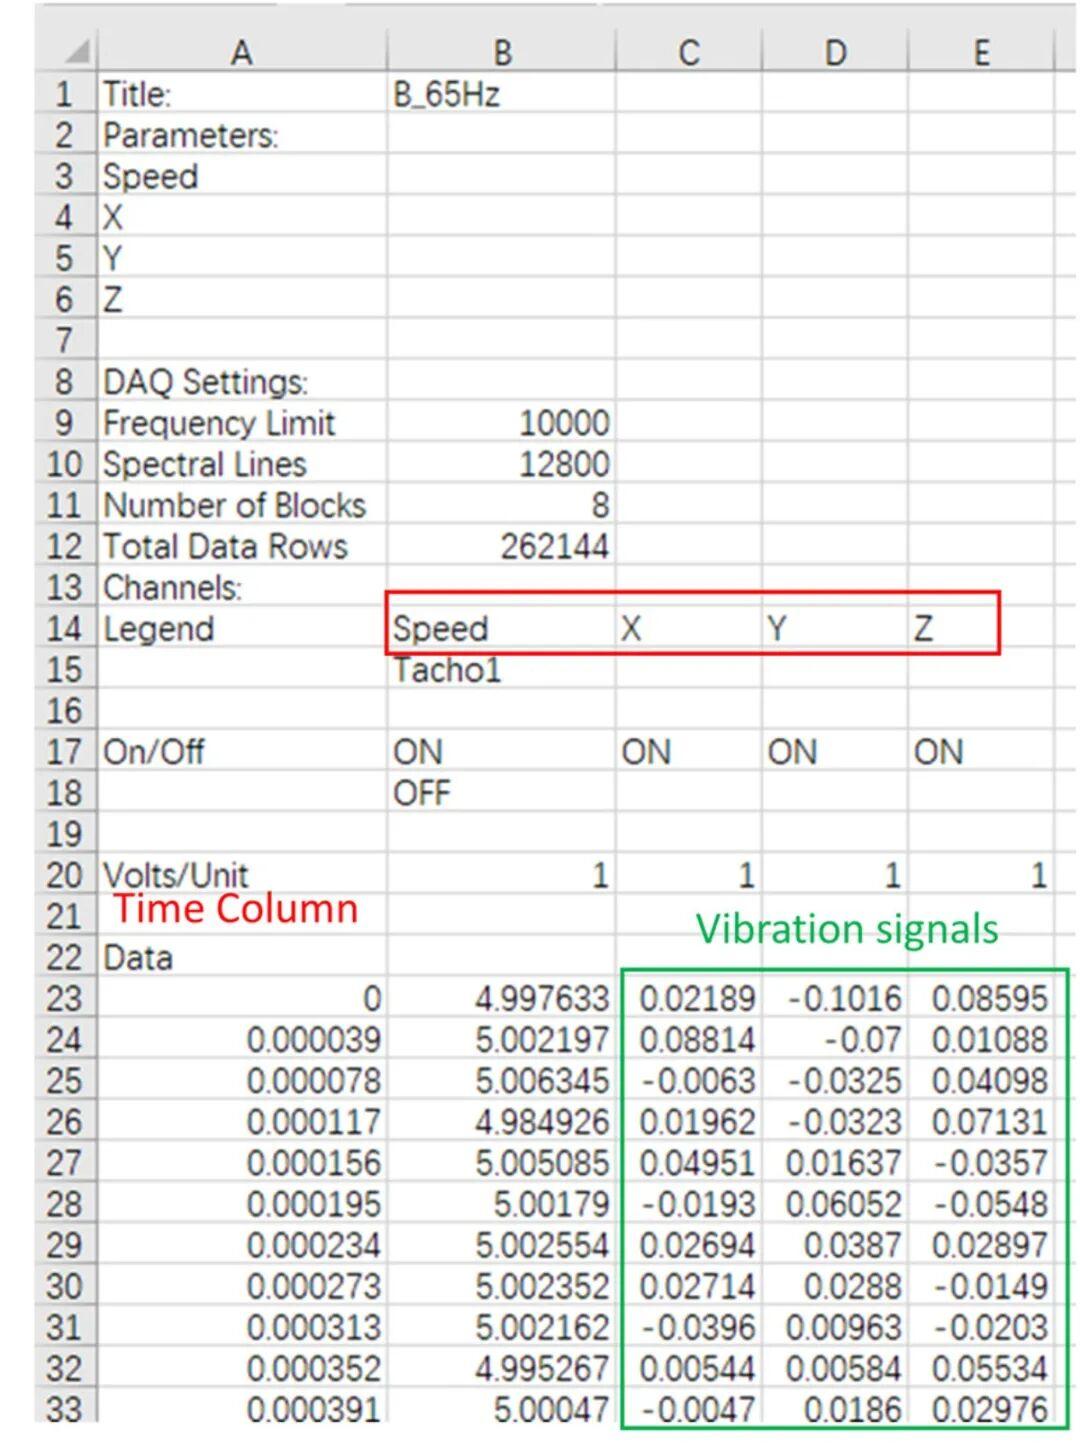
.pt 文件,并重新加载检查张量维度、数据类型、标签范围及 NaN/Inf,从而形成一套完整、可追溯且可直接供 LSTM 等故障分类模型使用的数据预处理流程。(注:与西储大学轴承数据集制作代码仅有数据集加载路径及方式区别,并且预处理的轴承故障数据集由cwru_dataset.pt变成HUST_dataset.pt。这里不再给出代码,可点击左下角阅读原文获取)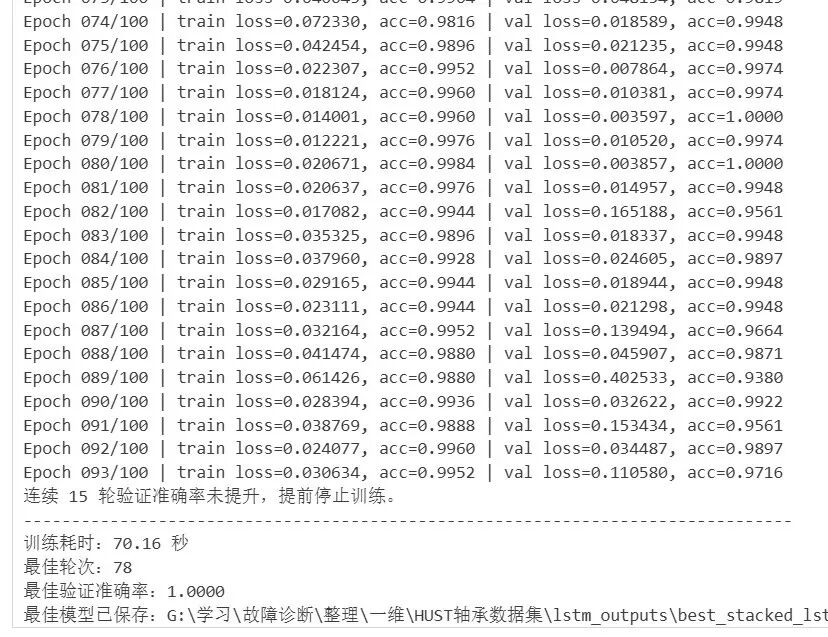
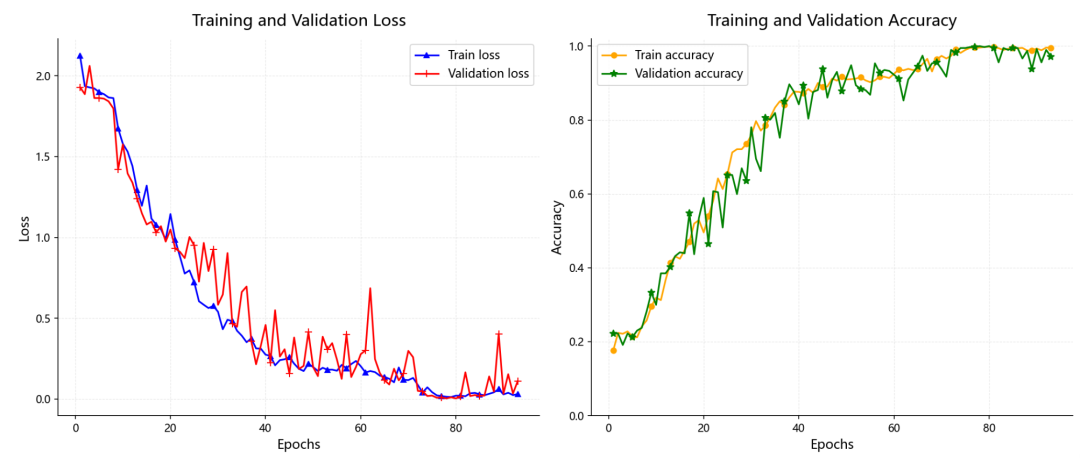
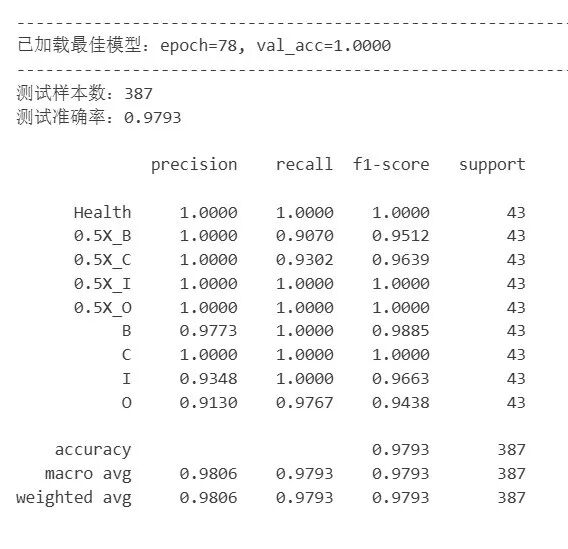
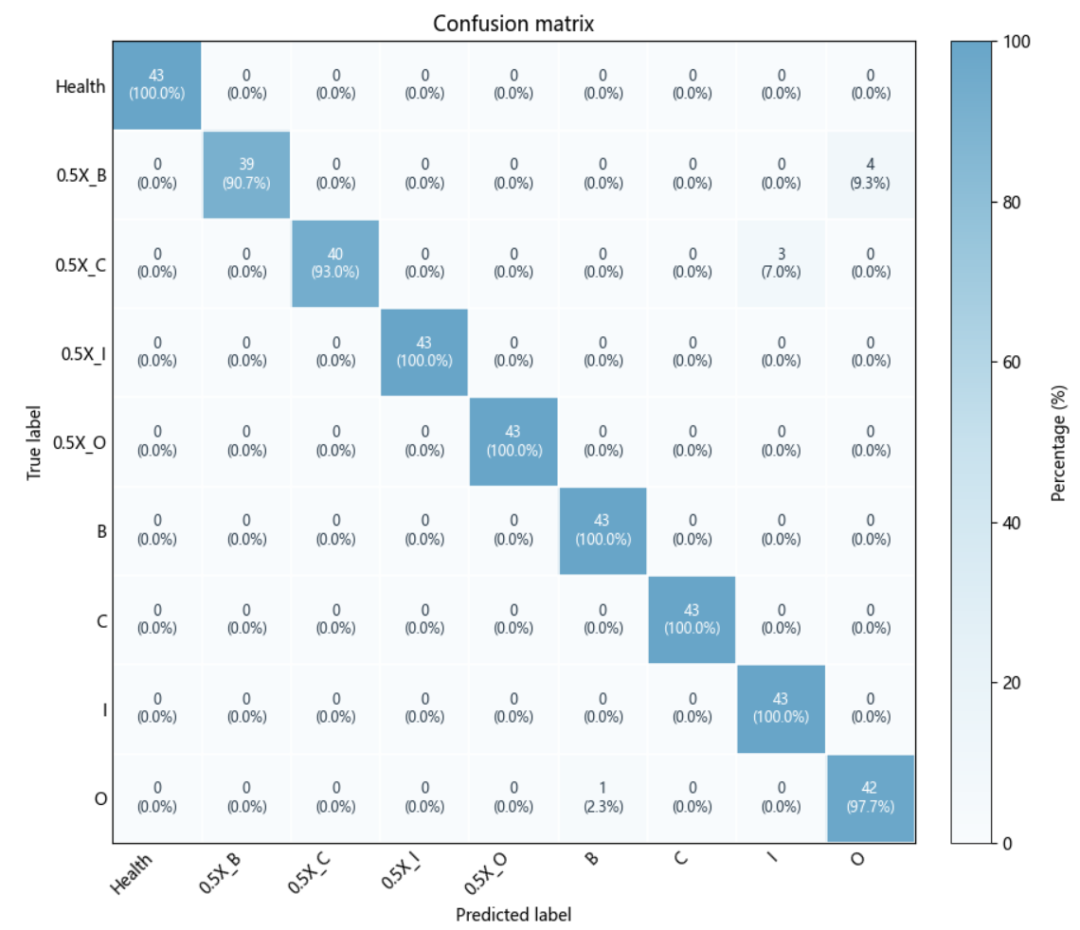
4 渥太华轴承数据集
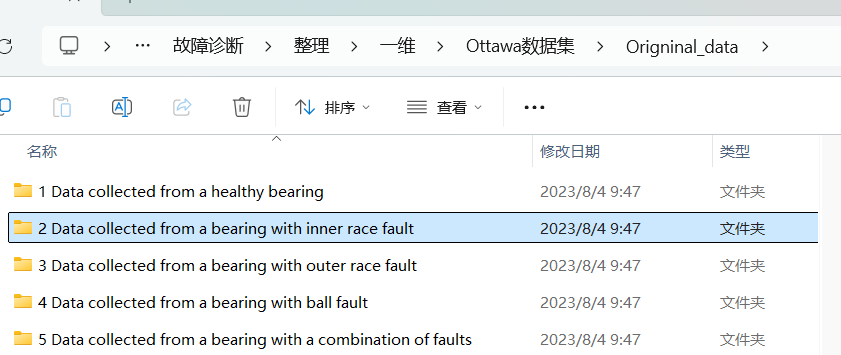
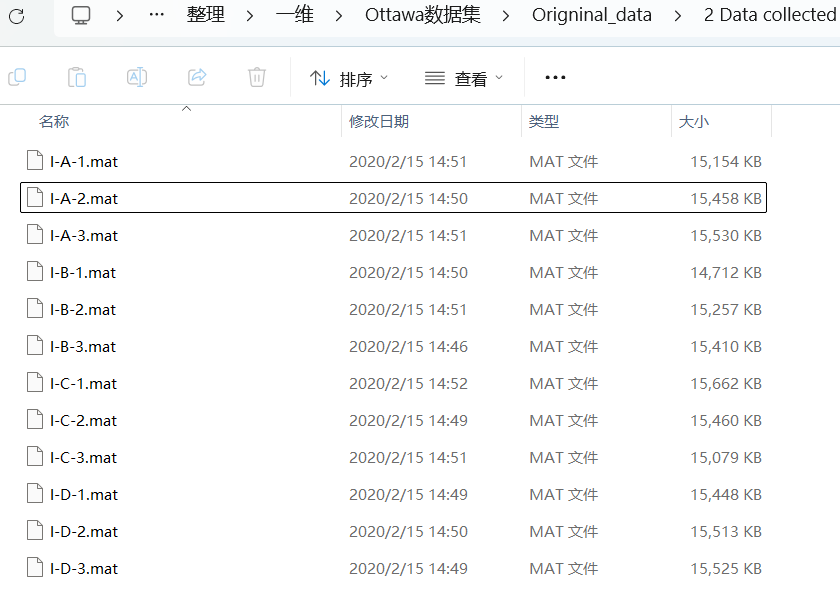
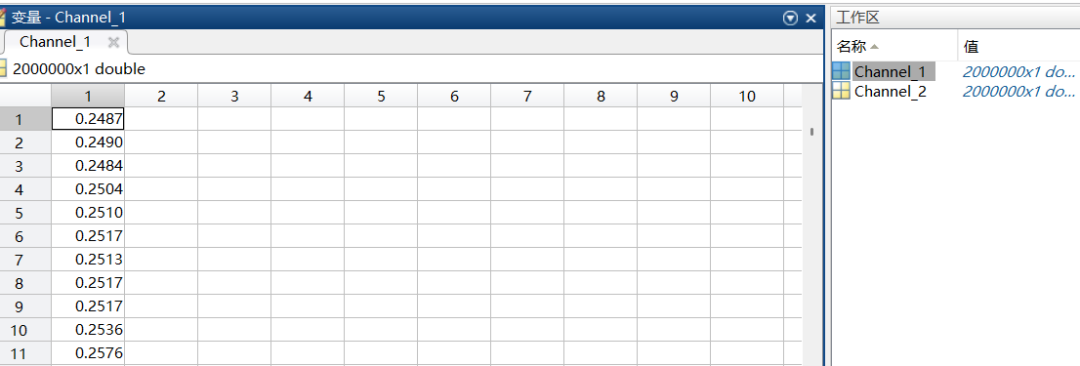
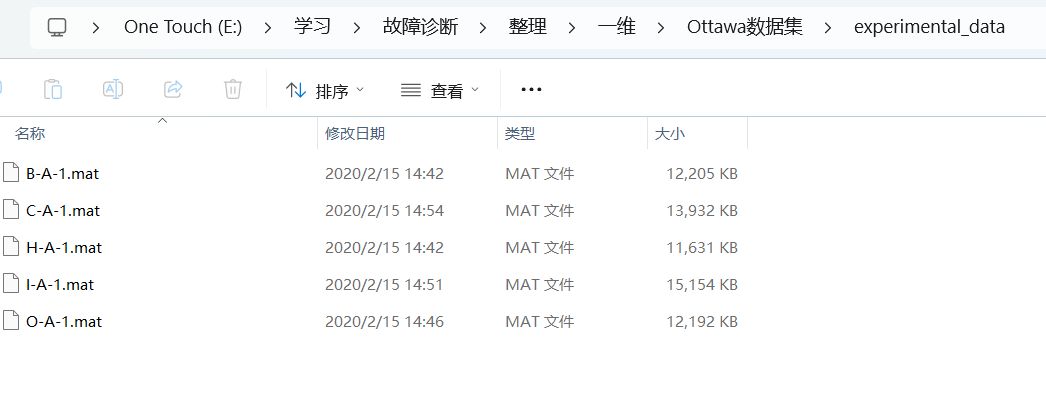
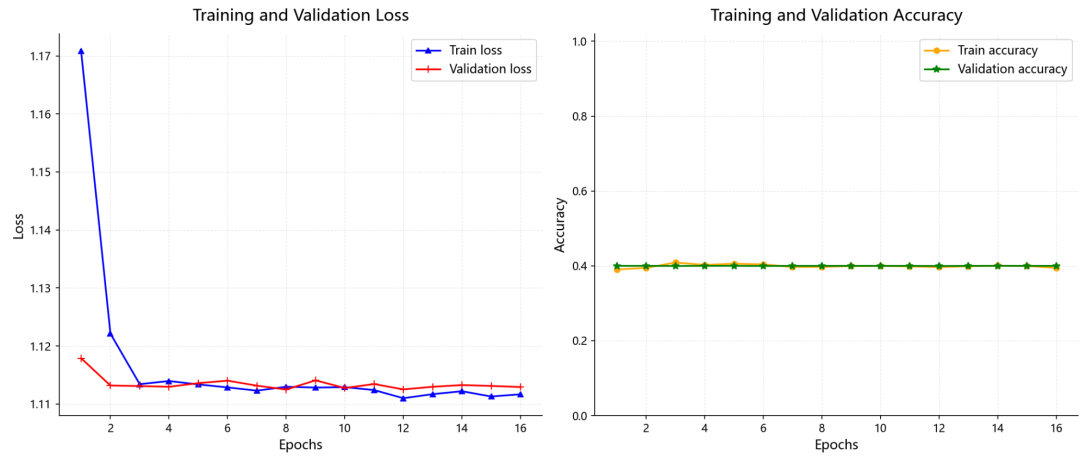
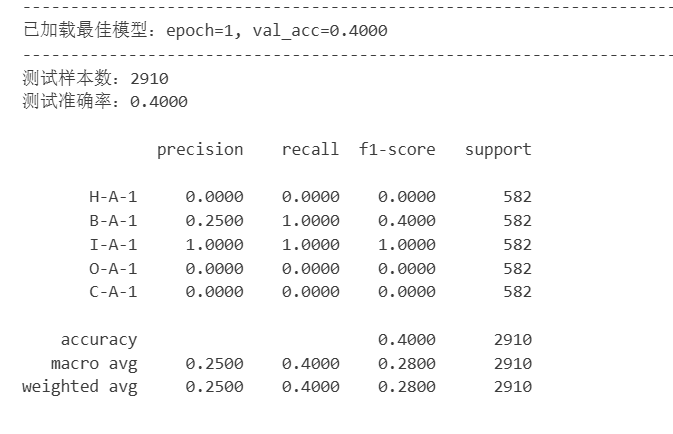
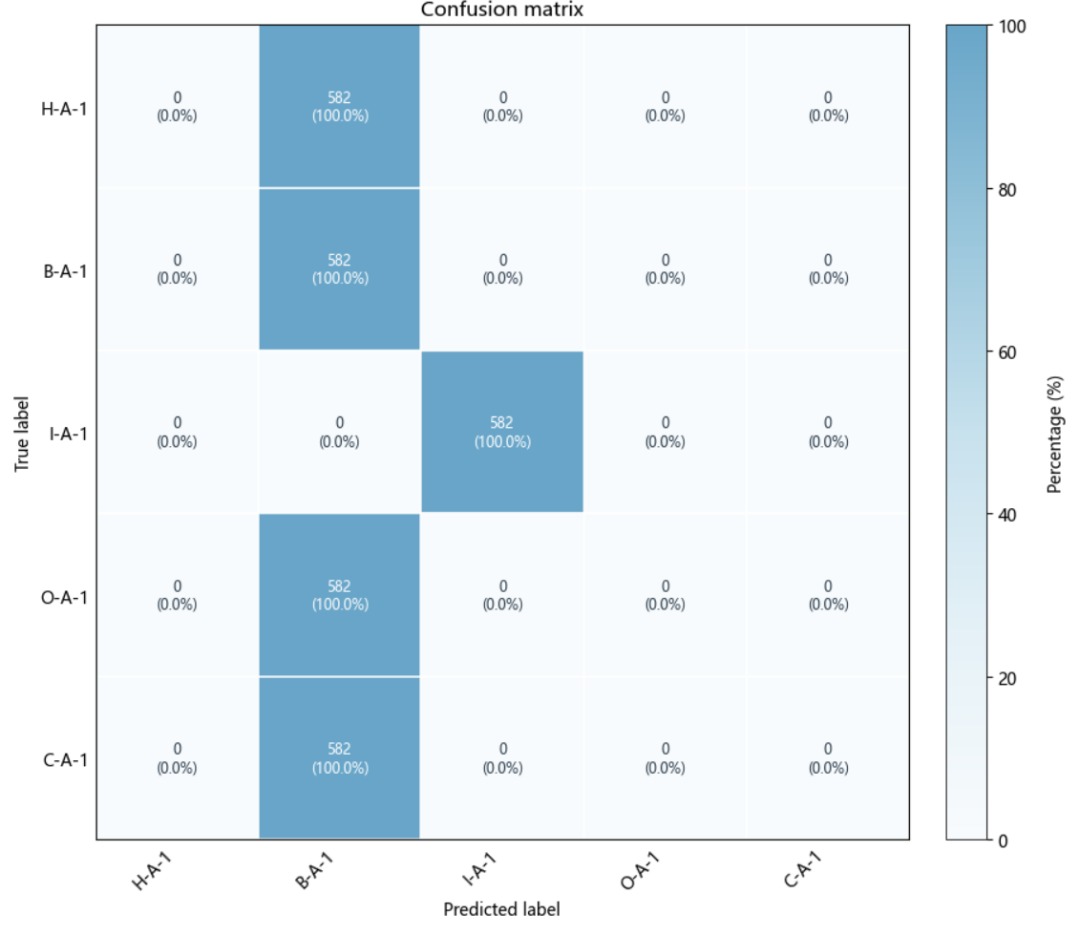
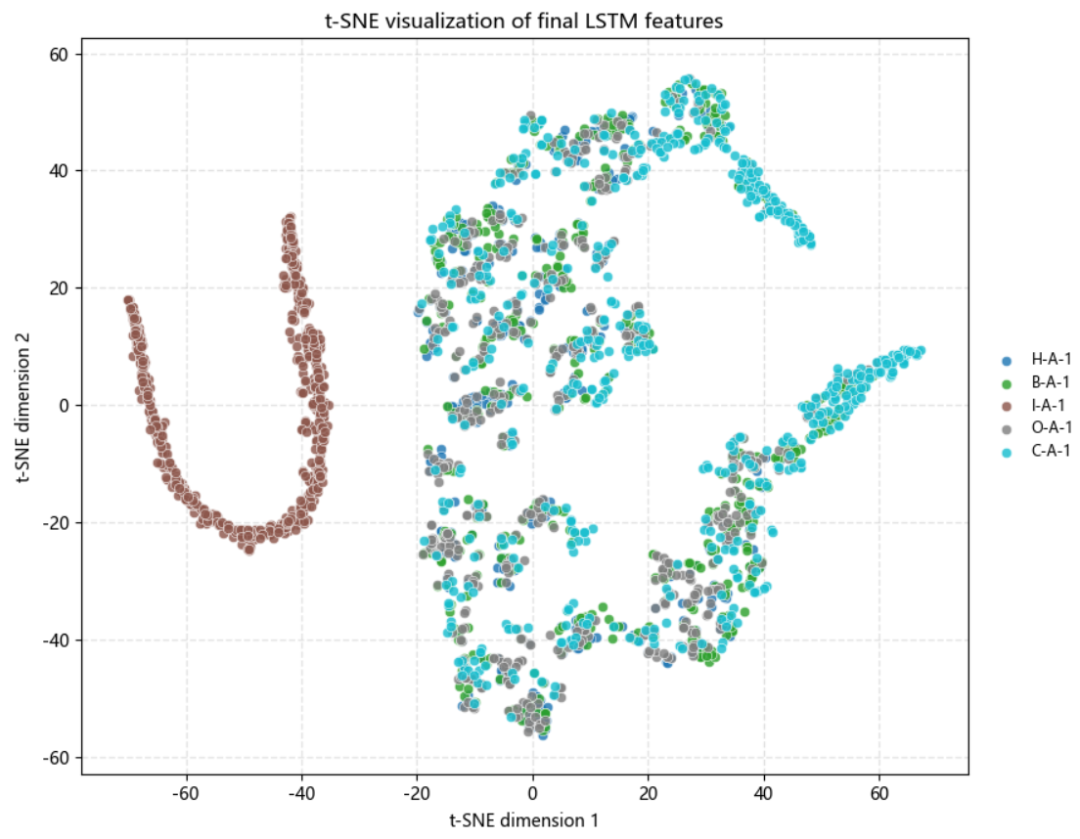
H-A-1、B-A-1、I-A-1、O-A-1、C-A-1 五个 MAT 文件中的 Channel_1 振动信号,并为每类截取前150万个连续数据点;随后先按6:2:2的比例将各类信号连续划分为训练集、验证集和测试集,并在相邻区域之间设置1024点隔离区,避免重叠样本跨集 合造成数据泄漏;之后采用长度1024、步长512的滑动窗口生成样本,仅对训练集进行随机打乱,最后将数据、标签、类别名称、样本数量及相关配置统一保存为 Ottawa_dataset.pt,并重新加载检查数据形状、类型、标签范围和异常值,形成可直接用于深度学习模型训练的标准数据集。(点击左下角阅读原文获取) 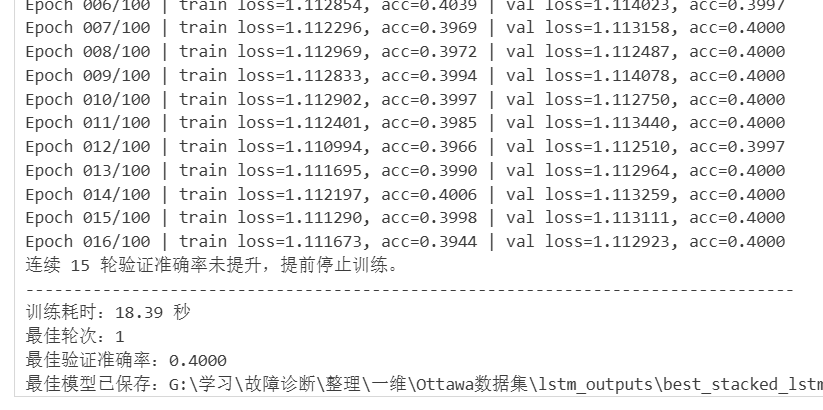
5 江南大学轴承数据集
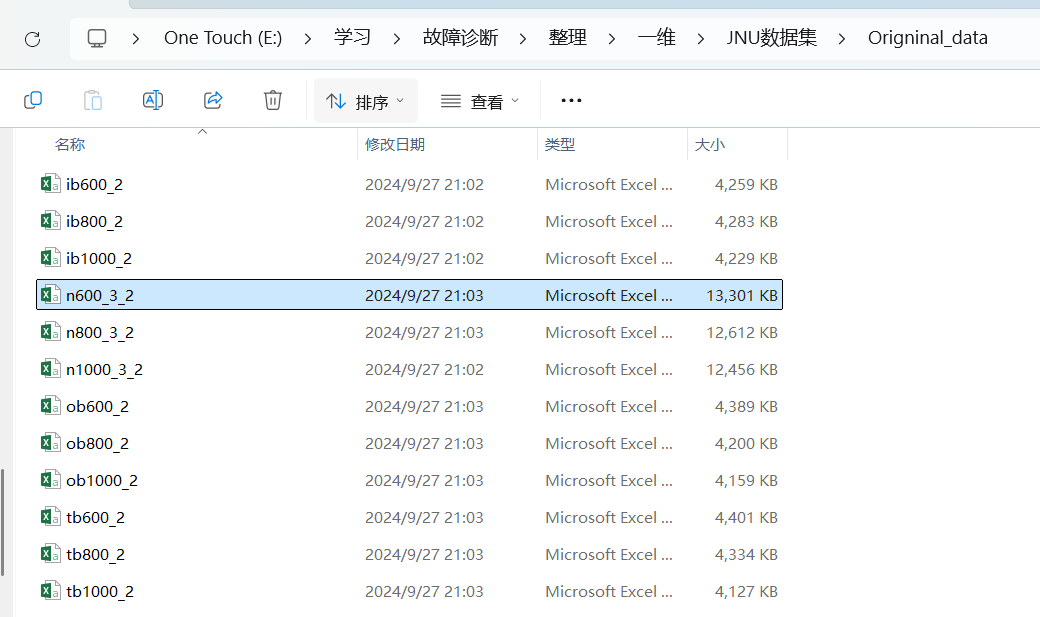
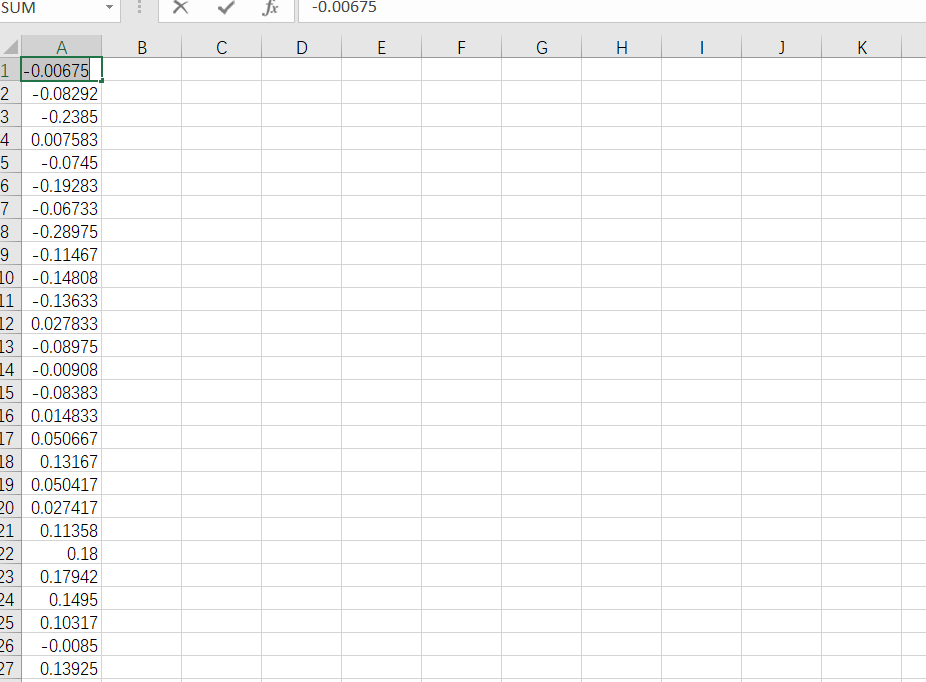
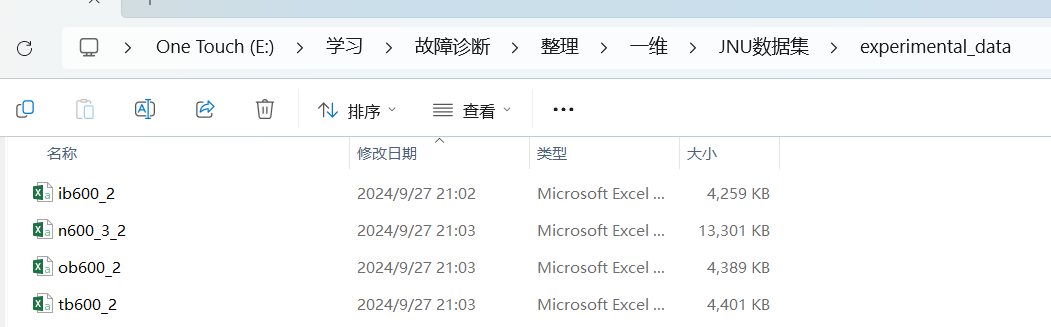
在JNU轴承故障数据集的制作过程中,首先按照类别配置读取4个 CSV 文件,将每个文件中的连续信号展开为一维数组、截取指定长度并检查异常值,同时打印原始形状和前几个数据;随后不是先滑窗再随机划分,而是先将每类连续信号按 6:2:2 划分为训练、验证和测试区域,并在相邻区域之间设置隔离段,以避免重叠窗口造成数据泄漏;之后仅使用训练区域拟合可选的归一化参数,再以长度1024、步长512分别进行滑动窗口采样,其中只随机打乱训练集;最后将训练集、验证集、测试集、类别名称、样本数量、归一化参数和数据制作配置统一保存为 JNU_dataset.pt,并重新加载检查数据形状、类型、标签范围及 NaN/Inf,从而形成完整、规范且可复现的 JNU 故障分类数据预处理流程。
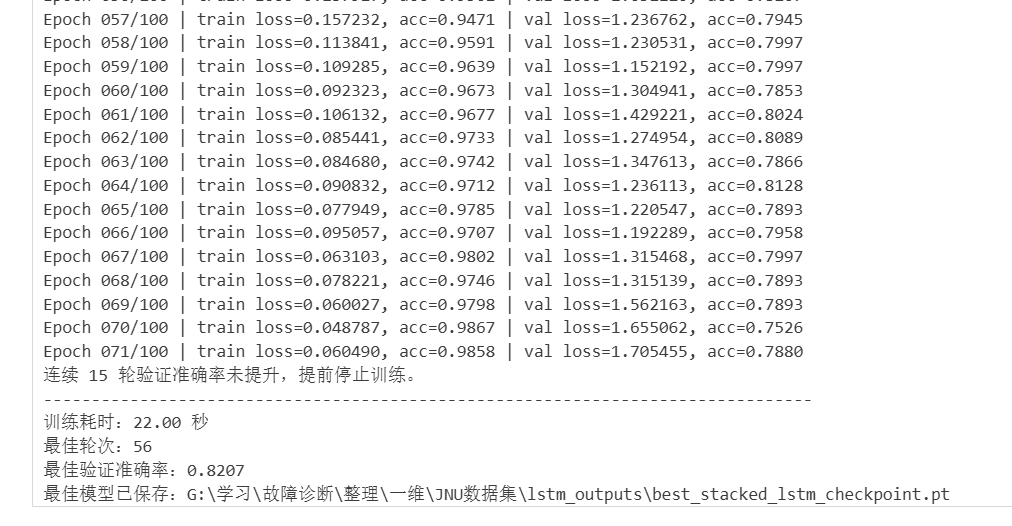
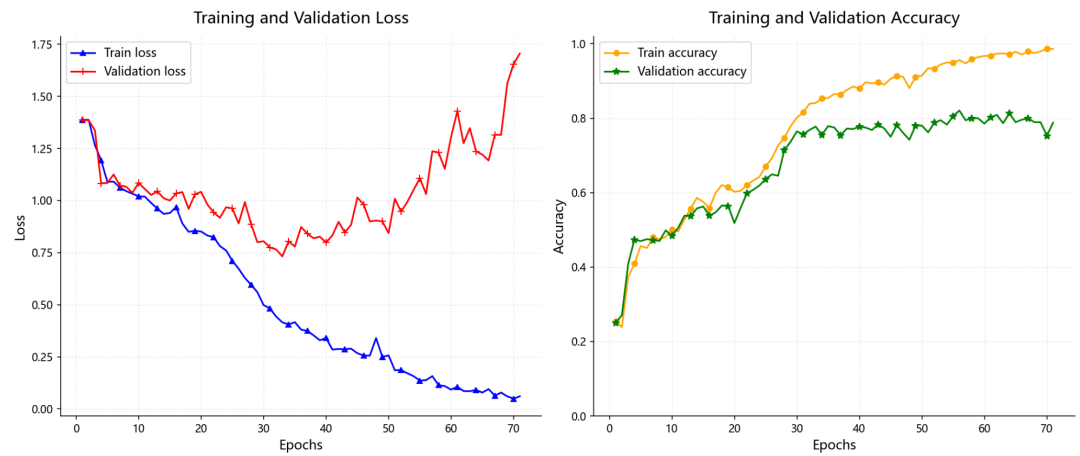
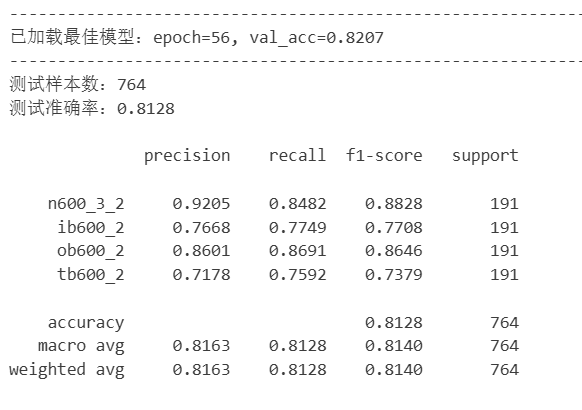
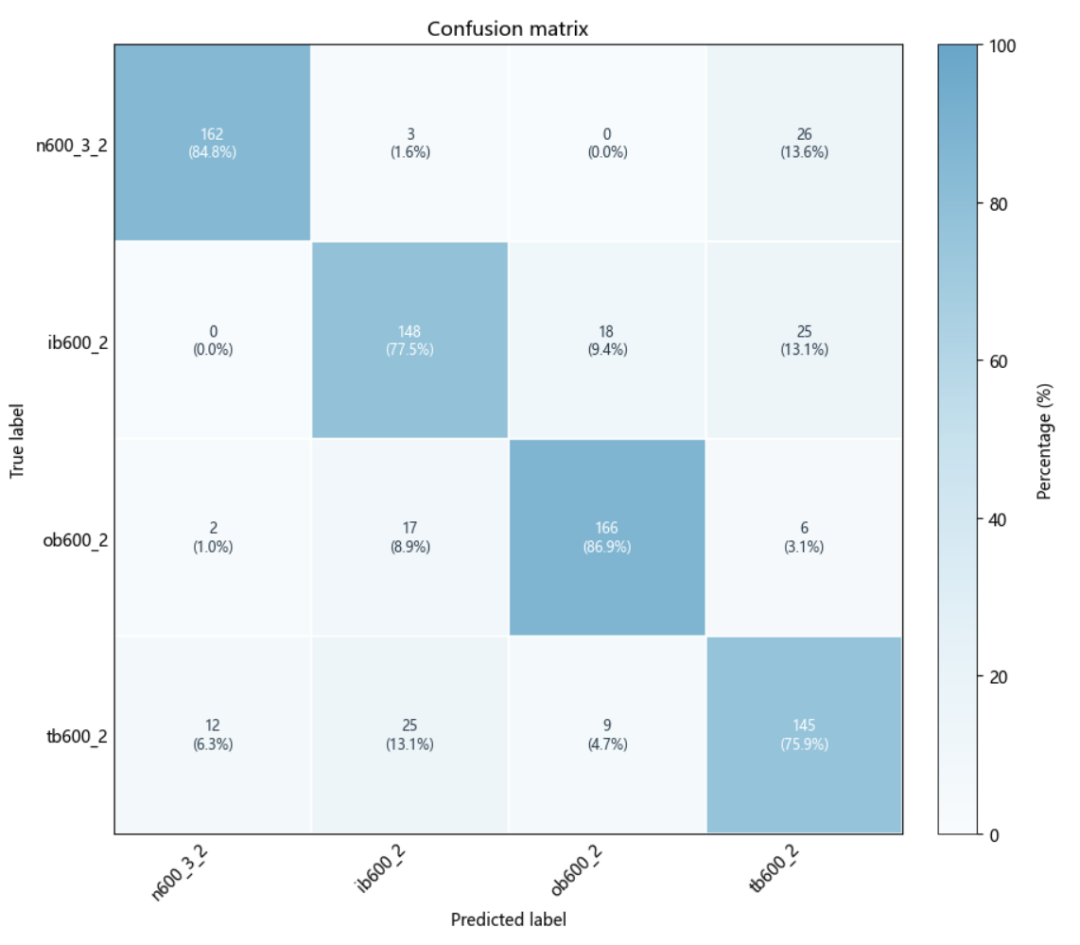
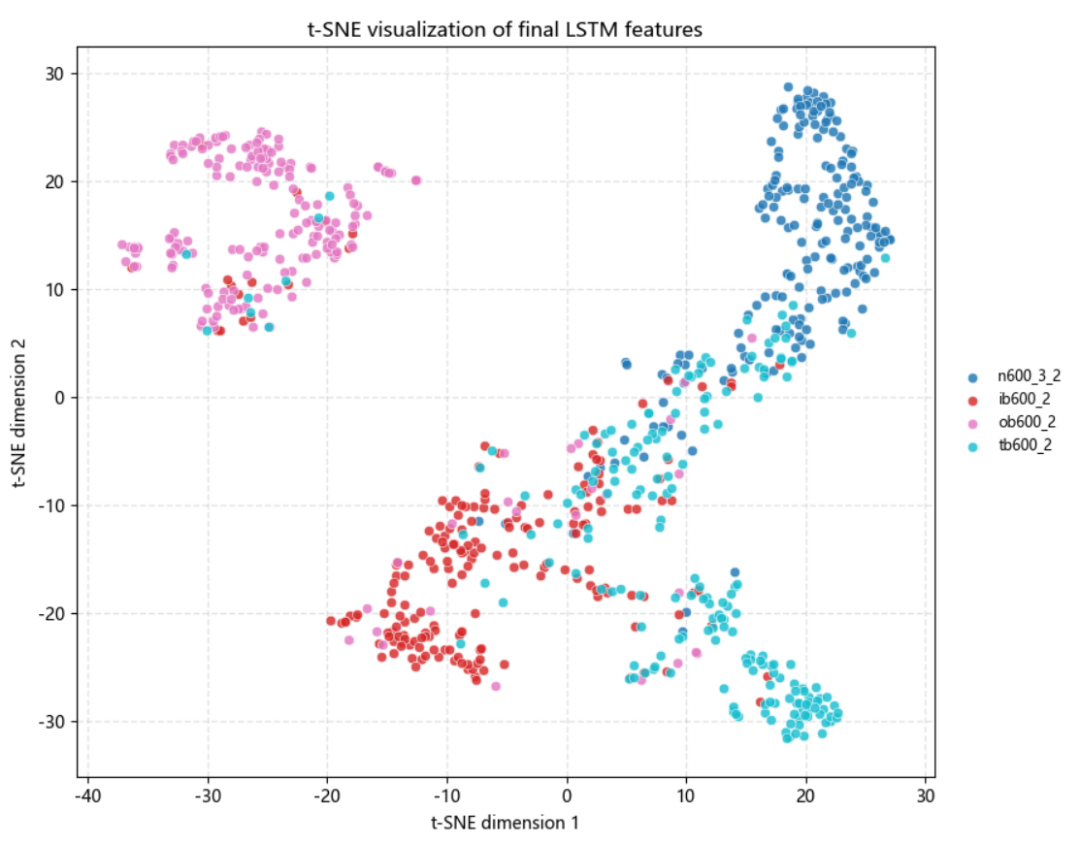 图36 江南大学测试集T-SNE图
6 WT齿轮箱数据集
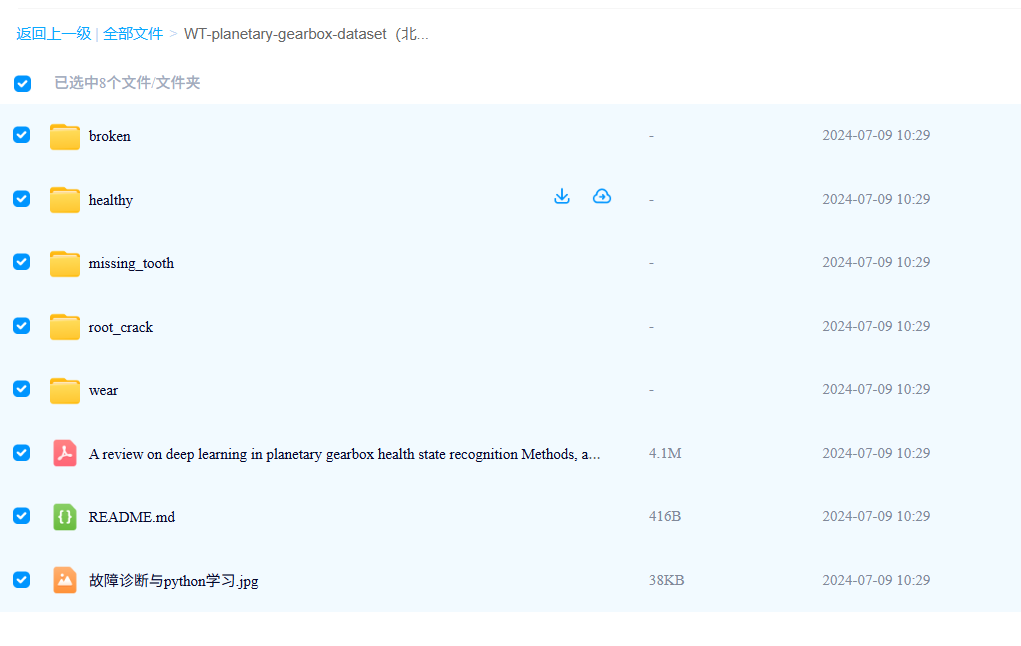
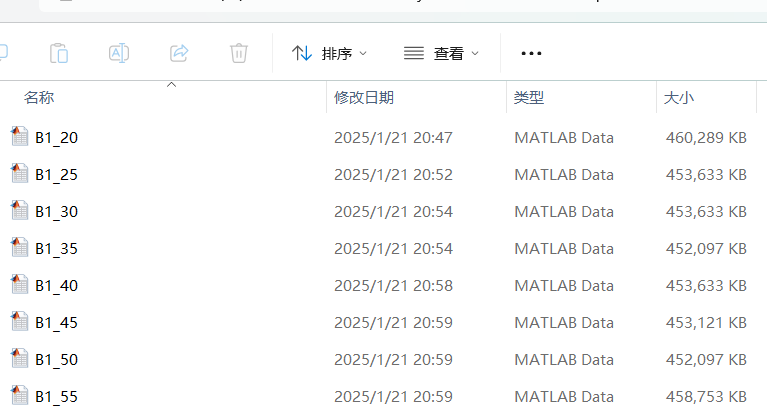
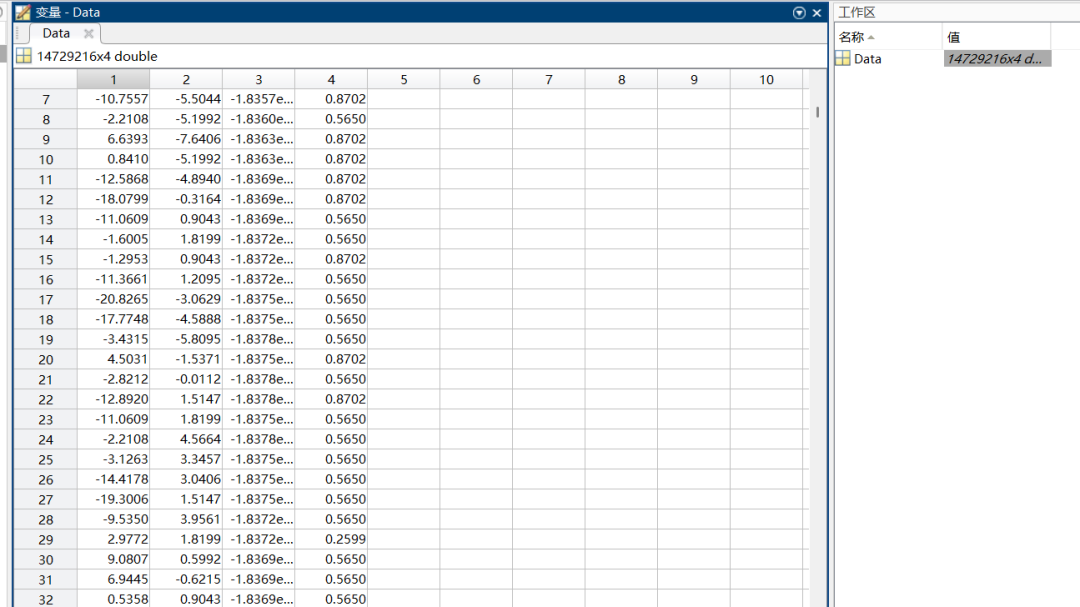
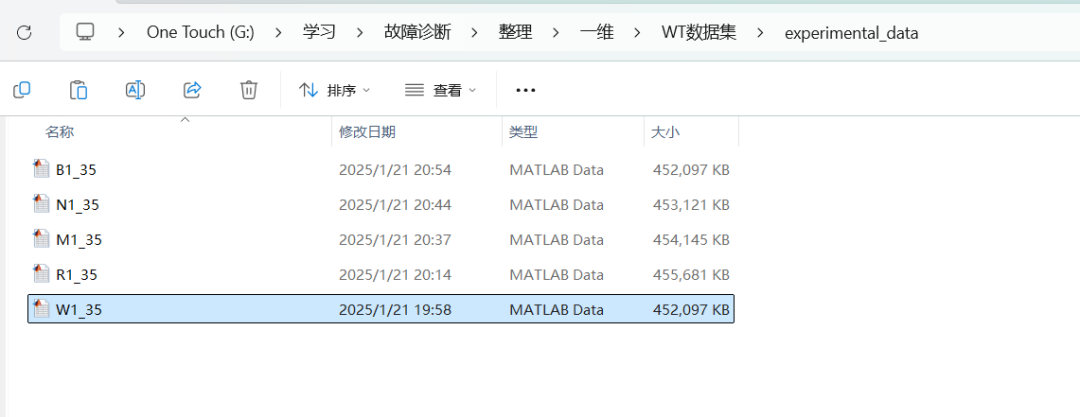
N1_35、B1_35、M1_35、R1_35、W1_35 五个文件,从变量名中包含 Data 的数据项中提取第一列振动信号,并截取每类前120000个连续数据点,同时检查信号长度、异常值并打印原始形状和前几个数据;随后对每类信号先按 6:2:2 的比例连续划分为训练、验证和测试区域,并在相邻区域之间保留隔离段,以避免重叠滑窗造成数据泄漏;之后采用长度1024、步长512分别生成样本,仅随机打乱训练集,最后将训练集、验证集、测试集、类别名称、样本数量、归一化参数和制作配置统一保存为 WT_dataset.pt,并重新加载校验数据形状、类型、标签范围及 NaN/Inf,从而形成完整、规范且可复现的 WT 故障分类数据预处理流程。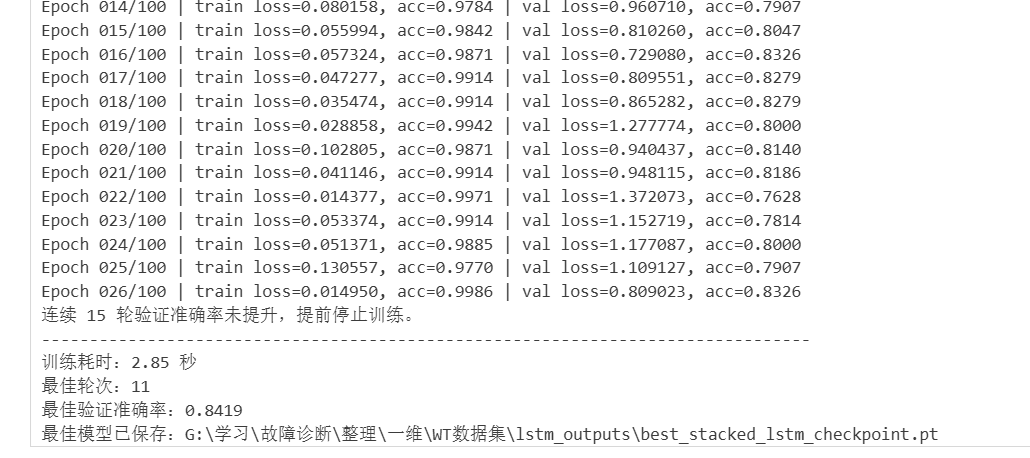
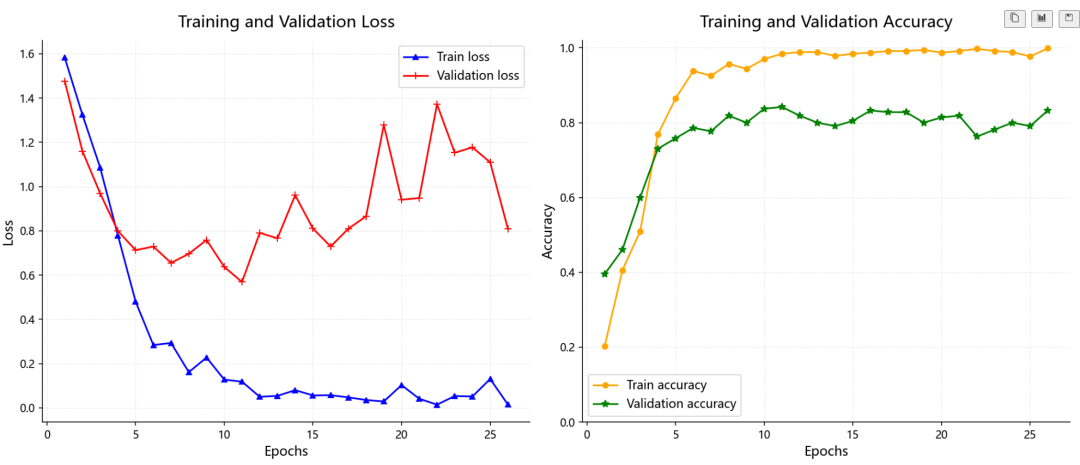
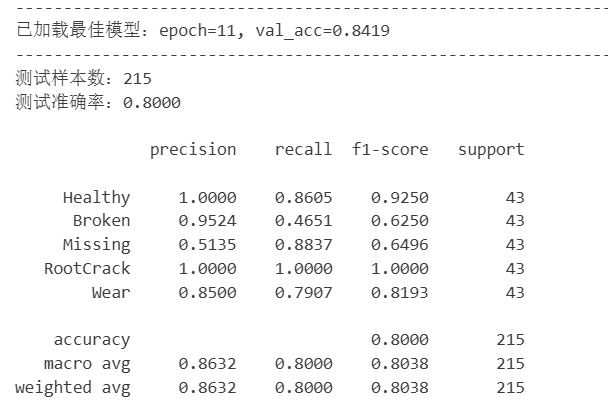
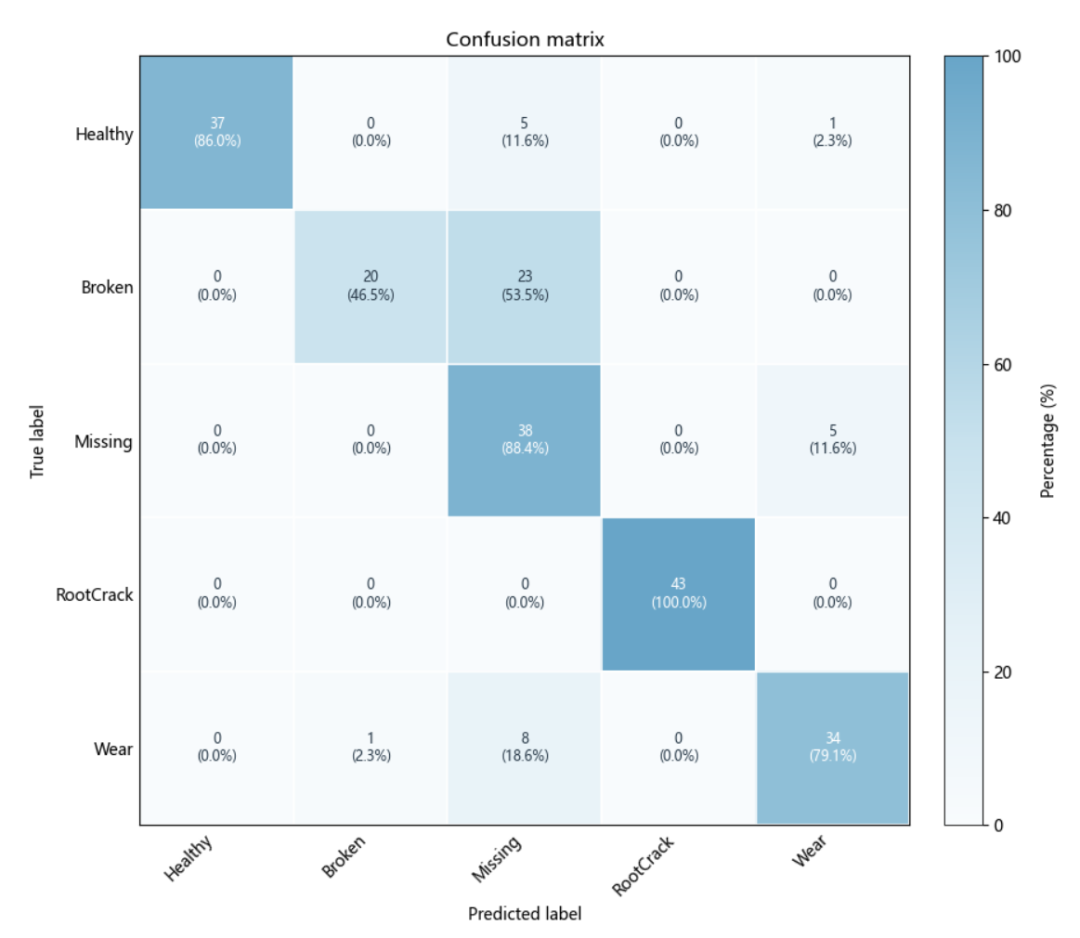
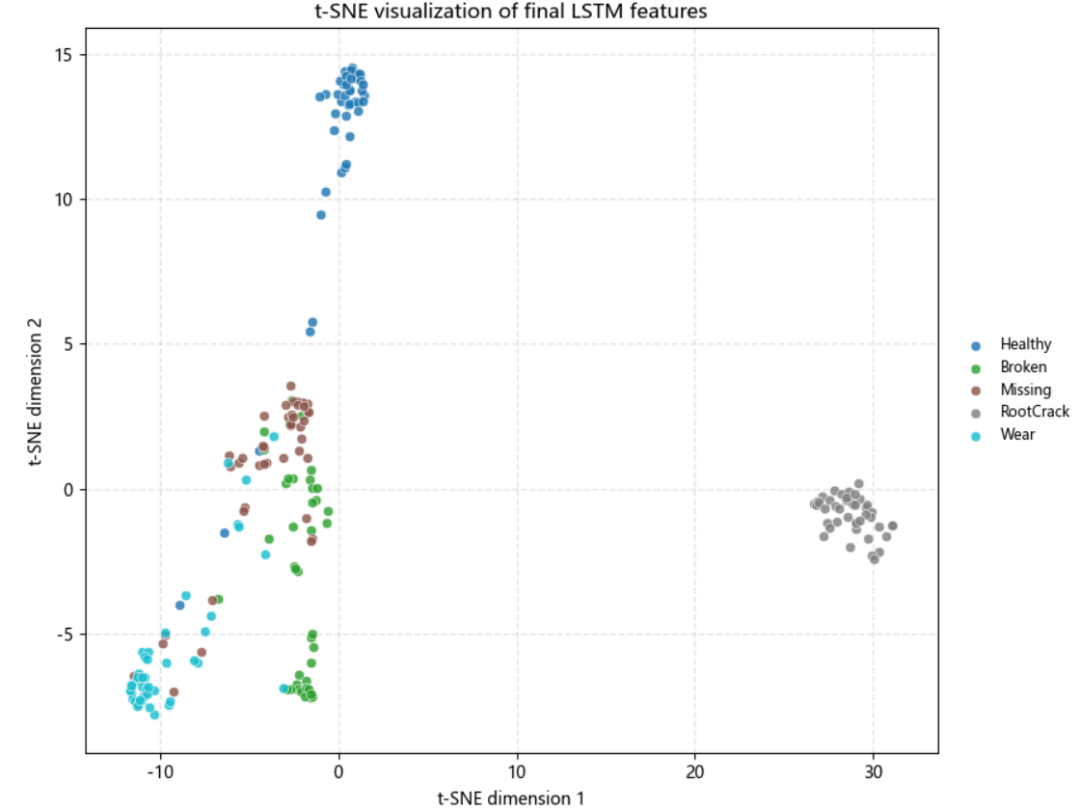 图45 WT齿轮箱测试集T-SNE图
编辑:Leo
校核:李正平、陈凯歌、曹希铭、Tina、白亮、任超、海洋、赵栓栓、Kira、陈宇航、王金、赵诚、肖鑫鑫、张优
该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除