
2-31 Gabor + PCA + ELM / 模板匹配人脸表情识别
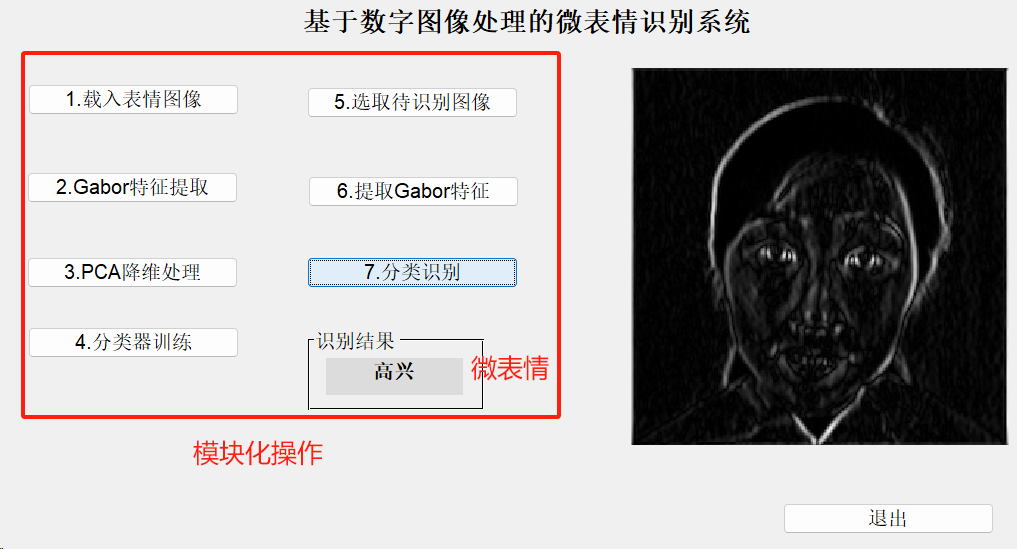
一句话介绍: 这套程序建立了一个 7 类静态人脸表情识别系统:先整理 213 张表情图像,提取 Gabor 纹理响应,再用 PCA 把高维图像压缩到 213 维,并训练 200 隐藏节点的 ELM 分类器;GUI 可以载入一张待识别人脸并输出中性、高兴、悲伤、惊讶、愤怒、厌恶或恐惧中的一种结果。
先看它真正解决什么问题
一张人脸照片里,眼睛、眉毛、嘴角和面部纹理会随着表情发生变化。
程序希望完成:
输入一张人脸图像 → 提取局部纹理 → 压缩高维信息 → 表情分类 → 输出 7 类表情名称
当前工程包含的 7 类为:
中性 NE、高兴 HA、悲伤 SA、惊讶 SU、愤怒 AN、厌恶 DI、恐惧 FE
1. 当前数据库有多大?
Database 中共有:213 张 256×256 人脸图像
来自:10 个对象
文件名已经包含表情类别,例如:对象编号.表情代码.图像编号.tiff
整个数据库的类别数量为:NE 30、HA 31、SA 31、SU 30、AN 30、DI 29、FE 32
GetDatabase.m 会读取 Database/list.txt,把图片名称整理到 S.mat,同时按照人物建立 T.mat。
所以程序训练数据的基本结构可以概括成:213 张人脸 → 7 类表情标签 → 后续特征提取与分类
2. 整个程序是怎样工作的?
GUI 主程序为:MainForm.m
完整准备与识别流程为:
载入数据库 → Gabor 特征提取 → PCA 特征压缩 → 构造 7 类训练数据 → ELM 训练 → 载入测试图像 → 提取 Gabor 特征 → PCA 投影 → 分类识别 → 显示表情名称
其中主要文件作用如下:
文件 | 作用 |
|---|---|
| GUI 与整个识别流程 |
| Gabor 纹理特征提取 |
| PCA 特征空间构建与投影 |
| 根据文件名生成 1~7 类标签 |
| ELM 训练 |
| 测试与最终类别输出 |
工程还已经提供 model.mat 和 elm_model.mat,分别保存 PCA 模型与 ELM 模型。
3. 为什么先用 Gabor 提取人脸纹理?
表情变化通常会影响:
眉毛方向;眼周纹理;鼻翼和面颊变化;嘴角和唇部边缘。
这些信息很多都表现为局部方向纹理和灰度变化。
程序使用一个 Gabor 型滤波器:
G(x,y) = exp{-0.5[(x'/Sx)² + (y'/Sy)²]} · sin(2πfx')
其中旋转坐标为:
x' = x cosθ - y sinθ
y' = y cosθ + x sinθ
当前调用参数为:
Sx=2,Sy=4,f=16,θ=π/3
可以简单理解为:
用一个具有特定方向和尺度的局部波形去扫描人脸,把与该方向纹理相匹配的区域增强出来。
这样眼睛、眉毛、嘴角等局部结构的变化会转化成新的纹理响应图。
4. 当前 Gabor 不是一个大滤波器组
很多 Gabor 人脸识别方法 会同时使用:
多个尺度;多个方向;形成几十个滤波响应。
当前 gaborfilter.m 实际只按:
Sx=2、Sy=4、f=16、θ=π/3
生成一组固定参数的滤波结果。
因此当前工程中的“Gabor 特征”更准确地说是:
一个固定方向 / 参数下的 Gabor 型纹理响应。
它的作用是把原始灰度人脸转换成更强调局部纹理变化的图像,再送入后续 PCA。
5. 为什么还要使用 PCA?
一张 128×128 图像包含:128 × 128 = 16384 个像素变量
如果直接把 16384 个值全部送给分类器,输入维数很高。
PcaDataBase.m 使用 PCA 建立低维坐标系。
设中心化后的训练矩阵为 X,程序先构造:Σ = X·Xᵀ
再求特征值和特征向量,并生成 PCA 基矩阵 base。
对于一幅待处理图像向量 b,它的低维坐标为:c = bᵀ · base
当前数据库有 213 张训练图,所以:16384 维图像 → 213 维 PCA 坐标
也就是把高维像素描述压缩成一个更短的特征向量。
6. 当前 PCA 与 Gabor 在源码中怎样衔接?
这里值得按源码本身理解。
PcaDataBase.m 建立 PCA 基底时读取的是:
原始 Database 人脸图像
并统一缩放到:128×128
得到 model.mat 中:base:16384×213
随后程序再读取已经生成的 Gabor 特征图,把 Gabor 图同样缩放为 128×128,并投影到这个 PCA 基底中。
因此当前实际链路是:原始人脸建立 PCA 基底 → Gabor 响应图投影到该基底 → 得到 213 维特征
每张训练图最终在 S(i).G 中保存一个:213 维向量作为后续分类输入。
7. 7 类标签是怎样自动生成的?
GetTrainData.m 不需要单独的标签表。
它直接读取文件名中的表达代码:
NE → 1 → 中性
HA → 2 → 高兴
SA → 3 → 悲伤
SU → 4 → 惊讶
AN → 5 → 愤怒
DI → 6 → 厌恶
FE → 7 → 恐惧
然后把一条训练样本组织成:[类别编号, 213 维 PCA 特征]
所以 ELM 的训练数据维数为:213 个输入特征 + 1 个类别标签
8. ELM 在程序中怎样训练?
GUI 的训练按钮设置:
分类模式 Elm_Type = 1
隐藏神经元 = 200
激活函数 = sin
ELM,也就是 Extreme Learning Machine,可以理解为一种单隐层前馈神经网络。
它的隐藏层可写成:
H = sin(WX + b)
其中:
X:213 维输入特征;
W:随机生成的输入权重;
b:随机隐藏层偏置;
H:隐藏层输出。
与传统 BP 反复迭代全部网络权重不同,ELM 随机确定隐藏层参数,然后直接求输出权重:β = pinv(Hᵀ) · Tᵀ
最终分类输出为:Y = Hᵀβ
当前保存的 elm_model.mat 实际结构为:213 输入 → 200 隐藏节点 → 7 类输出隐藏层激活函数为正弦函数。
9. 为什么 ELM 训练速度通常比较快?
普通 BP 网络需要:前向传播 → 计算误差 → 反向传播 → 更新参数 → 多轮迭代
ELM 的核心思路是:
隐藏层权重和偏置随机生成,不再用梯度下降反复训练;输出层通过广义逆一次求解。
因此在这种规模不大的静态图像分类实验中,训练过程比较直接。
按照工程中保存的 elm_model.mat 对 213 个训练样本重新计算,训练集分类结果为:213 / 213 正确
也就是:训练集准确率 100%
这个数值说明保存模型能够完全拟合当前训练库,但不能单独代表对全新独立人脸的泛化准确率。
10. 待识别图片怎样进入分类器?
GUI 中用户先载入一张图像。
随后执行 Gabor 特征提取,并把结果缩放成:128×128
展开后得到:16384 维像素向量
再使用 model.mat 中的 PCA 基:c = bᵀ · base
转换成:213 维特征
理论上的 ELM 测试流程就是:测试人脸 → Gabor → PCA 213 维 → ELM → 7 类输出
11. 当前 GUI 最终显示的类别实际上由什么决定?
这是当前源码最关键的实现细节。
elm_predict.m 的前半部分确实会:载入 elm_model.mat
计算隐藏层输出
得到 7 类 ELM 预测结果
但在函数最后,它又重新读取全部 213 张原始数据库图像,并计算测试图像和每张训练图之间的欧氏距离:dᵢ = ||I_test - Iᵢ||₂
然后寻找:i = arg min dᵢ*
再根据距离最近那张数据库图片的文件名重新确定表情类别。
这个结果会覆盖前面已经算出的 ELM output。
因此按照当前实际代码:
GUI 最终显示的“中性 / 高兴 / 悲伤……”并不是 ELM 的最终预测,而是原始像素最近模板匹配的结果。
所以整个工程更准确地分成两部分:Gabor + PCA + ELM:完成了完整训练与预测计算
但最终 GUI 类别:由最近原始人脸模板决定
12. 最近模板匹配为什么能够识别当前测试图?
模板匹配的思想非常简单。
把测试图片和数据库图片都展开成像素向量,然后计算:
dᵢ = √Σₖ(I_test(k) - Iᵢ(k))²
距离越小,说明两幅图在像素层面越相似。
程序找到最小距离模板后,直接继承它的表情标签。
这种方法不需要额外训练,但对:
尺寸;人脸位置;灰度;姿态;一致性比较敏感。
当前数据库和测试图全部是统一的:256×256人脸图,因此可以直接逐像素计算距离。
13. 工程自带测试集的实际情况
Test 文件夹中共有:23 张 TIFF 测试图
对这些图片与 Database 做逐像素核对,可以发现:
23 张测试图片都能在训练数据库中找到一张完全相同的图像。
也就是说,当前自带 Test 更接近:数据库样本的测试入口 / 演示样本
而不是与训练集完全独立的新测试集。由于最终识别又采用最近原始像素模板,因此这些示例都能找到距离为:0的数据库模板。
所以工程适合展示完整识别流程,但不能根据这些重复样本直接推断模型面对陌生人物和新图像时也具有同样准确率。
14. 为什么不直接用原始像素做所有分类?
事实上,当前最终 GUI 输出确实回到了原始像素最近距离。
但工程前面设计 Gabor、PCA 和 ELM 的理论目的更加完整:Gabor
增强局部纹理、方向边缘和表情相关结构。PCA把 16384 维高维图像压缩为 213 维特征。
ELM学习 7 类表情在低维特征空间中的分类关系。
相比直接逐像素比较,这条特征分类路线更适合继续扩展到:
同一表情但像素并不完全一致的新图片。
如果希望最终输出真正由 ELM 决定,只需要让 elm_predict.m 保留前半部分得到的 ELM output,不要再被后面的最近模板结果覆盖。
15. 这套程序适合用在哪里?
静态人脸表情识别教学
可以完整观察:图像 → Gabor → PCA → ELM → 类别
这一经典人工特征 + 机器学习流程。
Gabor 与 PCA 特征实验
可以研究局部纹理提取和高维图像压缩怎样配合使用。
ELM 多分类学习
当前已经包含 7 类标签和 200 隐藏神经元的完整 ELM 训练实现,适合学习 ELM 的随机隐藏层和广义逆输出权重。
GUI 图像识别演示
MainForm 提供了数据库加载、特征处理、训练、待测图载入和识别结果显示,可以作为 MATLAB GUIDE 图像分类项目的完整示例。
16. 怎么运行?
GUI 入口是:MainForm.m
完整重建模型时,按下面顺序执行 GUI 功能:
载入表情图像 → Gabor 特征提取 → PCA 降维 → ELM 训练
之后:载入待识别图像 → Gabor 特征提取 → 分类识别
工程已经附带 S.mat、T.mat、model.mat 和 elm_model.mat,也保存了预计算模型。
为了与当前数据库直接匹配,测试图片最好保持与工程样本一致的灰度人脸形式。当前 RGB 转灰度分支中使用了尚未赋值的变量 I,因此直接输入彩色 RGB 图片时需要先把 rgb2gray(I) 改为对实际读入图像 Img 进行转换。
17. 一句话看懂这个项目
这是一个7 类静态人脸表情识别工程:数据库包含 10 个对象的 213 张 256×256 人脸,类别为中性、高兴、悲伤、惊讶、愤怒、厌恶和恐惧;程序使用固定参数 Gabor 滤波提取纹理,把 128×128 图像投影为 213 维 PCA 特征,再训练 213→200→7 的正弦激活 ELM 分类器。需要特别注意,当前 elm_predict.m 在算完 ELM 后又使用原始像素欧氏距离寻找最近数据库模板,并用该模板类别覆盖 ELM 输出,因此 GUI 最终显示实际上由最近模板匹配决定;同时自带 23 张 Test 图都与数据库中的图片完全重复,所以该测试更适合流程演示,而不是独立泛化性能评价。


