做科学数据,是生化环材研究生进入 AI 领域的一把钥匙
(全文没有使用任何 AI,纯手搓,希望我们的洞见可以为你提供帮助。)
前言:
生化环材这年年常被叫作「天坑」专业,可在大模型行业,他们正变得炙手可热。
AI 的浪潮前所未有地席卷而来。很多非 AI 领域的研究生,会动过这样的想法:AI 这么热,我能不能也去做点相关的事?念头之后往往是泄气:我没训练过模型,代码只写过处理数据的脚本,人家凭什么要我。
2026 年中开始,AI 领域中,涌现了一项生化环材专业比计算机专业更适合的工作,那就是做科学数据。它指的是把你真实做过的科研工作,改写成大模型能够练习、也能够被打分的 「任务」 (行内话也叫做给模型出题)。这件事最稀缺的知识就在你手里:你知道一个真实的科研问题长什么样,知道什么答案算对,知道哪里容易出错。AI 工程师不知道这些。
(我们习惯称呼任务是用于评测大模型的,但是实际上评测的是 大模型+智能体框架,比如 Claude Opus5 + Claude Code。单独一个只会文字接龙的大模型是无法完成如此复杂的任务的。)
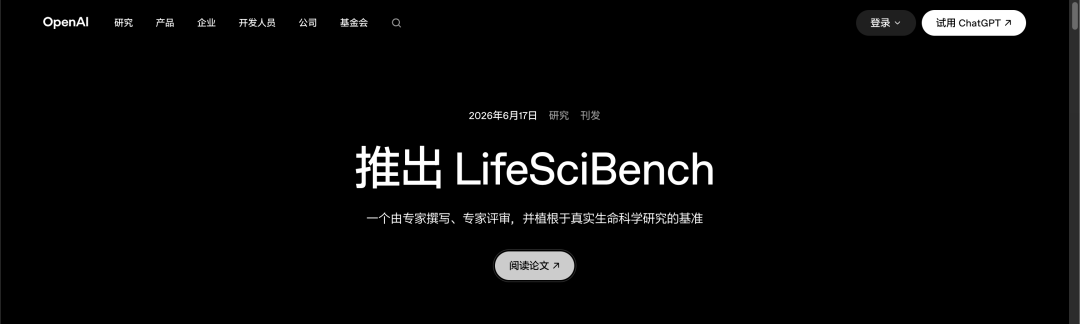
(OpenAI 招募众多生物科学家联合发布生命科学领域数据集 LifeSciBench)
(Anthropic 招募生命科学、化学家加入研究)
数据对于提升 AI 大模型能力而言非常本质
大模型的训练大致分两段。第一段叫预训练,把互联网上能找到的文本几乎全读一遍,学会语言和常识。继续精进预训练给模型带来的提升变得越来越少。第二段叫后训练,目的是让模型真正会做事:写代码、遵循意图、调用工具等。后训练需要大量的高水平数据。 现在模型的提升已经呈现这样的趋势:由数据驱动的部分远远大于由模型架构演化驱动的部分。也就是说,如果你能找到一份更好的预训练数据或后训练数据,它可能带来非常大的模型上限的提升。
后训练现在最有效的做法,是让模型自己动手做一道题,再由一个判分程序告诉它对了还是错了,对了就强化这种做法,错了就削弱。这套方法叫 「可验证奖励的强化学习」 。它成立的前提是:题目要真实、要难,判分要靠得住。
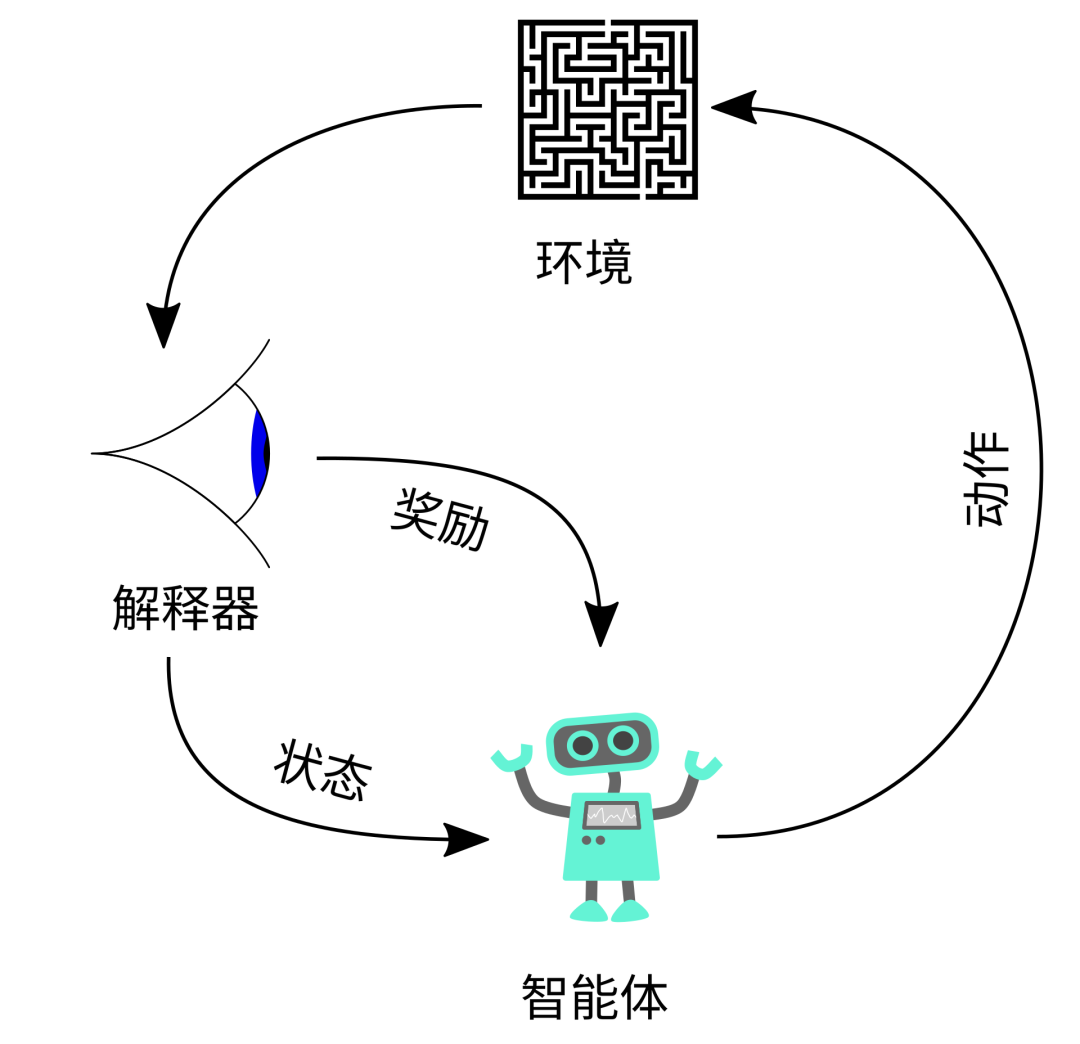
(强化学习是当前利用数据提升模型能力的最核心方法)
后训练的主战场已经转到 “教模型做可验证的长链推理和真实任务” ,科学是数学、代码之后同时满足高价值、可验证、数据还没被吃透这三个条件的领域。这些科学数据题 AI 公司自己出不了,出题的人必须有真正的科研经历。
这些科学数据如何被大模型所用
一条科学数据最核心的包括三个部分:任务定义、环境、Rubrics(评分细则)。
「任务定义」 需要定义大模型可以用到什么工具,需要做什么,以及需要提交什么等。
「环境」 是大模型完成这个任务所需要用到的背景资料、工具等
「Rubrics」 是用于判断大模型做题结果对错的程序或评分细则。有些科学数据还要一份参考解。
一条科学数据有三种用法。
1、当考题:很多条数据在一起,就可以构成一套 Benchmark(评测基准),用来评测大模型能力。现在的模型能力排行都是通过各种 Benchmark 测出来的。
2、当强化学习训练信号:让模型反复尝试这道题,用验证器的结果来奖励或惩罚。
3、当示范:参考解和解题记录直接作为模仿样本,用于 SFT (后训练的一种,用来提升模型能力)。
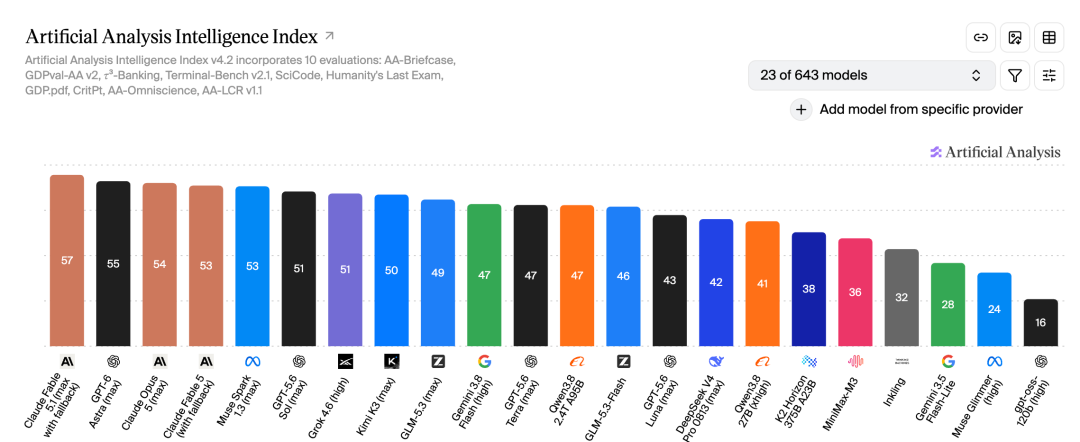
(这样的大模型能力排行都是通过各种 Benchmark 测出来的)
如何构造科学数据
最好的题目来源就是你的科研或项目经历:对论文的某张图的结果进行仿真复现,写算法处理实验数据,把模拟参数调到与实验吻合,从一堆结构里筛候选。每一项都能改成一道科学数据。
纯手搓构造当前高难度的科学数据已经是一件不太可能的事情。Claude Code、Codex 这类智能体,可以在构造科学数据的时候提供非常多的帮助,请多多尝试使用他们。有什么问题也可以尽管问他们,他们懂的很多。在「任务定义」和「Rubrics」上需要投入一定的人类科研经验,而其他的内容都可以由智能体辅助构造。
如何应聘相关岗位
GitHub 上有不少开源项目,公开征集大家的科学任务去构建 Benchmark(文末附上)。它们提供任务构造指南、详细的评审反馈和答疑,既是最好的练手场,也是证明能力的试金石。为这些项目贡献科学数据,还可以进入其所发表论文的作者名单。
有了这些成果,再去应聘数据公司或大模型公司的科学数据岗位,会有很大的优势。现在几乎所有的大模型公司,以及如春笋般涌现或者转型而来的数据公司,都非常渴望这样的科学数据人才。
即便你还没来得及做出贡献,只要科研经历扎实,又能熟练使用 Claude Code 这类智能体工具,直接去投也有很大机会。
一些感慨:
曾经我也不喜欢蹭热点、赶潮流,觉得在哪个领域踏踏实实做研究,最后都能做出成绩。现在我的想法变了:努力当然是成功的前提,但环境和机遇有时候也不可或缺,它能塑造一个人,也能改变一个人。AI 时代的到来,就是这样一次机遇。
希望每个人都能看清楚,自己手中的钥匙,可以去打开哪扇门。
最后附上一些公开征集科学数据的开源项目,为它们做出贡献会是你简历上精彩的一项:
(截止文章发布时间 2026 年 9 月 6 日,下面的项目都还处于征集中)
跨学科领域:
Terminal-Bench:考察智能体在命令行环境里完成真实工作。3.0 的征集页写得最详细,项目现已滚动更新到 4.0,仍在征集更难、更多样的新任务。征集页: https://www.tbench.ai/news/tb3-contribution-call
Terminal-Bench-Science:专收科研工作流,覆盖生命科学、物理科学、地球科学、数学与计算科学,目前 70 道任务,正向 100 道以上扩展。征集页: https://www.tbench.ai/news/tbsci-contribution-call
Agents' Last Exam:面向各行各业有经济价值的长任务。官网 https://agents-last-exam.org/
化学:
ChemBench:化学知识与推理评测集,发表于 Nature Chemistry,有专门的出题指南,可通过 PR、表单或邮件提交题目。出题指南 https://lamalab-org.github.io/chembench/contribute_questions/
物理:
FrontierPhysics:考察 AI agent 如何迭代式地开展前沿物理研究。介绍页:https://www.benchflow.ai/frontierphysics/contribute