首页/文章/ 详情

仿真科普|具身智能“物理身体”背后的CAE技术密码
41分钟前浏览0


  工厂里人形机器人自主完成精密装配、园区四足机器人穿梭巡检、家用服务机器人灵活完成家务、水下仿生机器人自主勘测水域……曾经只存在科幻作品里的实体智能体,正加速落地工业、民生、特种作业各大场景。这条从虚拟AI走向物理世界的核心赛道,便是当下产业热度拉满的“具身智能”。


  “十五五”规划纲要明确提出,推动具身智能培育为新质生产力增长点,人形机器人、移动作业机器人、特种仿生装备迎来政策与资本双重加持,行业预计将形成万亿级产业空间。而支撑具身智能从实验室样机走向规模化量产、实现安全可靠落地的底层核心工具,正是“CAE计算机辅助工程仿真技术”。


01 什么是具身智能?

  具身智能(Embodied AI)是搭载物理实体载体的智能系统,区别于纯文本、纯视觉的“离身AI”,核心逻辑是“感知-决策-行动-反馈”完整闭环:机器人拥有机身、关节、传感器、执行器,在真实物理环境中感知重力、摩擦力、流体阻力、碰撞载荷,自主调整动作策略,持续适配开放复杂场景。
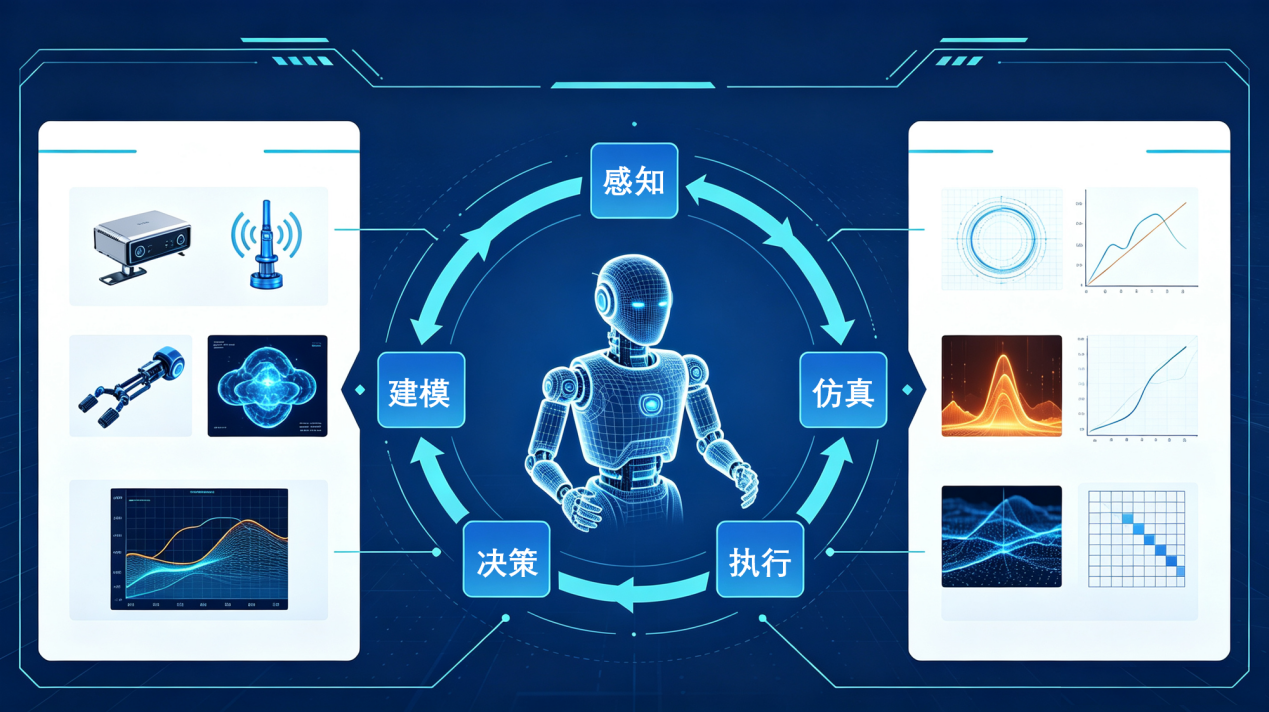

  赛道覆盖四大主流智能载体:

  • 人形双足机器人:工厂装配、家庭服务、办公通用作业

  • 四足巡检机器人:矿山、电力、消防、应急搜救

  • 轮式移动机器人:仓储分拣、园区配送、商用清洁

  • 特种仿生机器人:水下探测、空中作业、外骨骼装备

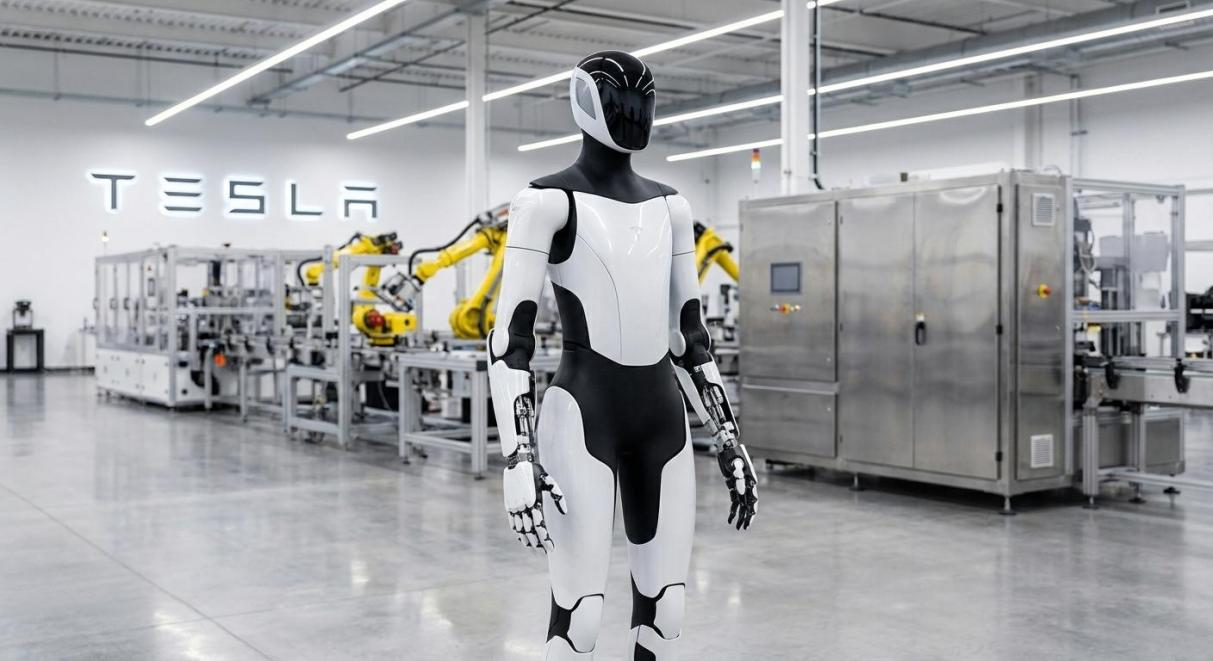
人形机器人在工业场景应用(图源网络)


  智能的根基永远建立在“可靠的物理身体”之上。如果机身强度不足、关节过热卡顿、行走姿态失衡、复杂环境交互失控,再强大的智能算法也无法落地。CAE仿真,就是为每一台智能体打造虚拟“试验场”,在设计阶段规避物理缺陷,打通 “仿真设计—虚拟验证—样机迭代” 全链路。


02 CAE在具身智能研发中的五大核心应用
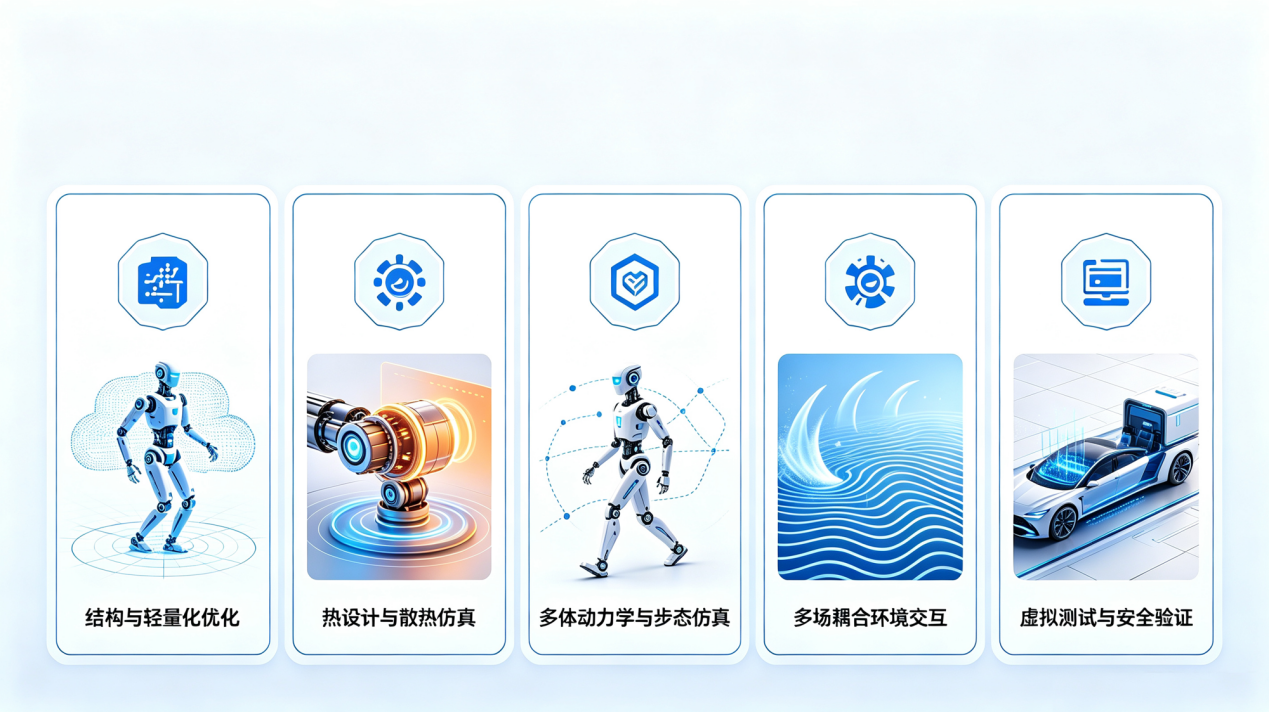


1. 机体结构与轻量化优化仿真


  机身骨架、关节支架、减速器壳体是机器人承载核心,不同姿态、碰撞、负重工况下极易出现应力集中、变形断裂。


  依托CAE中的有限元分析技术,完成全工况的静力学与显式动力学校核,精准模拟机器人在深蹲、负重、1.5米跌落冲击及抓取重物等场景下的应力应变;同时,基于拓扑优化算法对碳纤维、铝合金结构开展轻量化设计,实现减重30%与整机刚度保障的双重目标,从而大幅降低机身功耗与制造成本。同时仿真足地接触、多关节啮合非线性摩擦,模拟沙地、冰面、台阶等复杂地形的受力状态,从结构根源解决打滑、失衡问题。
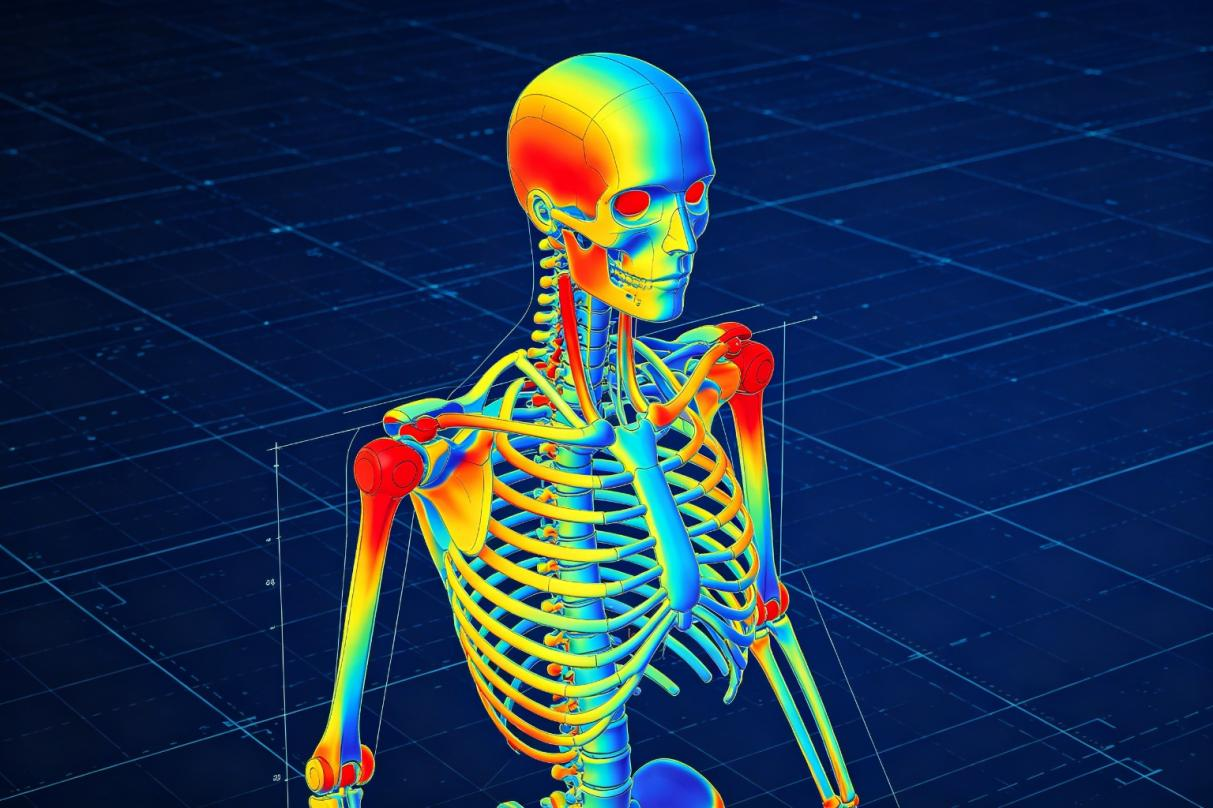


机器人机体结构有限元应力分析(图源网络)


2. 整机热设计与散热仿真


  人形、四足机器人的高功率电机与伺服电控持续工作会快速积热,高温直接导致动作卡顿、元器件寿命衰减、续航大幅缩水,这已成为行业量产的核心痛点。


  热仿真可建立从单颗电机到整机的完整热模型,精准预测关节、电控舱内部温度分布,定位高温隐患;优化散热风道、导热结构、隔热布局,无需反复 制作散热样机,提前规避过热失效风险,提升机器人连续作业时长与整机可靠性。
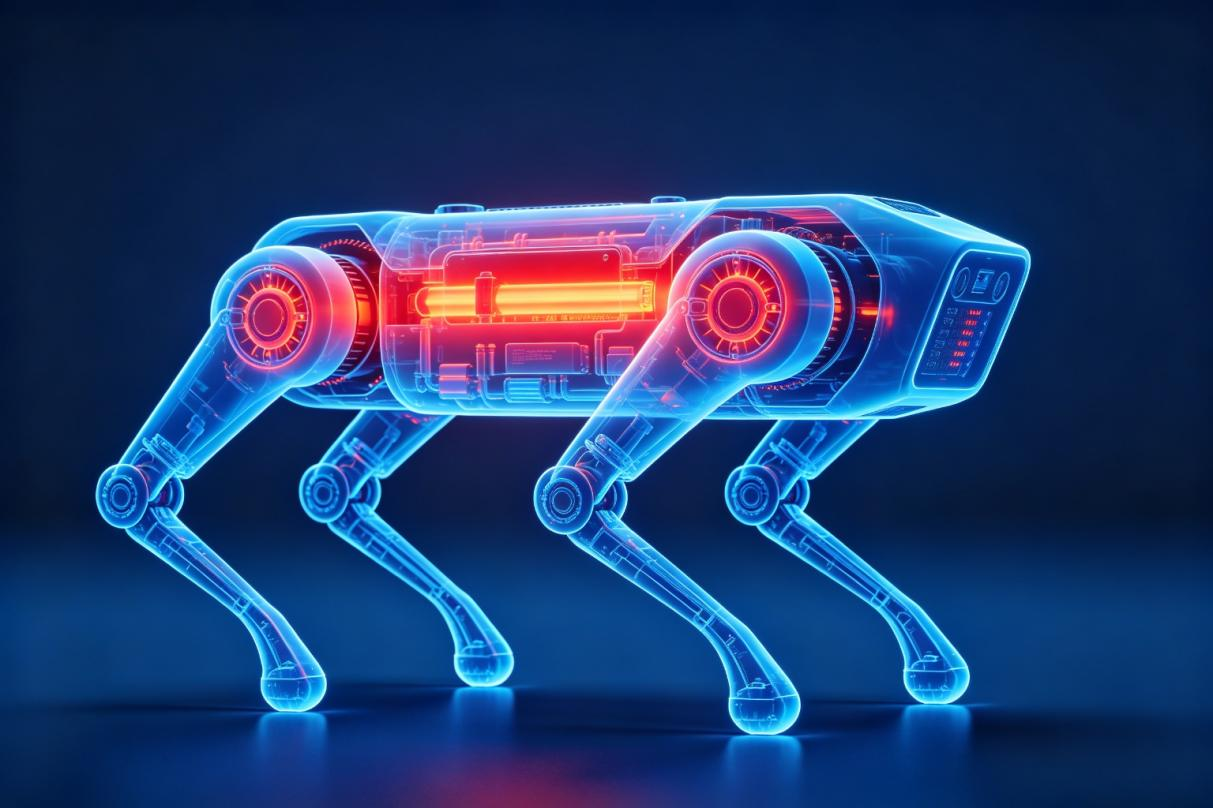


四足机器人整机热仿真温度分布(图源网络)


3. 多体动力学与步态运动仿真


  行走、攀爬、抓取、避障等所有动作,都依赖多体动力学精准建模。CAE可完整模拟机器人全关节联动轨迹、动态平衡特性、关节力矩变化。


  基于上述多体动力学模型,可在虚拟环境中复现上下楼梯、跨越障碍、高速转向等上千种运动工况,精准优化步态控制参数;同时输出高精度物理数据,用于评估机器人动态性能与结构可靠性,提前预判失衡、过载等风险,大幅减少物理样机试制次数,显著缩短研发周期。
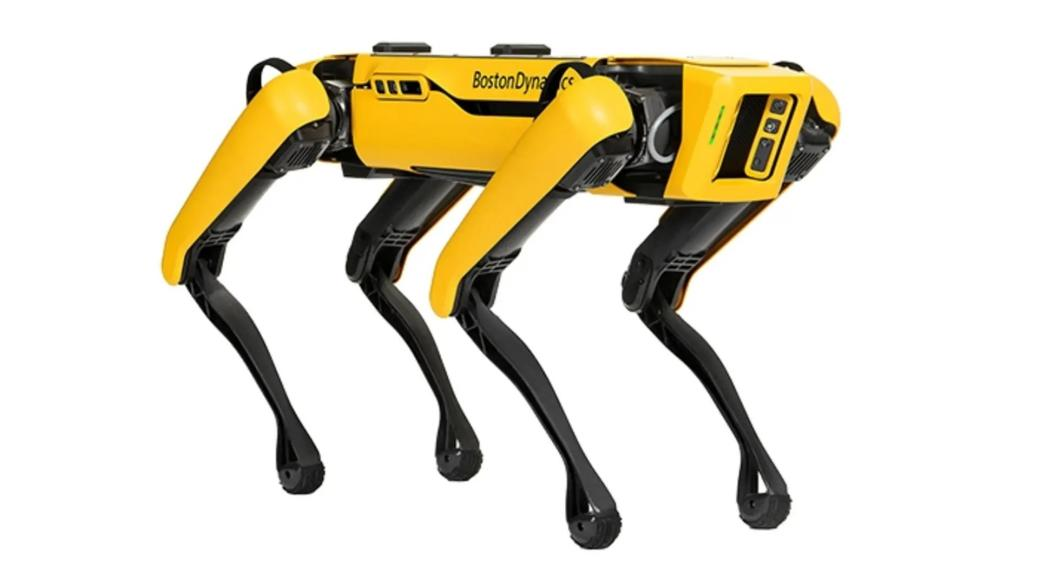
四足机器人Spot在复杂地形巡检(图源网络)


4. 多场耦合环境交互仿真


  具身智能体需要在风场、水流、高低温、冲击噪声等复杂环境作业,单一学科仿真无法还原真实工况:


  • 流固耦合:空中机器人风阻、水下仿生机器人水流冲击仿真,优化机身外形降低行进阻力;

  • 声振耦合:模拟机器人行走、机械臂运转噪音,优化结构抑制振动异响;

  • 电-热-结构耦合:同步分析电机通电发热、结构形变、应力变化的连锁影响。

  多物理场联合仿真,让机器人在设计之初就适配户外、水下、高空等极端作业场景。
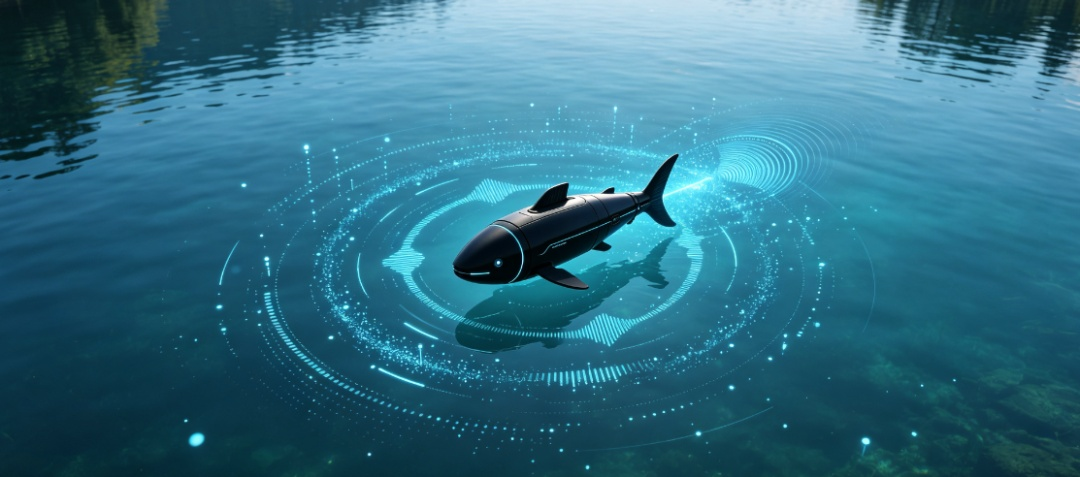


仿生机器鱼水下作业(图源网络)


5. 虚拟全场景测试与安全验证


  传统机器人研发依赖多轮物理样机测试,成本高、周期长,跌落、碰撞测试还存在设备损毁风险。


  为突破这一瓶颈,CAE仿真构建了全虚拟测试体系:批量模拟碰撞、过载、极端温变、长期疲劳损耗等破坏性工况,精准界定整机安全边界;同时,基于高保真数字孪生体批量生成物理交互数据,直接反馈至结构设计与控制逻辑优化,大幅减少实体样机试制数量,压缩研发周期50%以上。


03 神工坊®技术方案


  神工坊沉淀的动态网格自适应、大规模并行计算、复杂流场多场耦合核心技术,可全方位迁移赋能全场景具身智能体的环境交互仿真研发,解决行业 “仿真精度低、建模效率差、虚实差距大” 的核心痛点。


1. 复杂几何处理及网格自动生成,大幅提速具身智能建模迭代效率

  HSF-SAMR结构网格自适应框架,突破传统 CFD 网格对几何完整性的严苛限制,可直接导入带孔洞、面毛刺的“脏几何”模型,免去长时间几何修复。可快速适配水下仿生机器人、空中飞行智能体、陆上异形作业机器人等各类具身智能载体的复杂结构,实现网格自动生成。极大缩短多场耦合、环境交互工况的建模周期,解决具身智能样机高频迭代、多工况批量仿真的效率难题。
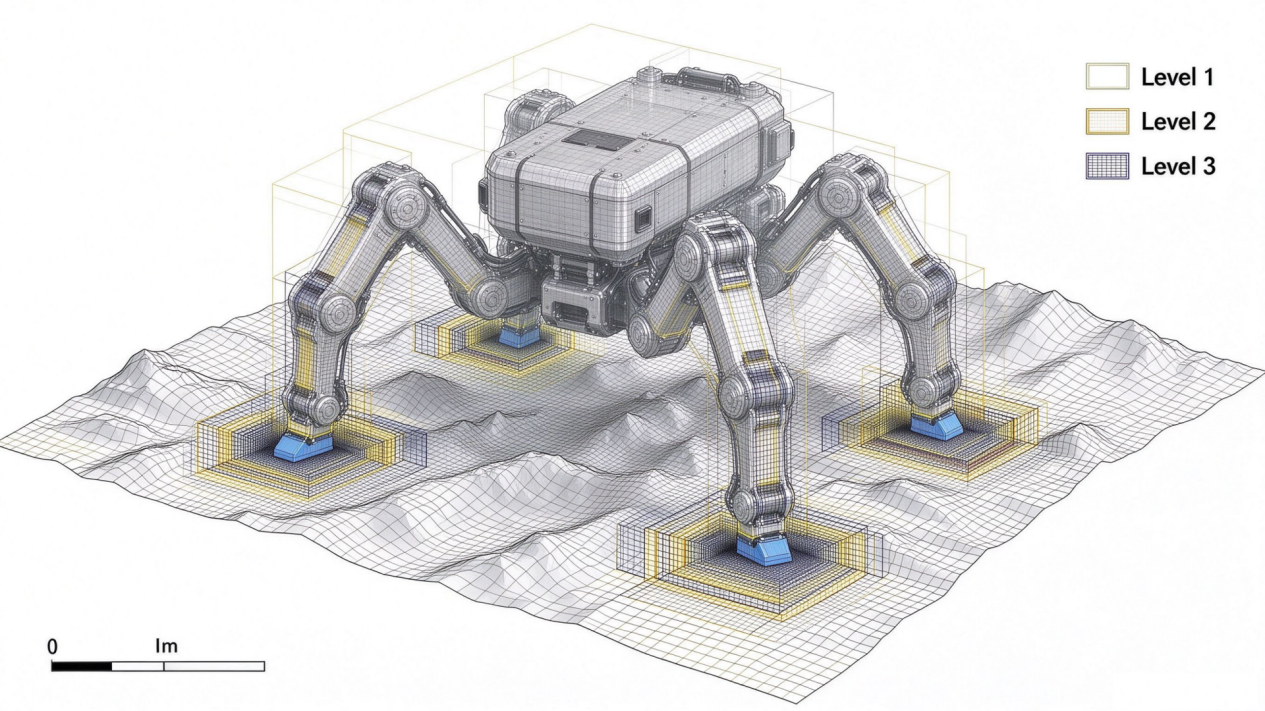


2. 动态网格自适应,实现具身智能高保真环境交互仿真

  具身智能的核心能力,是在动态、非结构化、极端复杂物理环境中完成自主感知、姿态调整、避障作业,对仿真的动态精度、环境还原度要求极高。依托可随物理场特征实时调整的动态网格加密技术,可精准刻画水流、风场、冲击、湍流等复杂环境的瞬时变化,完整复现水下暗流、高空紊流、地面复杂路况等极端作业场景。
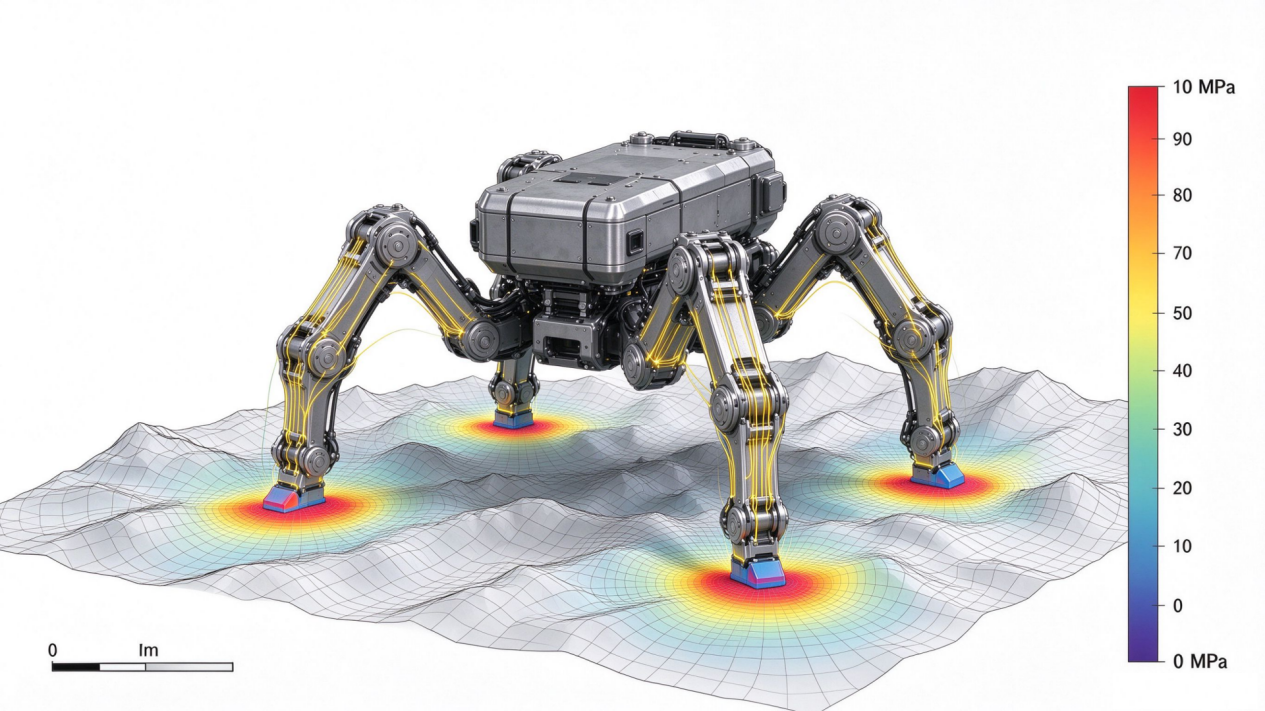


3. 超算级并行算力,支撑具身智能体大规模仿真

  依托项目沉淀的亿级网格、万核大规模并行计算能力,可支撑具身智能体全尺寸、全工况、长时序的批量仿真计算,能够快速生成海量、高精度的物理交互数据集。为机器人强化学习、步态优化、环境感知算法迭代提供充足的数据底座,赋能具身智能的数字化研发。


04 结语


  具身智能的竞争,本质是“物理本体性能”与“智能算法”的双重竞争。CAE仿真作为打通实体硬件与数字技术的桥梁,实现了从结构设计、环境适配、运动优化到安全验证的全流程数字化研发,是具身智能产业规模化发展不可或缺的底层基座。


  依托先进计算技术,神工坊®将持续探索具身智能等新兴场景,持续完善多学科耦合、AI加速仿真能力,以超智融合数值引擎为技术底座赋能国内企业与科研机构突破研发瓶颈,助力我国高端装备研发领域抢占全球技术高地,为新质生产力发展注入动能。


[媒介矩阵版尾-2025].png


参考资料:
[1] 中华人民共和国国民经济和社会发展第十五个五年规划纲要[R]. 北京: 国家发展和改革委员会, 2026.
[2] 工业和信息化部. 人形机器人创新发展指导意见[Z]. 2023.
[3] 36氪研究院. 2026年具身智能产业发展研究报告[R]. 北京: 36氪, 2026.
[4] 中国信通院. 中国具身智能产业发展报告(2026)[R]. 北京: 中国信息通信研究院, 2026.
[5] KIT. Methods for Lightweight Design of Mechanical Components in Humanoid Robots[D]. Karlsruhe: Karlsruhe Institute of Technology, 2018.
[6] 西北工业大学. 仿人机器人大腿结构轻量化及其快速成型技术[J]. 机械科学与技术, 2018.
[7] 西北工业大学. 有限元和拓扑联合优化方法及其在机器人结构轻量化设计中的应用[J]. 机械科学与技术, 2024.
[8] The Magneto-thermal Analysis of A High Torque Density Joint Motor for Humanoid Robots[C]//IEEE-RAS Humanoids. 2018.
[9] 高性能人形机器人用环形流道液冷环的设计、分析与实验验证[J]. 2026.
[10] Boston Dynamics. Spot Robot Official Documentation[EB/OL]. https://bostondynamics.com/, 2024.
[11] Sim-to-Real Transfer in Deep Reinforcement Learning for Bipedal Locomotion[J]. arXiv:2511.06465, 2025.
[12] 中科泷渊. 仿生机器鱼水域智能感知公开报道[EB/OL]. 2026.
[13] 基于流-固-电多场耦合的压电致动柔性尾鳍水下行-驻波特性分析[J]. 振动工程学报, 2026.
[14] A Modular Digital Twinning Framework for Safety Assurance of Collaborative Robotics[J]. Frontiers in Robotics and AI, 2021, 8: 758099.
[15] SyncTwin: Fast Digital Twin Construction and Synchronization for Safe Robotic Manipulation[J]. arXiv:2601.09920, 2026.



人工智能云计算NVHHPC后处理分析求解技术网格处理机器人流-固&热耦合结构基础流体基础试验神工坊 SIMFORGE通用静力学振动显式动力学疲劳断裂几何处理科普数字孪生
著作权归作者所有,欢迎分享,未经许可,不得转载
首次发布时间:2026-10-30
最近编辑:41分钟前
神工坊(高性能仿真)
神工坊,提供高性能仿真解决方案...
获赞 499粉丝 73文章 191课程 13
点赞
收藏
作者推荐

技术分享︱SIMFORGE HSF® 网格加密与热点加速技术实践

引言工程仿真规模持续增大后,网格和计算往往同时成为瓶颈。关键区域需要更高分辨率,网格变化后拓扑、边界和场数据仍要保持完整,长时间迭代中的高频循环还要充分利用并行硬件。SIMFORGEHSF®围绕这条计算链路,逐步形成了SAMR、USTR两类网格加密能力,并将GPU热点计算接入统一的求解流程。本文将按两部分展开:第一部分介绍网格加密,分别对应SAMR的分层自适应和USTR的非结构网格细分;第二部分介绍热点加速,从GPU计算路径、算子优化到工程算例验证,展示这些能力如何在同一框架中衔接。Part1网格加密/围绕“哪里需要更细”和“加密后信息是否完整”展开01HSF-SAMR:面向复杂几何与流场演化的自适应加密SAMR采用Octree管理空间层级,每个叶节点关联规则Block。Octree负责网格层级与空间拓扑,Block负责局部数据存储和高效遍历。这样的组织方式可以在全局保持灵活的加密层次,同时利用规则块内连续、规整的数据访问。图1SAMR多层分块网格示意:不同区域可处于不同分辨率层级1.1几何自适应与指定区域加密复杂外形进入计算域后,框架可根据STL表面与网格的空间关系,在几何边界附近自动提高分辨率。对于尾迹区、局部观测区等已知重点区域,也可以直接用Box描述加密范围,将网格细化到指定层级。图2几何自适应:复杂外形附近自动形成更细的网格层级指定区域加密和几何加密可以叠加使用。应用层只需要给出区域与层级,底层完成Octree调整、Block重建和后续数据准备,求解器仍通过统一的数据容器访问场变量。图3指定区域加密:通过空间范围控制局部分辨率1.2体素化:让几何边界进入网格体系网格生成之后,还需要确定计算单元与几何模型之间的关系。SAMR采用两级体素化:先以Block为单位快速区分inside、outside和cross,再对相交Block内的Cell做精细判断,得到边界单元及切割信息。这样可以把高成本几何判断限制在边界附近。图4两级体素化:先定位相交Block,再细化到Cell级边界判断体素化结果直接服务于浸入边界、切割单元和边界条件处理。远离几何表面的规则区域仍保持连续Block计算,边界附近则保留更细的几何描述。1.3解自适应与场数据迁移流场特征会随时间演化,固定加密区很难覆盖所有关键结构。SAMR可以从速度梯度、涡量等场量提取加密依据,生成refine、coarsen和unchange标记,再完成Octree拓扑调整。细网格随特征区域移动,计算量也随之重新分布。图5解自适应示意:细网格随局部特征区域重新分布网格层级变化后,场数据还要同步细化或粗化。框架在网格更新过程中完成插值、平均和数据迁移,并配合逐层负载调整,使新的网格拓扑可以直接进入下一阶段计算。02HSF-USTR:面向非结构网格的多单元细分与集/合继承USTR面向非结构网格,加密时需要同时处理单元形状、点线面体拓扑、跨进程编号和算例集/合。当前加密能力已覆盖工程算例中使用的主要三维单元类型。不同单元采用各自的细分模板,上层统一使用父子关系、拓扑重建和集/合更新流程。2.1从单元细分到完整网格重建以六面体为例,一个母单元通过边中点、面心和体心等新增节点完成规则细分,形成8个子单元。多层加密由一次参数设置触发,框架连续完成节点生成、子单元构建和父子关系记录,最后统一更新所需的拓扑与相关变量。图6USTR并行网格加密需要同时处理单元细分、编号、拓扑和边界集/合这套流程的重点在于把几何细分和网格语义放在同一个阶段处理。加密层数提高后,Cell2Node、节点坐标、单元属性、单元类型、局部到全局编号等信息都要同步更新,避免后续模块再做二次修补。2.2分布式新增节点与全局编号并行环境中,同一个进程边界上的新增节点可能由多个进程同时看到。USTR复用原有SharedNode/Edge/Face关系识别加密后的共享实体,并使用确定性的层级关系对共享节点排序,避免浮点坐标排序带来的不确定性。随后依据Owner和全局Offset生成编号,再将Owner侧的全局ID同步给邻接进程。原有进程边界信息在这里发挥了重要作用。它可以直接作为新Shared实体的查找入口,减少从零遍历和重建通信关系的成本,也使多层加密后的拓扑关系保持可追踪。2.3点、线、面、体集/合跟着网格一起加密工程算例中的材料区、载荷、约束和接触条件通常依赖Subset。Cell、Face、Edge集/合可以根据父子实体关系直接映射到细分后的网格。NodeSubset更复杂:同一个点集/合在物理上可能表示一条边、一个面,甚至一组单元。表1USTR加密过程中需要同步维护的典型信息因此,USTR为点集/合提供NODE、EDGE、FACE、CELL四种重建语义。用户可以明确点集/合对应的几何实体,框架先恢复原有边、面或体集/合,再根据细分关系生成新的点集/合。这样可以保持边界范围和物理作用区域不随加密发生偏移。USTRMeshuMesh(comm);uMesh.setRefineLevel(refineLevel);uMesh.setNodeSubsetRebuildMethod(HSF::SetType::FACE);2.4加密结果进入完整验证链路加密完成后,验证首先检查跨进程全局编号。各进程输出新增节点的全局ID与坐标并汇总,确认不存在“同一全局ID对应不同坐标”的冲突。随后通过可视化对照加密前后的边界集/合,确认点、线、面、体集/合仍位于正确位置。图7USTR加密验证:全局编号一致性与边界集/合继承同时检查这类验证直接对应求解阶段的使用需求。边界集/合一旦缺失或错位,接触搜索、载荷施加和材料区域识别都会受到影响;把编号一致性和集/合继承放进网格加密的基础测试,可以在求解器运行之前发现问题。Part2热点加速/围绕“计算如何放到GPU上”和“端到端性能如何提升”展开03热点计算路径:保持求解流程稳定,把高频算子下沉到GPU长时间迭代中,高频算子会逐渐占据主要计算时间。以LBM为例,碰撞和迁移都具有规则、重复和高并行度的特点,适合交给GPU执行。HSF保留原有迭代器组织方式,由CPU负责流程控制和必要的数据准备,设备相关实现集中在热点算子层。进入热点计算前,迭代器取得Block和场数据的连续指针,统一调度入口再将计算提交到GPUKernel。上层求解器仍沿用原有流程,不需要维护两套相互独立的计算逻辑。图8GPU热点计算路径:数据组织与设备端算子分层处理04GPU算子优化:扩大并行粒度,减少数据搬运4.1合并循环,增加单次Kernel的有效工作量热点代码首先处理并行粒度。原程序通常按Block遍历,再进入ijk多层循环;GPU路径将外层Block与内部网格索引映射到统一线程空间,让更多网格点在同一次Kernel中并行执行。迁移过程中的多个小循环也尽量归并到共同的数据访问模式,减少频繁启动Kernel和重复索引计算。4.2数据传输逐渐成为端到端瓶颈当Kernel计算速度明显提高后,Host与Device之间的数据往返会在总耗时中占据更大比例。一次热点计算的时间拆分可以直观看到这一变化:纯计算已经压缩到很小的时间片,而数据拷贝仍然需要承担固定成本。图9GPU热点中的数据传输与带宽:Kernel加速后,数据搬运成为主要优化空间后续优化的方向也随之明确:尽量延长关键场数据在GPU上的驻留时间,让连续热点算子复用同一份设备数据,只在确有需要时回写CPU;同时减少中间格式转换和临时缓冲区重建,把端到端收益从单个Kernel扩展到完整时间步。05GPU热点加速验证:数值一致性与端到端加速效果5.1小球绕流:先确认CPU/GPU结果一致热点迁移完成后,首先通过经典小球绕流算例检查数值一致性。算例采用多层网格加密,细网格集中在球体近场和尾迹区域。CPU与GPU计算得到的阻力系数保持一致,速度场分布也相互吻合。图10小球绕流的多层网格布置图11同一时刻的速度场对比:CPU与GPU结果保持一致表2小球绕流阻力系数对比5.2热点性能:Kernel收益已经比较明显在相同算例规模下,迁移热点的GPU纯计算加速约77倍,包含数据传输后的端到端加速约4.6倍;碰撞热点的纯计算加速约190倍,端到端加速同样约4.6倍。两组结果说明GPU侧计算能力已经得到发挥,总体性能进一步提升主要取决于数据驻留和传输策略。图12迁移与碰撞热点的GPU加速效果5.3大规模外流场:网格能力与热点加速协同工作在更大规模的外流场算例中,SAMR通过多层网格把分辨率集中在艇体近壁面和尾迹区域,求解器在此基础上执行长时间迭代。速度场与压力场能够连续呈现尾迹结构,也说明网格组织、场数据和热点计算可以在同一计算链路中稳定衔接。图13大规模外流场算例:多层网格、速度场与压力场结果06结语从网格加密到GPU热点优化,SIMFORGEHSF®目前已经形成两条比较清晰的技术链路。SAMR负责复杂几何和演化流场中的局部分辨率,USTR负责非结构网格细分后的拓扑与集/合继承;进入求解阶段后,迭代器继续组织数据,把高频算子交给GPU执行。这套能力的价值体现在应用层:网格可以围绕关键区域持续细化,加密后边界与材料信息能够直接沿用,求解器也无需因为硬件路径变化大幅重写。神工坊®团队将持续深耕SIMFORGEHSF®超智融合数值引擎的研发,继续围绕复杂单元、集/合条件、网格更新过程中的数据复用,以及GPU数据驻留与多算子融合等方向展开攻关。

未登录
还没有评论
课程
培训
服务
行家
VIP会员 学习计划 福利任务
下载APP
联系我们
帮助与反馈