首页/文章/ 详情

五部门:开展智能驾驶“端到端”大模型研发与测试

3月前浏览559

看到一则国家有关自动驾驶仿真的通知,这里转载扩散一下。


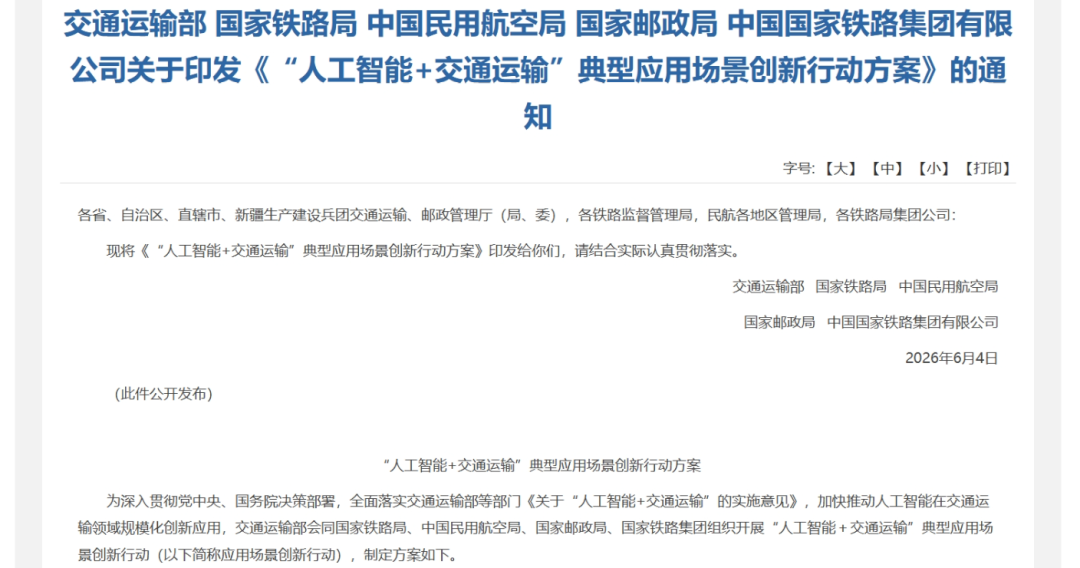
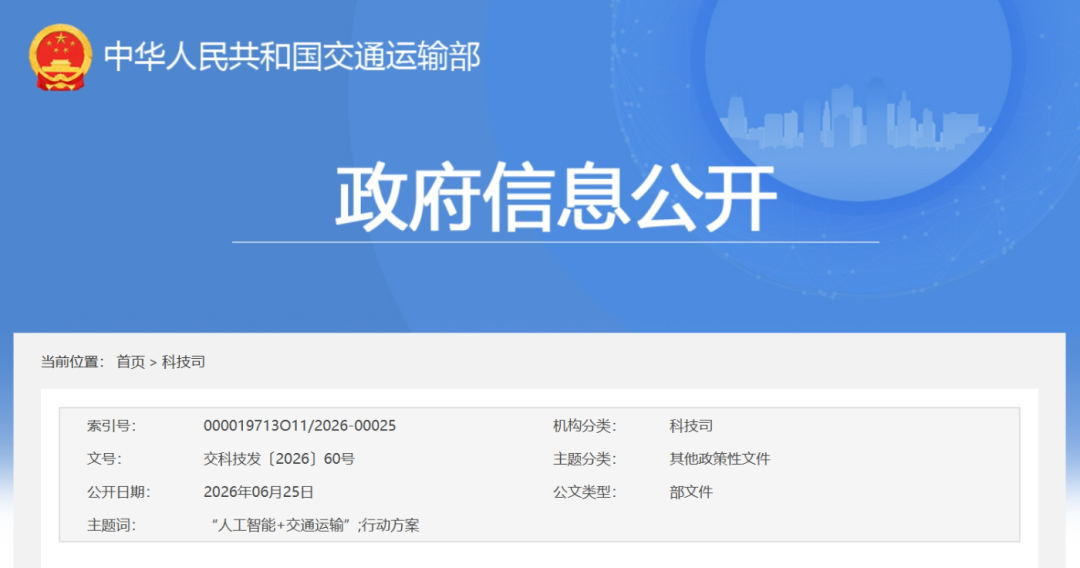
2026年6月25日,交通运输部等五部门联合印发《“人工智能+交通运输”典型应用场景创新行动方案》。


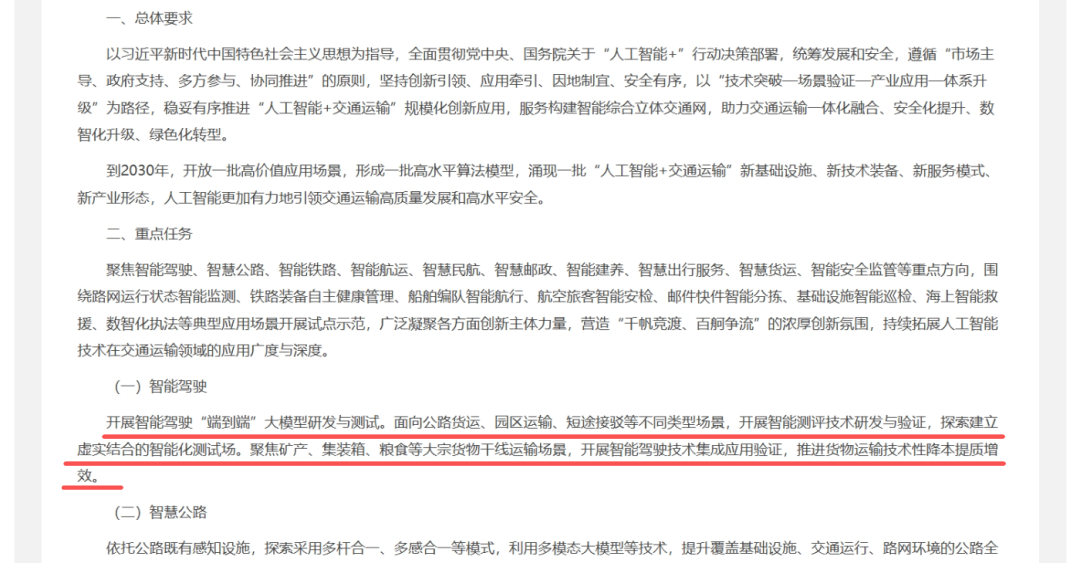
行动方案提出,开展智能驾驶“端到端”大模型研发与测试。面向公路货运、园区运输、短途接驳等不同类型场景,开展智能测评技术研发与验证,探索建立虚实结合的智能化测试场。聚焦矿产、集装箱、粮食等大宗货物干线运输场景,开展智能驾驶技术集成应用验证,推进货物运输技术性降本提质增效。


消息来源如下:

以上,本文完。


来源:车路漫漫
自动驾驶人工智能
著作权归作者所有,欢迎分享,未经许可,不得转载
首次发布时间:2026-07-08
最近编辑:3月前
李慢慢
硕士 自动驾驶仿真工程师一枚
获赞 14粉丝 93文章 322课程 0
点赞
收藏
作者推荐

世界模型的分类

作者 | 李慢慢编辑 | 李慢慢 出品 | 车路漫漫 最近世界模型这个词特别火。 Sora宣称自己是世界模拟器,机器人企业纷纷表示在研发世界模型,英伟达也将Omniverse视作世界模型的基础设施,连游戏引擎、视频生成、VLA、数字孪生等领域,都被纳入到世界模型的相关叙事当中。 可当下业内众人谈论的世界模型,其实并非同一个概念。 最近,李飞飞在个人 Substack 发表了一篇万字长文《A Functional Taxonomy of World Models》,对这一概念进行了厘清。 她首先回到强化学习教科书里那个最经典的图(POMDP 闭环:智能体→动作→状态→观测→智能体),然后指出:现在被叫做“世界模型”的东西,其实是这个闭环的三种不同投影。输出像素(观测)的是渲染器,输出状态的是模拟器,输出动作的是规划器。分类标准非常简洁,就看你输出的是闭环里的哪个部分。 第一类是渲染器(Renderer),它的输出内容为图像、视频、像素这类观测结果,Sora、Genie以及众多文生视频模型都属于此类。这类模型探究的核心问题,是还原世界的外在样貌。凭借极具冲击力的视觉效果,它也成为最容易实现商业化的类型,逼真且富有电影质感的视频,很容易让人们认为模型真正理解了世界。但其中存在明显误区:视觉上的真实,不等于物理层面的真实。这类模型可以制作出画面震撼的机器人影像、搭建出视觉逼真的城市场景,却未必能掌握空间结构、碰撞关系、材料属性与动力学规律。渲染器的局限性十分突出,它只能打造世界的表象,无法触及世界运行的内在机制。 第二类是模拟器(Simulator),它输出的不再是像素画面,而是世界的真实状态,包括内部结构、几何形态、材质、位置、速度、作用力、碰撞效果以及各类动力学关系。模拟器所要解答的,是世界本身如何运转,这也是李飞飞文章里的核心观点。在三类世界模型中,模拟器最容易被忽视,却也最为关键。它处于承上启下的中间位置,依托真实的三维结构与物理状态,能够从不同视角渲染出图像和视频;同时也能为动作规划提供支撑,只要明确动作对状态产生的影响,机器人就可以预判行为结果。可以说,模拟器是连接感知世界与改造世界的桥梁。单纯依靠渲染,机器只是停留在“模拟画面”的层面;仅具备规划能力,机器也只能在固定场景中做出被动反应。而掌握模拟能力后,机器才能在内部构建出可以推演的虚拟世界。 第三类是规划器(Planner),它的输出为具体动作。给定目标与观测信息,规划器便能判断出下一步的行动方向,这也是最受关注的发展方向,直接指向具身智能。不过李飞飞也指出,目前不少机器人演示作品虽然观感出色,但距离落地实际应用还有很远的距离。实验室环境与真实场景截然不同,现实中存在各类长尾场景、画面遮挡、数据异常、不可预判的人类行为以及复杂的物理交互。机器人能在短视频中完成短短二十秒的任务,和它在厨房、仓库、医院、道路等场景中长期稳定工作,有着巨大的差距。 这篇文章的独到之处,在于将大众对世界模型的讨论,从单纯的视觉效果拉回至对底层结构的思考。过去很长一段时间,不少人将世界模型的能力等同于生成更逼真的视频,但本质问题应该是模型是否掌握了世界的因果逻辑。模型是否明白杯子坠落的原理?是否清楚机械臂推动物体后物体的移动轨迹?能否预判动作发生后世界状态的变化?如果做不到这些,哪怕生成的画面再精美,也只是高级渲染器,算不上完整的世界模型。 备注:这篇文章当然也是 World Labs 的产品宣言。他们的 Marble 已经在同时输出高斯泼溅和碰撞网格,试图把渲染器和模拟器统一到一个模型里。文章末尾描绘的终局是一个统一的世界基础模型,能根据下游需求在渲染、模拟和规划之间自由切换。这个愿景是否能实现另说,但作为一个分析框架,渲染器/模拟器/规划器的三分法也许确实有助于穿透当前"世界模型"概念的一部分噪音。 真正完备的世界模型,需要同时拥有三项核心能力: 渲染能力,让机器想象世界的样貌;模拟能力,让机器读懂世界的结构与规律;规划能力,让机器明确行动方向。三者结合,正是AI从语言智能迈向空间智能的核心路径。 这篇文章看似只是对世界模型进行分类,实则重新划定了下一代人工智能的竞争方向。未来的比拼,不再局限于视频生成的逼真度、机器人演示的酷炫程度,核心竞争点在于能否打造出一套可生成、可交互、可推演、可执行动作的内部虚拟世界。当机器具备内部模拟世界的能力,它便不再只是单纯看见世界,而是真正理解世界,也拥有了在现实世界中开展各类行动的坚实基础。 语言模型让机器掌握了文字领域的统计规律,但物理世界依托空间、时间、几何、材质、力与动作存在,并非由文字构成。因此AI下一阶段的发展重点,并非提升语言表达能力,而是强化机器对现实世界的理解能力。 语言模型(VLM)赋予了机器一种谈论世界的方式。世界模型(World Model),是机器最终得以 理解、想象、推理并与世界互动 的方式。 以上,本文完。来源:车路漫漫

未登录
还没有评论
课程
培训
服务
行家
VIP会员 学习计划 福利任务
下载APP
联系我们
帮助与反馈