我做到了,让天下没有难写的论文
从定题到终稿,More Paper 8步写作工作流,彻底治好了我对写论文的精神内耗(恐惧)
More Paper Workflow Pro skill· 2026-06-25
开发者:Dr. Jiang Bingyun
GitHub:github.com/bingyunjiang/more-paper-workflow-pro-skill
开源:欢迎Star、提Issue、贡献代码
你是不是也有过这样的时刻——选题方向模糊不清,文献看了几百篇还是理不出头绪?大纲写了又改改了又写,好不容易动笔了又担心引用的文献被AI编造?如果写论文本身就是一场研究,那为什么不把方法论落到实处?
📌 核心结论
More Paper Workflow Pro Skill 不是又一个"输入标题→生成正文→随机补引用"的AI写作玩具。
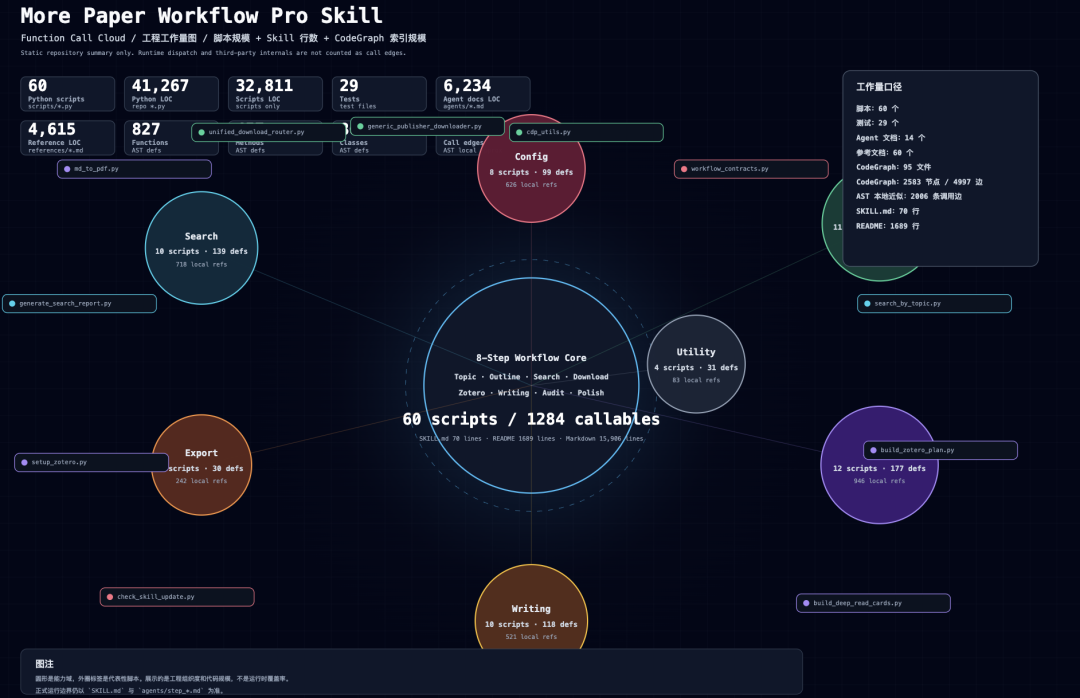
它把论文写作拆成 8 个可见、可检查、可回溯的步骤——
定题 → 大纲 → 检索 → 筛选 → 下载 → Zotero管理 → 写作 → 润色审计。
⚡ 每一篇文献都来自真实数据库
⚡ 每一条引用都能追溯到原文PDF
⚡ 每一步都留下可检查的中间产物
🧑💻 关于这套工具
More Paper Workflow Pro Skill 由 我自己(Dr. Jiang Bingyun) 开发和维护,GitHub 开源,免费 使用。
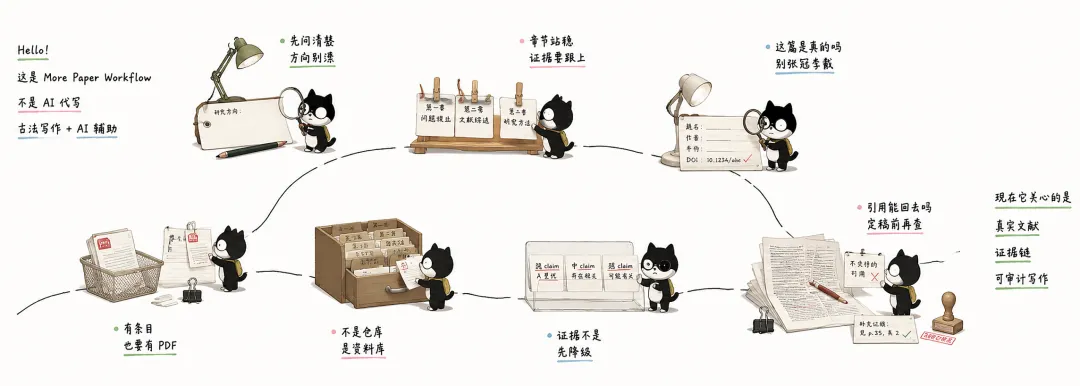
💡 开发初心:「让天下没有难写的文章」——不是一键代写,而是把论文工作拆成可见、可中断、可核验的过程,让研究者保留判断权,让AI承担流程组织和资料整理。
这套Skill尤其适合正在写综述、毕业论文、会议论文或期刊论文的研究生和科研工作者,也适合需要围绕真实文献构建论证链的工程师和课题负责人。它不适合只想输入一个题目就自动生成论文的人——它的价值不是替代研究者,而是帮助研究者把流程做扎实。
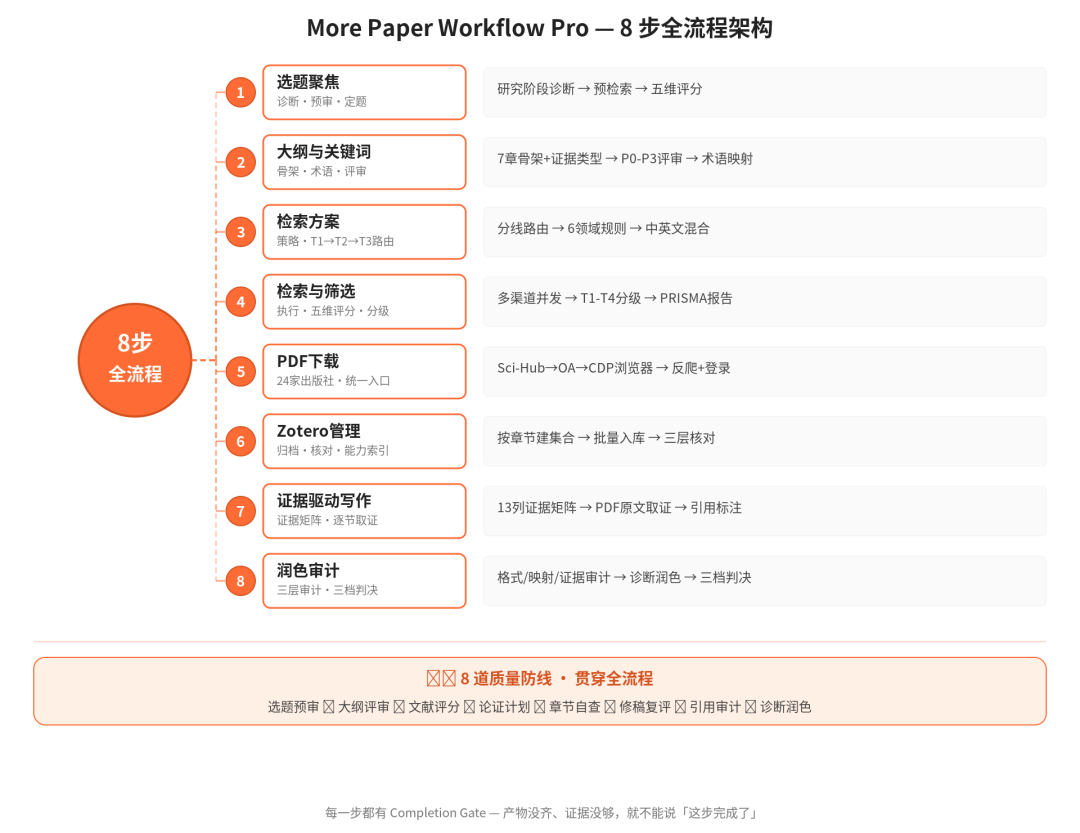
▲ More Paper Workflow Pro 8步流程架构思维导图 · 点击放大查看
🤔 它和普通AI写论文工具有什么区别?
01 还在"拍脑袋"定题?Step 1帮你用数据说话
大多数人的论文之路毁在第一步——方向太宽、文献底子不够、创新点说不清楚。
Step 1 不会直接给你生成一个题目。它会先帮你澄清研究对象、应用场景、核心问题、方法路线和创新边界,再通过预检索判断这个方向有没有足够的文献底子。最终产出的研究主题.md不是简单的头脑风暴笔记,而是一份包含研究对象、研究问题、方法论、创新点初判和风险提示的结构化文档。
🎯 五维选题预审
从原创性、重要性、可行性、文献支撑、方法准备度五个维度打分,告诉你这个方向是绿灯继续、黄灯调整还是红灯建议换方向。
📌 如果已经有题目怎么办?
不强制线性重跑。直接从 Step 2(大纲)、Step 3(检索)、Step 5(下载)、Step 7(写作)或 Step 8(润色)进入,灵活适配你的当前阶段。
02 大纲不是标题列表——Step 2生成结构性骨架
普通AI写作:你给我7个章节标题 → 我帮你填内容。
Step 2 截然不同——生成的每章都包含章节目标、核心论点、证据需求类型、预期图表和风险点。同时整理关键词清单和术语映射——核心词、同义词、上位词、下位词、方法词、场景词——这些词直接对接后续的检索方案。
大纲生成后有结构化评审:逻辑连贯性、结构平衡性、创新区分度、工程可行性、格式完备性逐项打分,按 P0必改 → P1建议 → P2可选 → P3可忽略 分级处理。
💡 这套机制也适用于:对已有大纲进行评审优化、将开题报告或草稿目录整理成可检索可写作的章节结构。
03+04 检索不是"扔进搜索引擎"——Step 3和4是特种作战
市面上99%的AI写作工具,检索阶段就是个黑箱。Step 3 先把大纲拆成结构化检索任务,每项绑定关键词组合、布尔查询、数据库路由和筛选策略。Step 4 执行多源并发检索、去重、评分和分级筛选。
T1到T2到T3 三级路由
每项检索任务有首选、回退和兜底数据库链路。不同学科(工程、医学、CS、综述、中文)有各自的路由策略。
五维评分 + T1到T4分级
主题匹配度 / 方法一致性 / 来源质量 / 时效性 / 引用量 → 0到25分 → T1必读 / T2尽量下载 / T3候选 / T4剔除
Step 4完成后的产物清单相当丰富:检索文献表(.md和.xlsx和.pdf)、文献库.bib、PRISMA风格检索报告、本地HTML交互看板、饱和度分析。
这个模块的核心价值在于:把"找文献"变成一个可审阅的筛选过程,而不是只给一串搜索结果。整个过程可回溯——你知道每一篇文献为什么入选、排在什么位置。
05 PDF下载——Step 5 一个入口,24家出版社
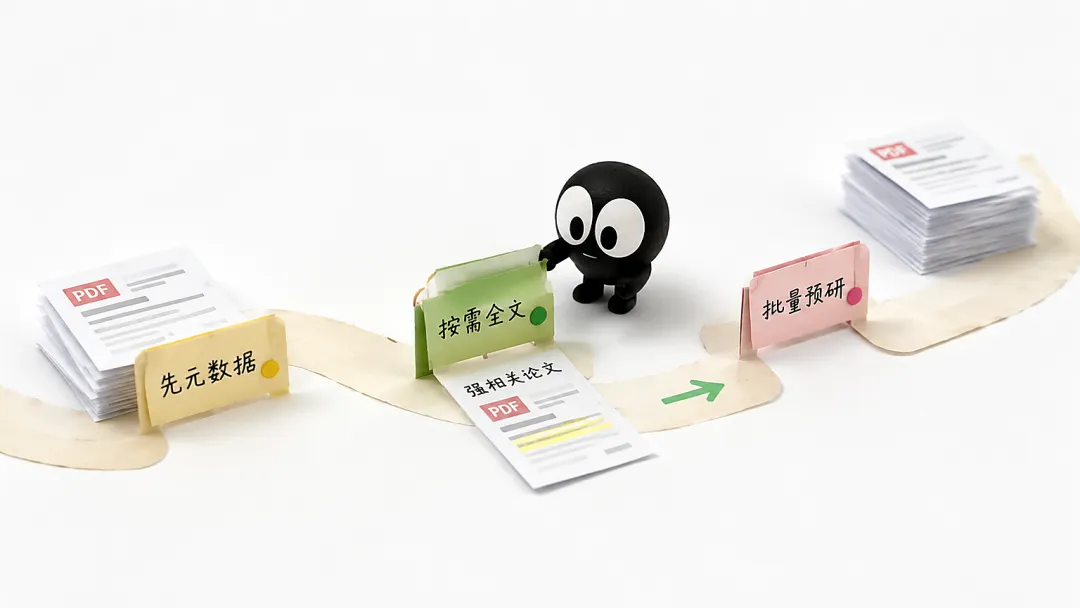
你不需要知道论文在Elsevier还是IEEE、该用什么方法下载。把DOI、BibTeX或标题清单交给工具,它会自动识别出版商,按策略依次尝试:
第一步:Sci-Hub(免费源)
↓ 不成功
第二步:OA Fast(Unpaywall → OpenAlex → Semantic Scholar)
↓ 再不行
第三步:CDP浏览器(Chrome DevTools操控真实浏览器)
↓ 遇到机构登录
停下来等你登录,登录完接着跑
支持的出版社名单覆盖你听说过的所有主流学术出版商:Elsevier、IEEE、Springer、Wiley、Taylor and Francis、Sage、ACM、RSC、MDPI、CNKI、万方……24+家。
需要说明:这个模块不承诺绕过所有数据库访问限制。对于需要机构权限的论文,仍然需要用户在浏览器中完成合法登录。登录态、下载失败和待重试项目都会被记录下来,不会把失败隐藏成成功。
如果你已经有DOI或BibTeX,可以直接从Step 5进入,不需要跑前面的步骤。
06 Zotero文库整理——Step 6让资料真正服务于写作
很多人用Zotero只是"下载 → 拖入 → 完事",结果文库和写作是两件事。
Step 6 负责把论文大纲、BibTeX、PDF附件和Zotero文库结构对应起来:
1. 根据论文大纲自动生成Zotero集 合结构——根集 合等于论文题目,一级集 合等于章节,子集 合等于二级目录
2. 将检索结果、BibTeX、PDF批量入库,中英文文献分别处理(中文用source_id加URL生成CSL JSON,不虚构DOI)
3. 三层核对:集 合结构对不齐?条目齐不齐?PDF附件关联上了吗?
4. 输出可写作资产能力索引——告诉你当前文库能支撑哪些章节写作,哪些地方还缺材料
这个模块的目标不是替代Zotero,而是让Zotero文库真正服务于论文大纲和后续写作。实际写入Zotero前需要用户确认模式;如果Zotero不可写,也可以只生成计划和对照表。
07 写作从证据出发——Step 7的核心原则
这是它和普通AI写作工具最根本的区别——先建证据层,再在证据边界内写作。重要结论必须能追溯到Zotero条目、PDF原文、用户证据包、笔记或其他可核验证据。
Step 7 支持多种写作方式:完整论文写作、指定章节写作、文献综述写作、中英文摘要写作、基于已有草稿续写、审稿意见解读和修稿路线图生成、图表意图规划、引用审计等。
动笔之前,先做三件事:
文献证据矩阵 — 13列结构化提取,逐级回退:Zotero笔记到PDF标注到元数据再到读全文
目标体裁学习 — 分析目标期刊的标题风格、段落密度、图表惯例
章节论证计划 — 动笔前锁定核心论点、所需证据、预期图表
证据不足怎么办? 输出缺口清单或降级表述,而不是强行写成确定结论。
写作时按Zotero子集 合逐节取证,直接读PDF原文而非向量分块,确保每一个数据、方法、结论都能在原文找到出处。每处引用标注证据深度:已读全文 / 已读摘要 / 仅元数据。
引用审计——每一条引用,三层核验
写作完成后,Skill会对正文中的引用、论断和证据支撑进行检查。这是解决"论文看起来写完了,但引用和证据是否可靠"这个问题的关键环节。
第一层 · 格式审计
GB/T 7714-2015完整规范,中英文排序、作者格式、7种文献类型代码正确性
第二层 · 映射审计
正文引用能否追溯到真实BibTeX或Zotero条目?有没有引用不在文库里的文献?
第三层 · 证据审计
被引文献真的说了正文里那句话吗?有没有用摘要级证据支撑了强因果判断?
每条引用附带动作建议:保留 / 降级表述 / 补充PDF证据 / 修复条目映射 / 替换或移除。高风险引用不能带入定稿。
08 保守润色——Step 8只做该做的
Step 8 面向已有初稿,定位是诊断优先的保守修订,不是重写。
它会做的:术语一致性检查、机械化表达诊断、局部衔接修复、保守补写、修订记录和润色质量报告
它不会做的:不凭空增加新证据、不替代完整引用审计、不把候选材料直接升级为正文证据
最终三档判决:
ready for finalize | ready with warnings | not ready, requires rollback
五个典型使用场景
场景一:研究方向还不清楚
从Step 1进入,帮你澄清研究对象、应用场景、问题边界和后续检索路线。
场景二:已经有大纲,需要补文献
从Step 3或Step 4进入,把章节拆成检索任务,形成可审阅的检索表和BibTeX文献库。
场景三:已有DOI或BibTeX,需要下载PDF
直接从Step 5进入,生成下载清单,尝试下载或记录待登录、待重试条目。
场景四:已有Zotero文库,需要开始写作
从Step 6或Step 7进入,先整理文献与章节对应关系,再生成章节蓝图和草稿。
场景五:已有初稿,需要检查和润色
从Step 7或Step 8进入,做引用审计、术语检查、机械化表达诊断和保守修订。
贯穿全流程的8道论文质量防线
质量保障不是一道墙,而是一张从前到后逐层收紧的网:
1. 选题预审 — 方向值不值得做
2. 大纲评审 — 结构问题不推到正文
3. 文献评分 — 每篇该不该进文库
4. 章节论证计划 — 动笔前锁定证据
5. 段落自查加引文支撑 — 每段有明确职责
6. 修稿复评 — 问题到底关没关
7. 引用审计 — 格式、映射、证据逐条核验
8. 诊断润色 — 终稿前最后一道风险收口
核心逻辑:越早发现问题,修复成本越低;越靠近终稿,越要区分能就地修还是必须回退。
它适合谁?
研究生 / 博士生
写毕业论文、综述或期刊论文,从选题一路走到终稿,每个阶段留下可检查的中间产物。
Zotero用户
文库整理和写作是两件事——Step 6和7帮你把它们对齐,从结构化索引到证据矩阵到正文按节输出。
被AI编造参考文献坑过的人
整个链路围绕"真实文献"设计——文献先进Zotero或证据包,再从证据往外写,写完走三层引用审计。
已有DOI或参考文献列表的人
直接从Step 5进入,24家出版社一个入口批量下载PDF,不跑前面步骤也完全OK。
工程师 / 课题负责人/导师
需要围绕真实文献构建论证链的技术研究人员,用于技术调研报告、项目方案论证等。
我的开发目标已实现,欢迎你试用
1. 把论文工作从"直接生成文本"改成"围绕真实文献推进流程"。
2. 把检索、下载、Zotero、写作和润色连接起来,减少资料与正文之间的断裂。
3. 每一步都尽量形成文件化产物,便于回查、复用、审阅和继续推进。
它不会承诺绕过所有数据库权限,也不会把未核验材料直接写成关键结论。遇到机构登录、Zotero写入、引用风险、证据不足等高风险节点时,流程会要求用户确认或降级处理。
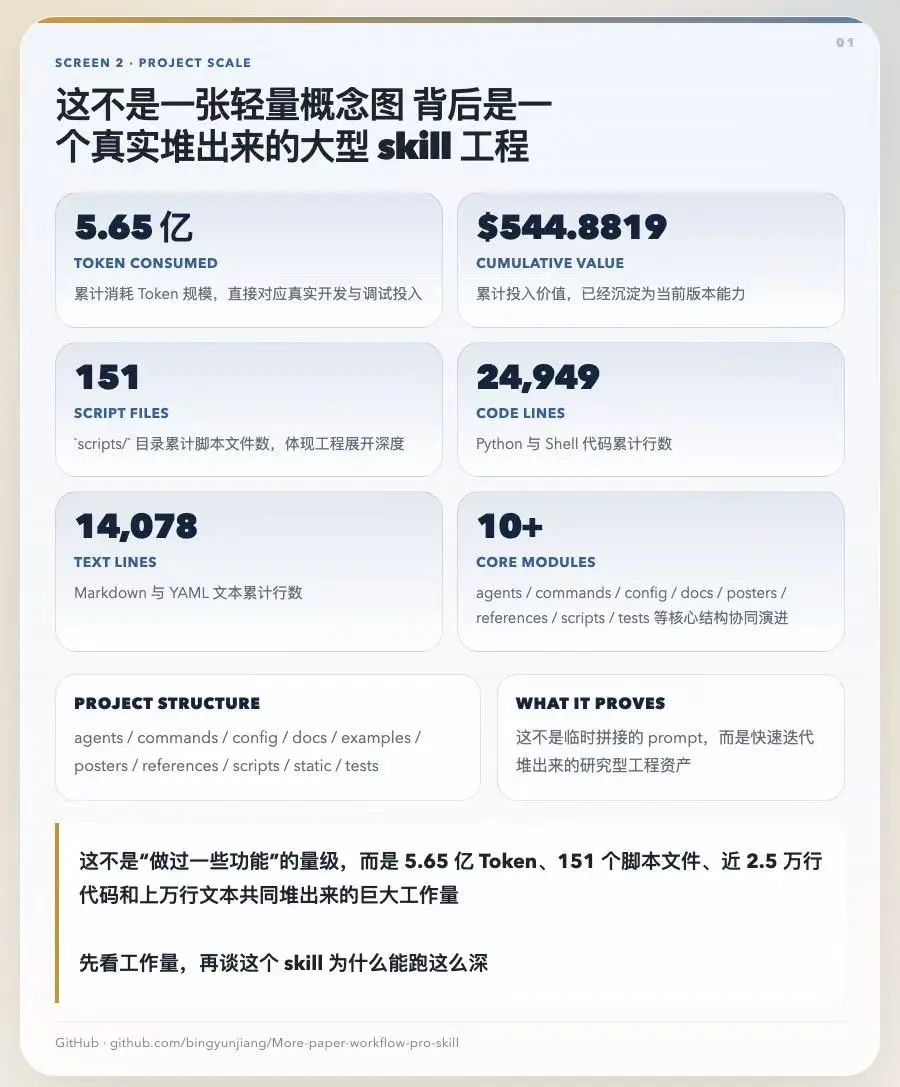
工程层面
- 跨平台:macOS / Windows / Linux 完整支持,Python CLI 优先
- 多宿主:同一套Agent规则在 Claude Code / Codex / Hermes / OpenClaw 上运行
- 可回溯:每一步都有Completion Gate——产物没齐、证据没够就不能说"这步完成了"
- 可恢复:下载中断不重跑已完成篇目,登录门控支持checkpoint恢复
- 自检:启动时自动检查依赖和版本更新
写论文本身就是一场研究。方法论落到实处,过程可复现、结论可检验——这才是做研究该有的样子。
而不是在深夜对着空白文档,焦虑地等AI给你编出下一段文字。
More Paper Workflow Pro Skill| Version 1.0.17 | GitHub开源