故障诊断大模型 | 可解释的机器故障诊断大型语言模型(下)
接上篇(故障诊断大模型 | 可解释的机器故障诊断大型语言模型(上)),论文提出了一种创新的FD-LLM框架,将大语言模型(LLMs)应用于可解释故障诊断。通过设计字符串标记化机制,将振动信号的FFT和包络频谱编码为文本序列,使LLMs能够直接处理传感器数据。FD-LLM包含两个互补的训练范式:分类导向方法用于量化评估诊断性能,频谱语言建模方法则生成人类可读的故障解释。在多个公开轴承数据集上的实验表明,Llama3系列模型在有效性、适应性、鲁棒性和少样本泛化性方面均表现优异,特别是在频谱建模任务中,模型能够识别特征频率、谐波和边带,并生成准确的诊断结论。下篇主要介绍实验和讨论,更多实验细节可查看论文附录。
论文基本信息
论文题目:
Large language models for explainable fault diagnosis of machines
论文日期:2025
论文链接:
https://doi.org/10.1016/j.engappai.2025.113131
作者:
Hamzah A.A.M. Qaid (a) , Bo Zhang (b) , Shuai Su (b), Dan Li (c) , See-Kiong Ng (d) , Wei Li (b,∗)
a: School of Mechatronic Engineering, China University of Mining and Technology, Xuzhou, 221116, China
b: School of Computer Science and Technology/School of Artificial Intelligence, China University of Mining and Technology, Xuzhou 221116, China
c: School of Software Engineering, Sun Yat-Sen University, Zhuhai 519080, China
d: Institute of Data Science, National University of Singapore, Singapore 117602, Singapore
作者简介:
李伟,教授,中国矿业大学城市应急技术装备研究中心主任。(https://faculty.cumt.edu.cn/LW12345678/zh_CN/index.htm)目录
摘要
1. 引言
2. 相关工作
2.1 智能故障诊断
2.2 基于大语言模型的时间序列数据
3. 方法
3.1 FD-LLM框架
3.1.1 分类导向训练方法
3.1.2 上下文感知频谱语言建模方法
3.2 数据预处理
3.2.1 FFT预处理
3.2.2 统计摘要
3.2.3 变分模态分解
3.2.4 时间序列数据编码
3.2.5 指令微调
4. 实验
4.1 数据集与评估任务
4.1.1 数据集
4.1.2 评估任务
4.2 模型
4.3 设置
4.4 评估指标
4.5 结果与讨论
4.5.1 基于分类导向的评估
4.5.2 上下文感知频谱语言建模评估
5. 结论
4.实验
4.1.数据集与评估任务
4.1.1.Datasets
我们采用了四个公开可用的轴承数据集,这些数据集同时涵盖了受控环境与真实工况下的故障状态:
CWRU:凯斯西储大学数据集(CWRU,2024)包含来自轴承的振动信号,这些轴承在内圈、外圈及滚动体处均存在人工诱发的缺陷(缺陷直径分别为0.007英寸、0.014英寸和0.021英寸)。信号采集于驱动端(DE)与风扇端(FE),测试涵盖四种载荷条件(0–3马力)及1730–1797转/分钟转速范围,采样率分别为12kHz和48kHz。本研究采用来自DE和FE端的12kHz数据。
MFPT:机械故障预防技术数据集(Bech-hoefer,2025)提供了在不同载荷条件下正常状态、内圈故障及外圈故障的单通道振动信号。数据采样频率为97.656kHz(包含三种正常状态和三种外圈故障,载荷270磅,频率25Hz)以及48.9328kHz(包含七种内圈故障和七种外圈故障,载荷范围25–300磅)。本研究未包含97.656kHz处的三个外圈信号。
XJTU-SY:XJTU-SY数据集(Wang等人,2020)由西安交通大学与Sumyoung科技有限公司联合开发,属于运行至失效型数据集,包含在三种工况(12kN–2100rpm、11kN–2250rpm、10kN–2400rpm)下测试的15个轴承样本,采样率为25.6kHz。该数据集仅使用水平振动信号。
PU:帕德博恩大学数据集(Lessmeier等人,2016)包含32个轴承样本:其中6个为健康轴承,12个带有人工诱发故障(7个外圈轴承,5个内圈轴承),另有14个通过加速寿命试验获得真实故障样本,所有样本均以64kHz采样率采集。该数据集定义了两个子集:PU-art(人工诱发故障样本)和PU-real(运行至失效信号样本)。
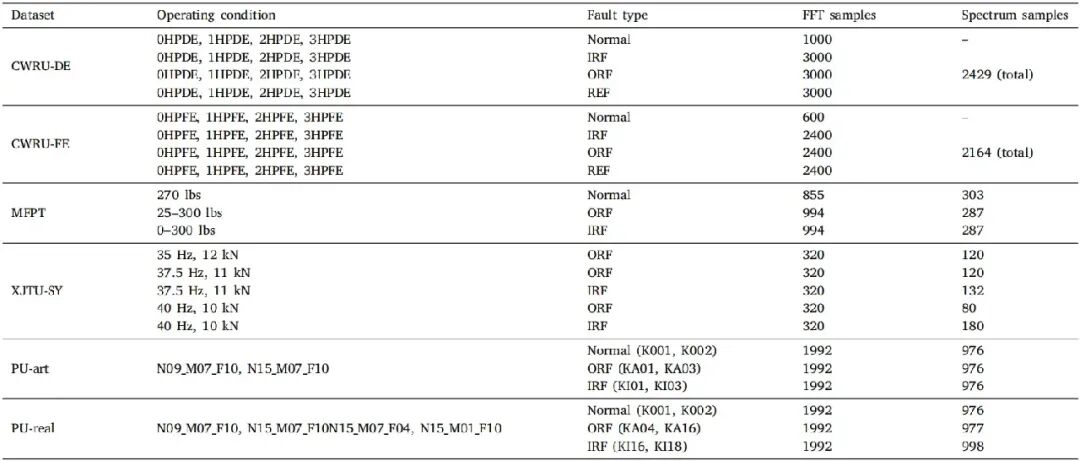
CWRU和MFPT数据集提供了来自受控实验室环境、带有人工诱导故障的高质量数据;而XJTU-SY数据集则通过运行至失效实验反映了实际环境中的性能退化情况。PU数据集结合了这两种数据类型,可同时评估两种故障类型。表2汇总了各数据集及其运行条件与健康状态(正常、IRF、ORF、REF)。其中90%的数据用于训练,10%用于测试。符号0HP–3HP表示负载水平;DE和FE分别指驱动端和风扇端。设置35Hz12kN表示转速为35Hz、径向力为12kN;而N09_M07_F10则对应900rpm转速、0.7Nm扭矩及1000N径向力。
所有信号均按第3.2节所述方法进行预处理。在 FFT 分析和统计分析中,每个时域信号均被分割为长度为2048个样本、重叠率为50%的片段;统计预处理仅应用于驱动端(CWRU -DE)和风扇端(CWRU -FE)信号,所得样本数量与经 FFT 处理的数据一致。对于频谱样本,其片段长度对应1秒数据(由各数据集的采样率决定),并采用90%的重叠率。尽管该重叠率较高,但受限于信号持续时间较短及片段长度为1秒的特点,既避免了过度冗余,又能确保足够的采样密度以捕捉瞬态频谱特征。
为提取适用于频谱-文本编码的包络谱,所有数据集中的分段信号均采用VMD变换处理,预设模态数 、惩罚因子 。对于PU数据集,则使用 ,并在VMD前应用低通滤波器以抑制噪声干扰(尤其是电源相关的频率成分)。虽然先前研究通常采用5–8个模态(Li等,2020; Zhang等,2017a),但我们选择10个模态以确保额外频率成分(如边带和谐波)得到充分保留。这一选择对维持所提出的频谱-文本编码所需的结构化频谱信息至关重要——该编码依赖峰的相对间距和幅度与文本诊断特征相匹配。惩罚因子 选取于常见报告范围(1000–2000)内,以确保模态分离稳定。所有参数设置均通过跨数据集实验验证:对于内部和外部故障信号,采用第4、5、6个VMD模态重建滤波信号,确保提取的频谱保留仅使用单一模态时常缺失的边带和谐波;而对于球形故障信号,则使用第1和第2个模态。
表2 轴承数据集摘要
4.1.2.评估任务
分类导向型方法:该方法涵盖以下任务。
有效性评估:我们利用FFT和CWRU数据集中的统计样本,对四种开源大语言模型(LLM)的有效性进行了验证。CWRU数据集包含高质量的振动信号,为评估这些模型并将其性能与传统基于机器学习(ML)和深度学习(DL)的方法进行对比提供了可靠依据。
适应性评估:采用零样本评估方法来检验大语言模型在不同运行环境及组件条件下的适应能力。所有模型均在0HPDE子集(见表3)上训练,并按以下方式评估:
(1)子集内评估: 为在相同运行条件下评估性能,按照标准故障诊断实验设置,选取10%的0HPDE样本进行评估;
(2)跨运行条件: 为评估同一机械部件(驱动端)在不同负载和转速条件下的适应性,模型分别在1HPDE、2HPDE和3HPDE子集上进行测试;
(3)组件间评估: 为评估模型在不同机器组件间的可迁移性,所有模型均在风扇端的0HPFE和1HPFE子集上进行评估。
稳健性评估:为降低计算开销并避免重复实验,仅选择性能最佳的模型用于后续的稳健性及评估任务。该评估旨在检验模型对信号质量变化的适应能力。首先,在0HPDE子集上通过引入模拟噪声(如高斯噪声、拉普拉斯噪声等),设置信噪比(SNR)从-9dB至9dB不等来测试稳健性;随后将评估扩展至其他数据集,并采用FFT和频谱表示法,以进一步验证模型在不同信号特性下的性能一致性。
少样本学习环境下的泛化能力评估:本研究在少样本学习场景下评估模型的泛化性能。具体而言,模型首先在CWRU数据集上进行预训练,随后利用有限数量的标注样本分别适配MFPT、XJTU-SY、PU-art及PU-real数据集。对于MFPT数据集,少样本适应阶段包含70个故障样本(每种故障类型各35个)和30个正常样本;XJTU-SY数据集仅包含IRF和ORF两类样本,每个类别从不同运行条件下选取50个样本以确保数据多样性;PU-art数据集采用两种配置:(1)包含100个样本且类别分布与MFPT一致的子集;(2)包含180个IRF/ORF样本和70个正常样本的250样本子集;PU-real数据集则使用250个样本,其类别分布与PU-art配置完全一致。
表3 适应性研究(CWRU)的数据集配置:统计处理样本数量与FFT样本数量相同。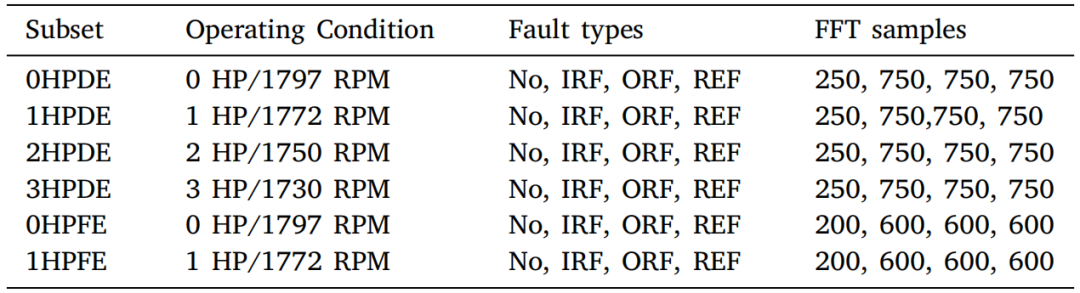
上下文感知频谱语言建模: 该方法的核心在于开发一种故障诊断大型语言模型(FDllm),该模型能够遵循指令并解析故障信号的频谱特征,生成基于文本的响应。与依赖特定模态编码器的方法不同,我们的编码方法保留了振动信号的频谱特性,从而能够生成包含频谱数据及对应观测结果的样本集。在本任务中,仅使用来自所有数据集的频谱样本。
4.2.模型
机器学习算法: 我们采用SVM——一种广泛应用于识别齿轮、滚动轴承等旋转机械部件健康状态的机器学习方法。
深度学习算法: WDCNN(Zhang等人,2017b)经过轻微修改后被采用:首个卷积核的尺寸从64缩至16,步长减至2以匹配我们数据集中的样本长度。1DCNN-SeNet(Xu等人,2024)是另一基准模型,旨在提取关键方位特征并自适应地加权重要通道以辅助故障诊断。
开源大语言模型: 我们选取了四种开源大语言模型——Llama3-8B、Llama3-8B-Instruct、Qwen1.5-7B和Mistral-7B,以构建涵盖不同模型家族的代表性基准。在筛选时,其对时间序列光谱数据的性能尚未明确。Mistral被纳入考量是因为其在零样本场景下的异常检测研究中已展现出显著潜力(Alnegheimish等,2024);而Qwen则因其在工业应用中的日益普及而被选中。此外,还有较小规模的Llama模型可供选择。Llama3.2-1B-Instruct和Llama3.2-3B-Instruct用于评估小型模型相较于大型模型的泛化能力。
4.3.设置
由于机器学习(ML)和深度学习(DL)算法仅能接收数值输入,我们仅在ML模型中使用统计数据,在DL模型中则使用FFT数据。这种选择符合最佳实践,充分发挥了两种方法的优势——尽管两种模型均可处理任一数据集。相比之下,大语言模型(LLM)能够同时整合文本数据与振动数据,包括统计量、编码后的FFT向量或包络谱。
所有实验均在配备NVIDIA A10 GPU的设备上进行,训练周期固定为3个epoch。为实现参数高效的微调,我们采用LoRA优化算法(秩数为8、缩放因子为16),覆盖Transformer模型的所有主要线性层(包括注意力机制和多层感知机(MLP)投影层)。训练时每个设备使用2样本批量大小,并采用两步梯度累积策略;优化算法选用AdamW,配合余弦学习率调度器,初始学习率为 。为提升计算效率,模型训练采用4位量化和混合精度(bfloat16)格式。推理阶段所有模型均以4位量化格式运行,既保持与训练过程的一致性,又显著降低GPU内存占用同时保证诊断准确率。该配置使得单块NVIDIA RTX4090(24GB显存)即可实现近乎实时的推理,在资源受限环境下仍能确保稳定性能。
4.4.评估指标
在分类任务中,我们采用准确率、F1分数、特异性及G均值来量化诊断性能。为评估上下文感知谱建模能力,采用了RAGAS框架(Es等人,2025),该框架可衡量信息保真度、语义相似性及答案正确性。为进一步量化语言质量,我们使用BLEU和Rouge指标,这些指标能够反映生成解释与参考解释之间的n元语法重叠度及结构对齐程度。
除了事实准确性外,我们还采用“LLM-as-a-Judge”范式(Zheng等人,2023)来评估解释的合理性。我们要求Qwen-Max针对每个生成的解释相对于真实值给出一个合理性评分(1–5分),其中1表示完全不可信,5表示高度可信。关于评估过程的更多细节详见附录D。图D.1中的提示指令明确同时考虑语言连贯性和语义一致性,并将temperature参数固定为0.0以确保可重复性,从而强制输出结构化结果。已有研究表明,像GPT-4这样的强效LLM模型能与人类偏好达成超过80%的一致性,其一致性水平与人类自身判断相当(Zheng等人,2023)。我们的方法借鉴了这些研究成果,提供了一种可扩展、可解释且有文献支持的人类评估替代方案——而传统人工评估往往成本高昂且劳动密集。
最后,为确保解释不仅流畅且具有诊断实用性,我们从生成的输出结果中提取故障预测,并采用与上述相同的分类指标对其进行评估。
4.5.结果与讨论
4.5.1.基于分类导向的评估方法
(1)有效性评估
表4展示了所有模型使用来自驱动端的统计处理数据(CWRUst-DE)和FFT处理数据(CWRUfft-DE),以及来自风扇端的CWRUst-FE和CWRUfft-FE所获得的评估结果。
经统计处理后的数据: Llama3和Llama3-instruct在CWRUst-DE数据集上均取得了令人满意的结果,准确率分别为94.80%和95.21%;然而在CWRUst-FE数据集上,两种模型的性能均出现下降,准确率分别降低了约10%和5%。相比之下,Qwen1.5和Mistral在两个数据集上均表现出持续较低的准确率,表明其从统计处理后的输入中诊断故障的能力有限。以SVM为代表的机器学习方法在CWRUst-DE数据集上表现最佳,但在CWRUst-FE数据集上准确率有所下降。
表4 使用CWRU数据集进行有效性评估的结果。
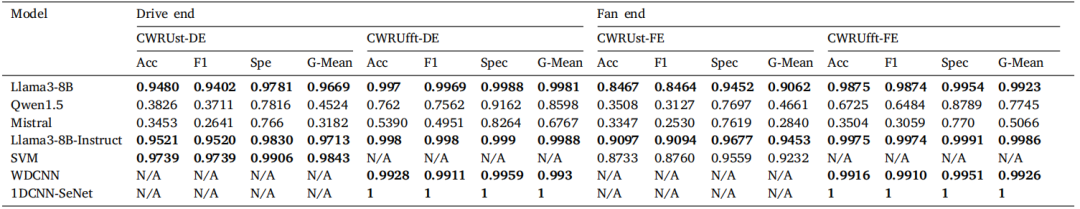
FFT处理后的数据: 在CWRUfft-DE和CWRUfft-FE数据集上评估时,Llama3和Llama3-instruct实现了接近100%的故障诊断准确率;相反,Qwen1.5和Mistral表现持续不佳,进一步凸显了其处理数值数据时的局限性;相比之下,WDCNN和1DCNN-SeNet则取得了具有竞争力的结果。
基于LLama3的模型在统计表示和FFT表示层面均展现出优于其他大语言模型的诊断准确性,其中使用FFT输入时能获得最一致的结果。其卓越性能源于高效的数值分词技术——将数字序列归并为紧凑的分词单元(例如‘‘314,31415’’ → ‘‘314’’, ‘‘’’,‘‘314’’,‘‘15’’)。相比之下,Mistral和Qwen1.5的准确率较低,主要原因是低效的分词方式将数值拆分为多个分词单元(例如‘‘314’’ → ‘‘3’’, ‘‘1’’, ‘‘4’’),这种拆分会增加输入序列长度,从而降低诊断性能。值得注意的是,由于分词器词汇表差异以及对文本指令、空格和数值边界处理方式的不同,Mistral生成的分词单元数量略多于Qwen1.5。
为验证分词效果的差异,我们使用各模型的分词器对0HPDE子集中的80个 FFT 样本(每类20个)进行了词元计数分析,结果汇总于图3(a)。Llama3模型生成的词元数量最少:在 时平均为2248.75,在 时为2468.50;Qwen1.5分别平均为2802( )和5021.5( );Mistral则分别为3294.5( )和5464( )。较低的词元数量与较高的诊断准确率之间存在明显相关性:Llama3系列模型在 时达到完美准确率(100%),在 时准确率为93.52%至94.12%。各类别的G均值评分(图3(b))进一步表明Llama3在所有故障类型中均具有高灵敏度和特异性。Qwen1.5在某些故障类型上表现尚可,但在 时性能下降;而Mistral在正常类别中表现优异,这可能源于正常条件下故障特征较为单一、幅度较小,且经过归一化(如缩放至[0,1]区间)和量化处理后进一步简化,从而减少了词元数量并缓解了Mistral的分词效率问题。
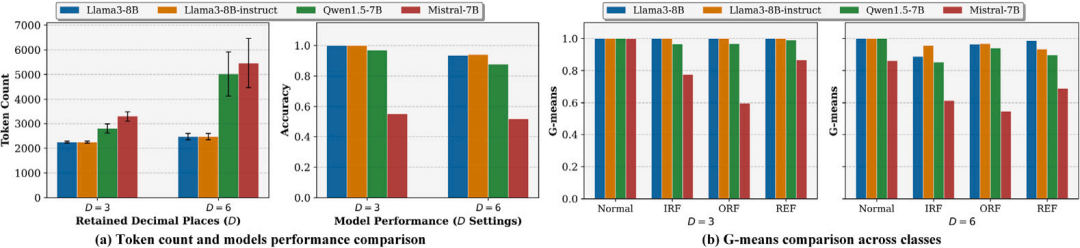
图3. 分词分析
(2)适应性评估
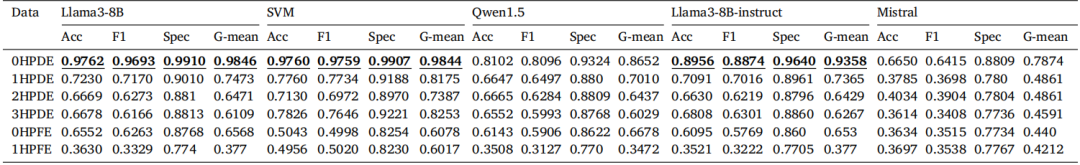
表5和表6分别展示了所有模型使用统计数据与FFT处理数据得出的评估结果。
经统计处理的数据: 如表5所示,评估结果表明所测试模型在不同目标领域中均表现出较低的适应性。这很可能源于统计表示方法的本质——其仅能捕捉振动信号的整体特性,而可能忽略对适应不同运行条件至关重要的细微变化或局部模式。因此,评估结果表明统计表示方法并未提升大语言模型的泛化能力。
表5 基于统计处理数据的模型适应性评估结果
FFT处理数据:表6汇总了FFT数据的评估结果。Llama模型展现出强大的泛化能力,能够适应未见过的操作场景并保持高性能表现。值得注意的是,较小规模的变体(Llama3.2-1B-Instruct和Llama3.2-Instruct)取得了与大型模型相当的结果,表明紧凑架构在经过适当微调后能有效捕捉特征谱模式。相比之下,Qwen1.5在多样化场景下的性能显著下降,而Mistral则持续表现欠佳;WDCNN和IDCNN-SENet虽取得竞争力结果但适应性有限(这与非大语言模型基线的表现预期一致)。跨组件评估(如0HPFE和1HPFE)显示所有模型均出现明显性能下滑,凸显其因领域变化导致对新机械部件的泛化能力较差。
表6 基于FFT处理数据的模型适应性评估结果
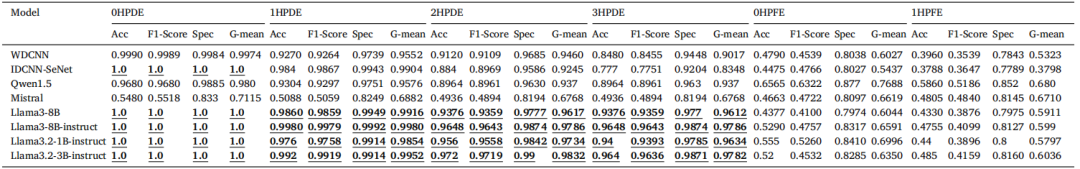
图4提供了更深入的分析结果,展示了大语言模型(LLM)的各类故障G均值分布。鉴于不同Llama变体表现相近,本文仅报告规模较大的模型数据。在跨条件评估中,两种Llama模型均能以高分识别所有故障类型,表明其对同一组件下不同负载和运行速度条件具有强泛化能力。Qwen1.5-7B表现出竞争力较强的诊断性能;但随着领域差异增大,其各故障类别的诊断表现趋于失衡。相比之下,Mistral-7B在驱动端的适应性明显较差:尽管能稳定识别正常状态,其各故障类别的G均值常低于0.60。在跨组件评估中,所有模型性能均显著下降,反映出明显的领域偏移现象——Llama模型对正常状态仍保持完美识别能力,但在故障类别(尤其是REF类,G均值小于0.25)上表现不佳;Qwen的IRF检测能力中等(约0.75–0.83),但在ORF和REF类上的表现欠佳;而Mistral在所有故障类别上均取得均衡但一般的诊断效果(约0.48–0.59)。这些结果表明,组件几何形状和转速的差异会导致光谱故障特征出现显著偏差,从而引起所有模型诊断性能的明显下降。
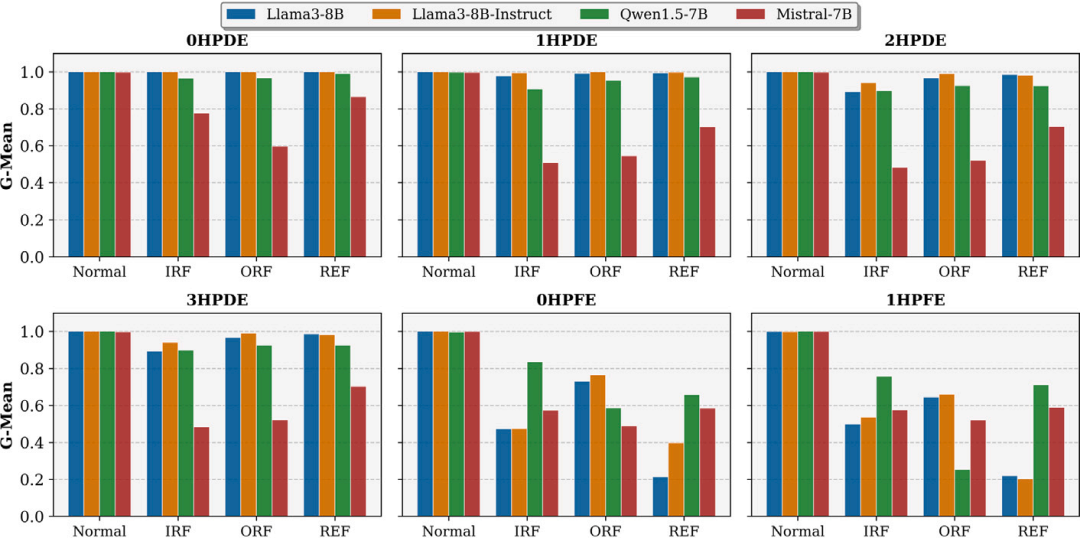
图4. 不同大语言模型在不同运行条件及跨组件迁移设置下的各类别G-means性能表现。
(3)稳健性评估
图5展示了该模型在0HPDE子集上针对高斯噪声、布朗噪声、拉普拉斯噪声及紫噪声(信噪比范围为–9 dB至9 dB)的鲁棒性评估结果。
该模型在所有噪声类型和信噪比水平下均保持高度稳健性。在布朗噪声条件下,模型在所有信噪比下均实现完美精度,表明其对低频失真具有强抗干扰能力;在高斯噪声和拉普拉斯噪声中,性能随信噪比增加而稳步提升,从0dB起即可达到完全精度。紫噪声在低信噪比下会导致性能显著下降(–9dB时为65%),这很可能源于其高频干扰效应,但模型能快速恢复,在3dB起即实现100%精度。这些结果充分证明该模型能在多种噪声环境下保持稳定性能。值得注意的是,在中高信噪比范围内模型能迅速收敛至完美精度,凸显了其出色的鲁棒性及在噪声环境中的实际应用潜力(详见表7)。
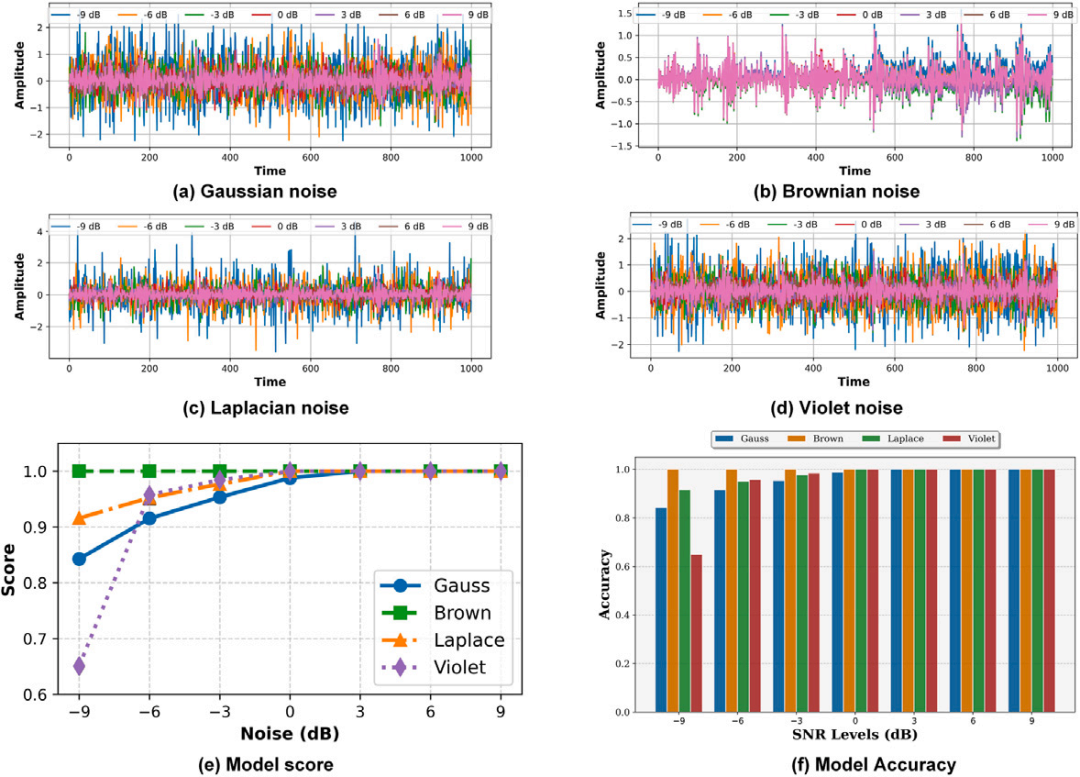
图5. Llama3-8B-instruct在含模拟噪声的0HPDE子集下的鲁棒性评估。
表7 在不同信噪比(SNR)水平及不同噪声类型下,数据集0HPDE的性能指标。
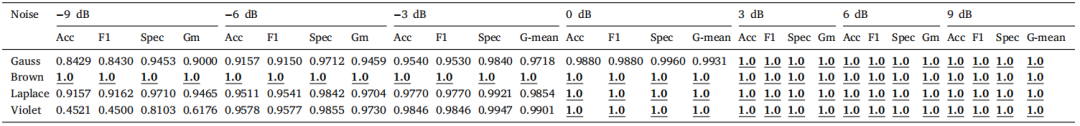
表8汇总了Llama3-8B-instruct模型在所有数据集上使用FFT和频谱样本时的性能表现。在FFT表示框架下,该模型在大多数场景中均展现出稳健的诊断性能。该方法在PU-art和PU-real数据集上的效果有限;相比之下,包络谱输入能显著提升所有数据集的性能表现,尤其在PU-art和PU-real数据集上效果尤为明显。然而对于PU-real数据集而言仍存在挑战:在不同运行条件下,内外层故障频率高度接近,加之电源谐波干扰的影响,使得准确分类变得复杂。
表8 使用FFT和光谱样本对所有数据集进行Llama3-8B-instruct模型评估的结果。
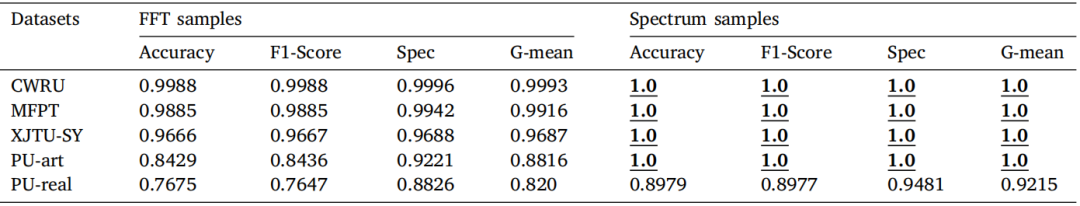
此外,为更好地理解我们的研究结果,我们将FD-LLM与DiagLLM(Wang等人,2025)进行对比——后者是一种基于大语言模型的新方法,采用多模态模型(Qwen2-VL-7B)并以光谱图像作为输入。DiagLLM在XJTU-SY数据集上的准确率达到98.44%,在PU-art和PU-real两个子集的综合测试中达到88.51%;但其实验均在相对有限的数据条件下进行。相比之下,我们的模型是在多个公开可用的数据集上训练和评估的,展现出更优的泛化能力。该模型在使用 FFT 和频谱表示两种方式时均展现出相当或更高的诊断准确率,在 XJTU -SY和PU-art数据集上达到100%准确率,在PU-real数据集上达到89.79%准确率。与依赖视觉编码器和多模态融合的DiagLLM不同,FD-LLM通过基于字符串的分词技术将频谱数据直接编码为文本形式。这种设计既保留了谐波、边带等关键频域特征,又为大语言模型提供了更自然的输入格式,使其能够直接以文本序列形式处理频谱信息。
(4)基于少样本学习的泛化能力评估
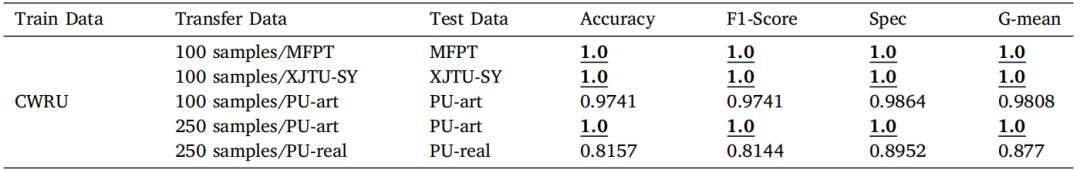
为评估Llama3-8B-instruct模型在少样本学习场景下的泛化能力,我们在CWRU数据集上训练该模型,并经过少样本学习阶段后,在MFPT、XJTU-SY、PU-art和PU-real数据集上进行测试。如表9所示,尽管每个数据集仅提供100个样本,该模型仍能在大多数数据集上展现出强大的泛化能力。然而,在PU-real数据集上的评估结果表明,由于该数据集包含复杂且重叠的故障模式,模型表现存在挑战。总体而言,虽然通过少样本学习可以有效缓解对大量标注数据的依赖需求,但这种优势在将知识从简单数据分布迁移至更复杂数据分布时可能受到限制。
表9 利用少样本学习的频谱样本对Llama3-8B-instruct模型进行泛化能力评估。
4.5.2.上下文感知频谱语言建模评估:
对Llama3-8B-Instruct模型进行微调以开发故障检测能力。该诊断语言模型被称为FDllm。对其评估涵盖四个互补维度:(i)利用RAGAS指标衡量与语谱上下文的事实一致性;(ii)通过BLEU和Ro-uge分数评估解释质量;(iii)遵循“LLM-as-a-Judge”范式进行合理性验证;(iv)故障预测的分类准确率。这一多维度框架共同验证了FDllm的诊断可靠性和可解释性。
表10汇总了实验结果。FDllm在RAGAS任务中实现了95.7%的保真度评分,表明生成的回答与底层光谱证据具有高度事实一致性。较高的语义相似度(95.1%)和回答正确率(94.0%)进一步证实FDllm能准确捕捉光谱特征,且未引入虚假或无关内容。
表10 FDllm在谱系建模任务中的评估结果。评估指标涵盖事实一致性、文本生成质量、合理性及分类性能。
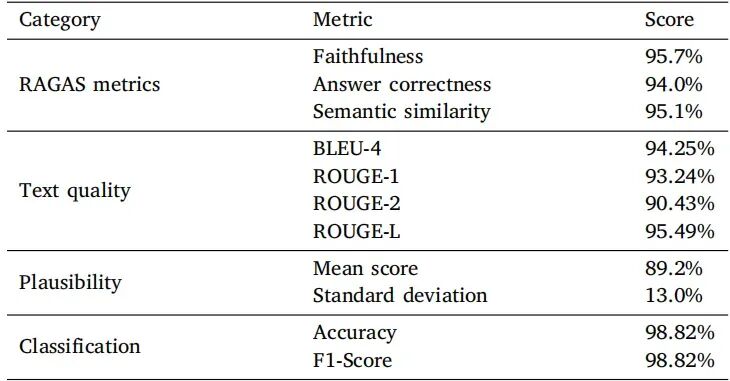
此外,该模型生成的解释与参考文本之间表现出高度一致性,这体现在较高的BLEU分数和Rouge分数上,这些指标均反映了强大的语义连贯性和语言质量。
为评估合理性,由独立的基于大语言模型(LLM)的评审专家对生成的解释进行了语言连贯性和领域合理性评估。FDllm获得平均合理性得分为89.2%,标准差为0.130,表明大多数解释在技术层面具有连贯性且在语境上站得住脚。
在诊断性能方面,FDllm实现了98.82%的准确率和F1值,证实了其将光谱模式与相应故障状态有效关联的强大能力。
FDllm采用的谱-语言建模方法能够提供可解释且基于上下文的故障诊断结果,这正是工业维护领域的关键需求——工程师需要透明的预测与推理依据。与传统深度学习(DL)方法(Li 等,2023; Brito 等,2023)虽能实现高精度但因表示方式不透明而缺乏可解释性不同,FDllm利用语言建模生成人类可读的解释说明。这些解释明确将谐波、边带及特征峰等频谱特征与特定故障类型(如内圈缺陷、外圈缺陷及滚动体缺陷)关联起来,提供清晰的因果关系解析。相比之下,梯度加权类激活映射(Grad-CAM)和夏普利加性解释(Shap)等事后可解释人工智能(XAI)技术仅生成抽象的显著性图,需深厚的专业知识支撑,且鲜少提供直接的机制理解。通过 RAGAS 指标、BLEU/rouge分数以及LLM-as-a-Judge框架进行定量评估证实,FDllm的解释既与频谱证据事实相符,又具有语义连贯性。通过融合分类与推理功能,FDllm提升了系统透明度、增强了操作人员信任度并优化了决策支持能力,使维护人员能够将诊断结论追溯至可解释的频谱特征。此外,其基于大语言模型(LLM)的推理机制能够实现跨不同组件和运行条件的灵活适配,有效克服传统 XAI 方法存在的任务特定局限性。未来研究可通过开发更多样化的多模态数据集并优化模型效率,进一步提升解释的丰富性,以满足更广泛的工业应用场景需求。
为实现信号加载、预处理及频谱提取的自动化,并支持交互式诊断对话,FDllm被部署在基于代理的框架中。图6展示了两个代表性的示例,演示了FDllm的诊断性能:第一个示例呈现了对应外圈故障的简单频谱,仅观测到80Hz处的外圈故障频率及其谐波;第二个示例则展示了118Hz处内圈故障的复杂频谱,包含旋转频率、内圈故障频率、其谐波以及相关边带信号。
在第一个频谱中,主故障频率出现在80Hz处,振幅为192。然而,FDllm识别出附近一个位于81.12Hz、振幅为39的峰值,这与理论上的外圈故障频率一致。尽管存在这一差异,FDllm仍能准确解析与故障相关的谐波模式,并精确判断轴承健康状况。在第二个案例中,FDllm成功解析了该频谱:识别出主故障频率为118Hz,边带频率分别为93Hz和143Hz,谐波频率分别为236Hz和354Hz。系统恰当地忽略了旋转频率,因其对诊断结果无贡献。在这两种情况下,FDllm均提供了正确且可靠的故障诊断结果。
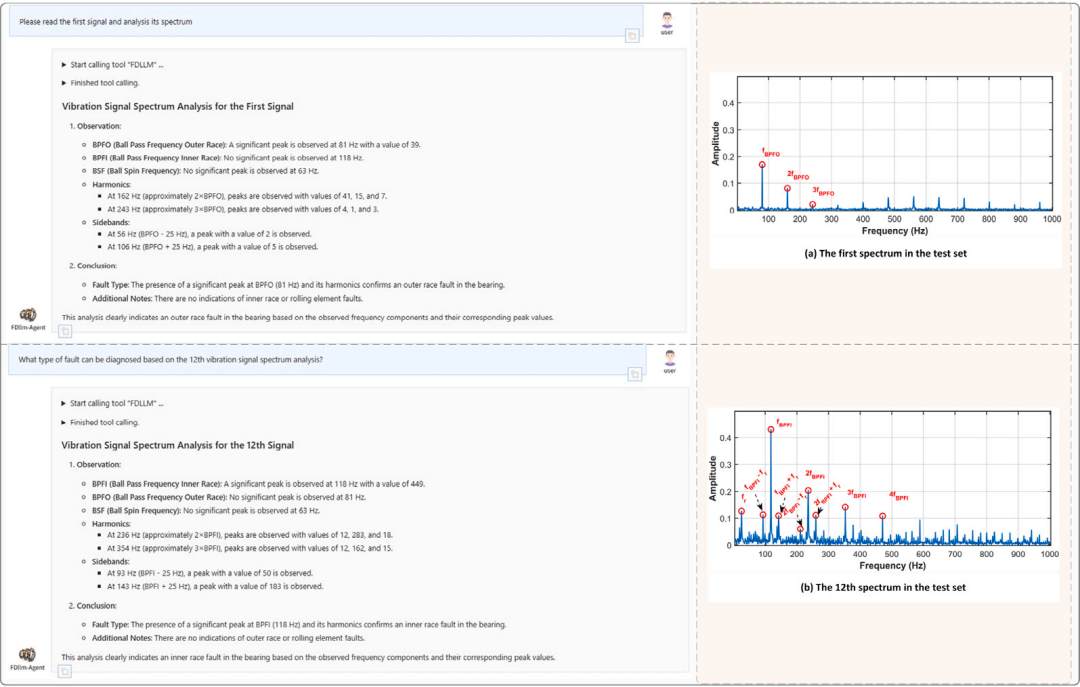 图6.使用外圈和内圈故障信号的示例
5.结论
本研究提出了FD-LLM这一创新框架,该框架通过两种训练范式(仅分类范式与频谱-语言建模范式)将振动信号与大语言模型(LLMs)相结合用于故障诊断。结果表明,当结合FFT和频谱表示时,LLMs在基于振动的故障诊断中具有显著优势。研究结果从三个维度展开讨论:有效性与适应性、鲁棒性与泛化能力以及可解释性。
有效性与适应性。 基于Llama3的模型在性能上优于Qwen1.5和Mistral等竞争对手,这得益于其高效的数值分词技术能够保留频谱信息;而竞争模型中的过度分词则会降低性能。虽然FFT表示有助于增强域内知识迁移能力,但由于传感器位置和机械结构存在差异,跨组件泛化仍面临挑战。未来研究可探索采用更大的上下文窗口以解决Mistral和Qwen等模型存在的数据碎片问题,并整合双重表示(如统计表示与FFT表示)以提升模型的适应性。
鲁棒性与少样本泛化能力。 Llama3-8B-instruct模型在低信噪比条件下仍能保持稳健性能,并在多种数据集上展现出强大的少样本泛化能力。该模型仅需少量标注数据即可实现高准确率,显著降低了对大型标注数据集的依赖。
可解释性。 谱-语言建模技术使FDllm能够将复杂的振动数据转化为可解读且语义丰富的诊断报告。然而,有限的多模态数据集限制了深度诊断交互功能,因此需要借助基于外部知识库的检索增强生成(RAG)技术。尽管模型参数量高达8B,但采用4位FB16量化方案可在单块RTX4090 GPU上实现高效部署和近乎实时的推理。未来研究可重点开发基于模拟频谱信号构建的多样化问答对齐数据集,以提升跨设备领域的交互能力和泛化性能;此外,优化策略还能提升模型在资源受限工业环境中的扩展性和部署效率。