为什么你用AI检索文献/写论文总在编造?
为什么你的 AI 写论文总在编造参考文献?因为你少了一个关键步骤
让 AI 帮你写论文引言,它给你列了 5 篇参考文献,格式工整、DOI 齐全、作者和期刊都对得上。你兴冲冲提交给导师,结果导师随手一查——3 篇压根不存在,1 篇作者对不上,剩下那篇标题是 AI 自己编的。
你说你冤不冤。
你明明花了很多时间去调 Prompt,让它「严格按照学术规范」、「确保参考文献真实可查」。但它还是编,而且编得越来越像真的。
这就不是 Prompt 的问题了。
问题出在根上:大多数 AI 学术工具的设计思路就是错的。它们把「写论文」当成「生成文本」——你给我一个主题,我给你一篇文章。至于中间引用的文献存不存在、论证过程有没有依据、写出来的东西读起来像不像人写的,它们不关心,或者假装关心但其实没能力解决。
核心观点:好的学术 AI 工具不应该替代研究者的判断。它应该做的是让检索更系统、让筛选有评分依据、让 PDF 下载不用一篇篇手动点、让文献库跟大纲对齐、让写作基于真实的论文内容而不是模型记忆、让润色有章可循有迹可查。
这几天我开发了一款开源工具,叫 More Paper Workflow Pro Skill,它跟其他 AI 学术工具最大的区别——它不做「一键生成论文」这种事。
做的事是按传统科研步骤,一步一步辅助你走完。每一步你都看得见产出文件,每一步你都可以确认和修改,每一条参考文献都来自你真实拥有的 PDF。
More Paper Workflow Pro Skill | v1.0.2 | MIT License
GitHub: github.com/bingyunjiang/More-paper-workflow-pro-skill
01|传统科研 8 步走,每一步都看得见
你有没有想过,正经做学术研究的流程其实是很清晰的:定研究方向 → 搭大纲 → 搜文献 → 筛文献 → 下载 PDF → 整理进文献库 → 写作 → 修改润色。这个流程不是谁拍脑袋定的,是学术共同体磨合出来的最佳实践。
那为什么到了 AI 工具这里,就变成了「输入主题 → 输出论文」的黑箱?
More Paper Workflow 的思路很简单:AI 应该辅助传统流程的每一步,而不是替代它。
①定题→②大纲+关键词→③检索方案→④检索+评分→⑤PDF下载→⑥Zotero管理→⑦论文写作→⑧论文润色
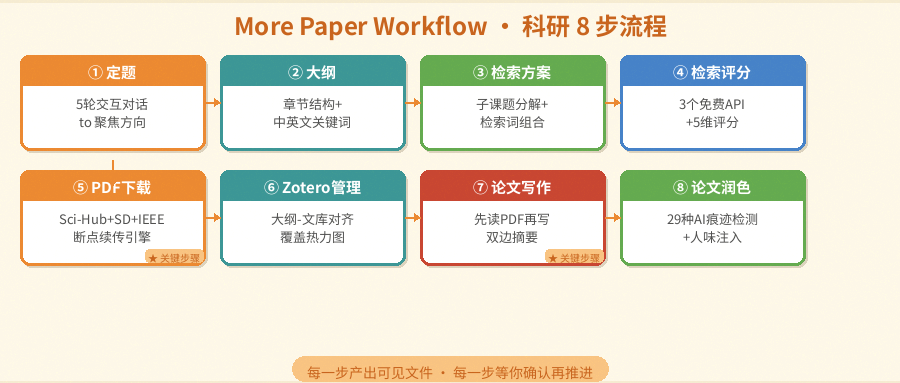
More Paper Workflow · 科研 8 步流程
整个学术工作流拆成 8 个步骤,每一步有独立的输入和产出:
① 定题
— 5 轮交互对话帮你聚焦研究方向
② 大纲+关键词
— 章节结构 + 中英文关键词,五维度质量门评分
③ 检索方案
— 子课题分解 + 检索词组合策略
④ 多渠道检索+评分
— 3 个免费 API + 五维度文献评分
⑤ PDF 文献下载
— Sci-Hub + ScienceDirect + IEEE 三轮自动下载,断点续传 ⭐
⑥ Zotero 文库管理
— 大纲-文库对齐,可视化覆盖热力图
⑦ 论文写作
— 先读 PDF 文献再写
⑧ 论文润色
— 29 种 AI 痕迹检测 + 句长波动分析 + 人味注入
📋 每一步都落盘为可见文件:定题产出 research-topic.md,检索产出 literature-table.md(带评分),下载产出 download-record.md,大纲评审产出 .docx 修订版。你可以随时中断、检查、修改任何一步的产出,再继续下一步。不是黑箱,是透明的管线。
交互确认贯穿全流程
随便举几个例子:
第 1 步
不是你输入一个关键词它就帮你定了,而是 5 轮结构化对话,从「你感兴趣的大方向是什么」开始,一轮一轮收敛到具体的研究问题、方法论、应用场景。
第 2b 步
做完大纲后有一个质量门:系统用逻辑连贯性、结构平衡性、创新区分度、工程可行性、格式完备性五个维度给你打分,但怎么改由你决定。
第 6c 步
改完大纲,系统自动诊断 Zotero 里每一篇文献跟新大纲各章节的对应关系——哪些有支撑、哪些有缺口、哪些没用上。移动文献前必须你逐条确认。
第 7 步
写作之前,系统先把本章计划引用的文献列出来给你看——每篇的核心贡献是什么、计划在哪个论点下引用。你确认了,AI 才开始写。
02|参考文献全是真实存在的——因为 AI 先读 PDF 再写
这是我觉得这个工具最硬核的地方。
很多 AI 写作工具也宣称「支持参考文献」,但它们怎么做的?RAG——检索增强生成。把 PDF 切成几百个小块,向量化存进数据库,写作时检索相关片段塞进 Prompt。
⚠️ RAG 的致命问题:切片丢失上下文。模型看到的不是「Smith et al. (2023) 提出了一个基于 GNN 的故障诊断框架,在 CWRU 数据集上达到 99.2% 准确率」,而是三个不连续的向量片段。结果就是:看起来很完美的参考文献列表,DOI 查不到,标题是编的,有时候连期刊名称都不存在。
More Paper Workflow 的做法简单直接:不切片,直接读全文。
通过 PyMuPDF 批量提取 PDF 的完整文本,写作时 AI 看到的是整篇论文的完整内容——摘要、方法、实验、结论,一个不落。这不是什么新技术,但多数 AI 写作工具不用,因为 RAG 是他们的卖点,而且读全文比切片「费 token」。但学术写作这件事,准确性比省 token 重要得多。
更关键的是工作流层面的硬约束。第 7 步有一条铁律:
「未出现在文献检索表或未读取过 PDF 的文献,不得引用。」
这不是 Prompt 里的「建议」,是工作流层面你绕不过去的规则。具体怎么执行的?写每章之前,系统先从 Zotero 对应的分类下读取该章节关联的所有 PDF,提取每篇的核心论点,列出引用清单。你在清单里勾选篇目、确认引用位置,然后 AI 基于你勾选的真实内容撰写这一节。
AI 在这里的角色是「读了你指定的文献,帮你组织论证」,不是「凭记忆帮你找文献」。找文献是你和第 4 步检索做的事,写论文是第 7 步做的事,两件事分开,各自有各自的产出和校验。
03|AI 写的论文一眼就能看出来?29 种模式帮你排查 AI 味
除了编造参考文献,AI 写出来的东西还有一个很头疼的问题:一眼就能看出是 AI 写的。
你肯定见过这些症状:
「值得注意的是……」——每段开头都是这个,全文出现 8 次
「不仅……而且……」——一篇论文用了 20 次二元对比结构
连续 5 句话长度几乎一样,读起来像节拍器,困得要死
「该研究具有重要意义」——什么意义?后面什么都不说
「在一定程度上」「某种意义上」——每隔一段出现一次,全是没信息量的限定词
Em Dash 满天飞,一段 3 个「——」,而且用法完全一样
这些不是写作风格问题,是AI 生成文本的统计特征。问题在于,多数润色工具只做表面替换——把「值得注意的是」改成「值得关注的是」,意义不大,AI 味还是在。
More Paper Workflow 的润色引擎分 4 级:
Level 1-2:常规的语法清理和结构优化,很多工具都能做。
Level 3:29 种 AI 写作模式系统检测
这 29 种模式分成 5 个大类:
内容类
:过度强调重要性(但没有具体论证)、空洞的 -ing 结尾分析、声称「该领域存在空白」但不说明是什么空白
语言语法类
:AI 高频词(delve、underscore、crucial、moreover……)、被动语态连续堆砌
风格类
:Em Dash 滥用、二元对比过量、段落首句模板化
交流类
:伪协作式交际痕迹(「as we can see」「let us consider」)
填充与模糊类
:没信息量的限定词和过渡句,删掉不影响理解的那种
每种模式都有具体的检测规则和修改策略,不是通用 Prompt 那种「让文字更自然」,而是「这段话同时触发了 P1、P7、P12,这 3 个地方需要注意」。
Level 4:注入人味
这个层次最有意思。它不是让你换个写法,而是从节奏、观点、语气三个维度系统性地把「人味」加回去。
节奏上
,做句长波动分析——连续 5 句话长度差在 ±3 词以内,标记为 AI 节奏。目标句长波动方差 ≥0.35。引言和结论部分方差目标≤0.25,因为短句子有冲击力。
观点上
,要求你「有立场」。不是「前人做了 A,前人做了 B,前人做了 C」这种文献流水账,而是「A 方法虽然有效,但它有一个前提假设在实际场景中往往不成立,所以本文选了 B 路线」。
语气上
,允许你「承认复杂性」。真实的研究者不会说「我们全面解决了该问题」,而是「这个问题目前没有完美方案」「我们选择的方法有一个已知局限」。
✅ 改完不是黑箱输出。润色结果以三栏表呈现:修改前 → 修改后 → 修改原因。每一处改动你都看得见,你可以接受、拒绝、或者修改任何一条建议。你在控制润色的方向,不是在验收 AI 的「作品」。
04|和其他 AI 学术工具比,到底差在哪?
讲完功能,我想从设计哲学的层面做一个对比。
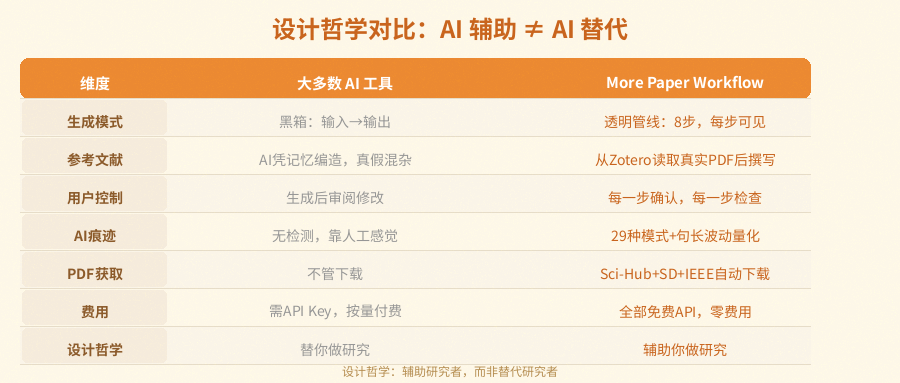
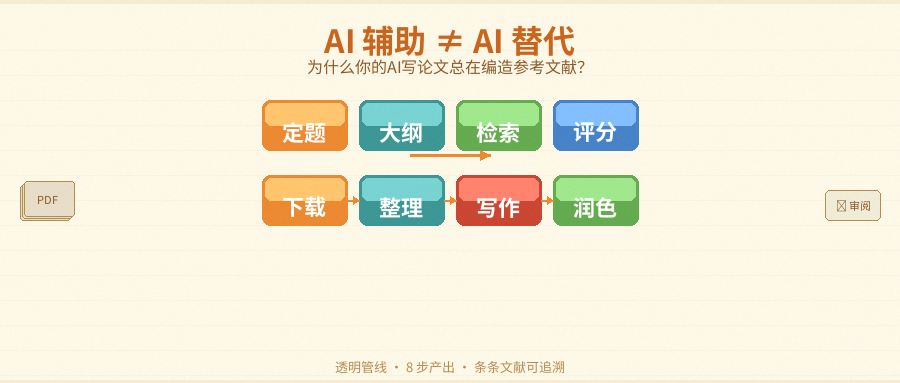
设计哲学对比:AI 辅助 ≠ AI 替代
关于 PDF 下载多补充一句:Elsevier 和 IEEE 全线部署了 Cloudflare 和 Akamai 反爬系统。这个工具用 Chrome DevTools Protocol 启动真实浏览器,模拟人类操作——维护 Cookie、带正确的 Referrer 头、等待 JavaScript 渲染完成后捕获 PDF 流。实测 94 篇 ScienceDirect 论文下载成功 89 篇,成功率 94.7%,IEEE 6 篇全过。
一句话总结差异:其他工具想帮你「写论文」,这个工具想帮你「做研究」。
05|适合谁?不适合谁?
写到这里我必须诚实地说:这个工具不是给所有人的。
✅ 如果你是这样的研究者,你会很喜欢它:
被 AI 编造参考文献坑过,对「一键生成论文」有阴影了
希望用 AI 提效,但不是让 AI 替你做决定,你始终要掌握控制权
正在写综述、毕业论文、或课题申报书,需要系统管理 50~200+ 篇参考文献
有 Elsevier 或 IEEE 的机构访问权限(学校 VPN 就行)
已经在用 Zotero,但手动整理文献库真的太累了
❌ 但如果你属于下面几种情况,它可能不太适合你:
「输入标题,3 分钟出一篇论文」是你的核心需求——这个工具刻意不做这种事
没有机构访问权限,同时又需要 2021 年之后的论文
写在最后
回到标题那个问题:为什么你的 AI 写论文总在编造参考文献?
因为你少了一个关键步骤:让 AI 先读文献再写,而不是凭参数里记住的碎片去猜。
这个步骤看起来多了一层工作,但它是区分「AI 替你写论文」和「AI 辅助你做研究」的核心分界线。
这个工具是 开源的,MIT 协议,GitHub 可以直接看源码。如果你被 AI 编参考文献坑过,或者单纯觉得手动管理文献太消耗精力了,下一次写论文可以试试这个工作流——看看和「打开 ChatGPT 直接让它写」有什么本质区别。
评论区聊聊 你用 AI 写论文时踩过最大的坑是什么?
More Paper Workflow Pro Skill | v1.0.2 | MIT License
GitHub: github.com/bingyunjiang/More-paper-workflow-pro-skill