一区论文学习 | FCLLM-DT:利用大型语言模型赋能基于数字孪生的工业物联网联邦持续学习
本期推荐论文提出了一种面向工业物联网轴承故障诊断的创新方案——FCLLM-DT,通过融合数字孪生(DT)、检索增强生成(RAG)辅助的大语言模型(LLM) 与联邦持续学习(FCL),系统性地解决了传感器数据异常、故障期间数据缺失以及跨工厂协作中的隐私保护三大关键问题。其中,DT结合动态强盗树(DBT)对异常数据进行物理建模与修复,RAG-LLM在传感器失效时生成高质量虚拟数据以保障训练连续性,FCL则在保护本地数据隐私的同时实现多工厂模型的协同优化与持续学习。实验表明,该方法在数据修复相似度、生成数据质量与故障诊断准确率上均显著优于CNN、FedAvg等现有方法,为分布式工业智能维护提供了高鲁棒、高精度且隐私安全的解决方案。
论文基本信息
论文题目:FCLLM-DT: Enpowering Federated Continual Learning With Large Language Models for Digital-Twin-Based Industrial IoT
论文日期:2025
论文链接:
10.1109/JIOT.2024.3510553
作者:
Yingjie Xia ,Yuhan Chen , Yunxiao Zhao, Li Kuang , Xuejiao Liu ,Ji Hu , and Zhiquan Liu
作者信息(来自IEEE):
Yingjie Xia is with the Micro-Electronics Research Institute, Hangzhou Dianzi University, Hangzhou 310005, China, also with the College of Computer Science and Technology, Zhejiang University, Hangzhou 310027, China, and also with Research and Development Department of Hangzhou Yuantiao Technology Company, Hangzhou 311121, China.
Yuhan Chen is with the College of Computer Science and Engineering and the College of Software, Guangxi Normal University, Guilin 541000, Guangxi, China.
Yunxiao Zhao and Xuejiao Liu are with the School of Information Science and Technology, Hangzhou Normal University, Hangzhou 311121, China.
Li Kuang is with the School of Computer Science and Engineering, Central South University, Changsha 410083, Hunan, China (e-mail: kuangli@csu.edu.cn).
Ji Hu is with the School of Electronics and Information Engineering, Hangzhou Dianzi University, Hangzhou 310005, China.
Zhiquan Liu is with the College of Cyber Security, Jinan University, Guangzhou 510632, China.
目录
摘要
I. 引言
II. 相关工作
A. 用于数据异常校正的数字孪生
B. RAG增强型LLM数据生成
C. 工业物联网中的联邦持续学习
III. 系统模型IV. 提出的方案
A. 基于数字孪生的异常数据修复
B. 基于RAG技术的LLM虚拟数据生成系统
C. 用于轴承故障诊断的联邦式持续学习方法
V. 性能评估B. 基线与我们的模型
C. 评估指标
D. DT修复异常数据的准确性
E. RAG辅助LLM生成数据的准确性
F. 基于FCL 的轴承故障诊断准确性
VI. 结论与未来工作
摘要
工业物联网(IIoT)是一项先进的技术,旨在提升工业环境中的生产管理能力并实现产量预测,包括机械设备故障诊断。故障诊断的准确性取决于诊断模型的训练效果及其与其他工业设施模型的互操作性。然而,在维护这些诊断模型的过程中仍存在若干关键挑战:1)机械设备传感器可能产生异常数据,导致模型训练质量欠佳;2)传感器故障可能导致连续数据流中断,从而阻碍模型训练;此外,与其他工厂协作以提升模型性能可能引发隐私泄露风险。本研究提出了FCLLM-DT方案,该方案整合数字孪生(DT)技术构建轴承物理模型,用于修正异常传感器数据。同时,采用检索增强生成(RAG)技术辅助的大语言模型(LLM)可在传感器故障场景下生成虚拟数据集。针对分布式工业环境中的工业物联网应用,本方案采用联邦持续学习(FCL)技术,通过整合来自不同设施的本地化模型来优化全局模型训练,从而提升轴承故障诊断精度并保护数据隐私。我们在两个数据集上对数字孪生异常数据修正精度、RAG辅助LLM虚拟数据生成能力以及FCL在轴承故障诊断方面的表现进行了实验,并与三种替代方法进行了对比。结果表明,本方案在各项性能指标上均优于现有方法。用于检测数据质量及轴承故障诊断的准确性。
关键词:数字孪生(DTs)、联邦持续学习(FCL)、大型语言模型(LLM)、机械故障诊断、检索增强生成(RAG)
I. 引言
随着工业物联网(IIoT)的不断发展,越来越多针对工业场景的复杂应用正在开发中,这些应用利用嵌入在机械设备和组件中的传感器所采集的数据。因此,通过传感器进行数据收集至关重要;数据中的任何异常——无论是由机械部件故障还是传感器故障引起——都可能严重影响这些应用的准确性和可行性。
近年来,基于深度学习框架的故障检测方法因其卓越的故障识别能力而得到广泛应用[2] ,[34]。对于规模庞大且地理分布分散的企业,可以通过汇总多个工厂的数据,并利用专用边缘服务器和中央服务器[8]进行分析来实施联邦学习(FL),从而提升故障诊断能力。Chandrasekhar等[12] 研究人员提出了一种基于高斯过程(GPs)的结构健康监测(SHM)方法,该方法充分利用了风力涡轮机叶片在结构特性上基本一致 、且均受相同环境与运行变量(EOVs)影响的特点。该方法通过分析其他叶片的边缘频率来预测特定叶片的故障状态。此外,为解决传感器故障导致的数据丢失问题,生成对抗网络(GANs)可通过数据生成与对抗学习机制自适应地填补缺失数据[3] ,[13]。Xu等人[22] 提出了一种方法,该方法结合旧条件下的模拟数据与真实数据来训练GAN模型,从而使在新条件下生成的数据能够高度模拟真实数据。
然而,在维护这些诊断模型的过程中仍存在若干挑战:
1)机械传感器可能生成异常数据,导致模型训练质量欠佳;2)在训练过程中无法快速、持续地提供数据,可能导致模型训练失败;3)为优化模型性能,各工厂通过整合其本地模型形成全局模型,开展协同合作。然而,该方法可能引发针对模型及底层数据的隐私泄露风险。
与GAN框架相比,结合大型语言模型(LLM) 的检索增强生成(RAG)在需要整合大量外部知识和最新信息的任务中更具优势。这是因为RAG适用于处理复杂且高度互联的数据集,并能深入探索数据集内部的深层关系。特别是在多层分析与推理方面,它能显著提升LLM对问题的理解能力及答案的 准确性[35] 。通过利用数字孪生(DT)和RAG辅助的LLM来修正和生成感知数据,机器学习模型可被训练用于工业场景中的生产维护与输出预测,例如机械故障诊断模型。对于拥有地理分布式工厂的企业,每个本地模型均基于本地收集和生成的数据进行训练。这些区域模型可通过交互协作整合为全局模型,并通过跨工厂的知识共享得到丰富。为有效利用这些本地模型,可采用联邦持续学习(FCL)[14][15] 该方法通过整合联邦学习(FL)[16]与持续学习(CL)[17]的原理实现。联邦学习能够在无需交换原始数据的情况下,促进去中心化设备间的协同模型训练;而持续学习则使模型能够逐步适应新数据或任务, 同时不会遗忘先前学到的信息。 FCL 技术支持在本地化数据上对故障诊断模型进行增量训练,使其能够在多个制造站点间进行数据聚合,同时保护数据隐私。然而,仍存在若干挑战,包括训练数据输入需要具备稳定性[10] , 以及需要开发出针对隐私侵犯攻击的稳健防御机制[9]。
基于上述挑战与问题,本文提出了适用于分布式工业物联网系统的FCLLM-DT方案,该方案为修复异常数据、管理传感器故障以及提升数据隐私保护能力(涵盖角速度、最大速度、运行时间、运行环境、轴承类型等工厂输出数据及其他数据)的故障诊断提供了全面解决方案。作为提升传感数据质量的核心环节,该方案整合了DT技术以模拟物理模型来修正异常传感器数据,并利用RAG技术特性处理复杂且高度互联的数据集,从而深入挖掘数据集内部的关联关系。通过调用大语言模型(LLM),可获取大量精准生成的数据,确保数据输入的准确性;基于DT优化后的数据流输出,该方案采用 FCL 技术构建全局故障诊断模型,同时有效保护本地数据隐私。
在FCLLM-DT中识别和修正异常传感器数据的概念,可扩展应用于电机[39] 、风扇叶片[40]及变速箱的故障检测系统——这些系统均通过各类传感器采集时间序列数据。现有研究大多基于异常数据分析故障类型与成因,却常忽视传感器故障导致误判的预防问题。我们的方法填补了这一空白。在电机故障检测中,核心关注点是电动机振动传感器采集的时间序列数据,需追踪三轴(轴向、径向及径向×轴向)变化;而在风扇叶片故障检测中,运行过程中的振动、噪声及涡轮参数是关键监测指标。FCLLM-DT所采用的DT原理可应用于这些领域,通过运用专为处理传感器故障而设计的 FCL 与DT算法,确保即使传感器发生故障,局部模型仍能持续训练并有效检测故障。这使得FCLLM-DT特别适用于轴承的鲁棒性故障检测。该方案的主要贡献如下:
1)通过将物理轴承模型与动态强盗树(DBT)相结合 ,一种专门用于修正异常传感的DT技术应运而生。该方法能主动提升传感数据的保真度,从而优化其在局部模型训练中的适用性。
2)本文提出了一种基于区域特异性RAG辅助的大语言模型(LLM)用于生成虚拟数据,该方法利用历史传感器数据构建RAG系统。此方案可在传感器发生故障时,确保持续提供传感数据流以支持连续学习(CL)。
3)FCLLM-DT方案整合了数据优化(DT)、RAG辅助的大语言模型(LLM)及 FCL 技术。该方案基于DT与RAG辅助LLM对数据的优化处理,采用FCL 技术以促进高精度故障诊断模型的开发, 同时确保分布式工厂中本地数据隐私的安全性。
本文结构安排如下:第II节概述相关研究;第III节与第IV节分别详细阐述系统模型及所提出的方案;第V节呈现实验结果及相应分析;最后,第VI节总结全文并探讨未来研究的潜在方向。
II. 相关工作
在本节中,我们综述了关于工业物联网(IIoT)背景下联邦学习(FL) 的相关文献、大型语言模型(LLMs)在数字孪生(DT)系统中的应用 , 以及基于RAG辅助的LLMs在数据生成中的应用。
A. 用于数据异常校正的数字孪生
DT由Grieves[38]提出,学术界广泛认可的定义是:DT通过接收传感器数据,并借助人工智能、机器学习和数据分析技术,在数字空间中对物理实体进行映射。随着数据的接收,DT会随物理实体的变化而相应调整[41] 。DT在运行维护及故障检测领域具有广泛的应用价值,能够实现结构状态的监测与故障诊断,从而实现结构的及时维护[42] 。Luo等人[43] 本文提出使用DT技术进行数控机床故障预测,该方法具有更高的故障预测精度。因此,对于大型机械中的不可见关键轴承,可采用DT技术对其进行仿真,此举具有两大主要优势:
1)故障识别精度更高;2)无需拆卸大型机械的关键轴承,即可通过DT技术监测其运行状态。
在实际工业生产环境中,数据采集过程易受到多种干扰的影响,从而导致异常数据的产生。在将此类数据用于后续应用之前,必须对这些异常数据进行严格的识别与处理, 以确保数据的完整性和可靠性 。Mehrang等人[46]本研究比较了三种用于检测和消除异常时间序列数据的不同技术,包括一种基于自回归积分滑动平均的提出模型、中位数绝对偏差估计法, 以及一种基于Rosner统计量的方法。在工业应用场景中,Hundman等人 [47] 研究提出了一种基于预测的方法,该方法结合了长短期记忆网络(LSTM)和非参数动态阈值来检测航天器异常。这些研究表明,在许多领域(尤其是处理时间序列数据时),识别并替换异常值是可行的。然而,所提出的异常处理方法往往具有领域特定性,难以直接应用于其他领域。此外,异常校正方法通常依赖于异常现象的上下文信息或数据的统计特性。当异常数据段较长时,插补数据的真实性可能会受到影响。
在轴承数据采集与应用的工业场景中,运行条件的变化及传感器故障可能导致采集数据出现异常,这些异常数据可能无法准确反映轴承的实际状态。因此,在将轴承数据投入训练和应用流程之前,对异常数据进行预处理至关重要。
DT在工业领域拥有非常多样化且广泛的研究与应用范围。从产品设计到生产、维护及质量控制,DT技术正推动工业4.0和智能制造的发展 。Shafto等人[48]首次在航空航天领域提出了DTs的概念,用于航空航天实体的镜像、仿真及分析支持。 Vijaya- kumar等人[49]提出了一种在制造设施中实施动态孪生(DT) 的方法,通过构建基于传感器数据的模型来模拟和管理设备资产。DT在数据异常检测与处理领域具有广阔的应用前景,尤其在工业物联网(IIoT)和智能制造系统中表现突出。我们建议将DT应用于轴承故障诊断,并推动异常传感器数据的修复工作。
B. RAG增强型LLM数据生成
大语言模型(LLM)在广泛的应用场景中展现出卓越性能。然而,在处理领域特定知识时,它们仍面临诸多局限[18] 。为应对这些挑战,RAG技术应运而生——该技术通过整合外部知识源来增强LLM的能力。RAG通过引用补充信息来提升LLM的性能,从而生成更准确且符合上下文的响应。近期RAG技术的研究进展主要集中在突破现有局限, 以拓展其适用范围和提升效能。Asai等人 [26] 提出了使用反射标记(reflection tokens) 的方法,使模型在检索过程中能够生成并反思所检索到的段落及其自身生成的内容。Shao等人[6] 提出了ITER- RETGEN 框架,该框架利用先前迭代的输出结果作为上下文线索, 以帮助检索更相关的知识 。Yan 等人 [27] 提出了修正型RAG (CRAG)模型,该模型旨在增强生成系统的鲁棒性。
在RAG技术应用于不同领域数据生成方面已取得显著进展。Li等人[21] 开发了一个框架,该框架利用语料库中的知识检索技术来提升大型语言模型(LLM)生成分子结构数据的性能。该框架通过整合外部来源的全面化学知识,增强了模型准确生成化学化合物的能力。类似地, Parvez等人[23]也提出了类似方法,开发了一个代码库,该代码库将检索机制与大语言模型(LLM)输入相结合, 以促进代码生成和摘要任务。其方法通过整合相关信息来提升生成代码和摘要的质量与上下文相关性,充分体现了RAG在技术及编程应用中的有效性。另一项研究[5]探讨了RAG与LLMs在处理非文本数据方面的应用 。Zhou等人 [25] 提出了DocPrompting技术,该技术可根据自然语言问题描述检索相关文档,并根据自然语言意图及检索到的文档片段生成代码。Nashid等人[24] 研究了用于断言生成和程序修复任务的少样本分类方法。在工业应用中,An等人 [1] 提出了Golden-Retriever框架——这是RAG的扩展版本,其中融入了基于反思的提问增强步骤。这一改进提升了模型在领域特定知识库中提供精确且符合上下文的答案的能力,彰显了其在处理超越传统文本生成范畴的更广泛数据类型和任务方面的潜力。
这些方法已在不同领域得到应用,显著提升了大型语言模型(LLMs)生成文本和数据的能力[33] ,[50]。然而,在持续生成数据的过程中,大型语言模型(LLM)更容易出现幻觉问题,导致生成的内容偏离现实。对于需要持续生成数据以修正异常的情况,这一问题将变得更加显著。
总之,RAG已被广泛应用于数据生成任务。然而,在工业物联网(IIoT)领域——其数据主要以时间序列格式存储——针对RAG在生成此类数据方面的应用研究仍相对滞后。
C. 工业物联网中的联邦持续学习
联邦学习(FL)作为一种分布式协作框架,通过协调多个去中心化客户端来实现模型训练。与集中式学习架构不同,FL这种技术本质上能提升安全性和隐私保护,因为边缘设备生成的数据始终保留在设备本地。因此,联邦学习(FL)近年来已成为推动工业物联网(IIoT) 中智能且保护隐私的应用的极具前景的技术范式。设备级数据用于本地化模型训练,仅更新后的模型参数会在边缘设备与云服务器之间交换[32] 。这些数据在边缘设备与云服务器之间进行交换[32]。大量研究已探讨了其在多个领域的应用,包括医疗健康[4][7]、入侵检测[31]以及其他工业物联网(IIoT)场景。
在支持DT的IIoT系统中,Hao等人 [29] 针对 IAI 问题 ,提出了一种高效且增强隐私保护的联邦学习(PE- FL)方案,该方案即使在串通(collusion)情况下也能防止数据泄露,为医疗保健和自动驾驶系统等敏感工业应用提供更高的准确性和效率。Sun等人[30] 提出了一种基于数字孪生(DT) 的工业物联网新架构,该架构融合了基于信任的聚合机制与自适应聚类异步联邦学习(FL)框架, 旨在资源受限条件下提升学习精度、收敛速度及能效。
在工业物联网(IIoT)的轴承故障诊断任务中,联邦学习(FL)被用于解决分布式计算中数据孤岛问题及工业协作相关的隐私问题。Zhang等人[36] 提出了一种自监督联邦学习(FL)方案,以实现保密的去中心化故障诊断。然而,数据不平衡对联邦学习的应用构成了重大挑战,可能导致学习性能显著下降 。Geng等人[45] 提出的FA- FedAvg方法旨在提升类别不平衡数据上的训练性能。Ma等人[44]该研究提出了一种基于线性滤波的学习方案,采用动态加权平均算法来降低数据不平衡带来的影响。然而,联邦学习模型在非独立同分布数据集上的性能仍需进一步探讨和优化;此外,这些方法在处理此类数据集时性能仍会受到影响。与此同时,当客户端需要对一系列非独立同分布的任务进行学习时,现有的联邦学习方法无法在数据流中保留先前任务所学到的知识。
现有研究已将联邦学习(FL)与其他方法相结合,用于解决其他领域中多个客户端在高度差异化任务流上的学习与知识迁移问题。 FCL 是一种基于联邦学习框架的协同学习(CL)方法,其特点是在较长的学习周期内持续聚合模型参数,并能够在不依赖历史数据和先前获取知识的情况下,利用新数据更新模型。Li等人[19]对此进行了研究, 提出了一种个性化 FCL 框架,用于从客户端提取生物特征数据,并在每个客户端中构建了一个可学习的学习率网络, 以实现本地模型的个性化定制。He等人[20] 该研究提出了一种基于深度学习网络的异步 FCL 系统,用于对自主飞行器采集的数据进行入侵检测,其效率和准确性均优于现有的联邦学习方案。然而,这些方法难以直接应用于方位角故障诊断任务,因为该任务需要对时间序列数据进行知识保留。
本文探讨了在基于数据采集与监控(FCL)的工业物联网(IIoT)系统中,如何实现轴承故障诊断。
III. 系统模型
本节介绍了所提出的FCLLM-DT方案的系统模型,该方案部署于本地工厂环境、边缘服务器及云基础设施中,如图1所示。
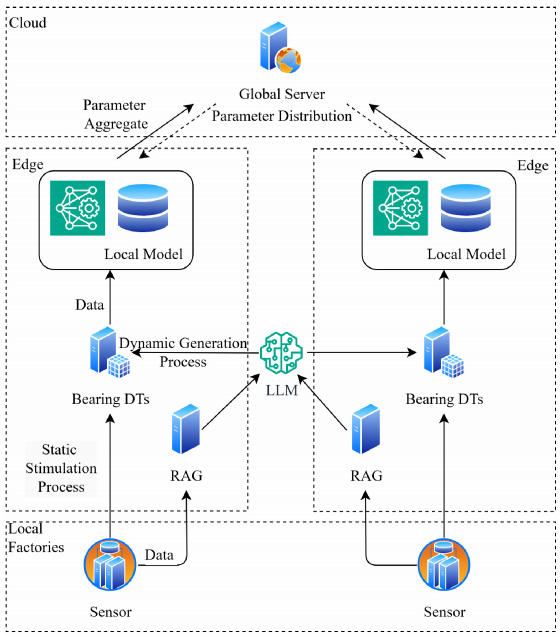
图1. 系统模型
在本地工厂环境中,传感器被部署在各类设备中,包括机械设备、轴承、芯片、 电机及其他组件。这些传感器可采集速度、压力、流速、振动、温度、湿度等参数数据。根据具体应用或设备类型,还可能收集更专业的数据。传感器采集的数据会输入到包含物理模拟的DT模型中,并存储起来,用于构建RAG系统所依赖的知识库。
在边缘服务器上 ,FCLLM-DT 方案包含三个关键组件:1)DT;2)RAG; 以及3)FCL 的本地模型。
1)轴承DT组件模拟了工厂生产运营流程的物理模型,同时模拟了轴承数据的运作机制,建立了一一对应关系。当设备传感器输入异常数据时,轴承DT将物理模型与DBT 相结合,从而提升用于本地模型训练的传感数据的准确性和质量。
2)RAG系统基于历史传感数据构建,可在传感器发生故障时协助在线LLM动态生成虚拟数据。该系统将生成的数据传输至DT ,使DT能够在各种运行条件下向本地模型提供连续的数据流。
3)FCL 内的本地模型能够利用由数字孪生(DT)优化、并由RAG辅助的大语言模型(LLM)生成的数据进行训练。这些本地模型充分利用了边缘服务器的计算能力,并经过专门训练以适应各工厂独特的运营特性。随着新数据的不断获取,本地模型会持续从中学习,适应不断变化的数据分布,并在联邦聚合过程中将更新结果贡献给全局模型。
在云端, FCL 框架下的全局模型得以持续维护。该全局模型充当中央存储库,整合来自分布式本地模型的参数,同时确保隐私保护。这些本地模型在多个工厂的不同边缘服务器上训练完成,它们在不共享原始数据的情况下贡献更新。通过整合来自各本地模型(每个模型均基于私有且可能不重叠的数据集训练)的更新,全局模型形成了涵盖所有参与实体集体知识的通用表征。这使得全局模型能够适应更广泛的数据分布和模式,从而提升设备故障诊断的准确性。
在系统的运行流程中,传感器将采集到的现实世界数据传输至DT模块和 RAGLLM 模块,用于构建轴承的DTs,并为大型语言模型(LLM)提供数据支持。当传感器数据中检测到异常时,DT会向RAG发起请求,根据异常数据的上下文生成相应数据,从而实现预测性数据修复。DT持续为边缘端本地模型的训练提供数据。各客户端的本地模型通过联邦持续学习与全局服务器进行交互,不断适应并从新任务中学习,从而实现在连续数据流上的故障诊断。
IV. 提出的方案
在本节中,我们将提出的FCLLM-DT方案详细分为三个部分: 1)基于DT 的异常数据修复;2)基于RAG 的LLM虚拟数据生成;3)轴承故障诊断 FCL。具体实现细节如下。
A. 基于数字孪生的异常数据修复
本文提出了一种基于数字孪生(DT) 的新型异常数据修复方法,适用于轴承传感器(包括轴承加速度和速度传感器)产生异常数据的情况。为提高本地模型中轴承故障诊断的准确性,我们采用DT对异常数据进行校正;随后运用 DBT 算法推断数据集中Meyer小波滤波器的边界以进行特征提取,从而提升数据质量。该流程包含一系列算法(如树生长算法) 以优化最终结果。
1) 异常数据识别与修正阶段: 鉴于传感器在异常工况下可能无法准确反映轴承的工作状态,我们分析了轴承的旋转运动特性,并基于神经网络驱动的DT技术开发了动态仿真模型。该方法能够有效识别并修正异常数据。
FCLLM-DT以轴承加速度作为案例研究。首先,将接收到的传感器信号分解为多个序列样本以满足训练要求,使得每个样本的数据点至少达到以下要求:
其中 表示每个样本包含的点数。 表示传感器的采样频率。 为类别数量。 是模型复杂度系数。 为生成样本所需的多样性要求。
将生成的样本数据集输入DT模型,并在模拟过程中结合物理机制与历史数据来训练判别器和生成器。判别器的作用是识别异常数据,而生成器则在判别器检测到异常后生成对应数据。判别器与生成器的训练过程与生成对抗网络(GAN)类似。异常数据与故障数据的区分基于时间阈值:传感器故障引发的异常通常表现为单个时间片段内的短期影响,这种现象在正常传感器工作条件下不会出现;相比之下,故障数据则会在多个时间段内呈现缓慢连续的模式。因此,该阈值时长能有效区分传感器异常与实际故障。
2) 故障数据特征提取: 此步骤旨在从DT传输至本地模型的数据中提取特征,并增强故障数据特征,从而提升本地模型的故障诊断准确性。
第一部分: 从轴承收集加速度数据,并将其转换至傅里叶频域以进行频谱分析。
第二部分: 应用 DBT 方法确定最优频带边界。在此步骤中,采用循环谐波噪声比(CHNR)( )作为故障指标来推断Meyer小波滤波器的边界。 DBT 的树状生长过程包含一种用于优化频带边界的带划分算法,通过多次迭代循环逐步调整以获得最佳结果。该优化的目标是最大化 ,即最大化信号中循环谐波与噪声的比值。
和 是频带的边界。 是具有频带 的信号的 CHNR 。 的定义为:
表示故障频率谐波的数量,我们考虑前三个谐波。 代表同步包络谱[37] 。 表示第 个估计谐波,而 表示 附近的最大值。 CHNR 通过将估计谐波与周围局部最大值的 SES 进行比较来计算,从而衡量故障频率相对于这些局部最大值的平均显著性。
详细算法如下。
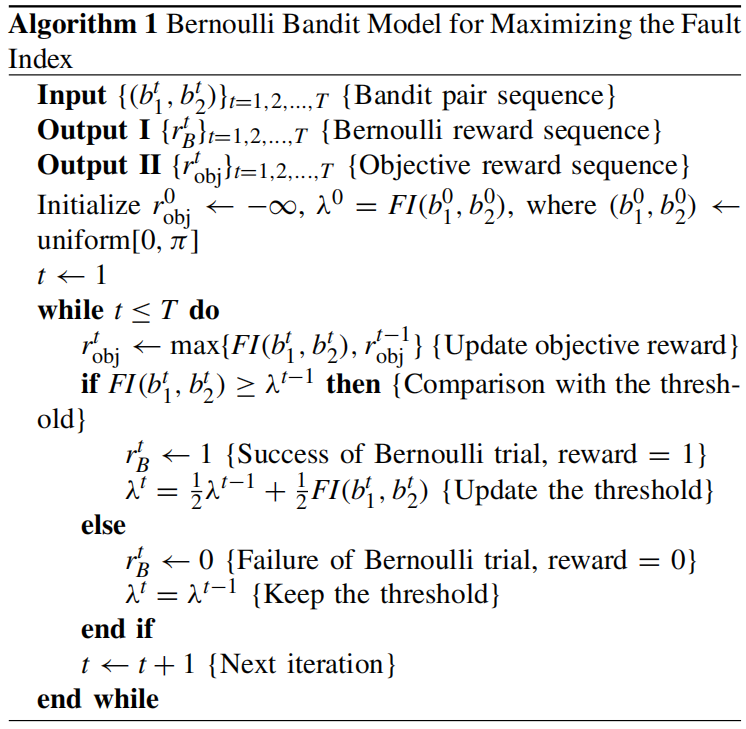
1)树状结构: DBT 采用多树结构方案,而蒙特卡洛树则采用单树方法。
2)探索与利用策略: 蒙特卡洛树通过设定置信度上限来平衡探索与利用过程,具体采用何种置信度公式取决于具体应用场景。相比之下, DBT 采用汤普森采样法,该方法对目标奖励值作出连续性假设,并使用伯努利奖励机制[28]。
第三部分: 将优化后的带状信号解调为同步包络谱(SES)。
FCLLM-DT通过其三个组件的协同运作,能有效识别并放大机械故障特征,因此在复杂机械系统中尤为实用。该方法提升了局部模型实现更精确故障诊断的能力。
在获得计算得到的信号频谱后,我们进行逆傅里叶变换将其转换为时域信号数据,随后将其传输至本地模型。 表示时域信号, 表示频域信号的幅度谱, 为虚数单位, 为时间变量, 为频率变量。
B. 基于RAG技术的LLM虚拟数据生成系统
图2阐释了RAG辅助大语言模型(LLM)在虚拟数据生成中的完整流程与模块架构。当传感器发生故障无法采集数据时,FCLLM-DT方案会利用RAG辅助的LLM系统:首先从历史传感器数据构建知识库,再由LLM生成虚拟数据集并提供给DT 。
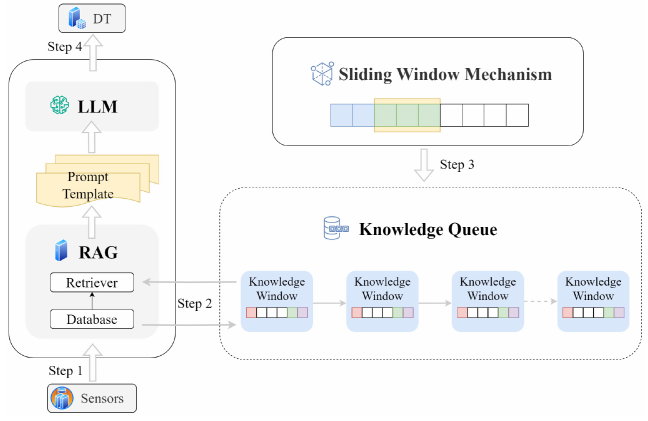
图2. RAG辅助的大语言模型(LLM)用于虚拟数据生成的过程。
该系统的具体流程如下。
步骤1: RAG 系统根据 (基于时间的轴承加速度)和 构建知识库。当 DT 无法从传感器接收运行数据时 ,它会提取 (故障传感器的标识符) 和 (故障发生时间) ,并向 RAG 发送查询以获取后续时间序列数据。收到该查询后,RAG 会通过数据库中的 快速检索出 (故障前的历史数据)。
步骤2: RAG 系统采用创新的数据管理和查询策略与LLM(本例中为ChatGPT)进行交互。通过提供与轴承相关的特定知识,RAG 协助 LLM 进行推理并优化生成结果。为实现高效的数据管理,系统根据查询需求智能组织和更新知识,构建了动态队列系统。初始阶段,RAG 系统创建一个队列( ),每个窗口代表一个知识单元。这些窗口是检索知识的基本单位,其大小和内容根据特定轴承模型及历史数据进行定制。在查询知识库时,RAG 系统提供充足的历史数据,确保 LLM 拥有足够的上下文知识以生成准确数据。
步骤3: RAG 系统采用滑动窗口机制来调整提示词,从而提升大语言模型的生成性能。对于异常数据段( ),RAG 会在提示词中使用其前序上下文窗口( )来生成 ,随后将生成的数据作为下一个单元与上下文连接,并将提示窗口滑动至( )。在此过程中 , LLM 会基于当前上下文多次生成数据段,并将其拼接成完整的生成数据( ),有效缓解了长数据生成过程中出现的幻觉问题。
步骤4: 在 RAG 辅助的LLM 生成数据后,系统会使用滑动窗口机制更新知识库的队列( )。这意味着一旦 LLM 的数据生成完成,RAG 系统会将队列前端的旧数据移除,并将新生成的数据窗口添加到队列末尾。这一迭代过程确保队列始终包含最新的轴承数据,并通过多次迭代逐步积累和优化生成的虚拟队列( )。与传统方法仅提出单一问题即可生成大量数据不同,该RAG系统能更有效地控制数据的质量与相关性——因为它允许模型在每次迭代中学习并适应,从而持续提升生成的方位感知数据的准确性与实用性。
C. 用于轴承故障诊断的联邦式持续学习方法
在分布式工厂中,轴承故障诊断模型通过 FCL 技术进行训练,从而实现更精确的模型,并具备动态适应性和隐私保护功能 。 FCL 方案首先在云服务器上建立全局模型,该模型通过加权平均方式整合边缘服务器上部署的本地模型参数;随后,云服务器将聚合后的全局参数发送至各边缘服务器, 以更新其本地轴承故障诊断模型。本地模型通过结合全局参数、任务相关传感数据及历史传感数据,能更好地适应当前任务需求,并在完成一轮训练后将更新后的参数上传至全局模型。 FCL 方案不仅提升了轴承故障诊断性能,还实现了数据隐私保护及对新传感数据的持续动态适应。轴承故障诊断的FCL流程如下:
步骤1: 通过构建全局轴承故障诊断模型对整个系统进行初始化。随后将该构建完成的全局模型发送至各分布式工厂,作为本地轴承故障诊断的初始本地模型。
步骤2: 工厂利用 DT 持续提供的时间序列数据对本地模型进行训练, 以优化轴承故障诊断,并将参数发送至服务器。公式(5)展示了本地模型的训练方法。
一旦我们获得了 、 、 和 的值,我们就能轻松计算出 。
在该方程中, 表示输入数据集的规模, 表示轴承健康状态的类别数量, 表示第 个输入数据样本的标签,而 表示将第 个样本分类为标签 的概率。训练完成后,客户端会上传参数的梯度,可定义为 ,其中 是当前任务 的基础参数集, 表示稀疏向量掩码集。
步骤3: 云服务器上的全局模型通过加权平均法汇总本地参数,并将生成的全局参数 发送至边缘服务器上部署的本地模型,从而提升对轴承故障的精准诊断能力。加权聚合的具体计算方式如下:
步骤 4 : 在本地更新过程中,本地模型采用一种策略,即有选择地将全局参数与任务特定的本地参数相结合,以优化并更新其本地模型。这种方法可根据自身传感数据的特性和需求调整本地模型参数,从而提升模型性能及其对本地工厂运营的适应能力。通过这种方式,客户既能充分发挥全局学习的优势,又能保持对本地数据特征的敏感性,实现个性化且优化的模型更新。首先,本地参数可定义为:
要更新本地参数,只需设置 ,然后如下最小化目标函数来学习新的训练参数 :
表示前述损失函数, 是稀疏正则化项, 表示最新基础参数与当前参数之间的差值,而 则表示故障诊断模型的先前自适应参数与其当前自适应参数之间的差值。步骤 2-4 将持续执行,直至局部模型决定不再更新。
该方法通过整合基于任务的参数(这些参数旨在增强当前本地任务的适应性,表示为 ),使客户端能够根据特定任务的具体目标定制各自的模型。这些自适应参数捕捉了与正在处理的任务相关的核心知识。它们会被保留并随机重新分配给本地模型用于后续任务,这有助于防止先前任务中的知识丢失,同时提升当前任务的学习效率。
V. 性能评估
我们利用 CWRU[11]和 MFPT 数据集,对FCLLM-DT算法在多种轴承故障诊断任务中的性能进行了配置与验证。这些数据集涵盖了轴承故障诊断所需的全套关键参数,包括轴承加速度、转速及轴承类型等。为全面评估故障检测精度,我们制定了涵盖三大核心维度的评估指标:1)DT算法修正异常数据的能力对比分析;2)基于RAG辅助的大语言模型(LLMs)生成数据的准确性;3)FCL 在轴承故障诊断中的有效性。
该评估的核心依据是数据对比得出的可量化结果,这些结果充分证明了我们项目的有效性。评估内容包括:RAG辅助的大语言模型(LLM) 的可用性、DT异常修正结果与真实数据的相似度, 以及轴承故障诊断的准确性。最终,工厂采用 FCL 技术实现跨工厂的分布式学习,同时确保隐私保护,这充分体现了我们基于FCLLM-DT的轴承故障诊断方法的实用性。
A. 实验设置
我们实验中使用的数据包括来自 CWRU 和 MFPT 数据集的缺陷数据。这些数据集涵盖了轴承故障诊断所必需的全面参数,例如振动、轴承加速度、转速和轴承类型。在此背景下,B代表轴承内的滚珠,IR表示内圈,OR表示轴承外圈。0.007毫米、0.014毫米和0.021毫米的测量值分别对应轴承内相应位置裂纹的长度。
故障数据 指传感器故障导致轴承运行数据在一段时间内无法采集的情况。相比之下, 虚拟数据 是通过将真实数据输入 RAG 至大语言模型(LLM)生成的完整数据集。该方法旨在模拟轴承运行数据,在传感器故障期间持续向决策系统(DT)提供信息。 原始数据集 包含传感器采集的所有数据,可作为基准用于判断哪种方法最接近实际运行条件。
该解决方案的算法与实验均采用Python编写。中央服务器配备V100显卡和125 GB内存,边缘服务器环境则搭载i 9-13900HX处理器及32 GB内存。测试系统基于CentOS 7操作系统运行。
B. 基线与我们的模型
1)卷积神经网络(CNN): CNN通过一系列重叠的卷积层、激活层、池化层和全连接层逐步提取特征。利用反向传播算法最小化损失函数,从而优化模型参数,以实现高效的分类或回归任务。
2)CL: CL通过整合新任务或数据持续更新模型参数,使模型能够在保留先前学习信息的同时适应新知识。
3)FedAvg[16]: 一种联邦学习算法,服务器会计算本地模型梯度的平均值,并将汇总后的更新结果分发给客户端。
4)FCLLM-DT: 我们的 FCLLM 算法。
C. 评估指标
为构建更清晰的框架,FCLLM-DT首先提出了数据校正的评估指标,该指标采用基于欧几里得距离的相似性方法。
表示与原始数据的欧几里得距离,其中( )表示原始数据点,而( )表示已校正或异常的数据点。
D. DT修复异常数据的准确性
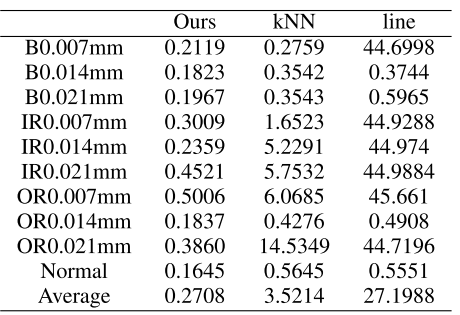
在本研究中,我们将提出的FCLLM-DT方法与现有的KNN 和线性插值算法进行了比较, 以评估其对异常数据的校正效果。如表Ⅰ所示,我们通过大量实验评估了在轴承不同位置发生传感器故障的情况下,校正后数据与真实数据之间的相似度。结果表明,采用本方法校正后的异常数据平均值低于现有方法且更为稳定。 KNN 和线性插值算法均高度依赖周围数据的局部特征,这对数据质量和参数选择提出了严格要求;相比之下,FCLLM-DT展现出更高的稳定性——其平均欧氏距离低于0.3 ,在异常数据校正方面取得了更优效果。
表Ⅰ 不同条件下DT输出数据的相似性实验
从图3可以看出,采用DT对数据进行预处理后再用 FCL进行训练所得的结果优于未进行DT处理的情况。这是因为DT通过 DBT 技术能更便捷地调整参数以优化Meyer小波滤波器的边界,从而增强与故障相关的频率成分,有效剔除异常数据。这一过程不仅提升了故障数据的分类能力,还能通过削弱时间序列数据中的异常值,有效降低异常数据对故障诊断准确性的负面影响。结果显示,经过DT预处理后的缺陷数据、处理后数据及原始数据的故障诊断率均比未预处理时高出1%-2%。
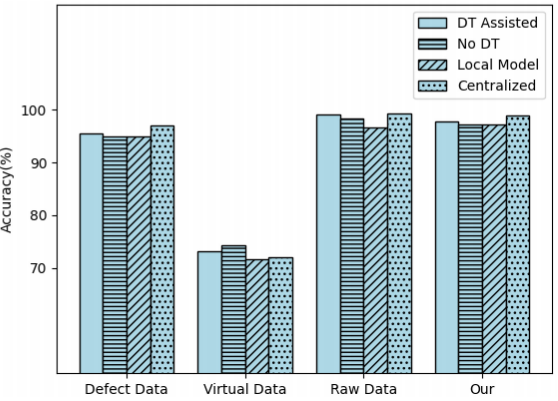
图3. 不同数据输入下轴承故障诊断的准确性
E. RAG辅助LLM生成数据的准确性
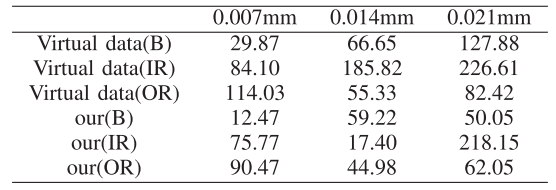
通过分析表Ⅱ可以明显看出,采用我们提出的方法生成的虚拟数据在与真实数据的相似性方面具有显著优势。这些数据是通过欧几里得距离算法计算得出的,能够准确反映数据间的相似程度。在不同裂纹条件(0.007 、0.014和0.021毫米)下,生成的数据集与原始数据之间存在差异。在对比三种不同条件(B 、IR和OR)时,仍存在一定误差范围,但本方法生成的数据集相较于未采用本方法的全虚拟数据集,明显更接近原始数据。这表明我们的方法能有效提升数据生成的准确性和可靠性。
表Ⅱ 通过计算虚拟数据与原始数据之间的欧氏距离(数值越小表示相似度越高),我们评估了虚拟数据与真实数据的匹配程度。
F. 基于FCL 的轴承故障诊断准确性
在本研究中,我们采用了三个广受认可的轴承故障诊断数据集——测试数据集 、CWRU 数据集[11] 、CWRU Imperfect Data以及 MFPT 数据集,以验证我们方法的通用性和有效性。通过对比故障诊断的准确率,我们证明了该方法在不同数据集上的表现。此外,为验证我们方法的性能,我们还与CNN 、CL及FedAvg等其他先进故障诊断技术进行了定量对比分析。这些对比结果不仅凸显了我们方案的优势,也为轴承故障诊断领域的研究提供了宝贵参考。
1)不同方案在各类数据集上的轴承故障诊断准确性比较: 我们的研究方案在三个不同数据集及含异常数据设置的数据集上,均与其他方案进行了广泛的故障诊断性能对比。如表Ⅲ所示,我们的方案在各类数据集上均实现了最高的故障诊断准确率,这不仅体现了该方案在分布式多任务环境中的诊断性能,也证明了其对异常缺陷数据的适应能力。
表Ⅲ 比较不同学习方法在跨不同数据集进行轴承故障诊断时的准确性(数值越高表示性能越好)
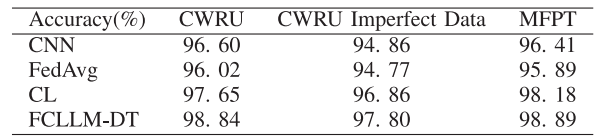
通过引入DT技术优化数据,我们的方法显著提升了时域数据集的修复能力。 同时, FCL 方法确保了在非独立同分布数据集上的学习性能。此外,在不完美的 CWRU数据集上的诊断结果表明,我们的方案能够识别并修正错误数据,有效抵消了错误数据对模型的负面影响。
如图4所示,我们采用 CWRU 数据集中的三个客户端进行了仿真实验以评估本方法。与CNN 、FedAvg和CL三种方法相比,我们的方案在轴承故障识别准确率及跨客户端稳定性方面均表现出更优性能。这证实了本方法的学习策略能确保每个本地客户端的性能稳定,非常适合工厂等大规模制造环境。
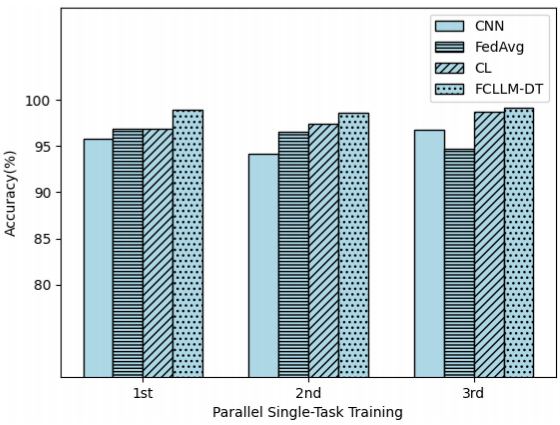
图4. 故障诊断准确率比较
2) 基于新任务与现有任务训练的轴承故障诊断模型: 图5展示了新任务与现有任务之间的性能差异。此处呈现的任务并非原始数据,而是原始分类结果,意味着这些数据完全属于全新类型。第八轮测试中识别准确率的下降归因于当时进行的全局参数聚合操作,该操作可能阻碍了局部模型充分学习数据特征,从而导致性能暂时下滑。随着训练推进,聚合策略将逐步提升模型性能,因为全局模型能够从多个局部模型中学习更广泛的数据特征。从初始到第30轮测试, 已出现任务的故障识别准确率始终高于新任务,这表明,即使面对之前遇到过的任务,我们的方法仍能保持较高的故障诊断准确率。
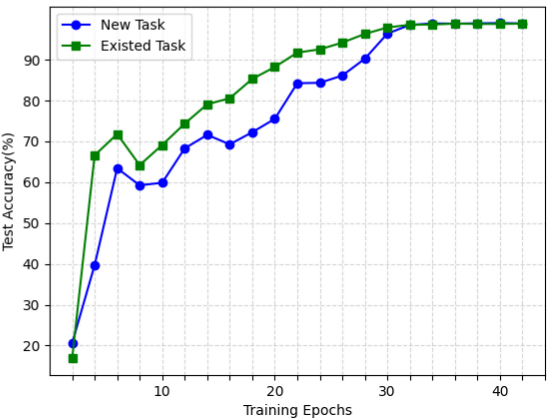
图5. 在新任务和现有任务上训练的轴承故障诊断模型的测试准确率。
3)FCL 的记忆能力: 图6(a)和(b)展示了FedAvg与FCLLM-DT的混淆矩阵,体现了这两个模型在完成最终轮任务学习后在整个测试集上的分类效果。显然,FCLLM-DT模型具备保留并利用过往任务学习成果的能力,能够有效调用并应用历史数据中的知识;相比之下,FedAvg仅直接对本地模型更新进行平均处理,缺乏这种记忆功能,因此难以识别和分类当前任务训练数据中未包含的类别。当处理包含多种类别(其中某些类别可能很少出现)的数据集时,FedAvg方法的缺陷尤为明显。FCLLM-DT增强的记忆能力与FedAvg缺乏该能力之间的对比,凸显了在机器学习系统设计中考虑模型记忆能力的重要性——尤其是在从过往经验中泛化以实现最佳性能至关重要的情况下。
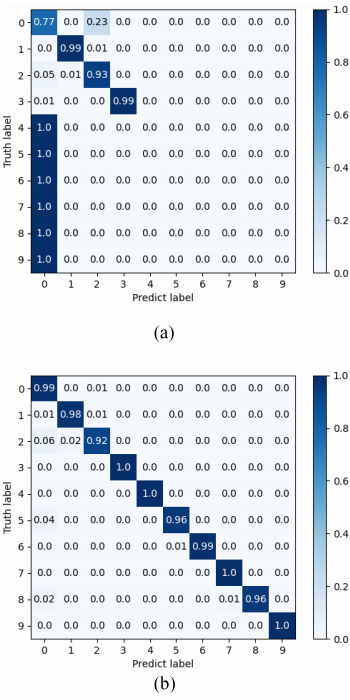
图6. 不同方法的混淆矩阵。(a) 混淆矩阵FedAvg.(b)我们的混淆矩阵。
VI. 结论与未来工作
综上所述,FCLLM-DT方案为分布式工业物联网系统中保持精准故障诊断模型的挑战提供了创新解决方案。该方案通过整合数字孪生(DT) 与RAG辅助的大语言模型(LLM)作为数据优化技术,并运用 FCL 算法训练故障诊断模型,有效解决了传感器数据异常、传感器故障及数据隐私等问题。专为模拟轴承物理模型并利用决策强盗树设计的DT模型,显著提升了本地模型训练所用传感器数据的质量;而基于历史传感器数据的领域专用RAG辅助LLM ,则能在缺乏实时传感器输入的情况下生成精确的虚拟数据集以支持协同学习(CL)。 FCL 方法通过整合分布式工厂的本地模型实现全局故障诊断模型的优化,同时保障各工厂数据的隐私安全。实验结果表明,FCLLM-DT方案在提升传感器数据质量和轴承故障诊断准确性方面具有显著成效。
未来的工作重点将放在提升由RAG辅助的大语言模型(LLM)生成的虚拟数据的准确性 。RAG系统可采用多种架构进行设计,例如利用知识图谱来挖掘数据间的深层关联。此外,我们将探索不同版本的LLM以确定其最佳性能表现 。 同时 ,我们计划开发并部署更广泛的DT模型, 以进一步验证所提出的数据质量改进技术的有效性。