首页/文章/ 详情

“数字孪生/故障诊断”专题||数字孪生+视觉语言大模型:用于多场景工业故障诊断(上)
8月前浏览1052

本期给大家分享一篇小编近期阅读的1区top文章。如果有故障诊断相关方向研究人员希望宣传自己研究成果,欢迎大家在公 众号后台与小编联系投稿,大家一起交流学习。  

本期推荐的这篇是西安交通大学许权宁的文章,本文系统综述了工业故障诊断从“数据驱动深度模型”走向“大模型时代”的完整技术脉络:首先回顾了传统规则/模型/数据三类范式的演进瓶颈,继而梳理了大型语言模型、视觉模型与多模态视觉-语言模型(LVLMs:Large Vision-Language Models)在故障预测与健康管理(PHM:Prognostics and Health Management) 领域的最新进展,指出通用大模型因缺乏工业知识、难以应对跨工况分布漂移与高质量样本稀缺等痛点;在此基础上,重点剖析了数字孪生驱动的深度合成数据、参数高效微调(LoRA:Low-Rank Adaptation)、跨模态对齐与对比学习等关键技术如何协同解决样本不足、域泛化与可解释性三大核心问题,最终提出面向多场景、可对话、可迁移的下一代智能故障诊断大模型研究框架与未来挑战。  

由于文章篇幅过长,小编将分两次为大家翻译介绍这篇论文。第一篇推文提出融合深度数字孪生与大型视觉-语言模型的故障诊断框架故障诊断通用语言模型(FDGLM:Fault Diagnosis General Language Model),利用虚拟实体生成高质量振动样本,经短时傅里叶变换(STFT:Short-Time Fourier Transform)转为时频图,再借助LoRA策略对视觉和语言模块进行两阶段微调,实现跨工况、跨设备智能诊断,并构建人机交互式维护决策,突破工业数据稀缺与泛化瓶颈。  

希望对大家的学习有所帮助,文章质量很高同时希望大家可以多多引用。  

论文基本信息

论文题目: Deep digital twin-powered large vision-language model for multi-scenario industrial fault diagnosis

论文期刊:Advanced Engineering Informatics

Doi:https://doi.org/10.1016/j.aei.2025.103997

作者: Quanning Xu(a), Guangrui Wen(b), Zihao Lei(c),Shulong Gu(d),Yu Su(e),Zhifen Zhang(f),Xuefeng Chen(g)
论文时间: 2025年
机构: 

a National Key Lab of Aerospace Power System and Plas ma Technology, Xi’an Jiaotong University, Xi’an 710049, China

b State Key Laboratory for Manufacturing System Engineering, Xi’an Jiaotong University, Xi’an 710049, China

c School of Mechanical Engineering, Xi’an Jiaotong University, Xi’an, Shaanxi 710049, China

作者简介:许权宁,西安交通大学机械工程学院博士研究生,国家航空航天动力系统与等离子体技术重点实验室、机械制造系统工程国家重点实验室核心成员。长期聚焦工业人工智能、数字孪生与多模态大模型融合研究,近三年在《Advanced Engineering Informatics》等顶刊以一作/通讯身份发表多篇论文,主导开发了面向多场景工业故障诊断的开源框架 FDGLM。(来源:ResearchGate)

摘要

数据驱动的深度学习技术已被广泛采纳于工业健康监测与维护。然而,传统诊断方法常受场景特异性限制且智能能力不足。新近发展的大规模视觉-语言模型为智能故障诊断提供了先进的人机交互范式。本研究通过提出FDGLM框架,将LVLMs拓展至工业故障诊断,实现跨多种运行条件与数据集的智能化诊断。首先,依托先进数字孪生技术生成高质量振动样本以支撑模型训练;这些样本经STFT处理,生成增强的时频谱图,满足故障诊断通用语言模型(FDGLM:Fault Diagnosis General Language Model)训练对大规模数据的需求。随后,采用低秩自适应策略对预训练视觉模型进行微调,联合交叉熵损失与圆损失以同步提升对工业故障时频特征的判别能力与鲁棒性。接着,利用领域专用文本指令对语言模型进行微调,实现视觉与文本模态的深度对齐,使因果故障分析与维护决策成为可能。最后,在四个独立数据集上开展跨工况与跨数据集实验,结果显示:同工况诊断精度达0.995,变工况为0.890,跨数据集为0.947,同时呈现专业级对话诊断能力。实验结果证实,FDGLM以极小微调代价即可提供适用于工业场景的可靠诊断,性能优于现有框架,为下一代工业装备健康管理提供解决方案。
关键词:大语言模型;大规模视觉-语言模型;故障诊断;多模态大语言模型;数字孪生

目录

1 引言

2 相关研究

   2.1 智能故障诊断

   2.2 大规模模型

3 深度数字孪生模型

   3.1 滚动轴承的虚拟表示

   3.2 虚拟-物理数据流融合

4 所提出的大规模视觉-语言模型

   4.1 模型架构

   4.2 预训练视觉模型的微调

   4.3 查询变换器

   4.4 预训练语言模型的微调

   4.5 实现流程

5 实验验证

   5.1 数据集配置与预处理

   5.2 实验设计与实现细节

   5.3 数字孪生模型验证

   5.4 单工况验证

   5.5 跨工况验证

   5.6 跨数据集验证

   5.7 超参数分析

   5.8 消融实验

6 结论


注:小编能力有限,如有翻译不恰之处,请多多指正~
     若想进一步拜读完整版,请下载原论文进行细读。

1 引言

作为工业界与学术界人工智能领域的首要研究焦点,大规模模型已在多学科掀起新一轮技术浪潮。在自然语言处理、计算机视觉与科学计算等领域,这些模型衍生出大语言模型[1,2]、视觉模型[3]及天气预报模型[4]等多元变体。通过跨学科融合,它们进一步演化为融合视觉与文本数据的多模态视觉-语言模型[5,6],以及面向工业视觉监测的多模态对话模型[7]。这些技术对装备健康管理与工业系统智能化升级展现出变革性潜力。

故障诊断作为故障预测与健康管理的核心环节,依托传感器信号分析实现故障类型识别、故障部位定位及严重程度评估。近十年来,计算机科学的范式迁移推动了基于深度学习的诊断方法取得显著突破[8]。凭借端到端学习机制,此类方法在面向特定运行工况定制的数据集上展现出卓越诊断性能。然而,由于域间分布漂移,其性能在不同工况或不同设备间往往难以泛化[9]。将大规模模型技术融入PHM框架,尤其是通过面向故障诊断的专用时序建模架构,为保障机械设备运行稳定性提供了变革性视角[10]。在工业数据集上微调后,预训练视觉-语言模型能够以强泛化能力与上下文理解力完成故障诊断。

此外,多模态数据的有效利用以实现缺陷全面表征仍是持续显著的研究挑战。在真实工业环境中,先进传感系统通常产生多源数据流,涵盖振动、声信号、文本描述及视觉图像。学者已针对各类信号模态展开广泛研究:例如,Löwenmark 等提出弱监督技术语言处理框架,借助自然语言标注提升模型性能[11];Lei 等提出变工况轴承振动信号域自适应诊断方法[12];Liu 等构建动态视觉数据神经形态故障诊断框架,利用脉冲神经网络实现高效特征提取,并通过迁移与元学习增强泛化[13]。大规模模型凭借异构模态对齐、互补特征融合及语义推理[14],在整合文本、图像、音频、视频数据方面展现强大能力,实现全面信息理解与生成。OpenAI 的对比语言-图像预训练(CLIP:Contrastive Language–Image Pre-Training)[15]通过对比学习将视觉与文本模态投影至共享语义空间,实现高效跨模态对齐与检索。将工业图像与文本信息融合后,视觉-语言模型在故障诊断中展现出变革性应用潜力。

深度神经网络架构的演进呈现出参数规模持续扩大的显著趋势。以Transformer框架为代表的大规模预训练模型已相对传统神经网络实现显著性能跃升。依据Vapnik-Chervonenkis维度理论,模型容量、泛化能力与所需训练数据量存在根本关联——即模型越复杂,所需样本越多[16]。因此,构建大规模故障诊断模型亟需高质量数据集且须具备充足样本多样性。然而,工业环境中设备故障发生频率低且复现成本高昂,导致采集多样化多状态数据以构建全面数据集极为困难[17]。为突破该瓶颈,研究者已探索多种数据增强方法:Hei 等提出融合Wasserstein距离与工况标签嵌入生成对抗网络的方法,利用注意力驱动预自适应模块缓解分布漂移[18];Yu 等将信号标签嵌入去噪扩散概率模型,并优化网络架构以提升层内与层间特征表示,实现不平衡数据条件下的精准轴承故障诊断[19]。然而,生成模型固有地难以在合成数据质量与训练规模间取得平衡,因而无法彻底解决数据稀缺问题。数字孪生技术通过利用丰富虚拟资源于工业生态系统内模拟故障状态,为构建高质量训练数据集提供了变革性解决方案[20,21]。Yu 等提出数字孪生特征输入框架,建立虚拟映射关系,实现非接触故障诊断[22]。本文尝试通过孪生数据构建全面训练集,以支撑视觉-语言模型的训练。

综上,为在多状态且高质量数据稀缺的条件下构建智能对话诊断模型,本文提出数字孪生驱动的大规模视觉-语言故障诊断框架。主要创新包括:(1) 研发实用化数字孪生驱动视觉-语言诊断框架;(2) 利用数字孪生构建大规模高质量数据集,满足大规模模型训练需求;(3) 提出故障诊断视觉-语言模型,采用两阶段训练策略对视觉模块与语言模块进行渐进式微调;(4) 开展全面验证,证明该框架在单工况、跨工况及跨数据集场景下均具备智能化多场景诊断性能。本文结构如下:第二节回顾智能故障诊断与大规模模型相关研究;第三节阐述数字孪生模型;第四节介绍所提视觉-语言框架;第五节给出实验结果;第六节总结关键发现并展望未来研究方向。

2 相关研究

2.1 智能故障诊断

在旋转机械领域,借助 DT 的动态建模正成为研究热点;优质的动态模型是 DT 建模的根基,可为后续虚实交互提供高保真虚拟信号。当前研究主要集中于轴承、齿轮与转子系统。对轴承系统,研究重心为轴承损伤(如内圈、外圈及滚动体损伤)的动态建模,主要关注轴承自身力学特性,而不考虑转子系统影响。对齿轮传动系统,研究重心为裂纹、剥落、磨损、断齿等故障状态下齿轮传动系统的动态建模。对转子系统,当前重心主要为不平衡、不对中、碰摩、机座松动等工况下的转子系统动态建模 [50]。这三类系统所采用的主要建模方法包括:基于物理的模型(如集中参数模型、有限元模型、刚−柔耦合模型)、唯象模型以及数据驱动模型。

从另一个角度来看,故障诊断经历了四个关键的开发阶段。如图1(a)所示,传统的诊断技术主要集中在一维振动信号分析上。这些模型通常使用工业数据从零开始进行训练,但往往受到泛化能力有限的影响,并且需要大量的训练样本。如图1(b)所示,预训练模型显著降低了对标记样本的依赖。通过将一维信号转换为图像,已经建立的视觉模型(如视觉Transformers(ViT:Vision Transformers)[28])成功应用于故障诊断。大型语言模型(LLMs:Large Language Models)利用其在序列信号处理方面的强大能力,为PHM引入了新的范式。这些模型通过智能人机交互在分类和预测任务中实现了高性能[3,4]。如图1(d)所示,视觉-语言模型超越了LLMs的局限性,通过动态融合视觉和文本特征来增强多模态推理能力[7,29]。具体而言,使用信号处理技术将一维信号转换为二维表示。这种转化不仅满足了基于视觉模型的输入要求,还增强了与故障相关的特征,同时减少了因采样频率差异和设备特定变异而引起的伪影。LVLMs利用领域特定的文本语料库实现准确的故障分类和因果推断。此外,通过利用视觉和语言特征之间的深度交互,该模型支持高精度的故障诊断和在工业应用中的知情决策。因此,本研究重点关注使用LVLMs进行精确的轴承故障诊断。
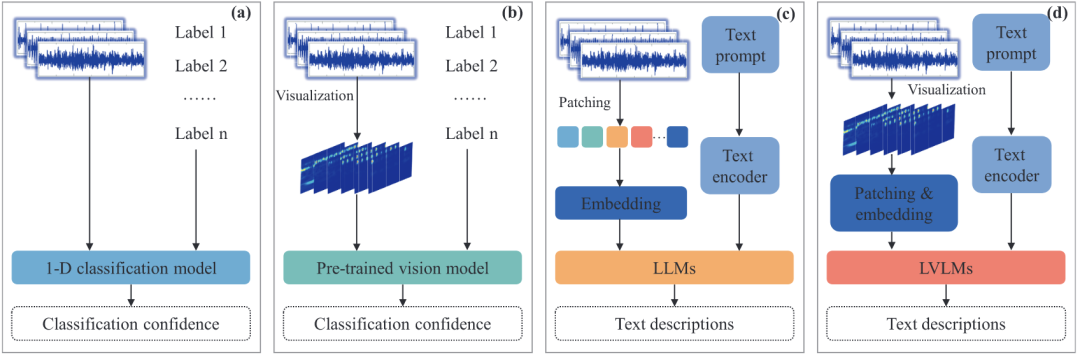
       

图1 不同阶段的故障诊断办法

2.2 大规模模型

大规模模型是计算机科学中的一个关键前沿,最初出现在自然语言处理(NLP:Natural Language Processing)领域[30]。为了处理图像和视频等视觉数据模态,这些模型已经演变为大规模视觉-语言架构。通过将视觉和文本数据映射到统一的语义空间,这些模型实现了跨模态的相关性和理解。Luo等人提出了一种对比跨模态去噪框架,通过结合跨模态匹配与模态内部去噪,利用被遮挡和未遮挡视频帧之间的对比来改善视觉-文本对齐[31]。然而,由于缺乏领域特定的知识,现有的大型语言模型在工业视觉数据上的表现不尽如人意。近期的研究努力专注于为PHM应用开发专用的LLMs。Wang等人开发了一种多模态晶圆缺陷数据集,并使用LVLMs实现了高精度的多类缺陷识别[32]。Zheng等人针对复杂系统的故障诊断进行了初步研究,使用预训练的大型模型进行数据集大小、数据预处理和可解释性等因素的定量和定性评估[33]。Tao等人推出了首个用于轴承故障诊断的大型语言模型,通过统计分析选择振动信号特征,并验证其在少样本和跨数据集场景下的性能[10]。Tang等人提出了一种针对少样本和零样本场景设计的大规模视觉-语言模型。通过联合优化交叉熵损失、焦点损失和Dice损失,该模型在样本有限的情况下也能实现准确的故障识别[29]。针对故障诊断的LLMs研究仍处于早期阶段,如何在故障数据稀缺的条件下有效操作仍是一个主要挑战。

从头训练含数亿到万亿参数的大规模模型计算开销惊人,于是学界转向参数高效微调:仅更新极少额外参数即可把预训练模型“挪”到新任务。全参数微调虽更新全部权重,却丝毫未减算力负担;当前把通用大型视觉-语言模型拉进垂直场景,几乎全靠这类“轻量”微调,主流套路有 Adapter、Prefix-Tuning 和低秩适应。Adapter 在每个 Transformer 层塞入轻量前馈子模块 [34],训练时只动这些“小插头”,思路简单却额外加层,推慢推理,且参数效率与优化深度仍受限;Prefix-Tuning 把一串可训练的“前缀 token”贴到输入,靠冻结主干、只调前缀来引导输出 [35],但连续软提示直接学习极易震荡、收敛糟糕;相比之下,LoRA 用低秩矩阵逼近权重更新 [36],在算力与性能间切出最优权衡——Meta 的工作已证实,预训练模型本征维度极低,在此压缩子空间微调即可媲美全参更新;LoRA 仅对高维 权重矩阵做低秩分解、训练其中一小撮参数,便实现“四两拨千斤”。

令预训练模型中 特定层的原始权重矩阵记为        ,微调更新为        ,得到更新后的参数矩阵        。根据LoRA假设,更新         可以用两个低秩矩阵的乘积近似:        ,其中        ,        和        。这里,        作为一个超参数控制着低秩近似的复杂度。与传统的微调更新整个矩阵        不同,LoRA只需要        个额外参数,显著降低了计算成本和内存占用。如图2所示,在前向过程中,给定一个输入         ,,层的输出h被计算为:

矩阵         使用高斯分布初始化,而         初始化为零矩阵。值得注意的是,尽管只引入了少量的额外参数,LoRA实现了与完全微调相当的性能,同时大幅降低了计算和内存成本[38]。
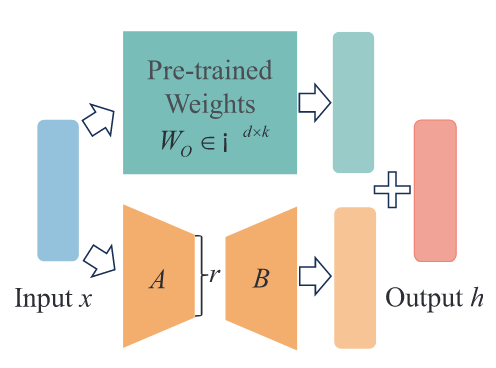
     

图2 LoRA微调方法示意图

3 深度数字孪生模型

深度数字孪生(DDT:Deep Digital Twin)技术通过将深度学习算法嵌入数字孪生框架,并以生成模型为桥梁,实现虚拟-物理的高保真映射 [39]。概念上,DDT 由三大核心单元构成:物理实体、虚拟实体以及虚实映射网络 [40]。为构建覆盖全健康状态的大规模训练数据集,本文借助 DDT 生成多样化多健康状态数据。

3.1 滚动轴承的虚拟表示

在为精准复现轴承振动特征与失效机理,本文以六自由度动力学模型作为虚拟映射:如图 3 所示,该模型将六个自由度分配至内圈、外圈与壳体部件。

该模型融合滚动体非线性接触、润滑油膜阻尼及缺陷效应等关键因素。运动方程基于 Hertz 接触理论建立,用以刻画滚动体与滚道间的弹性相互作用;针对不同故障类型,通过将几何缺陷参数与动态响应数据耦合,量化缺陷引发的位移扰动。非线性接触力由接触变形计算,速度相关阻尼则表征油膜效应。轴承系统微分方程见式 (2)。采用 Runge-Kutta 法数值求解,获得机匣振动位移,并通过二阶差分生成仿真加速度信号。详细建模流程与参数设置参见文献 [41]。该虚拟建模方式可大规模生成多故障数据集,服务于下游基础模型训练。
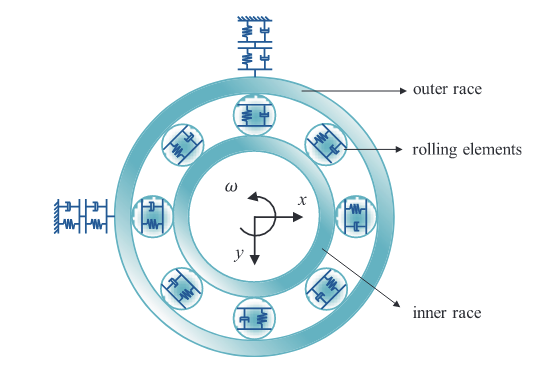
   

图3 滚动轴承的虚拟表示

3.2 虚拟-物理数据流融合

基于前期研究 [41,42,43],本文采用 CycleGAN架构建立虚拟域与物理域的双向数据转换,如图 4 所示。具体而言,该框架配置两对镜像对称的生成器-判别器,实现仿真振动信号与真实振动信号的循环映射。训练过程通过对抗损失与循环一致性损失的联合优化进行引导,其中对抗损失与循环一致性损失的比例设为 0.1 [41]。通过每对生成器-判别器之间的迭代对抗学习,仿真信号被转换为高保真的合成信号,即孪生信号。实验结果表明,这些孪生信号在波形特征上与实际测量数据高度一致,能够有效捕捉环境噪声及故障相关信息。因此,所生成的数据可直接用于故障诊断、剩余使用寿命预测等下游任务。更多实现细节参见文献 [41,42]。
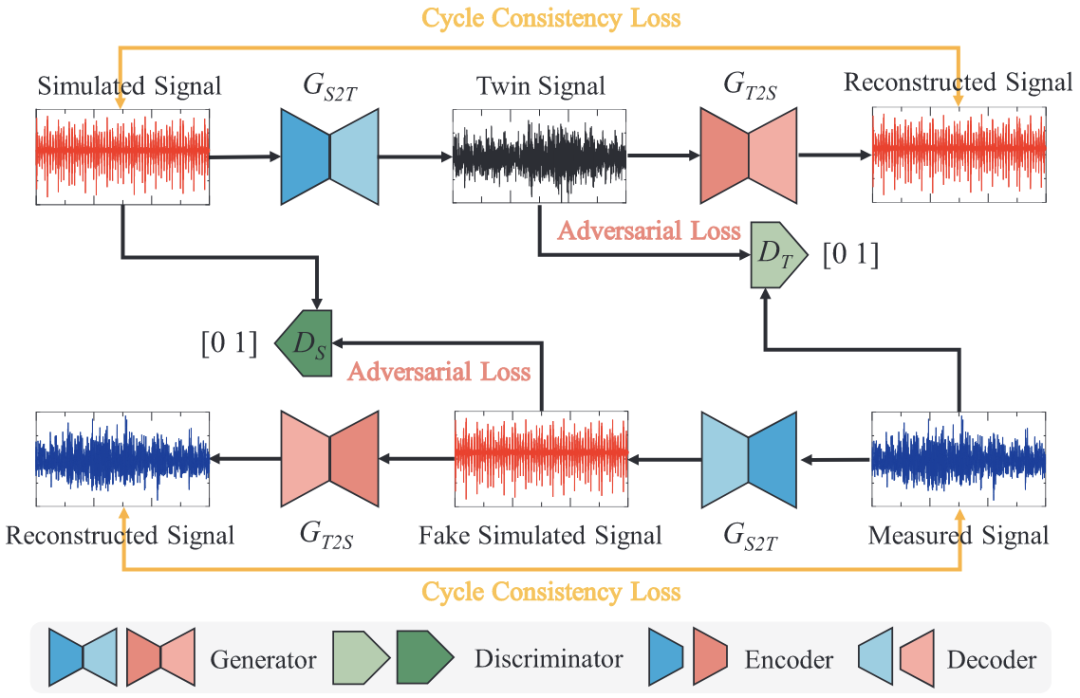
图4 基于CycleGAN框架的虚实数据流融合

4 所提出的大规模视觉—语言模型

为提升故障诊断的可及性与智能化水平,本文提出数字孪生驱动的大规模视觉-语言模型机械故障诊断框架。该框架实现 LVLM 在工业场景下的实用化部署,并缓解标注数据稀缺带来的训练瓶颈;通过将专家知识注入模型,进一步增强自动化能力,显著简化日常维护与巡检流程。

4.1 模型架构

DGLM 采用时–频谱图分析,以支持直观且高效的人机交互故障识别。如图 5 所示,整体框架由三大模块组成:数字孪生模块、信号预处理模块与 FDGLM。首先,通过虚拟–物理数据流集成构建深度数字孪生模型,生成大量孪生信号用于 FDGLM 训练。随后,信号预处理模块利用 STFT 将一维孪生信号转换为二维时–频谱图,使其格式与视觉模型输入要求对齐。为使视觉–语言模型适配机械系统的智能运维任务,采用两阶段微调策略,包括视觉与文本编码器适配;两阶段均使用 LoRA 技术实现高效参数调优。预训练 ViT 作为视觉编码器,经微调后增强从时频表示中提取故障相关模式的能力;同时,ChatGLM-6B 作为文本编码器。为使模型对齐领域特定知识(如诊断术语与推理逻辑),利用 LoRA 联合微调视觉与文本编码器,确保跨模态表征学习最优。QueryTransformer 模块通过可学习查询注意力机制,将提取的视觉特征转换为语义丰富的文本表示,从而桥接 ViT 与 ChatGLM-6B。

两阶段训练流程逐次优化视觉与文本模态:基于 LoRA的轻量适配在冻结绝大部分预训练编码器参数的同时注入领域知识,有效抑制灾难性遗忘。LoRA 层被选择性嵌入视觉与语言编码器的关键组件,使模型在可训练参数大幅减少的情况下仍获得与全参数微调相当的性能。第一阶段聚焦时频谱图的视觉特征抽取,第二阶段转向基于文本的故障理解与决策生成,最终形成覆盖数据解读与动态决策的闭环智能维护体系。
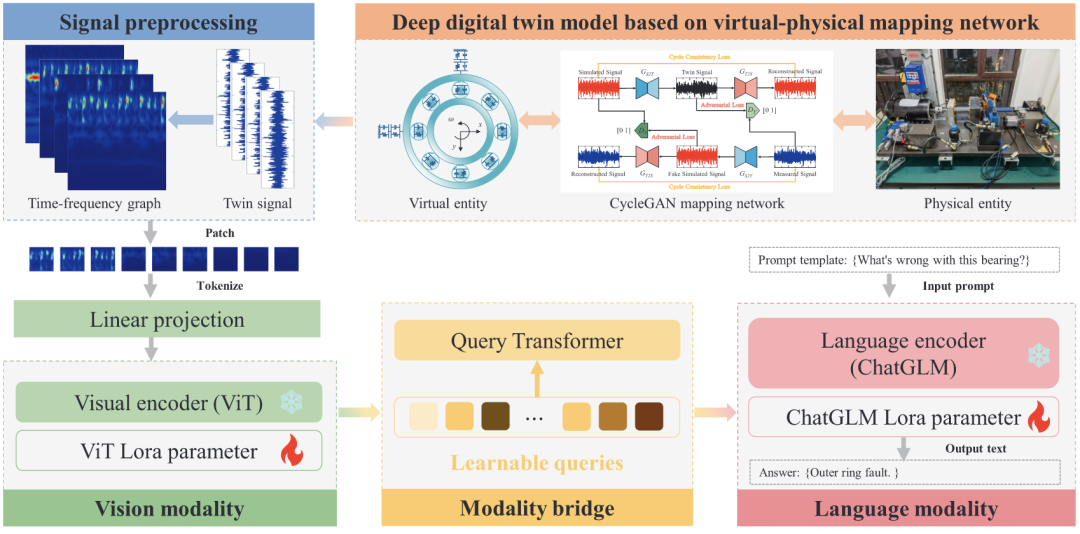
     

图5 基于深度数字孪生驱动LVLMs的故障诊断框架

4.2 预训练视觉模型的微调

在 FDGLM 框架中,ViT充当视觉模型的骨干。ViT 已在大规模公开图像数据集上完成充分预训练,对自然图像的视觉表征提取能力强劲 [44]。然而,由于振动信号谱图与常规图像在视觉特性上存在本质差异,若冻结视觉编码器、仅训练语言模型,效果并不理想。受近期研究 [32] 启发,我们采用 LoRA策略对预训练 ViT 进行微调,使其能够有效捕捉由振动信号生成的时频表示的独特特征。通过增强 ViT 对工业谱图的建模能力,框架得以提取更具判别力的故障特征,微调流程示于图 6。
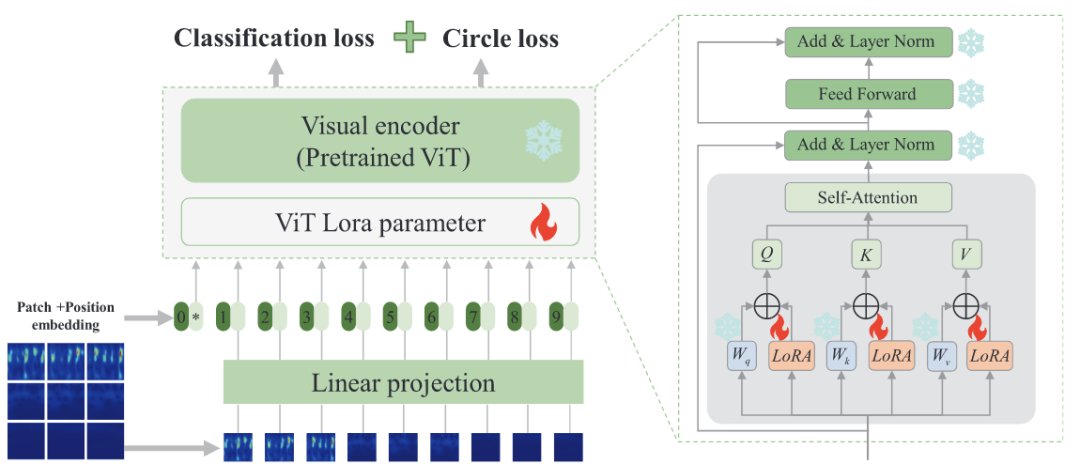
         

图6 基于LoRA的视觉模型微调

ViT的操作方式是将输入图像划分为固定大小的块,这些块随后作为顺序输入格式中的元素进行处理,如图7所示。对于尺寸为              的输入图像,该图像被重塑为大小为              ,其中              和              分别表示图像的高度、宽度和通道数。              是输入序列的长度,              是向量的维度。图像被均匀地划分为不重叠的块,并展平成一个维度为              的序列。生成的序列包含              个块,每个块被表示为维度为              的向量。为了捕获块级表示,每个块通过一个可学习的线性投影矩阵              投影到              维的潜在空间中,从而得到形状为              的统一表示矩阵。
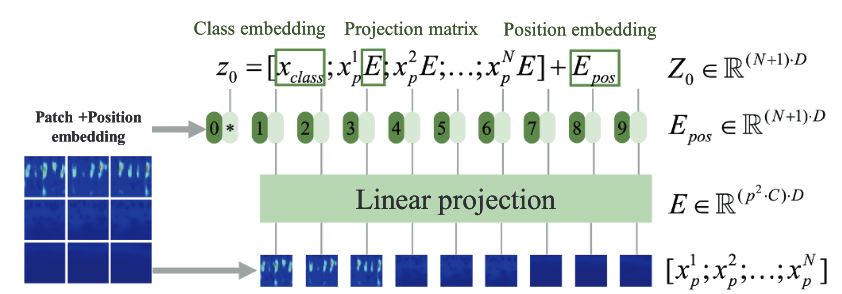
             

图7 图像块及位置嵌入示意图

 一个可学习的类标记,记为              ,被添加到块序列的前面,以聚合全局上下文并实现整体图像理解。为了保持块之间的位置信息关系,一个可学习的位置信息编码矩阵              被添加到嵌入的块序列中。在本研究中,使用正弦/余弦函数生成位置信息编码,如公式(3)所定义:

其中                和                分别表示位置编码向量中的偶数和奇数索引,               表示序列中每个标记的位置。正弦/余弦编码不仅捕获了相对位置的信息,还减少了序列表示中的冗余 [45]。经过上述变换后,最终的输入序列记为               。

综上,为在多状态且高质量数据稀缺的条件下构建智能对话诊断模型,本文提出数字孪生驱动的大规模视觉-语言故障诊断框架。主要创新包括:(1) 研发实用化数字孪生驱动视觉-语言诊断框架;(2) 利用数字孪生构建大规模高质量数据集,满足大规模模型训练需求;(3) 提出故障诊断视觉-语言模型,采用两阶段训练策略对视觉模块与语言模块进行渐进式微调;(4) 开展全面验证,证明该框架在单工况、跨工况及跨数据集场景下均具备智能化多场景诊断性能。本文结构如下:第二节回顾智能故障诊断与大规模模型相关研究;第三节阐述数字孪生模型;第四节介绍所提视觉-语言框架;第五节给出实验结果;第六节总结关键发现并展望未来研究方向。

其中              、              和               分别表示查询、键和值矩阵,                表示注意力头的维度。整合LoRA矩阵可以实现自注意力机制的自适应调节。如Eq.(1)式中,注意力矩阵的约束形式表示为:

如图6所示,微调过程冻结了ViT模型的所有预训练参数,只更新插入的LoRA矩阵。为了确保跨多个健康状态的准确分类,交叉熵损失被用作主要分类目标:

此外,为提升模型对振动信号时频表示中显著特征的敏感度,我们引入对比学习策略:构建正、负样本对,最大化正对相似度并最小化负对相似度;采用 Circle Loss 对该策略进行优化,从而增强模型在工况多变或设备差异下对同一故障类型的识别鲁棒性 [48]。

其中,               与                分别表示类内相似度与类间相似度;               与                分别为类间与类内阈值;               与                为非负权重系数;               为缩放超参数。Circle Loss 旨在最大化类内相似度并最小化类间相似度。第一阶段的总体损失函数由上述两项损失加权求和得到:

两项损失虽共同优化视觉特征表征,却各有侧重:交叉熵损失作为首要分类准则,为模型划定健康状态间的决策边界,实现故障精准归类;Circle 对比损失则提升模型对振动信号时频图中细微特征的敏感度,强化其捕获故障本质特性的能力,并促使所学特征更具判别力且工况不变,显著增强跨工况诊断的鲁棒性与泛化性。二者协同,既保证分类精度,又大幅提升模型的适应性与韧性。

4.3 查询变换器

由Salesforce Research开发的查询变换器(Q-Former:Query Transformer)是一种轻量级的变换器架构,有效地连接了预训练的视觉和语言编码器。它促进了强大的跨模态特征对齐和特定任务的适应。其主要目标是将视觉特征映射到大语言视觉模型的语义空间中,最小化参数更新,从而最大限度地重用冻结的预训练组件。

如图 8 所示,Q-Former 从冻结的 ViT 编码器提取的特征中构建一组可学习的视觉查询向量;这些查询向量捕获特定语义属性,如故障类别与缺陷尺寸。Q-Former 架构包含三大关键模块:交叉注意力、自注意力与前馈神经网络。在交叉注意力层,查询向量与视觉 token 交互,提取与文本数据语义对齐的任务相关信息;自注意力机制随后促进查询间的内部交互,增强语义一致性;所得表征经前馈网络进行非线性变换并调整输入格式。通过多个 Q-Former 块后,输出的查询向量封装高级视觉语义,并被送入语言编码器进行联合训练。为优化 Q-Former 的表征能力,Salesforce Research 引入多目标优化策略,最小化文本对比损失、文本匹配损失及图像条件文本生成损失。更多实现细节参见文献 [49]。
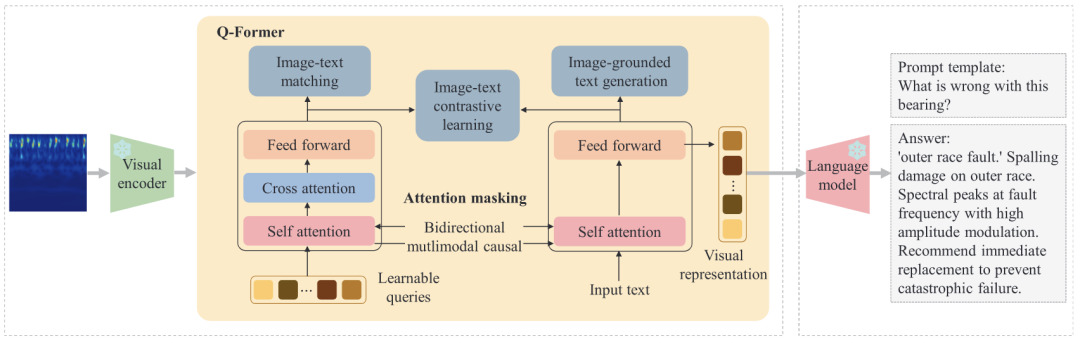
         

图8 Q - Former的架构

通过使用可学习的查询向量,Q-Former 有效地融合了视觉和语言表示。它无缝地融入了所提出的两阶段训练策略中,使视觉特征与文本语义对齐,并使大型语言模型能够基于视觉上下文生成连贯且特定领域的文本输出。

4.4 预训练语言模型的微调

在本小节中,预训练的 ChatGLM-6B 语言模型采用 LoRA 方法进行微调,以优化其在工业故障诊断任务中的性能。通过利用定制设计的图文配对数据集,微调后的模型能够从文本描述中提取与故障相关的特征,并将其与相应的故障模式关联。此外,该模型对特定任务要求的理解得到了提升,能够生成准确且具上下文感知的文本解释。在智能维护的全面知识基础支持下,该模型还提供简洁且可行的建议,以辅助操作决策。图文数据集构建的详细信息见第 5.1 节。

如图9所示,诊断文本首先被切分为适合模型处理的离散单元;随后这些 token 被嵌入为连续向量,以捕获文本的语义内容。对于给定文本序列               ,嵌入过程生成向量表示               ,其中                为将序列映射至潜在语义空间的嵌入函数 [7]。通过 Q-Former 生成的时频视觉 token 与文本 token 拼接,形成多模态 token 流;该统一表征被送入预训练语言模型进行进一步微调。按照与视觉编码器相同的调参策略,在语言模型选定的自注意力层插入 LoRA 矩阵;优化目标采用自回归损失函数:

其中              表示长度为              的输出序列中的第 t 个标记。自回归损失使模型能够生成在语法和语义上与诊断上下文一致的响应,从而产生富有洞察力的健康评估和可实施的维护建议。
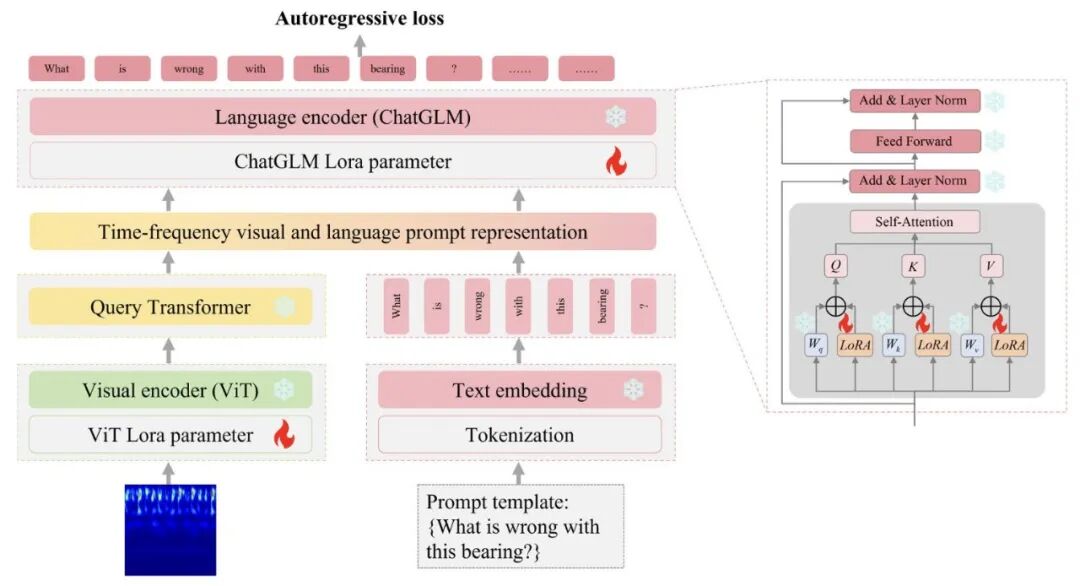
         

图9 基于LoRA的语言模型微调

4.5 实现流程

总而言之,FDGLM 框架通过基于 LoRA 技术的两阶段微调流程,将通用视觉-语言模型转化为面向故障诊断的领域专用系统;该策略同时实施视觉与语言适配,以提升诊断任务性能。第一阶段(视觉模型微调)包含三个主要步骤:(1)利用 STFT 将合成孪生信号转为二维时频表示,形成大规模图像数据集;(2)预训练视觉编码器提取可捕获关键故障特征的判别特征;(3)构建正、负样本对,并通过联合最小化分类损失与 Circle 损失,使用 LoRA 微调视觉编码器,从而增强特征判别力与模型鲁棒性。第二阶段(语言模型微调)包括四个关键步骤:(1)构建配对的图像-文本数据集,涵盖视觉特征与故障语义描述;(2)使用已微调编码器提取视觉特征,确保跨模态一致性;(3)Query Transformer 将视觉特征投影至语言嵌入空间,并与文本 token 融合,生成统一的多模态表征;(4)采用自回归损失对经 LoRA 增强的语言模型进行微调,以产生连贯且任务特定的文本输出。通过该两阶段流程,FDGLM 在多种工业场景的智能故障诊断中展现强劲性能,提供可扩展且可泛化的解决方案。  

编辑:赵栓栓

校核:李正平、陈凯歌、曹希铭、赵学功、白亮、任超、海洋、陈宇航、Kira、Tina、王金、赵诚、肖鑫鑫、张优

该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除


来源:故障诊断与python学习
ACTMechanicalSystem振动非线性旋转机械通用航空航天python海洋LMS裂纹理论电机传动数字孪生控制人工智能数控
著作权归作者所有,欢迎分享,未经许可,不得转载
首次发布时间:2026-02-05
最近编辑:8月前
故障诊断与python学习
硕士 签名征集中
获赞 87粉丝 153文章 336课程 0
点赞
收藏
作者推荐

特征解耦与节点优选|面向多传感器设备寿命预测的抗干扰图神经网络框架

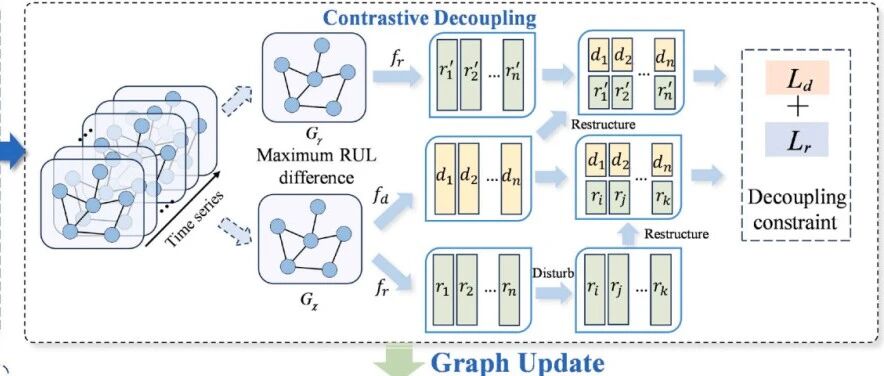
本期聚焦多传感器设备剩余寿命预测的关键挑战:在复杂工况下,设备性能退化往往通过多源传感器信号呈现高维、耦合的动态演化模式,而传统图神经网络方法常因共享节点特征导致预测任务与依赖建模间的信息冲突,且缺乏对弱相关节点的有效筛选机制,限制了预测精度与鲁棒性。为此,本文提出了一种基于对比解耦图神经网络与偏差‑扩散性协同节点选择器的新框架。该框架通过节点特征对比解耦模块将特征显式分解为面向寿命预测的全局退化特征和面向关系建模的局部关联特征,并结合任务驱动的对比约束确保信息独立性与任务相关性;进一步设计偏差‑扩散性协同节点选择器,依据特征偏差与信息扩散能力自适应滤除冗余节点,显著提升模型抗干扰能力。在公开数据集与实际风电机组预测任务上的实验表明,该方法在保持高精度的同时具备优异的工程实用性。论文基本信息论文题目:Contrastive decoupling graph neural network with deviation-diffusivity cooperative node selector for equipment remaining useful life prediction 论文期刊:Reliability Engineering and System Safety论文日期:2026年论文链接:https://doi.org/10.1016/j.ress.2025.111923作者:Yi Qin (a†), Linjie Zheng (a†), Jun Luo (a), Junyu Qi (b), Yongfang Mao (c*)机构: a. State Key Laboratory of Mechanical Trans mission for Advanced Equipment, Chongqing University, Chongqing 400044, China;b. Reutlingen Research Institute, Reutlingen 72762, Germany;c. College of Automation, Chongqing University, Chongqing 400044, China通讯作者简介:毛永芳老师,现任重庆大学自动化学院副教授。毛老师长期致力于智能运维与故障预测领域的前沿研究,主要研究方向包括半监督/无监督学习方法、智能故障预测与诊断、运行安全评估与控制等,并在机理与数据融合建模、多模态表征与融合、跨域迁移诊断等方面开展了系统深入的探索。在科研项目方面,她主持了国家自然科学基金面上项目“物理约束下液氢加注系统多模态融合表征模型及迁移诊断方法”等多项国家级课题。相关研究成果已在《IEEE Transactions on Industrial Informatics》、《Mechanical Systems and Signal Processing》等高水平期刊上发表论文。(来源: https://accu.cqu.edu.cn/info/1376/9186.htm)目录1 摘要2 引言3 相关工作3.1 基于RNN的剩余使用寿命预测方法3.2 基于CNN的剩余使用寿命预测方法3.3 基于GNN的剩余使用寿命预测方法4 提出的剩余使用寿命预测方法4.1 图结构构建4.2 节点特征对比解耦模块4.3 图更新机制4.4 偏差-扩散性协同节点选择器4.5 损失函数设计4.6 剩余使用寿命预测流程5 实验结果与验证5.1 评价指标5.2 研究 I:CMAPSS数据集剩余使用寿命预测5.3 研究 II:TWM数据集剩余使用寿命预测5.4 研究 III:风力涡轮机剩余使用寿命预测6 结论1 摘要图神经网络(GNN)已在多源信息融合驱动的RUL预测中得到广泛应用。然而,传统的基于GNN的方法通常使用共享的节点特征同时进行RUL预测与空间依赖关系建模,这可能导致隐性的信息冲突。此外,现有方法缺乏有效机制以识别弱相关节点,使得预测精度易受噪声干扰。为化解潜在的信息冲突,本文提出一种新颖的节点特征对比解耦模块( Node feature contrastive decoupling module, NFCDM)。该模块采用交叉融合-对比解耦策略,将节点特征显式分解为面向RUL预测的全局退化特征和面向空间依赖关系建模的局部关系特征。进一步设计面向任务的对比解耦约束机制,确保解耦后特征兼具任务相关性与信息独立性。此外,为实现有效的节点筛选,本文提出一种偏差-扩散性协同节点选择器(Deviation-diffusivity cooperative node selector, DDCS)。该选择器能够基于全局退化特征的偏差值及节点的信息扩散能力构建联合评估指标,从而自适应地剔除冗余节点。基于以上两个创新模块,本文构建了融合偏差-扩散性协同节点选择器的对比解耦图神经网络(Contrastive decoupling graph neural network with deviation-diffusivity cooperative node selector, CDGNN-DDCS)用于RUL预测。在多个公开数据集上的对比实验验证了所提方法的优越性。最后,通过对实际风力发电机开展的RUL预测实验,成功验证了该方法的工程实用性。关键词:剩余使用寿命预测;特征解耦;图神经网络;多传感器信息融合2 引言预测与健康管理(Prognostics and Health Management,PHM)是一种通过实时监测机械系统运行状态,实现故障预测、诊断及维护决策的先进技术框架。作为PHM的核心组成部分,剩余使用寿命(Remaining Useful Life,RUL)预测已成为可靠性工程领域的重要研究焦点。RUL预测通过分析多源运行数据,估算系统从当前状态到其失效阈值的剩余时间间隔,从而为优化基于状态的维护策略提供关键决策依据。工业大数据与计算能力的快速发展,使得基于深度学习的方法能够通过自主特征提取和非线性退化建模,在RUL预测领域取得显著进展。其中,利用循环神经网络(Recurrent Neural Network, RNN)、卷积神经网络(Convolutional Neural Network, CNN)和图神经网络(Graph Neural Network, GNN)的RUL预测方法已成为主流研究方向并广受关注。然而,基于RNN和CNN的方法通常将多源监测数据视为独立的时间序列或仅进行简单堆叠,因此无法显式建模传感器网络内部的空间依赖性。在复杂的工业机械系统中,多源监测数据往往表现出异构性和空间分布特征。传感器节点间的拓扑结构等关键空间关联尚未得到充分利用。CNN受限于局部感受野的规则网格结构,而RNN则仅侧重于时间动态性。这些方法难以刻画节点间的空间交互作用,从而限制了RUL预测的精度与泛化性能。将多源传感器监测系统抽象为图结构数据,使得传感器网络内部的拓扑关系得以显式数学表征。其中,节点代表嵌入监测特征的传感器单元,边则定义传感器节点之间的功能连接。作为建模非欧几里得空间数据的强大表征工具,GNN能够自适应地聚合多跳邻域节点的信息并揭示潜在的空间依赖关系。传统的深度学习方法依赖单维度的时间建模,而基于GNN的框架则将传感器网络内部的空间关系与相应的监测特征相融合,从而能够实现更丰富的多维度表征。这种融合显著提升了复杂工况下的RUL预测精度。尽管基于GNN的RUL预测取得了一定进展,但仍存在若干关键局限。首先,大多数现有方法未能充分认识到特征解耦的潜在优势,通常使用相同的节点特征同时进行RUL预测和空间依赖建模。这种做法可能导致特征学习目标冲突:空间依赖建模侧重于捕捉节点间的局部关联,而RUL预测则要求节点特征表征设备的退化状态。当两项任务共享同一特征表示时,节点嵌入必须同时编码退化信息和拓扑关系,往往导致特征纠缠。在复杂工况下,这种纠缠不利于退化特征的有效表达,进而降低预测性能。值得注意的是,尽管特征解耦方法已在其他领域提出,但这些方法通常无法保证解耦后的特征既相互独立又具备任务相关性。其次,工业监测系统中冗余或弱相关的传感器节点会引入噪声、弱化关键退化特征并干扰全局表征学习。因此,有效筛选有价值的节点至关重要。例如,大型风力涡轮机通常在关键部件上安装大量传感器,用于监测风速、发电机温度等多种运行参数,这些多源传感器数据中常存在冗余。例如,在相同负载条件下,发电机输出功率与扭矩往往高度同步;位于同一区域或相邻部件上的温度传感器也可能记录高度相似的温度变化模式。此外,由于风力涡轮机长期在恶劣户外环境中运行,传感器易受潮湿和极端温度影响,导致性能下降或测量噪声。若此类传感器数据未经适当滤除,不仅会增加计算负担,还会稀释关键退化信号的有效性。本文提出了一种融合偏差-扩散性协同节点选择器的对比解耦图神经网络,以应对多传感器设备RUL预测中的上述问题。在该框架中,所提出的节点特征对比解耦模块旨在解决上述第一个问题。该模块将节点特征解耦为两类:用于剩余寿命预测的全局退化特征和用于空间依赖建模的局部关系特征。为增强解耦特征的任务相关性和独立性,该模块采用一种交叉融合-对比解耦策略,将两类特征在图内和图间进行重组,并基于重组后的表示构建针对特定任务的解耦约束,从而有效缓解任务无关信息的干扰。为克服上述第二个问题,提出了偏差-扩散性协同节点选择器。该模块通过设计的特征偏差因子有效量化退化特征的异常程度,并将此偏差因子与节点的信息扩散能力相结合,构建联合评估指标。因此,该选择器能够自适应地滤除冗余节点,有效抑制特征聚合阶段冗余或弱相关节点造成的干扰,从而增强模型在复杂工况下刻画退化趋势的能力。本文的主要贡献总结如下:为缓解因不同任务需求引发的潜在特征冲突,提出了节点特征对比解耦模块。该模块采用精心设计的交叉融合对比解耦策略,将两类解耦特征在同一图内或不同图间进行交叉组合,生成新的融合表示。基于这些表示,为RUL预测和空间依赖建模任务构建定制化解耦约束。该策略显著增强了解耦特征的任务相关性和信息独立性。为减轻冗余传感器的影响,提出了偏差-扩散性协同节点选择器。该模块同时考虑节点特征的偏差和节点的信息扩散能力,能够在不引入额外训练参数的情况下实现自适应节点选择。开发了一种基于上述两个模块的新型对比解耦图神经网络,用于多传感器设备RUL预测。在CMPASS和TWM数据集上的实验表明,所提方法在两项预测评估指标上均优于现有先进方法。3 相关工作3.1 基于RNN的剩余使用寿命预测方法循环神经网络及其变体,例如长短期记忆网络和门控循环单元,在时序建模方面具有固有优势,因此已被广泛应用于剩余使用寿命预测任务。然而,基于循环神经网络的方法在训练效率和模型复杂度方面仍然存在一定的局限性,并且在捕捉多源传感器数据间的空间相关性方面能力不足。3.2 基于CNN的剩余使用寿命预测方法 卷积神经网络擅长局部特征提取和分层表征学习,近年来在剩余使用寿命预测任务中的应用日益增多。通过采用一维或二维卷积运算,卷积神经网络能够有效地从监测信号中捕获局部模式和退化特征。与循环神经网络相比,卷积神经网络在并行计算和训练效率方面具有优势;然而,其建模能力通常局限于局部邻域,这使得其难以充分捕捉多源传感器之间的全局依赖关系。3.3 基于GNN的剩余使用寿命预测方法随着图神经网络的发展,越来越多的研究尝试利用图神经网络进行剩余使用寿命预测。与循环神经网络和卷积神经网络不同,图神经网络能够在图结构上直接进行特征传播与聚合,从而对传感器之间的非欧几里得拓扑关系进行建模。基于图神经网络的方法在建模多源数据的复杂依赖性方面展现出显著优势,但仍存在一定的局限性。首先,现有方法通常使用同一组节点特征同时服务于剩余使用寿命预测和空间依赖建模,却忽略了这两项任务对特征表示的不同需求,这容易导致潜在的特征冲突,进而削弱模型性能。其次,大多数现有方法依赖注意力机制来过滤冗余节点,这不仅会显著增加训练时的参数量和计算成本,而且未能充分考虑节点在图中的相对位置及其对全局表征的贡献。4 提出的剩余使用寿命预测方法本文提出的基于CDGNN-DDCS的多传感器设备剩余使用寿命预测方法基于以下关键假设。首先,设备的传感器数据可表示为图结构,其中节点对应单个传感器,边表示传感器间的关联关系,并假设该图结构能有效捕捉传感器间的依赖关系。其次,节点特征可解耦为两个相互独立的特征:用于剩余使用寿命预测的全局退化特征和用于建模空间依赖性的局部关系特征,且这些特征可在模型训练过程中有效解耦。最后,通过图卷积或消息传递机制,节点特征的聚合能够充分捕获来自相邻节点的信息,而不会引入显著的信息损失。所提方法的整体框架如图 1 所示。此外,本节将对其各组成部分进行详细阐述。 图1. 基于CDGNN-DDCS的多传感器设备RUL总体框架4.1 图结构构建在多传感器数据处理中,从不同传感器采集的数据通常反映了系统的不同属性,这些属性之间常通过复杂的空间依赖性相互关联。多传感器数据可建模为图数据,以捕捉并分析这些潜在关系,从而提取传感器间丰富的空间依赖信息。在图数据中,每个传感器被抽象为一个节点,而节点之间的边则编码了传感器之间的空间依赖关系。给定图 ,其中 表示节点特征集 合, 表示边集 合, 为节点总数。设 代表从 个传感器采集的数据。本文利用长短期记忆网络捕捉每个传感器数据中的时序依赖性,并将其输出的嵌入向量作为图的初始节点特征。该过程描述如下: 其中,表示图中第 个节点的初始特征, 为LSTM输出的嵌入维度。初始边 按以下方式确定: 其中, 用于衡量传感器数据间的相似度。本文采用余弦相似度作为默认的度量方法,但点积或可学习的神经网络等其他方法同样适用。4.2 节点特征对比解耦模块理想情况下,解耦后的特征应具有高独立性且与各自任务高度相关。具体而言,全局退化特征应仅包含与RUL预测直接相关的信息,而局部关系特征则应仅保留建模空间依赖所需的关键属性。为此,本文提出了节点特征对比解耦模块以实现上述目标(图2)。 图2. 通道注意力- Inception-Unet 框架该模块将每个节点的特征解耦为用于RUL预测的全局退化特征和用于空间依赖建模的局部关系特征。首先进行图内交叉融合:将一个节点的全局退化特征与另一个节点的局部关系特征组合,通过对比融合前后特征在空间依赖建模任务中的差异,构建相应的解耦约束项。随后进行图间交叉融合:选取来自两个RUL标签差异显著的图中的节点,将其全局退化特征与局部关系特征进行融合,在RUL预测任务中计算融合特征与原特征的差异,形成对应的解耦约束项。这两项约束共同增强了全局退化特征与局部关系特征的独立性,减少了语义干扰,从而提升了模型在RUL预测中的判别能力与泛化性能。其实现过程如下:设 表示第 层中节点 的特征。随后通过两个独立的解耦网络 和 分别进行处理,得到全局退化特征 与局部关系特征 。该过程可形式化表示为: 其中, 用于 RUL 预测, 用于空间依赖关系建模。如前所述, 应排除与空间依赖建模相关的信息,而 则应排除与 RUL 预测相关的信息。然而,仅通过两个独立的解耦网络难以实现精确的特征分离。因此,本文引入了两项附加约束项以强化解耦效果。首先,令 表示局部关系特征矩阵, 表示全局退化特征矩阵。对 的行进行随机打乱以生成 ,如下所示: 其中,表示置换矩阵。随后,将 与 融合以生成新的特征矩阵 ,具体如下所示: 其中, 表示 中的特定行向量,其计算方式如下: 其中, 表示逐元素相加操作。接着,通过计算 与 中其他行向量的相似度,得到向量 : 其中, 代表相似性度量网络,该网络包含三个全连接层。其最后一层全连接层由单个神经元构成,并采用Sigmoid激活函数输出相似度评分。 在信息充分分离的条件下, 与其他节点间的空间依赖关系应与 完全相同,即: 因此,可以为空间依赖建模任务构建如下的解耦约束项: 接下来,将另一个解耦约束项应用于RUL预测任务。设 表示网络第 层的图集 合。从该集 合中随机选取一个图 ,则必存在另一个图 使得下式成立: 其中, 与 分别表示对应于图 与 的真实剩余使用寿命值。随后,通过对 和 进行节点特征解耦,可分别得到解耦后的特征矩阵:对于 ,获得关系特征矩阵 与退化特征矩阵 ;对于 ,获得关系特征矩阵 与退化特征矩阵 。接着,将 与 融合,得到 ,其计算公式如下所示: 此处, 融合了 中用于空间依赖建模的信息与 中用于剩余使用寿命预测的信息。因此,基于 得到的剩余使用寿命预测值应接近于基于 的预测结果。于是,可以推导出剩余使用寿命预测任务的解耦约束项如下: 其中, 表示剩余使用寿命预测网络,该网络由两个全连接层构成。在构建上述两项面向特定任务的约束项后,经过训练,网络应实现如下目标: 可以看出,对于 , 与 是分别添加到 和 的扰动项;类似地,对于 , 是添加到 的扰动项。因此,通过所提出的交叉融合‑对比解耦策略,能够提高解耦特征的独立性及任务针对性。与此同时,网络在提升鲁棒性的过程中,其抗干扰能力也得以增强。 4.3 图更新机制 局部关系特征用于衡量节点间的连接性。当前层的边可基于当前层的局部关系特征与前一层提供的边信息推导得出: 其中, 表示第 层节点 与节点 之间的边。更新后的边将随后用于同步更新全局退化特征与局部关系特征,其计算过程描述如下: 其中, 表示特征解耦更新网络,该网络由两个全连接层构成。最终,将 与 重新耦合,并输入至下一层进行进一步解耦。该耦合过程表述如下: 其中, 表示特征耦合网络,该网络同样由两个全连接层构成。4.4 偏差-扩散性协同节点选择器 基于图神经网络的RUL预测方法通常聚合图中所有节点的信息,以实现对目标任务的准确预测。然而在实际应用中,图中可能包含冗余节点,且部分节点的全局退化特征易受噪声干扰。这会增加全局信息聚合的复杂度,并削弱图的整体表征能力。本文提出的DDCS通过设计的特征偏差因子量化节点全局退化特征的偏离程度,并结合节点的信息扩散能力构建联合评估指标,使模型能够自适应地剔除冗余或无效节点,从而更聚焦于关键的退化特征。DDCS的结构如图 3 所示。 图3. DDCS框架 值得注意的是,DDCS不引入额外的训练参数,其实现过程如下。首先,基于 获得初始的图全局表征 : 令 与 分别表示 与 中的第 个元素。本文采用信息熵来衡量节点特征的偏差: 的值越低,意味着 在某些特征维度上可能与总体存在显著偏差;反之, 较高时,虽不表明存在局部维度偏差,却可能提示 发生了均匀的多维度整体偏移。因此,本研究构建了特征偏差因子,旨在综合识别这两种不同的异常模式: 该值越小,表明该节点存在特征偏差的可能性越高。随后,将节点的信息扩散能力纳入 联合评估指标的构建中。设 表示第 层的邻接矩阵, 代表 第 行元素的总和, 表示 所有元素的总和。节点 的信息扩散能力定义如下: 值越高,表明节点 对其他节点具有更大的影响力。节点 的联合评估指标 可基于 和 计算得出: 随后,通过执行择优排序操作,将待丢弃节点的全局退化特征设置为零,从而得到更新后的全局退化特征矩阵 : 其中, 表示待丢弃的节点数量, 为掩码矩阵。最终,重构后的图全局表征 可通过下式获得: 4.5 损失函数设计经过L层网络更新后,利用所有层重构的全局表征获得最终预测的RUL: 其中, 表示模型预测的剩余使用寿命。本文所提模型的损失函数定义如下: 其中,均方误差损失用于量化实际剩余使用寿命与预测剩余使用寿命之间的差异, 和 为超参数。4.6 剩余使用寿命预测流程 本文提出的基于CDGNN-DDCS的RUL预测方法详细流程如图 4 所示,展示了从多源传感器数据输入到剩余使用寿命预测的整体步骤。 图4. 基于CDGNN-DDCS的剩余使用寿命预测流程图为便于更直观地理解方法实现,表1给出了所提算法的伪代码。表1 所提剩余使用寿命预测方法伪代码 5 实验结果与验证为系统评估所提方法的有效性与优越性,本节在商用模块化航空推进系统仿真(CMAPSS)数据集和刀具磨损监测(TWM)数据集上,与多种先进方法进行了综合对比。此外,通过在实际风力涡轮机的剩余使用寿命预测任务上进行验证,以评估该方法在真实工业场景中的适用性。5.1 评价指标本文采用均方根误差与评分函数两项指标评估模型性能。均方根误差是评估回归模型的常用指标,其计算如式所示: RMSE可用于衡量预测值与真实值之间的偏差,适用于评估模型的整体预测精度,其值越小表明模型性能越好。均方根误差可衡量预测值与实际值之间的偏差,适用于评估模型的整体预测精度,其值越小表明模型性能越好;评分函数则是专为剩余使用寿命预测任务设计的评估指标,其计算定义如下: 该评分函数引入了指数化惩罚机制,针对提前预 测和滞后预测施加差异化惩罚,从而能够在不同预测阶段对模型性能进行更为全面的评估。评分函数的值越低,表明模型的预测性能越好。5.2 研究 I:CMAPSS数据集剩余使用寿命预测5.2.1 CMAPSS数据集描述与预处理 CMAPSS数据集由美国国家航空航天局(NASA)开发,是RUL预测研究中广泛使用的基准数据集。该数据集通过高保真涡轮风扇发动机仿真模型生成,包含四个子集(FD001–FD004)。每个子集模拟了21个传感器在不同故障模式与运行工况下的监测数据。本研究选取其中14个传感器进行RUL预测,编号分别为2、3、4、7、8、9、11、12、13、14、15、17、20和21。为便于后续预测任务,传感器监测数据采用最大-最小归一化方法进行标准化处理。为生成深度学习模型可直接使用的训练样本,采用滑动时间窗口法对每个序列进行分段处理:设定窗口长度为 ,步长为1,将每台发动机的监测数据划分为多个重叠的子序列。每个子序列包含 个连续时间步,其标签定义为该子序列末时间步对应的真实RUL值。四个子集的详细规格如表2所示。表2 CMAPSS数据集详情 5.2.2 实验配置 本实验训练过程中采用Adam优化器,使用其默认超参数,批处理大小设为128,总训练轮数为200。初始学习率设置为 。所提模型在CMAPSS数据集上的超参数设置如表3所示。表3 CDGNN-DDCS在CMAPSS数据集上的参数配置 5.2.3 在CMAPSS数据集上的性能比较 为验证所提出的CDGNN-DDCS的性能,本研究将其与九篇文献中的方法进行了比较。对比方法包括基于RNN的方法(BiGRU-TSAM、DA-LSTM)、基于CNN的方法(STRUL、AMST-GATE);基于GNN的方法(GAT-DAT、MST-GAT、HAGCN、ConvGAT、MGCAL-UQ与GCN-PR)以及混合GNN-Transformer方法(NSD-TGTN、DVGTformer、FIT-GSTM与GF-GGAT)。与RNN和CNN方法的对比验证了GNN在RUL预测中的显著潜力;而与GNN方法及混合GNN-Transformer方法的对比则凸显了本研究所提网络的优越性。 表4 各方法在CMAPSS数据集上的实验结果对比 表4展示了所有方法在CMAPSS数据集上的RMSE与SF值。实验结果表明,CDGNN-DDCS在CMAPSS数据集上的整体性能显著优于其他方法,体现了其在RUL预测任务中的优越性。值得注意的是,由于对多源传感器数据间空间信息的利用不足,BiGRU-TSAM、DA-LSTM和STRUL等方法相较于HAGCN、MST-GAT等GNN方法在综合性能上表现较弱,这一对比验证了GNN在RUL预测应用中的巨大潜力。此外,与这些先进的GNN方法及混合GNN-Transformer方法的比较结果,也验证了本文提出的NFCDM和DDCS模块的有效性。 图5对比了CDGNN-DDCS预测的RUL与CMAPSS四个子集中的真实RUL。预测RUL与真实RUL表现出高度一致性,与表5中的结果相吻合,进一步证明了CDGNN-DDCS在RUL预测中的可行性。 图5. 所有测试发动机实际与预测剩余使用寿命对比5.2.4 消融实验 本节通过一系列消融实验来评估CDGNN-DDCS模型中各组件对整体性能的影响。具体设计了四种模型变体:(1)模型1:移除NFCDM和DDCS模块;(2)模型2:移除DDCS模块,并使用两个独立的神经网络进行节点特征解耦;(3)模型3:仅保留NFCDM模块;(4)模型4:仅保留DDCS模块。 所有其他配置在模型间保持一致,以确保公平比较。表5和表6总结的实验结果表明,完整的CDGNN-DDCS模型在所有四个子数据集上均优于四个消融变体。表5 各模型的均方根误差评估结果 表6 各模型的评分函数评估结果 值得注意的是,模型3的性能优于模型2,这表明得益于所提出的两项面向特定任务的解耦约束,NFCDM有效改善了特征解耦效果。模型1与模型4的对比证实了DDCS通过剔除冗余节点提高了模型的RUL预测性能。综上所述,CDGNN-DDCS模型中的各个组件对其整体性能的提升均不可或缺。 图6. 特征可视化结果 图6展示了CDGNN-DDCS与模型1在FD001和FD003数据集上的特征可视化结果,以证明所提CDGNN-DDCS的优越性。由于具备节点特征解耦能力,CDGNN-DDCS实现了更优的任务级特征优化,因此其提取的特征相比缺乏特征解耦的模型1呈现出更显著的退化趋势。 图7. 解耦特征可视化结果此外,图7展示了所提模型在FD001子集上的特征解耦可视化结果,可以看出全局退化特征与局部关系特征之间存在显著差异,这表明两项任务对特征的需求各不相同。5.2.5 模型复杂度分析 为评估所提方法在工业应用中的可行性,本节对模型进行了系统的计算复杂度分析。设 为批量大小, 为图中节点数量, 为节点特征的维度。与基线模型相比,所提方法因引入NFCDM和DDCS模块而产生了额外开销。NFCDM在训练阶段增加了 的时间复杂度和 的空间复杂度,而在测试阶段其时间复杂度降至 。DDCS模块则引入了 的时间复杂度和 的空间复杂度。表7 模型复杂度与性能对比分析 如表7所示,本文从参数量、运行时间等方面将所提CDGNN-DDCS与标准GCN及开源方法GGCN进行了对比。CDGNN-DDCS中的NFCDM包含两个特征解耦网络和一个特征耦合网络,而DDCS模块本身不包含可训练参数,因此所提方法并未引入过多的额外参数量。此外,NFCDM仅在训练阶段构建两个解耦约束项,在测试阶段不会显著增加计算时间。相比之下,GGCN的参数量和运行时间均有大幅增加,但其性能提升却较为有限。而CDGNN-DDCS仅以轻微的计算开销增长,即实现了显著的模型性能提升。对比结果表明,CDGNN-DDCS在性能与效率之间实现了有效平衡,为在工业应用中部署高性能图神经网络提供了实用且高效的解决方案。5.3 研究 II:TWM数据集剩余使用寿命预测5.3.1 TWM数据集描述与预处理 刀具磨损监测数据集源自PHM学会主办的"刀具健康预测"竞赛,是机械领域PHM研究的重要基准数据集。实验所用平台如图8所示。该数据集使用多种传感器记录了高速CNC机床球头铣刀整个生命周期内的信号,包括X、Y、Z三个方向的切削力、振动信号以及声发射信号的均方根值。数据采集覆盖了刀具的整个生命周期,通过六次独立的重复实验产生了六个子数据集,分别标记为C1、C2、C3、C4、C5和C6。每个子数据集对应一把新刀具从初始状态到失效的完整磨损过程,记录了每个切削周期的多通道传感器信号以及人工标注的实际磨损测量值。 图8. 数据采集实验平台 在本研究中,仅选取了带有标注的子数据集C1、C4和C6进行实验。这些子数据集不仅包含全生命周期传感器数据,还提供了每个周期对应的剩余切削周期数,可直接用于RUL预测模型的训练与验证。在特征构建方面,从七类传感器信号中提取均方根值作为原始特征。针对每个切削周期,以适当间隔采样30个均方根测量值作为节点特征来构建图表征,使得每个图的初始节点特征维度为30。每个周期对应的剩余切削周期数则被视为相应图样本的RUL标签。5.3.2 实验配置本研究采用 3 折交叉验证策略,在 TWM 数据集上设置了三个预测任务。具体而言,每次选取其中两个子集作为训练集,剩余一个子集作为测试集。三项任务的具体配置细节如表 8 所示。表 9 列出了 CDGNN-DDCS 在三项任务中的超参数设置。与案例研究 I 类似,采用 Adam 优化器更新网络参数,初始学习率为 ,批处理大小设为 128 ,训练轮数为 500 轮。表8 TWM数据集预测任务配置表9 CDGNN-DDCS在TWM数据集上的参数配置 5.3.3 在TWM数据集上的性能比较 为评估所提CDGNN-DDCS的优越性,选取了七种对比方法(STRUL、TCN-SA、HAGCN、MST-GAT、GAT-DAT、NSD-TGTN和AMST-GATE)进行比较。相应的实验结果如表10所示。 表10 各方法在TWM数据集上的实验结果 结果表明,CDGNN-DDCS的整体性能显著优于所有其他方法。图9展示了CDGNN-DDCS在各任务上的预测结果,显示其预测RUL与实际RUL具有高度一致性。图10展示了CDGNN-DDCS在三个任务上的特征可视化结果。CDGNN-DDCS提取的特征呈现出清晰的退化趋势。因此可以得出结论,所提出的CDGNN-DDCS在RUL预测中表现出卓越的性能。 图9. 三项任务的剩余使用寿命预测结果 图10. 三项任务的特征可视化结果5.3.4 模型超参数分析 为分析模型关键超参数的敏感性,分别考察了超参数 、 和 对模型性能的影响。其中, 和 用于控制两项解耦约束项的强度,而 控制待丢弃的节点数量。通过在CMAPSS和TWM数据集上逐一调整这些超参数并观察RMSE与SF的变化,研究了模型对这些超参数的敏感性。图11至图14展示了 和 在不同取值下的变化趋势实验结果表明。模型整体性能保持稳定,仅在部分参数值处出现微小的随机波动。随着参数 与 的增大,模型在两个数据集上的RMSE与SF曲线并未呈现明显的变化趋势,参数 对性能的影响与 类似。综上所述,所开发的模型对参数 和 均表现出较低的敏感性。 图11. 参数 λr 对CMAPSS数据集模型性能的影响 图12. 参数 λd 对CMAPSS数据集模型性能的影响 图13. 参数 λr 对TWM数据集模型性能的影响 图14. 参数 λd 对TWM数据集模型性能的影响 图15和图16展示了超参数 的敏感性分析结果。可以观察到,在 (即不丢弃任何节点)的设置下,模型在这两个数据集上并未取得最佳性能。当 时,模型在两个数据集上均达到了最佳性能,这表明适度丢弃部分节点有助于消除冗余信息并提升表征能力。然而,随着 继续增加,图结构中的有效信息也可能被削弱,导致在两个数据集上的性能均出现一定程度的下降。这些结果表明,节点选择机制在适当范围内能够提升模型性能,但过度丢弃会导致信息丢失和性能下降。因此,在实际应用中,应将 设置为较小值以保留更多有用的预测信息。 图15. 参数ω对CMAPSS数据集模型性能的影响 图16. 参数ω对TWM数据集模型的影响 5.4 案例研究三:风力涡轮机剩余使用寿命预测5.4.1 实验数据描述实验设备为位于中国西北部某风电场内的多台2兆瓦风力涡轮发电机,如图17(a)所示。在这些涡轮机的关键部件上共安装了26个传感器(见图17(b))以采集多源监测数据,数据采集系统基于SCADA平台。图17. 实验风力涡轮机详情 表11列出了用于风力涡轮机监测的各传感器信息。实验数据采集时长为两年,采样间隔为一分钟。表11 风力涡轮机测量传感器描述 图18展示了特定时间段内若干传感器记录的监测数据典型示例。在本实验中,编号为7、15和18的涡轮机发生了故障。因此,使用这三台涡轮机的数据来验证所提方法的有效性。样本采用滑动窗口方法生成,并计算其均方根值作为网络输入。具体而言,使用7号和18号涡轮机的数据构建训练集,而15号涡轮机的数据用于构建测试集。图18. 部分传感器采集信号示例 5.4.2 实验设置 类似地,本实验使用Adam优化器更新网络参数,初始学习率为 ,批处理大小设为512,训练轮数为500轮。控制两项解耦约束项的超参数 和 分别设置为0.3和0.1。基于传感器总数,本实验中的丢弃节点数 设为2。时间窗口大小设置为60,CDGNN-DDCS网络配置为2层。 5.4.3 实际风力涡轮机剩余使用寿命预测结果 本实验选取了六种方法与所提方法进行比较, BiGRU 、 BiLSTM 、 SALSTM 、 GCN 、 GAT 和 GGCN 。表 12 展示了这些方法在实际风力涡轮机上的 RUL 预测结果。为验证在实际工程应用中丢弃冗余节点的有效性,表 12 同时列出了当 时所提 CDGNN-DDCS 的预测结果。实验结果表明, CDGNN-DDCS 的性能明显优于对比方法。此外可以观察到,当不丢弃任何节点时, CDGNN-DDCS 取得的 RMSE 为 3.56 , SF 为 141.21 ,均高于 时的结果,这进一步证明传感器网络中冗余节点的移除有助于提升模型的预测性能。 表12 不同方法在实际风力涡轮机剩余使用寿命预测上的实验结果 图19(a)展示了预测RUL与实际RUL的对比情况,图19(b)则展示了该方法所得全图表征的特征可视化。如图19(a)所示,预测RUL与实际RUL高度吻合,准确捕捉了风力涡轮机RUL的变化趋势。图19(b)的可视化结果表明,所提方法获得的全图表征能够有效区分对应不同健康状态的特征。综上所述,所提方法可有效应用于实际风力涡轮机的剩余使用寿命预测。 图19. 所提方法的风力涡轮机剩余使用寿命预测结果:(a) 预测剩余使用寿命与实际值对比;(b) 特征可视化结果 5 结论本文提出了一种基于CDGNN-DDCS的多传感器设备剩余使用寿命预测方法,其主要贡献可归纳如下。首先,针对传统方法中潜在的特征隐式冲突问题,提出了节点特征对比解耦模块。该模块将节点特征分解为全局退化特征与局部关系特征,分别用于多传感器设备RUL预测任务和空间依赖性建模;同时,NFCDM采用交叉融合‑对比解耦策略,有效减少了任务无关信息带来的交叉干扰。其次,所提出的偏差‑扩散性协同节点选择器能够自适应剔除冗余节点,从而在特征聚合过程中最小化其干扰,提升模型的鲁棒性。此外,通过在两个公开数据集上的对比实验验证了所提方法的优越性,并基于真实风力涡轮机的RUL预测结果进一步证明了其工程实用性。编辑:Jin校核:李正平、陈凯歌、赵栓栓、曹希铭、赵学功、白亮、任超、海洋、Tina、陈宇航、Kira、肖鑫鑫、赵诚、张优该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除来源:故障诊断与python学习

未登录
还没有评论
课程
培训
服务
行家
VIP会员 学习计划 福利任务
下载APP
联系我们
帮助与反馈