
首页/文章/ 详情

MST综述 | 智能故障诊断模型可解释性研究的系统综述
9月前浏览1220

    深度学习模型是一个内部机制不明确的黑箱模型,这大大降低了用户对决策过程的信任度。很多研究者们在研究可解释系统,期望诊断结果更可靠、透明。

    邵海东老师团队对智能故障诊断领域最新的可解释性研究进行系统综述。将该领域内近期关于可解释模型的学术成果进行了系统梳理,并根据其方法和结构特征进行了分类。此外,还探讨了智能故障诊断可解释性面临的挑战及未来的研究方向。非常值得相关研究方向人员学习。

    论文链接:通过点击本文左下角的阅读原文进行在线阅读及下载。

    论文基本信息

    论文题目:A systematic review on interpretability research of intelligent fault diagnosis models

    论文期刊:Measurement Science and Technology

    论文日期:2024

    论文链接:10.1088/1361-6501/ad99f4

    作者:Ying Peng(a), Haidong Shao(a), Yiming Xiao(a), Shen Yan(a), Jie Wang(a) and Bin Liu(b)  

    机构:

    a: College of Mechanical and Vehicle Engineering, Hunan University, Changsha 410082, People’s Republic of China   

    b:  Department of Management Science, University of Strathclyde, Glasgow G1 1XQ, United Kingdom

    作者简介:

    邵海东,1990年生,副教授,博士生导师,岳麓学者,西北工业大学本硕博,瑞典吕勒奥理工大学博士后,IEEE Senior Member,湖南省优青,湖湘青年英才(湖南省青年科技人才),入选科睿唯安全球高被引科学家(工程学/交叉学),爱思唯尔中国高被引学者(机械工程),斯坦福全球前2%顶尖科学家终身科学影响力榜单(人工智能),ScholarGPS全球前0.05%顶尖科学家榜单(信息学),中国知网高被引学者TOP 1%(机械工程)。曾获:湖南省自然科学奖二等奖(排名1/4),中国振动工程学会科学技术奖二等奖(排名1/3),吴文俊人工智能青年科技奖,中国施工企业管理协会工程建设十大新技术(排名13/20),第五届全国高校教师教学创新大赛二等奖(排名2/4),湖南省普通高校教师教学创新大赛一等奖(排名2/4),湖南省普通高等学校课程思政教学竞赛一等奖(排名3/5),中国机械行业产教融合教育教学创新大赛全国赛一等奖(排名6/10),全国航空航天类课程思政示范课程(排名8/10),全国宝钢优秀学生特等奖,IEEE Andrew P. Sage Best Transactions Paper Award,英国物理学会IOP Publishing Top Cited Author Award,中国精品科技期刊顶尖学术论文,中国机械工程学会优秀论文,《机械工程学报》第六届/第九届高影响力论文,《航空学报》2020—2023年高影响力论文,湖南大学优秀教师新人奖,教学优秀奖,长丰优秀教师奖,青年岗位能手,创新创业优秀指导教师,本科毕业论文优秀指导教师,连续3年博士生国家奖学金等荣誉。  

    研究方向为运载装备机电系统的健康管理与智能运维,主持国家自然科学基金面上项目,青年项目,国家重点研发计划子课题,湖南省创新平台与人才计划项目,湖南省自然科学基金优秀青年基金项目,教育部产学合作协同育人项目,国家级重点实验室开放课题和研究所/企业委托课题等,参与了重大研究计划、军委装备预研基金、航空科学基金等课题。  

    目前以第一作者/通讯作者发表学术期刊论文100余篇:70余篇中科院SCI一区/Top (全部为非开源);20余篇ESI热点,40余篇ESI高被引;具体期刊包括Information Fusion、IEEE TII、IEEE TSMC、IEEE TIE、IEEE-ASME TMECH、IEEE TTE、IEEE IoTJ、IEEE TR、IEEE TIM、MSSP、JMS、ESWA、RESS、ADVEI、CII、EAAI、Science China、中国科学: 技术科学、机械工程学报、航空学报等;论文被引总次数16000+(Google Scholar),单篇最高被引次数700+,H-index为67,公开授权发明专利9项。  

    担任《IEEE Transactions on Industrial Informatics》、《IEEE Transactions on Systems, Man, and Cybernetics: Systems》、《IEEE Transactions on Intelligent Transportation Systems》、《Structural Health Monitoring》、《IEEE Sensors Journal》、《Journal of Vibration and Control》、《Proc IMechE, Part C: Journal of Mechanical Engineering Science》等10余个SCI期刊副主编(Associate Editor);《Measurement Science and Technology》、《CMC-Computers Materials & Continua》等多个SCI/EI期刊编委(Editor Board Member);30余个EI国际会议Program Chair和Session Chair等;中国振动工程学会动态信号分析专业委员会委员;中国机械工程学会工业大数据与智能系统分会委员;中国系统工程学会系统可靠性工程专业委员会委员;湖南省高新技术产业科技创新引领计划项目评审专家;教育部学位中心学位论文评审专家;湖南湘江新区青年科技工作者联合会理事;IEEE Senior Member;IIAV/IET Member。  

    独立指导1名博士生入选首届中国科协青年人才托举工程博士生专项计划;独立指导多名博士生,硕士生和本科生获国家奖学金、省级优秀毕业生、校长奖学金、优秀研究生标兵、优秀学生党员等荣誉。独立指导的SIT项目组成员成功前往苏黎世联邦理工学院,南洋理工大学,香港大学、香港中文大学等知名高校攻读硕士和博士学位。(来源:湖南大学教师主页)  

    目录

    摘要

    1 引言

    2 事前可解释模型

        2.1 物理知识嵌入模型

        2.2 功能框架嵌入模型

        2.3 算法结构等价模型

    3 事后可解释模型

        3.1 模型特定可解释性

        3.2 模型无关可解释性

    4 挑战与展望

    5 结论

    摘要

    近年来,基于深度学习方法的智能故障诊断(IFD)发展迅猛,提供了日益精准和自主的解决方案。然而,这些方法忽视了模型的可解释性,且大多数模型是内部机制不明确的黑箱模型,从而降低了用户对决策过程的信任度。这在关键决策中尤其成问题,因为诊断依据的不明确会带来重大风险。为应对这些挑战,迫切需要一个更可靠、透明且可解释的系统。关于智能故障诊断可解释性的研究势头渐盛,如今已成为一个活跃的研究领域。为促进该领域的深入研究和发展,有必要对现有的关于可解释故障诊断模型的期刊文章进行全面审视。此类综述将为读者揭开当前技术的神秘面纱,并为未来的研究奠定基础。本文旨在对智能故障诊断领域最新的可解释性研究进行系统综述。我们对该领域内近期关于可解释模型的学术成果进行了系统梳理,并根据其方法和结构特征进行了分类。此外,我们还探讨了智能故障诊断可解释性面临的挑战及未来的研究方向。  

    关键词:可解释性、智能故障诊断、深度学习、黑箱模型

    1 引言

    如今,各行各业对安全性和健康的经济周期都有了更高的要求,而故障诊断在设备监测、诊断和维护中起着至关重要的作用[1]。传统的故障诊断方法依赖人工检查和专家经验,不仅效率低下,还容易受到人为因素的影响[2, 3]。智能故障诊断(IFD)技术的出现正是为了弥补这一不足,并提供更准确、高效、实时的故障诊断解决方案。IFD的应用领域十分广泛,例如建筑系统[4]、化工过程[5]、能源工程[6]、电气系统[7]、智能交通[8]等。IFD技术融合了人工智能与故障诊断的精髓,在设备健康监测和故障预防方面取得了重大突破[9]。随着技术的发展,IFD技术变得越来越先进、具有更强的适应性和智能化[10]。  

    尽管智能故障诊断(IFD)已经达到了前所未有的准确度和精确度,但大多数深度学习算法都是黑箱模型。如果一个机器学习模型表现良好,我们就能信任该模型并忽略其决策背后的原理吗?答案是否定的。从模型结构和算法设计的角度来看,正是复杂的结构和错综复杂的参数优化策略推动了模型性能的提升,这不可避免地导致无法直观理解模型的内部机制。黑箱模型无法为决策者提供诊断结果的合理解释,这降低了模型在高可靠性要求环境中的可信度,因为它将面临极高的未知风险,从而限制了其应用[11]。为了提高智能故障诊断的安全性和可信度,有必要让决策者了解模型给出输出结果的原因。因此,需要增强模型的可解释性[12]。值得一提的是,“可解释的”“可说明的”及其其它表达方式在本文中传达的是相同的含义。  

    许多学者都对IFD的可解释性进行了研究,相关出版物数量显著增加。然而,我们注意到,目前尚未有对该领域研究的全面调查,也没有从可解释性的角度对现有模型进行分类。因此,在本综述中,我们借鉴了最新且相关的文献,对IFD可解释性研究的所有成果进行了回顾和分类[13]。过去五年中,关于可解释性故障诊断的期刊文章数量迅速增长。为了揭示这种方法的受欢迎程度,我们在Web of Science上进行了文献检索,结果如图 1 所示。我们发现,大多数期刊文章来自IEEE Xplore和Elsevier Science Direct。这表明过去五年该领域的研究高度集中,且近三年的出版物数量显著增加。值得注意的是,由于可解释性故障诊断算法的命名方式多样,要全面涵盖所有相关研究具有一定难度。近年来发表的这些文章可能为该领域的研究提供新的思路。但目前仍需要对这些进展进行更深入的综合与传播。因此,对当代研究进行系统综述既是必要的,也是至关重要的[14,15]。  
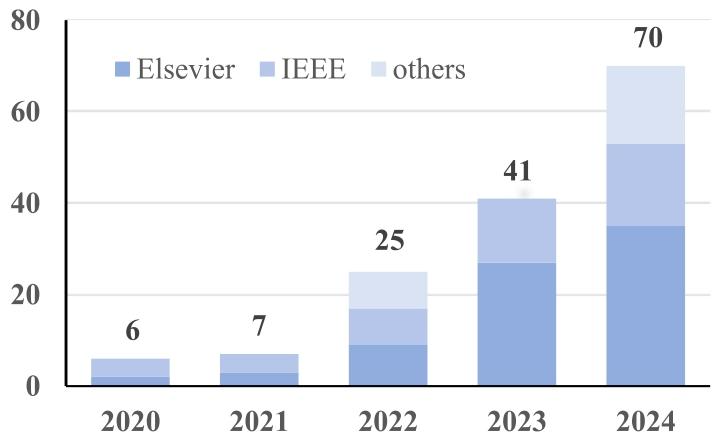
    图1 过去五年间可解释性故障诊断相关期刊论文数量  

    可解释的故障诊断模型大致分为两类:事前可解释模型和事后可解释模型。事前可解释性是指训练好的模型无需补充信息就能让人理解其决策过程或原理,这是在模型训练前就固有设计好的。典型的事前可解释模型包括线性回归、逻辑回归和决策树[16,17]。在本文中,事前可解释模型被进一步分为三类:物理知识嵌入模型、功能框架嵌入模型和算法结构等价模型。相反,事后可解释性是在模型训练后进行处理的。事后可解释性指的是在不改变原始模型结构的情况下构建一个可解释的模型,基于原始模型的输入数据和输出结果,推导出模型决策的逻辑和原因,并得出合理的解释。典型的事后可解释性方法包括类激活映射(CAM)[18]、沙普利加性解释(SHAPs)和局部可解释的模型无关解释(LIME)[19]。事后可解释性还进一步分为模型特定可解释性和模型无关可解释性[20]。此外,可解释性的范围可以是局部的,侧重于单个输入样本;也可以是全局的,旨在揭示模型的总体逻辑和内部机制[21]。事前可解释性和事后可解释性之间的区别如图 2 所示。  
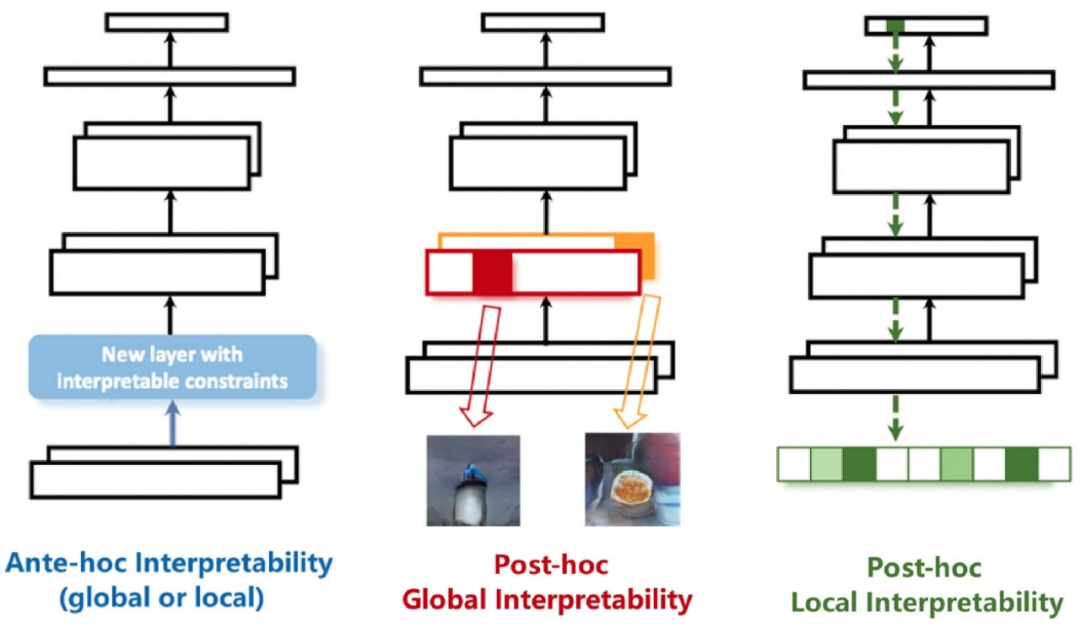
    图2 事前可解释性与事后可解释性的差异  

    本文的主要贡献总结如下:  

    • 介绍了可解释性的基本概念和理论,包括事前可解释性和事后可解释性,并从算法角度系统回顾了IFD模型的可解释性研究。

    • 围绕模型架构和原理,详细阐述了可解释性故障诊断模型的五个子类别,这有助于指导从业者为其特定的工业应用选择合适的算法。    

    • 阐述当前可解释性故障诊断发展面临的挑战和未来方向,旨在为该领域的新手和资深学者提供系统性综述。    

    如图 3 所示,本研究的结构安排如下。第2节介绍了事前可解释模型,并将相关文献分为三类:物理知识嵌入模型、功能框架嵌入模型和算法结构等价模型。第3节详细介绍了事后可解释模型并对其进行了分类。
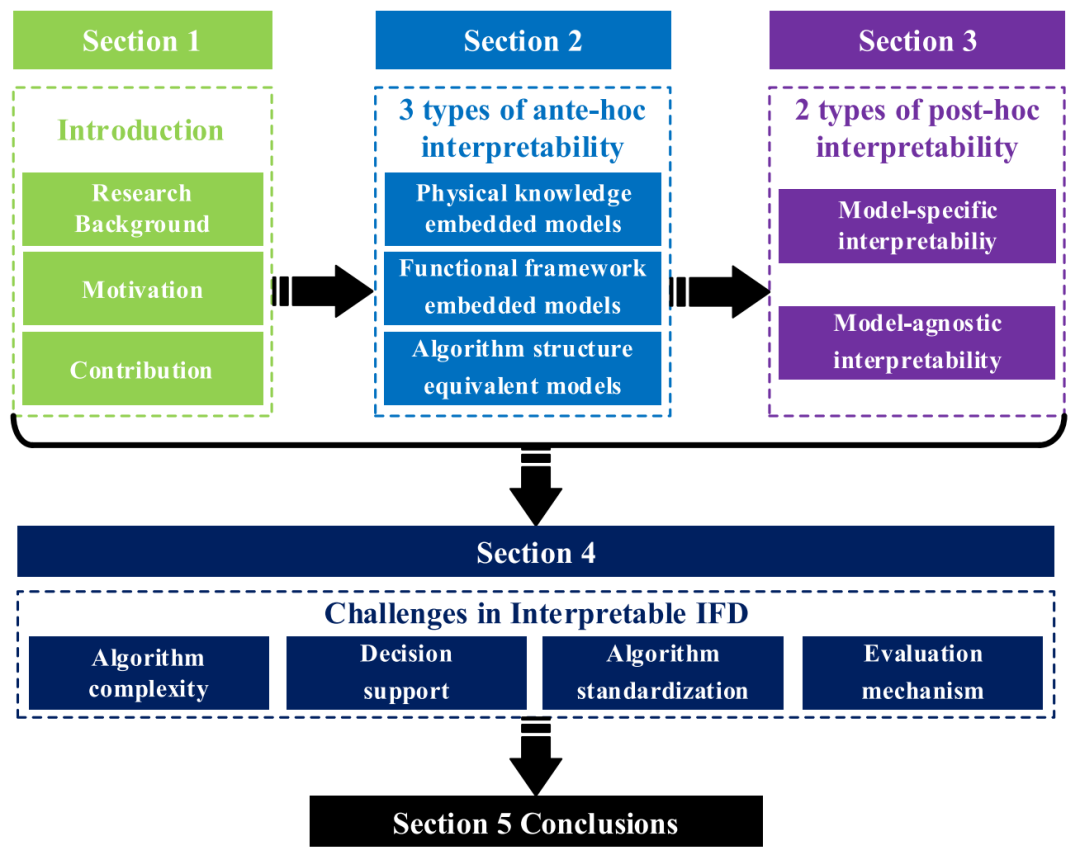
    图3 本系统性综述的框架  

    它们进一步分为两类:特定模型和无关模型。文中对相关概念进行了解释,以说明它们各自的优势。第4节讨论了IFD可解释性面临的挑战和未来的研究方向。最后,第5节对本综述进行了总结。

    2 事前可解释性 

    在本节中,我们介绍事前可解释性的基本概念,这是一种在训练前就将可解释性融入模型设计的主动策略。通过引入额外的网络结构或修改训练过程,可以在网络的训练过程中施加可解释性约束,从而引导网络具备可解释性,并符合实际问题的特定物理结构。我们将现有的事前可解释故障诊断模型分为三类:物理知识嵌入模型、功能框架嵌入模型和算法结构等价模型,以阐明事前可解释性的运行机制和策略方法。  

    2.1 物理知识嵌入模型  

    物理知识嵌入模型是一种直接的事前可解释模型,它直观地将相关约束整合到损失函数中,从而促使黑盒神经网络执行物理定律或经验公式,以获取额外信息来辅助模型训练[22]。深度学习已成为智能故障诊断(IFD)的主要方法。特别是卷积神经网络(CNNs)显著提高了故障诊断性能[23]。然而,传统卷积神经网络的内部结构不透明,这限制了它们在现实中的实际应用。如果将小波变换嵌入卷积神经网络(CNN),可能会有一些改进。  

    鉴于小波分析的物理相关性,它能够有效增强深度神经网络(DNNs)的可解释性。离散小波变换(DWT)是一种近似小波变换方法,可将信号分解为不同尺度的近似系数和细节系数。Wang等人[24]基于DWT坚实的物理理论基础,提出了一种能够进行深度频率分离的物理知识嵌入模型。他们模型的创新之处在于设计了一个频率学习层,该层由基于DWT的频率分解模块和基于卷积的特征学习模块组成。Li等人[25]构建了一种具有物理可解释性的网络,该网络结合了小波基和卷积核的优势。他们的算法在准确性和噪声鲁棒性方面表现更优。Gao等人[26]也将物理知识(即小波基单元函数)嵌入到卷积网络(ConvNet)中。他们设计了三种不同的小波基单元函数,并将其嵌入到卷积层中。由于其物理原理清晰,因此该嵌入层本质上具有可解释性。Zhao等人[27]创新性地将双阻尼小波作为核函数嵌入到卷积层中,能够更好地识别故障特征。他们更关注模型的轻量化设计,以降低大量参数带来的高计算成本。他们使用多个并行卷积层而非堆叠卷积层来筛选故障特征,这可以降低网络的复杂度。前面提到的内容就是基于双阻尼小波的动态CNN模块。最后,在此基础上,他们结合改进的DWT来增强轴承故障诊断的可解释性,这就是DWT增强模块。频率特征被转换为线性通过逆离散小波变换输出,如图 4 所示。
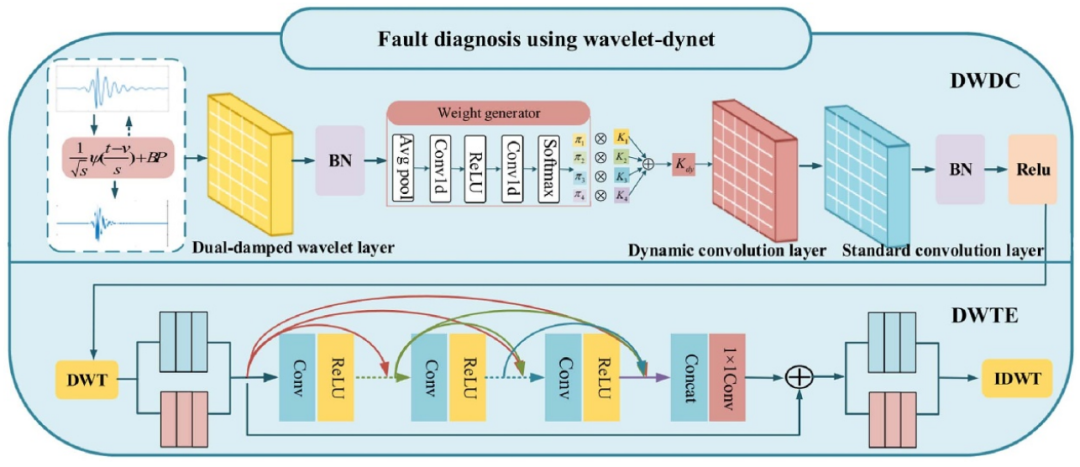
    图4 基于小波动态层的故障诊断流程图  

    某些方法将小波与其他功能可解释模块相结合,以提高可靠性和适用性。Li等人[28]提出了完全可解释的透明算子网络。该透明算子网络由三个本质上具有物理可理解性的模块组成:带有参数化Morlet小波滤波算子的信号算子层、带有特征归一化的统计特征层以及线性分类器。整个透明算子网络的所有模块都具有物理可解释性。He等人[29]提出了一种可直接获取的小波权重初始化方法,该方法具有很强的物理可解释性。该模型侧重于降噪的权重初始化和阈值设置。为了增强少样本学习能力并提高可解释性,Liu等人[30]提出了一种跨域模型,该模型采用时间散射卷积网络,在每个卷积层而非仅第一个卷积层中使用小波核。通过这种方式,卷积网络的所有层(包括Morlet小波变换和softmax)都是可解释的。之后,Liu等人[31]提出了一种归一化小波散射卷积网络,以增强故障诊断模型在跨传输路径迁移任务中的域泛化能力。  

    短时傅里叶变换(STFT)也常被用于可解释网络,因为它能将时域信号转换为时间-频率表示,从而突出那些更易于分析和理解的重要特征及模式。这种表示形式通常可视化为频谱图,它为信号提供了更清晰、更具结构性的视图,有助于特征提取,并使神经网络的决策更具透明度和可解释性。短时傅里叶变换具有可解释的理论基础,因此,He等人[32]将可微分的短时傅里叶变换作为物理知识嵌入到网络中,使网络具有内在的可解释性。上述两个模型都是跨机器故障诊断,从实验场景到实际场景。他们使用可视化方法来证明所提出模型的有效性,如图 5 所示。可以看出,可微分短时傅里叶变换能够集中能量并降低噪声。之后,He等人[33]对其进行调制,使时频谱具有鲁棒性,如图 6 所示。Chen等人[34]提出了一种可解释网络。他们将具有物理可解释性的时频变换(TFT)技术嵌入到卷积神经网络的预处理层中,使模型具有事前可解释性。Kim等人[35]提出了一种可解释框架,结合短时傅里叶变换和包络分析来展示模型所学习到的故障特征的分类机制。  
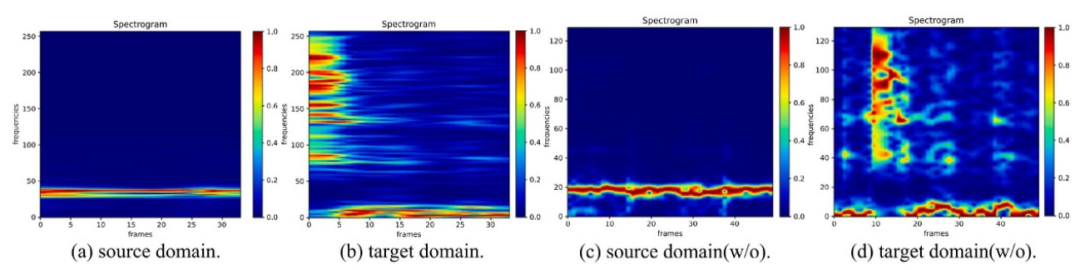
    图5 有无可微分短时傅里叶变换的时频图
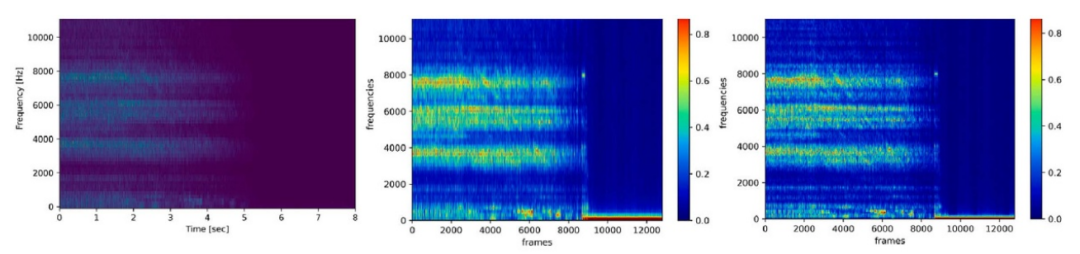
    图6 采用短时傅里叶变换、可微分短时傅里叶变换及调制可微分短时傅里叶变换时频图

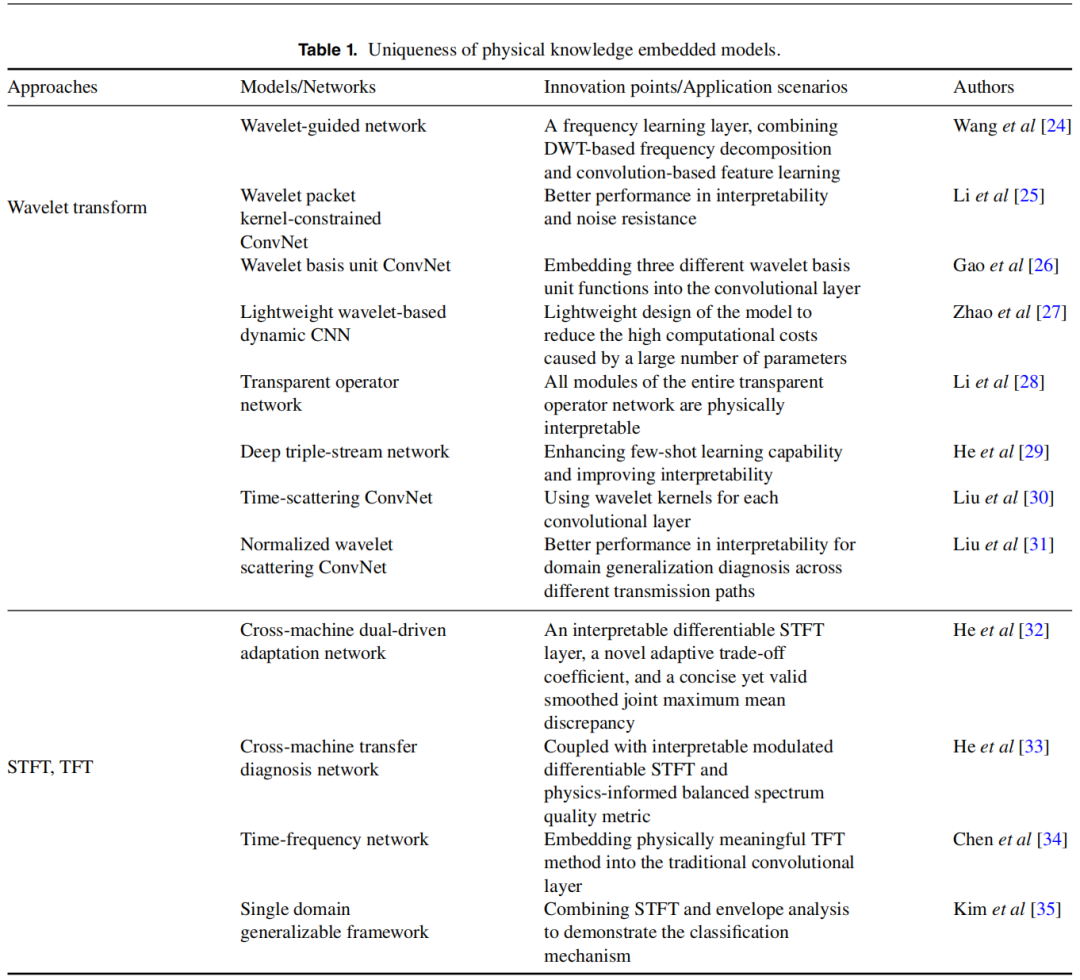
    对于嵌入物理知识的模型,表 1 突出显示了不同作者使用相同可解释方法提出的模型的独特之处,包括创新点或应用场景。

    表1 物理知识嵌入模型的独特性
    神经网络中还嵌入了一些其他物理模块,以提高模型的可解释性。Yan等人[36]将物理信息权重矩阵嵌入到单个隐藏层网络中,该网络被设计为决策模块,以确保可解释性。Sun等人[37]为诊断结果提供了直接的物理解释。Liu等人[38]针对滚动轴承故障引起的非平稳脉冲信号,构建了物理知识增强的稀疏子段引导降噪层,利用稀疏子段进行降噪增强了网络的可解释性。Abid等人[39]开发了一个新的深度学习框架。它实现了高准确率、事前可解释性以及对噪声的鲁棒性。  

    2.2 功能框架嵌入模型  

    该功能模块本地嵌入深度神经网络(DNN)中,用于体现特定的物理知识,以提高可解释性。常见的功能模块包括卷积核模块、注意力机制模块等。  

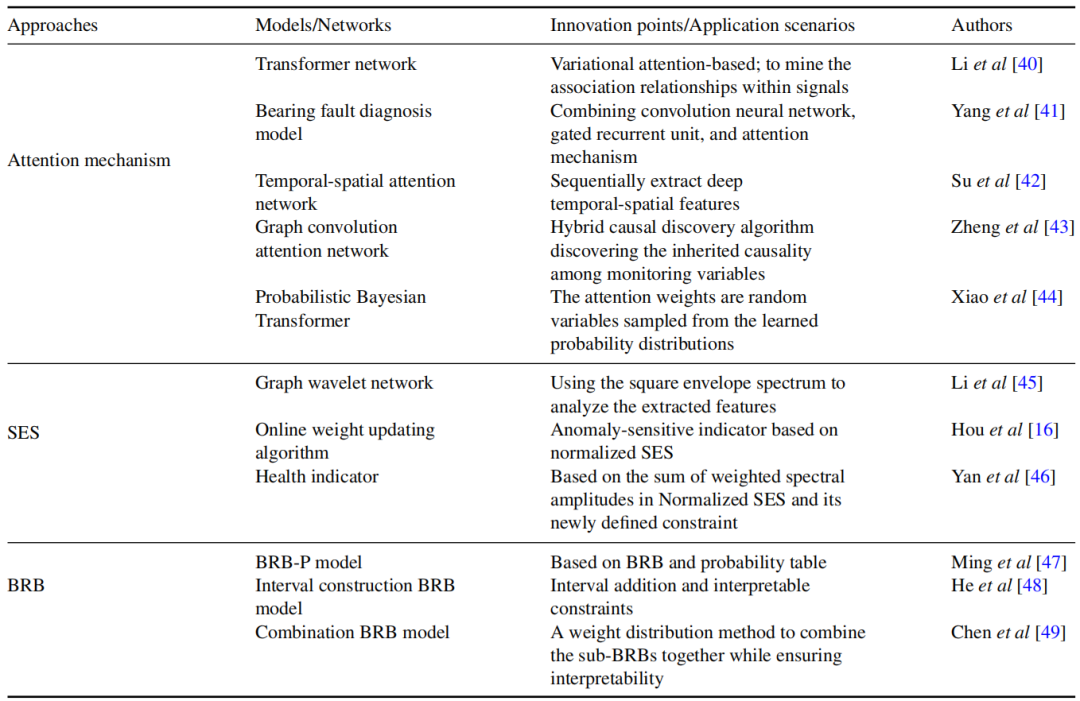
    深度学习中的注意力机制模仿人类的注意力过程,使模型能够聚焦于输入数据中的关键信息,极大地提高了模型的准确性和效率,并增加了模型的透明度。注意力机制已在各种模型中得到广泛应用。Li等人[40]提出了一种使用Transformer网络进行挖掘的旋转机械故障诊断模型。

    信号内部的关联关系,这通过稀疏正则化约束来优化注意力权重。Yang等人[41]提出了一种轴承故障诊断模型,该模型利用注意力机制来反映不同输入片段对结果的重要性,如图 7 所示,其中    表示输入向量;    表示查询向量,它是与任务相关的表示,    表示评分函数,用于计算每个输入向量与查询向量之间的相关性;    代表注意力分布,它是在给定    和    的情况下选择第i个输入向量的概率:    作为输入的高级表示可用于进一步诊断,并且使用softmax分类器进行最终的轴承状态分类。Su等人[42]提出了一种卷积时空网络。该模型通过使用注意力模块具有可解释性的优势,能够从输入数据中依次提取深层次的时空特征。Zheng等人[43]构建了一个图卷积注意力网络,利用注意力机制根据特征重要性分配自适应权重。Xiao等人[44]提出了一种用于旋转机械故障诊断的Transformer模型,并利用贝叶斯知识优化注意力权重。
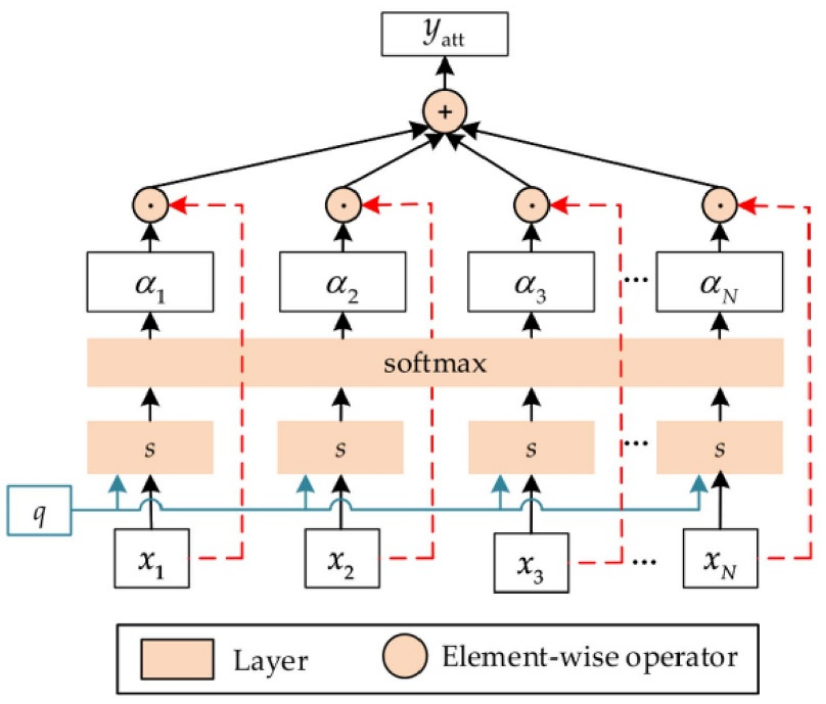
    图7 注意力机制的工作流程

    平方包络谱(SES)是一种传统的信号处理方法,已被用于可解释的故障诊断模型中。Li和Chen[45]将SES引入了传统故障诊断。Hou等人[16]提出了一种基于可解释机器学习的故障诊断方法,该方法采用在线更新策略逐一更新每个样本的权重。Yan等人[46]基于归一化的SES定义了一个异常敏感指标,经过权重优化后,该模型能够在信号处理和频谱分析中自主发现故障特征频率。  

    信念规则库(BRB)模型作为一种智能专家系统被提出,用于处理模糊和不确定的信息。它结合了专家系统和数据驱动模型的优势,特别适用于信息不完整或专家知识难以量化的复杂系统预测。在预测模型中使用BRB时,专家的知识可以以“如果-那么”规则的形式进行编码,这些规则利用置信度来表达各种类型的不确定性和模糊信息。更重要的是,作为一种白盒方法,它可以为决策者提供直接的访问途径和透明度。利用这一点,Ming等人[47]将BRB与概率表相结合,构建了BRB-P模型,该模型能够实现比传统BRB更高的精度。随后,他们通过添加可解释性约束,在可解释性要求下对参数进行优化。He等人[48]为复杂系统设计了一种可解释的BRB模型,并在该模型中添加了可解释性约束。Chen等人[49]提出了一种新的可解释方法,即将具有大量参数的BRB分解为多个参数较少的子BRB,然后构建权重分配方法来组合这些子BRB,同时确保惯性平台故障诊断的可解释性。  

    对于功能框架嵌入模型,表 2 强调了不同作者使用相同可解释方法提出的模型的独特性,包括创新点或应用场景。

    表2 功能框架嵌入模型的独特性
    神经网络中还嵌入了一些功能框架,以使算法具有可解释性。Zhou等人[50]使用极端梯度提升来替代卷积神经网络(CNN)的部分功能,从而使模型具有可解释性。Tong等人[51]对故障诊断模型进行了可解释性分析,将卷积层的第一层结构和原始信号的输出特征进行可视化,然后通过展示每一层训练后特征图的变化,直观地揭示了模型的特征学习过程和表示。Liu等人[52]设计了多个具有事前可解释性的时频滤波核,利用数学中的点积方法来提取特征。Huang等人[53]构建了一个图结构模型,该模型利用基于概率分布知识的物理约束来反映分布差异和关联。  

    2.3 算法结构等价模型  

    算法结构等价模型对神经网络中信号处理方法的结构进行近似,从而提高网络的可解释性,并挖掘目标信号的健康状态特征。  

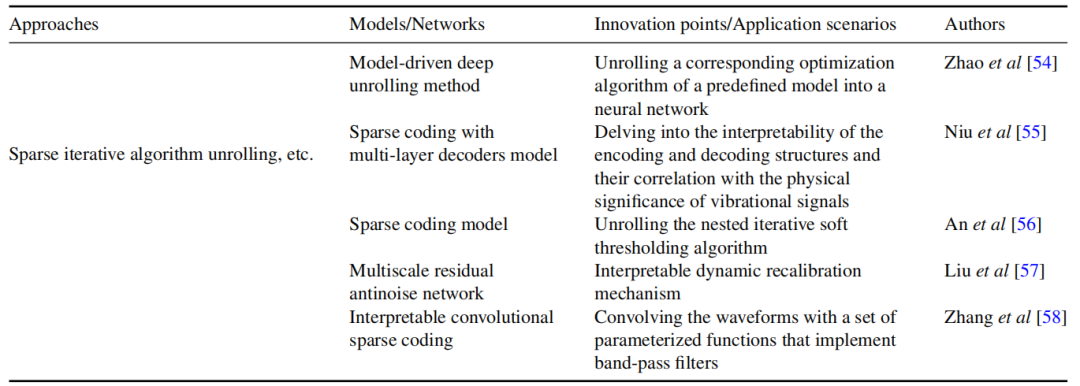
    基于稀疏表示的稀疏迭代算法引起了广泛关注。Zhao等人[54]提出了一种具有事前可解释性的深度学习模型。基于多层稀疏编码器的思想,他们设计了一种能够跨层解决稀疏编码问题的算法。Niu等人[55]深入探究了自编码器的可解释性,分别研究了其组件结构,并提出了一种具有清晰理论框架的稀疏编码模型。An等人[56]将扩展稀疏编码模型的嵌套迭代软阈值算法成功应用于轴承的智能诊断中,并通过特征可视化验证了所学特征是否有意义,证明了该模型的透明性和可信度。Liu等人[57]提出了一种新的多尺度残差网络用于滚动轴承故障诊断,其中在特征提取器中应用了动态校准机制,并将校准结果可视化以提供可解释性。Zhang等人[58]提出了一种稀疏编码方法如图 8 所示,该方法利用兰姆波卷积,并将多层迭代软阈值算法应用于多层基追踪问题,以灵活识别兰姆波损伤特征,实现损伤识别与定位。
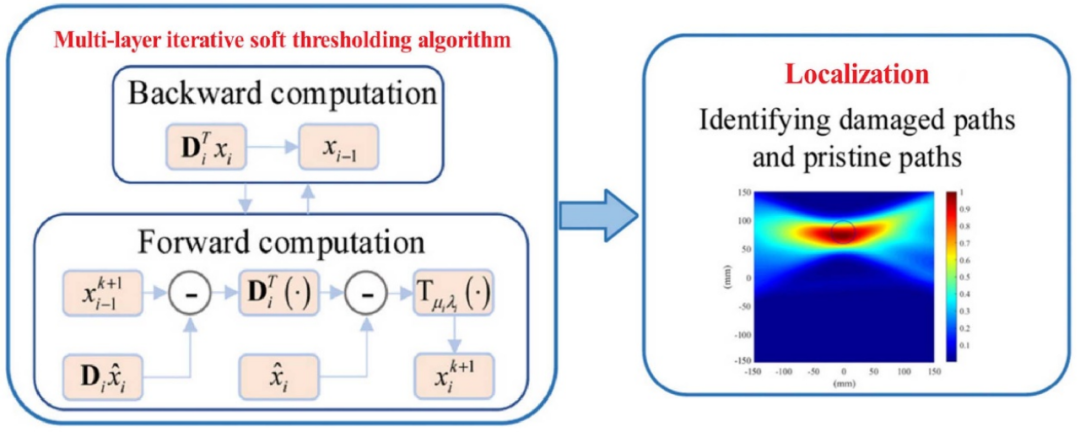
    图8 基于多层迭代软阈值算法的损伤定位  

    对于算法结构等价模型,表 3 强调了不同作者使用相同可解释方法提出的模型的独特性,包括创新点或应用场景。

    表3 算法结构等价模型的独特性
    3 事后可解释模型

    事后可解释性技术拓展了智能故障诊断(IFD)技术的理论与应用边界,不仅有助于更清晰地理解复杂诊断模型的故障分类过程及深层逻辑,还提升了诊断模型的可信度、可靠性与准确性。如图 9 所示,可解释性分析能让用户更深入地洞察模型决策背后的依据,进而增进对模型判断结果的信任度。在本节中,我们将从两个主要维度,探究事后可解释性方法在不同智能故障诊断(IFD)模型中的适用性。
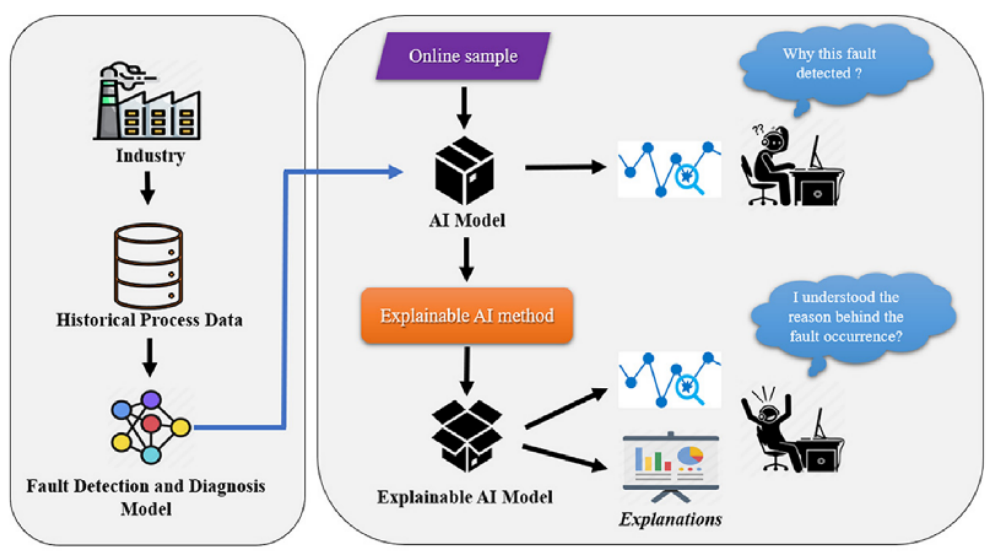
     

    图9 事后可解释方法的作用

    3.1 模型特定可解释性

    模型特定可解释性指通过分析模型的输入、输出、结构、参数等信息,设计可解释性方法,以理解模型进行分类决策的依据。该类可解释性仅适用于特定模型,无法迁移至其他类型的模型。通常,模型特定可解释性以梯度信息为载体,通过特征显著性图、类激活映射(CAM)等方式,解释模型的分类原理。  

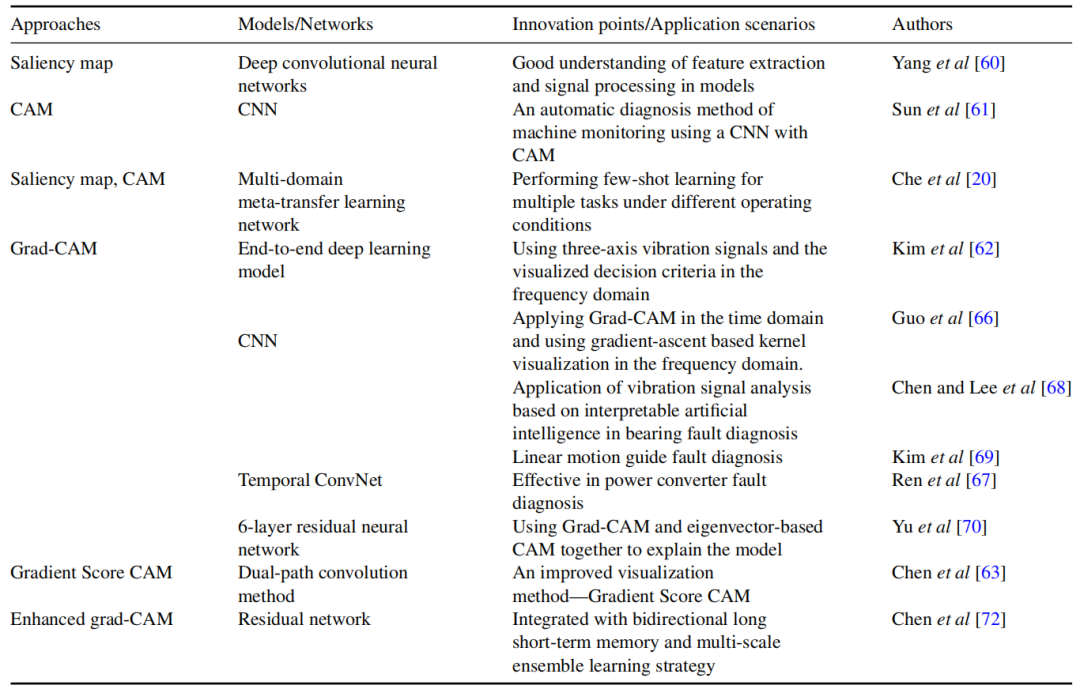
    杨等人 [60] 提出了一种深度学习模型,该模型在旋转机械的振动数据(已转换为频域)上进行训练。该模型结合了神经元激活最大化和显著性图两种方法来可视化学习到的特征,从而推断模型识别健康状况的依据,如图 10 所示。孙等人 [61] 提出了一种通过图像和学习特征进行故障诊断的方法,并通过CAM技术定位故障。车等人 [20] 提出了一种可在不同工作条件场景下使用的迁移学习模型,利用CAM获取显著性图,这在增强模型可解释性的同时确保了模型的稳定性和准确性。金等人 [62] 提出了一种端到端模型,用于学习时间域数据。他们使用分组卷积为每个轴学习可解释特征,并使用基于频域的梯度加权CAM(Grad-CAM)可视化训练模型的决策标准。陈等人 [63] 提出了一种新的梯度评分CAM方法,用于分析时间域信号注意力分布的可解释性。陈等人 [64] 提出了一种新的评分加权CAM方法,用于提取暖通空调系统中的关键特征。程等人 [65] 使用Grad-CAM方法验证所提出的方法是否准确学习了故障特征。郭等人 [66] 从时间域和频率域两个角度开发了一种解释CNN的方法,用于轴承故障诊断。他们使用Grad-CAM检测时间域的注意力分布,并使用基于梯度上升的核可视化研究CNN在频域的工作原理。任等人 [67] 在时间卷积网络中使用Grad-CAM分析特征图,并观察当前模型在做出决策时的关注点,从而提高了电力系统的可解释性变流器故障诊断。陈和李[68]使用Grad-CAM在分析轴承振动信号进行故障诊断时,获得了CNN模型的注意力分布。Kim等[69]使用Grad-CAM可视化频域中的分类标准,用于线性导轨故障诊断。Yu等[70]将基于特征向量的CAM与Grad-CAM结合,用于解释一个6层残差神经网络。Lee等[71]使用Grad-CAM识别模糊能量模式图像数据中对模型影响最大的区域。陈等[72]改进了Grad-CAM技术,并将其与领域的先验知识结合,以理解模型的分类原理。
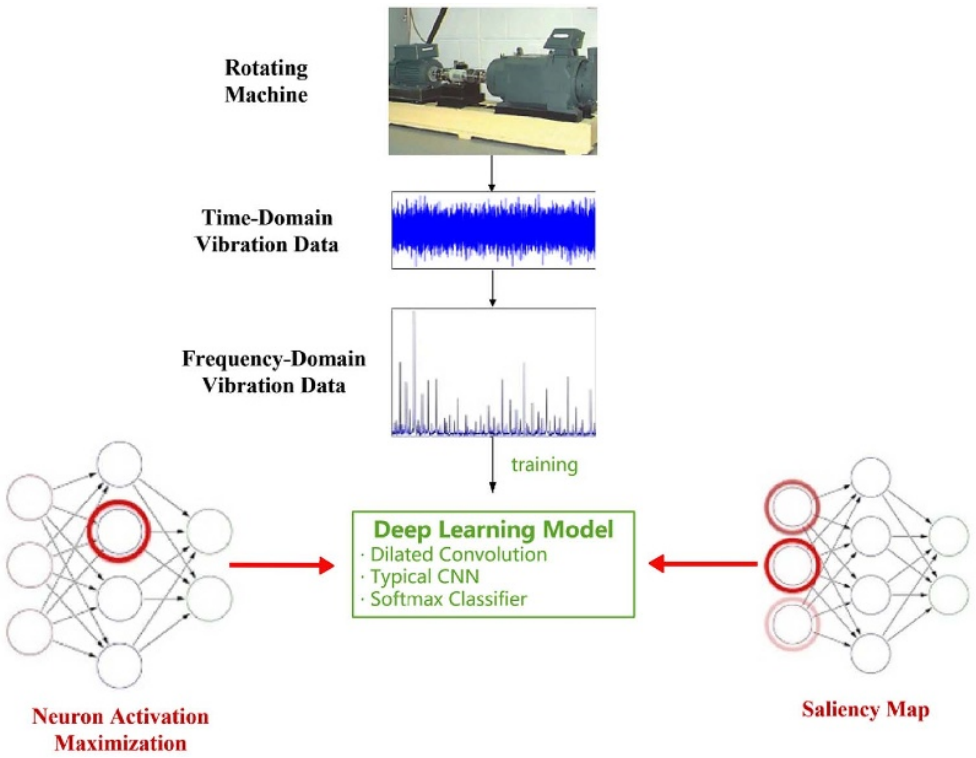
    图10 基于显著图的可解释性故障诊断  

    对于特定模型的可视化方法,表 4 突出了不同作者提出的模型在使用相同可解释方法时的独特性,包括创新点或应用场景。

    表4 模型特定可视化方法的独特性
    与CAM可视化的解释策略不同,Tang等人[73]提出了一种使用自注意力机制的可视化方法,用于观察每一层的注意力图并解释模型的工作原理。在滚动轴承故障诊断中,深度学习模型的抗噪性能弱且可解释性差,会降低其在工业应用中的可信度。为了解决这个问题,Sun等人[74]提出了一种具有强抗噪能力的模型,并使用可视化方法确保可解释性。他们可视化了网络的输出,如图 11 所示。Yang等人[75]提出了一种针对IFD的事后可解释方法,用于可视化模型从经过STFT处理的故障信号中学习到的特征。Kim等人[76]提出了一种可解释方法,使用频率激活图。虽然An等人[56]设计了上述的事前可解释模型,但他们也进行了事后可解释性分析,使用可视化方法观察算法学习到的特征。Li等人[40]能够通过注意力热图推导故障特征与分类结果之间的关系,使用的是事后可解释的可视化方法。Jiang等人[77]通过分析模型小波核的结构和参数并可视化其特征来说明可解释性。Guo等人[78]提出了一种具有跨域性能的IFD方法,使用因果解释来提高决策系统的可靠性。
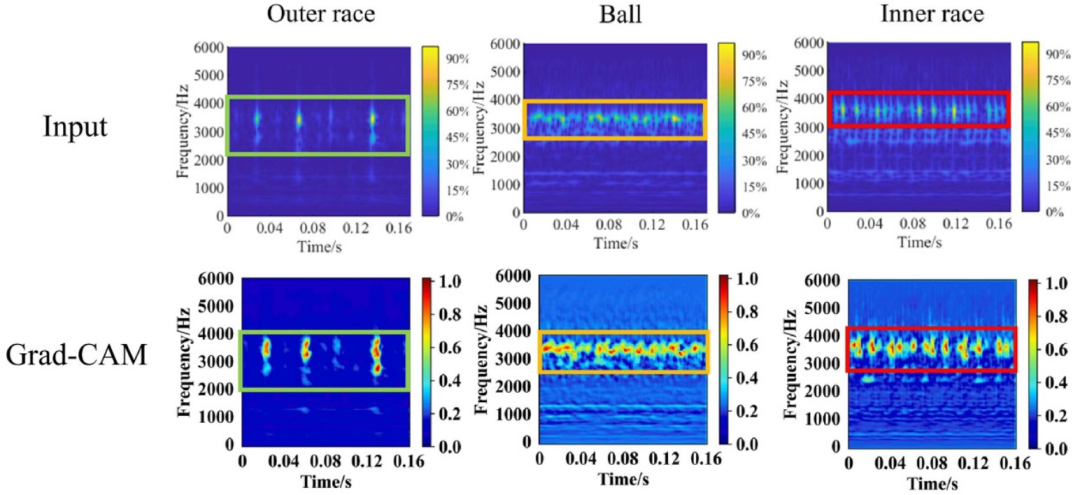
    图11 类别激活可视化结果  

    Gwak 等人 [79] 提出了一个基于扰动的事后可解释模型,该模型通过观察输入和输出的变化来解释模型。此外,他们使用扰动数据来测试模型 [80, 81]。Liao 等人 [82] 提出了一个深度信念网络,用于解释 DNN 的学习和决策过程。Fang 等人 [83] 专注于量化和解释环境因素对传感器数据的影响,并构建了一个对抗学习网络以解释输入对输出的影响。Li 等人 [84] 通过对模型进行事后可解释性分析,确认了其轴承故障诊断的可靠性。Liu 等人 [38] 使用模型关键信息权重分布结果来说明事后可解释性。Glock 等人 [85] 提出了一个新的算法思路,即使用一个可解释模型来解释另一个不可解释的模型。在 [86] 中,他们提出了一个可解释的故障诊断神经网络,该网络使用特征重要性值和反事实方法,从全局和局部两个角度提供解释。Zhang 等人 [87] 提出了一个基于功能性脑网络理念的可解释功能网络。Rui 等人 [88] 提出了一个用于噪声环境下故障诊断的可解释有限脉冲响应网络,并通过实验证明该方法具有良好的事后可解释性。

    3.2 模型无关可解释性  

    与模型无关的可解释性表明该算法适用于各种方法。Grad-CAM 和 SHAP 在可解释性研究领域中被广泛使用。Grad-CAM 通过可视化输入图像中的感兴趣区域提供局部可解释性信息,而 SHAP 值则衡量每个特征对模型预测的贡献并探索依赖关系 [53]  

    SHAP 起源于博弈论,旨在帮助人们理解机器如何做出决策[89,90]。可解释性分析的流程图见图 12。该方法将模型输出的预测值分解为各特征的贡献,从模型外部探讨可解释性[91]。Zhu 等人[92]在每一层中使用 Shapley 值来确定是否简化决策树学习中生成的树。Brito 等人[93]提出了一种方法论,他们使用 SHAP 来解释旋转机械故障诊断的黑箱模型。根据模型可解释性获得的重要性,对特征进行了排序。Li 等 [94] 使用 SHAP 值量化了一个顺序不变且可解释的扩张卷积神经网络中 特征的贡献。Jang 等 [95] 能够顺利地将 SHAP 与监测指标结合使用,以解释对抗自编码模型。Chowdhury 等 [96] 使用 SHAP 库来理解集成学习模型在 3D 打印机故障诊断中预测机制。Zhang 等 [97] 开发了使用 SHAP 的故障特征选择方法,可以理解故障特征如何影响油浸变压器故障诊断的诊断结果。  
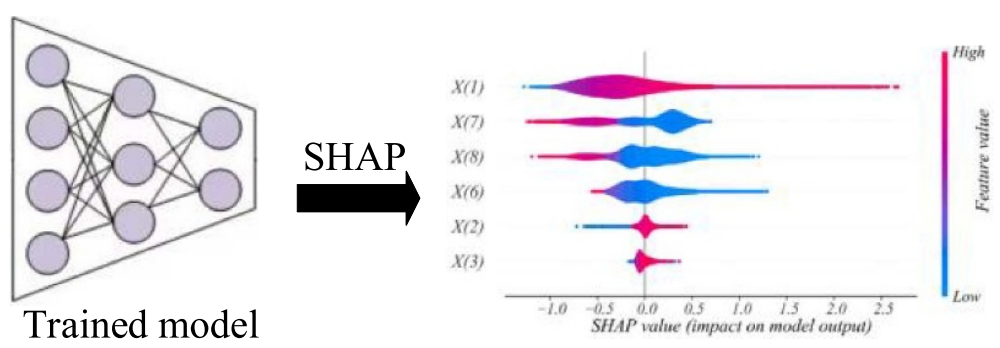
    图12 利用 SHAP 对训练好的模型进行可解释性分析  

    SHAP 也可以应用于其他学科领域的故障检测与监控或故障诊断。在故障检测与监控方面有四种情况。Bhakte 等 [59] 提出了一种基于 Shapley 值的事后可解释方法用于过程监控。Hwang 和 Lee 等 [98] 使用 SHAP 可视化工业控制系统异常检测中的异常情况。Keleko 等 [99] 在液压系统状态监控中应用深度 SHAP 进行解释。Utama 等 [100] 在光伏故障检测中使用 SHAP 提高可解释性。在其他学科领域也有四种情况。Biju [101] 在电气故障分类中使用 SHAP 进行可解释性研究。在建筑能源系统领域,Li 等 [102] 提出了一种权重融合算法,利用 SHAP 值和 Grad-CAM 的优势特性来增强可解释性。Bi 等 [103] 设计了一种特征权重计算方法并使用 SHAP 分析进行数据处理。Chen 等 [104] 使用 SHAP 以理解模型的内部原理和运行过程。  

    逐层相关传播(LRP)是一种可解释的方法,通过反向传播计算重要性。LRP算法假设神经网络每一层的神经元与神经网络输出之间存在一定的相关性。神经元之间相关性越高,它们对神经网络输出的影响就越大,其重要性也越高。此外,该算法为神经网络中的每一层定义了一种特殊的反向传播方法,可以将神经网络逐层输出的相关性传递到输入样本的每一个单元,即相关性传播,从而计算每个单元与输出之间的相关性,如图13所示。Kim 等人[35]通过使用LRP热图增强了物理可解释框架的可解释性。Tong 等人[105]也使用LRP增强模型的可解释性,并设计了压缩特征编码器。Grezmak 等人[106]使用LRP获得每个输入单元的梯度值,这可以很好地反映该输入单元的重要性。Li 等人[107]使用LRP方法解释暖通空调故障诊断模型。
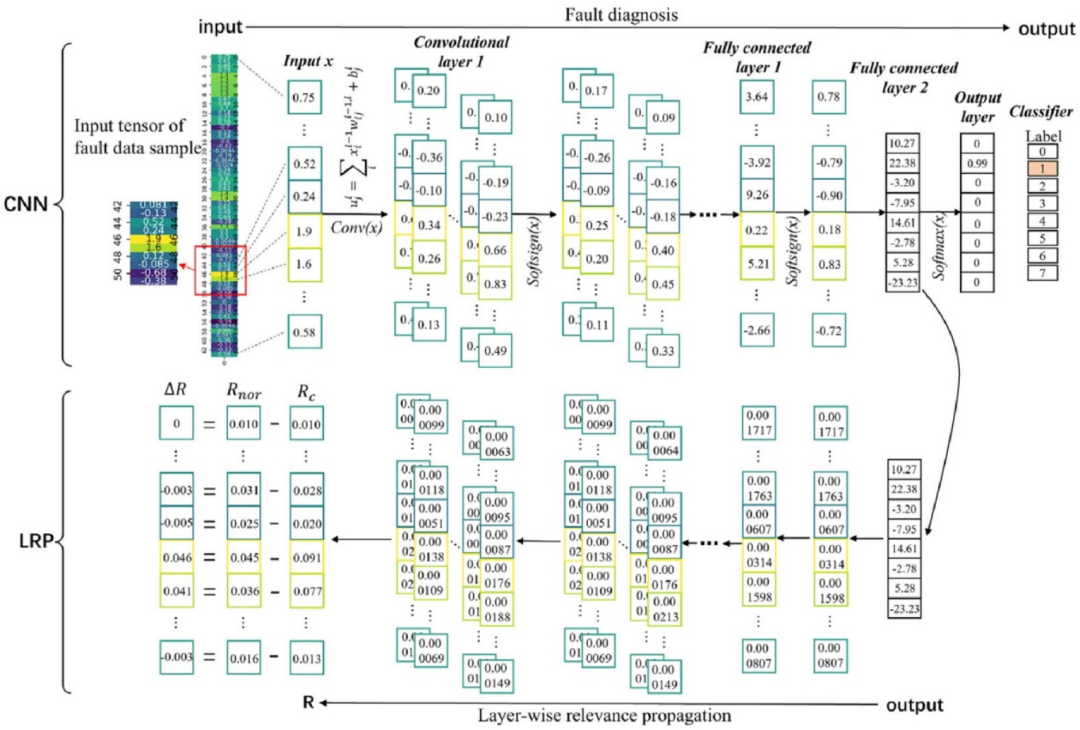
    图13 基于 LRP 的 CNN 故障诊断模型解释  

    Lu 等人 [108] 利用 LIME 模型解释了其在时变速度条件下基于特征的拟议模型。Li 等人 [109] 使用 LIME 模型对决策过程进行了可解释性分析。Zhang 等人 [110] 引入了 LIME,如图 14 所示,通过使用超声导波在小样本数据中进行损伤识别时,根据预测概率和关键特征值表对预测结果进行解释。Oliveira 等人 [111] 将 LIME 与 SHAP 方法结合,从全局和局部两个角度解释模型,以便更全面地理解轮胎制造过程中缺陷检测背后的内部机制。Gawde 等人 [112] 使用 LIME 解释预测性维护中的故障分类结果。
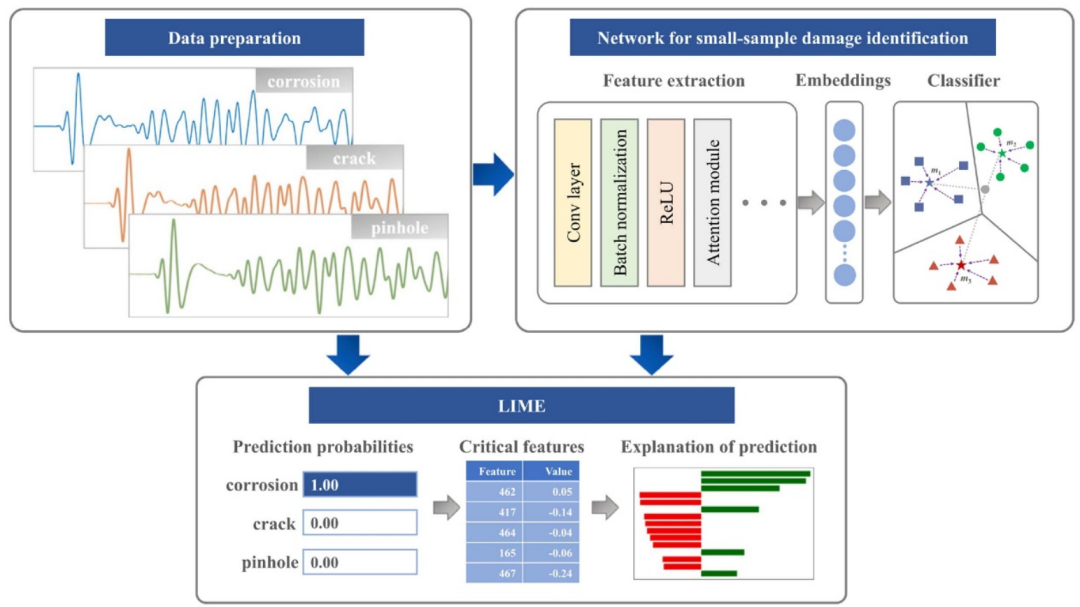
    图14 基于 LIME 的可解释性损伤识别  

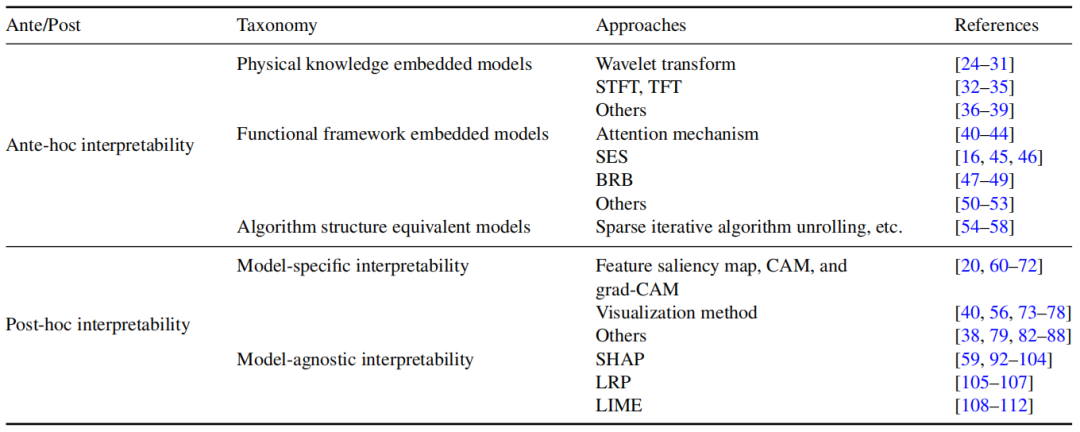
    对于模型无关的可解释方法,表 5 突出了不同作者使用相同可解释方法提出的模型的独特性,包括创新点或应用场景。此外,还有一个分类表,如表 6 所示,根据本文提出的分类法对主要期刊文章进行了分类。

    表5 模型无关可解释方法的独特性
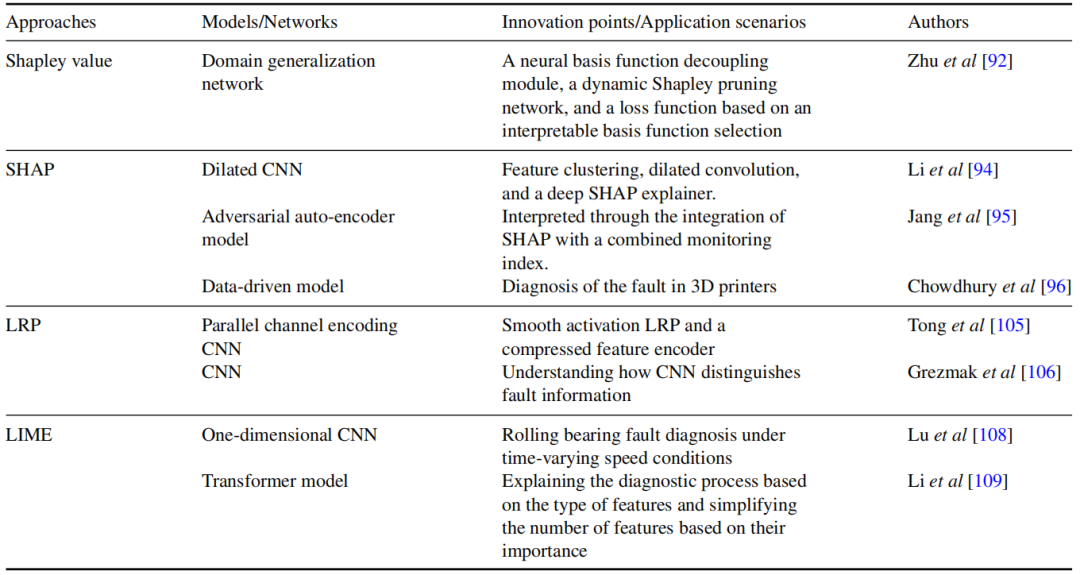
    表6 可解释故障诊断模型的分类  
    4 挑战与展望

    事前可解释性和事后可解释性各有其优缺点。事前可解释性涉及使用本质上可解释的模型,如线性回归或决策树。这 些模型提供了透明性,因为它们的结构直接显示了输入如何影响输出。它们在需要解释的高风险决策场景中 特别有用。然而,这种固有的简单性往往以诊断能力为代价,使得它们难以处理更复杂的问题。此外,可解释层的存在会影响分类器的训练,因为它们是一起训练的。事后可解释性则是在训练后使用技术对复杂模型进行解释。像 Grad-CAM、SHAP 或 LIME。这些方法通过可视化特征重要性或生成解释,使人们能够理解“黑箱”模型。这些方法保持了原始模型的诊断能力,但其真实性需要验证,可能会限制其可靠性。本质上,事前可解释性倾向于简单和可靠,但可能限制性能,而事后可解释性则更适用于高性能模型。  

    尽管已经有大量研究致力于提高IFD模型的可解释性,但仍然存在许多挑战:  

    (1) 算法复杂性。嵌入物理知识的事前可解释性模型利用小波变换和STFT等技术来增强可解释性。这些模型解决了如下问题噪声减少、计算效率和领域泛化。然而,平衡可解释性与算法复杂性仍然是一个挑战。如果可解释算法的复杂性远远超过现有诊断方法,或者引入可解释技术显著增加了方法的整体复杂性,那么该方法的实用性将需要进一步评估。

    (2) 决策支持。嵌入功能框架的模型在前可解释性中使用了各种方法,如注意力机制、SES 和 BRB。然而,这些方法不仅应作为解释工具,还应旨在增强诊断结果的可信度或确保与用户的更清晰沟通,从而最终实现更明智、更准确的决策。因此,在开发和评估可解释性技术时,必须优先考虑其支持和增强决策过程的能力。  

    (3) 算法标准化。特定模型的可解释性通过特征显著性图、CAM 和 Grad-CAM 等方法,使通过分析模型输入、输出和结构来详细理解分类决策成为可能。然而,不同领域研究人员的背景差异产生了各种关于可解释性的观点。可解释性的需求也会随着应用环境而变化操作条件,强调了标准化和可适应可解释算法的必要性。  

     (4) 评估机制。像 SHAP、Grad-CAM 和 LRP 这样的模型无关方法已被广泛采用,以提供对各种应用中模型行为的洞察。但不仅需要理解模型,还需要确保可信决策的可解释性和结果的可靠性。关于可解释性自我评估的研究有限,例如输出结果的可靠性。针对特定需求开发可解释的定性或定量评估机制,是该领域进步的一个必然问题。  

    5 结论

    IFD 方法的“黑箱”问题已成为其可信度的巨大制约因素,关于其可解释性的研究以及可解释方法的建立,已受到学术界和工业界越来越多的关注。在此背景下,本文从“事前(ante-hoc)”和“事后(post-hoc)”两大分类框架,对 IFD 模型的可解释性研究进行了系统综述。基于此,本文进一步完善了分类框架,利用类似的方法对可解释的故障诊断模型进行聚类。最后,本文指出了当前可解释性相关研究发展的瓶颈,并讨论了深度智能诊断领域可解释性研究所面临的挑战和发展方向。  

    编辑:李正平
    校核:陈凯歌、赵栓栓、曹希铭、赵学功、白亮、任超、Tina、陈宇航、陈莹洁、王金、赵诚、肖鑫鑫、张优
    该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除


    来源:故障诊断与python学习
    ACTMechanicalSystem振动化学旋转机械航空航天建筑暖通电力ANSA参数优化理论电机多尺度数字孪生控制人工智能
    著作权归作者所有,欢迎分享,未经许可,不得转载
    首次发布时间:2025-12-17
    最近编辑:9月前
    故障诊断与python学习
    硕士 签名征集中
    获赞 87粉丝 153文章 336课程 0
    点赞
    收藏
    作者推荐

    LLM故障诊断论文 | LLM-TSFD:基于大语言模型的工业时间序列人机环路故障诊断方法

    本期给大家推荐一篇基于LLM的故障诊断论文:LLM-TSFD:基于大语言模型的工业时序人机协同故障诊断方法,提出了一种融合任务驱动与人机交互的智能诊断新范式。该研究以大语言模型为核心,赋予其在数据管理、因果修正、模型调度与决策诊断中的四大关键角色,显著提升了故障诊断的自动化程度与结果可解释性。通过设计结构化提示词框架,有效引导模型理解工业时序数据,实现了在钢铁冶金场景中的高效应用。实验表明,该方法在精度、召回率等指标上优于传统方法,具备强泛化能力与低资源依赖,为工业智能诊断的升级与普及提供了可行路径。论文基本信息论文题目:LLM-TSFD: An industrial time series human-in-the-loop fault diagnosis method based on a large language model论文期刊:Expert Systems With Applications论文日期:2024论文链接:https://doi.org/10.1016/j.eswa.2024.125861作者:Qi Zhang(a), Chao Xu(a), Jie Li(a), Yicheng Sun(a), Jinsong Bao(a)*, Dan Zhang(a,b)机构:a: College of Mechanical Engineering, Donghua University, Shanghai 201602, Chinab: Department of Mechanical Engineering, The Hong Kong Polytechnic University, Hong Kong, China作者简介:鲍劲松,男,东华大学机械工程学院教授、博士生导师、智能制造研究所所长。2002年获上海交通大学机械制造及其自动化专业工学博士学位,2002-2015年任上海交通大学机械与动力学院讲师、副教授,2010年任美国南加州大学访问教授,2015年加入东华大学。主要从事智能制造系统理论、工业智能技术、数字孪生等领域研究。主持国家自然科学基金面上项目2项、科技部重点研发计划1项,参与工信部智能制造专项8项。(百度百科)目录摘要1. 引言2. 相关工作 2.1. 大模型vs小模型 2.2. LLM &时间序列数据故障诊断 2.3. 时间序列数据prompt的开发3. 基于LLM的人在环任务驱动的钢铁冶金故障诊断2.0框架 3.1. 基于LLM的任务驱动方法 3.2. 提出的框架——基于大语言模型的工业时间序列故障诊断(LLM-TSFD) 4. LLM在工业时间序列数据故障诊断中的作用 4.1. 管道管理器 4.2. 监督器 4.3. 控制器 4.4. 决策器 4.5. 基于工业时间序列数据的故障诊断prompt的设计过程 5. 案例研究 5.1. 环境下框架的建立 5.2. LLM-TSFD结果讨论 5.2.1. LLM-TSFD与未使用LLM的钢铁冶金故障诊断方法的比较 5.2.2. FD 1.0、FD 1.5、FD2.0的比较 5.2.3. 消融实验 6. 讨论 7. 结论 摘要工业时间序列数据提供有关设备运行状态的实时信息,有助于识别异常。数据驱动和知识引导的方法在这一领域已经占据主导地位。然而,这些方法依赖于工业领域知识和高质量的工业数据,这可能导致诸如诊断结果不明确和开发周期长等问题。本文介绍了一种新颖的人在环任务驱动方法,以减少对手动注释数据的依赖,并提高诊断结果的可解释性。该方法利用大型语言模型进行故障检测,促进过程自治,增强人机协作。此外,本文探讨了大型语言模型的四个关键角色:管理数据管道、纠正因果关系、控制模型管理以及对诊断结果做出决策。此外,提出了针对时间序列数据的故障诊断设计的prompt结构,使大型语言模型能够实现任务驱动。最后,本文通过钢铁冶金背景下的案例研究验证了所提出的框架。1. 引言随着工业5.0的发展,机械设备的稳定运行对于保证安全生产至关重要。对机器设备进行有效的监测、预测、检测和诊断,不仅是工业发展的保障,也是工业发展的动力。工业场景中时间序列异常检测的任务很复杂,需要在整个开发过程中从手动方法过渡到自动化方法。在工业应用中,基于时间序列的故障诊断任务是复杂的。操作人员需要观察和预测数据趋势的变化,发布故障预警,并分析趋势之间的因果关系。在这个过程中,故障任务需要从手工流程向自动化发展。特别是在钢铁冶金领域,复杂任务流程和海量传感器数据处理的自动化已经成为一个重大的工程问题。目前,故障诊断模型严重依赖领域专家来管理每个任务的数据集,并创建特定的模型进行训练。这种方法不仅费力,而且随着时间的推移也难以维持。此外,由于整个工业过程主要依赖于人为干预——包括数据处理和模型选择——这导致了漫长的设计周期和高昂的维护成本。因此,有效利用大量数据进行自动化处理,再加上开发合适的模型,已经成为一个迫切需要关注的关键问题。“大数据-人工智能-物联网”(BD-AI-IoT)时代的到来,使得人工公式调整已无法应对海量数据生成的挑战。由此催生了故障诊断1.0时代(FD 1.0),其特征是采用基于预测、基于重构及混合方法的数据驱动自动化流程。在这一自动化过程中,故障诊断依赖数据并能从中生成模型。多种方法已被证明有效,包括基于预测的方法(Chauhan & Vig,2015;Z. Chen等,2022;Munir等,2019)、基于重构的方法(Audibert等,2020;L. Li、Yan等,2023;B. Zhou等,2019)以及混合方法(Bashar & Nayak,2020;Han & Woo,2022;Zhao等,2020)。尽管这些方法取得了成功,但其在可解释性方面仍面临挑战,并且高度依赖数据质量。为解决这些问题,研究人员提出整合数据驱动的领域特定规则,以在整个过程中提高可解释性并降低对数据质量的依赖(Xin等,2022),这标志着故障诊断1.5时代(FD 1.5)的开端。常用策略包括专家系统与神经网络的融合,以及知识图谱与深度学习的融合(Chai,2020)。虽然这些方法提升了可解释性,但也存在局限性,例如故障知识规则不完整以及难以解决新问题。FD1.0时代是由数据驱动的方法定义的,这些方法在可解释性和模型可重用性方面面临挑战。为了解决这些问题,FD1.5将数据驱动技术与领域特定规则结合起来,提高了模型的可解释性,但仍然依赖于大量的人工参与。大语言模型(LLM)的出现开启了FD2.0时代,任务驱动的自主故障诊断成为可能。在任务驱动型故障诊断中,用户向LLM提供时间序列数据和任务,标志着故障诊断2.0时代(FD 2.0)的开始。LLM通过系统化分解用户任务,并整合专家知识来处理每个子任务,从而有效提升其对整个任务流程的管理能力(Ruan等,2023)。随着GPT3.5、GPT4和Chat GLM(Du等,2022)等语言模型的涌现,这些通过感知学习展现认知能力的模型已在多个领域取得显著成果。这些依托感知学习实现认知能力的生成模型,能为用户提供符合预期的智能回应。图1概述了从FD1.0到FD1.5,最后到FD2.0的进展,突出了这一过程的变革性质。这一演变展示了可解释性、自动化和任务处理能力的重大改进。由LLM提供支持的FD2.0提供了更高的灵活性,减少了人为干预,并且能够利用数据驱动的洞察力和特定领域的知识,标志着故障诊断方法的范式转变。 图1 故障诊断时代分为FD1.0、FD1.5和合并的FD2.0三个阶段LLM的突破性进展为工业故障诊断带来了重大变革。这些模型不仅能精准定义和拆解工业任务,还能简化时间序列数据预处理、故障检测/预测模型构建、模型结果解读以及根本原因识别等关键环节(Tu等,2023)。在故障诊断全流程中,LLM高效承担着多重角色,其任务分解后的数据处理能力已与人类专家不相上下(Cheng等,2023)。以MetaGPT(Hong等,2023)、HuggingGPT(Shen等,2023)和AutoGPT(Yang等,2023)为代表的智能工具,正是人类研发的智能助手,既能自主完成指定任务,又能提供专业反馈与优化建议。用户可以根据其输出查询LLM,从而实现持续学习和改进。这种协作过程使LLM能够更有效地处理类似或新的问题。随着智能系统越来越融入社会,对有效人机交互的需求也在增加。因此,机器产生可靠和可读信息的重要性变得更加关键。结合人在环学习增强了灵活性、适应性和交互性,提高了机器的能力。Prompt对LLM高效理解输入信息至关重要。prompt的选择会影响模型的问题解决导向和策略,必须针对具体任务进行定制。北京大学与阿里巴巴的研究人员提出了一种利用LLM对时间序列数据进行分类和预测的技术。该方法采用软prompt,基于频率、形状、值等不同特征来匹配时间序列,可以增强LLM处理多元时间序列嵌入的能力,然而,这种预定义的分类方式在处理复杂时间序列数据时灵活性受限,因其可能无法捕捉所有关键信息或变量间的空间关系。LLM面临若干挑战:1.可控生成:LLM由于其固有的不稳定性,导致同一问题的答案不一致,实现可控生成具有挑战性。本研究引入了prompt工程来处理时间序列数据进行故障诊断,从而提高了模型遵循用户指令的能力。2.高效自适应:LLM适应垂直领域涉及快速学习和模型参数的微调(Delta调优)。目标是在特定领域内装备LLM解决问题的能力。在工业故障诊断中,确定LLM如何取代传统过程以促进高效的人机协作是至关重要的。建立一个适当的框架对于利用LLM的能力来提高效率和有效性至关重要。本文分析了工业环境中基于时间序列数据的故障诊断任务。目前,工业异常诊断过程高度复杂和错综复杂,使故障检测和故障排除变得困难。处理范围广泛的参数和变量,以及数据中的不确定性,增加了这些任务的复杂性。传统的故障诊断方法往往无法有效管理未知故障,严重依赖专家经验,导致诊断过程既耗时又难以自动化。本文旨在将工业时间序列故障诊断作为LLM的任务目标来解决。所提出的方法将复杂的任务目标分解为优先级优先的子任务列表,从而明确了目标并增强了对LLM的理解。研究了一种基于LLM的工业时间序列人在环故障诊断方法。我们的研究包括以下贡献:1.本研究提出了一种基于LLM的方法来开发任务驱动的自主故障诊断流程。该框架通过结构化的人在环模型增强了人机交互。2.为克服时间序列数据处理中预定义时间特征的局限性,本研究提出一种组合推理方法。该方法明确了LLM的作用,融合了少样本学习,并整合了领域知识。3.LLM在故障诊断任务中的角色:i.数据处理:LLM作为管道管理器,管理整个数据管道,并根据用户输入协调各个阶段的数据流和依赖关系。ii.因果关系修正:LLM作为监督者,访问和纠正由使用领域知识的算法推断的因果关系。iii.故障预测和检测任务:LLM作为控制器,使用算法库中的模型和用户需求提出建议。它调用本地算法接口来执行结果。iv.故障诊断:LLM作为决策者,使用来自规则库的故障知识来推断检测到异常的原因。如果没有发现原因,LLM进行网络查询,收集信息并提供解决方案。2. 相关工作2.1. 大模型vs小模型随着LLM的快速发展,出现了GPT3.5/4、ChatGLM、Vicuna等具有自主认知能力的生成模型。这些具有数十亿个参数的模型被分类为大模型,而具有数百万个参数的模型被分类为小模型((S. Li et al., 2022)。与小型模型相比,大型模型在推理能力、计算能力和泛化方面表现出了显著的性能((L. Li, Zhang, et al., 2023; Shridhar et al., 2023)。尽管大型模型的出现改变了分散的模型开发模式,即单个AI应用场景中的多个任务需要多个模型的支持,每个模型都需要算法开发、数据处理、模型训练和调优(Y.-F. Li, Wang, et al., 2023)。尽管如此,小型模型仍然具有显著的优势,例如训练成本低、尺寸较小、易于维护。因此,可以采用“小模型车间”和“大模型工业化”相结合的方法,在考虑到这些模型各自优势的情况下,充分挖掘这些模型的潜力。LLM的生成能力是其最显著的特征。在数据缺失不可避免的行业中,LLM在生成缺失的事件序列值或填充时间序列数据方面证明了它们的价值,使领域模型能够有效地解决缺失数据的挑战。此外,LLM还可以作为集成不同领域模型的综合模型库。这种集成方法是通过使用评分机制聚合多模型来识别最优模型来实现的。领域模型更适合于特定的领域,其中LLM更一般化以处理更复杂的工业任务。Yao(2023)认为,大模型和小模型可以从数据交互、模型交互、应用交互三个方面进行组合,如表1所示。表1 小模型车间vs大模型工业化((Ma et al., 2023; Q. Yao, 2023) 这种小模型和大模型的结合增强了学习和处理复杂问题的能力,同时为时间序列数据的深度特征提取和处理奠定了基础。这些模型可以发现底层的发现模式、趋势和相关性,提取这些信息作为领域模型的输入特征。因此,领域模型可以直接从细粒度特征中学习,减少它们对原始数据的处理,提高领域模型理解和分析时间序列数据的能力。2.2. LLM &时间序列数据故障诊断ChatGPT的成功引起了学术界的广泛关注,使得LLM应用于时间序列数据故障诊断的研究兴趣增加(Wu et al., 2023)。Li等人(2023)已将设备健康管理和预测确定为LLM应用的未来研究方向。他们认为当前的深度学习模型需要从单模态、单任务的方法转向利用大量数据的多模态、多任务的方法。他们认为,现有的深度学习方法在认知和泛化能力方面存在局限性。同样,Zhou等人(2023)提出了一种创新的解决方案,称为D-Bot,专为数据库管理员设计。D-Bot通过LLM持续从文本资源中获取数据库维护经验,并为目标数据库提供持续的诊断与优化建议。此外,Chen等人(2023)提出了一种称为racopilot的方法,该方法使用LLM分析自动识别云事故的根本原因。racopilot依靠LLM来总结故障信息,并预测多事件故障,以确定其根本原因。Ahmed等人(2023)将LLM推理和总结技术应用于历史故障文本,如故障描述、根本原因报告和建议的解决方案。通过这种方法,他们为新出现的问题推荐根本原因和解决方案。本研究提出一种任务驱动的LLM框架,用于时间序列数据的故障诊断。该框架将LLM与Pandas、Scikit-learn、SQL和本地数据库结合起来,用于对时间序列数据进行数据处理和模型推荐调用。此外,这些研究证明了LLM在时间序列故障诊断中的应用前景,克服了现有方法的局限性。2.3. 时间序列数据prompt的开发Prompt是用户与LLM交互的关键界面。没有它,LLM就无法理解用户的问题。Prompt包含两个组成部分:一是指示LLM执行操作的指令,二是明确用户期望LLM完成任务的具体问题。Teven et al.(2021)曾指出,prompt包含了相当多的信息,一个prompt可以相当于100个真实的数据样本。此外,prompt在数据稀疏的垂直领域中提供了重要的支持,即使在零样本场景中也表现出色,这使得prompt技术成为使用LLM的重要组成部分。目前,prompt设计方法分为少镜头(Madotto等人,2021)、思维链prompt过程(CoT) (Wei等人,2022)、零镜头思维链(Kojima等人,2022)、自一致性(Wang等人,2023)、知识prompt生成(X. Chen等人,2022)、过程辅助语言(PAL) (Gao等人,2023)、和ReAct (S. Yao等,2023)。然而,时间序列数据的prompt设计方法仍处于探索阶段。Li et al.(2022)提出了一种预测时间序列特征的prompt技术,但使用语言驱动Bert模型预测时间序列的过程需要考虑时间序列数据对齐的问题。此外,对未来信息的预测需要考虑领域知识,以获得更好的结果。为了解决这些问题,Xue等人(2023)开发了PromptCast方法,该方法使用文本到文本的输入进行时间序列预测。然而,这种方法在时间序列数据中遗漏了大量的信息。因此,Sun等人(2024)提出了TEST方法,该方法将时间序列数据转换为用频率、形状和值来描述的文本表示。这使得LLM能够处理和分析时间序列数据。本研究设计了一个时间序列故障诊断的prompt结构,能够处理时间序列数据、模型检索、因果关系校正等应用,结果证明了其有效性。3. 基于LLM的人在环任务驱动的钢铁冶金故障诊断2.0框架3.1. 基于LLM的任务驱动方法工业时间序列数据的传统故障诊断过程严重依赖人工干预。这包括对数据进行手动标注和预处理,手动整合领域知识以纠正因果关系,手动选择算法模型进行数据预测和异常检测,以及手动整合领域知识以确定故障的原因和解决方案。在整个故障诊断过程中,大量的人力和物理资源是必不可少的。然而,大量的人工干预消耗大量人力物力,且非专业人员难以有效处理故障问题。就及时性而言,存在显著延迟,难以实现快速诊断。即便是专业运维人员,其知识储备有限,可能难以应对新出现的问题。因此,需要一种能够自动化任务处理、存储广泛领域知识、有效处理复杂任务的方法。LLM通过用户提问和回答促进快速解决问题,充当用户和知识库之间的纽带。通过不断调整其角色以响应用户需求,LLM捕获最相关的知识并为自动化工作流程做出贡献。数据和知识流的这种范式转变彻底改变了当前基于任务的流程。我们重新定义了基于LLM的任务驱动方法,并将其与另外两种驱动方法(数据驱动和数据知识驱动)进行了比较。数据驱动的方法完全依赖数据来驱动整个过程,而数据和知识驱动的方法则结合了领域知识来增强数据驱动的方法。相反,基于LLM的任务驱动方法封装数据和知识来定义和分解用户提出的任务。由此产生的数据和知识流遵循任务流。这种方法采用了分层任务分解策略。首先,它将复杂的任务解构成更直接、更易于管理的任务。然后将这些简单的任务分解成一系列连续的步骤。每一步都有明确的目标和预期输出,以特定的顺序和逻辑关系联系起来,形成一个完整的过程。这种方式实现了任务驱动的自主性,提升了整个任务执行的精准度和效率。3.2. 提出的框架——基于大语言模型的工业时间序列故障诊断(LLM-TSFD)使用LLM进行人在环任务驱动的时间序列故障诊断的框架如图2所示。该模型在整个过程中依赖于两个主要输入:用户prompt和来自中间层的工业时间序列数据。用户prompt由一系列指令和问题组成。一旦经过人在环的LLM处理,就可以输出期望的结果。在数据处理任务中,将输入数据可视化,预处理后的数据以CSV格式本地存储。在故障检测任务中,输出的是修正后的因果关系。在故障诊断任务中,模型推荐预测/检测模型,并提供故障检测和预测的结果。在这个过程中,LLM在知识库中搜索最相关的内容作为输出。当遇到新问题时,LLM可以在网络中搜索找到合适的解决方案。 图2 使用LLM进行故障诊断的结构框架概述了利用LLM从输入到输出的整个过程。输入由用户需求和待处理的数据组成,结合prompt形成一个完整的问题,成为用户需求目标。用户需求被转移到LLM,分解成单独的子任务并排序。任务根据它们的排序顺序依次执行。结果以两种形式提供给用户:定量反馈和二进制反馈。如果对结果不满意,用户可以将其修改为标准答案,并在收到满意的输出之前将其传递回LLM用于学习。最后,将结果与第三方工具集成,用于数据处理、因果发现和故障诊断等方面的应用。图2右侧展示了人机协同的大型语言模型(LLM)工作流程。该模型采用“循环”机制运作:用户先设定目标,通过LLM理解并分解任务,再按分解后的步骤依次执行。任务完成后,LLM会通过两种方式与用户互动:首先是二元反馈机制,LLM给出答案后,用户可选择“满意”或“不满意”。若用户不满意,LLM会修正答案,或用户可修改问题引导LLM提供更精准的回应,这种迭代过程能不断优化答案质量。其次是量化反馈机制,LLM在执行任务时会查询数据库或向量数据库,通过计算查询内容与知识库的相似度来确定置信度——低置信度表示匹配度较低,高置信度则匹配度较高。当置信度较低时,LLM会提示用户答案可能不够精确,并建议修改问题以获取更详细描述。在整个任务驱动过程中,人机持续互动,各阶段都鼓励反馈。这种循环中的反馈机制有效提升了LLM的性能表现和可解释性。LLM的工作机制体现在任务分解和执行上。这个过程主要分为三个模块:数据处理、因果发现、故障诊断,如图3所示。红色虚线框起的部分突出了LLM的工作部分。对于数据处理,用户输入的问题经过令牌嵌入和位置嵌入来产生一个向量 , , 表示第 个单词。LLM对 向量进行处理,生成答案。输入向量 乘以模型得到的 、 和 矩阵,生成 、 和 矩阵。这些矩阵被自关注机制用来计算相似度,如式(1)所示。式(1)中的 、 和 分别对应第 个元素的查询向量、键向量和值向量。 对查询向量( )、键向量( )和值向量( )矩阵进行点积运算。接下来,将注意力分数相乘并求和,以获得上下文语义向量的注意力权重。完整的过程可以用下面的等式来表示: 对于公式(2)中的每个元素 和 ,我们计算一个关注分数( , ),它表示 对 的关注程度,其中 是关键向量的维度, 是缩放因子;式(3)中的注意力分数通过softmax函数得到 的注意力权重;式(4)中的 为值向量,对其进行加权求和,得到最终的上下文矩阵 。上下文矩阵不仅包含当前单词的信息,还包含上下文信息,帮助模型理解不同段落中每个单词的含义。 图3 使用LLM进行任务处理的示意图:LLM是一种Transformer结构,在注意力模块中以Q、K、V作为关键参数。LLM中任务处理的主要目标是对输入内容进行矢量化,并在知识库中进行匹配,以获得最相似的输出生成。有最高的相似度。这些片段被输入到LLM中,使用自注意机制生成上下文向量,类似于数据处理中生成答案的过程,最终产生修改后的因果关系。LLM通过全连接层将上下文向量映射到高维空间,随后将结果转换为词汇表大小的向量,并通过softmax函数生成每个词的概率分布。输出代码完全符合用户需求。在因果发现过程中,用户输入的因果关系被嵌入系统,随后与存储专家知识的向量数据库内容进行相似性匹配,从而确定相似度最高的相关语段。这些片段被输入到LLM中,通过自注意力机制生成上下文向量,其过程类似于数据处理中的答案生成机制,最终产生修正后的因果关系。在故障诊断过程中,用户查询会被嵌入向量并与包含SQL数据库表结构的向量数据库内容进行比对。通过识别最相似的向量片段,LLM利用自注意力机制建立上下文语义相似性。最终根据用户需求生成SQL语句,该SQL查询将作用于MySQL数据库以确定模型位置并向用户推荐合适模型。故障分析阶段中,蓝色箭头标示文本嵌入后的处理流程:完成编码后,向量数据库会检索故障原因并找到最相似片段,随后运用自注意力机制计算上下文向量,最终生成故障原因诊断结果。4. LLM在工业时间序列数据故障诊断中的作用LLM是一个通用的模型,因此找到其工业生产能力并推动行业向前发展至关重要。在与LLM的互动中,不同的个人和背景可以以不同的方式解释内容。因此,为LLM建立定义角色、场景和其他相关因素的规则对于增强模型的领域知识和改善结果是必要的。AutoGPT是ChatGPT的扩展,允许用户定义角色并将其分配给GPT。相反,MetaGPT分配特定的角色并提供详细的信息,提高LLM对各自领域的理解。因此,为LLM分配适当的角色对于有效学习工业时间序列数据至关重要。图4描述了FD2.0期间LLM的预期角色。这些角色如下:(1)数据管道管理器:LLM执行自动化数据预处理、清洗、标记和可视化。这减少了运维人员在数据标注和处理上花费的时间和精力。(2)监督器:LLM修正传统算法建立的因果关系。该任务通过将领域知识与逻辑推理相结合,以实现对因果关系的精确判定。(3)控制器:LLM调用算法中的模型,通过用户建议进行故障预测与识别。针对实际生产问题,LLM可推荐合适的机器学习模型并启动其本地执行。(4)决策器:LLM通过理解检测过程并以运维人员可以理解的方式呈现模型的行为来检测异常结果。此外,LLM概述了诊断结果,供工作人员参考和理解。 图4 LLM在故障诊断2.0中的作用价值:对于数据处理,LLM的作用类似于管道管理器。对于因果发现,LLM扮演的是监督者的角色。最后,对于故障诊断,LLM同时承担控制器和决策者的角色,以有效地诊断故障。下面将详细描述LLM所扮演的每一个角色。4.1. 管道管理器当前的行业领域模型依赖于数据质量。数据来源于多个传感器、设备和系统。尽管如此,这些数据通常包含噪声、缺失值和异常值,这可能会影响模型的准确性和可信度。此外,工业数据具有独特的结构、格式和标准。为了有效地分析这种多样化的数据范围,对这些异构数据源的分析进行集成和统一是至关重要的。传统上,需要专业人员来处理、标记数据,并将结果与相关专业知识相结合,以实现高效的解释。此外,特定的平台界面可能会限制用户偏好的灵活性。本研究提出使用LLM来处理时间序列数据。首先,通过对话采用直接的数据分析减少了对人工设计数据分析技术的需求,最大限度地减少了主观性,提高了工作效率。其次,使用对话以用户想要的格式输出数据图表,有效地满足了特定的需求。LLM充当管道管理器,监督数据流和处理。整体流程如图5所示。用户提供一个工业时间序列数据文件和一个任务问题作为管道管理器的输入。随后,管道管理器调用LLM代码生成代理,后者根据用户的输入生成所需的代码。然后执行生成的代码并返回一个输出结果。在需要进行数据预处理的情况下,LLM生成处理后的CSV文件,并将其保存在本地。同样,如果需要数据可视化,则生成可视化图表以满足用户的需求。在代码生成阶段,导入pandas和sklearn库,允许使用各自的函数进行数据处理。此外,如果LLM检测到输入数据的维度发生了变化,它将保存历史信息。因此,依赖这些维度的模型被标记为“需要维护和更新”。 图5 LLM作为数据处理的管道管理器:LLM结合一些Python库进行数据处理,生成完整的代码内容。在本地环境中执行代码,然后生成所需的答案、CSV文件、图像等。考虑到用户的任务需求,LLM会自动生成适当的代码进行数据分析。为了简化处理操作,引入了相关的第三方库,从而自主生成用户期望的结果。4.2. 监督器在完成数据处理后,需根据具体工程问题和数据特征,选择合适的因果推断方法或模型进行因果发现。一旦通过模型提取了因果关系,就需要对结果进行评估和验证,以确保其可靠性和适用性。传统方法通常需要进行交叉验证、敏感性分析等一系列操作进行验证。此外,与领域经验协作的讨论和验证是不可或缺的。LLM具有一定的推理能力。当提供模型推理结果、专家知识和需求时,LLM可以充当监督器,将其推理与模型输出相结合,对因果关系进行判断和验证。通过将其推理结果与模型输出相结合,LLM可以对因果关系进行纠正和细化,从而得出更准确的结论。由于传统模型缺乏领域知识,因果关系的发现表现出一定的偏差。要学习真正的关系,需要相关的领域知识来指导模型。本研究建议LLM可以充当监督器,如图6所示。利用LLM的推理能力修改原来的因果发现增强了因果关系的发现能力。用户输入从传统算法模型推导出的因果关系,在进入LLM后结合领域知识对其进行修改,推导出更合理的因果关系。最后,将因果关系的输出表示为因果图。 图6 LLM作为因果纠错的监督器:用户输入初始的因果关系,结合专家知识库对因果关系进行纠错,最后输出纠错的结果。在这个过程中,用户的初始关系被嵌入到向量中,并与存储在向量数据库中的向量进行相似性比较。更相似的片段被输入到自关注机制中,生成符合用户期望的响应。4.3. 控制器在企业中,模型通常部署在本地环境中,以确保隐私和安全。当需要进行预测性维护、异常检测或设备剩余寿命预测时,必须选择合适的模型。如果数据状态保持不变(即没有出现新的传感器或额外的维度),则可以使用预训练的模型进行预测。然而,在现实场景中,传入的数据是不断更新的,因此必须不断维护和更新模型,以确保其有效性和对不断变化的数据的适应性。本研究提出使用LLM作为模型控制器,帮助用户选择模型,并提供模型是否需要更新的反馈,如图7所示。用户将问题和时间序列数据输入到LLM中,LLM随后分成两条处理路径。首先,它比较输入的时间序列数据文件,以检查是否有新的传感器或维度。如果LLM检测到任何新的维度,则标记相关模型并向开发人员提及模型需要更新。其次,如果没有新的维度,LLM会根据用户的需求从算法库中推荐一个模型,并对输入文件进行处理,生成所需的输出。 图7 LLM作为模型调度过程的控制器:用户向系统提供需要处理的需求和数据。然后LLM算法将此输入与SQL数据库进行匹配,以推荐匹配度最高的模型。随后,被推荐的模型输出故障检测/预测结果。在这个过程中,LLM作为一个控制器,管理从算法库中选择模型,同时评估输入数据的维数。这种方法可以快速选择模型进行处理和支持模型更新以确保准确的预测结果。4.4. 决策器工业中机械设备故障诊断的可解释性往往较差。数据驱动的模型使得用户很难理解故障的具体原因和解决方案。同样,知识驱动模型表现出不完整的知识表示(例如,知识图和专家系统),使得难以处理新问题。本文提出使用LLM作为用户需求和处理解决方案之间的沟通桥梁。LLM可以通过理解用户需求、采用网络化搜索、调用模型以及连接数据库来方便用户理解来找到最优解决方案。本研究提出,LLM作为具有本地知识库和网络搜索的决策者,为诊断故障的原因提供可读的解释,如图8所示。首先,将用户的问题嵌入并与存储在向量数据库中的领域故障知识进行匹配。如果存在相似度相对较高的片段,则生成诊断结果。在相似度较低的情况下,进行网络查询,获取问题的相关信息。然后将答案存储在向量数据库中,补充现有知识,并能够为用户生成所需的结果。 图8 LLM作为决策者进行决策:用户输入一个经过编码并与向量数据库中的内容匹配的需求。然后输出最相似的内容。如果没有匹配,系统搜索网络,并将任何找到的内容作为新知识添加到向量数据库中。4.5. 基于工业时间序列数据的故障诊断prompt的设计过程LLM中的推理过程包括三个主要组成部分:输入、推理和输出。Prompt还作为一种引导机制,在LLM中指导整个推理过程。在不设计prompt的情况下,当用户输入问题 时,模型预测文本的概率 可以表示为: Prompt的添加可以看作是提供了额外的约束。如果prompt设置为y,则模型预测文本的概率为 。这表明,在指令条件下,通过限制用户输入问题,模型可以为用户生成期望的结果。从本质上讲,prompt是用来将原始概率空间缩小到与其相关联的子空间。因此,预测概率 可以表示为: 在LLM中,prompt的添加通过提供条件约束来修改概率空间,这些条件约束引导模型生成条件相关的输出。这个过程增强了语言模型的响应与用户期望之间的一致性,从而提高了其性能和泛化能力。此外,准确的prompt对于使LLM有效地发挥作用并产生令人满意的结果起着至关重要的作用。然而,重要的是要注意,LLM是一个广义模型,缺乏特定领域的理解。他们需要在一个知识领域内的指导,才能知道如何解决问题。为了解决行业内时间序列数据中的故障诊断问题,本文提出了一个prompt结构来指导任务驱动的开发。Prompt设计结构如式(7)所示。 在式(7)中,在式(1)的基础上添加约束,约束内容,记为 ,即本研究提出的prompt结构。prompt由七个核心组件组成:时间( )、角色( )、输入形式( )、任务分解( )、输出形式( )、推理形式( )和领域知识( )。角色(R)是由本研究提出的四个角色组成的四元数结构: 。具体来说, 代表时间序列数据分析专家, 作为时间序列因果关系发现的修饰语, 作为时间序列故障诊断模型推荐专家, 承担时间序列故障诊断决策专家的角色。在式(7)中, 表示便于记录的当前日期。 和 为LLM提供具体的角色和相关的行业领域知识。这使得LLM能够了解自己处于什么样的场景,扮演什么样的角色,接下来需要完成什么样的任务。一组定义良好的工业场景和领域角色为LLM提供了对其工作的更清晰的理解,类似于人类工作工程。这使得模型能够理解其在公司中的位置,并预测下一步。接下来,需要将LLM配置为接受 形式的输入和 形式的输出。为了根据用户的任务生成代码,可能需要将用户上传的文件处理成代码可以理解的格式。为了增强LLM的数据处理能力,可以集成Pandas等工具,将输入转换为DataFrame格式进行程序化处理,从而提高数据处理的效率。考虑到用户的任务需求有时不明确,自动化任务分解就变得很有必要。这个过程使LLM能够逐步分解和理解用户的目的,从而达到预期的结果。此外,在推理过程中, 设置的方法如下:LLM逐渐一步一步地思考,最终导致更好的结果生成。LLM基于上述框架进行操作,然后输出结果。展示了LLM对数据进行分析和处理的过程,如图9所示。第一步包括引入必要的工具包,然后确定分析过程的输入。最后,分解并执行用户的任务需求。在本地执行LLM生成的代码时,同时返回对运行结果的解释,以方便用户理解。表2展示了时间序列故障诊断prompt设计的示例体系结构。 图9 以数据处理为例,生成prompt LLM代码的过程:在prompt的指导下,对用户的需求进行分析并分解为子需求。LLM对这些子需求进行相应的优先级排序和处理。如果问题与数据处理有关,LLM的最终输出将是处理此类数据的相应代码。表2 时间序列数据故障诊断prompt设计框架 5. 案例研究钢铁冶金是一个重要的工业领域,严重依赖于高效的设备来保持生产力和产品质量。目前,位于中国宝山的一家钢铁冶炼企业在处理时间序列数据故障诊断方面面临挑战,特别是在资源有效利用和工作效率方面。因此,迫切需要一种智能和自主的方法来增强开发周期、维护后流程和用户可读性。5.1. 环境下框架的建立针对FD1.0和FD1.5带来的问题,本文提出了LLM任务驱动方法在钢铁冶金领域的故障诊断应用。图10给出了一个连铸设备故障诊断场景。 图10 基于LLM的工业时间序列数据故障诊断平台:实施LLM不仅减少了人力和物力资源,而且缩短了平台的开发周期。此外,它有效地利用经验知识来评估因果关系的准确性和所选模型的适当性,以促进决策过程。平台根据LLM建立的角色进行划分。最终的故障诊断模块包括两个关键组件:故障模型的选择和诊断信息的问答,涵盖了分配给LLM的两个角色。LLM系统的第一个模块作为数据管道管理器。用户上传一个CSV文件,其中包含机械设备上某个传感器在特定时间段的数据,并指定要处理的任务,以获得相应的输出。传统方法需要人工经验来设计数据处理方法,需要领域工作人员了解标记数据的相关上下限限值,与此相反,LLM可以取代这些任务。用户将任务输入到LLM中,然后LLM将其分解为子任务,提供调优代码的反馈,在本地执行,根据此经验添加相关的领域经验进行标记,并允许用户确定他们想要的输出格式。用户可以通过告知LLM他们喜欢的显示类型,将任何格式的输入数据可视化。此外,使用历史信息作为参考点,LLM确定当前输入文件中是否存在新的维度数据;如果存在,后续模型将相应地进行标记,并发出有关维护或更新的通知。图11显示了使用LLM可视化显示功能在钢铁冶金领域执行处理设备相关CSV文件相关操作时的用户对话过程。如果用户对LLM的初始输出产生的结果不满意,他们可以提供反馈,这将促使LLM进一步响应,直到获得满意的结果。 图11 使用LLM进行数据处理操作的用户对话流程:一旦用户输入问题并上传文件,LLM将生成相应的响应以及处理后的CSV文件或图表。系统的第二个模块是因果发现,其中LLM作为传感器数据中变量之间因果关系的校正器。最初,用户使用常见的因果分析算法建立变量之间的基本关系。然后将这些算法的输出馈送到LLM中,LLM结合从规则库中学习到的领域知识来确定是否有任何关系需要纠正。虽然传统方法要求用户拥有或搜索相关知识才能做出因果判断,但在采用LLM后,允许用自动化流程取代领域专家。图12说明了如何使用LLM通过二进制和定量用户反馈机制执行因果关系校正操作。在二元反馈模式下,用户可以通过点击“同意”或“不同意”来表示他们对LLM答案的满意程度。在定量反馈模式下,LLM根据与向量数据库中的匹配项的相似度得分来评估置信度;如果置信度分数太低,则提供主动反馈,以prompt用户进行更详细的问题描述。 图12 使用LLM的因果关系校正操作过程:LLM通过使用二进制和定量反馈机制对其输入的因果关系进行校正。前者提供答案是否正确的信息,而后者则通知LLM它提供了不充分的响应,需要用户的额外输入。第三个模块是故障诊断,包括LLM控制器和决策器。在传统方法中,专业操作员设计一个模型,并提供一个描述供用户选择,包括每次使用需要修改的输入和参数。然而,使用LLM,用户只需要描述任务,LLM将他们的描述与本地算法库中最合适的模型相匹配。然后,用户选择输入数据通过模型接口运行,然后获得所需的结果作为输出。图13说明了这个过程。故障诊断模块包括故障检测模型推荐、故障预测模型推荐和故障诊断建议三个子模块。在提出检测或预测故障的模型时,LLM检索数据库,根据用户需求推荐合适的模型。如果用户对推荐的结果不满意,他们可以提供二进制反馈(满意/不满意)。在故障诊断过程中,LLM在数据库中搜索可能提供答案的相似片段。如果没有找到,则表明用户问题与知识库内容之间的相似性较低,要求提供更详细的问题描述。此外,每个答案有四个对话选项:复 制、引用、查询和评估。“复 制”允许用户将答案复 制到剪贴板上。通过选择“引用”,用户可以跨长度进行诊断。通过从上下文中选择一个特定的回应,引用它,然后提出一个问题,引用和查询可以传输到LLM中进行进一步的分析和响应。图13在引用LLM之前的回复或提供二进制反馈(“评估”)时显示了这些选项以及网络搜索功能(“查询”)。 图13 使用LLM的故障诊断过程:用户向LLM输入需求,随后,LLM从其本地存储库中推荐最合适的模型。此外,通过LLM的知识库或通过互联网搜索也可以查询故障原因。5.2. LLM-TSFD结果讨论5.2.1. LLM-TSFD与未使用LLM的钢铁冶金故障诊断方法的比较本文将提出的方法与不使用LLM的方法进行了比较。具体而言,开发了一个用于钢铁冶金企业故障诊断的平台。该平台基于深度学习方法,不包含LLM,如图14所示。该平台利用预训练的深度学习模型进行故障分析。用户选择合适的模型,模型检测异常。此外,用户可以选择预测模型,该模型预测未来时间窗内的值,并根据预定义的规则检测异常(如图14所示)。一般来说,工业中用于故障诊断和预测的深度学习模型通常是监督式或半监督式学习模型。这些模型需要手动标记数据,以实现精确的检测和预测。然而,在企业内部不易访问标记数据的情况下,无监督学习可能是模型训练的唯一可行替代方案。此外,新的数据模式经常出现在工业时间序列数据中,而这些数据不能单独从历史数据中学习。因此,需要提高无监督模型的能力。对数据标记挑战的一个潜在解决方案是利用LLM,它可以在时间和效率方面提供优势。通过依赖LLM而不是手工标记过程,组织可以简化他们的工作流程,并以更少的努力获得更准确的结果。深度学习模型需要标记数据进行训练。考虑到工业时间序列数据的复杂性,增强基于高度相关数据的多维异常检测至关重要。操作员可以使用因果算法来识别每个维度之间的因果关系。然而,仅仅依靠这些算法可能会导致错误的关系。为了获得更准确的因果关系,将LLM与专家知识库合并可以帮助做出更正确的判断。图14(a)示出了平台的模型配置模块。后端为十个预训练模型提供接口,用于异常检测和预测。为了有效地检测异常,用户必须选择合适的深度学习模型。然而,由于他们不知道哪种模型会产生更好的结果,他们只能通过不断的试错来获得最优的结果。图15(a)描述了LLM如何根据用户输入要求推荐算法。相比之下,图14(b)的故障线图并没有为用户提供可读的信息。图15(b)展示了LLM如何通过将流行场景与领域专家知识相结合来解释警告结果,从而增强可读性。 图14 基于深度学习的钢铁冶金行业预警平台(FD1.0/1.5) 图15 基于深度学习的钢铁冶金行业预警平台(FD2.0)本文从可读性、自主性和泛化三个方面对未使用LLM的FD1.0或FD1.5中的故障诊断方法与FD2.0中使用LLM的方法进行比较,结果如表3所示。根据表3,“不使用LLM”是指仅使用深度学习方法进行故障诊断,而“LLM- TSFD”是指本文提出的使用LLM进行故障诊断的方法。管道管理器、监督器和控制器等角色对可读性要求不高,因此本文不考虑其对用户的可读性。但是,决策器需要告知用户检测到的故障、原因、解决方案和措施。当操作员依赖基于深度学习的故障诊断方法而没有LLM时,用户缺乏可读性。相反,当与知识库相结合时,LLM可以提供可理解的故障信息。LLM还增强了方法的自主性,消除了需要大量人力或物力来重写程序代码的需要,因为它可以基于LLM进行任务驱动。这种概括允许其应用于各种场景,如本文中讨论的管道管理器、控制器和决策器。表3 使用LLM与不使用LLM异常诊断结果的比较 5.2.2. FD 1.0、FD 1.5、FD2.0的比较本文对FD 1.0、FD 1.5和FD 2.0方法进行了对比分析。数据集来源于中国上海某钢铁冶金企业。培训和测试数据来源于工业连铸设备。研究主要集中在导辊电流和结晶器截面的数据上。导辊电流主要包括S1至S16的上辊电流和S8至S16的下辊电流。结晶器截面的数据包括宽面的内弧出口流量、宽面的外弧出口流量、窄面的右侧出口流量、窄面的左侧出口流量以及结晶器的液位。该数据集包含85000个条目,其中80%用于训练集,剩下的20%用于测试集。训练和测试在8个A100 GPU上进行,实验结果如表4和表5所示。表4 基于连铸设备导辊电流的FD1.0-FD1.5-FD2.0异常检测结果比较 表5 基于连铸设备结晶器截面的FD1.0-FD1.5-FD2.0异常检测结果比较 本文使用精确率, 召回率和F1分数作为评价指标来综合评价和比较所采用方法的性能。此外,本文还将所提出的方法与11种公开可用的时间序列异常检测方法进行了比较:Agglomerative Clustering (Müllner, 2011), Long Short-Term Memory (LSTM) (Karim et al., 2018), Temporal Convolutional Networks (TCN) (Y. He & Zhao, 2019), Mamba (H. He et al., 2024), Transfomer (Wen et al., 2023), iTransformer (Liu et al., 2024), Kmeans& rules (Budiarto et al., 2019), Autoencoder& expert system (Valtierra-Rodriguez et al., 2023), Knowledge-Distillation (Pol et al., 2023), Time-GPT (Garza et al., 2024), and Prompter-GPT (Alnegheimish et al., 2024)。这些指标从不同的角度评估了方法的性能,提供了更全面、更精确的比较结果。精确率:精确率衡量正确预测的异常在所有被预测为异常的样本中所占的比例。它是一个统计度量,重点关注被分类器分类为正的数据。 召回率:召回率衡量的是模型正确识别的实际异常的比例。 F1分数:考虑到预测的准确性和完整性,F1分数是精确率和召回率的调和平均值。其最大值为1,最小值为0,值越高表示模型性能越好。 其中,TP表示正确分类的阳性样本数量,FP表示错误分类的阴性样本数量,FN表示错误分类的阳性样本数量,TN表示正确分类的阴性样本数量。表4将本文方法与故障诊断的FD1.0、FD1.5和FD2.0时期的几种典型模型的异常检测结果进行了比较。在每个阶段,异常检测结果最好的模型以粗体突出显示。在FD1.0阶段,最优模型为TCN;在FD1.5阶段,最佳性能模型为K-means & rules;在FD2.0阶段,该方法实现最优。此外,本文还将本文提出的方法与上述两种方法在精确率、召回率和F1分数方面进行了比较。结果表明,我们的方法在利用连铸设备中各种导辊的电流值进行异常检测方面优于其他两种方法。表5主要分析了来自连铸设备结晶器部分的数据,并对FD1.0、FD1.5和FD2.0阶段的几个模型进行了评估。本文使用精度、召回率和F1分数作为比较指标。Transformer模型、知识蒸馏模型和提出的方法以粗体突出显示,表明性能更好。与其他两种方法相比,本文提出的方法在检测阳性样本的精度较高的同时,保持了较高的召回率。F1分数也是最高的,证明了所提方法具有优越的检测性能。5.2.3. 消融实验本文比较了两个数据集上11个公开可用模型的平均F1分数,如图16所示。散点图显示每个模型的平均F1分数,颜色越深表示值越高。Prompter-GPT模型平均得分最高,可作为消融实验的基线模型。此外,当使用大型语言模型作为故障检测的决策器时,我们提供了对结果的解释性文本分析,这与管道管理器,监督器和控制器模块的评估方法不同。因此,本节的消融实验主要关注管道管理器、监督器和控制器模块在精确率、召回率和F1分数方面的性能,以评估它们在基于从连铸设备收集的数据的故障检测中的有效性。 图16 本文评估了11个模型在不同数据集上的Precision、Recall和F1分数。图中渐变的圆圈表示在两个数据集上计算的每个模型的平均F1分数。颜色越深表示数值越高。Prompter-GPT模型平均F1分数最高,可作为消融实验的基线模型。本文将管道管理器、监督器和控制器模块引入基线模型,并评估其有效性,如表6和表7所示。表6给出了使用来自连铸设备的导辊电流数据进行消融实验的结果。从表6中可以明显看出,将管道管理器和监督器模块添加到基线模型中可以提高精确率、召回率和F1分数,从而证实了这些模块的有效性。控制器模块利用了大型语言模型推荐的模型,取代了目前的基线模型。当引入控制器模块时,与仅包含管道管理器和主管模块的基线模型相比,有显著的改进。与基线模型相比,所提出的方法在精确率、召回率和F1分数方面都有提高,证明了所提出模块的有效性。表7显示了使用连铸设备结晶器部分数据进行消融实验的结果。当基线模型包含管道管理器和监督器模块时,精确率,召回率和F1分数得到改善。此外,控制器和管道管理器模块的组合优于仅使用管道管理器模块的基线模型。然而,控制器和主管模块的组合与只有主管模块的基线模型相比,性能略差。然而,同时使用这三个模块的性能要优于基线模型、带有管道管理器模块的基线模型和带有主管模块的基线模型。这证明了所提的管道管理器、监督器和控制器模块的有效性。表6 基于连铸设备导辊电流数据的消融实验对比 表7 基于连铸设备结晶器段数据的消融实验对比 5.2.4. 在不使用prompt的情况下LLM- TSFD和LLM方法的比较本文采用决策制定者来为用户查询提供可解释的响应,并在钢铁冶金领域提出了一个验证数据集,该数据集包含500个由用户生成的问题和答案构建的问答对。数据集仅包含文本描述,不包含任何伴随的CSV文件或图像。它涵盖了数据处理、因果关系修改、模型推荐结果、故障原因诊断结果及相关意见等多个方面。为了评估我们提出的使用提示(LLM- TSFD)的方法的有效性,我们将其与四种公开可用的LLM(GLM-3、ernie Bot3.5、GPT3.5和GPT4.0)的无提示方法进行了比较。使用四个指标(即bleu-4, rouge-1, rouge-2, and rouge-l)来衡量性能,并将结果展示在表8中。表8 使用所提的prompt(LLM-TSFD)与不使用所提的prompt(无prompt)在四个不同指标下的结果比较 首先简要介绍本研究采用的四个指标:bleu-4分数用于评估四元数案例中预测答 案与标准答案的相似程度,数值越高表明预测结果与参考文本越吻合;rouge-1指标则专门衡量预测结果与参考答案之间的词汇重叠程度。评估预测与参考文本的单个单词或短语的匹配程度。度量值越高,表明结果与参考文本之间的相似性越强。rouge-2度量量化了预测结果与参考文本中两个连续的单词或短语之间的一致程度。分数越高,表示与手动注释的相似度越高。被称为rouge-l的度量量化了预测结果与参考文本中发现的最长公共子序列之间的重叠程度。该指标得分越高,表明性能越好。表8说明了在所有四个公开可用的LLM中,所提的prompt方法优于无prompt方法的性能。为了更直观地观察表8的内容,我们用三维直方图(图17)对无prompt法和LLM-TSFD法进行了对比。其中,蓝色条表示提出的LLM-TSFD方法,橙色条表示无prompt方法。图17清楚地显示,在rleu-4、rouge-1、rouge-2和rouge-1指标区域,LLM-TSFD条的高度始终超过无prompt方法的高度,表明我们提出的模型生成的答案质量更好。 图17 在三维柱状图中,提出的方法与无prompt方法在四个指标下的比较6. 讨论FD1.0的特点是采用数据驱动的方法,依靠手动和自动化的方法来处理来自传感器的时间序列数据,以供人类决策。FD1.5的后续发展以更自动化的方式整合了数据和知识,使处理各种类型的数据成为可能,并增强了人类对模型输出的理解。随着LLM的出现,FD2.0时期现在以用户的任务分解流程为主导。模型具备自主赋能和自反馈调整能力,在处理大规模复杂问题和多模态数据处理任务的同时,节省了大量资源。此外,LLM增强了人类对结果的可读性,从而在一定程度上提高了理解能力。尽管与传统的LLM模型相比,LLM在自主性方面有了显著的进步,但仍然面临着诸如高资源环境要求和对幻觉的敏感性等挑战,这些都需要在未来的研究中进一步研究。目前,所提出的方法主要集中在单一数据源上,特别是CSV文件。在现实场景中,有必要考虑不同类型的数据源。因此,未来的研究将探索如何处理多模态工业时间序列数据。此外,本研究采用的方法主要采用公开可用的通用模型。这些模型缺乏与工业领域相关的特定能力。因此,未来的研究将构建钢铁冶金领域数据集,并开发具有鲜明工业领域特征的大型语言模型。考虑到工程师的专业水平不同,用户对底层算法的理解程度也不同。本文主要侧重于利用LLM结合算法库的内容来帮助不同技能水平的用户选择合适的模型。此外,考虑到LLM固有的推理能力,我们的目标是在未来的工作中充分利用这些能力进行全面的模型推荐。这包括推荐更新模型超参数,以更好地适应新的输入变量,以及其他增强功能。在论文发表后,我们将通过GitHub存储库提供相关的研究代码。7. 结论LLM的出现为解决钢铁冶金中的故障诊断挑战提供了重要机遇,促进了该领域的进步和发展。依靠LLM的数据处理和分析能力,可以获得对冶金过程中潜在故障的准确预测和识别。通过分析大规模数据,LLM可以帮助工程师及时识别潜在故障点,使他们能够在生产中断或质量问题出现之前采取纠正措施。这种组合为故障诊断提供了新的工具,从而提高了可靠性和效率。提出了一种基于LLM的的人在环任务驱动时间序列数据故障诊断方法。利用LLM的生成能力将任务分解为预期结果,同时通过人机反馈协同回路将生成的结果反馈给用户进行修改。我们设计了一个组合推理prompt框架,应用于工业时间序列故障诊断处理,能够调整和指导LLM的行为和输出结果。在钢铁冶金故障诊断中,我们考虑了LLM的四个主要角色:数据处理过程中的管道管理器;因果纠正期间的监督者;模型推荐期间的控制器;和故障诊断阶段的决策者。未来的研究将集中在如何在保护工业隐私的同时最好地应用LLM来维护数据安全。此外,利用LLM的生成能力,根据用户的期望生成仿真数据,也是未来的重点任务之一。此外,我们计划利用LLM的推理能力,为不同专业水平的用户推荐和优化模型,包括超参数调整,以适应不断变化的输入需求。=编辑:陈莹洁校核:李正平、陈凯歌、赵栓栓、曹希铭、赵学功、白亮、任超、海洋、陈宇航、Tina、王金、赵诚、肖鑫鑫、优该文资料搜集自网络,仅用作学术分享,不做商业用途,若侵权,后台联系小编进行删除来源:故障诊断与python学习

    未登录
    还没有评论
    课程
    培训
    服务
    行家
    VIP会员 学习计划 福利任务
    下载APP
    联系我们
    帮助与反馈