
学术版腾讯WorkBuddy开源,起飞了
大家好,我是PaperTody,努力做最Nice的分享。
今年,腾讯的AI Agent产品WorkBuddy大火,主打一个全场景AI办公工作台。
办公场景被安排明白之后,一个自然的问题来了:科研人员的「Buddy」在哪里? 这不,学术版 WorkBuddy 真的来了——而且它不止帮你干活,还会越用越强。
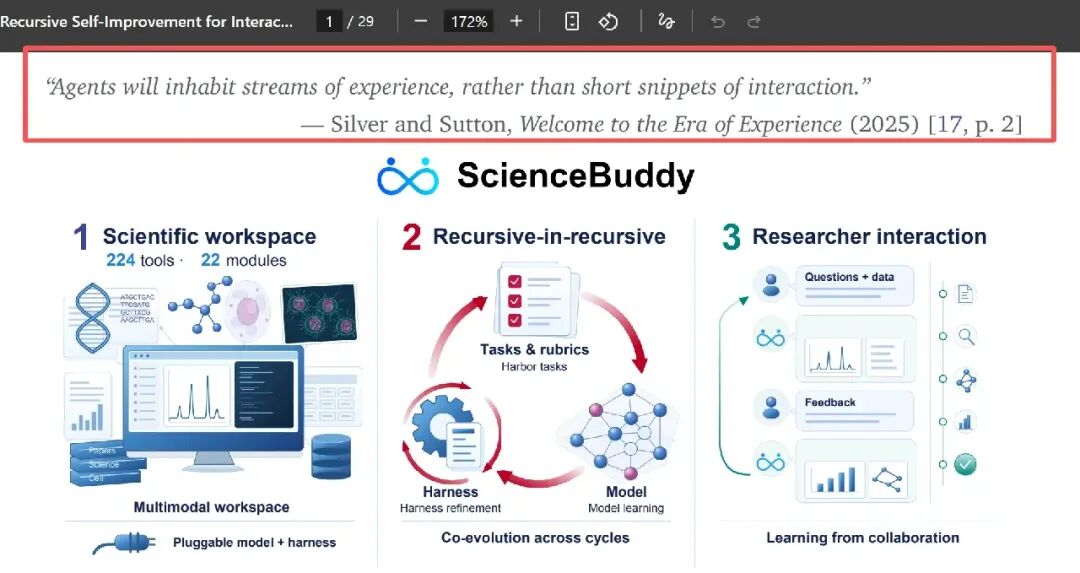
ScienceBuddy 是一个会「越用越强」的科研智能体工作台——它把你日常提需求、给反馈、看结果的过程,自动变成训练任务和评分标准,然后一边改自己的工作流程(harness),一边强化学习底座模型,形成「递归套递归」的自我进化。
能上线的产品&代码已开源
现在的科研 Agent 有个共同的尴尬:对话里纠正了它,下次它还是犯同样的错。
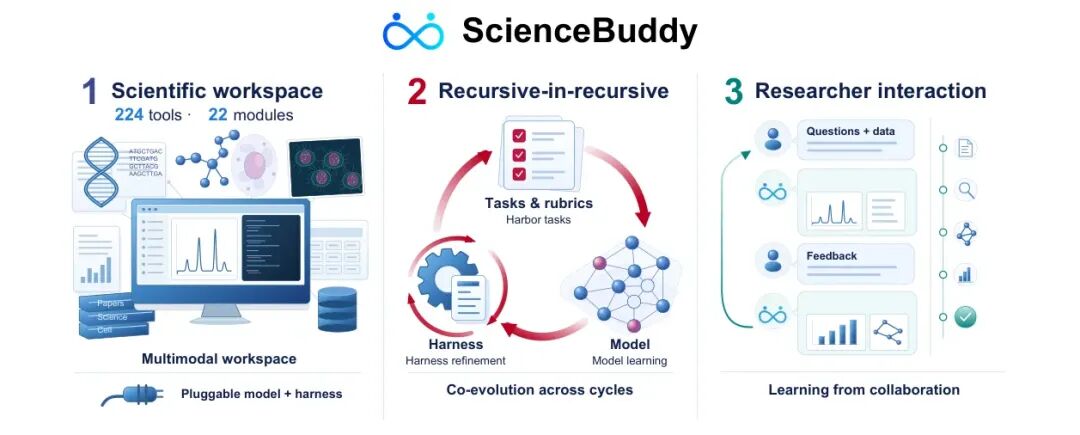
ScienceBuddy 的答案是:让真实协作本身来生产任务和评分标准,用它们同时驱动两层进化。
核心机制:递归套递归
整个系统的骨架是一张「双循环」图:
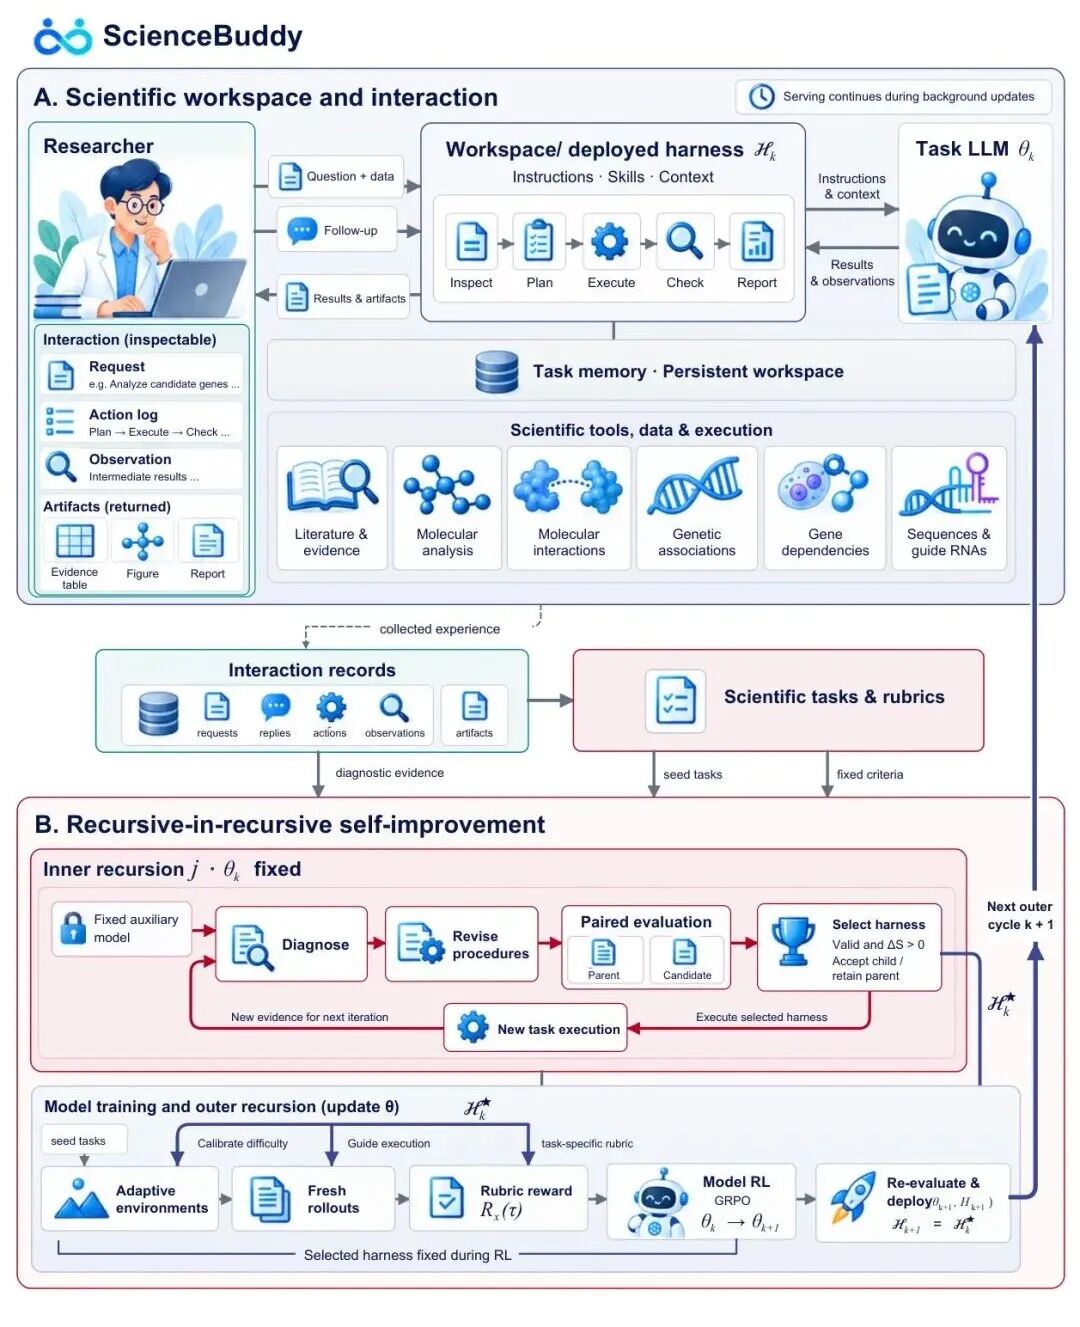
拆开看就三层意思:
内层递归(模型不动):一个固定的辅助模型(GPT-6 Astra)诊断失败轨迹,对 harness 的指令、技能、上下文设置提出「有界修改」;候选方案必须在配对开发评测上严格更好才被接受,否则回滚。
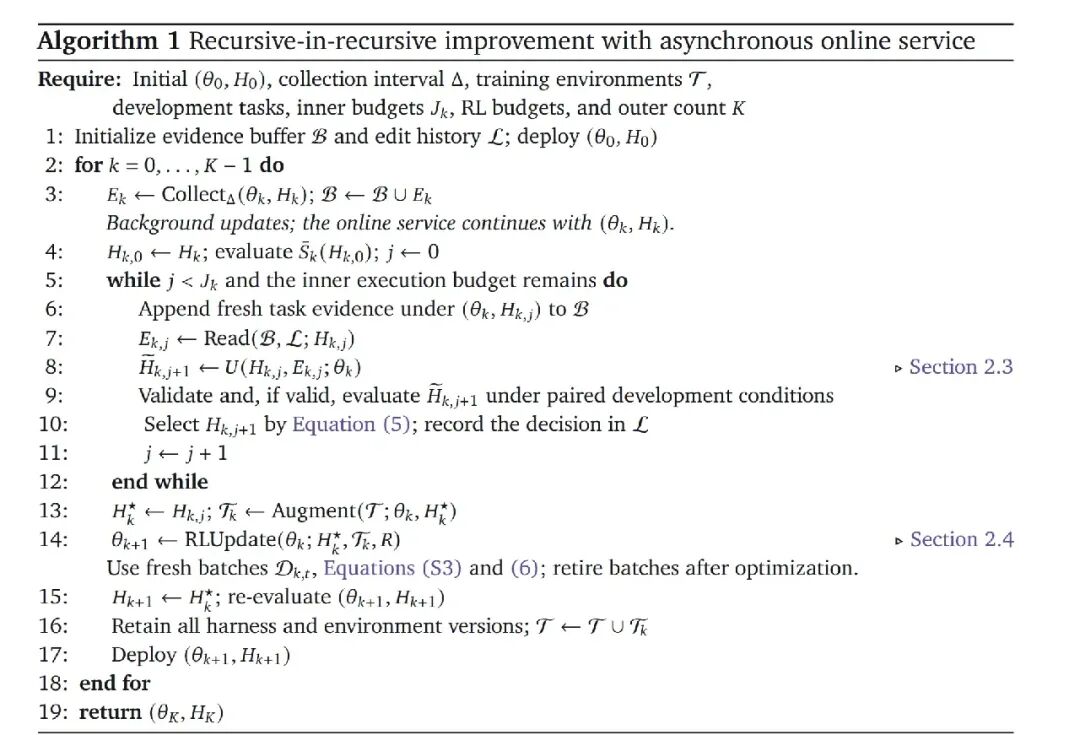
外层递归(harness 不动):用选定的 harness 校准任务难度、跑全新 on-policy 轨迹,rubric 打分当奖励,GRPO 更新模型权重。 耦合滚动:新模型配继承的 harness 重新评测后上线,研究者继续使用,产生的交互又喂给下一轮。后台升级期间线上服务不中断。
那训练任务从哪来?答案是协作记录本身:
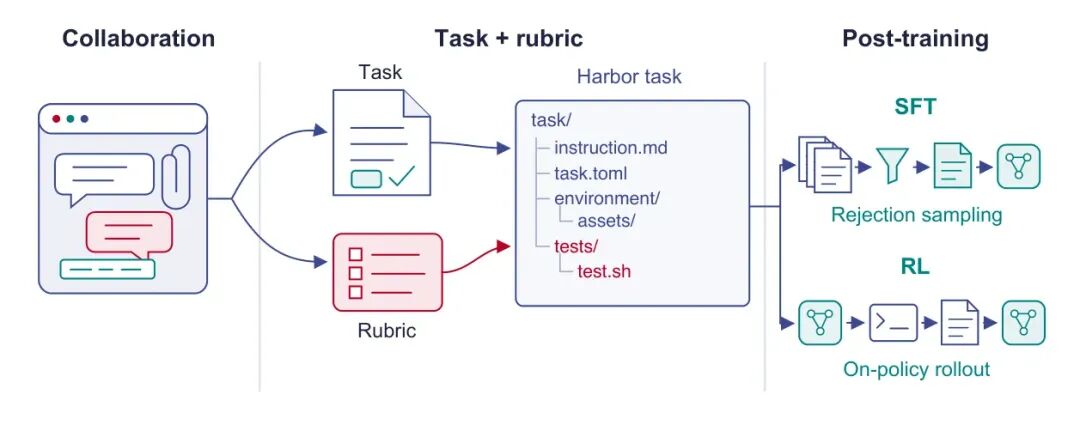
一次真实协作会被整理成自包含的任务包(instruction、资产、环境、rubric 测试脚本),同一份任务既能做拒绝采样 SFT,也能做 on-policy RL。注意论文特别强调:研究者的认可不会被默认当作科学事实,评分标准要经过冲突消解才入库。
产品长什么样
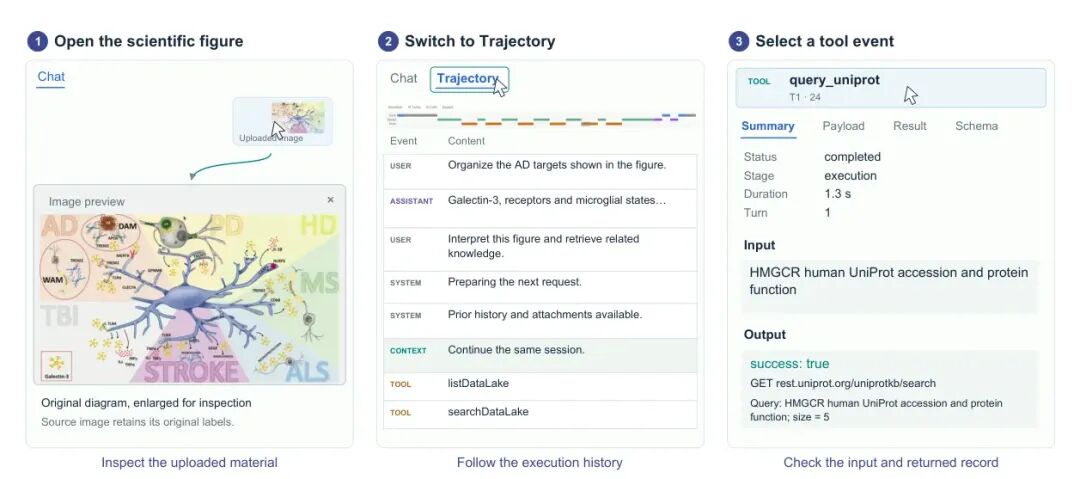
这不只是个训练框架,而是一个真上线的工作台:
224 个工具、22 个功能模块,覆盖基因组学、分子与癌症生物学、药理学、生物成像、文献检索、数据库查询; 运行时支持 Python / R / Bash,自带本地数据湖; 文档、表格、序列、图片都能直接拖进对话框。
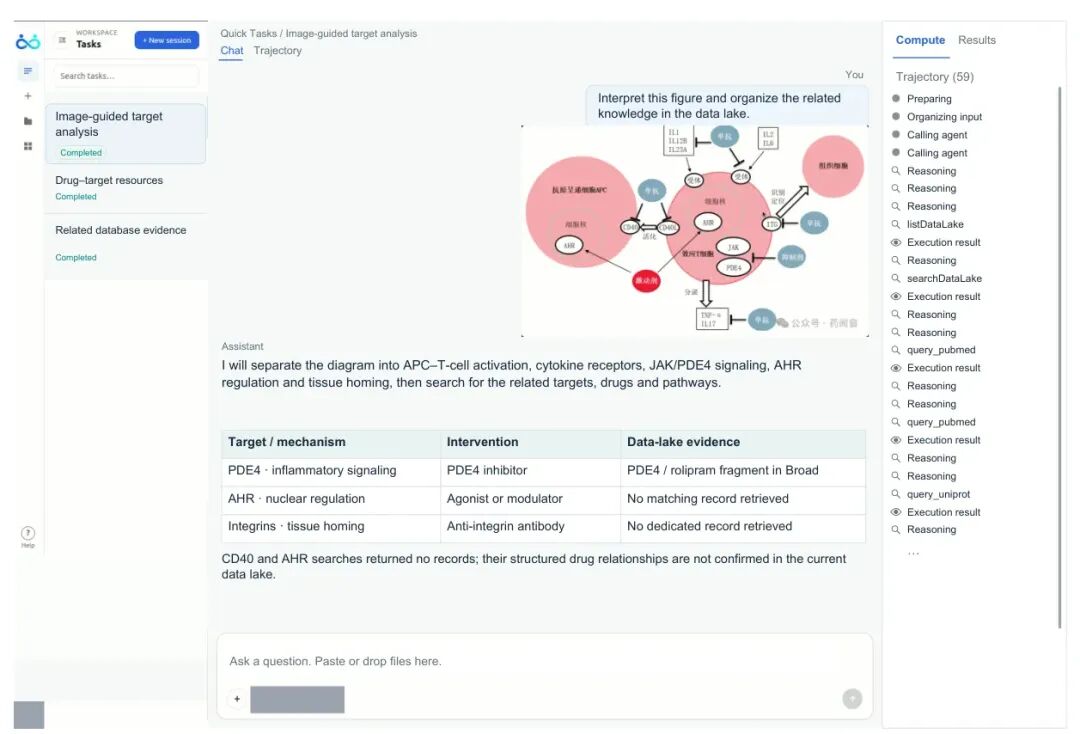
上面这个例子里,研究者丢了一张免疫信号通路图,Agent 把图拆成 APC–T 细胞激活、JAK/PDE4 信号等模块,逐个查数据湖和 PubMed/UniProt,最后给出靶点–证据表——查到就是查到,没查到(CD40、AHR)也老实标注「无匹配记录」。
而且全程可审计:Trajectory 面板里每一次工具调用的输入、输出、耗时都能点开看。
交互如何变成训练信号
论文给了两个真实案例:一个是小细胞肺癌 JAK1 研究设计,一个是 ARL4C 论文汇报 PPT。研究者一句「先聚焦 JAK1,机制后面再做」,就被转译成了任务目标、评分标准和交付物要求:
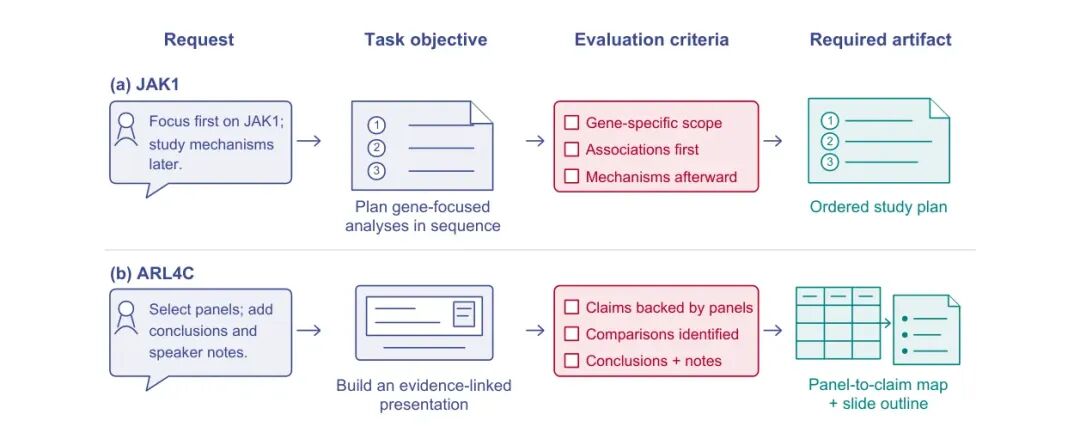
这一步是整个范式的「咽喉」——协作质量直接决定训练信号质量。
实验:数字确实在涨
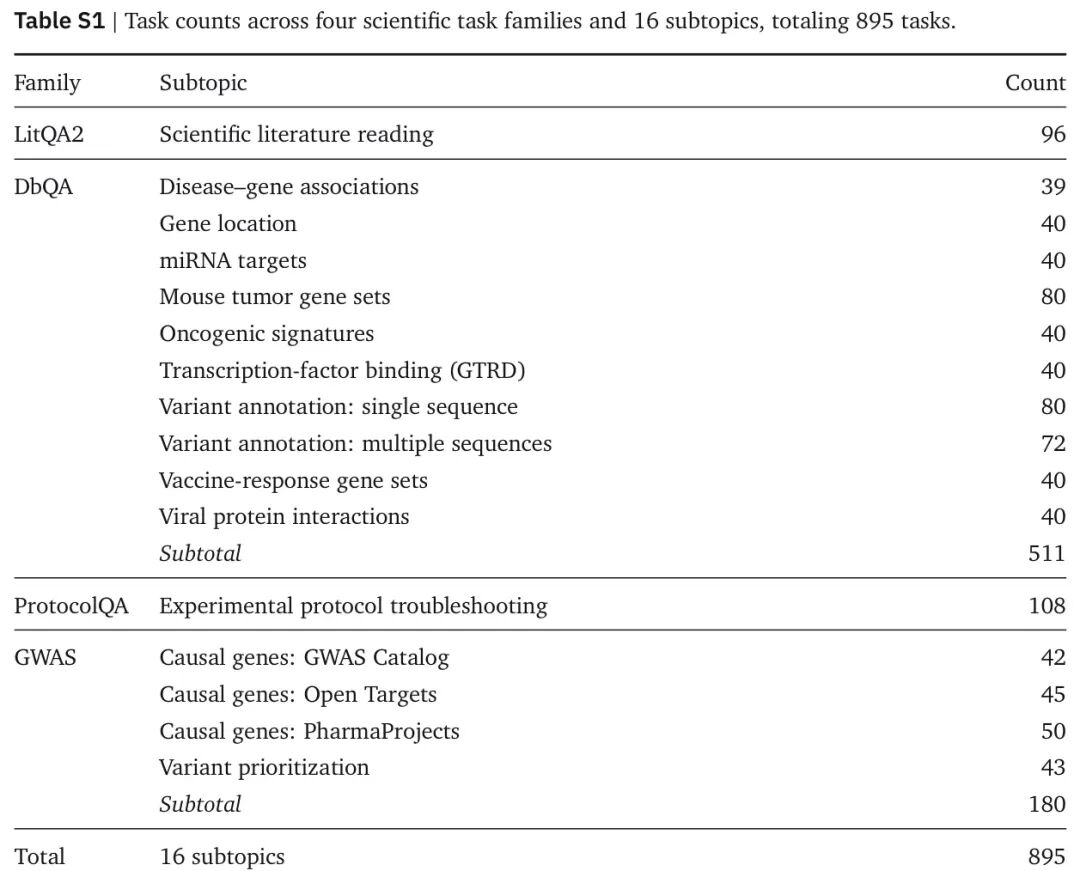
评测基于 LAB-Bench 和 Biomni-Eval1 的 895 个任务,覆盖文献阅读、数据库判断、实验排错、基因变异评估四大家族:
三轮「递归套递归」共演化(Qwen3.5-4B 起步,每轮 10 步 harness 搜索 + 20 次 RL 更新):
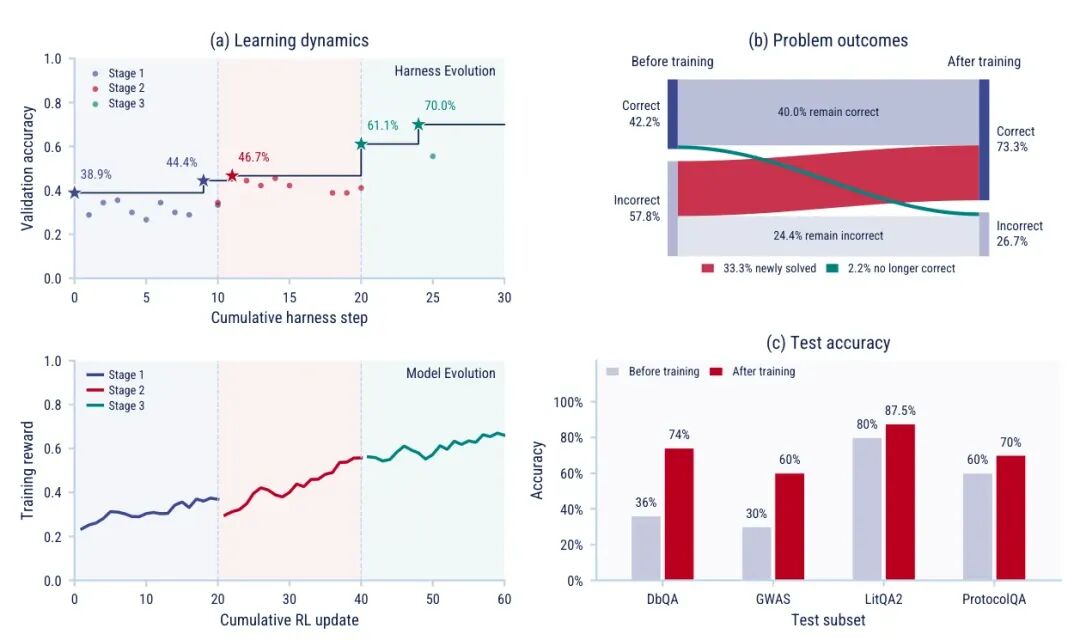
harness 验证准确率三轮分别提升 38.9%→44.4%、34.4%→46.7%、61.1%→70.0%; 测试集单次作答准确率 **42.2% → 73.3%**,33.3% 的题由错转对,只有 2.2% 退化; 四个任务家族全线上涨。
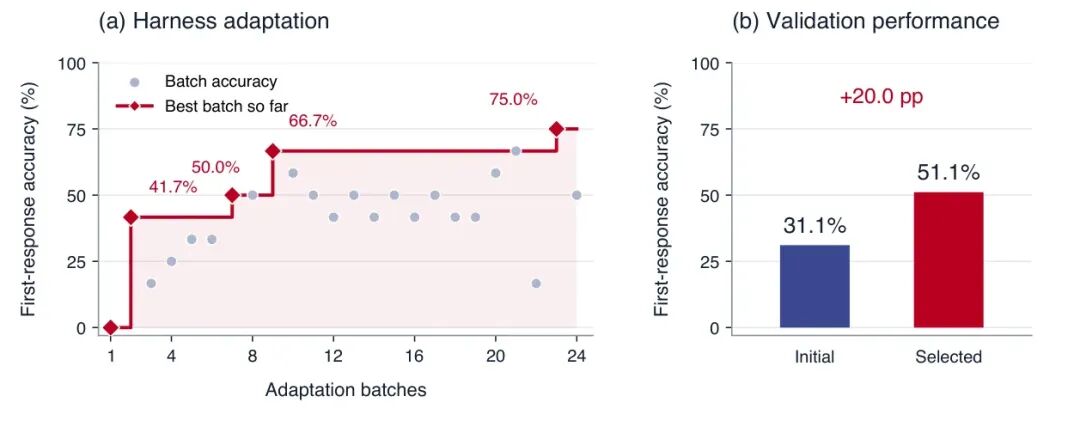
单独看 harness 进化(模型权重冻结):24 批自适应后,验证集首答准确率 31.1% → 51.1%,+20 个百分点。最终 harness 攒下了 4 条指令、9 个作用域技能,比如基因集归属检查、细胞带查询这类可复用程序。
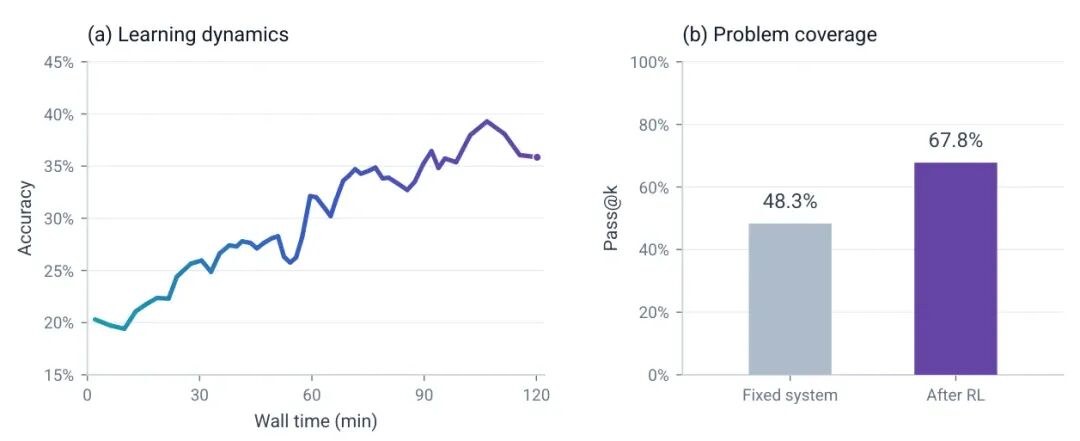
单独看模型 RL(harness 冻结):两小时训练后,pass@4 问题覆盖率 48.3% → 67.8%,+19.5 个百分点——同样预算内能解的题明显变多。
最后
这篇论文最有价值的不是某个单点技术,而是把「产品交互」和「自我改进」闭成了一个环:用户用得越多,任务库和 rubric 越丰富,harness 和模型就越强,强者又能接更难的活——正是 Silver 和 Sutton「经验时代」那句引文的落地姿态。
ScienceBuddy: Recursive-in-Recursive Self-Improvement for Interactive Scientific Agents
Arxiv:2609.17523


