还在盲试配方?锂电/固态电池研发,用机器学习把试错成本砍半
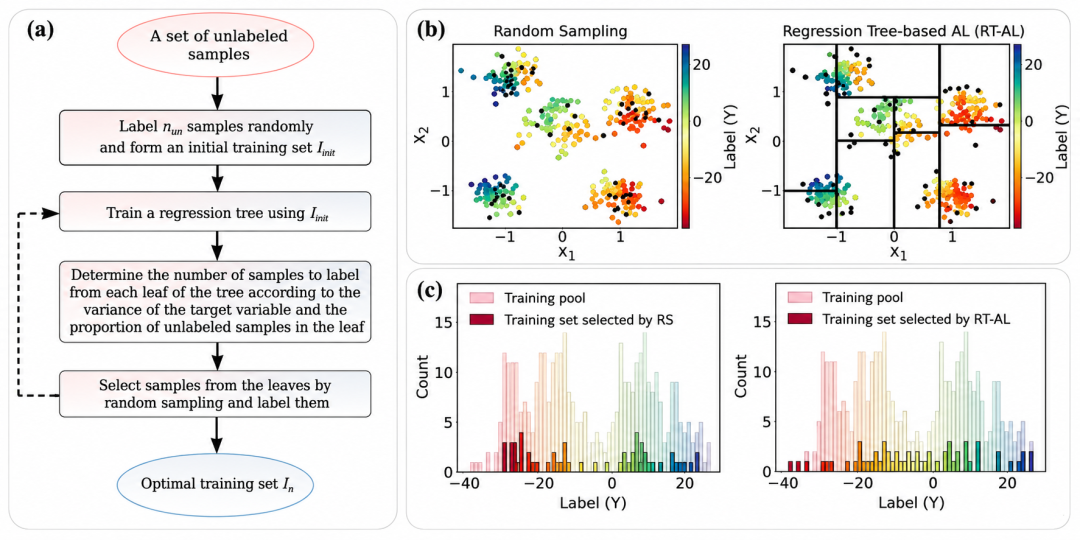
AI + 新能源材料研发,已经不只是概念层面的讨论,而是正在进入材料预测、性能评估和候选筛选这些更具体的研发环节。
对企业研发团队和高校课题组来说,问题也变得更落地:
手里已经有实验数据、文献数据、计算数据,能不能真正用起来?
面对大量配方、元素、结构和测试条件,下一组实验到底该怎么选?
模型预测出来的结果,如何解释,如何反过来指导材料筛选?
在过往机器学习课程和相关咨询中,我们也反复遇到类似问题。
老师会问:课题组积累了不少实验数据,学生会整理表格、会画图,但再往后怎么建模分析,就卡住了。
同学会问:文献数据能整理出来,但不知道怎么清洗,怎么构建特征,怎么判断模型结果是否可信。
在企业研发场景中,这个问题会更现实:材料体系越来越复杂,试错成本越来越高,能不能更快判断哪些方案值得优先验证?
这些问题背后,其实都指向同一件事:
新能源材料研发,不能只停留在“做实验—看结果—再试一组”的循环里。已有数据能不能沉淀下来,模型结果能不能解释清楚,候选材料能不能筛得更有依据,正在变成研发效率的一部分。
这正是《机器学习辅助新能源材料研发:从预测到筛选》这门课想解决的问题。
1、下一组实验,先别盲试
新能源材料研发,不是简单地“多做几组实验”。
以锂电、钠电、固态电池、电解质、正负极材料为例,真正影响性能的变量非常多:材料组成、元素比例、晶体结构、制备工艺、测试条件、循环制度、温度环境……每一个变量变化,都可能带来完全不同的结果。
过去多研发判断主要依赖经验和试错。经验当然重要,但当候选材料越来越多、性能指标越来越复杂,只靠人工判断,很容易遇到几个问题:
数据做了很多,却没有沉淀成可复用的方法;
文献看了很多,却很难快速筛出高潜力方向;
实验一组组推进,但不知道下一组该优先验证什么;
模型、图表和结果解释之间断开,难以形成完整研究闭环。
机器学习在新能源材料研发中的价值,是帮助研发人员把已有数据重新组织起来,先做预测和筛选,再把实验资源集中到更有可能出结果的方向上。
换句话说,它解决的核心问题是:下一组实验,先往哪个方向做。
2、数据怎么变成筛选依据
很多人听过机器学习,也知道它可以用于材料研发,但真正上手时,往往会卡在第一步。
我的实验数据能不能建模?
文献里的材料数据怎么整理?
材料组成、制备条件、性能指标怎么变成模型能识别的变量?
XGBoost、SHAP 这些方法到底怎么用?
模型预测完之后,如何筛选候选材料,而不是只停留在一张结果图?
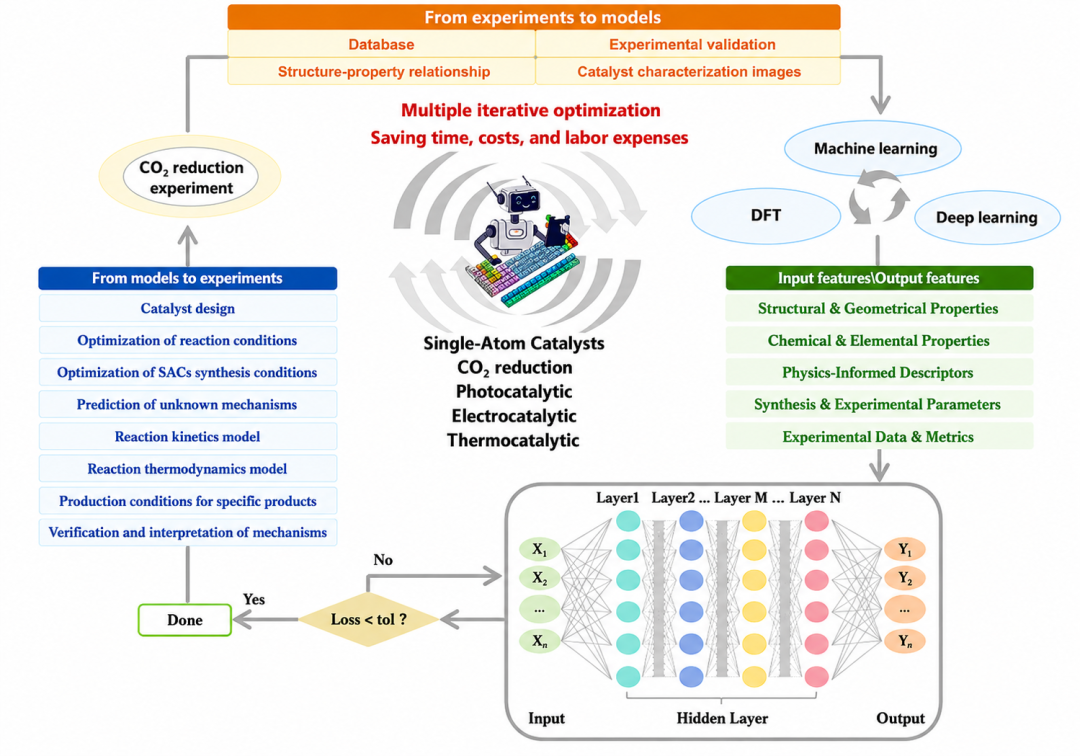
这门课不会只讲算法概念,而是围绕新能源材料研发中的真实流程,带大家把“数据清洗—特征构建—模型预测—结果解释—候选筛选”完整跑一遍。
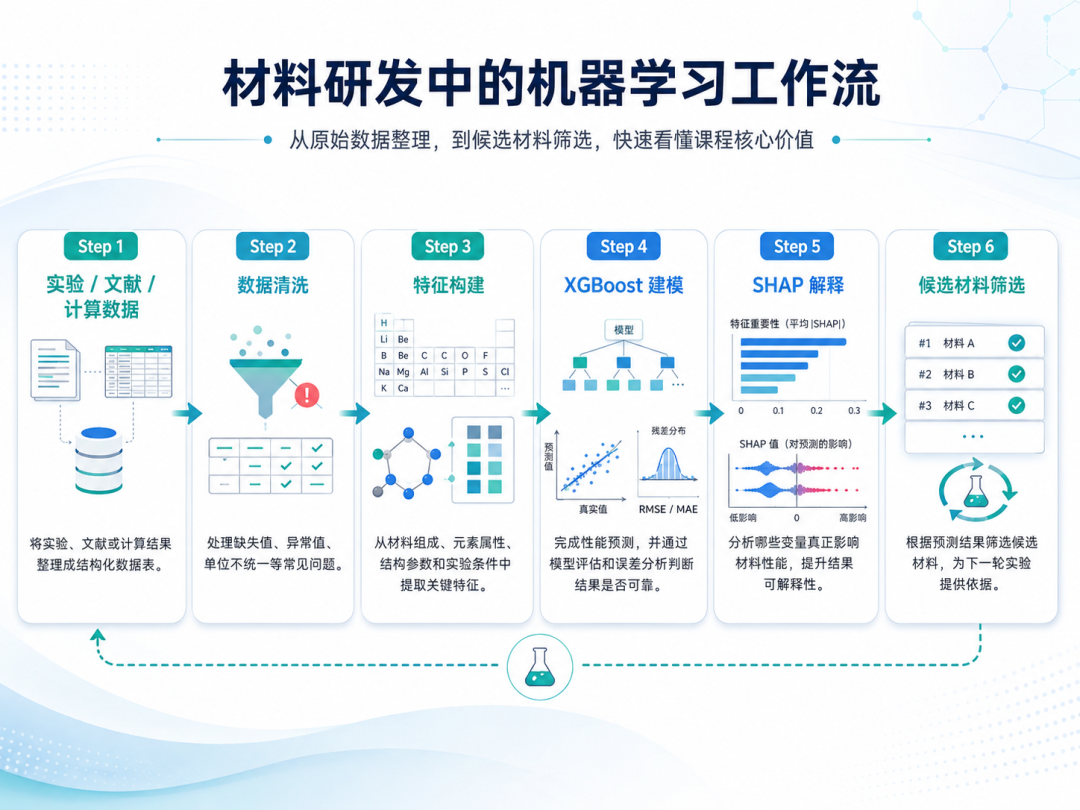
这套流程跑通之后,机器学习就不再是一个孤立的“算法工具”,而是能嵌入新能源材料研发流程的方法。
3、从预测到筛选,现场跑通
机器学习辅助材料研发,看起来是一套软件和代码流程,但真正容易卡住的地方,往往不在“能不能运行代码”。
遇到的问题是十分具体,只看录播或零散教程,往往很难判断自己卡在哪里。
在线下课,老师会把完整案例拆开讲,从数据开始,一步步带大家跑到模型预测、结果解释和候选筛选。你不仅能看到流程怎么做,也能在现场跟着练,及时解决自己理解不到位、操作跑不通的问题。
对老师来说,这更像是一次课题组方法训练:可以派学生来系统补上数据建模能力,把后续课题中的实验数据、文献数据更好地用起来。
对企业研发人员来说,这更像是一套可迁移的工作流训练:学完之后,可以把课程里的处理思路迁移到自己的材料体系和研发数据中。
对学生来说,这不只是“学一个算法”,而是补上一段完整的 AI + 材料项目经历:数据怎么来,模型怎么建,结果怎么解释,候选材料怎么筛。
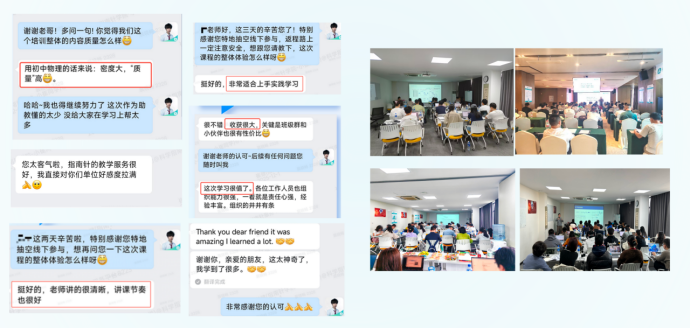
(线下课氛围与课后评价)
为了帮助大家学习新能源材料科研真实流程,仿真秀联合科学指南针培训中心于2026年7月17-19日为大家带来为期3天的《机器学习辅助新能源材料研发:从预测到筛选》培训,帮助大家快速掌握独立跑通“材料数据 -> 特征工程 -> 模型训练 -> 性能预测 -> SHAP 解释 -> 高通量筛选”的完整流程,并迁移到电池、固态电解质、电催化、钙钛矿等研究方向。
识别二维码获取培训通知
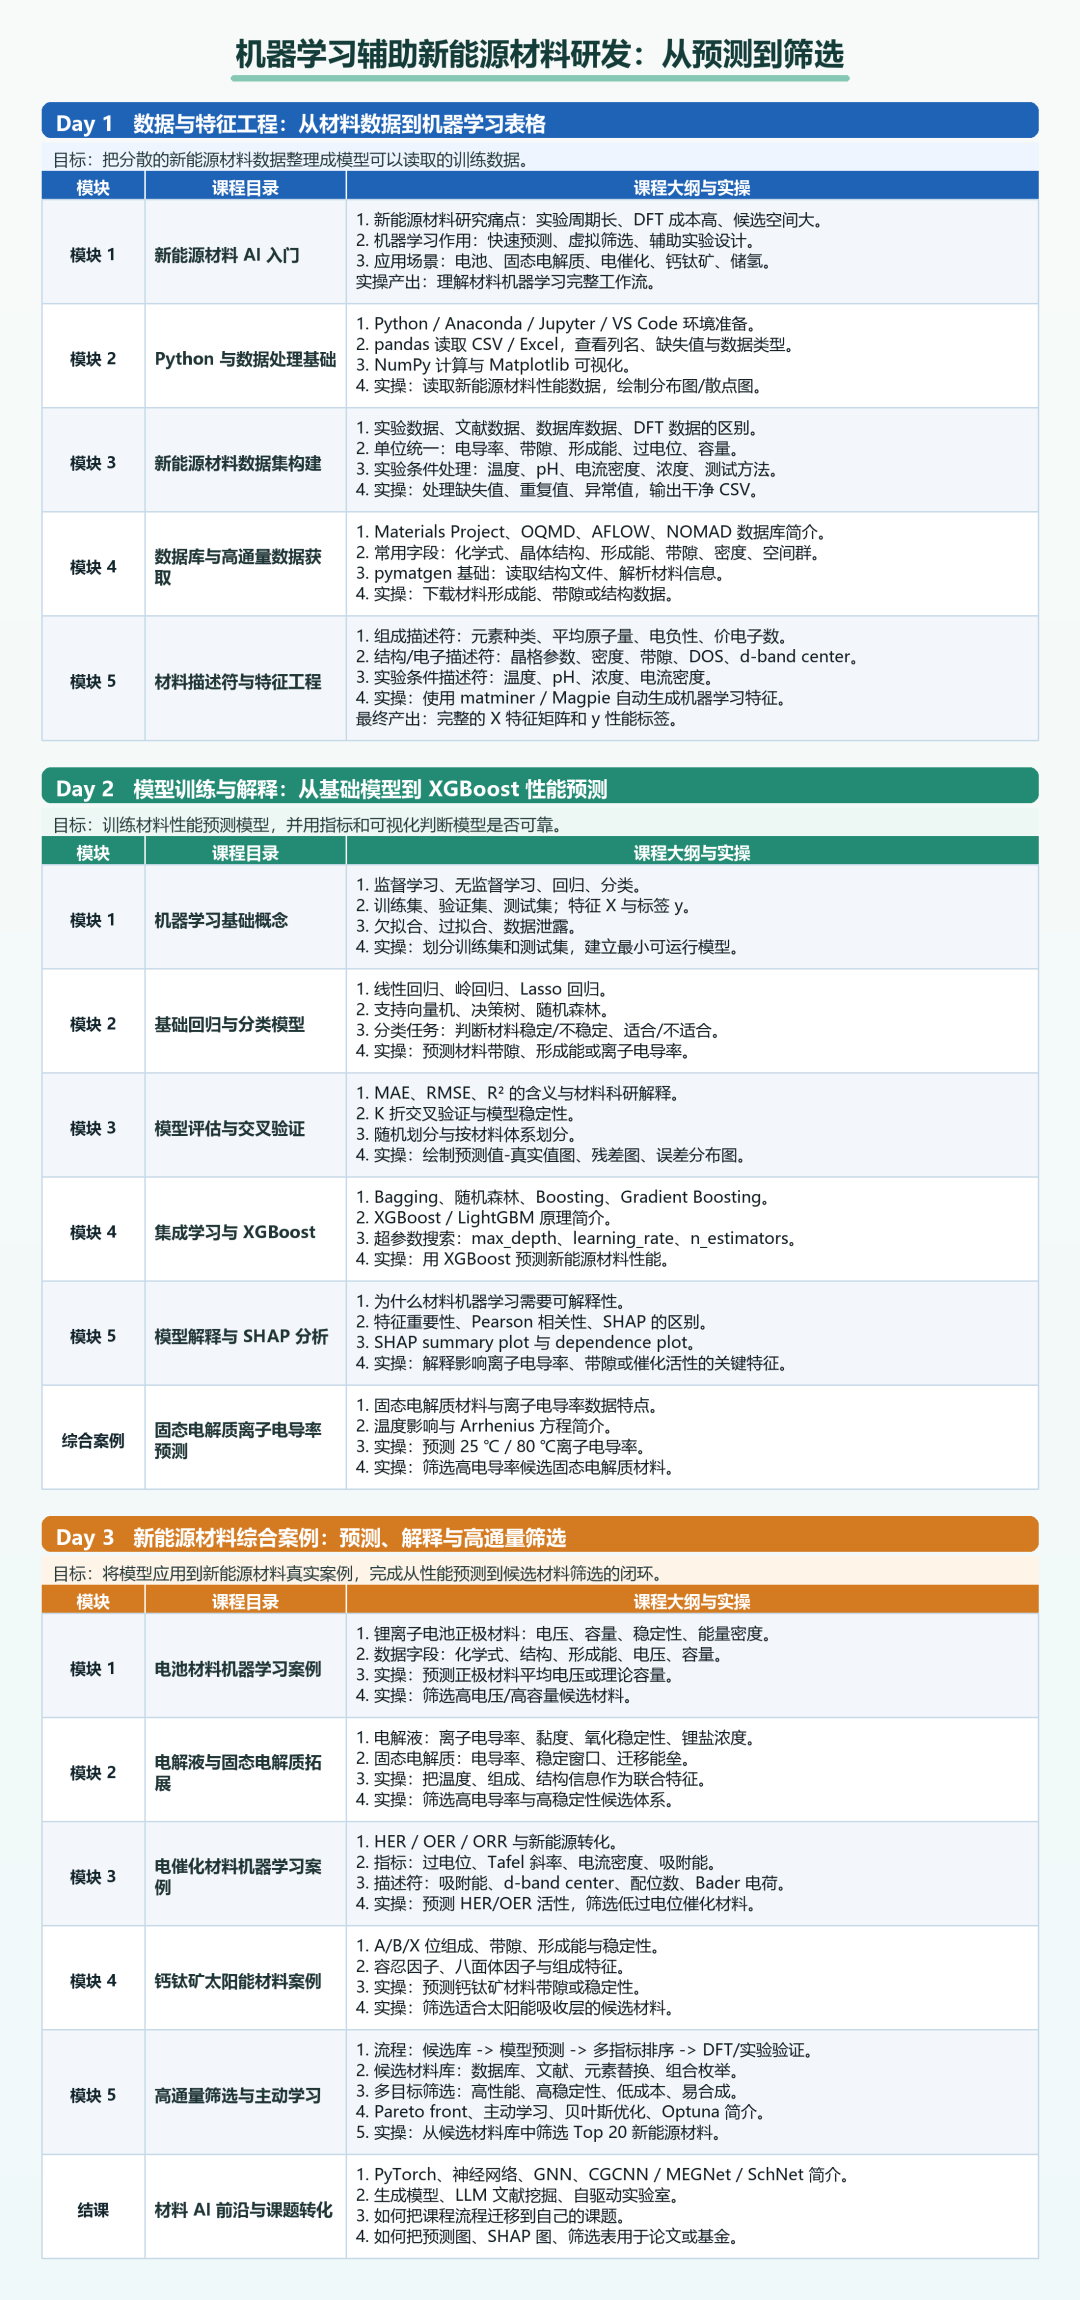
【以下为培训大纲】
点击下方阅读原文,立即获取培训通知