把英文视频变成中文视频: 一套从识别、翻译到配音合成的完整工作流
视频制作 · AI工具 · 工作流实践
把英文视频变成中文视频:
一套从识别、翻译到配音合成的完整工作流
从一段原始视频出发,让字幕、中文配音与画面重新匹配,形成更适合中文观众观看的成片。
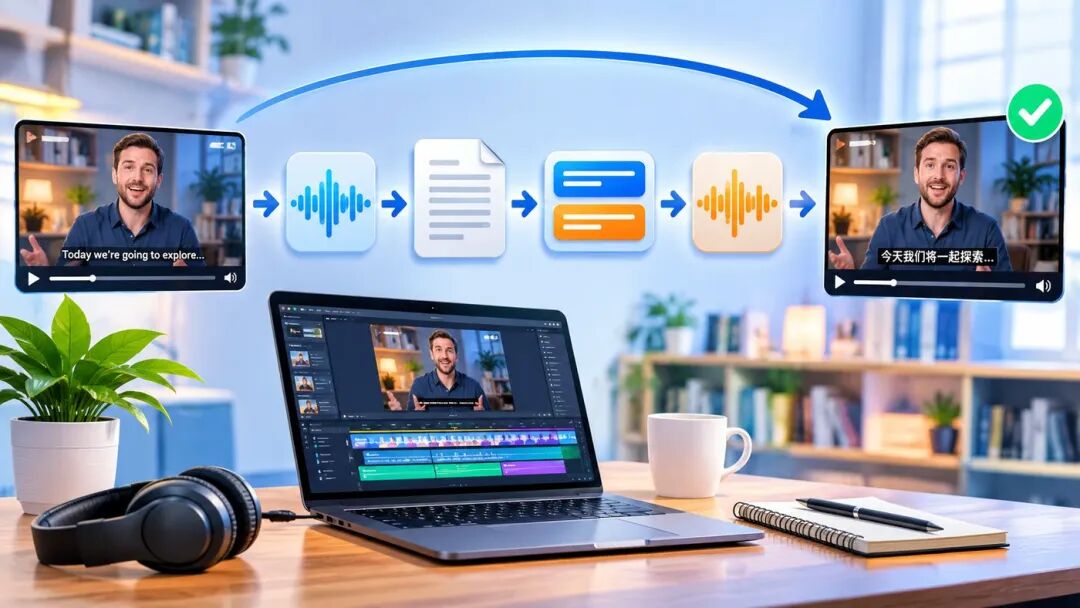
先说结果:最终能得到什么? 输入英文 MP4 或 MKV 视频,经过音频提取、语音识别、中文字幕翻译、中文语音合成、音画同步和视频导出,最终可以得到带中文字幕、可选中文配音的中文版本视频。流程以自动化处理为主,关键字幕和声音节点仍可人工检查,兼顾效率与成片质量。 |
一、为什么要建立这套流程?
很多优质内容以英文呈现。语言不同,会影响理解速度,也会限制知识传播的范围。单纯添加一份翻译字幕,虽然能解决一部分阅读问题,但观看者仍然需要不断读字幕;如果进一步生成自然的中文配音,并让声音与画面、字幕保持同步,就能把原本的英文内容转化为更完整的中文视听体验。
这套流程的核心,不是单独完成某一次翻译,而是把视频处理中的多个环节连接起来:让原始视频进入系统后,逐步生成中文文本、中文声音和最终视频文件。
二、整体流程:从英文原片到中文成片
| 01导入视频 | 02提取与处理音频 | 03语音识别字幕 | 04翻译与中文润色 |
| 05生成中文配音 | 06音画同步 | 07字幕与声音合成 | 08导出中文视频 |
说明:不同视频的音轨、字幕和画面比例可能不同,具体处理参数可按素材情况调整。
三、每一步具体是怎样实现的?
| 步骤 01|导入视频,提取音频 |
以 MP4、MKV 等常见视频文件作为输入,先读取视频和音轨,再提取适合后续识别的音频文件。需要保留原片环境声、背景音乐时,可以进一步进行人声与背景声音分离,为后续中文配音留出处理空间。 这一环节的作用:把视频画面和声音拆分成可分别处理的素材,同时尽可能保留原片的音乐与环境氛围。 |
| 步骤 02|语音识别,生成带时间轴的英文字幕 |
将提取出的音频送入语音识别(ASR)环节,把英文语音转换为文字,并生成对应的字幕时间轴。得到的字幕文件可以是 SRT 等常见格式,后续翻译和配音都以这份时间信息为基础。 需要检查:人名、数字、专有名词、多人对话以及背景噪声较大的片段。识别准确度会直接影响后续翻译。 |
| 步骤 03|使用 Subtitle Edit 翻译并润色中文字幕 |
将英文字幕导入 Subtitle Edit,进入“翻译 → 自动翻译”,选择英文到简体中文的语言方向。支持本地模型的版本可以选择 llama.cpp(local LLM) 等本地翻译引擎,下载模型后由本机运行,不需要填写云端 API Key。 翻译完成后,检查语义是否准确、中文是否自然、句子是否过长,并统一人物称谓和专业术语。对于需要更强上下文一致性的内容,可以使用带上下文、概要和术语表功能的高级本地翻译引擎(具体选项以安装版本为准)。 这一环节的重点:不是逐字替换,而是在尊重原意的基础上,让字幕符合中文表达习惯,并尽量适合视频阅读节奏。 官方功能说明:Subtitle Edit 自动翻译与本地模型文档 |
| 步骤 04|中文语音合成(TTS) |
将校对后的中文字幕送入中文 TTS(文本转语音)工具,生成普通话配音。可以根据内容选择不同音色、语速和表达风格;长视频则需要关注分段长度、生成稳定性和音频文件的完整性。 这一环节的作用:让观众不仅能读懂中文内容,也能通过中文声音连续理解视频。 |
| 步骤 05|配音与画面同步,处理片尾 |
将中文配音放回视频时间线上,按字幕时间戳和语句节奏调整音频位置、停顿与衔接,避免声音明显早于或晚于画面。需要保留原片音乐和环境声时,可以将背景音轨与原始人声分开处理,再把中文配音叠加到合适的音轨中。 对于片尾残留的英文语音或尾部片段,可以通过自动检测规则定位,并按设置提前约 500 毫秒截断,减少成片结尾残留不需要的英文声音或多余片段;实际截断位置仍应结合画面和音频试听确认。 这一环节的重点:让中文声音、字幕时间和画面内容尽量对应,结尾自然,不突兀。 |
| 步骤 06|烧录中文字幕,导出最终视频 |
将校对后的中文字幕与中文配音合成到视频中,按发布平台和观看场景设置分辨率、画幅、码率与音量。当前工作流可设置竖屏 1080×1920 等输出规格,也可以按原片比例导出横屏版本。 最终输出:一份带中文字幕、带中文配音(可按需要保留背景音乐)的中文视频文件。 |
四、这套流程能解决哪些问题?
减少重复劳动 把提取、识别、翻译、配音和合成串联起来,减少在多个软件之间反复导入导出。 | 降低语言门槛 把英文内容转换为中文字幕和中文配音,帮助中文观众更顺畅地理解信息。 |
方便统一管理 保留字幕文件和中间音频,便于后期修订术语、替换配音或重新导出。 | 适配多种内容 可用于学习资料、课程内容、知识分享、产品介绍和企业培训视频的中文化制作。 |
五、实际使用时,有几个细节值得注意
1. 识别结果要先校对。如果原始音频有口音、多人重叠说话或背景噪声,ASR 可能出现错字;错误字幕会继续影响翻译和配音。
2. 本地模型也需要合适的硬件。本地翻译不需要云端 API Key,但首次使用仍需下载模型,运行速度取决于 CPU、显卡、内存和模型大小。16GB 内存电脑建议从较小的量化模型开始,并以软件模型列表实际提供的选项为准。
3. 翻译要结合上下文。人名、代词、行业术语和前后呼应的句子,不能只看单条字幕。对课程或专业内容,建议建立术语表并进行人工抽查。
4. 配音时长不一定等于原字幕时长。中文和英文语速、句子长度不同,合成后需要检查停顿、语速和时间对齐,必要时调整分段或时间轴。
5. 导出后要完整试听。重点检查开头、片尾、静音处、背景音乐、人声衔接、字幕遮挡和画面比例,避免只检查中间片段。
六、适合哪些人和场景?
这套流程可以应用在多种内容制作场景中,例如:
把英文公开课程、教学视频制作成中文字幕和中文配音版本; 将国外科普、纪录片和知识分享内容转化为中文视听材料; 为企业产品说明、操作指南和内部培训视频制作中文版本; 为多语言传播、学习交流和无障碍观看提供字幕支持; 为个人创作者建立可重复使用的视频本地化制作流程。
写在最后 真正有价值的,不只是某一个翻译模型或某一款软件,而是把音频处理、语音识别、字幕翻译、中文配音、音画同步和视频导出组合成一条清晰、可复用的工作流。以后面对不同的英文视频素材,只需要根据内容调整参数和检查重点,就能更高效地制作中文版本。 |
本文介绍的是英文视频中文化制作工作流,具体软件功能、模型名称及运行要求以所使用的软件版本和电脑配置为准。