Information Fusion|重庆大学攻克图冗余传播难题,提出RUL预测新框架
本期聚焦机器剩余使用寿命预测新进展。剩余使用寿命预测长期受图冗余信息不可控传播与细粒度子图结构忽视两大技术瓶颈制约,全局视角表征不足、子图特征融合效率低更是领域普遍短板。重庆大学秦毅团队近日提出基于信息瓶颈的层次子图神经网络(hierarchical subgraph neural network with information bottleneck, HSNN-IB)框架,为多源传感器信息融合驱动的RUL预测提供了全新技术路径。
该框架采用混合度量图划分算法,融合节点连接强度与确定性自动识别中心节点,构建具有代表性的子图;通过层次门控子图特征更新策略,先执行局部更新再选择性跨子图整合信息,有效提升节点表示质量;配套多子图融合信息瓶颈模块,压缩并整合子图融合表示,抑制冗余信息并保留任务相关特征。实验证实,该方法在公开基准数据集上优于当前最优方法,并在实际风电机组监测数据上验证了其实际适用性。
论文基本信息
论文题目:
Hierarchical subgraph neural network with information bottleneck for machine remaining useful life prediction
论文期刊:Information Fusion
论文日期:2026年
论文链接:
https://doi.org/10.1016/j.inffus.2025.103953
作者:Linjie Zheng (a), Junyu Qi (b), Junyu Qi (a), Yi Qin*(a)
机构:
a. State Key Laboratory of Mechanical Transmission for Advanced Equipment, Chongqing University, Chongqing 400044, China;
b. Reutlingen Research Institute (RRI), Reutlingen 72762, Germany.
通讯作者简介:秦毅,重庆大学教授,于重庆大学机械电子工程系获工学博士学位。长期致力于智能故障诊断与装备健康管理、动力学建模与数字孪生、智能无人系统以及智能制造等领域的创新研究。秦毅教授在国内外权威学术期刊及高水平会议上发表论文230余篇,研究成果涵盖《IEEE Transactions on Industrial Informatics》《Mechanical Systems and Signal Processing》《Reliability Engineering and System Safety》等知名期刊,学术影响力广泛。他长期担任国家重点研发计划、长江学者奖励计划、国家自然科学基金等多项国家级与省部级科研项目评审专家,深度参与国际学术交流与期刊建设。在学术组织方面,秦毅教授是中国机械工程学会、中国振动工程学会的高级会员,并担任IEEE可靠性学会重庆分会副主席,在智能故障诊断与动态测试技术领域积累了深厚的学术声望。(来源:https://faculty.cqu.edu.cn/YiQin)
目录
1 摘要
2 引言
3.1 图构建
3.2 基于混合度量的图划分算法
3.3 层次门控子图特征更新策略
3.4 多子图融合信息瓶颈模块
4 实验
4.1 评估指标
4.2 案例研究一:CMAPSS数据集
4.3 案例研究二:SCADA数据集
4.4 模型分析
5 结论
1 摘要
图神经网络在多源传感器信息融合驱动的剩余使用寿命(RUL)预测中日益受到关注。然而,现有方法大多依赖整合整个图的结构特征与节点表示以获得全局视角,而忽略了更细粒度的子图结构。这往往导致图中冗余信息的不可控传播,限制了预测性能。
为解决该问题,本文提出了一种基于信息瓶颈的层次子图神经网络(HSNN-IB)用于RUL预测。HSNN-IB采用所提出的基于混合度量的图划分算法,该算法融合节点连接的强度与确定性来自动识别中心节点,从而构建具有代表性的子图。随后,提出了一种层次门控子图特征更新策略,该策略先执行局部更新,再选择性地跨子图整合信息,从而有效提升节点表示质量。在此基础上,开发了一种多子图融合信息瓶颈模块,用于压缩并整合子图融合表示,有效抑制冗余信息并保留任务相关特征。最后,在公开基准数据集上的对比实验证明了所提方法优于当前最优方法,同时在实际风电机组监测数据上的实验验证了其实际适用性。
关键词:剩余使用寿命预测;图神经网络;图划分;信息瓶颈;多传感器信息融合
2 引言
机械设备在长期运行过程中会逐渐出现性能退化。故障发生后的被动维护策略不仅会导致非计划停机与生产损失,还可能引发连锁安全事故,对人员生命与资产安全构成严重威胁。在此背景下,剩余使用寿命(RUL)预测技术已成为机械设备高效维护的关键支柱。
RUL预测方法可大致分为两类:基于模型的方法与数据驱动的方法。基于模型的方法依赖物理建模,通常需要对设备运行机理有深入理解。因此,其在应用于复杂系统时面临重大挑战。相比之下,数据驱动方法利用大量监测数据,通过统计分析、机器学习或深度学习技术构建预测模型,且不需要精确的物理先验知识,因而展现出更强的适应性。特别是深度学习方法——如卷积神经网络(CNN)、长短期记忆(LSTM)网络和门控循环单元(GRU)网络——因其在特征提取与时序建模方面的优势,在RUL预测中受到广泛关注。
然而,许多现有的基于深度学习的RUL预测方法主要关注挖掘传感器数据中的时序依赖关系,而相对忽略了不同传感器之间的空间相关性。实际上,传感器之间的空间依赖关系在表征设备局部结构状态与多源信息交互方面起着至关重要的作用。忽视这一特性可能导致模型无法充分捕捉关键退化模式,从而影响预测精度与鲁棒性。因此,挖掘空间依赖信息对于构建更全面、更精细的RUL预测模型具有重要意义。
近年来,越来越多的研究开始采用图神经网络(GNN)来建模传感器之间的空间依赖关系。在GNN中,多传感器系统被表示为图结构,其中节点对应单个传感器,边描述它们之间的空间或功能关系。因此,GNN能够有效捕捉传感器之间的结构化交互信息。与传统方法相比,GNN利用消息传递机制聚合邻域节点信息,实现多源异构传感器数据的深度特征提取与融合。该方法显著提升了设备退化建模的精度,为RUL预测提供了新的技术途径。
尽管GNN已成功应用于建模多个传感器之间的空间依赖关系,但现有的基于GNN的RUL预测方法仍主要依赖图级信息传播进行特征更新。然而,随着传播范围扩大,目标节点不断接收来自远处结构区域的特征信号,其中不可避免地包含大量任务无关甚至干扰性的噪声特征。这一现象最终导致节点表示逐渐模糊或语义偏移。此类局限性不仅降低了模型的判别能力,还严重损害了其在复杂下游任务中的泛化性能。
为解决该问题,本文提出了一种基于信息瓶颈的层次子图神经网络(hierarchical subgraph neural network with information bottleneck, HSNN-IB)用于RUL预测。与依赖全图级信息传播策略的传统图神经网络不同,HSNN-IB设计了一种基于混合度量的图划分算法(hybrid metric-based graph partitioning algorithm, HMGPA),用于将原始图划分为多个子图,该算法能够有效定位信息传播范围。具体而言,本文提出了两个子图中心节点选择准则,即中心节点应具有强连接强度与高连接确定性。在此基础上,构建混合度量对节点中心性进行排序并选择中心节点,从而将整个图划分为若干子图,每个子图聚焦于与中心节点直接相关的局部结构。为实现高效特征学习,提出了一种层次门控子图特征更新(hierarchical gated subgraph feature update, HGSFU)策略,该策略包含两个特征更新阶段。在子图内更新阶段,节点特征仅基于原始图中的局部连接进行更新,使模型能够首先学习结构可靠的局部语义表示。在子图间信息交互阶段,动态控制不同子图之间的信息流动强度,确保仅传播任务相关表示,同时抑制来自远处结构的噪声扩散。通过这种层次化更新设计,模型不仅增强了节点表示对局部结构的敏感性,还隔离了无关区域的影响,并构建了层次化特征。此外,设计了一种多子图融合信息瓶颈模块(multi-subgraph fusion information bottleneck module, MFIBM),用于压缩和优化来自多个子图的融合表示,迫使网络仅保留对下游任务最关键的特征。本文的主要贡献总结如下:
提出了一种新颖的基于混合度量的图划分算法(HMGPA),该算法联合考虑节点连接强度与连接确定性,构建混合度量以量化和排序节点中心性。基于该排序,算法智能选择最优子图中心节点,实现对图的精确划分。
提出了一种层次门控子图特征更新(HGSFU)策略,以增强局部结构学习并有效调控全局信息流。
首次设计了一种多子图融合信息瓶颈模块(MFIBM),用于压缩和整合来自多个子图的表示,显著提升模型的RUL预测性能。
开发了一种基于信息瓶颈的层次子图神经网络(HSNN-IB)的新RUL预测方法。其优越性与实际适用性通过公开基准数据集和实际风电机组的多源监测数据得到验证。
3 所提方法
所提出的基于HSNN-IB的RUL预测方法的整体流程如图1所示。其主要部分,包括图构建、基于混合度量的图划分算法以及层次门控子图特征更新策略,将在以下小节中详细阐述。
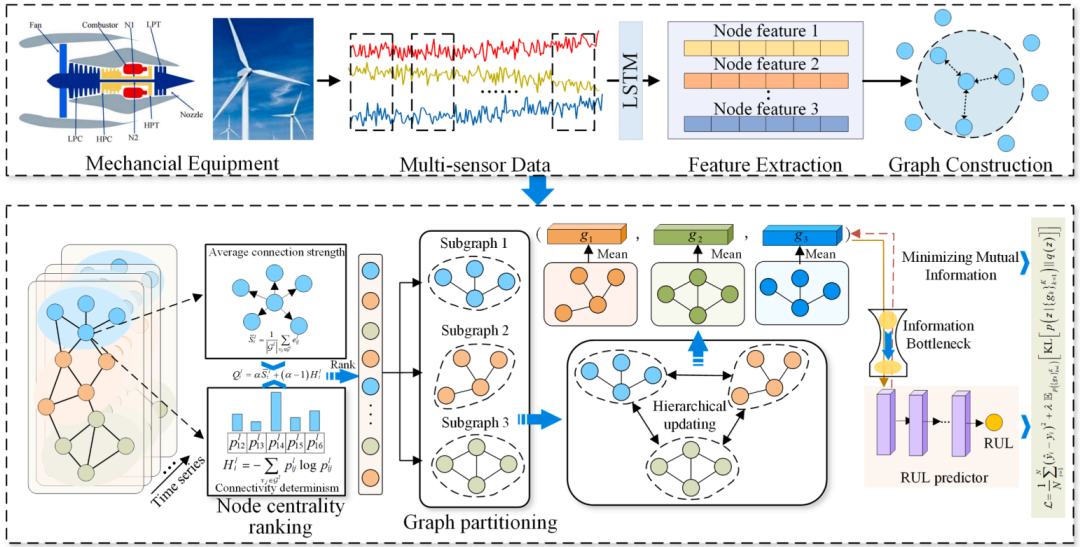
图1 所提出的用于RUL预测的HSNN-IB整体框架
3.1 图构建
针对多源传感器数据,不同传感器通道通常具有不同的物理含义,且它们之间存在复杂且潜在的依赖关系。图结构为捕捉多维数据中的交互提供了一种有效的建模途径,其中节点表示实体(如传感器通道),边描述实体之间的关系或相似性。在本研究中,原始多维传感器数据被转换为图表示,以建模多个传感器源之间的潜在关系。图可表示为 ,其中 表示节点集 合, 表示边权重集 合。 表示原始图中节点的总数。令 表示经过最小-最大归一化操作后的多源传感器数据,节点 与 之间的初始边权重 计算如下:
其中 表示 与 之间的余弦相似度。鉴于归一化数据的余弦相似度落在 范围内,选取该区间的中点值 作为阈值。该值能够保留关键边,同时有效滤除弱相关和噪声边。该值的有效性已通过后续敏感性分析实验得到验证。采用 LSTM 网络提取 的初始特征表示 :
其中 表示 LSTM 网络的参数。
3.2 基于混合度量的图划分算法
为了减少信息冗余并促进高效的层次化特征学习,在更新每一层特征之前,将原始图 划分为 个具有代表性的子图 。该划分过程有助于约束信息传播范围,从而提升局部特征表示的质量。这些子图的节点互斥,且每个子图中的最大节点数设为 。由于算法工作流程的独特设计,子图中的实际节点数可能小于 ,从而有效实现冗余节点的自动排除。因此,所有子图中的节点总数可能小于原始图的节点总数。 和 均为预定义参数。具体过程如下。
令 表示原始图 中的一个节点。则其邻居节点集 合定义为:
的计算公式如下:
其中 表示节点 在第 层的特征表示, 表示节点 与 之间的相似度, 表示批归一化, 表示 卷积层, 表示 Sigmoid 激活函数。
以上公式共同构成相似度计算网络。本文采用可学习的相似度计算网络,因为与固定相似度度量相比,它更适合处理在多个网络层中持续更新的节点特征。可学习的相似度函数能够自适应地建模节点之间的潜在动态关系,从而产生更准确的边权重。因此,下游预测任务的性能可以得到有效提升。
在图划分阶段,为确保所选子图具有代表性,需要为每个子图选择中心节点。中心节点的选择准则定义如下:
1) 节点应具有高连接强度,即它应尽可能与更多邻居节点直接相连,以确保其代表性。
2) 节点与其邻居之间的连接应表现出高确定性,即连接权重的分布应具有低信息熵,反映信息传输的结构稳定性与可靠性。为量化第一个准则(即节点的连接强度),节点的归一化平均连接强度定义为:
可以很容易地注意到, 反映了图结构中节点与其邻域之间的整体交互强度,即它可作为节点作为中心节点的连通覆盖能力的度量。为量化第二个准则,本文利用信息熵来刻画节点邻接中边权重分布的确定性。具体而言,对于给定节点 ,其邻接边权重分布的信息熵写为:
其中 表示第 层节点 与 之间的归一化边权重,反映该边在节点 所有连接中的相对重要性。信息熵越小意味着边权重分布越集中,表明该节点的结构确定性越高。通过整合这两个指标,本文构建中心性评分函数如下:
其中 是一个调节参数(默认设为0.5),用于平衡连接强度与连接确定性之间的权重。基于所有节点的中心性得分,按降序排列如下:
假设所选节点集 合记为 ,初始化时将其设为空集。第 个子图的构造过程如下,从未使用的节点中,选择当前排名最高的节点作为中心节点:
然后,获取该节点的所有邻居节点如下:
接下来,基于与中心节点相连的前 个最大边权重,从邻居节点中选择至多 个节点,并将其指定为该子图内中心节点的邻居节点:
其中 表示从剩余邻居节点中选出的前 个节点的集 合,按边权重 排序。由于某些节点对的边权重为零,这可能导致某些节点的剩余邻居不足(即其数量小于 )。随后,第 个子图的节点集构造如下:
随后,已使用节点集 合按下式更新:
最后,子图的边集按如下方式构成:
3.3 层次门控子图特征更新策略
图2展示了所提出的HGSFU策略的工作流程,该策略在两个连续阶段中运行:第一阶段完成子图内节点特征的更新,在此基础上,第二阶段实现跨子图的信息传播。
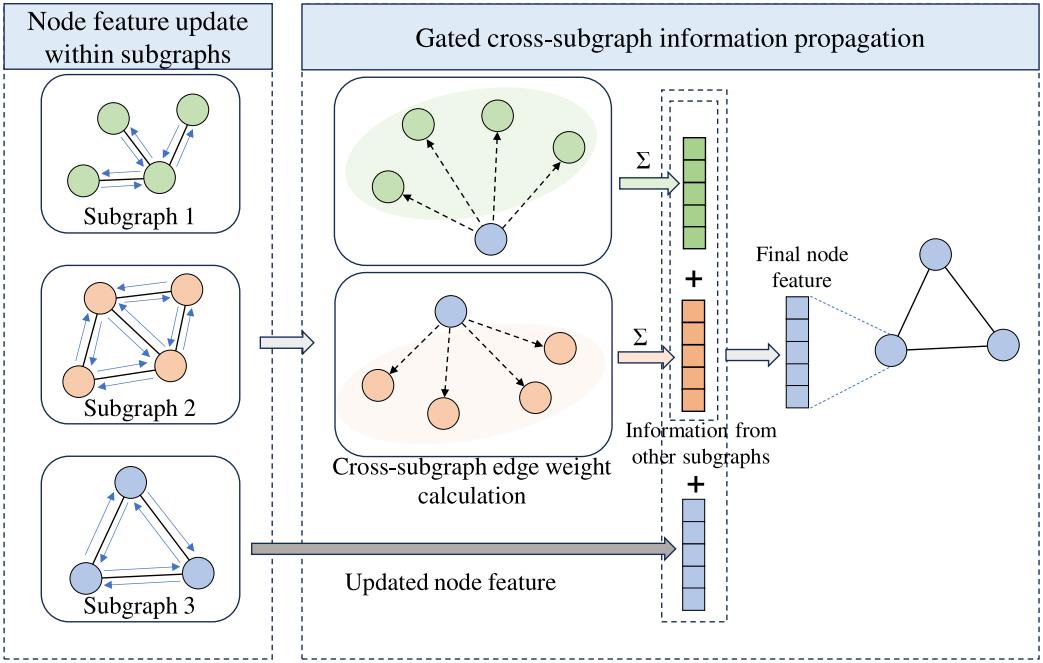
图2 层次门控子图特征更新策略的工作流程
3.3.1 子图内节点特征更新
完成图划分后,每个节点的局部特征在子图内进行更新。局部邻域信息通常携带最直接且高置信度的结构信息。通过优先进行子图内的局部聚合,模型能够构建稳定且具有判别性的局部表示,从而为后续的子图间信息交换奠定基础。令 表示节点 在第 个子图第 层的特征表示。采用标准消息传递机制在每个子图内实现第 层的特征更新,其公式如下:
其中, 表示子图内节点特征更新网络,该网络由两个全连接层组成,每个全连接层后接一个 Tanh 激活函数。
3.3.2 门控跨子图信息传播机制
为实现全局信息流动,有必要进一步融合与协调跨子图的信息。为此,本文提出了一种门控跨子图信息传播机制,该机制允许每个子图内的节点吸收来自其他子图中与其相关的特征,同时抑制无关干扰。首先,对于每一对跨子图节点 与 ,跨子图边权重 由下式计算:
其中, 表示子图间相似度计算网络。接下来,对来自子图 的所有节点进行加权求和,以获得中间聚合表示,如下所示:
为增强跨子图信息传播的可控性与适应性,引入两个门控因子 和 ,其定义如下:
其中 表示特征拼接, 、 、 和 为可训练网络参数。 用于控制信息融合,而 用于抑制特征冗余。最终,节点 在第 层的特征表示 由下式更新:
完成层次子图特征更新后,所有子图被重新组合为完整图,并重新计算整个图的边权重,为下一层的图划分做准备。
3.4. 多子图融合信息瓶颈模块
在完成子图内局部特征更新与跨子图门控信息传播后,设计了一种MFIBM,以进一步整合全局信息并抑制冗余特征对预测精度的干扰。该模块旨在压缩并提取多个子图中与RUL预测任务高度相关的信息,从而获得面向下游应用的低冗余联合表示。
给定子图 ,其子图表示 由下式构成:
在完成子图构建、子图内节点特征更新以及跨子图信息传播之后,所得表示 包含了局部邻域中与退化模式高度相关的结构信息,以及不同子图之间的相关特征。这表明,在输入MFIBM之前, 已经编码了从原始数据中提取的与RUL预测密切相关的核心信息。由于MFIBM的优化过程只能压缩和精炼已有的输入信息,而无法生成额外的任务相关内容,因此模型的预测能力取决于输入中是否存在与RUL相关的信息。若输入缺乏足够的RUL相关信息,模型将难以具备良好的预测性能。事实上,在多个数据集上获得的结果进一步验证了 确实包含足以服务于RUL预测的信息。因此, 可被视为一种“充分信息源表示”。
为从多个子图表示中获得压缩且任务相关的联合表示,基于信息瓶颈原理,MFIBM的优化目标形式化如下:
其中超参数 作为信息压缩与任务相关性之间的权衡系数。
在RUL预测任务中,模型的核心目标是从传感器数据中提取能够反映设备退化趋势与健康状态的关键特征,即“任务相关特征”。若特征表示 与目标变量 (RUL)高度相关,则对 的观测应能显著降低 的不确定性。互信息 是量化这种不确定性降低的有价值指标,形式上刻画了“已知 所提供的关于 的信息增益”。因此,最大化 本质上鼓励模型增强与RUL预测最相关特征的表示。
此外,从 的定义来看,其等价于最大化条件对数似然 ,即:
在RUL预测场景中,假设给定表示 时,RUL标签 服从均值为 、方差为常数 的高斯分布,则优化目标可表示为:
忽略与模型参数无关的常数项,上述表达式的最大化等价于最小化预测值与真实值之间的期望平方差(即均方误差(MSE)):
因此,在常见且合理的高斯观测假设下,公式中的预测项在优化目标上与RUL任务中常用的MSE损失一致。然而,若仅优化预测项,模型可能将输入中的所有信息编码到 中,这会导致过拟合和泛化能力减弱。公式中的压缩项 约束了 的容量,鼓励模型优先选择能显著增强 (即降低任务损失)的信息子集。这样,任务相关特征得以保留,而冗余信息被丢弃,从而提升泛化能力。在RUL预测背景下,这意味着模型必须主动识别并移除冗余输入信息,仅保留最关键和有用的特征。
因此,MFIBM的优化目标在理论上与RUL预测任务是兼容的。由于 的计算具有挑战性,基于已知形式的分布 计算一个上界以实现可处理的优化,其推导如下:
该不等式由Kullback-Leibler(KL)散度的非负性引入。在实践中,采用标准高斯分布 作为变分分布。对于 ,假设其服从高斯分布,其参数由神经网络估计。计算过程如下:
其中 , 是一个单层全连接层。利用重参数化技巧,联合表示嵌入 通过下式计算:
随后,预测的RUL标签由下式获得:
最后,所提出模型的优化目标表示为:
由于 和 均服从高斯分布,上述方程中的KL散度具有闭式解:
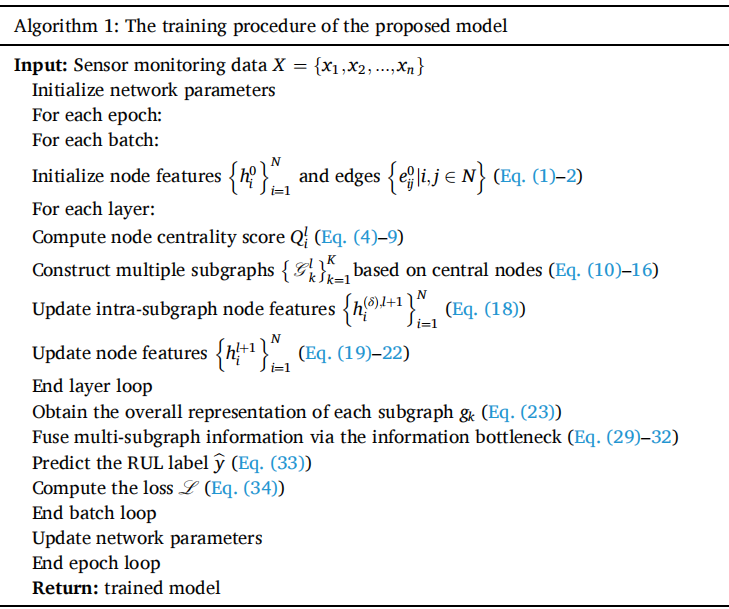
表1展示了所提出模型的伪代码,涵盖了数据输入、子图构建和特征更新等主要过程。
表1 所提出模型的伪代码
4 实验
4.1 评估指标
为定量评估所提方法的性能,本文采用均方根误差(RMSE)和评分函数(SF)作为评估指标,其公式如下:
RMSE衡量预测值与实际值之间的偏差,因此适用于评估整体预测精度。SF指标对提前预 测和滞后预测施加不同程度的惩罚,从而反映模型在不同预测阶段的性能。RMSE或SF越低,表示预测精度越高。两种指标的结合使用能够对模型预测性能提供更全面的评估。
4.2 案例研究一:CMAPSS数据集
4.2.1 CMAPSS数据集的介绍与预处理
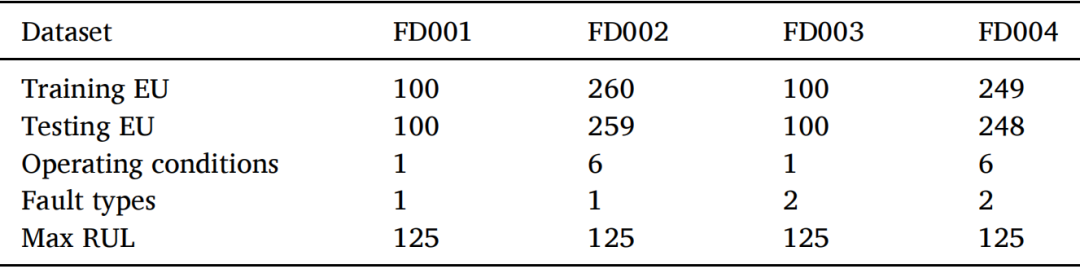
CMAPSS数据集由NASA开发,是PHM领域广泛使用的基准数据集。它模拟了涡扇发动机在不同飞行条件下的退化过程。该数据集包含四个子数据集(FD001–FD004),每个子数据集代表不同的运行条件和故障模式,详见表2。每个子集包括训练集和测试集。训练集包含来自多台发动机的完整全寿命运行数据,而测试集仅包含部分运行数据。每台发动机由21个传感器监测。由于并非所有传感器都携带 meaningful 的退化信息,本研究选择编号为2、3、4、7、8、9、11、12、13、14、15、17、20和21的传感器用于RUL预测。在每个子数据集中,所有传感器读数均归一化至 范围。在本研究中,监测数据采用长度为60、步长为1的滑动时间窗口分割为多个样本。
表2 CMAPSS数据集的细节
4.2.2. 对比方法与实验设置
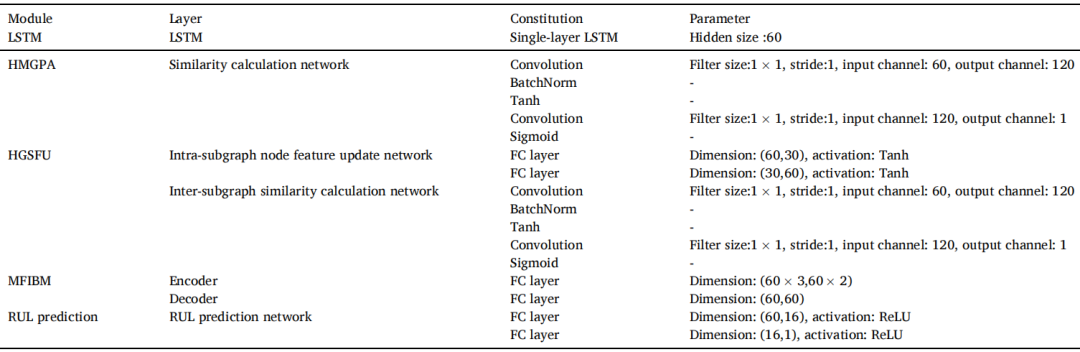
为有效验证所提方法的性能与优越性,将其实验结果与九种主流方法进行对比分析。这九种方法包括基于CNN的方法(MS-DCNN、AGCNN和STRUL)、基于LSTM的方法(DA-LSTM)、基于Transformer的方法(TATFA),以及基于GNN的方法(MGCAL-UQ、ASTHGNN、GCN-PR和KEST-GCN)。所提方法在PyTorch中实现,采用Adam优化器更新模型参数。学习率设为0.001,训练轮数为200,批次大小设为512。在四个子数据集中, 和 的值分别设为3和5。表3展示了所提模型在CMAPSS数据集上的网络架构与参数设置。
表3 所提出的 HSNN-IB 在 CMAPSS 数据集上的网络架构
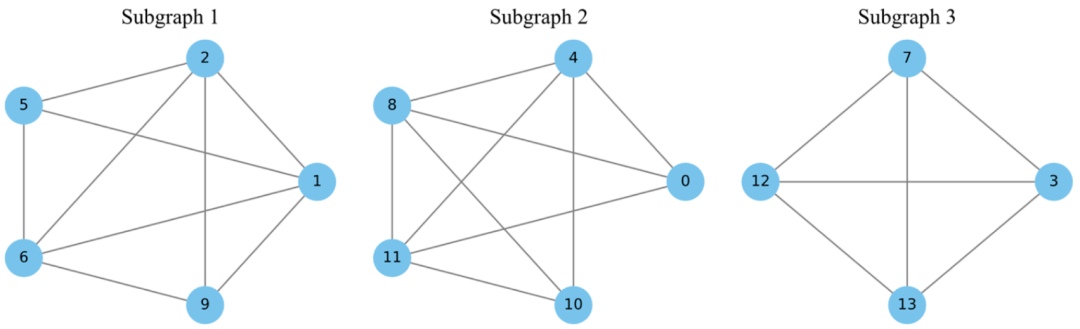
以FD001子数据集为例,图3展示了使用所提方法的图划分结果。超参数 在四个子数据集上分别设为[2e-5, 1e-5, 1e-5, 1e-5]。
4.2.3 性能对比与分析
多种方法在CMAPSS数据集上的实验结果总结于表4。如表所示,所提方法在所有子数据集上取得了七项最优指标和一项次优指标,整体性能显著优于其他基线方法。基于CNN的方法(如MS-DCNN)在复杂工况下表现不佳,因其无法有效捕捉信号的时序特征。例如,在FD004子数据集上,MS-DCNN的RMSE高达22.22,与其他方法存在显著性能差距。尽管DA-LSTM能够建模信号中的时序依赖关系,但缺乏捕捉多传感器间空间依赖的能力,限制了其相对于所提方法的性能。
表4 各种方法在CMAPSS数据集上的实验结果
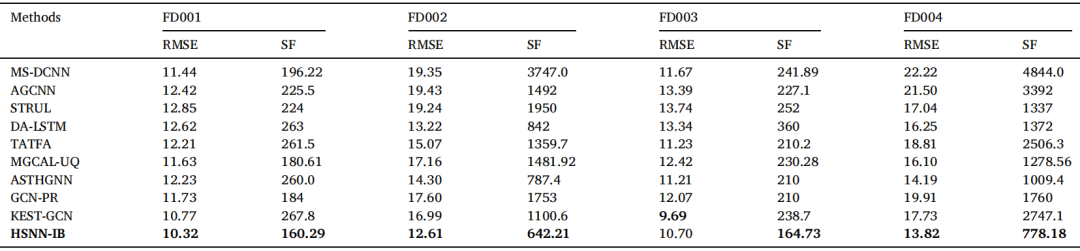
与主流基于GNN的方法(如GCN-PR和KEST-GCN)相比,所提方法引入了子图分割策略以实现层次化特征更新。此外,它结合了信息瓶颈机制以有效融合子图特征,从而在抑制冗余信息的同时增强关键特征的表示。因此,所提方法在所有子数据集上均展现出优越的预测性能。图4展示了四个子数据集上预测RUL值与实际RUL值的对比。预测RUL与实际RUL的高度一致性进一步验证了所提方法在复杂工况下的有效性与可行性。
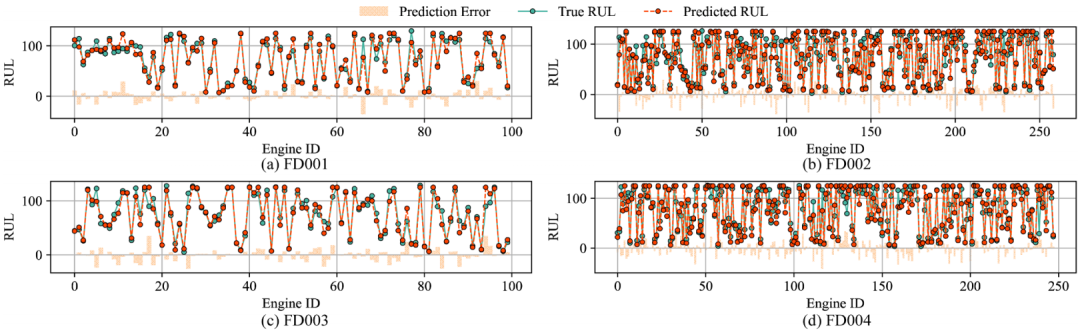
图4 所有测试发动机上实际RUL与预测RUL的对比
4.2.4 消融实验
为评估各组件对所提模型整体性能的影响,本文通过设计三种变体对HSNN-IB进行消融研究:模型1:不含图划分策略的HSNN-IB。模型2:不含HGSFU策略和MFIBM的HSNN-IB。取而代之,采用常规信息聚合方法进行跨子图消息传递,并使用拼接生成多子图融合表示。模型3:不含MFIBM的HSNN-IB,同样采用拼接方法进行多子图表示融合。
消融结果如图5所示,清晰表明HSNN-IB优于所有三种变体。模型2与模型3的对比表明,所提出的HGSFU策略能够实现更有效的子图级特征学习。模型3与HSNN-IB模型之间的性能差异表明,MFIBM有效压缩了冗余信息并提升了多子图融合表示的质量。模型1表现最弱,凸显了图划分策略的重要性。这些发现共同证实,所提模型的每个组件均对提升其整体性能有实质性贡献。
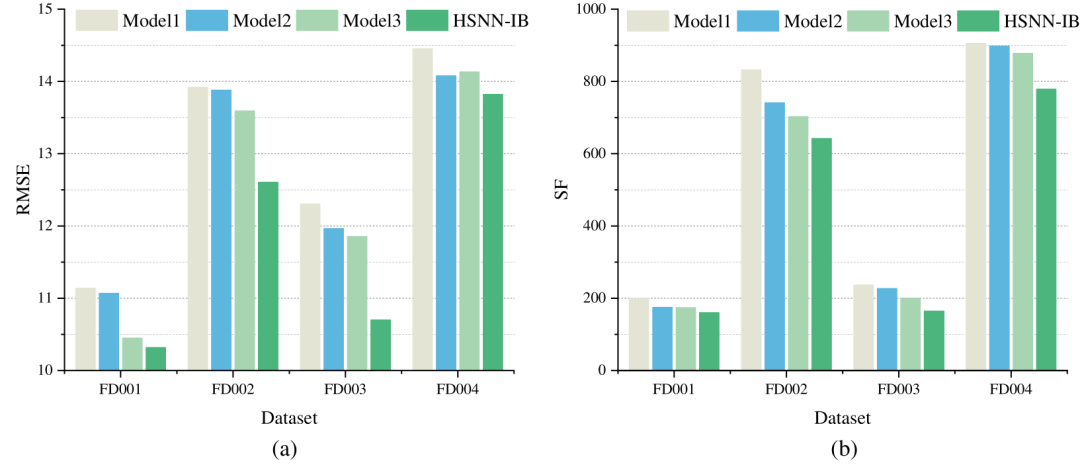
图5 消融实验结果
4.3 案例研究二:SCADA数据集
4.3.1 SCADA数据集的介绍与预处理
为验证所提方法在实际工程场景中的适用性,本文使用位于中国西北某风场的多台2 MW风电机组的真实运行数据评估其性能。风电机组的主要结构如图6所示。
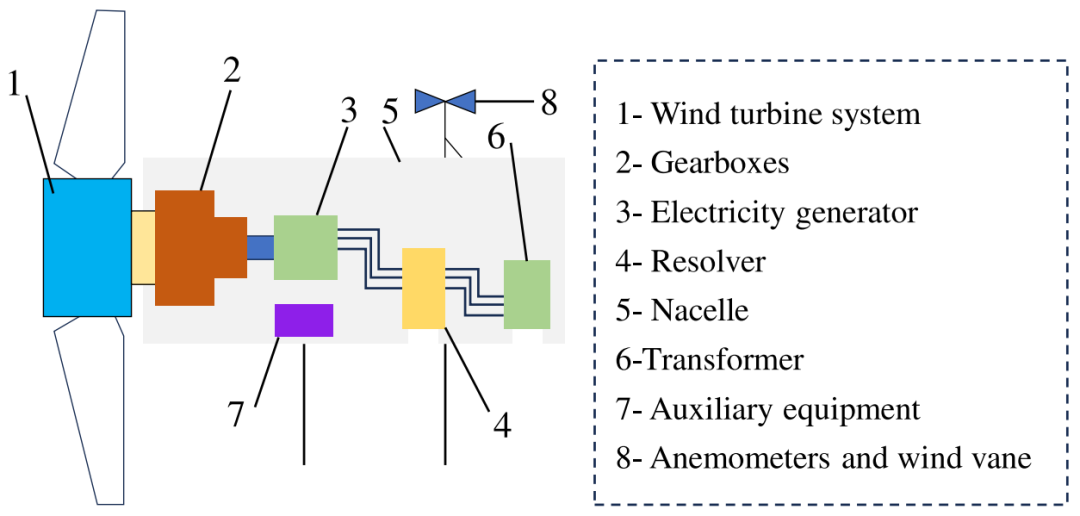
图6 实验风电机组的主要部件
数据由SCADA系统以1分钟间隔采集,覆盖2018年1月1日至2019年12月29日期间。共安装26个传感器,部分传感器的功能与参数列于表5。
表5 部分传感器的描述
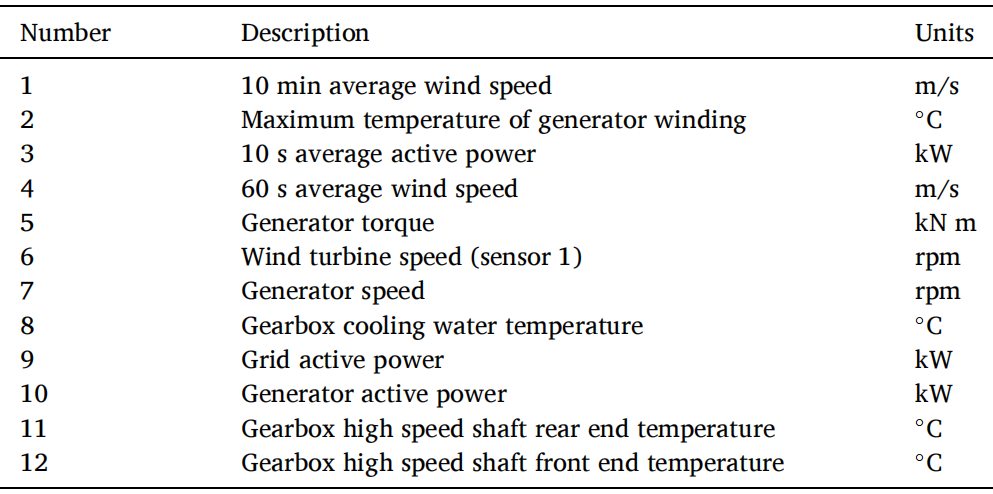
图7展示了特定风电机组在选定时间段内的运行数据。本研究选择编号为7、15和18的风电机组作为实验对象。这些机组在数据采集期间发生故障,并在停机维护后重新投入运行。为构建样本数据集,提取每台机组每天中午12:00记录的运行数据,并采用滑动窗口方法生成实验样本。
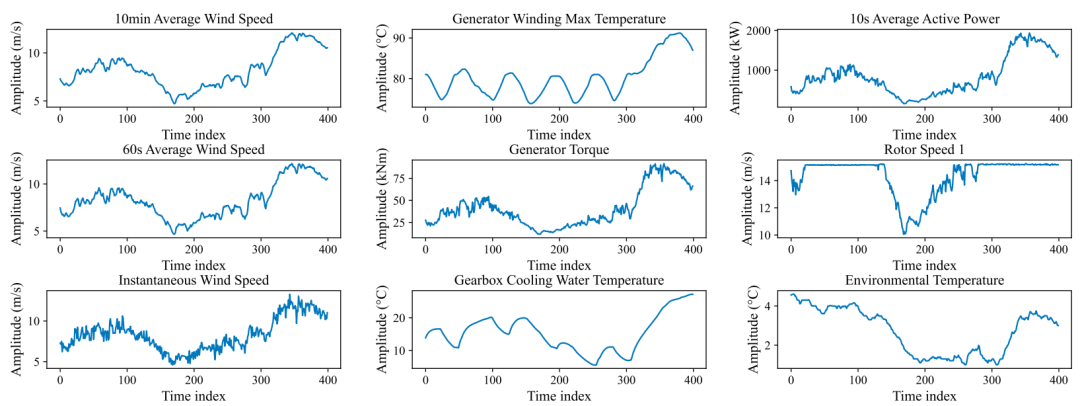
图7 部分传感器监测数据
4.3.2 实验设置
选取7号和18号风电机组的运行数据作为训练集,15号风电机组的数据作为测试集。时间滑动窗口长度设为60,最大RUL上限设为55。这三台风电机组维护后采集的监测数据也将用于训练和测试,由这些数据划分的样本标签设为最大RUL。所提方法使用PyTorch机器学习框架实现。采用Adam优化器更新模型参数,学习率为0.001,批次大小为512,总训练轮数为600。模型超参数 、 和 分别设为4、7和5e-5。
4.3.3 性能对比与分析
为全面评估所提方法的有效性,与多个基准模型进行对比实验,包括BiLSTM、SA-LSTM、BiGRU、GCN和GGCN。如表6所示,所提方法在RMSE和SF两方面均显著优于基线方法,表明其在RUL预测中具有更高的精度。
表6 SCADA数据集上各种方法的实验结果
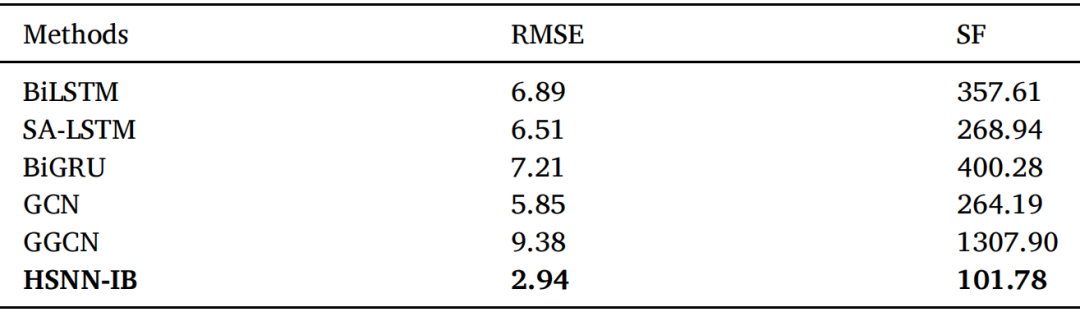
图8展示了某次实验中HSNN-IB分割出的四个子图。可以看出,节点1、3和15在此图划分过程中被丢弃,这证明了HSNN-IB自适应消除冗余节点的能力。
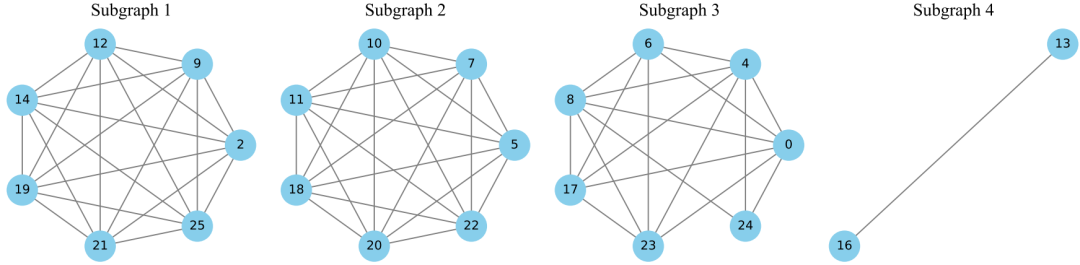
图8 SCADA数据集上的图划分结果
此外,图9展示了HSNN-IB与另外三种对比方法的RUL预测结果。可以看出,HSNN-IB预测的RUL与实际RUL更为接近,表明拟合效果更好。这些实验结果共同验证了HSNN-IB在RUL预测中的优越性能,并凸显了其在实际工业应用中实现更准确、更稳定RUL预测的潜力。
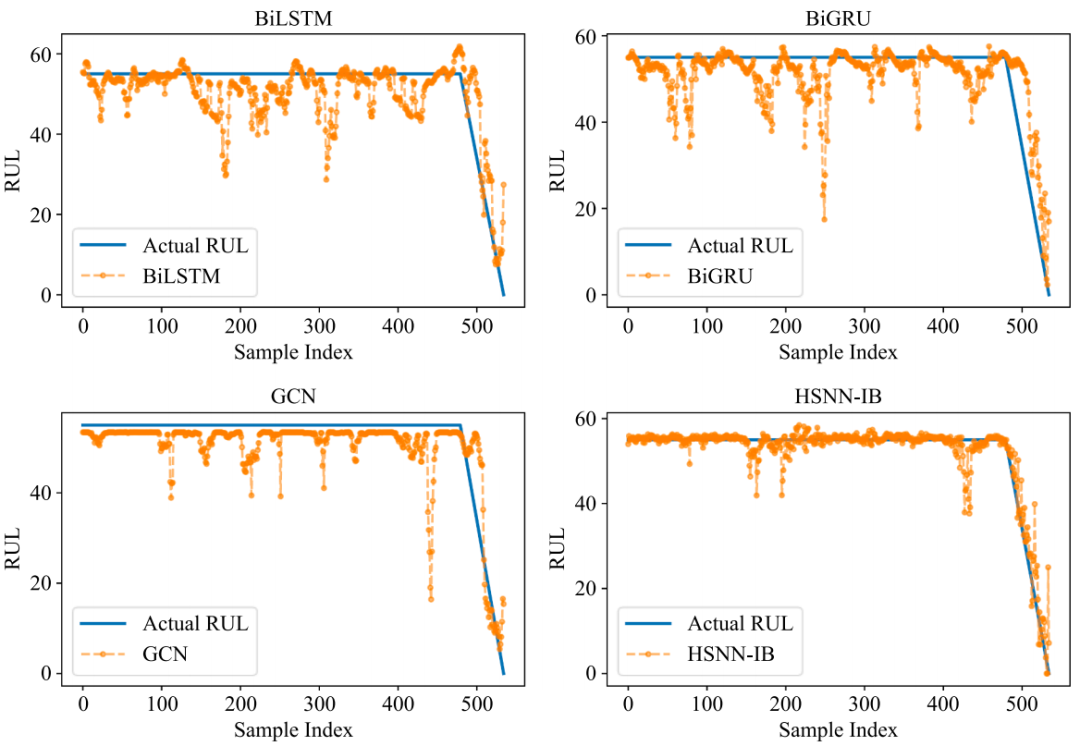
图9 SCADA数据集上的RUL预测结果
4.4 模型分析
4.4.1 超参数 的敏感性分析
在节点中心性评分函数中,超参数 用于平衡连接强度与连接确定性两个组成部分,在节点中心性评估中起关键作用。为验证 设置的合理性及模型对其的鲁棒性,在四个FD001–FD004子数据集和SCADA数据集上开展了参数敏感性分析实验,系统研究了不同 下的模型性能。结果如图10所示。
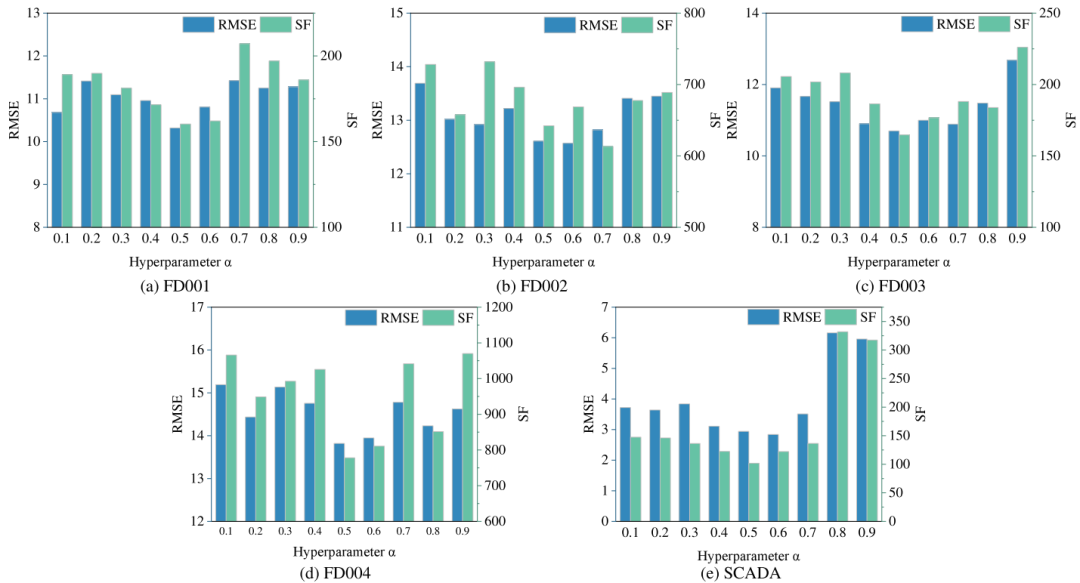
图10 超参数 对模型性能的影响
总体而言, 的变化对模型性能有一定影响。具体来说,两种评估指标在大多数情况下呈适度波动;然而,当 接近0.1或0.9时,模型在所有数据集上的预测性能均有一定程度下降。相比之下,当参数 在0.5左右时,模型表现相对更好。更具体地,当 取值在0.5–0.7范围内时,模型在FD002子数据集上取得优越的预测结果;当 在0.4–0.6范围内时,其在FD003子数据集上也表现出良好性能。
这一趋势在四个CMAPSS子数据集和SCADA数据集上均一致观察到,表明当 在0.5左右时,模型表现出更好的稳定性与泛化能力。基于上述发现,本文默认将 设为0.5,以在“连接强度”与“连接确定性”之间实现合理平衡。此外,为提升特定任务中的性能,可在此基线值附近进行微调。
4.4.2 超参数 的敏感性分析
参数 作为MFIBM模型中信息压缩项的权重系数,其主要作用是约束潜变量从输入特征中保留的信息量,从而在特征压缩与信息保留之间实现权衡。为研究该超参数对模型整体性能的影响,在CMAPSS数据集和SCADA数据集上进行了系统的敏感性实验。具体实验结果如图11所示。
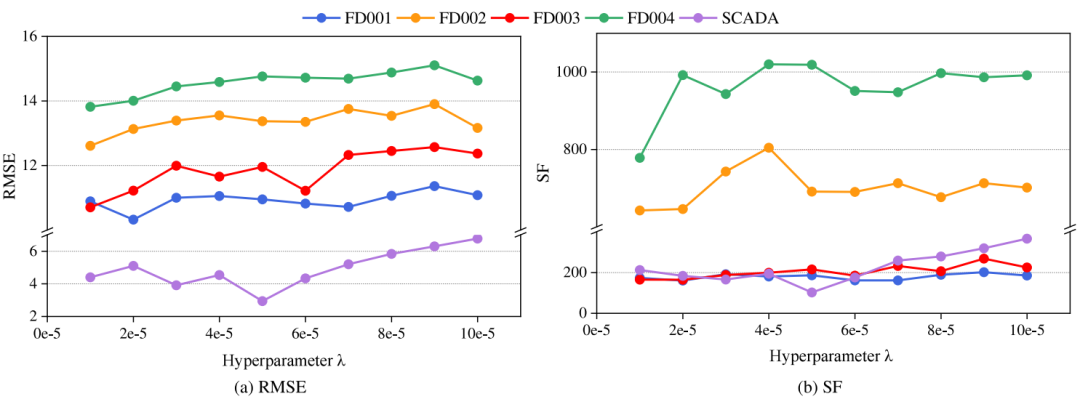
图11 超参数 λ 对模型性能的影响
从整体趋势来看,随着 值的不断增大,模型在多个数据集上的预测精度呈现波动的下降趋势。这一现象可能是因为当信息压缩项的权重设置过高时,一些对预测任务至关重要的有效特征也被过度压缩,导致关键判别信息丢失,从而引起模型性能下降。值得注意的是,在不同数据集上均可观察到类似规律,表明 对模型性能的影响具有一定程度的普遍性。基于实验结果与分析,为防止有用信息被过度压缩而导致性能损失,建议将 设置在相对较小的值范围内,以避免因过度压缩而造成性能下降。
4.4.3 超参数 和 的敏感性分析
超参数 控制图结构中划分的局部子图数量。若 值过小,模型性能可能因局部结构表达能力不足而受限;若 值过大,则可能引入冗余划分并增加计算开销。超参数 定义每个子图允许的最大节点数,从而控制子图规模。考虑到CMAPSS与SCADA数据集在传感器规模上的差异,针对这些数据集采用不同的 组合进行敏感性实验。对于CMAPSS数据集,使用 、 、 和 ;对于SCADA数据集,使用 、 、 和 。
实验结果如图12所示,表明模型性能在不同 组合下存在一定波动。具体而言,CMAPSS数据集在 时获得最高预测性能,而SCADA数据集在 时达到最优。基于上述结果,我们建议根据具体数据集在合理范围内选择适中的子图数量和节点规模,以平衡模型的表达能力与计算效率。综上, 和 的适当设置有利于预测性能的提升。
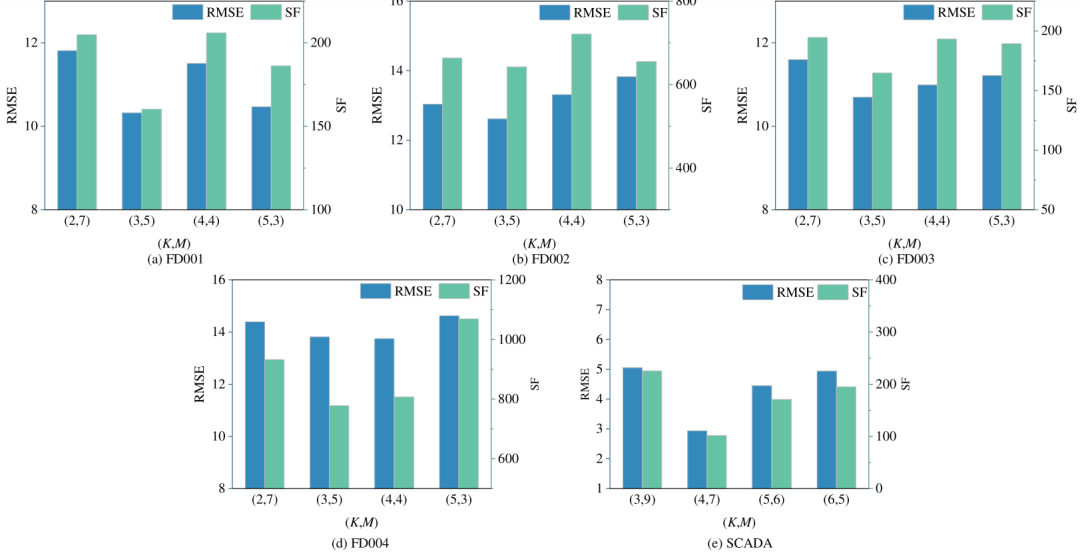
图12 超参数 K 和 M 对模型性能的影响
4.4.4 初始边阈值的敏感性分析
为考察公式中初始边阈值对图构建及模型性能的影响,在CMAPSS和SCADA数据集上进行了敏感性实验。该阈值直接决定初始图中保留的边数量及空间依赖关系的强度。阈值过低会引入大量弱相关或噪声连接,而阈值过高则可能导致图过于稀疏,损害有效的节点交互与特征传播。因此,有必要评估不同阈值下的模型性能。实验结果如图13所示。
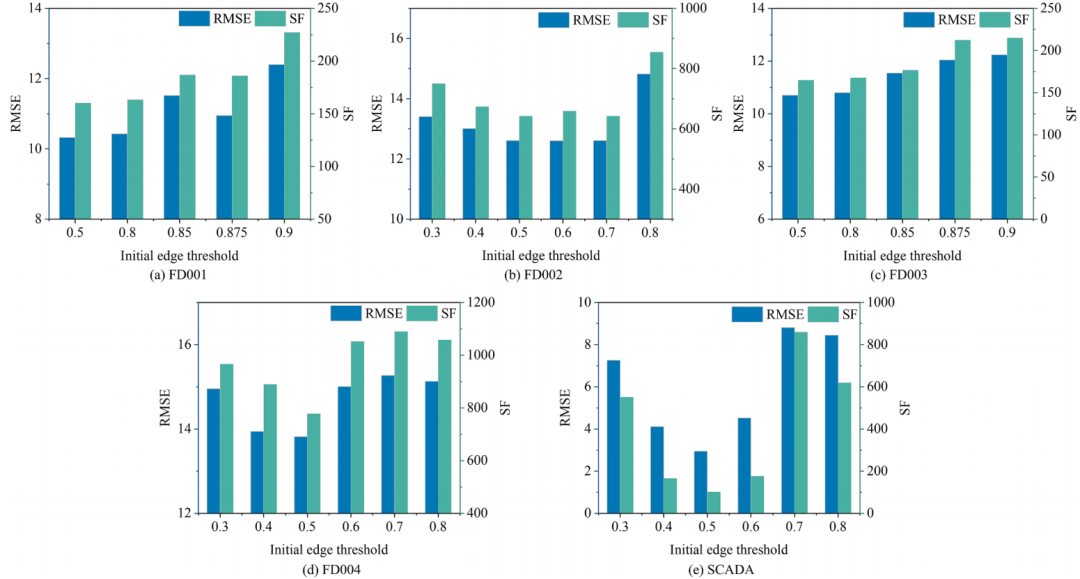
图13 始边阈值对模型性能的影响
在FD001和FD003子集中,大多数节点相似度大于0.8。因此,当阈值设置为低于0.8时,所得图结构差异很小,模型预测性能基本保持不变。据此,重点关注这两个子集中阈值超过0.8的情况。如图13所示,当阈值为0.5或0.8时,模型表现几乎相同;然而,当阈值进一步增至0.85或0.9时,图变得过于稀疏,导致模型性能下降。
对于其他数据集,阈值对模型性能具有类似影响。当阈值较小(如0.3)时,大量弱相关或噪声边被保留,导致预测性能不佳。当阈值增至0.7以上时,一些关键边被移除,造成性能下降,这在SCADA数据集上尤为明显。基于上述分析,公式中的初始边阈值最终设为0.5。该值有效保留了重要的空间依赖关系,同时避免了噪声边的干扰,从而确保了稳定且优越的预测性能。
4.4.5 不同子图表示计算策略的对比分析
为评估不同子图表示计算方法在本任务中的有效性,本文设计了若干实验,系统比较三种方法在所有CMAPSS子数据集和SCADA数据集上的性能,包括平均池化(Model4)、拼接操作(Model5)以及基于多头自注意力的加权求和(Model6)。需要指出的是,由于所提出的HMGPA方法生成的子图中节点数量不一致,Model5在构建子图表示时需要采用零填充以满足后续线性层的输入要求。实验结果如图14所示。
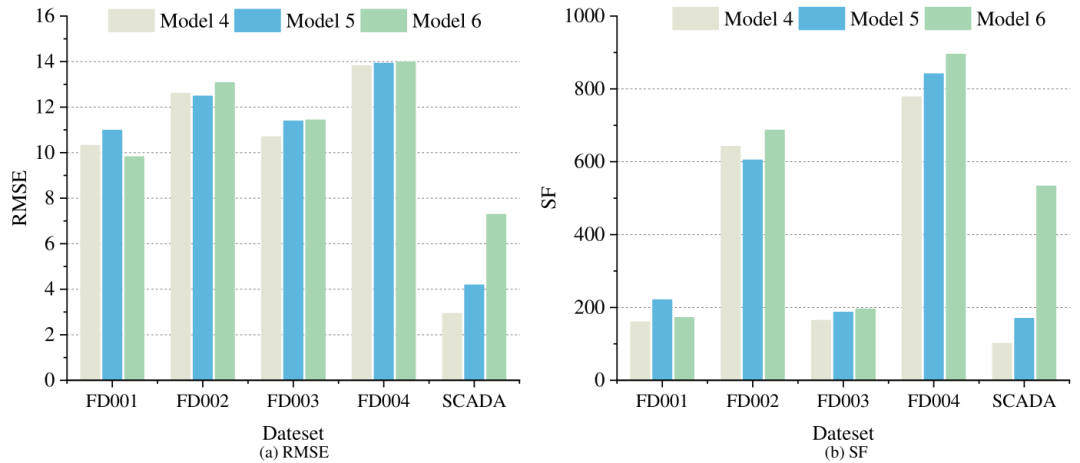
图14 不同子图表示计算方法的比较
从结果可以看出,Model4在所有五次实验中均取得最优或接近最优的综合性能,展现出强大的泛化能力与稳定性。相比之下,另外两种策略在不同方面表现出一定局限性:Model5仅在FD002子数据集上表现略好,但在大多数情况下性能较差,这可能是由于填充操作引入了噪声并增加了学习难度。Model6在FD001上取得了最低的RMSE,但在SCADA数据集上性能显著下降。这可能是由于其复杂权重学习机制存在稳定性不足和泛化能力较弱的问题。
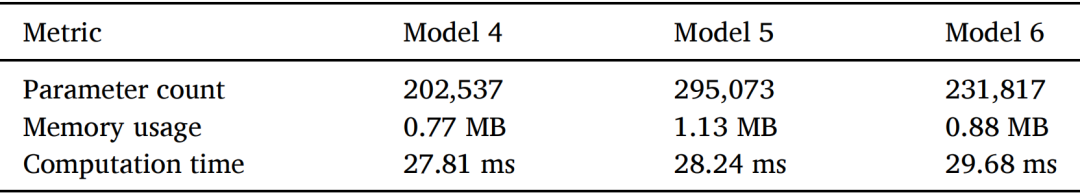
此外,表7从参数量、内存占用和计算时间方面对这三种方法进行了比较。可以看出,拼接操作显著增加了参数量,而加权求和操作则导致计算时间增加。相比之下,平均池化在不显著增加参数量或计算时间的情况下取得了优异性能。基于上述比较结果,本文最终选择平均池化作为子图表示的计算方法。
表7 不同子图表示计算方法的计算复杂度与效率
6 结论
本文提出了一种新颖的HSNN-IB用于RUL预测。所提出的模型采用HMGPA自动提取具有代表性的子图结构,有效捕捉关键的局部拓扑信息。通过引入HGSFU策略,模型显著增强了对局部结构的敏感性,同时有效抑制了冗余信息在子图间的传播。此外,利用MFIBM压缩并优化多个子图的融合表示,从而仅保留对下游预测最任务相关的信息。在CMAPSS和SCADA数据集上进行的大量实验证明了所提方法的优越性与工程适用性。尽管HSNN-IB能够分割出具有代表性的子图,但仍无法实现子图结构的优化。因此,我们未来的研究方向之一是探索图结构优化方法。
编辑:Jin